 LLM
大規模言語モデルのスケーリング則とは?意味・仕組み・活用例をわかりやすく解説
近ごろ、人工知能、とりわけ言葉を扱う技術の分野では、大規模言語モデルが大きな注目を集めています。この大規模言語モデルとは、人間が書いた文章を大量に学習させることで、まるで人間のように文章を書いたり、質問に答えたり、翻訳したりと、様々な作業をこなせるようになる技術です。まるで魔法の箱のようです。この魔法の箱の性能を向上させる鍵となるのが、「規模の法則」です。
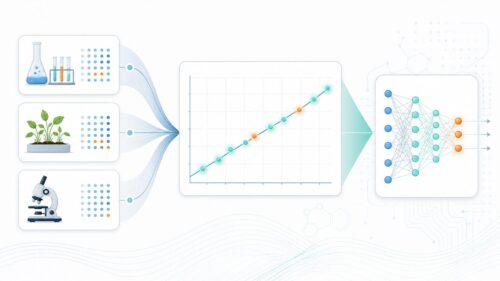
この規模の法則は、モデルの性能が、計算に使う資源の量、学習に使う文章の量、そしてモデル自体の大きさといった要素に、どのように関係しているかを示す経験的な法則です。簡単に言うと、これらの要素を大きくすればするほど、モデルの性能が良くなるという法則です。まるで、植物に水をやればやるほど大きく育つように、モデルも大きく育てれば育てるほど賢くなるのです。しかも、この成長は予測可能です。どれだけの資源を投入すれば、どれだけの性能が得られるか、ある程度見当をつけることができます。この予測可能性が、大規模言語モデルの開発において非常に重要です。限られた資源を効率的に使い、目標とする性能を達成するために、この規模の法則はなくてはならない羅針盤のような役割を果たしているのです。次の章では、この規模の法則について、さらに詳しく見ていくことにしましょう。