

AIの初心者
「物体検出タスク」って、写真に何が写っているかだけでなく、その場所までわかるということですか?

AI専門家
そうです。たとえば犬と猫が写った写真なら、それぞれを四角い枠で囲み、「ここに犬」「ここに猫」と種類と位置を示します。この枠をバウンディングボックスと呼びます。
AIの初心者
犬と猫とボールのように、複数のものが一緒に写っていても、それぞれを見つけられるんですね。
AI専門家
はい。ただし、見つけられる種類や精度は、学習したデータや写真の状態によって変わります。どんな情報が得られるのか、画像分類との違いや、使うときの注意点も見ていきましょう。
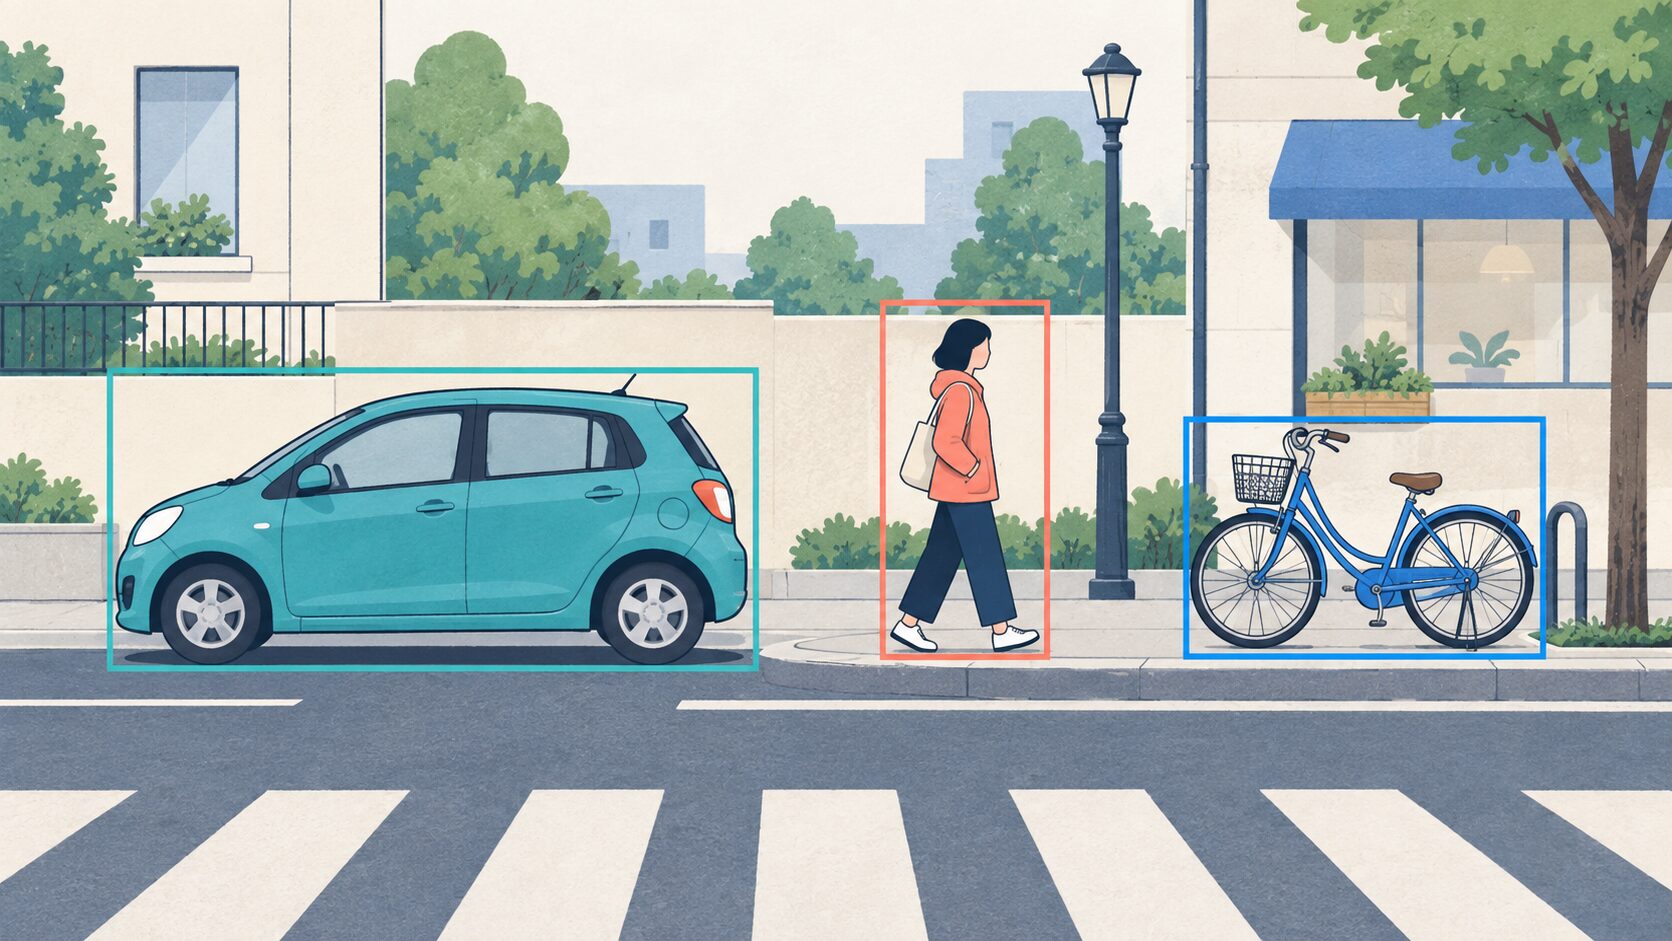
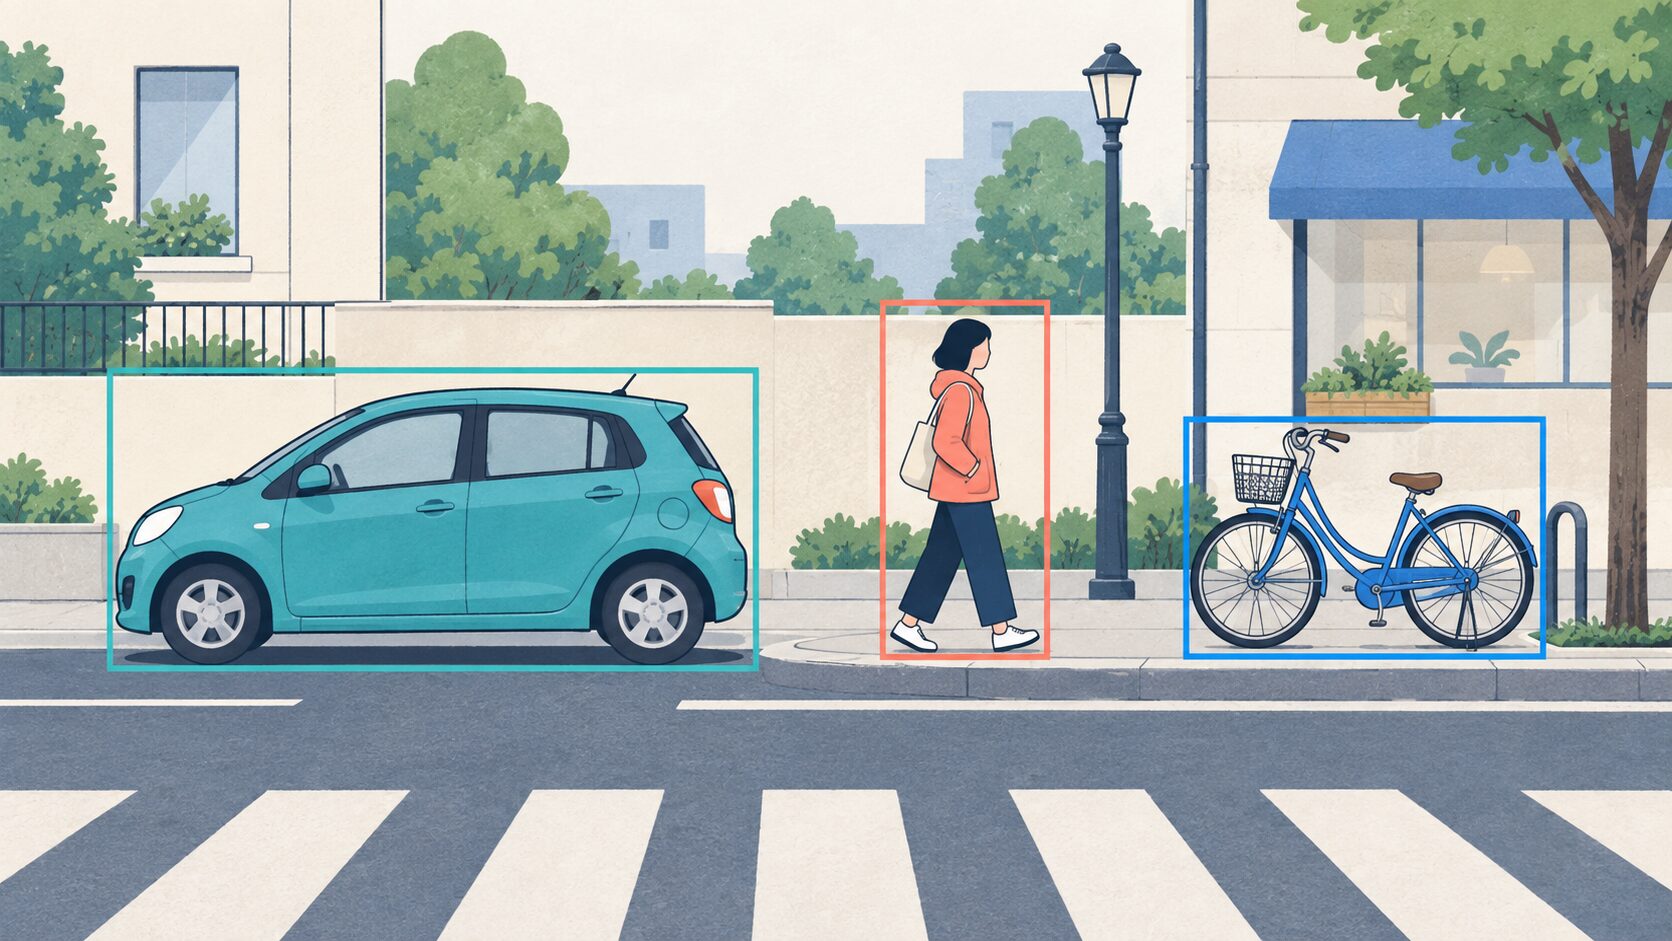
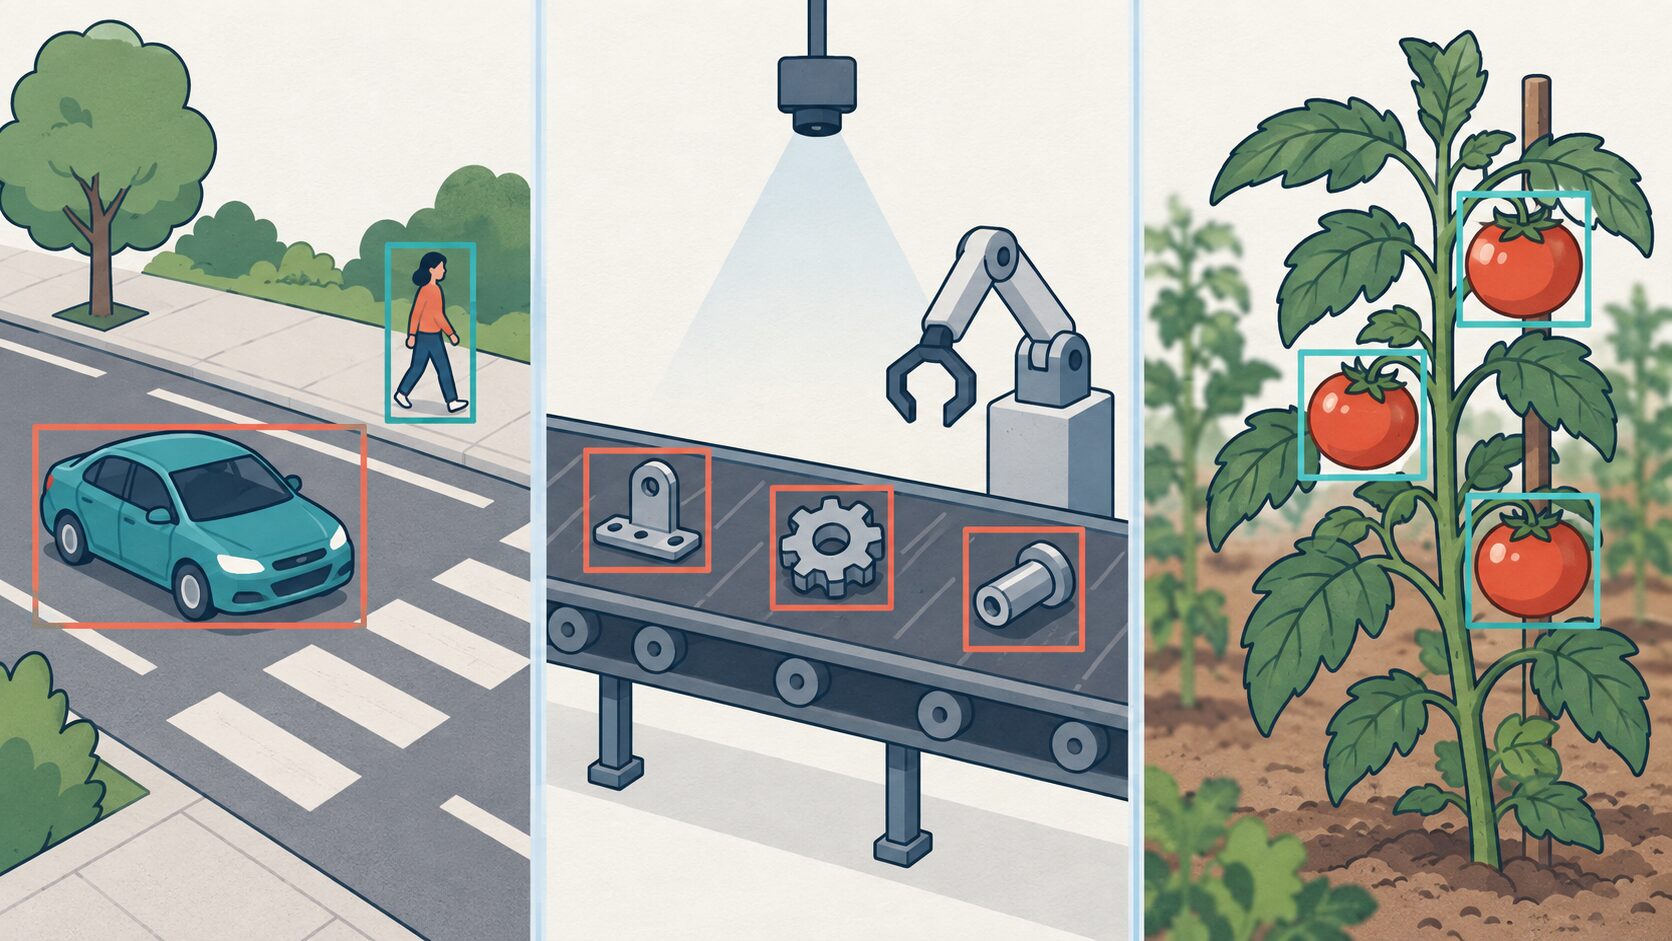
写真の中の車や人を、AIが四角い枠で囲んで示す。このように、画像から物体の種類と位置を見つける技術が「物体検出」です。自動運転の周辺認識、工場での検査、農作物の観察など、画像を使った判断や作業の入口として役立ちます。
この記事では、物体検出の意味、画像分類やセグメンテーションとの違い、検出の仕組み、R-CNN・YOLO・SSDなどの代表的な手法を順に説明します。活用例に加え、精度の見方や導入時につまずきやすい点も確認できます。
物体検出とは?画像の「何が・どこに」を見つける技術
物体検出(Object Detection)とは、画像内にある物体を見つけ、その種類と位置を同時に推定する技術です。AIや機械学習では、取り組む課題のことを「タスク」と呼ぶため、「物体検出タスク」という言い方もします。
たとえば、犬・猫・ボールが写った写真に対し、物体検出ではそれぞれの周囲に枠を描き、「犬」「猫」「ボール」という名前を付けます。犬が2匹いれば、同じ種類でも別の物体として2つの枠を出すことができます。このように、画像全体を一言で説明するのではなく、個々の対象を取り出して扱えることが特徴です。
位置は通常、物体を囲む長方形の「バウンディングボックス」で表します。動画でも、各時点の画像に物体検出を行えば、その時点に写っている車や人の位置を得られます。そこから台数を数える、特定の範囲に人がいるか確認する、といった処理につなげられます。
ただし、一般的な物体検出モデルは、あらかじめ学習した対象の種類を中心に見つけます。犬を検出できるモデルが、そのまま工場独自の部品や細かな傷まで認識できるとは限りません。「画像内のあらゆるものを必ず見つける技術」ではなく、目的と条件に合わせて使う推定技術だと捉えると理解しやすくなります。
画像認識・画像分類・セグメンテーションとの違い
「画像認識」と「物体検出」は、どちらか一方だけを選ぶ対立した概念ではありません。画像認識は、画像から意味のある情報を読み取る技術を広く指す言葉です。その中に、画像分類や物体検出などの課題があります。
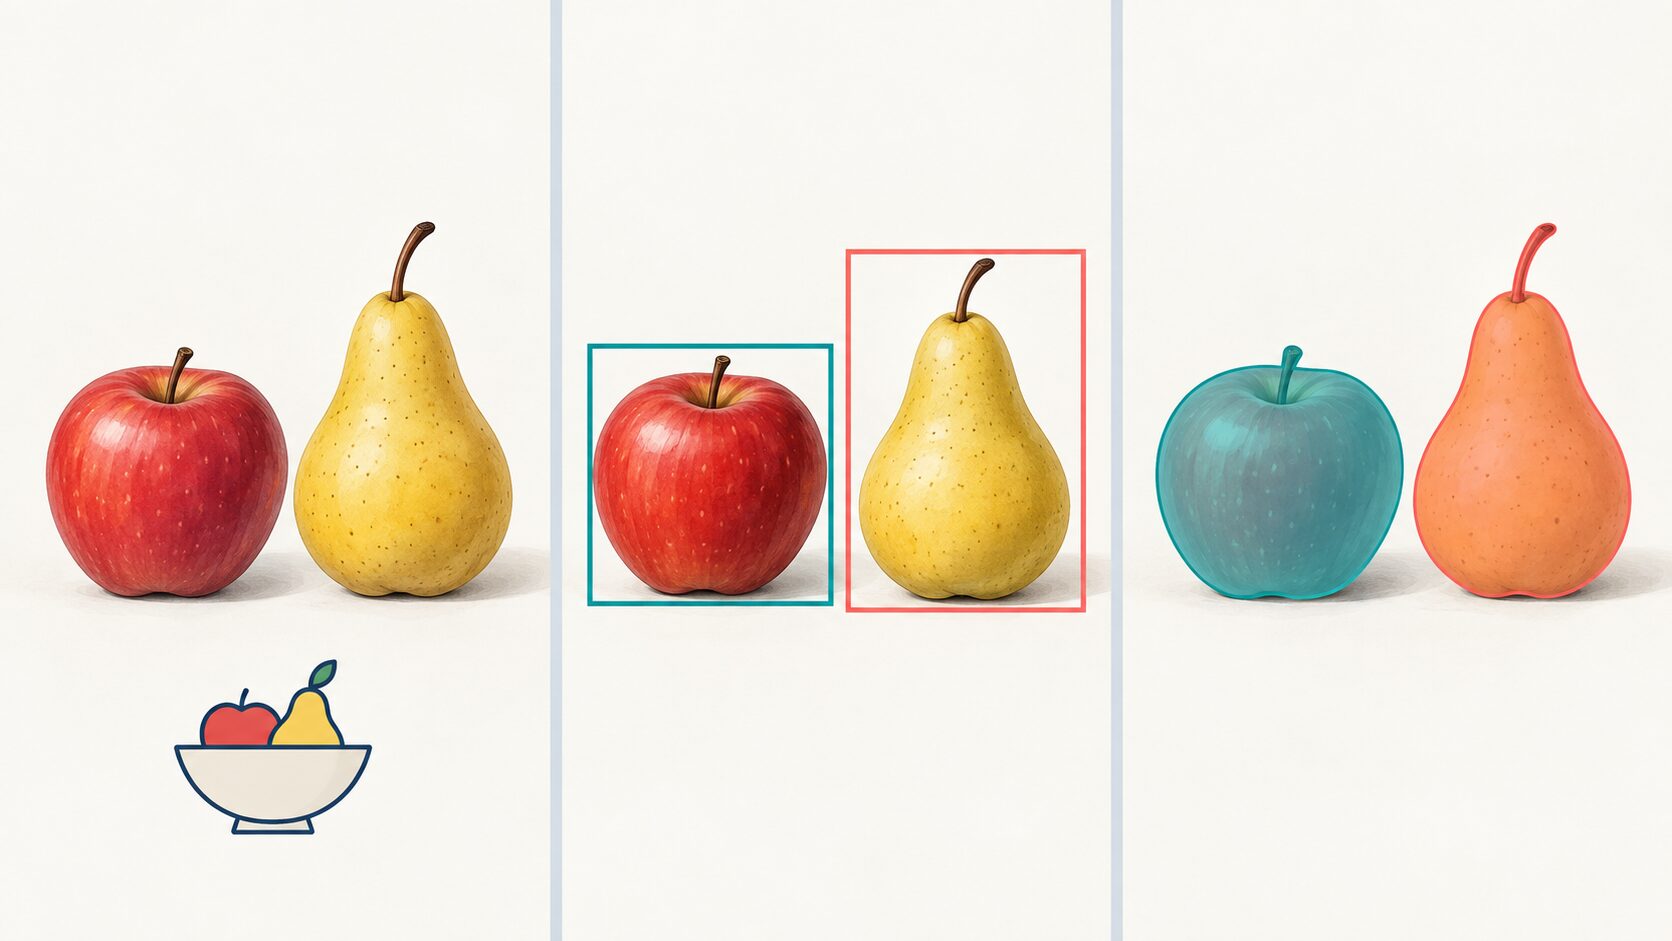
物体検出との違いが分かりやすい比較対象は、画像全体のカテゴリを判定する「画像分類」です。たとえば「果物が写っている画像か」を知りたいだけなら画像分類で足りますが、リンゴと洋ナシの場所や個数を知りたいなら物体検出が役立ちます。
| タスク | 主な出力 | 果物の画像での例 | 向いている目的 |
|---|---|---|---|
| 画像分類 | 画像全体に対する1つ以上のカテゴリ | 「果物の画像」と判定する | 画像の仕分けや、画像全体の良否判定 |
| 物体検出 | 物体ごとの種類と四角い枠 | リンゴと洋ナシを別々の枠で囲む | 対象の位置確認や個数の集計 |
| セグメンテーション | 画素単位の領域 | 果物の輪郭に沿って領域を塗り分ける | 輪郭や画像内の面積を詳しく調べる |
セグメンテーションには、画素ごとの種類を分ける方法や、同じ種類でも物体ごとに領域を分ける方法があります。四角い枠では背景まで含まれるため、果物の形や傷の広がりを詳しく知りたい場合には、輪郭に沿った領域を扱う方法が候補になります。
下図は左から、画像全体の分類、物体ごとの検出、輪郭に沿った領域分割のイメージです。求める出力を先に決めると、必要以上に複雑なタスクを選ばずに済みます。
また、動画で「この車が次の時点ではどこへ動いたか」を結び付ける処理は、物体追跡と呼びます。検出は各画像で対象を見つける役割、追跡は時間をまたいで同じ対象を対応付ける役割です。動画の通行量を数える際には、同じ車を何度も数えないために、この違いが重要になります。
検出結果の読み方:枠・クラス・信頼度
一般的な物体検出の出力は、バウンディングボックス、クラス、信頼度スコアの組み合わせです。見た目の枠だけでなく、数値として位置を取り出せるため、後から集計や別の処理に使えます。
| 出力 | 意味 | 読み方の例 |
|---|---|---|
| バウンディングボックス | 画像内で物体を囲む長方形の位置と大きさ | 左上の横・縦位置と、右下の横・縦位置 |
| クラス | モデルが予測した対象の種類 | 人、車、自転車、犬など |
| 信頼度スコア | 検出候補の確からしさを表すモデルの出力値 | 0.92などの値を基に、採用する候補を絞る |
たとえば横640・縦480ピクセルの画像で、左上から横100・縦80の位置を枠の左上、横300・縦280の位置を右下とすれば、幅200・高さ200ピクセルの枠になります。実装によっては、枠の中心と幅・高さを使ったり、画像サイズに対する割合で表したりするため、座標の形式を確認する必要があります。
枠から分かるのは、まず画像の中での位置や見かけの大きさです。遠くの大型車が近くの小型車より小さく写ることもあるため、枠の大きさだけでは実物の寸法やカメラからの距離を確定できません。実空間の位置が必要なら、奥行き情報やカメラの条件なども使います。
信頼度スコアも、必ずしもそのまま「正解する確率」を示す値ではありません。0.92と表示されても、同じ条件の結果が必ず92%正解するという保証にはならず、スコアの意味や計算方法はモデルによって異なります。
また、「人」というクラスが付くことと、その人の感情・意図・行動を理解することは別です。検出結果を何に使えるかを考える際には、得られる情報の範囲を押さえておきましょう。
物体検出の仕組み:学習から検出まで
深層学習を使う物体検出では、ニューラルネットワークが多数の画像から対象の特徴を学びます。従来の画像処理では、人が色や輪郭などの判断基準を設計する方法も使われてきました。深層学習では、学習データに合わせて特徴の捉え方を調整できることが強みです。
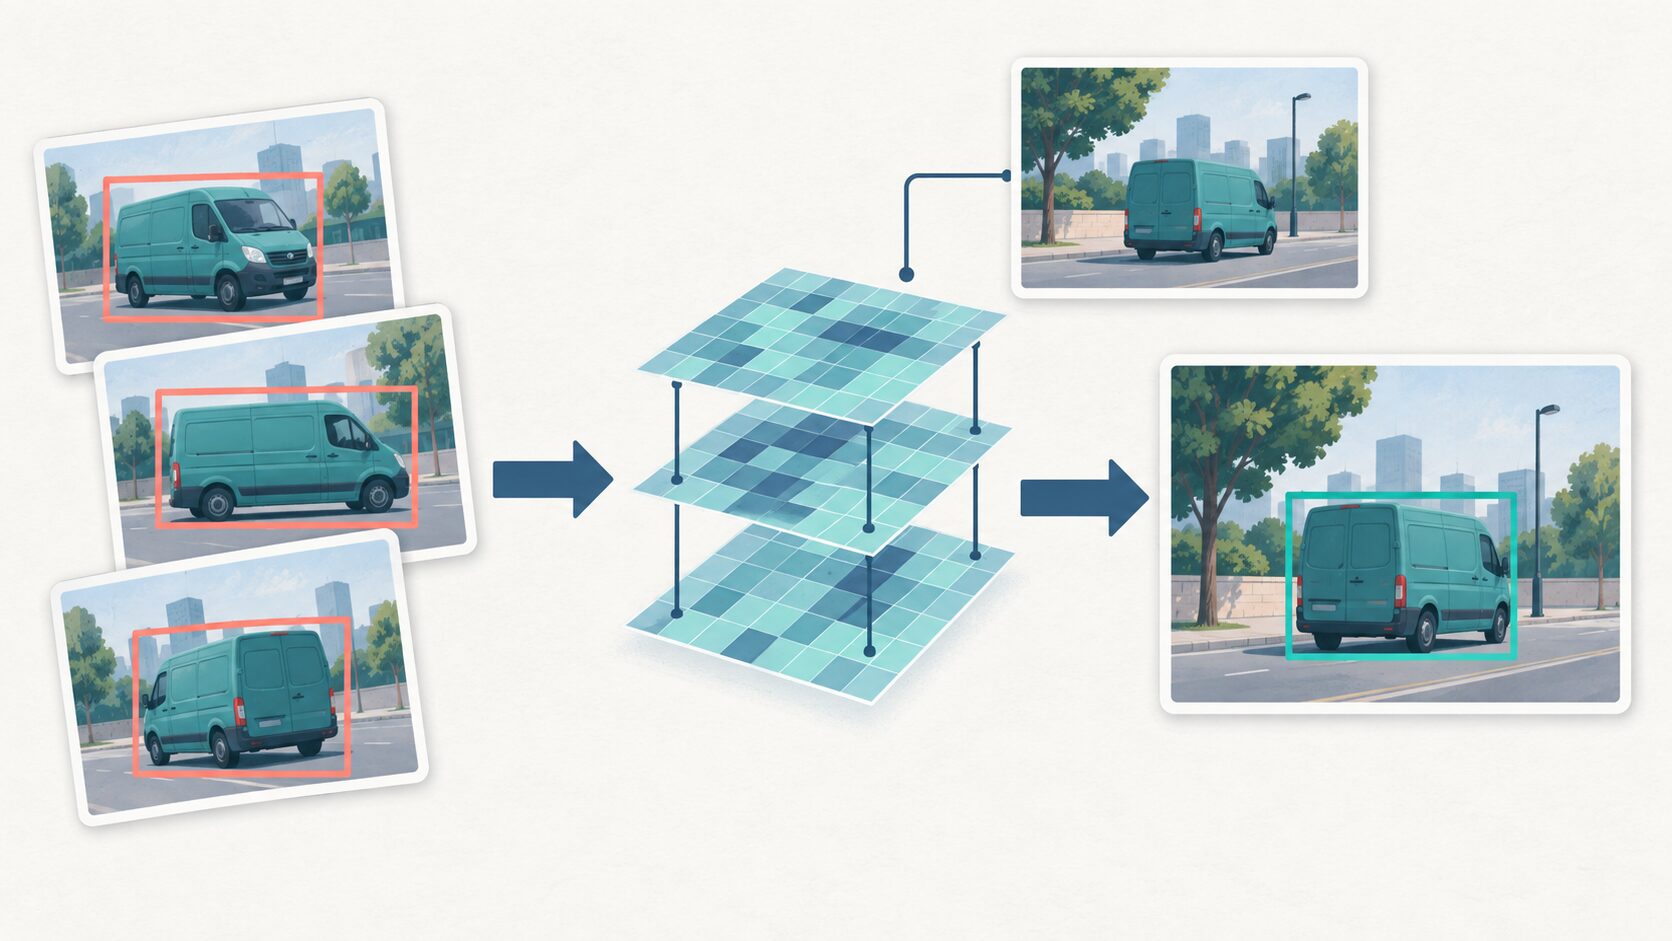
基本的な教師あり学習から利用までの流れは、次のようになります。
- 対象とクラスを決める。「人と車を見つける」「3種類の部品を分ける」など、必要な出力を具体化します。名前の付け方が曖昧なままだと、学習に使う正解も揺れてしまいます。
- 画像に正解を付ける。対象を枠で囲み、対応するクラスを記録します。この作業をアノテーションと呼びます。たとえば車なら、さまざまな角度・大きさ・明るさで写った例を用意します。
- 画像の特徴と正解の関係を学ぶ。モデルの予測した種類や枠と正解との差が小さくなるよう、内部のパラメータを調整します。輪郭や模様、部分の組み合わせなどが判断に使われます。
- 新しい画像から候補を予測する。学習済みモデルに画像を入力し、対象の種類・枠・スコアを得ます。この段階を推論と呼びます。
- 候補を整理して結果を使う。スコアに基づいて候補を絞り、方式によっては重複した枠を整理します。最終結果を画面表示、集計、検査などに渡します。
同じ車に似た枠がいくつも出た場合、そのまま数えると台数を多く見積もってしまいます。そこで、重なりの大きい候補から代表的な枠を残すNMS(非最大値抑制)などの処理が使われます。ただし、候補の出し方や重複処理はモデルによって異なり、すべてが同じ手順ではありません。
学習はモデルの判断の仕方を調整する工程、推論は学習済みモデルを新しい画像に適用する工程です。通常、画像を1枚入力するたびに最初から学び直すわけではありません。既存の学習済みモデルで目的の対象を検出できるか試し、不足する場合に独自データで追加学習する、という進め方もできます。
代表的な手法:R-CNN・YOLO・SSD
物体検出には、対象がありそうな領域を候補として調べる方法や、画像の特徴から枠と種類を直接予測する方法があります。代表例として挙げられるのが、R-CNN、YOLO、SSDです。手法名は無理に日本語へ直訳せず、英字の名称と役割を一緒に覚えると、教材や実装を調べやすくなります。
| 手法 | 基本的な考え方 | 理解・比較のポイント |
|---|---|---|
| R-CNN系 | 物体がありそうな候補領域を用意し、領域ごとに種類や位置を判断する | 元のR-CNNと、処理の共有などで改良されたFast R-CNN・Faster R-CNNを区別する |
| YOLO | 画像全体の特徴から、物体の枠と種類を直接予測する | 速度を重視した用途で検討される。構造や性能はバージョンやモデルサイズで変わる |
| SSD | 複数の解像度の特徴マップを使い、位置と種類を予測する | 異なる大きさの対象を扱うための仕組みを持つ。入力解像度などが検出結果に影響する |
R-CNN系は、まず候補を考え、次に詳しく調べるという流れを理解する入口になります。元のR-CNNは候補領域ごとに画像の特徴を計算するため処理負荷が大きく、その後の手法では特徴計算の共有などが取り入れられました。そのため、「R-CNN系はすべて同じ速度」とは考えないことが大切です。
YOLOは「You Only Look Once」の略です。名前は画像全体から直接予測する考え方を表しており、「すべての処理が1回の計算だけで終わる」という意味ではありません。SSDは「Single Shot MultiBox Detector」の略で、粗さの異なる特徴マップを利用することが特徴です。
選ぶときは、方式名だけで速さや正確さを決めず、同じ画像と同じ実行環境で比較することが重要です。小さな対象の見つけやすさは、方式に加えて入力画像の解像度、学習データ、モデルの規模などでも変わります。「YOLOは小さいものを検出できない」「SSDなら速度と精度が必ず両立する」といった断定はできません。
たとえば、ベルトコンベア上の部品を検査するなら、部品が通過するまでに結果が間に合うかを確認します。一方、静止画像をまとめて検査するなら、多少時間をかけても見逃しを減らす設定が適する場合があります。必要な精度、許容できる待ち時間、使える機器を合わせて判断しましょう。
物体検出の活用例:自動運転から工場・農業まで
物体検出は、画像の中から次の処理に必要な対象を取り出す役割を担います。活用例を見るときは、「何を検出するか」と「検出した後に何を判断するか」を分けると、システム全体を理解しやすくなります。
| 分野 | 検出する対象の例 | 検出結果の使い方・組み合わせる処理 |
|---|---|---|
| 自動運転・運転支援 | 車、歩行者、信号機、標識 | 周辺状況の把握に利用し、距離・動きの推定や走行判断と組み合わせる |
| 監視カメラ・施設管理 | 人、車両、荷物 | 立ち入り範囲や滞在時間のルール、追跡処理と組み合わせて確認対象を絞る |
| ロボット・物流 | 部品、箱、通路上の障害物 | 把持する対象の候補や移動計画に使い、奥行き・姿勢推定や制御につなげる |
| 製造業の外観検査 | 製品、傷、欠けなど | 不良の疑いがある位置を示し、検査基準に沿った確認に使う |
| 医療画像の解析 | 画像上の病変が疑われる領域 | 医師が確認する候補の提示など、画像の読影支援に使う |
| 農業 | 果実、作物、害虫など | 数や位置の把握を起点に、生育の観察や収穫作業の支援につなげる |
自動運転では、歩行者を検出した結果がブレーキなどの判断に使われることがあります。ただし、枠が出るだけで安全に停止できるわけではありません。進行方向、速度、距離、ほかのセンサー情報などを組み合わせて、車両を制御する必要があります。
監視カメラでも、人を検出しただけで「不審者」だと判断することはできません。指定区域への立ち入りや荷物の置き去りを調べるには、位置に加えて時間的な変化や運用ルールが必要です。ロボットが部品をつかむ場合にも、画像上の枠だけでなく、部品の奥行きや向き、つかめる位置を求める処理が関わります。
外観検査では、傷の有無を画像全体で判定できれば画像分類、傷の位置を示すなら物体検出、傷の輪郭や面積を調べるならセグメンテーション、というように目的で使い分けます。医療や農業でも同様に、検出できることと最終的な診断・収穫時期の判断ができることは別です。必要な確認や分析を含めて活用を設計します。
精度を確認する指標と見逃し・誤検出
物体検出の精度は、「枠がたくさん表示されたか」だけでは判断できません。対象を見落としていないか、背景を対象と間違えていないか、枠の位置が適切かを確認します。種類が正しくても枠が大きくずれていれば、位置を使う処理には支障が出ます。
適合率(Precision)は、検出したもののうち正しかったものの割合です。たとえば「車」として10件を検出し、評価基準に合う正しい検出が8件なら、適合率は80%です。残り2件は別のものを車と誤認したなどの誤検出に当たります。
再現率(Recall)は、実際にある対象のうち検出できたものの割合です。別の例として、画像に車が10台あり、そのうち8台を正しく見つけたなら、再現率は80%です。見つからなかった2台が見逃しです。どちらも80%ですが、何を分母にするかが異なります。
候補を採用する信頼度の基準値を「しきい値」と呼びます。しきい値を上げると低スコアの候補が減り、一般には誤検出を抑えやすくなる反面、見逃しが増えることがあります。下げると対象を拾いやすくなりますが、誤検出も増えがちです。見逃しと誤検出のどちらをどれだけ許容できるかを、実際の作業に合わせて決めます。
枠の位置の評価には、予測した枠と正解の枠の重なり具合を示すIoUが使われます。2つの枠が重なる面積を、両方を合わせた領域の面積で割った値で、完全に重なれば1、重なりがなければ0です。どの程度の重なりを正解とするかで、評価結果は変わります。
複数のクラスについて検出性能をまとめる指標としてmAPもあります。しきい値を変えたときの適合率と再現率の関係を基に評価する指標ですが、IoUの条件や集計方法によって値が変わります。異なる記事や製品の数値を比べる際は、評価に使った画像、対象クラス、入力解像度などの条件も合わせて確認することが必要です。
導入・学習で押さえたい注意点
きれいなサンプル画像で検出できても、実際のカメラ映像で同じ結果が出るとは限りません。物体検出を学ぶときも業務で使うときも、成功例だけでなく、失敗する条件を集めて確かめることが大切です。
- 対象が小さい・遠い。画像内で数ピクセル程度しか占めない物体は、種類を判断する手掛かりが少なくなります。入力解像度を上げるほか、カメラの位置や撮影範囲を見直す方法もあります。
- 対象の一部が隠れている。人の重なり、棚の陰、葉に隠れた果実などは、全体の特徴が見えません。見えている部分だけを正解枠にするか、全体を想定して囲むかといった注釈の方針も統一します。
- 暗さ・逆光・ブレがある。対象と背景の区別が難しくなります。モデルの変更だけでなく、照明、シャッター速度、カメラの固定など、撮影側の改善も検討します。
- 学習時と使用時の画像が異なる。昼間の道路で学習したモデルを夜間に使う場合や、別の工場・カメラに移す場合は、写り方の違いで精度が下がることがあります。
- 正解データに抜けやばらつきがある。写っている対象を囲み忘れたり、同じ部品に別のクラス名を付けたりすると、学習にも評価にも影響します。枠を付ける基準を共有しましょう。
評価用の画像は、学習用とは分けて用意します。特に動画から画像を切り出す場合、ほぼ同じ連続フレームが両方に入ると、新しい場面に対応できているかを確かめにくくなります。撮影日や場所、動画単位で分けるなど、実際の利用に近い条件を考えて分割します。
速度の確認も欠かせません。モデルの推論時間だけが短くても、撮影、画像の転送、前処理、結果表示に時間がかかれば、作業に間に合わない場合があります。1秒間に処理できる画像数であるFPSに加え、撮影から結果が使えるまでの遅延を、実際に使う機器で測ります。
初めて試すなら、目的を1つに絞り、学習済みモデルに手元の画像を数種類入力してみると理解が進みます。その際、対応するクラスを確認し、検出できなかった画像や誤った枠を記録します。対象の大きさ、明るさ、角度などの共通点を探すと、追加データや撮影条件のどこを改善すべきか考えやすくなります。
人物や私有地が写る映像を扱う場合は、撮影・利用する範囲、保存期間、アクセスできる人も決めておきます。モデルを動かすことだけでなく、取得した画像と検出結果をどう扱うかまで含めて準備します。
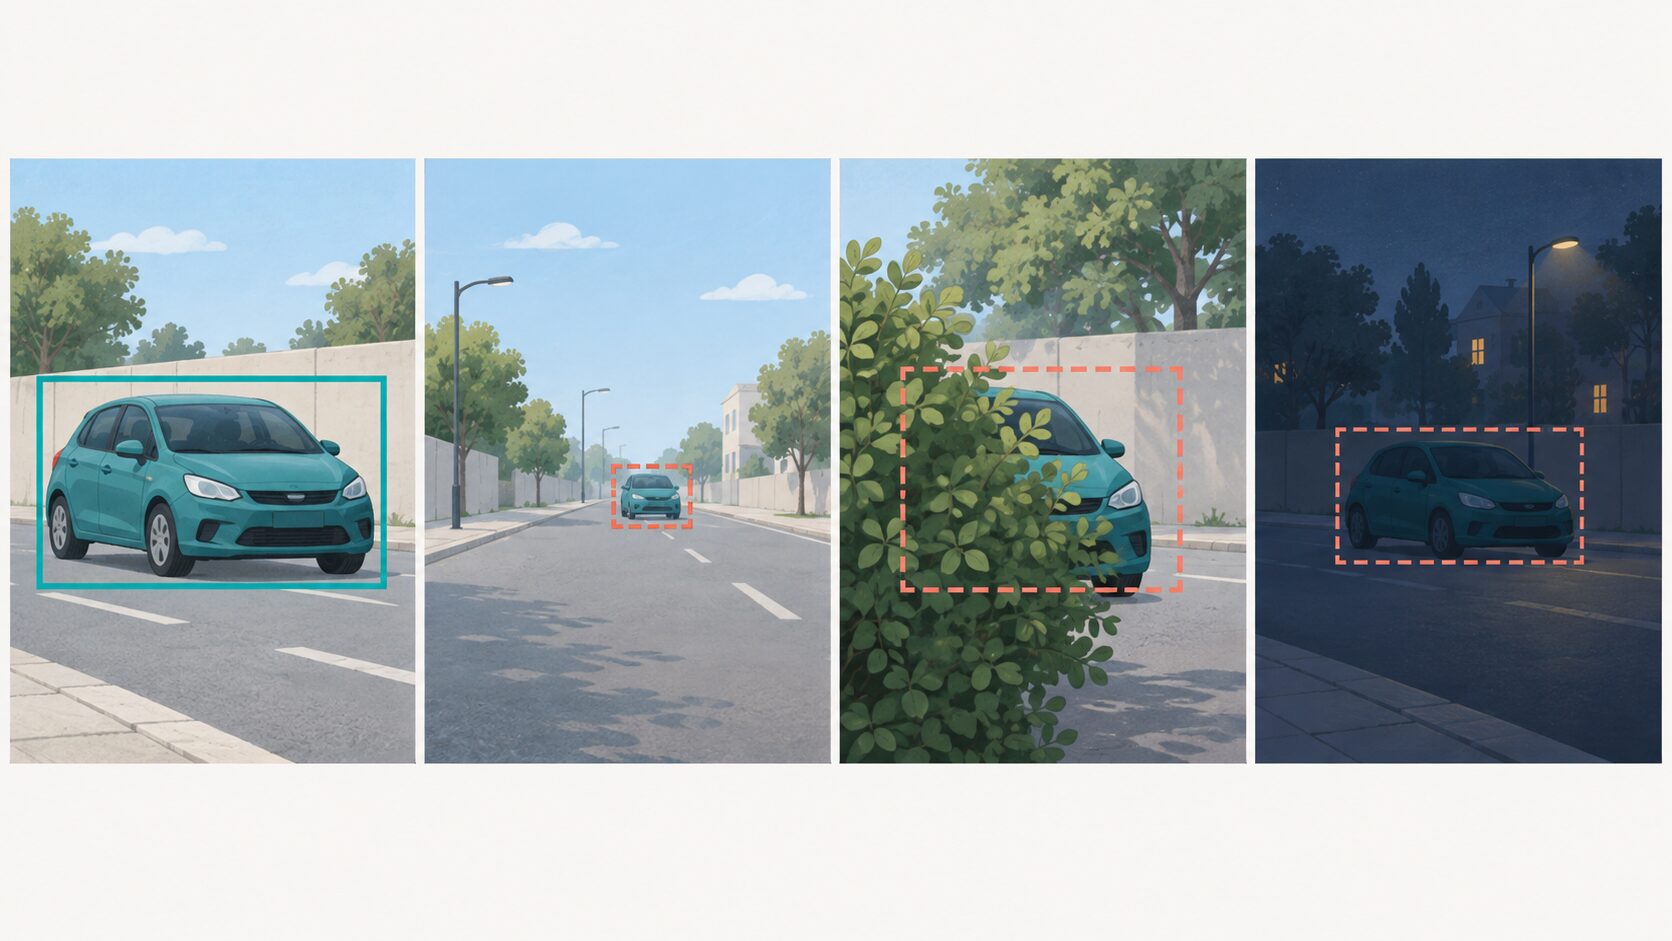
図の点線は、検出が難しくなりやすい条件を示すための表現です。実際に検出できるかどうかは、モデルや撮影条件によって異なります。
今後の展望:追跡・3次元認識との連携
物体検出の発展を考えるうえでは、精度や速度の改善に加え、別の技術と組み合わせて何ができるかが重要です。動画で同じ物体を結び付ける追跡と連携すれば、移動経路や滞在時間の分析に使えます。奥行き情報などを用いる3次元認識と連携すれば、画像上の枠から一歩進んで、実空間の位置関係を扱えます。
農業では、果実や作物を検出した記録を時系列で比べ、生育の変化を観察する使い方が考えられます。ただし、収穫時期を判断するには、果実の検出に加えて成熟度などを調べる処理が必要です。災害対応でも、撮影画像から人や車両、損傷が疑われる箇所などの候補を見つけることが、状況把握を支える可能性があります。
こうした用途では、小さな対象や複雑な背景への対応、撮影環境が変わっても安定して使えることが課題になります。大量の画像から確認すべき箇所を絞り込める一方で、画像に十分写っていない情報まで確実に復元できるわけではありません。用途に必要な情報を撮影し、検出結果を検証できる仕組みと合わせて発展させていくことが大切です。
まとめ:目的に合った検出と評価が大切
物体検出は、画像の中の「何が・どこに」を推定し、物体ごとの種類と位置を取り出す技術です。画像全体を分類する方法や、輪郭に沿って領域を分ける方法との違いを理解すると、目的に合った使い方を選べます。
R-CNN・YOLO・SSDなどの手法を比較するときは、名前だけで判断せず、必要な対象を実際の画像と機器で確かめましょう。見逃し・誤検出・処理の遅延を確認し、検出後の集計や判断まで設計することが、学習にも実務への導入にも役立ちます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月29日 | 画像分類との違いと検出結果の読み方を補い、手法比較と評価指標を見直した |