LLM

記事数:(54)

学習

GRPOとは?複数の回答を比較してLLMを学習させる仕組み

GRPOとは?複数の回答を比較してLLMを学習させる仕組み AIの初心者 GRPOは、AIに何度も回答させて、一番よい答えを選ぶ仕組みですか? AI専門家 複数の回答を比べる点は近いですが、目的はモデルの学習です。同じ質問への回答を採点し、...
アルゴリズム

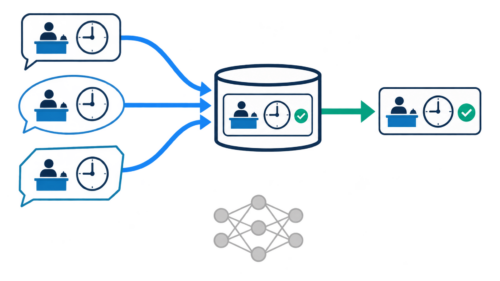
セマンティックキャッシュとは?似た質問の回答を再利用する仕組みと注意点

セマンティックキャッシュとは?似た質問の回答を再利用する仕組みと注意点 AIの初心者 AIへの問い合わせで、同じ意味の質問にも毎回答えを作っているのは、少しもったいなく感じます。 AI専門家 そんな場面で役立つのがセマンティックキャッシュで...
アルゴリズム

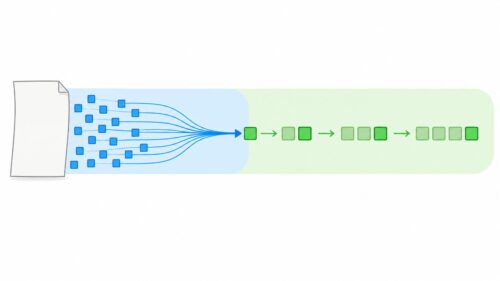
プリフィルとデコードとは?処理の違いとLLM推論を分離する仕組み

プリフィルとデコードとは?処理の違いとLLM推論を分離する仕組み AIの初心者 生成AIで、返答が始まるまで長く待つときと、文章が少しずつ遅く出てくるときがあります。どちらも同じ処理が遅いのでしょうか? AI専門家 原因は分けて考えられます...
アルゴリズム

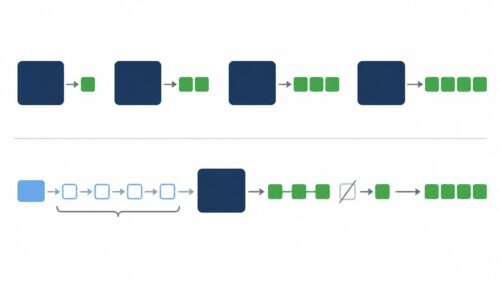
投機的デコーディングとは?LLMの回答を高速化する仕組み

投機的デコーディングとは?LLMの回答を高速化する仕組み AIの初心者 AIの回答が少しずつ表示されます。まとめて文章を作れば、もっと速くなるのでしょうか? AI専門家 通常は直前までの文章を見て、次の要素を一つずつ決めます。そこで、軽いモ...
アルゴリズム

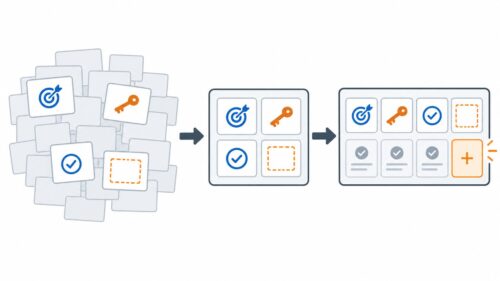
コンテキスト圧縮とは?長いAI作業を引き継ぐ仕組みと注意点

コンテキスト圧縮とは?長いAI作業を引き継ぐ仕組みと注意点 AIの初心者 AIと長く相談していると、最初に伝えた条件が抜けることがあります。会話を短くまとめれば、そのまま続けられるのでしょうか? AI専門家 そのための方法の一つがコンテキス...
LLM

プロンプトキャッシュとは?LLMの費用と待ち時間を減らす仕組み・効かない原因

プロンプトキャッシュとは?LLMの費用と待ち時間を減らす仕組み・効かない原因 AIの初心者 社内の長い業務マニュアルをAIに毎回渡しています。同じ資料を送るたびに費用と待ち時間がかかるのですが、減らす方法はありますか? AI専門家 共通する...
LLM

ローカルLLMとは?自分のPCや社内環境でLLMを動かす方法

ローカルLLMとは?自分のPCや社内環境でLLMを動かす方法 AIの初心者 「ローカルLLM」という言葉を見かけました。ChatGPTのようなAIと何が違うのでしょうか? AI専門家 ローカルLLMは、インターネット上のAIサービスに毎回問...
AI活用

MCPとは?AIエージェントの外部ツール連携をCLI連携と比較して解説

MCPとは?AIエージェントの外部ツール連携をCLI連携と比較して解説 AIの初心者 MCPという言葉をよく見るようになりました。AIエージェントや外部ツール連携と関係があるのですか? AI専門家 あります。MCPは、AIアプリやAIエージ...
アルゴリズム

ハーネスエンジニアリングとは?意味と使い方をわかりやすく解説

ハーネスエンジニアリングとは?意味と使い方をわかりやすく解説 AIの初心者 「ハーネスエンジニアリング」という言葉を見ました。プロンプトエンジニアリングとは違うものですか? AI専門家 違います。ハーネスエンジニアリングは、AIをうまく動か...
LLM

敵対的プロンプトとは?プロンプトインジェクションのリスクと防御策

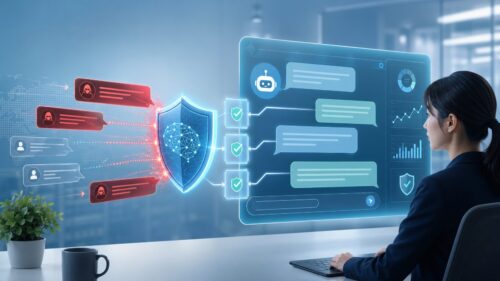
近ごろ、人工知能、とりわけ文章や絵、音楽といったものを作り出す人工知能の進歩には目を見張るものがあります。このような技術は、私たちの暮らしや仕事に大きな変化をもたらす可能性を秘めています。まるで夢のような話ですが、その一方で、使い方を誤ると大変な危険も潜んでいます。その一つが「敵対的な指示」と呼ばれるものです。 この「敵対的な指示」とは、人工知能を騙して、本来とは違う結果を出させる特別な命令のことです。まるで魔法の言葉のように、人工知能の働きを邪魔し、有害な情報や間違った情報を作り出させてしまう危険性があります。例えば、本来は安全な情報を提供する人工知能に、この特別な命令を与えることで、人を騙すような情報や、差別的な言葉を吐かせることもできてしまうのです。 この技術が悪用されれば、社会に混乱を招きかねません。偽の情報が拡散され、人々の判断を狂わせ、社会不安を引き起こす可能性も否定できません。また、企業の機密情報が盗まれたり、個人のプライバシーが侵害されるリスクも懸念されます。 そこで、この敵対的な指示から人工知能を守るための対策が重要になります。人工知能自身が悪意のある命令を見破る能力を高める工夫や、外部からの不正なアクセスを防ぐ仕組み作りが必要です。さらに、利用者側も正しい知識を持ち、責任ある使い方を心がけることが大切です。このブログ記事では、これから敵対的な指示の仕組みや影響、そして対策について、より深く掘り下げて解説していきます。これらを理解することで、人工知能の恩恵を安全に享受し、より良い未来を築く一助となるでしょう。
LLM

AIのハルシネーションとは?原因・具体例・対策をわかりやすく解説

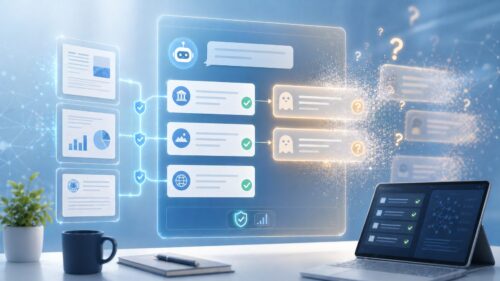
近ごろ、人工頭脳の著しい進歩に伴い、様々な場所で活用が進んでいます。ものの、人工頭脳はなんでもできるわけではなく、時として人が驚くような間違いを起こすことがあります。特に注目されているのが「幻覚」と呼ばれる現象です。まるで幻覚を見ているかのように、人工頭脳が事実に基づかない情報を作り出してしまうこの現象は、人工頭脳開発における大きな課題となっています。人工頭脳が社会に深く入り込んでいく中で、幻覚の理解はますます大切になっています。 この幻覚は、人工頭脳が学習したデータに偏りがあったり、学習データが不足していたりする場合に発生しやすくなります。例えば、特定の人物や物事に関する情報ばかりを学習した場合、それ以外の情報について問われると、学習データに基づかない不正確な情報を生成してしまう可能性があります。また、大量のデータを学習したとしても、そのデータの中に誤った情報が含まれていた場合、人工頭脳はそれを正しい情報として認識し、幻覚を引き起こす原因となることがあります。 この幻覚は、様々な問題を引き起こす可能性があります。例えば、ニュース記事を生成する人工頭脳が幻覚を起こした場合、事実に基づかない誤った情報が拡散される危険性があります。また、医療診断を支援する人工頭脳が幻覚を起こした場合、誤診につながり、患者の健康を脅かす可能性も考えられます。このように、人工頭脳の幻覚は、社会に大きな影響を与える可能性があるため、早急な対策が必要です。 幻覚への対策としては、学習データの質と量を向上させることが重要です。偏りのない、多様なデータを用いて人工頭脳を学習させることで、幻覚の発生率を抑制することができます。また、人工頭脳が生成した情報が正しいかどうかを検証する仕組みを導入することも有効です。人が生成された情報をチェックしたり、他の情報源と照らし合わせたりすることで、幻覚による誤りを防ぐことができます。人工頭脳が社会にとってより良いものとなるよう、幻覚への理解を深め、対策を進めていく必要があります。
AI活用

専門特化型生成AI:ドメイン固有とは

近頃、文章や画像、音楽などを作り出す人工知能が大きな進歩を見せており、様々な場面で使われています。こういった人工知能は広く一般的な知識を学習していますが、特定の分野における専門的な知識や言い回し、文脈の理解が十分でない場合があります。特定の分野に特化した人工知能は、この点を克服するために注目を集めています。 特定の分野に特化した人工知能とは、ある特定の領域や分野に絞って学習させた人工知能のことです。医療、法律、金融など、様々な分野を専門とする人工知能が開発されています。これらの特化型人工知能は、専門分野における知識や用語、独特の言い回しを理解し、その知識に基づいて文章や応答を作り出します。 例えば、医療分野に特化した人工知能を考えてみましょう。この人工知能は、医学用語や病気に関する知識を豊富に持っています。患者の症状を説明する文章を入力すると、その症状から考えられる病気を推測したり、適切な検査方法を提案したりすることができます。これは医師の診断を補助するツールとして役立ちます。 また、法律分野に特化した人工知能もあります。法律用語や過去の判例に関する知識を大量に学習しており、法的紛争が生じた際に過去の判例を参考にしながら、どのような法的措置を取るのが適切かをアドバイスすることができます。 このように、特定の分野に特化した人工知能は、その分野に特化することで、より正確で専門性の高い結果を生み出すことができます。これは、人工知能が様々な専門分野で活躍するための重要な一歩と言えるでしょう。
LLM

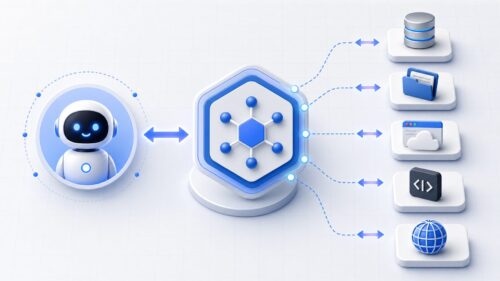
外部ツールで進化するLLMとは?RAG・Function Calling・エージェントを解説

近ごろの技術の進歩によって、巨大な言葉の模型、いわゆる大規模言語模型が急速に発展しています。これらの模型は、膨大な量の文章を学習することで、人間のように自然な文章を作ったり、質問に答えたりすることができます。まるで、知識の宝庫を持っているかのように、様々な話題について話したり、文章を書いたりすることができるのです。しかし、この知識の宝庫にも限界があります。大規模言語模型が学習した情報は、学習時点までのものです。そのため、常に最新の出来事や特定の分野の専門的な知識を提供することは難しいのです。 そこで注目されているのが、外部の道具を使って大規模言語模型の能力を拡張する技術、「拡張言語模型」です。これは、大規模言語模型が単独で答えを出すのではなく、外部の道具を使って必要な情報を集め、より正確で豊富な内容を伝えることを可能にします。例えるなら、専門家が調べ物をするときのようにです。専門家は、文献や情報データベースから必要な情報を集め、それを基に答えをまとめます。同じように、拡張言語模型も外部の道具を使うことで、まるで専門家のように振る舞い、その能力を格段に向上させることができるのです。 具体的には、計算機や情報検索システム、翻訳システムなど、様々な道具を連携させることができます。例えば、最新のニュースについて質問された場合、拡張言語模型はニュースサイトから最新の情報を取り出して答えを生成します。また、特定の分野の専門知識が必要な場合は、専門のデータベースにアクセスして情報を取得し、より専門的で正確な回答を提供することができます。このように、拡張言語模型は、大規模言語模型単体では不可能だった、常に最新で正確な情報を提供することを可能にし、私たちの生活をより豊かにする可能性を秘めていると言えるでしょう。
LLM

RAGとは?意味・仕組み・活用例をわかりやすく解説

RAG(検索拡張生成)は、LLMが回答を作る前に外部文書やデータベースを検索し、その情報をもとに回答を生成する仕組みです。この記事では、RAGの意味、基本的な流れ、ベクトル検索との関係、通常のLLMとの違い、活用例、導入時の注意点をわかりやすく解説します。
AIサービス

大規模言語モデルを使ったサービスの広がり

近ごろ、言葉を扱う大きなコンピュータ技術がとても進歩しています。まるで人間のように自然な文章を組み立てたり、質問に答えたり、言葉を通訳したりと、その能力は目を見張るものがあります。この技術は、膨大な量の文章を学習することで、言葉の繋がりや意味を理解しています。そして、この技術はもはや研究室の中だけの話ではなく、私たちの身近なところで使われるようになってきました。例えば、文章の作成を手伝ってくれたり、わからないことを教えてくれたり、外国語を翻訳してくれたりと、様々な場面で活躍しています。 この技術を支えているのは、「大規模言語モデル」と呼ばれる、巨大な頭脳のようなものです。この頭脳は、インターネット上にある、書籍や記事、会話など、膨大な量の文章データを学習しています。学習したデータをもとに、私たちが普段使っている言葉と同じように、自然で滑らかな文章を作り出すことができるのです。まるで人間が書いたかのような文章を作るため、文章の作成支援だけでなく、文章の要約や校正など、様々な作業を効率化することができます。また、質問に対して的確な答えを返すことも得意としています。そのため、検索エンジンや人工知能を使った相談窓口などで活用されています。 さらに、この技術は言葉の壁をなくす力も持っています。異なる言語を瞬時に翻訳することで、世界中の人々がスムーズにコミュニケーションをとれるようになります。ビジネスの場での活用はもちろんのこと、旅行や国際交流など、様々な場面で活躍が期待されています。このように、大規模言語モデルは私たちの生活に革新をもたらす可能性を秘めています。今後、更なる技術の進歩によって、私たちの生活はどのように変わっていくのでしょうか。その可能性について、これから詳しく見ていきましょう。
LLM

プロンプトエンジニアリングとは?基本の作り方・例・注意点を解説

近年、人工知能(AI)技術は目覚ましい発展を遂げ、私たちの暮らしを大きく変えつつあります。特に、人間が書いたような自然な文章を作成する技術は、目覚ましい進歩を見せています。文章の生成だけでなく、翻訳や質問への回答といった高度な処理も可能になり、様々な分野で活用が始まっています。この技術の中核を担うのが、大規模言語モデルと呼ばれるものです。膨大な量の文章データを学習することで、まるで人間のように言葉を使うことができるようになりました。 しかし、AIの能力を最大限に引き出すためには、適切な指示を与えることが不可欠です。あいまいな指示では、AIは期待通りの結果を出せません。まるで、料理人にレシピを教えずに美味しい料理を作ってほしいと頼むようなものです。そこで重要になるのが、プロンプトエンジニアリングと呼ばれる技術です。プロンプトエンジニアリングとは、AIに与える指示を設計し、最適化する技術のことです。具体的には、どのような言葉で、どのような順番で指示を与えるか、どのような情報を加えるかなどを工夫することで、AIからより正確で、より望ましい結果を引き出すことができます。 プロンプトエンジニアリングは、AI活用における重要な鍵と言えるでしょう。適切な指示によって、AIは秘められた能力を発揮し、私たちの生活をより豊かにしてくれるはずです。例えば、顧客からの問い合わせに自動で回答するシステムや、大量の文書を要約するシステムなど、様々な場面で活用が期待されています。プロンプトエンジニアリング技術の進歩は、AIの更なる普及と発展に大きく貢献していくことでしょう。
LLM

大規模言語モデルの弱点とは?LLMが得意なこと・苦手なことをわかりやすく解説

近年の技術革新により、大規模言語模型は目覚ましい発展を遂げ、膨大な資料から規則性を、多様な作業をこなせるようになりました。文章の作成や翻訳、質疑応答など、私たちの生活に役立つ場面も増えてきました。しかし、高度な専門性を要する分野においては、その実力を十分に発揮できないという課題も抱えています。 例えば、法律や自然科学といった分野を考えてみましょう。法律では、過去の判例や法令に基づいて緻密な論理を展開し、結論を導き出す必要があります。自然科学では、複雑な数式を用いた計算や、実験に基づいた検証が不可欠です。大規模言語模型は、資料から規則性を見つけることは得意ですが、論理的に考えたり、計算をしたりすることは苦手です。そのため、これらの分野で正確な結果を出すことは難しいと言えるでしょう。 大規模言語模型は、学習資料に含まれる単語の繋がりや出現頻度に基づいて文章を生成しています。つまり、言葉の表面的な繋がりを捉えているだけで、その背後にある深い意味や論理構造までは理解していません。そのため、一見すると正しそうに見える文章でも、論理的に破綻していたり、事実と異なる内容が含まれていたりする可能性があります。 もちろん、専門的な資料を学習させることで、ある程度は専門性の高い文章を生成することも可能です。しかし、それはあくまでも学習資料に含まれる情報の組み合わせであり、真の理解に基づいたものではありません。そのため、専門家による確認や修正が必要不可欠です。今後、大規模言語模型が真に高度な専門知識を扱えるようになるためには、論理的思考力や計算能力の向上といった、さらなる技術革新が求められます。現状では、大規模言語模型を補助的な道具として活用し、最終的な判断は専門家が行うことが重要です。
LLM

AIのスケーリング則とは?仕組み・数式・限界を初心者向けに解説

「規模の法則」とも呼ばれるスケーリング則は、人工知能モデルの性能向上が、モデルの規模拡大とどのように関係しているかを示す重要な法則です。この法則は、モデルの性能に影響を与える要素を数学的に表しています。具体的には、モデルの中に含まれるパラメータの数、学習に使うデータの量、そして計算に使う資源の量が、モデルの精度にどのように関わってくるかを説明します。 一般的に、これらの要素を増やすほど、モデルの誤りは少なくなります。そして、この減少の仕方は、対数スケールで見るとほぼ比例関係にあることが分かっています。つまり、パラメータの数やデータ量、計算資源などを10倍に増やすと、誤りは一定の割合で減るのです。例えば、誤りが半分に減るのに必要な規模の増加量が分かれば、さらに誤りを半分に減らすのに必要な増加量も同じだけだと予測できます。 この比例関係は、冪乗則と呼ばれています。冪乗則は、ある変数の変化が、他の変数の変化にどのように影響するかを表す法則で、人工知能の分野では特に重要な役割を果たします。スケーリング則は、この冪乗則を用いて表現されます。 スケーリング則を理解することで、より高性能な人工知能モデルを開発するために必要な資源を予測することができます。例えば、目標とする精度を達成するためには、どれだけのデータが必要か、どれだけの計算資源を用意すれば良いのかを、ある程度の精度で見積もることが可能になります。このため、スケーリング則は、人工知能研究において重要な指針となっています。近年、大規模言語モデルの開発が盛んですが、スケーリング則は、こうした巨大なモデルの設計や性能予測にも役立っています。 より多くのデータで、より大きなモデルを学習させることで、どこまで性能が向上するかを予測し、開発の指針とすることができます。
LLM

少ない例で賢く学習:Few-shot

近年の技術革新により、人工知能は目覚ましい発展を遂げてきました。この発展を支えているのが、膨大な量の情報を用いた学習です。まるで、多くの経験を積むことで賢くなる人間のように、人工知能も多くの情報を学習することで精度を高めていきます。しかし、現実には十分な量の情報を集めることが難しい、あるいは情報収集に多大な費用がかかるといった問題が存在します。 このような問題を解決する手段として、近年注目を集めているのが「少ない例」から学習する手法です。この手法は、限られた情報からでも一定の成果を得られるよう工夫されており、情報収集の手間を大幅に減らすことができます。従来の方法では、大量の情報を用いて人工知能を訓練しなければ高い精度は期待できませんでした。いわば、多くの経験を積まなければ一人前になれない職人のようなものです。しかし、この「少ない例」から学習する手法は、従来の方法とは全く異なるアプローチであり、少ない情報からでも高い精度を実現できる可能性を秘めています。 具体的には、既に学習済みのモデルをわずかな追加情報で微調整する方法や、少ない情報でも効率的に学習できる特別な仕組みを組み込む方法など、様々な工夫が凝らされています。まるで、熟練の職人が少しの手ほどきで新しい技術を習得するかのようです。このように、「少ない例」から学習する手法は、情報収集の負担を軽減しながら人工知能の性能向上を図る、画期的な技術として期待されています。今後の更なる発展により、様々な分野での応用が期待されます。
LLM

思考の連鎖でAI進化

思考の連鎖とは、人工知能、特に大規模言語モデルの性能を高めるための、新しい指示の出し方のことです。この指示の出し方は、まるで思考の鎖を繋げるように、段階的に推論を進めることで、最終的な解答を導き出すことを助けます。 従来の指示の出し方では、例題と解答をそのまま入力していました。たとえば、小学校の算数の問題で考えてみましょう。「みかんが3個、りんごが2個あります。全部で何個の果物がありますか?」という問題に対して、「5個」という解答を入力するだけです。 しかし、思考の連鎖では、例題と解答に加えて、解答に至るまでの思考過程も入力します。同じ例題で考えると、「みかんが3個あります。りんごが2個あります。3個と2個を足すと5個になります。全部で5個の果物があります。」のように、解答に至るまでの考え方を示すのです。これは、人間が問題を解く際に、頭の中で行う思考のステップを真似たものです。 このように、思考過程を具体的に示すことで、人工知能は問題の解き方をより深く理解できるようになります。そして、複雑な推論課題でも高い正しさで解答を導き出せるようになります。たとえば、文章の要約や翻訳、文章の作成といった、高度な言語処理の課題にも効果を発揮します。思考の連鎖は、人工知能がより人間のように考え、より複雑な問題を解決するための、重要な技術と言えるでしょう。
LLM

ゼロショット学習とは?仕組み・活用例・few-shotとの違いを解説

指示を与えるだけで望む結果が得られる、まるで魔法のような技術が人工知能の世界で注目を集めています。それが「ゼロショット学習」と呼ばれる革新的な手法です。これまでの機械学習では、ある課題を解決させるためには、その課題に特化した大量のデータを使って機械に学習させる必要がありました。例えば、猫を認識させるには、膨大な数の猫の画像を機械に見せて、それが猫であることを教え込む必要があったのです。しかし、ゼロショット学習では、このような事前の学習は一切不要です。まるで人間に指示を出すように、「猫の絵を描いて」と指示するだけで、機械は猫の絵を生成することができます。 これは、人間が初めて出会う課題に対しても、これまでの知識や経験を応用して解決策を見つけ出すことができるのと同じです。例えば、初めて自転車に乗る場合、自転車の仕組みや乗り方を具体的に教え込まなくても、これまでの経験からペダルを漕ぐ、バランスを取るといった動作を応用して乗ることができます。ゼロショット学習も同様に、事前に具体的な学習をしなくても、既に持っている知識を基に、指示された内容を理解し、結果を出力することができるのです。 この技術は、人工知能がより柔軟で人間に近い知能へと進化していく上で、非常に重要なステップと言えるでしょう。指示だけで様々な課題を解決できるようになれば、人工知能の活用範囲は飛躍的に広がり、私たちの生活はより便利で豊かなものになるでしょう。今まで、機械学習では大量のデータ収集と学習に膨大な時間と費用がかかっていましたが、ゼロショット学習によってこの手間が大幅に削減されることが期待されます。将来的には、より複雑な課題に対しても、ゼロショット学習で対応できるようになるでしょう。これは人工知能の発展における大きな前進であり、私たちの未来を大きく変える可能性を秘めていると言えるでしょう。
LLM

文脈内学習:その仕組みと利点

「文脈内学習」とは、人間が初めて出会う状況でも周りの様子から行動を決めるように、人工知能も与えられた情報だけから答えを導き出す学習方法です。たとえば、初めて入る飲食店で、周りの人がどのように注文するのかを観察して、同じように注文する場面を想像してみてください。あらかじめ注文方法を知らなくても、周りの人の行動から必要な情報を理解し、適切な注文ができます。これが文脈内学習です。 この学習方法は、特に「大規模言語モデル」と呼ばれる、大量の文章データから学習した人工知能で注目されています。大規模言語モデルは、少量の例文を示すだけで、新しい作業をこなせる可能性を秘めています。まるで、子供が周りの大人の振る舞いを見て言葉を覚えるように、人工知能も与えられた例文から学習し、新しい状況に対応できるのです。 従来の人工知能の学習方法は、大量のデータと、それに対する正解をセットで与える必要がありました。たとえば、画像に写っているものが「猫」であると人工知能に学習させるためには、大量の猫の画像を用意し、それぞれに「猫」というラベルを付けて学習させる必要がありました。しかし、文脈内学習では、このような大量のデータと正解のセットは必要ありません。 文脈内学習では、人工知能に「今日はいい天気ですね。明日は~でしょう」という文章を与え、続きを予測させることで、天気予報のような文章を生成させることができます。つまり、「明日は晴れでしょう」や「明日は雨でしょう」といった続きを予測させることで、天気予報の文章を生成する学習を、例文を少し示すだけで行えるのです。このように、文脈内学習は、少量のデータから効率的に学習できるため、今後の発展が期待されています。人工知能が、より人間の思考に近い学習方法で、様々な状況に対応できるようになるための、重要な一歩と言えるでしょう。
学習

ファインチューニング:AIモデルの性能向上

人工知能のモデル、特に近年注目を集めている大規模言語モデルは、膨大な量のデータを使って学習され、様々な作業をこなせる能力を身につけています。しかし、これらのモデルは汎用的な知識を備えている一方、特定の作業においては更なる精度向上が求められる場面も少なくありません。そこで登場するのが「磨き上げ」という表現がぴったりの「微調整」と呼ばれる技術です。 微調整とは、既に学習済みのモデルに、特定の作業に特化した追加の学習を施すことで、その作業における性能を向上させる手法です。例えるならば、様々な知識を既に習得している人が、特定の職業に必要な専門知識や技能を学ぶことで、その職業で活躍できるようになるのと似ています。一般的な学力を持つ人が、医師や弁護士、技術者など、特定の分野で活躍するために更なる学習を行うのと同じように、人工知能のモデルも特定の作業に特化するための追加学習が必要なのです。 微調整では、追加のデータを用いてモデルの内部にある無数の細かい設定値を調整することで、特定の作業に対する精度や効率を高めます。これは、職人が長年使い込んだ道具を、自分の手になじむように微調整し、より精緻な作業を可能にするのと似ています。あるいは、音楽家が楽器の音色を微調整することで、より美しい旋律を奏でられるようにするのと同様と言えるでしょう。 このように、微調整は、人工知能モデルを特定の目的に最適化し、その真価を最大限に引き出すための重要な工程と言えるでしょう。大量のデータを使って学習済みのモデルに、微調整を加えることで、そのモデルは特定の作業に秀でた、より専門性の高いものへと進化を遂げるのです。
LLM

事前学習:巨大言語モデルの土台

近ごろ、急速に発展している人工知能の分野で、巨大言語モデル(言語を扱うとても大きな人工知能)が大きな関心を集めています。まるで人間が書いたかのような自然な文章を作ったり、難しい質問に答えたりする能力は、私たちの暮らしや社会を大きく変える可能性を秘めていると言えるでしょう。この巨大言語モデルの驚くべき能力の土台となっているのが「事前学習」と呼ばれる過程です。この文章では、事前学習とは一体どのようなものなのか、その仕組みや大切さについて詳しく説明していきます。 事前学習とは、巨大言語モデルに大量の文章データを読み込ませ、言葉の繋がりや意味、文法などを学習させる過程のことです。人間が言葉を覚えるのと同じように、巨大言語モデルも膨大な量の文章データに触れることで、言葉の規則性やパターンを学習していきます。この学習を通して、単語の意味や文脈を理解し、自然で意味の通る文章を生成する能力を身につけるのです。まるで、赤ちゃんが周囲の言葉を聞いて言葉を覚えていく過程と似ています。 事前学習の方法はいくつかありますが、代表的なものに「自己教師あり学習」というものがあります。これは、入力された文章の一部を隠したり、順番を入れ替えたりすることで、モデルに隠された部分や正しい順番を予測させるという学習方法です。例えば、「今日は良い[マスク]です」という文章から[マスク]の部分を予測させることで、モデルは文脈から「天気」という言葉が当てはまることを学習します。このようにして、大量のデータから自動的に学習していくのです。事前学習は、巨大言語モデルが様々なタスクをこなせるようになるための基礎となる重要な段階と言えます。この事前学習をしっかりと行うことで、人間のように自然な文章を生成したり、質問に答えたり、翻訳したりといった高度な処理をこなせるようになるのです。まさに、巨大言語モデルの驚異的な能力の出発点と言えるでしょう。