学習
人間と共に進化するAI:RLHF入門
近ごろの技術革新によって、人工知能は目覚ましい発展を遂げ、様々な場所で活躍するようになりました。特に、人間の意見を学習に取り入れる方法である「人間からのフィードバックによる強化学習」、略して「強化学習HF」は、人工知能をより人間らしく、より実用的にするために欠かせない技術として注目されています。
従来の機械学習では、人間の持つ価値観や感覚を人工知能に反映させることは困難でした。例えば、文章の良し悪しを判断する際、文法的な正しさだけでなく、内容の面白さや表現の豊かさなども考慮する必要があります。しかし、これらの要素を数値化することは容易ではありませんでした。強化学習HFは、人間のフィードバックを直接学習に取り入れることで、この問題を解決する糸口となります。具体的には、人間が人工知能の出力結果を評価し、その評価に基づいて人工知能が学習を進めるという仕組みです。
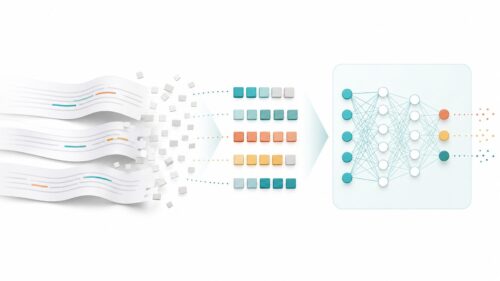
強化学習HFの仕組みは、大きく分けて三つの段階に分かれています。まず、初期段階の人工知能モデルを用意し、様々な課題を与えて出力結果を得ます。次に、人間がこれらの出力結果を評価し、良し悪しを判断します。そして最後に、人間の評価を基に、人工知能モデルが学習を行い、より良い出力結果を出せるように調整を行います。このサイクルを繰り返すことで、人工知能は次第に人間の価値観や感覚に沿った出力を生成できるようになります。
強化学習HFは、文章生成や翻訳、画像生成など、様々な分野で応用が期待されています。例えば、文章生成においては、より自然で人間らしい文章を作成することが可能になります。また、翻訳においては、より正確でニュアンスに富んだ翻訳が可能になります。さらに、画像生成においては、人間の感性に訴えかけるような、より創造的な画像を生成することが可能になります。このように、強化学習HFは、人工知能の未来を担う重要な技術と言えるでしょう。今後、更なる研究開発が進み、様々な分野で活用されることで、私たちの生活はより豊かで便利なものになることが期待されます。