

AIの初心者
「VALL-E」は、たった3秒の音声を手掛かりに、その人に似た声を作れるんですか?

AI専門家
そうだね。短い声の見本と読み上げたい文章を使って、話者に似た音声を生成する研究モデルなんだ。録音にない文章も読み上げることを目指しているよ。
AIの初心者
短い録音だけで、どうやって別の文章を読めるのでしょうか?
AI専門家
あらかじめ多くの音声を学んだモデルが、録音を声の見本として使うんだ。3秒だけで一から学ぶわけではないし、いつでも本人と同じ声になるとは限らないよ。
「たった3秒の音声で、その人の声を再現できる」と聞くと、録音さえあれば誰の声でも完全に複製できるように思えるかもしれません。VALL-Eは、短い音声を手掛かりに、話者に似た声で新しい文章を読み上げる音声合成の研究モデルです。ただし、3秒という数字は参照する音声の長さを指し、生成時間や再現の完全さを保証するものではありません。
この記事では、VALL-Eの仕組み、一般的な読み上げやボイスチェンジャーとの違い、活用が期待される場面、利用時の注意点を解説します。研究の特徴と将来の応用を分けて捉えると、音声AIでできることを判断しやすくなります。
VALL-Eとは?3秒の音声を手掛かりにする音声合成
VALL-Eは、Microsoftの研究による音声合成モデルです。読み上げたいテキストに加えて、声の見本となる短い録音を与え、その話者の特徴を反映した音声を生成することを目指しています。文章を音声に変える技術は、TTS(Text-to-Speech、テキスト読み上げ)と呼ばれます。
通常の読み上げでは、あらかじめ用意された声を選ぶ方法がよく使われます。一方、VALL-Eで注目されるのは、短い参照音声を使って、学習時に登場していない話者の声にも対応しようとする点です。特定の人の声質を再現する側面は、ボイスクローニングとも呼ばれます。
例えば、本人の同意を得て録音した短いあいさつを声の見本にし、別に用意した案内文を似た声で読み上げる、といった使い方が考えられます。元の録音に含まれていない文章を作れるため、録音をそのまま再生する仕組みとは異なります。ただし、声が似ていることと、本人がその内容を発言したことは別です。
「3秒で声を再現」の意味と誤解しやすい点
VALL-Eを理解するうえで大切なのは、3秒の録音の役割です。これは新しい話者の声を知るための手掛かりであり、モデルが言葉の発音や文章の読み方を最初から覚えるための全データではありません。音声を生成する能力は、あらかじめ多くの音声を使った学習によって身につけています。
例えば、「こんにちは。今日はいい天気ですね」という短い参照音声と、「明日の集合時刻は午前10時です」という原稿を与える場面を考えてみましょう。目標は、参照音声の話者に似た声で後者を読み上げることです。録音内の単語を切り貼りして文章を作るわけではありません。
| 混同しやすい点 | 押さえたい意味 |
|---|---|
| 3秒で処理が終わる | 3秒は参照音声の長さ。生成にかかる時間は別の話です。 |
| 3秒の録音だけでAIを一から学習させる | 事前に学習したモデルが、短い録音を生成の手掛かりにします。 |
| どんな録音でも本人と同じ声になる | 録音の状態、話し方、読み上げる内容などによって結果が変わります。 |
| どんな言語や歌声にもそのまま使える | 対応言語、翻訳、歌唱は、それぞれ確認が必要な別の論点です。 |
特定の話者に合わせた長時間の録音や追加学習を減らせる可能性は、大きな利点です。一方で、参照音声の準備や出力の確認まで不要になるわけではありません。「調整不要」という表現だけで理解せず、モデルの追加学習と、制作時の品質調整を分けて考える必要があります。
VALL-Eの仕組みを入力から出力まで理解する
VALL-Eの特徴は、音声を細かな単位に符号化し、その並びを予測して生成する考え方にあります。この単位を音響トークンと呼びます。ここでのトークンは文字や単語そのものではなく、圧縮された音の特徴を表す符号です。
- 音声と言葉の関係を事前に学ぶ:多くの音声と対応するテキストから、発音や音のつながり、さまざまな声の特徴を学習します。
- 参照音声を符号に変える:ニューラル音声コーデックという、音声を圧縮・復元する仕組みで、声の見本を音響トークンの列として扱います。
- 新しい文章に対応する符号を生成する:読み上げるテキストと参照音声を手掛かりに、次に必要となる音響トークンを予測します。
- 符号を聞こえる音に戻す:生成したトークンの列を音声に復元し、新しい読み上げ音声として出力します。
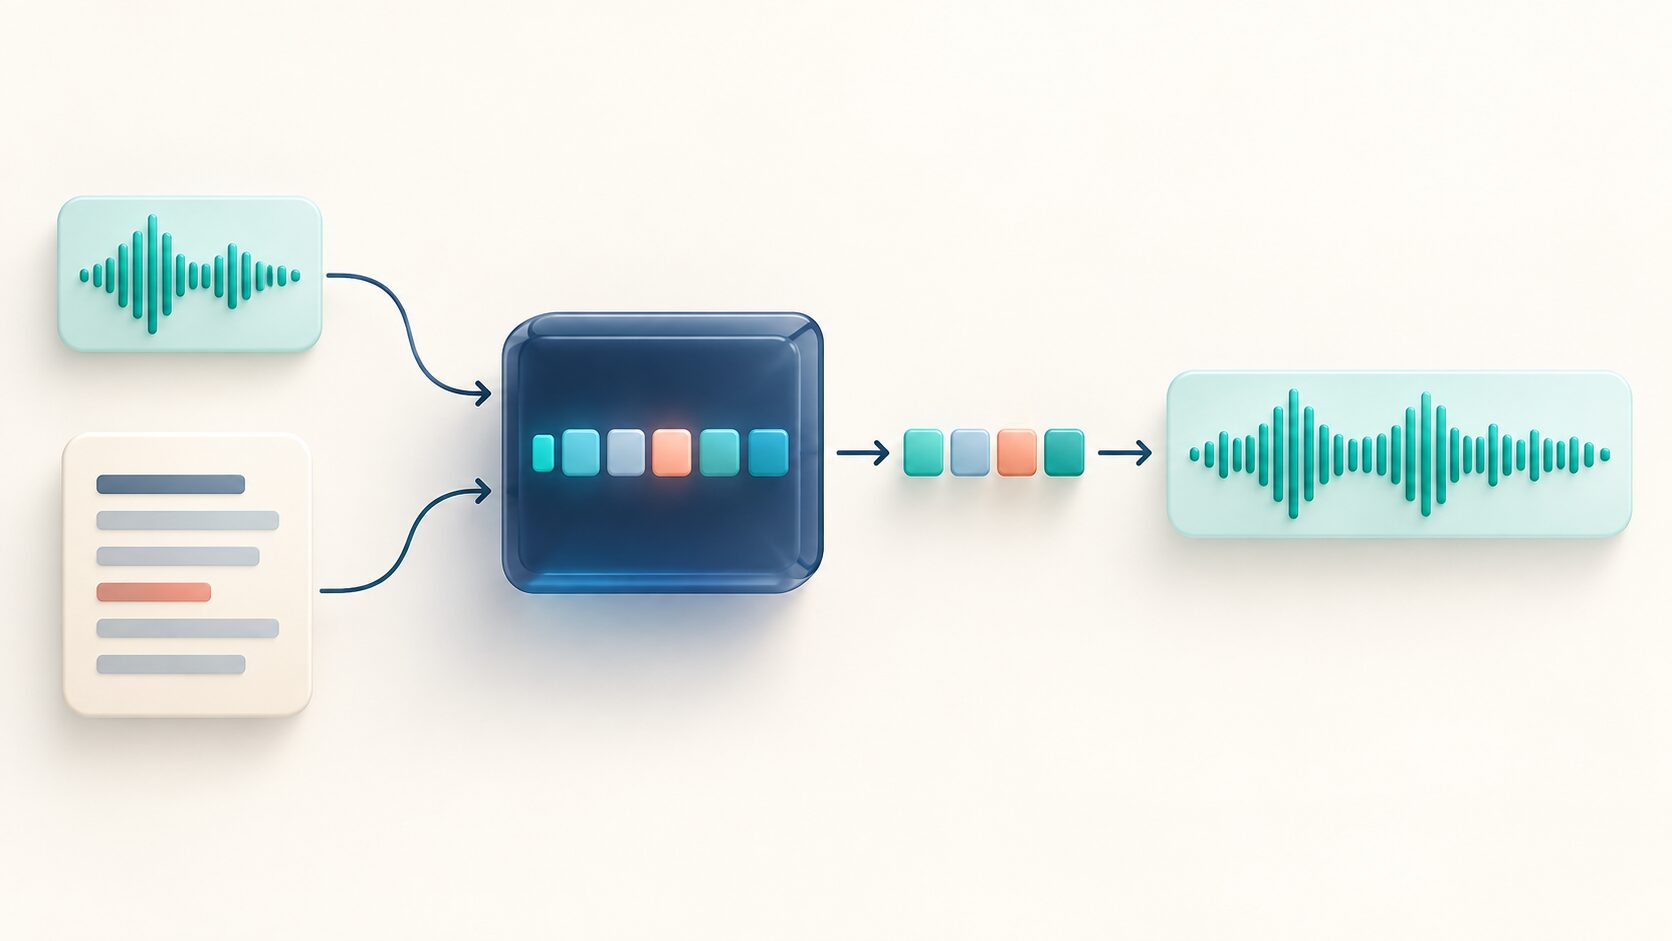
見方を変えると、文章の続きを予測する言語モデルに近い発想を、音声の符号列へ広げた仕組みです。ただし、音には発音内容だけでなく、声色やリズムなども含まれます。そのため、正しい文章を読むことと、話者らしい声を作ることを両立させる必要があります。
新しい話者ごとにモデルを追加学習させず、見本を与えて対応する考え方は「ゼロショット」と呼ばれます。ゼロショットは、学習も見本も不要という意味ではありません。VALL-Eでは、事前学習した能力を、短い参照音声を条件として使う点が重要です。この違いを押さえると、「3秒だけで全部を学ぶ」という誤解を避けられます。
通常の読み上げ・ボイスチェンジャーとの違い
音声AIのサービスを調べると、音声合成、ボイスクローニング、音声変換といった似た言葉が出てきます。違いを見分けるには、「何を入力し、何を変えたいのか」に注目すると分かりやすくなります。
| 技術・方法 | 主な入力 | 目的とVALL-Eとの関係 |
|---|---|---|
| 一般的なテキスト読み上げ(TTS) | テキスト、使用する声の指定 | 文字を音声にします。VALL-EもTTSの一種で、短い声の見本を利用する点に特徴があります。 |
| ボイスクローニング | 再現したい話者の音声など | 特定の人に似た声を作ることを指します。VALL-Eはこの目的につながる音声合成モデルです。 |
| ボイスチェンジャー・音声変換 | すでに話した音声 | 発話の声質や高さなどを変えます。テキストから新たな発話を作る場合とは入力が異なります。 |
| 録音の再生・編集 | 収録済みの音声 | 実際に録音した声を使います。未収録の原稿を自由に読むには、追加収録などが必要です。 |
例えば、既存の説明文を好きな声で読ませたいならTTS、録音した自分の発話の声質を変えたいなら音声変換、特定の話者らしさを引き継ぎたいならボイスクローニングが検討対象になります。実際の製品では複数の機能が組み合わされるため、名前だけでなく入力と出力を確認しましょう。
なお、従来の音声合成をすべて「長時間の録音が必須」「機械的な声しか出せない」とまとめるのは適切ではありません。必要なデータや自然さは方式によって異なります。VALL-Eの特徴は、短い参照音声を条件にした生成という観点から比較すると捉えやすくなります。
声色・抑揚・感情はどこまで再現できる?
声の再現性を考えるときは、声色、抑揚、読み上げ内容の正確さを分けて見ることが大切です。声色は「誰の声に聞こえるか」、抑揚は「どのように話しているか」に関わります。声の質感が似ていても、アクセントや間の取り方が不自然なら、本人らしさは弱く感じられるでしょう。
VALL-Eでは、参照音声にある話者の特徴に加え、感情的な調子や録音環境の特徴が出力に反映される可能性があります。ただし、参照音声の調子を引き継ぐことと、文章の意味から適切な感情を理解して自由に演じ分けることは同じではありません。「うれしい文章なら必ず明るく、悲しい文章なら必ず悲しげに読む」とは限りません。
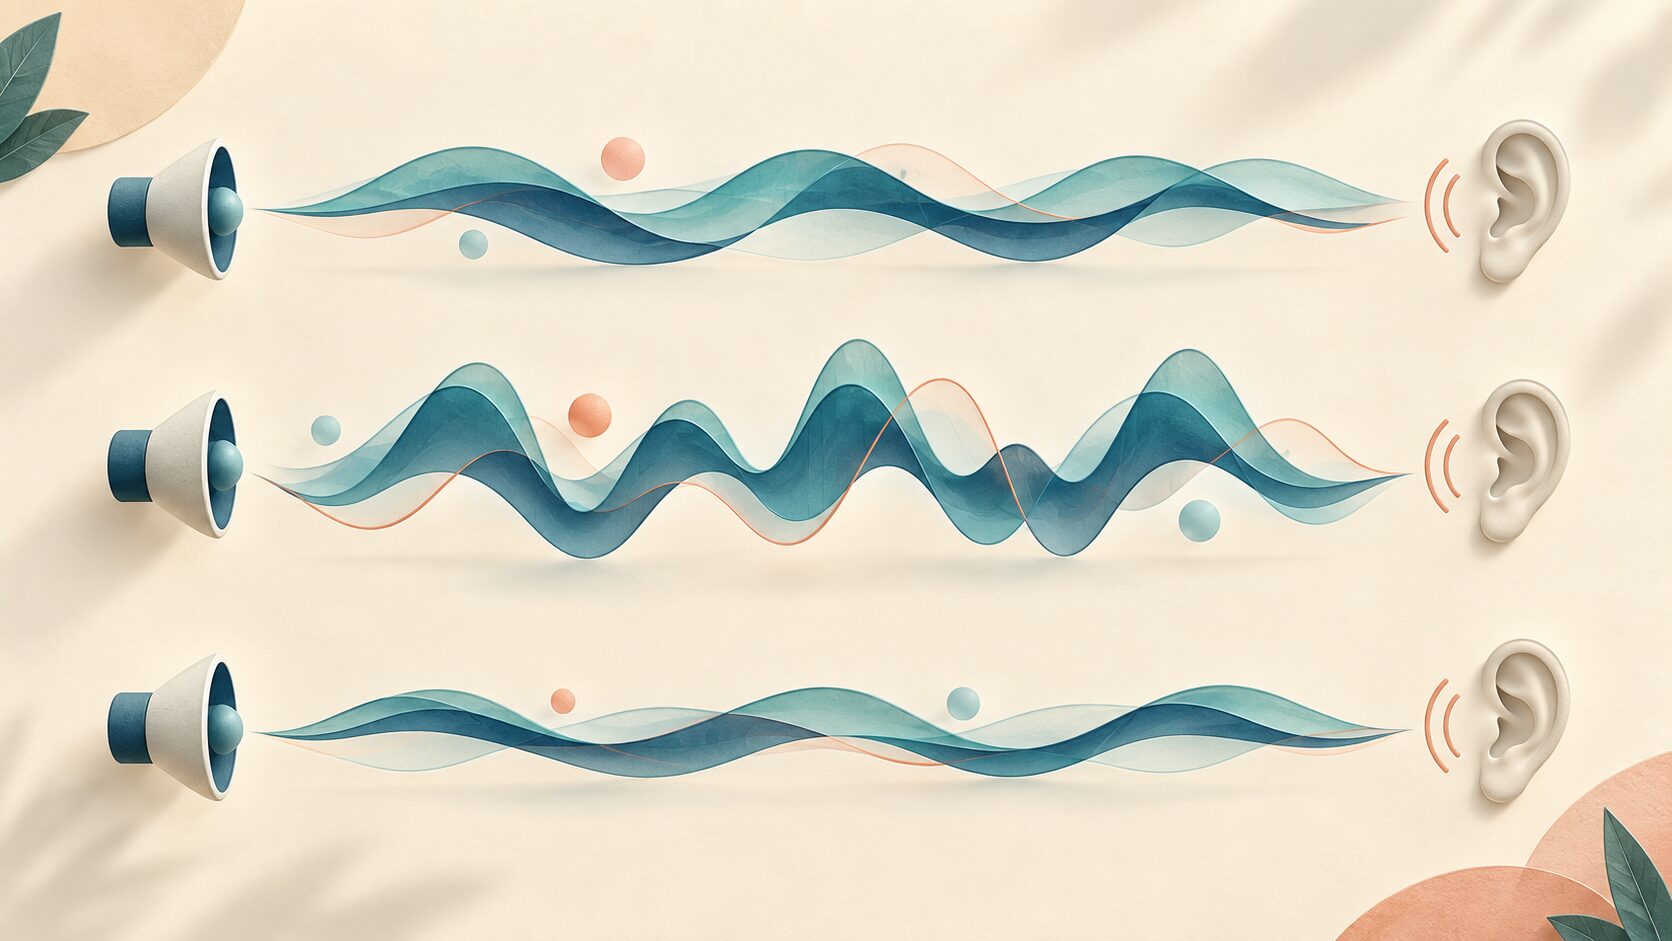
例えば、落ち着いた説明用の録音を見本にした場合、活発なキャラクターの台詞に求められる演技まで得られるとは限りません。逆に、録音に反響や雑音が含まれていると、欲しい声質だけでなく、不要な音の特徴も影響する可能性があります。見本の選び方も結果を左右する要素です。
- 話者の類似性:声の高さや質感が、目標とする話者にどの程度似ているか。
- 内容の正確性:単語、数字、固有名詞の読み間違いや、読み飛ばしがないか。
- 音声の自然さ:間、アクセント、速度、文末の調子に違和感がないか。
- 用途への適合:教材、案内、演技など、その場面に合う表現になっているか。
似ている声ができたという理由だけで完成とせず、原稿と聞き比べながら確認することが実務では欠かせません。特に数字や名称を伝える案内では、声の印象より読み上げ内容の正確さを優先する必要があります。
活用が期待される分野と具体例
短い音声から話者の特徴を引き継げる技術には、収録や編集の負担を減らす可能性があります。以下はVALL-Eのような音声合成技術から考えられる応用例です。各用途でVALL-Eがそのまま導入できることや、実用性が確認済みであることを意味するものではありません。
| 分野 | 具体的な使いどころ | 期待される利点と確認点 |
|---|---|---|
| 映像・娯楽 | 動画のナレーション、ゲームやアニメの台詞の試作 | 原稿変更に応じた音声制作を助けます。声の利用許諾、演技の品質、最終的な監修が必要です。 |
| 教育・学習 | 教材の読み上げ、語学の音声教材 | 文字と音を組み合わせた学習を支援できます。専門語の読みや発音、対象言語への対応を確認します。 |
| 情報アクセス | 文章を音声で確認したい人に向けた読み上げ | 視覚に頼らず情報を得る選択肢になります。聞き取りやすさや再生操作も重要です。 |
| 仕事・顧客対応 | 研修資料、発表資料、定型的な音声案内 | 再録音の負担軽減が期待できます。日付・金額などの読み違いを確認し、内容の責任者を決めます。 |
| コミュニケーション支援 | 発声が難しい人が、入力した文章を本人に近い声で伝える仕組み | 自分らしい声で伝える可能性につながります。本人が無理なく使える入力方法と意思の確認が大切です。 |
例えば、社内研修の説明を音声化するとき、原稿の一部を変更するたびに全体を録音し直す負担を減らせるかもしれません。ただし、音声を作る機能だけで教材が完成するわけではなく、原稿の確認、聞き取りやすさの調整、利用許諾の管理などが残ります。
元記事で挙げていた映画の吹き替え、多言語の顧客対応、バーチャルアイドルの歌声には、それぞれ追加の論点があります。吹き替えには翻訳や映像との同期、対話には回答内容を作る仕組み、歌声には旋律や歌唱表現への対応が必要です。音声合成ができることを、これらすべての機能が備わっていることと混同しないようにしましょう。
また、音声で伝える支援と、言葉を理解したり文章を組み立てたりする支援も別です。元記事にあった失語症への言及を含め、コミュニケーション上の困りごとは一様ではありません。声の再現だけで解決できると考えず、使う人の状況に合った仕組みを検討することが大切です。
VALL-Eの使い方を調べる前に確認したいこと
VALL-Eという研究モデルの名称と、誰でも利用できる音声合成サービスは区別して調べる必要があります。研究の紹介や音声デモがあることだけでは、一般向けの利用画面、API、モデルの配布、商用利用の許可が提供されているとは判断できません。本記事では、現行の提供状況を前提とした登録手順や操作方法は扱いません。
実際に音声生成を試す場合は、利用しようとしているサービスについて、次の点を確認します。特に「VALL-E」を名乗るページを見つけた場合も、名称だけで研究元との関係や機能を判断しないようにしましょう。
- 提供元と機能:誰が提供しているのか、テキスト読み上げ・声の複製・音声変換のどれに対応するのか。
- 対応言語:日本語を入力できるかだけでなく、日本語の発音やアクセントを適切に生成できるか。
- 参照音声の条件:必要な長さ、ファイル形式、録音品質、本人確認の方法は何か。
- 利用条件:生成音声をどの用途で使えるか、公開・商用利用・再配布などに条件があるか。
- データの扱い:録音がどこに保存されるか、学習に使われるか、削除や利用停止が可能か。
技術の基本を学ぶなら、「自分が何を入力し、どのような音声を得たいのか」を先に決めると比較しやすくなります。検証用の原稿には、短い説明文だけでなく、数字や固有名詞、質問文なども含めると、声の似方だけでは分からない得意・不得意を確認できます。
ボイスクローニングの倫理的課題と安全な運用
本人に似た音声は便利である一方、本人が話していない内容を発言したように見せることにも使えてしまいます。問題になるのは、なりすましや詐欺、偽情報の拡散、本人の評判を損なう発言の捏造などです。声が本人に似ているという印象だけで、発言の真偽を判断できるとは限りません。
音声を作る側は、録音を手に入れたことと、その声を自由に使ってよいことを分けて考える必要があります。例えば、会議への参加に同意していても、録音を別の商品の宣伝音声に使うことまで同意しているとは限りません。用途、公開範囲、利用期間、再利用の可否を本人と確認する運用が重要です。
| 課題 | 運用で考えたい対策 |
|---|---|
| 無断での声の利用 | 本人の同意を確認し、用途・期間・公開範囲を記録します。別用途に広げるときは改めて確認します。 |
| 合成音声と実際の発言の混同 | AIで生成した音声であることを説明し、元の原稿や生成の記録を残します。 |
| 録音データの漏えい・転用 | 保存先、閲覧権限、保管期間を決め、必要以上の収集や共有を避けます。 |
| なりすましによる指示 | 金銭や重要情報に関わる連絡は、声だけで判断せず、既知の連絡先など別の経路で確認します。 |
| 声を仕事にする人への影響 | 再利用の範囲、対価、修正や監修への関与を取り決め、制作工程での役割を確認します。 |
技術面では、合成音声に識別の手掛かりを付けること、利用者確認やアクセス制限を行うことなどが対策として考えられます。ただし、表示や検出技術だけですべての悪用を防げると期待せず、同意の管理や出所の記録と組み合わせることが大切です。これらは望ましい対策の例であり、VALL-Eに標準搭載されている機能の一覧ではありません。
アナウンサー、声優、ナレーター、コールセンターなどへの影響も、単純に「仕事がなくなる」と決めつけずに考える必要があります。収録の一部が効率化する一方で、演出、確認、権利管理といった作業の比重が変わる可能性があります。技術を導入する側と声を提供する側が、役割と条件を共有することが重要になります。
今後の課題とVALL-Eから学べること
VALL-Eが示すのは、十分に学習したモデルに短い見本を与えることで、新しい話者に合わせた生成を目指せるという方向性です。必要な録音量を減らせれば、音声コンテンツの制作や個人に合わせた読み上げの選択肢が広がります。
一方、実用性を判断するには、声の類似性だけでなく、長文でも安定して読めるか、固有名詞を正確に発音できるか、用途に合った抑揚を保てるかといった点を見る必要があります。言語や録音条件が変わった場合の性能、生成に必要な時間や計算資源も重要です。これらは研究上の成果をサービスへつなげる際の課題になります。
さらに、音声の自然さが高まるほど、本人の同意や合成音声であることの説明も重要になります。品質の向上と安全な運用を一緒に考えることが、VALL-Eのような技術を評価するうえで欠かせない視点です。
まとめ
VALL-Eは、短い参照音声を手掛かりに、話者に似た声で新しい文章を読み上げる音声合成の研究モデルです。「3秒」は声の見本の長さであり、事前学習が不要になることや、完全な再現を意味するものではありません。
仕組みを理解するときは、テキスト、参照音声、音響トークン、生成音声の流れを押さえましょう。活用を考えるときは、声の似方と読み上げの正確さを別々に確かめ、対応言語や利用条件、本人の同意を確認することが大切です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年9月27日 | 3秒の意味と生成の仕組みを補い、感情表現の限界や声の利用同意を追記 |