

AIの初心者
「テンソルフロー」ってよく聞くのですが、どんなことができるものですか?

AI専門家
TensorFlowは、データからパターンを学ぶ機械学習モデルを作るための道具だよ。たとえば、写真を見て犬と猫を見分ける仕組みを開発できるんだ。
AIの初心者
完成したAIを使うのではなく、AIの仕組みを作るための道具なんですね。初心者でも使えますか?
AI専門家
使えるよ。TensorFlow自体は無料で公開されているんだ。Pythonの基礎とデータの扱い方を学び、小さなモデルを動かすところから始めると理解しやすいよ。
TensorFlow(テンソルフロー)は、機械学習モデルの構築・学習・実行を支えるオープンソースのライブラリです。画像認識や文章の分類、将来の数値の予測などを行うプログラムを作るときに利用できます。
ただし、導入するだけでAIが完成するわけではありません。何を予測するかを決め、データを整え、学習結果を確かめる必要があります。この記事では、TensorFlowの仕組みと用途、Kerasなどの関連ツールとの違い、初心者の学習手順を順に解説します。
TensorFlowとは?機械学習モデルを作るためのライブラリ
TensorFlowは、Googleが開発・公開した機械学習のためのソフトウェアです。数値計算、モデルの組み立て、学習に必要な微分計算などの機能を備えています。開発者はこれらを組み合わせることで、基礎的な計算処理をすべて自作せずにモデルを開発できます。
ここでいうモデルとは、入力データを受け取り、予測や分類の結果を出す計算の仕組みです。たとえば、写真を入力すると犬か猫かを判定するモデルや、過去の売上から次の期間の売上を予測するモデルが考えられます。TensorFlowは、その計算方法を表現し、データを使って調整するための道具です。
関連する言葉の関係も押さえておきましょう。人工知能(AI)は、認識や判断などの知的な処理をコンピューターで実現する技術の広い呼び名です。機械学習はその中でもデータから規則性を学ぶ方法で、深層学習(ディープラーニング)は、多層のニューラルネットワークを使う機械学習の一分野です。
ニューラルネットワークは、神経細胞のつながりから着想を得た計算モデルですが、人間の脳そのものを再現するわけではありません。数値を受け渡す層を重ね、層の間にある重みなどを調整して、目的に合う出力を得ます。TensorFlowはこの構築を得意としつつ、一般的なテンソルの計算にも使えます。
また、TensorFlow自体を無料で利用できることと、開発や運用に費用がかからないことは別です。データの収集・整理、クラウドの計算資源、保存先などには費用が発生する場合があります。最初は小さな教材データと手元の実行環境で、計算の流れを体験するとよいでしょう。
テンソルと計算グラフの仕組み
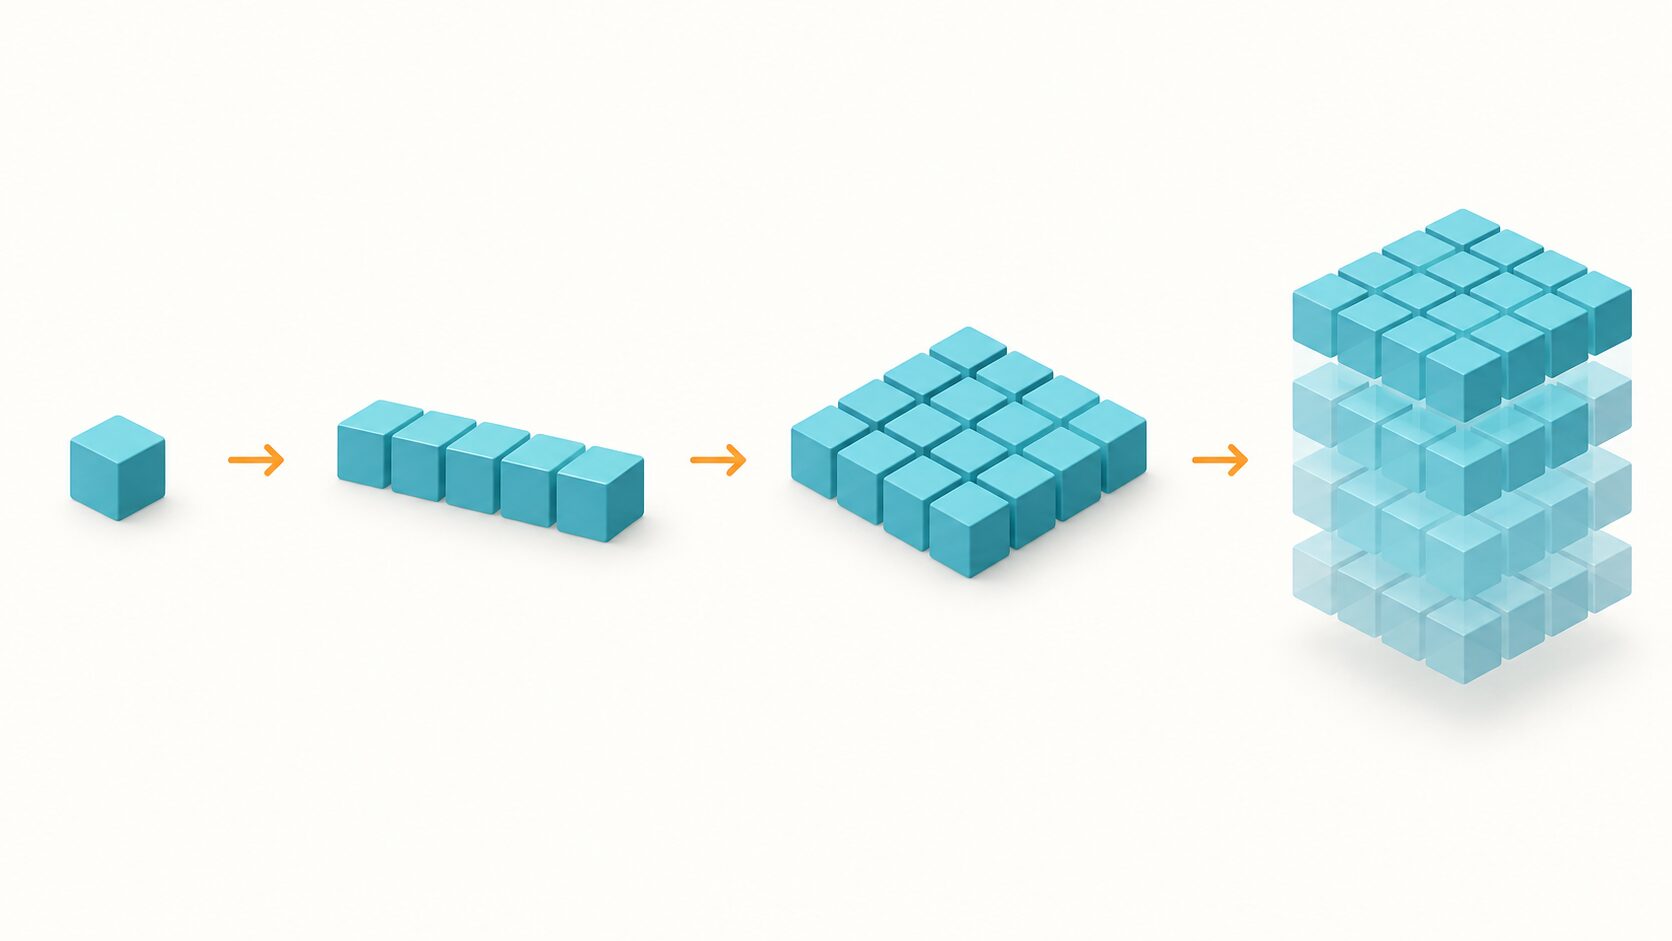
TensorFlowを理解する鍵は、データを表す「テンソル」と、処理のつながりを表す「計算グラフ」です。機械学習の文脈では、テンソルを数値を一定の形に並べた多次元配列と考えると理解しやすくなります。画像や音声、文章も、モデルが扱える数値の集まりに変換して入力します。
| 配列の形 | イメージ | データの例 |
|---|---|---|
| スカラー(0次元) | 一つの値 | ある時点の気温 |
| ベクトル(1次元) | 値を一列に並べる | 1週間分の気温 |
| 行列(2次元) | 値を行と列に並べる | 縦と横に画素が並ぶ白黒画像 |
| 3次元以上の配列 | 行と列に、色や枚数などの軸を加える | カラー画像、複数画像をまとめたデータ |
たとえば、縦28画素・横28画素の白黒画像1枚は、明るさの値を28行28列に並べて表せます。カラー画像では色の成分を表す軸が加わり、複数枚をまとめると枚数の軸も加わります。このように各軸の大きさを示すものが「形状(shape)」です。一度に処理するデータのまとまりは「バッチ」と呼びます。画像の扱い方によっては、白黒画像でも色成分の軸を明示します。
計算グラフでは、足し算や行列の掛け算などの演算を「ノード」、演算の間を流れるテンソルをつなぐ線を「エッジ」で表します。グラフは売上の折れ線グラフのような図ではなく、どの計算結果を次の処理に渡すかを表す構造です。処理の依存関係が明らかになるため、実行方法の最適化や処理の再利用に役立ちます。
ただし、「TensorFlowでは必ず先にグラフ全体を定義しなければならない」と覚える必要はありません。TensorFlow 2系では、通常は演算をその場で実行する「Eager execution」を使い、Pythonの処理として結果を確認できます。必要に応じてtf.functionで関数をグラフとして実行する仕組みも使えます。
初心者はまず、入力の形状と途中の計算結果を確認することに慣れましょう。グラフ化による効率化は、その後に学んでもかまいません。どのような計算でもグラフ化すれば速くなるわけではなく、処理内容や入力の形状にも左右されます。
学習から推論までの流れ
TensorFlowでモデルを学習させるときは、予測と正解のずれを使って、重みなどの「パラメータ」を少しずつ調整します。犬と猫を見分ける分類モデルを例にすると、基本的な流れは次のとおりです。
- データを用意して整える。犬・猫の画像と、正解を示すラベルを用意します。画像の大きさや画素値の範囲をそろえ、モデルが受け取れるテンソルに変換します。
- モデルに予測させる。画像を入力し、犬と猫のどちらに該当しそうかを出力させます。初期状態では重みが十分に調整されていないため、間違いも生じます。
- 予測のずれを測る。予測と正解ラベルを比べ、ずれの大きさを「損失」という数値で表します。損失関数は、その計算方法を定めるものです。
- 重みを更新する。自動微分で、重みを動かすと損失がどちらに変わるかを調べます。最適化アルゴリズムが、その情報を使って損失を小さくする方向へ重みを調整します。
- 繰り返して性能を確かめる。バッチごとに学習を進め、学習用データ全体を一巡する単位を「エポック」と呼びます。別に確保したデータでも予測がうまくいくかを確認します。
ニューラルネットワークでは、出力側から入力側へと微分の情報を伝える「誤差逆伝播法」が重みの調整を支えます。TensorFlowの自動微分機能を使うことで、開発者が重みごとの微分式を手作業で書く負担を減らせます。ただし、データに合うモデルや損失関数、更新方法は選ぶ必要があります。
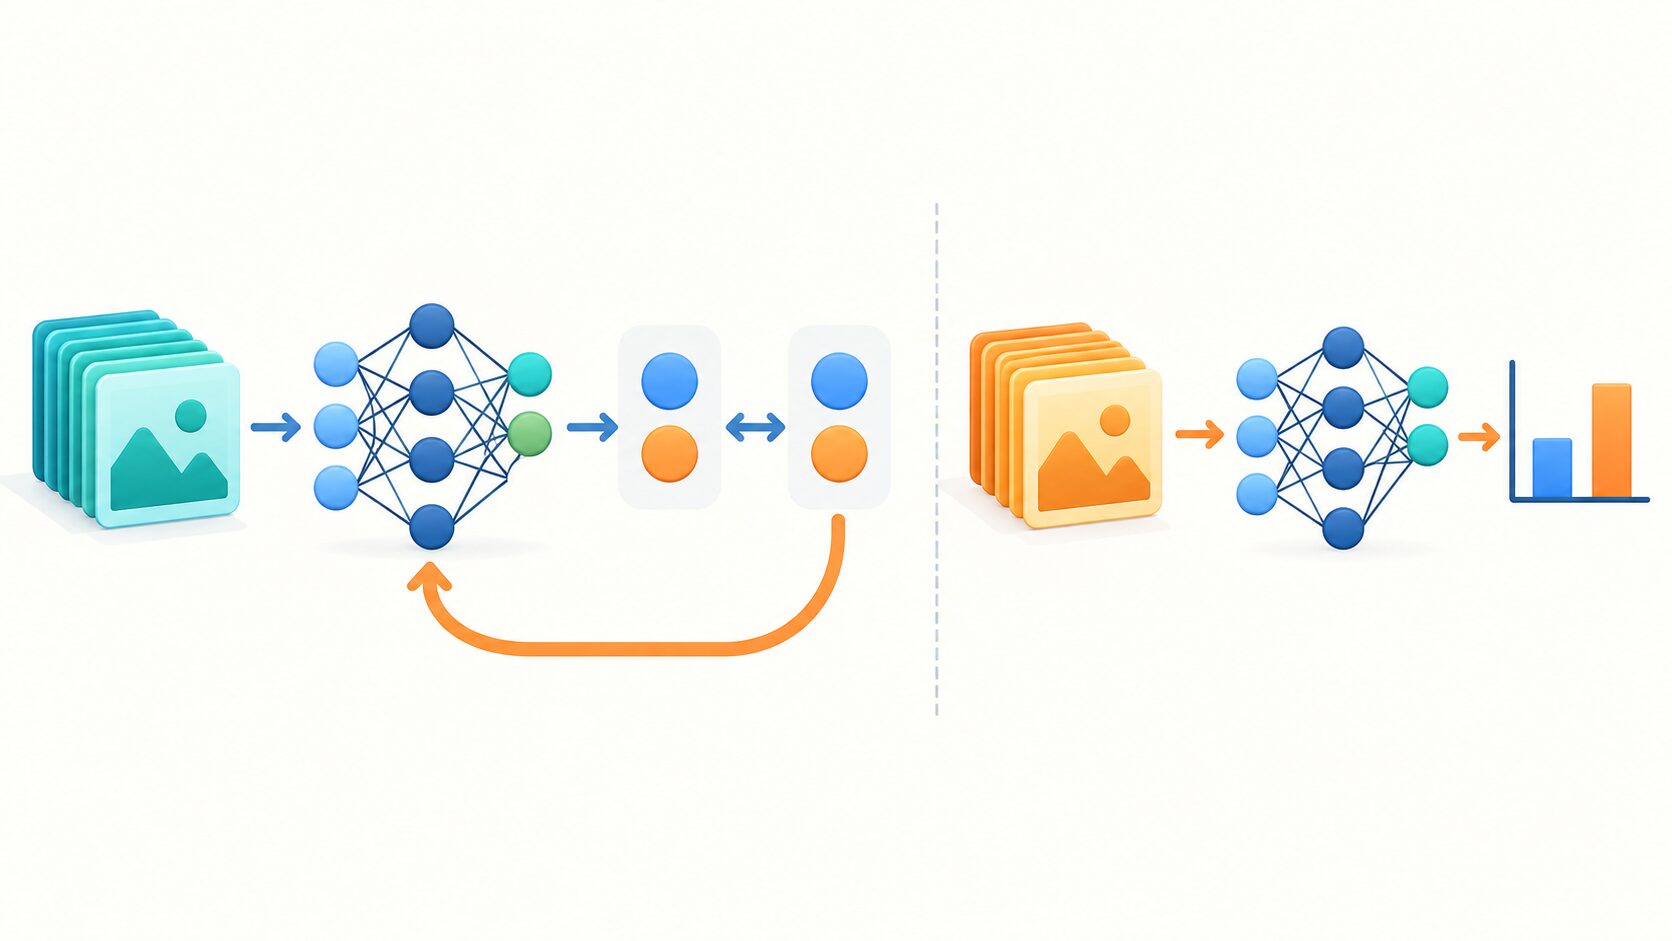
評価では、訓練データ・検証データ・テストデータの役割を分けることが大切です。訓練データは重みの更新に使い、検証データはモデルの構成や学習回数を選ぶ判断材料にします。テストデータは、調整が終わったモデルの最終的な性能を確かめるために取っておきます。
見たことのある画像を当てられても、新しい画像を当てられるとは限りません。未知のデータにも対応できる能力を「汎化」と呼びます。同じ写真の複製が訓練用とテスト用の両方に入ると、汎化性能を実際より高く見積もる原因になります。
学習したモデルに新しい画像を渡し、結果を得る処理が「推論」です。通常の推論では、学習で決めた重みを使い、正解ラベルは必要ありません。学習は重みを調整する工程、推論は調整したモデルを利用する工程、と区別すると整理できます。
TensorFlowとKeras・PyTorch・scikit-learnの違い
機械学習を調べると、TensorFlowと一緒にKeras、PyTorch、scikit-learnという名前が出てきます。どれも開発を助けるソフトウェアですが、役割や使うときの見通しは同じではありません。
| 名前 | 主な役割 | 初心者が押さえたい点 |
|---|---|---|
| TensorFlow | テンソル計算、自動微分、モデルの学習・実行を支える | 計算の基盤からモデルの利用までを扱う道具 |
| Keras | 層を組み合わせ、モデルの構築や学習を簡潔に記述する | TensorFlowを利用する際の高水準APIとして使える |
| PyTorch | テンソル計算や自動微分を通じてモデル開発を支える | TensorFlowと同様に深層学習に使える別のフレームワーク |
| scikit-learn | 回帰・分類・クラスタリングや前処理、評価を支える | 表形式データなどで基本的な機械学習モデルを試す選択肢 |
Kerasは、モデルを扱いやすい形で記述するための窓口と考えるとよいでしょう。TensorFlowの教材で見かけるtf.kerasは、層や学習処理などを利用するためのAPIです。低水準の演算を一つずつ書くより少ない記述でモデルを組み立てられます。
ただし、Kerasという名称が常にTensorFlow専用を意味するわけではありません。複数の計算基盤に対応するKerasもあるため、教材がtf.kerasと単独のkerasのどちらを前提にしているかを確認しましょう。異なる教材の導入手順や記述を、前提を確かめずに混ぜるとエラーの原因になります。
TensorFlowとPyTorchについては、単純にどちらが優れているかではなく、学びたい教材、既存のコード、モデルを動かす先などから選びます。また、売上や顧客属性のような表形式データを扱うなら、まずscikit-learnで単純な回帰や分類を試し、比較の基準を作る方法もあります。すべての課題に深層学習が必要なわけではありません。
TensorFlowの利点とCPU・GPUの使い分け
TensorFlowの利点は、機械学習に必要な部品を再利用できることです。層、損失関数、最適化アルゴリズムなどを組み合わせて試せるため、計算の実装だけに時間をかけず、データやモデルの改善に取り組みやすくなります。公開されたソースコードや教材を参照できることも、学習と開発の助けになります。
入門ではPythonを使うと、データの加工から学習結果の確認まで進めやすくなります。C++から利用する仕組みもありますが、対応する機能や開発の手順がPythonとすべて同じというわけではありません。初心者は一つの言語・一つの教材で基本を身につけ、既存システムへの組み込みなどが必要になってから他の選択肢を検討すると負担を抑えられます。
計算資源としては、さまざまな処理を担うCPUに加え、大量の似た演算を並列に処理するGPUを使える点が特徴です。TPUのような、機械学習向けに設計された計算装置を利用する構成もあります。ただし、対応環境の準備や、実行する処理との適合が必要です。
| 計算資源 | 特徴 | 検討する場面 |
|---|---|---|
| CPU | 汎用的な処理を担い、手元の環境で始めやすい | 小さな教材、前処理、動作確認 |
| GPU | 大量の並列演算に適するが、メモリ容量や対応環境に制約がある | 画像などを扱う、計算量の多いモデルの学習 |
| TPU | 機械学習の特定の計算を効率よく処理するための装置 | 対応する実行環境とモデルで、大規模な計算を行う場合 |
GPUを使うことと、予測精度が上がることは別です。GPUは主に計算時間の短縮を助けるもので、データの偏りやモデルの設計を自動で解決するわけではありません。小さな処理では、データ転送などの負担により高速化しないこともあります。まずCPUなどで正しく動くことを確かめ、時間やメモリが課題になった段階で計算資源を見直しましょう。
TensorFlowでできることと主な活用例
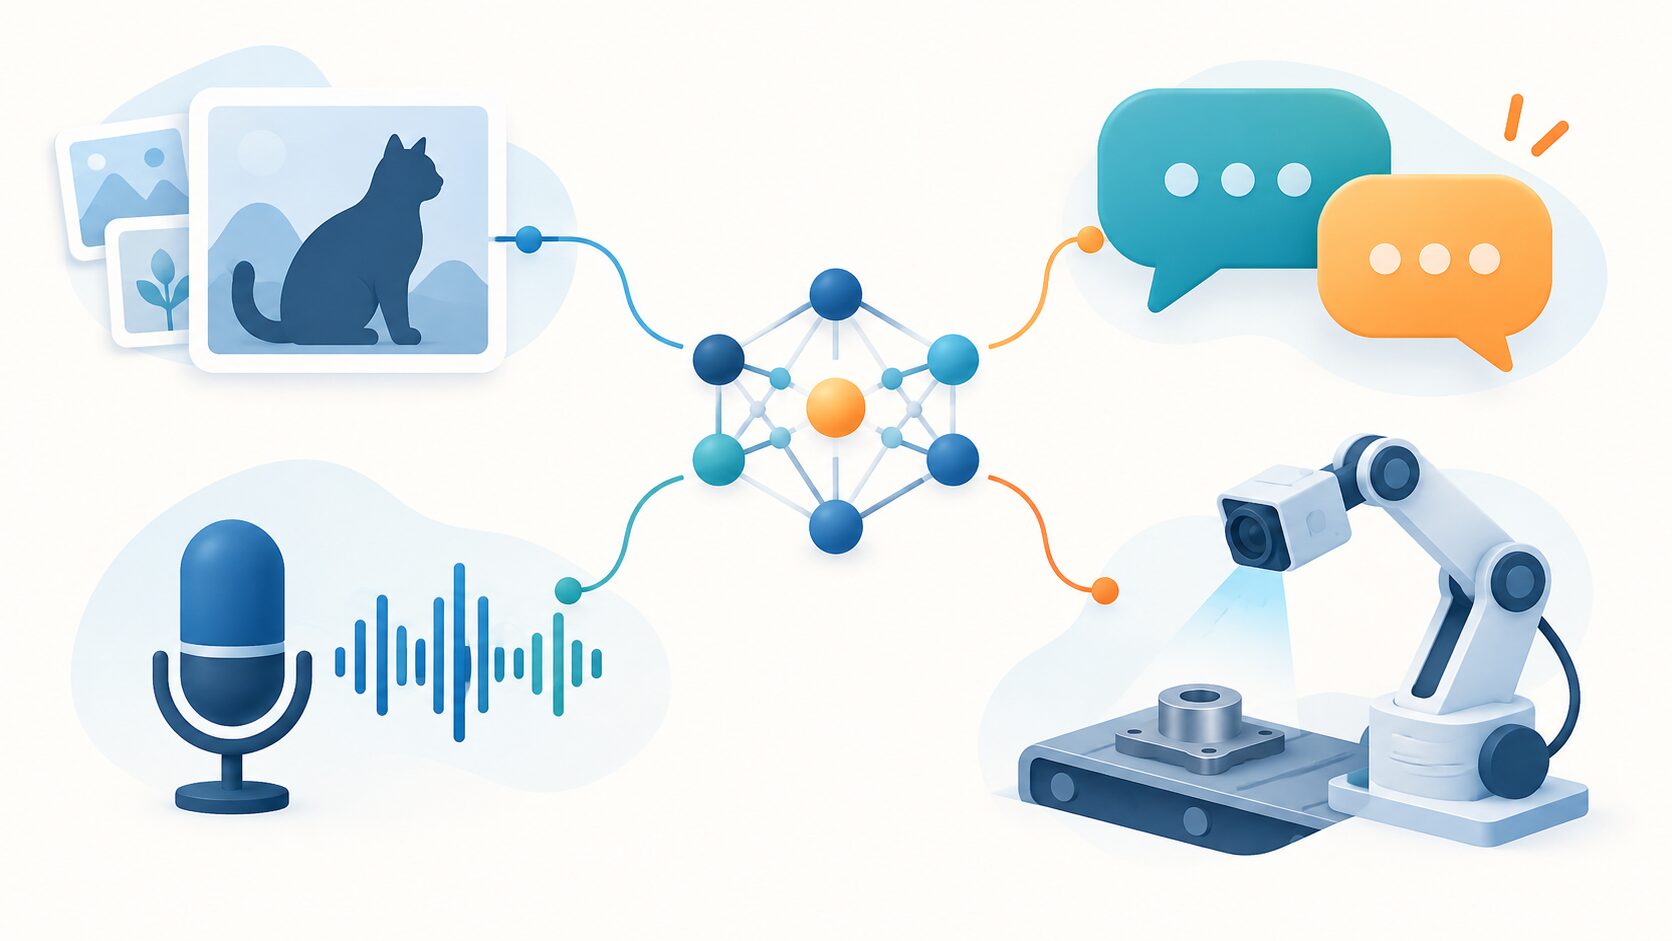
TensorFlowは、数値に変換したデータから規則性を学ぶ課題に利用できます。入力と出力を具体的に考えると、使いどころをつかみやすくなります。以下は開発できる仕組みの例であり、特定の製品がTensorFlowを採用していることを示すものではありません。
| 分野 | 入力と処理の例 | 開発時に考えること |
|---|---|---|
| 画像認識 | 犬猫の分類、製品の外観検査、顔画像の特徴の照合 | 明るさや撮影角度が変わっても使えるかを確認する |
| 自然言語処理 | レビューの感情分類、文章の翻訳・要約 | 文章を数値表現に変換し、文脈に合う出力かを評価する |
| 音声認識 | 音声から発話内容や音の種類を推定する | 雑音、話し方、録音環境の違いを考慮する |
| 予測・推薦 | 売上や気象関連の数値の予測、購買履歴に基づく商品推薦 | 時間の前後関係や、利用者・商品の偏りを点検する |
| 医療・創薬研究 | 画像の分析による診断支援、化合物の特徴から性質を予測する研究 | 専門家による検証や、利用目的に応じた厳格な評価が必要 |
| 自動運転・ロボット | 周囲の物体の認識、動作に必要な状態の推定 | 認識モデル以外に制御・安全設計・実環境での検証を組み合わせる |
たとえば、商品のレビューを「好意的・否定的」に分けるモデルなら、文章と正解の分類を学習データとして用意します。工場の外観検査なら、正常な製品と不良品の画像をそろえ、見逃したくない不良を検出できるかを確かめます。同じ分類でも、必要なデータや失敗したときの影響は異なります。
翻訳や要約のような複雑な課題では、大きなモデルや学習済みモデルの利用も検討します。既に学習されたモデルを別の課題に活かす方法は「転移学習」と呼ばれ、ゼロからの学習に比べてデータや計算量を抑えられる場合があります。ただし、利用条件や元の学習対象、手元のデータとの違いは確認が必要です。
どの用途でも、TensorFlowはシステムを構成する一部です。データを集める仕組み、結果を利用者に示す画面、人が判断を引き継ぐ運用などと組み合わせて初めて、実際の課題解決につながります。
初心者がTensorFlowを学ぶ5つのステップ
最初の目標は、高性能なAIを完成させることよりも、データの準備から学習・評価・推論までを一度通して経験することに置くと進めやすくなります。手書き数字の画像分類など、問題と正解が明確な小さな課題から始めましょう。
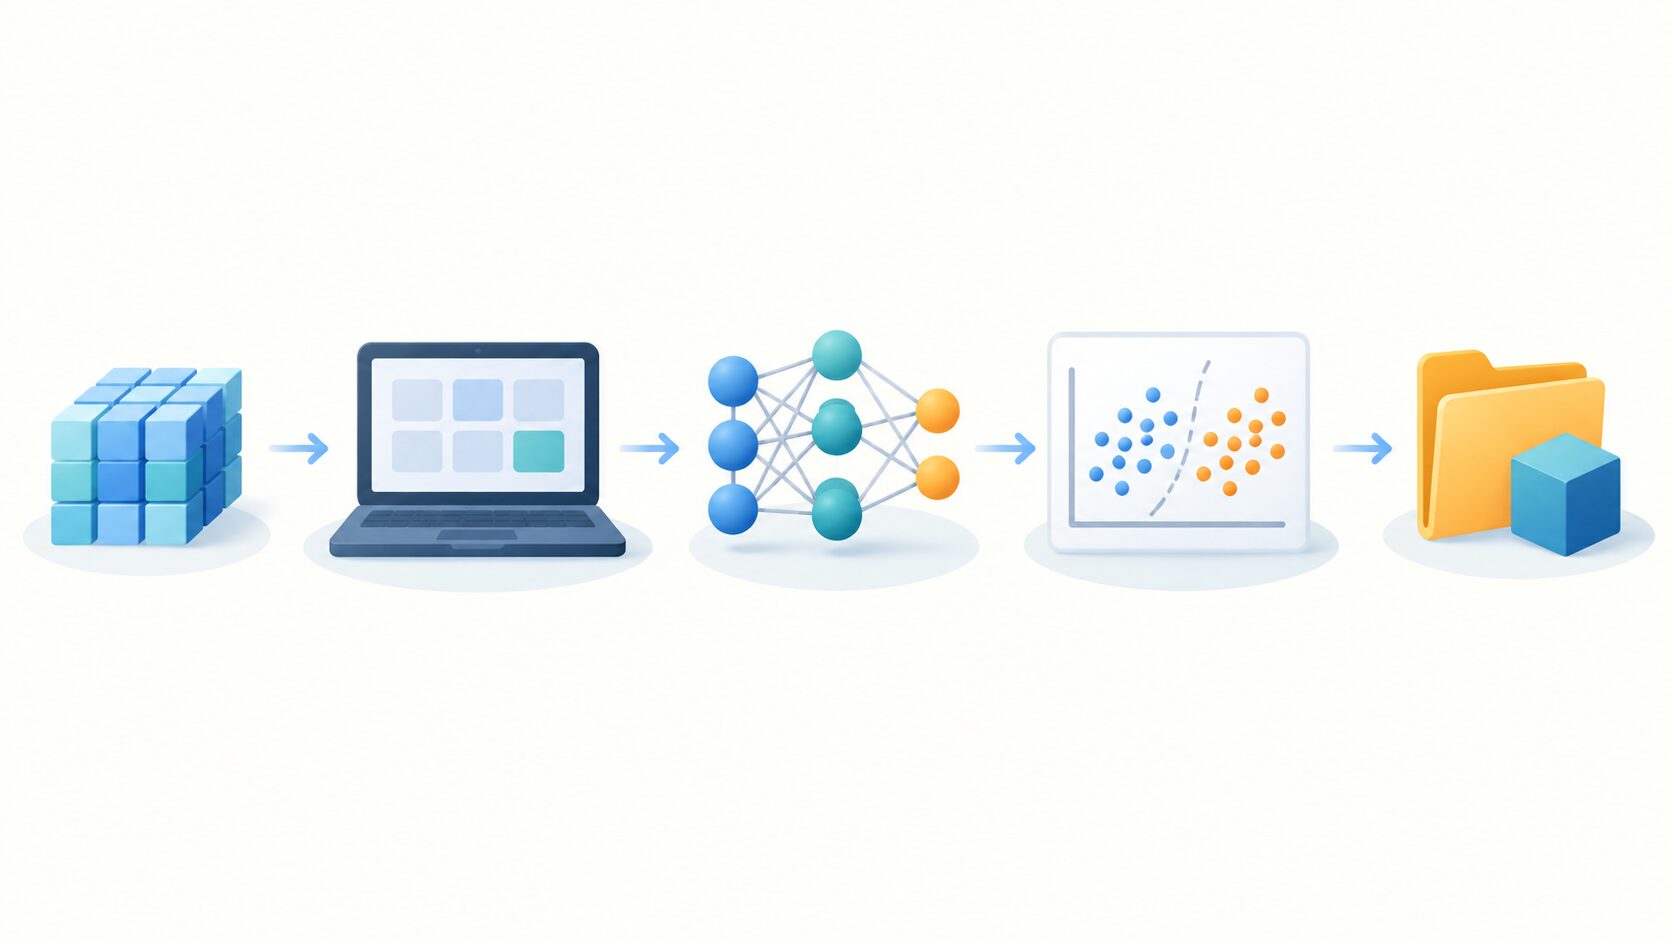
- Pythonと配列の基本を確認する。変数、条件分岐、繰り返し、関数、ライブラリの読み込みを使えるようにします。NumPyなどで配列の形状やデータ型を確認する練習も役立ちます。高度な数学をすべて学び終える必要はありませんが、平均、行列、微分が何を表すかを並行して学ぶと理解が深まります。
- 教材に合う実行環境を用意する。手元の仮想環境や、ブラウザーから利用できるノートブック環境などを選びます。PythonとTensorFlowのバージョン、OS、GPUの利用条件を教材の前提と照らし合わせ、まず小さなテンソル計算が動くかを確かめます。
- 小さな分類モデルを動かす。手書き数字なら、画素の明るさを入力し、0〜9のどの数字かを出力するモデルを作ります。Kerasの層を組み合わせ、損失関数・最適化方法・評価指標を設定して学習します。初回は教材の設定で一通り実行し、入力と出力の形を確認します。
- 予測結果を見て、一つずつ変更する。正解率だけでなく、どの数字を取り違えたか、訓練と検証で損失に差があるかを調べます。学習回数や層の大きさを一度に変えず、一項目ずつ変えて結果を記録すると、何が性能に影響したかを考えやすくなります。
- モデルを保存し、読み込んで使う。学習したモデルを保存し、別の実行で読み込んで新しい画像を予測させます。画像の大きさや明るさの変換など、学習時と同じ前処理を再現することが重要です。保存しただけで運用が完成するわけではなく、入力と出力の扱いも一緒に確認します。
手書き数字の教材で高い正解率が出ても、自分で撮影した数字をそのまま判別できるとは限りません。背景色、余白、文字の位置、画素値の範囲などが違うためです。うまくいかない入力を観察し、学習データとの違いを探す経験が、次の課題にもつながります。
この一連の流れを説明できるようになったら、犬猫の画像分類、レビューの分類、表形式データの予測など、自分が扱いたいテーマへ広げます。課題が変わっても、データを整え、比較の基準を作り、未知のデータで評価するという軸は共通です。
教材・公式資料・コミュニティの活用法
学習資料は、一つですべてを理解しようとするより、役割に応じて使い分けると役立ちます。公式チュートリアルは基本的な手順を通して学ぶ入口に、APIリファレンスは関数や引数の意味を確かめる資料になります。コードを写すだけで終わらせず、「この入力は何を表すか」「なぜこの損失関数を使うか」を言葉にしてみましょう。
動画講座は実行の流れや画面操作を追うときに、書籍は機械学習の背景から体系的に学ぶときに向いています。練習問題がある教材なら、少し条件を変えて自分で実装する機会を作れます。有料・無料だけで判断せず、前提知識、対象バージョン、扱う課題が自分の目的に合うかを確認します。
特に、TensorFlow 1系を前提とした教材には、グラフを定義してセッションで実行する説明が登場します。TensorFlow 2系の教材と実行方法が異なるため、古いサンプルを部分的に混ぜると混乱しがちです。公式資料でも、表示しているページのバージョンや必要な実行環境を確認する習慣をつけましょう。
コミュニティや他の開発者の公開コードは、つまずきの解消や実装例の理解に役立ちます。質問するときは、実行環境、ライブラリのバージョン、最小限のコード、エラーメッセージ、期待した結果をそろえると状況が伝わります。公開の場へ貼る前に、個人情報や秘密の認証情報が含まれていないかも確認します。
学習でつまずきやすい点と注意点
モデルが動かない問題と、動くのに良い予測ができない問題では、調べる順序が異なります。エラーが出るなら入力の形状や型から確認し、精度が伸びないならデータの内容や分割、評価方法を点検しましょう。
- 形状とデータ型を合わせる。画像の枚数・縦・横・色の軸を取り違えると、層に渡せないことがあります。整数のラベルを使うのか、分類先を並べた形式に変換するのかも、損失関数の前提と合わせます。エラーが出た箇所の直前で形状と型を確認するのが近道です。
- 過学習を見分ける。訓練データでの結果だけ良く、検証データでは改善しない状態は、過学習の兆候です。学習回数やモデルの大きさを抑える、データを増やす、重みが過度に複雑にならないよう正則化を使う、といった対策を検討します。
- データ漏洩を避ける。重複データの混入だけでなく、未来の情報を使って過去を予測することも、不適切に高い評価につながります。前処理の基準値を求める際も、原則として訓練データから求め、検証・テストデータには同じ変換を適用します。時系列データでは時間の順序を保つ分割が必要です。
- 正解率だけに頼らない。100件中99件が正常なデータなら、すべて正常と答えるだけでも正解率は99%になります。不良品を見つけたい課題では、見逃しと誤検出を別々に数え、目的に応じた指標で判断します。
- 計算量と再現性を管理する。バッチを大きくするとメモリを多く使い、長時間の実行はクラウド費用にも影響します。乱数の設定、データの分割、モデルの設定、ライブラリのバージョンを記録すると結果を比較しやすくなります。ただし、同じ設定でも装置や実行方法により結果が完全には一致しない場合があります。
- データの質と利用条件を確かめる。誤ったラベルや特定の条件に偏ったデータは、予測の偏りにつながります。画像や文章を収集する場合は、そのデータを学習や目的の用途に利用できるか、個人情報を含まないかも確認します。
たとえば、犬の写真は屋外、猫の写真は室内ばかりというデータでは、モデルが動物そのものより背景を手掛かりにする可能性があります。ライブラリの設定を細かく調整する前に、データの一部を実際に見て、ラベルや撮影条件を点検することが重要です。
今後の活用を考えるときに大切なこと
元記事で触れた医療、製造、金融、交通などの分野では、認識・予測・推薦を支える技術として機械学習の応用を考えられます。TensorFlowのような道具を使うことでモデルを試しやすくなりますが、導入の価値は新しい技術を使ったかではなく、実際の課題をどれだけ改善したかで判断します。
たとえば、製造現場の外観検査では、学習時の画像だけで評価を終えず、照明や製品の種類が変わったときにも性能を確認します。運用後に入力データの傾向が変われば、モデルの再評価や再学習が必要になる場合があります。精度に加え、処理時間、費用、誤判定への対応まで含めて設計することが大切です。
今後の機能や特定の技術の普及を断定するよりも、資料を確認しながら学び直せる基礎を持つことが役立ちます。テンソルの形を読み、学習と推論を区別し、評価結果を吟味できる力は、使うツールや実行環境が変わっても活かせます。
まとめ:小さなモデルで一連の流れを体験しよう
TensorFlowは、テンソル計算や自動微分を土台に、機械学習モデルの構築・学習・利用を支えるライブラリです。Kerasを使うとモデルを簡潔に記述でき、画像・言語・音声・数値予測などの課題に取り組めます。
初心者はPythonと配列の基本を確認し、小さな分類モデルで前処理、学習、評価、推論を一巡させましょう。「動いた」で終わらず、未知のデータで何を間違えるかまで確かめることが、機械学習を使いこなすための第一歩になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月2日 | 初回公開 |
| 2026年9月26日 | テンソルの構造と学習手順を補い、Kerasとの関係や評価時の注意点を追記 |