
ROC曲線でわかる分類モデルの性能:仕組み・AUC・注意点

AIの初心者
「ROC曲線」ってよく聞くんですけど、何を調べるためのグラフなんですか?

AI専門家
二つのグループを見分けるモデルについて、判定基準を変えると、見つけられる割合と誤検出する割合がどう変わるかを見るグラフだよ。正解率だけでは分からない特徴を調べられるんだ。
AIの初心者
例えば迷惑メールの判定なら、見逃しと、普通のメールを間違って迷惑メールにしてしまうことの両方を見られるんですか?
AI専門家
そのとおり。迷惑メールを多く見つけようとすると、普通のメールまで引っかかることがある。その関係をROC曲線で確認し、実際の目的に合う判定基準を考えていくんだよ。
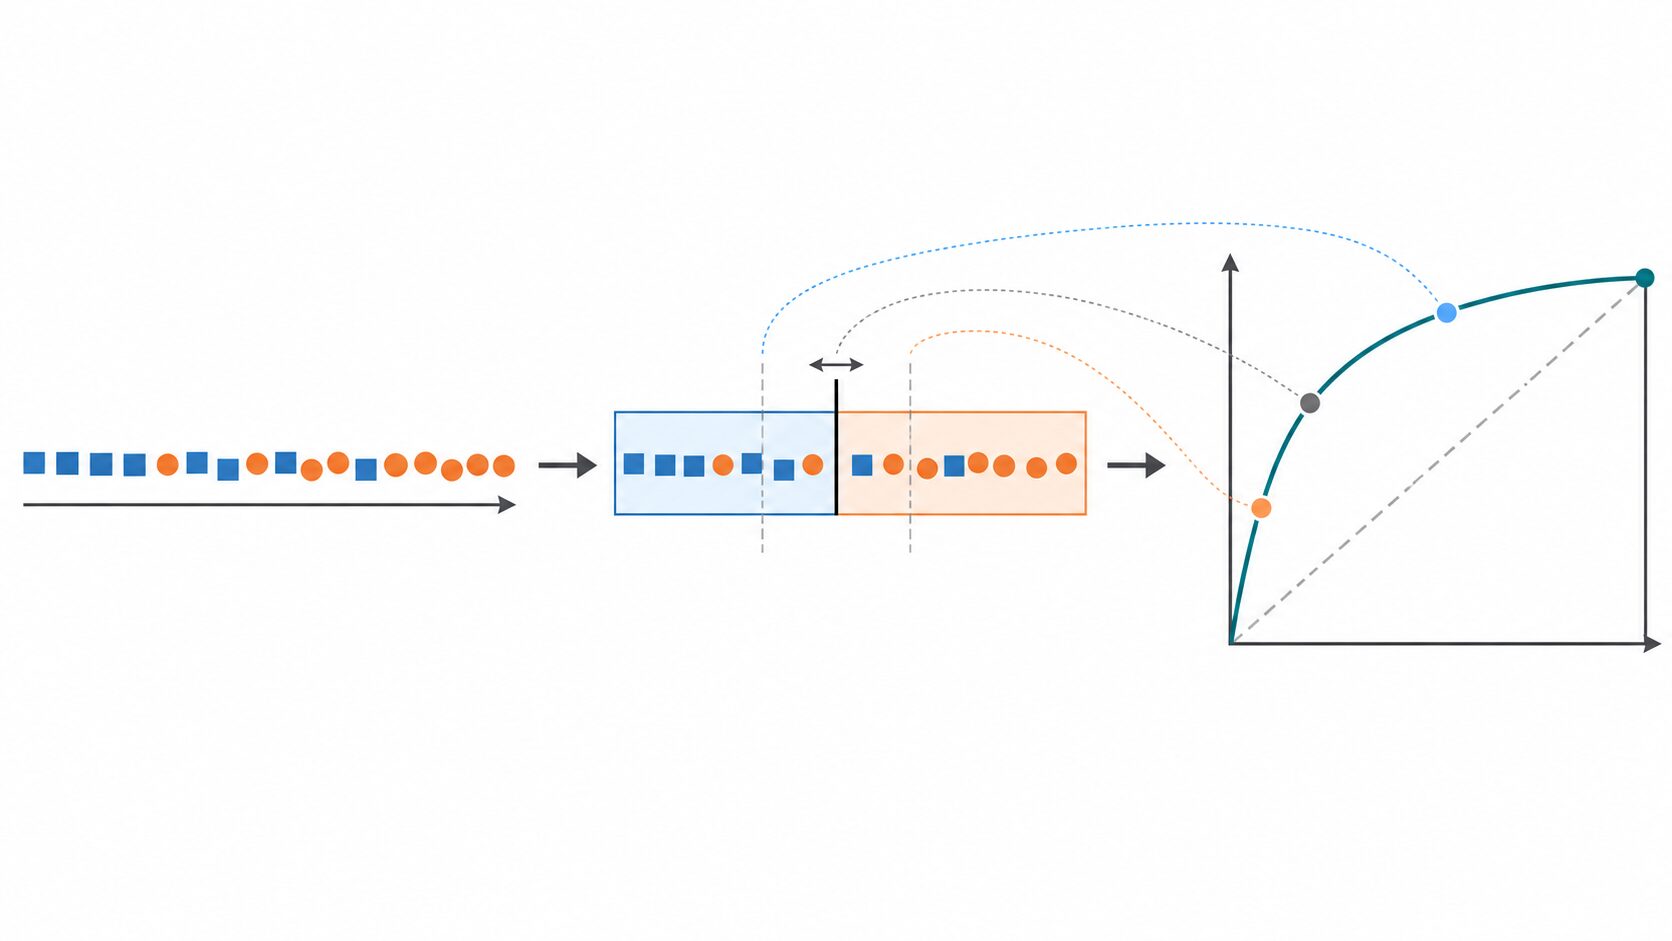
ROC曲線は、分類の判定基準である閾値を動かしながら、真陽性率と偽陽性率の関係を描いたグラフです。モデルが二つのクラスをどれくらい見分けられるかを評価し、見逃しと誤検出のバランスを検討するために使います。
読み方の出発点は、モデルのスコア、閾値による判定、判定結果の集計を順につなぐことです。この記事では、迷惑メール判定の数値例を使い、二つの軸の計算からAUCの意味、運用する閾値の選び方、PR曲線との違いまで確認します。
ROC曲線とは:分類モデルの識別能力を可視化する
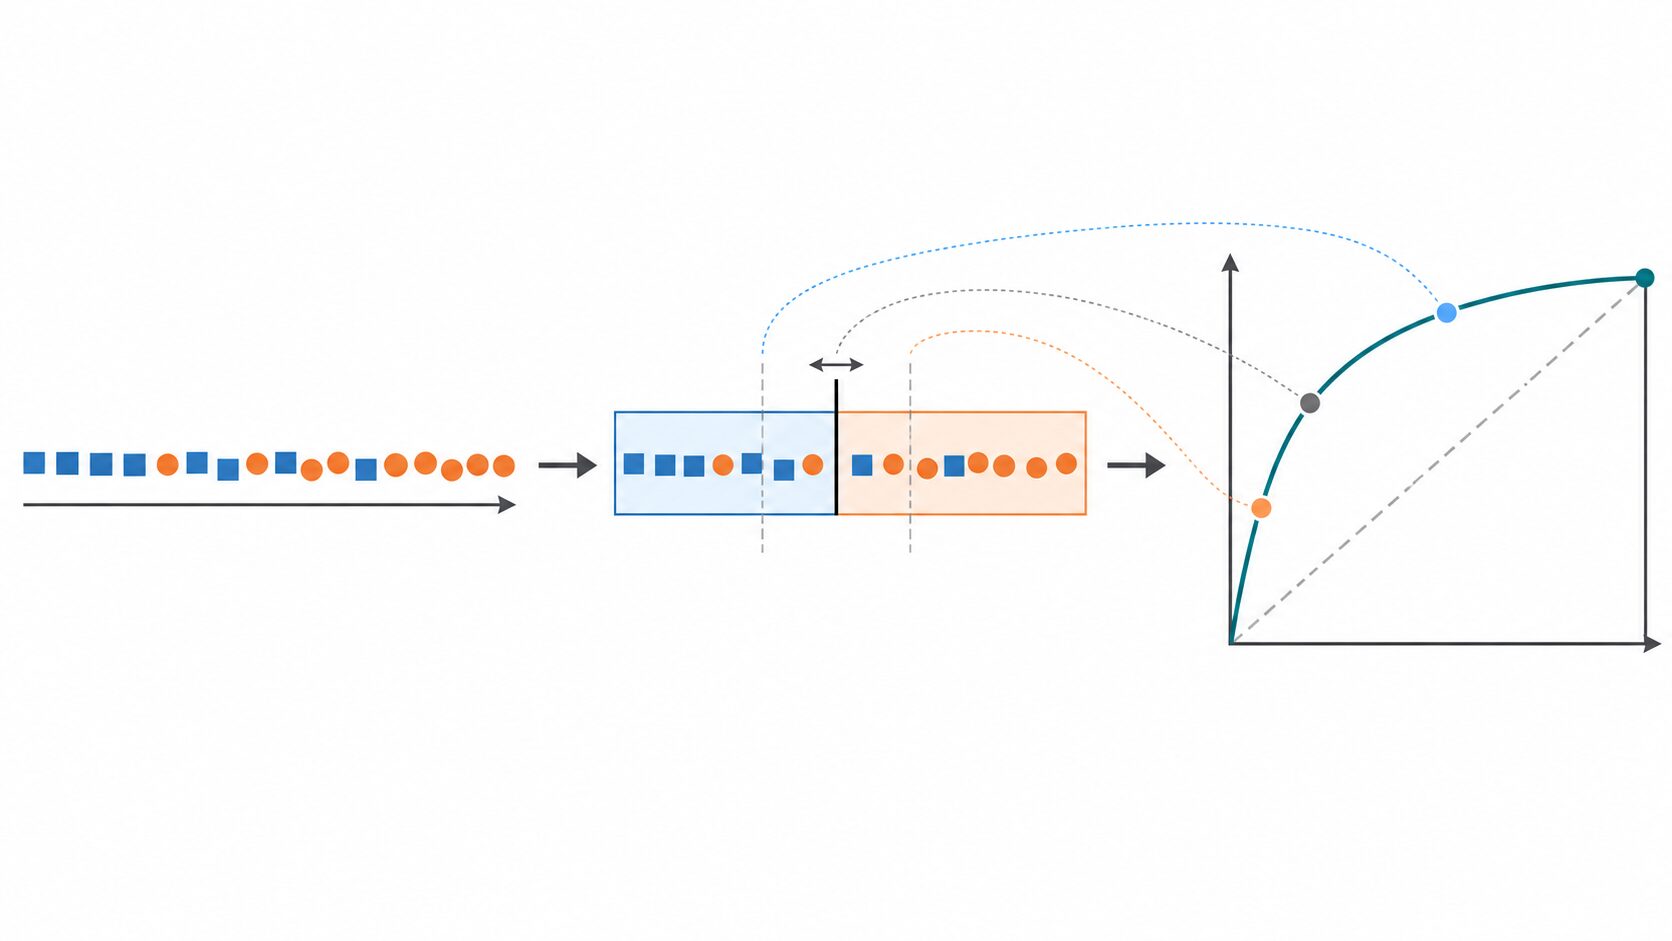
ROCはReceiver Operating Characteristicの略で、日本語では「受信者動作特性」と呼ばれます。ROC曲線は、主に二値分類モデルの識別能力を評価するものです。二値分類とは、メールを「迷惑メール」と「通常のメール」に分けるように、対象を二つのクラスのどちらかに分類する問題を指します。
二つのクラスのうち、検出したい側を「陽性」、もう一方を「陰性」と呼びます。ここでの陽性・陰性は、良い・悪いという意味ではありません。以降の例では迷惑メールを陽性、通常のメールを陰性とします。検査で対象の状態があるかを調べる場合にも同じ考え方を使えますが、どちらを陽性と定義したかを先に確認する必要があります。
分類モデルは、いきなり最終判定を返すだけでなく、「どれくらい陽性らしいか」を表すスコアを出すことがあります。例えば、スコアが0.5以上なら迷惑メールと判定する、という基準を置けます。この境界となる値が閾値(しきい値)です。なお、スコアは必ずしも確率ではなく、値が0〜1の範囲に収まるとも限りません。ROC曲線には、陽性らしさの順序を表すスコアを使えます。
一つの閾値を固定すると、ROCグラフ上では一つの点が得られます。閾値を変えて得られる点をつないだものがROC曲線です。正解率が「その判定基準で全体の何割を正しく分類したか」を表すのに対し、ROC曲線は判定基準を変えたときの識別の特徴を示します。比較には、正解ラベルと、最終的な二択の判定にする前のスコアを用意します。
真陽性率・偽陽性率を混同行列から理解する
ROC曲線の縦軸は真陽性率、横軸は偽陽性率です。まずは、実際のクラスとモデルの予測を組み合わせた「混同行列」を作ると、計算の対象が分かります。基本となる式は次の二つです。
\(\mathrm{TPR}=\frac{\mathrm{TP}}{\mathrm{TP}+\mathrm{FN}}\) \(\mathrm{FPR}=\frac{\mathrm{FP}}{\mathrm{FP}+\mathrm{TN}}\)真陽性(TP)は陽性を正しく見つけた件数、偽陰性(FN)は陽性を見逃した件数です。偽陽性(FP)は陰性を誤って陽性とした件数、真陰性(TN)は陰性を正しく陰性とした件数を表します。実際に迷惑メールが20件、通常のメールが80件ある、計100件の仮想データで考えてみましょう。
| 実際のクラス | 迷惑メールと予測 | 通常のメールと予測 | 合計 |
|---|---|---|---|
| 迷惑メール(陽性) | TP:16件 | FN:4件 | 20件 |
| 通常のメール(陰性) | FP:8件 | TN:72件 | 80件 |
| 合計 | 24件 | 76件 | 100件 |
真陽性率の分母は「実際に陽性の全件」、偽陽性率の分母は「実際に陰性の全件」です。真陽性率は、迷惑メール20件のうち16件を見つけているので、\(\mathrm{TPR}=16/20=0.80\)となります。真陽性率は「感度」や「再現率」と同じ指標です。
偽陽性率は、通常のメール80件のうち8件を誤検出しているので、\(\mathrm{FPR}=8/80=0.10\)です。陰性を正しく陰性と判定できる割合を「特異度」といい、この例では\(72/80=0.90\)になります。偽陽性率は、1から特異度を引いた値です。
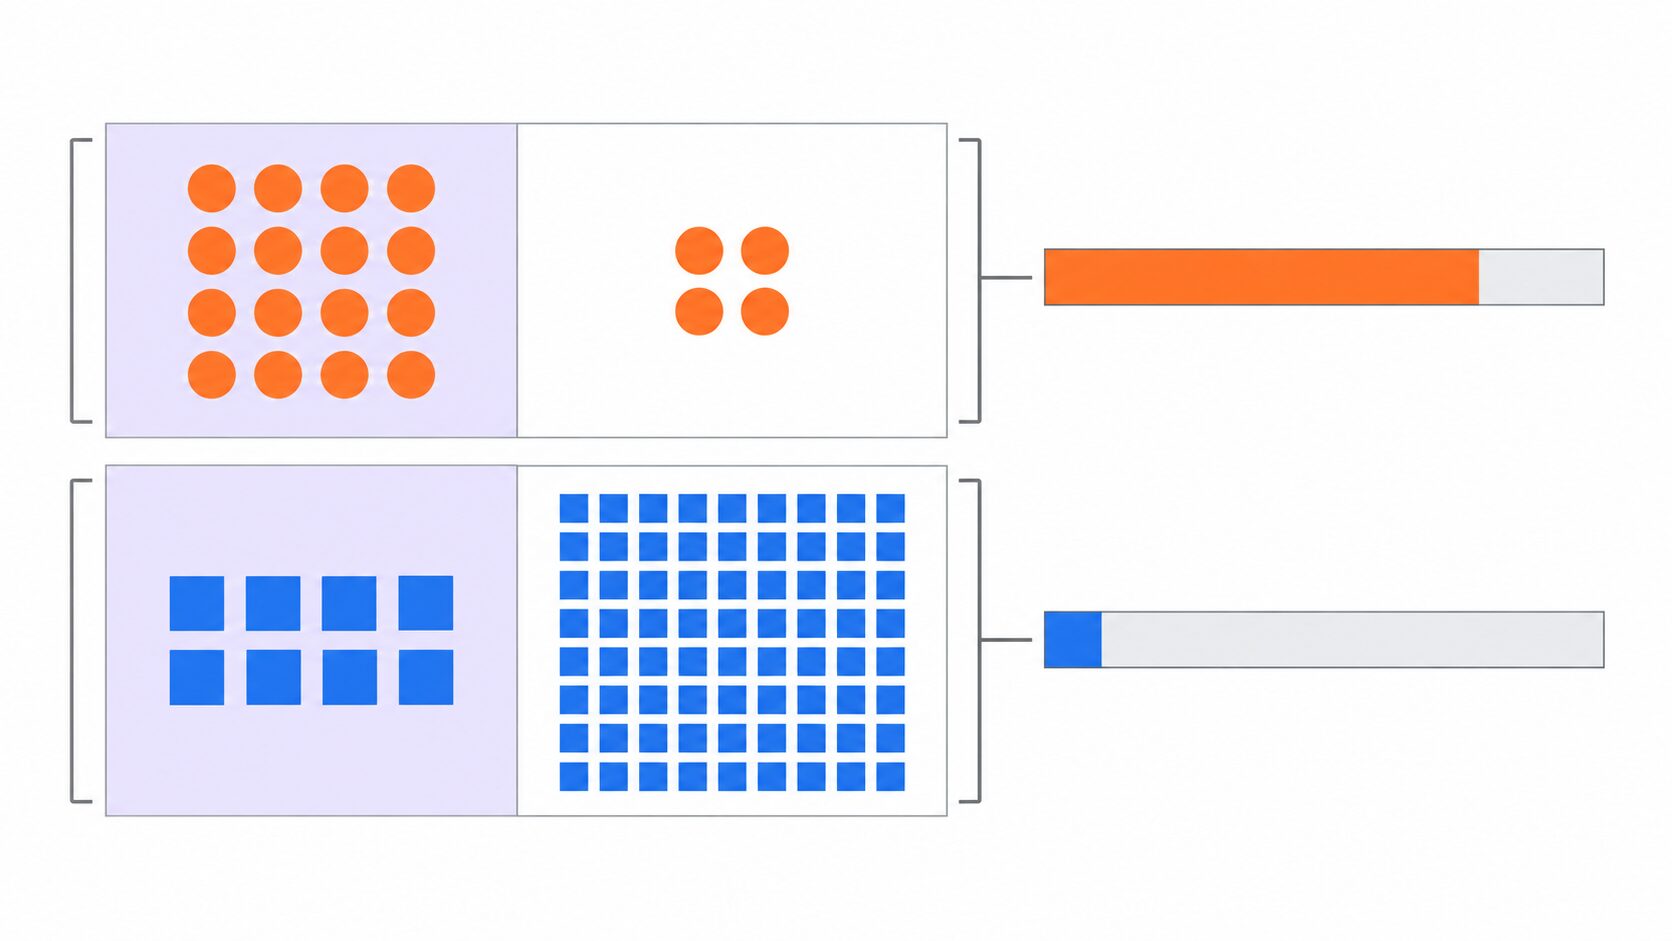
混同しやすいのが「適合率」です。適合率は、陽性と予測したもののうち、本当に陽性だった割合を指します。この例では\(16/(16+8)\approx0.667\)、約66.7%です。再現率は「本物をどれだけ拾えたか」、適合率は「拾ったものがどれだけ当たっていたか」を表し、質問の向きが異なります。
閾値を動かしてROC曲線を描く・読む
ROC曲線では、横軸と縦軸の順に\((\mathrm{FPR},\mathrm{TPR})\)を一つの点として配置します。ここでは「高いスコアほど陽性らしく、閾値以上を陽性と判定する」と決めます。この前提では、閾値を下げるほど陽性判定の対象が広がり、真陽性率と偽陽性率はどちらも減りません。
同じモデルで採点した同じ100件について、閾値だけを変える仮想例を見てみます。実際の陽性20件・陰性80件という内訳は固定しています。
| 閾値 | TP | FP | 真陽性率 | 偽陽性率 | ROC上の座標 |
|---|---|---|---|---|---|
| 0.8 | 10件 | 4件 | 0.50 | 0.05 | \((0.05,0.50)\) |
| 0.5 | 16件 | 8件 | 0.80 | 0.10 | \((0.10,0.80)\) |
| 0.2 | 19件 | 24件 | 0.95 | 0.30 | \((0.30,0.95)\) |
閾値0.8ではスコアが高いメールだけを陽性とするため、誤検出を4件に抑えられる一方、迷惑メールを10件見逃します。閾値を0.2まで下げると見逃しは1件になりますが、通常のメール24件も陽性と判定します。陽性判定の条件を厳しくすることは閾値を上げること、緩くすることは閾値を下げることに対応します。
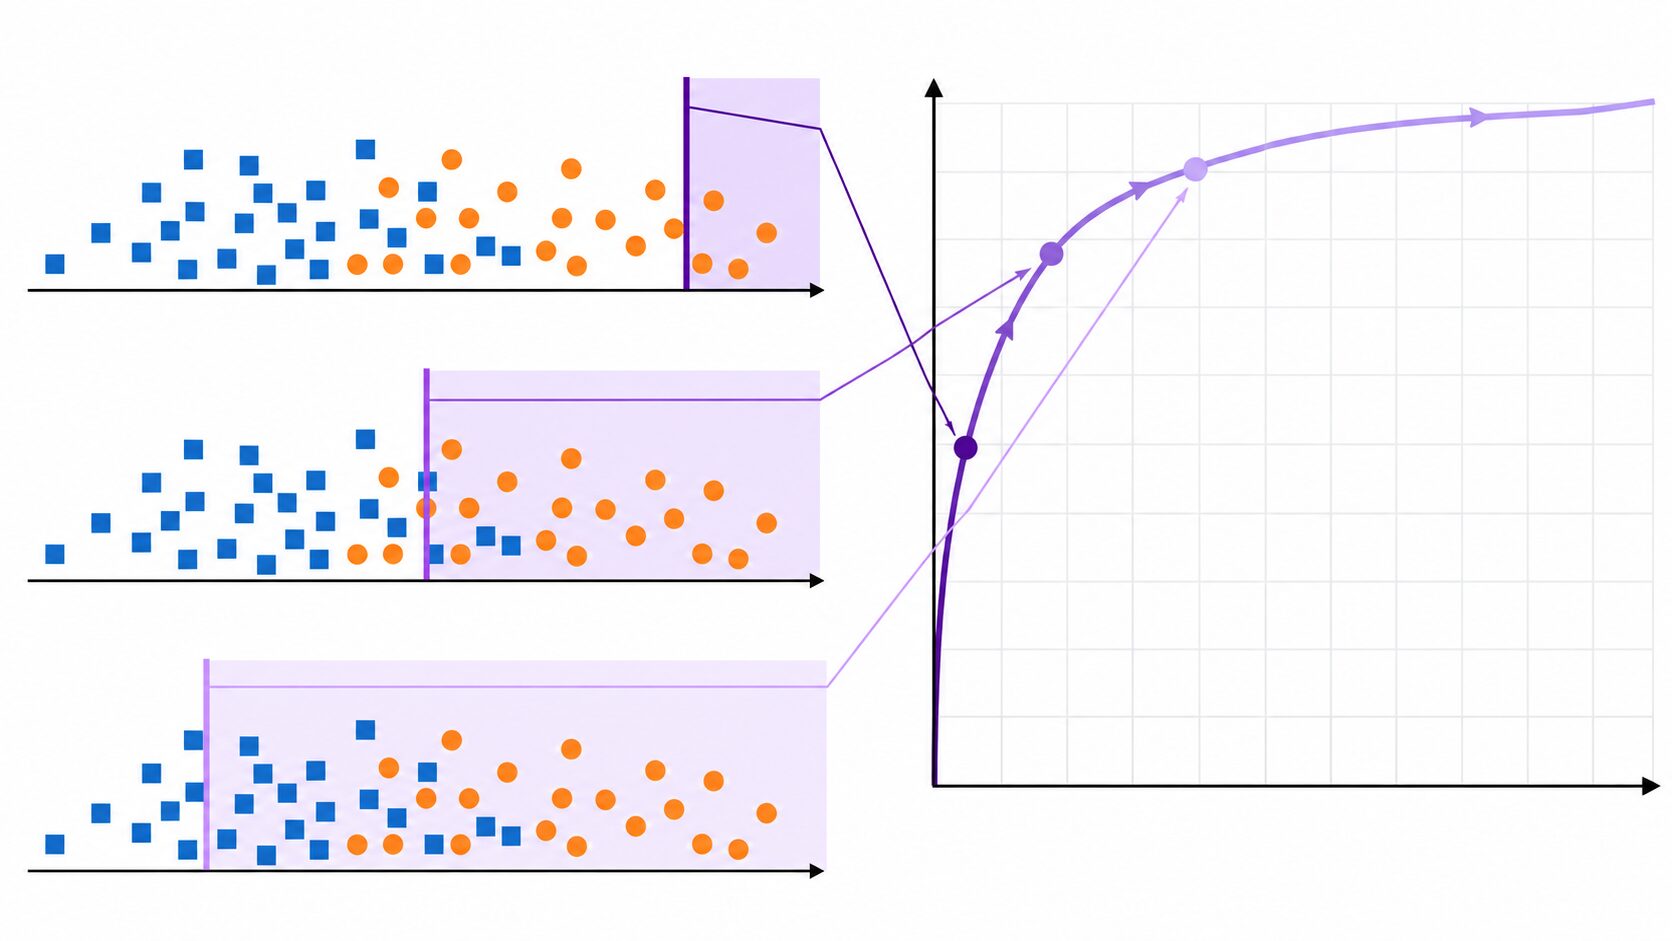
閾値を全データのスコアより高くすれば、すべて陰性と判定され、点は左下の\((0,0)\)にあります。そこから閾値を下げ、すべて陽性と判定する状態にすると、右上の\((1,1)\)に到達します。点は上方向や右方向へ進みますが、両方の率が毎回同時に増えるとは限りません。データ数が有限なので、実際には段差のある形になることもあります。
理想は左上の\((0,1)\)です。この点では陰性の誤検出がなく、陽性をすべて見つけています。同じ偽陽性率で比べるなら、より上にある点ほど陽性を多く拾えます。同じ真陽性率で比べるなら、より左にある点ほど誤検出を抑えられます。
左下から右上への対角線は、クラスと無関係にランダムな順位を付けた場合の基準です。ただし、限られた標本ではランダムなスコアでも曲線は上下に揺れます。実際のモデルの曲線も、必ず対角線より上に位置するわけではありません。下側に大きく膨らむ場合は、識別性能に加えて、スコアの向きや陽性ラベルの指定を確認します。
AUCの意味とモデル比較での読み方
AUCはArea Under the Curve、つまり「曲線の下の面積」を意味します。ここではROC曲線の下面積であるROC-AUCを指し、値は0〜1の範囲になります。複数のモデルのROC曲線を、一つの数値で比較するときに役立ちます。
AUCは、陽性と陰性を無作為に1件ずつ選んだときに、陽性のスコアが陰性より高くなる確率としても解釈できます。同点は半分の成功として扱います。したがって、AUCが0.9でも「全データの90%を正しく分類できる」という意味ではありません。表しているのは陽性と陰性の順位付けの良さであり、ある閾値での正解率は別に計算します。
| AUCの値 | 読み取り方 | 確認したいこと |
|---|---|---|
| 1 | 評価データ上で陽性と陰性を完全に順位付けできている | データ漏洩がなく、未知のデータでも性能を保てるか |
| 0.5 | 全体の面積ではランダムな順位付けと同等 | 曲線の形や、実際に使う領域での性能 |
| 0.5未満 | 全体では陽性が陰性より低く順位付けされる傾向 | 陽性ラベルやスコアの向き、評価処理の誤り |
AUCが0.5の曲線が、必ず対角線と一致するわけではありません。また、0.5未満だからといって、実運用で確かめずにスコアを反転すればよいとも限りません。まずは、何を陽性とし、どのクラスに対するスコアを渡したのかを確かめます。
モデルを比較するときは、同じ評価データと陽性の定義を使います。AUCが大きいほど、全閾値にわたって集約した識別能力は高いといえます。ただし、ROC曲線が交差する場合、AUCの大小と、特定の偽陽性率での優劣は一致しないことがあります。通常メールの誤隔離を強く抑える用途では、偽陽性率が低い左側の領域を詳しく見る必要があります。
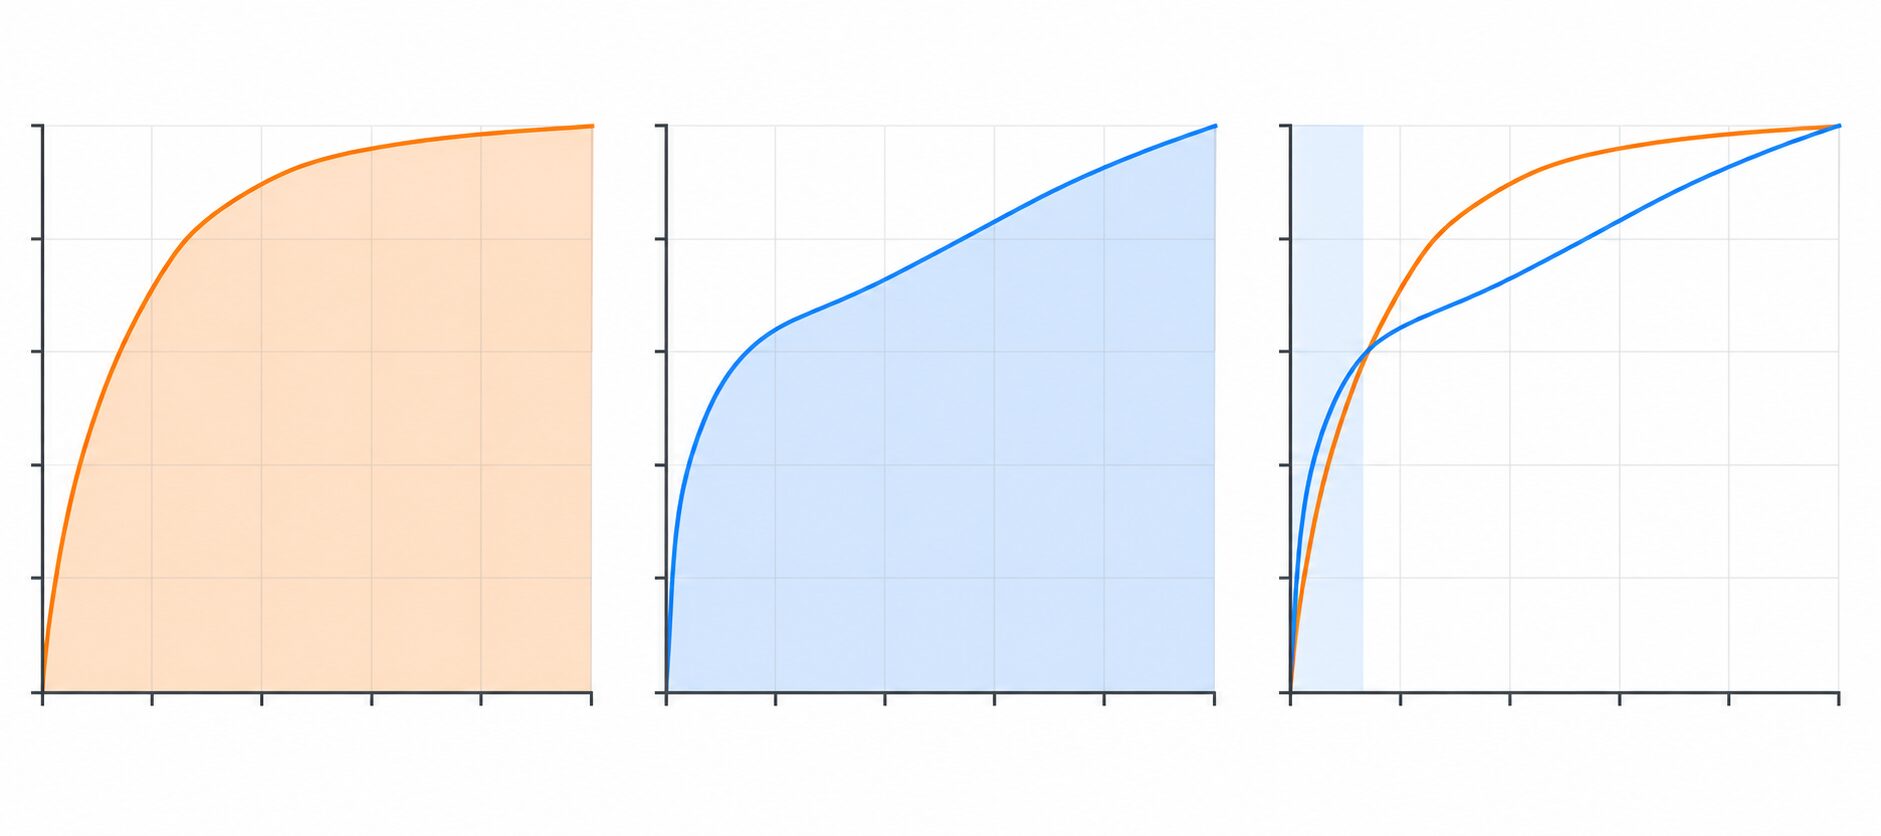
ここでいう「全体」は、評価データ上で閾値を変えた範囲のことです。高いAUCが、あらゆる利用条件での優位性や、将来も安定した性能を保証するわけではありません。AUCの差が小さい場合には、評価に使った標本の偶然による差も考慮します。
使いどころと目的に合った閾値の選び方
ROC曲線の主な用途は、候補モデルの比較と、見逃し・誤検出のトレードオフの把握です。曲線を計算した際の閾値を残しておけば、各点に対応する判定基準を確認できます。ただし、ROC曲線だけで業務に最適な閾値が自動的に決まるわけではありません。見逃しと誤検出のどちらをどこまで許容するかは、利用目的によって変わります。
迷惑メールの見逃しを減らしたいなら、閾値を下げて再現率を高める方向を検討します。一方、大切な通常メールを隔離してしまう損失が大きいなら、閾値を上げて偽陽性率を抑える判断が必要です。同じモデルでも、単に注意を表示する機能と、自動でメールを隔離する機能とでは、適した閾値が異なります。
先ほどの100件の例で、通常メールの誤隔離を4件までに抑える条件なら、表の候補では閾値0.8が該当します。しかし、この選択では迷惑メールを半分見逃します。閾値0.5に変えると6件多く見つかる代わりに、誤隔離も4件増えます。この追加の検出と誤隔離に、どの程度の価値や損失があるかを考えます。
実務では、誤分類1件あたりの損失だけでなく、陽性の割合や、担当者が確認できる件数も条件になります。偽陽性率が同じでも、通常メールが毎日何万件も届く環境では、誤検出の確認作業が大きな負担になります。「偽陽性率を何%まで許すか」と「1日何件まで確認できるか」を結び付けることが大切です。
- 何を陽性とするかを定め、見逃し、誤検出、確認作業について許容条件を決めます。
- 学習に使っていない検証データで、候補モデルと閾値を比較します。
- モデルと閾値を決定した後、選択に使っていない独立したテストデータで最終評価します。
- 運用する点の混同行列、適合率、再現率、実際の処理件数を確認します。
テスト結果を見るたびに閾値を調整すると、そのデータに都合のよい設定を選んでしまいます。比較や調整のための検証データと、最後の確認に使うテストデータの役割を分けることで、未知のデータに対する性能を見積もりやすくなります。
不均衡データでの注意点とPR曲線との違い
ROC曲線は、陽性と陰性それぞれの集団に対する割合を使うため、件数の多いクラスに全体の正解率が引っ張られる問題を避けやすい指標です。ただし、陽性がまれな「不均衡データ」に対して、ROCだけで十分に評価できるわけではありません。予測結果を確認する作業では、次の適合率も重要です。
\(\mathrm{Precision}=\frac{\mathrm{TP}}{\mathrm{TP}+\mathrm{FP}}\)例えば、陽性100件・陰性9,900件の計10,000件を考えます。すべて陰性と答えるだけで正解率は99%になりますが、陽性は1件も検出できません。ROCの真陽性率を見れば、この判定では陽性をまったく拾えていないことが分かります。
では、真陽性率0.8、偽陽性率0.1のモデルなら十分でしょうか。陽性100件の80%である80件を見つける一方、陰性9,900件の10%である990件を誤って陽性とします。陽性と予測したのは合計1,070件で、適合率は\(80/(80+990)\approx0.075\)、約7.5%です。見つけた候補の大部分は誤検出になります。
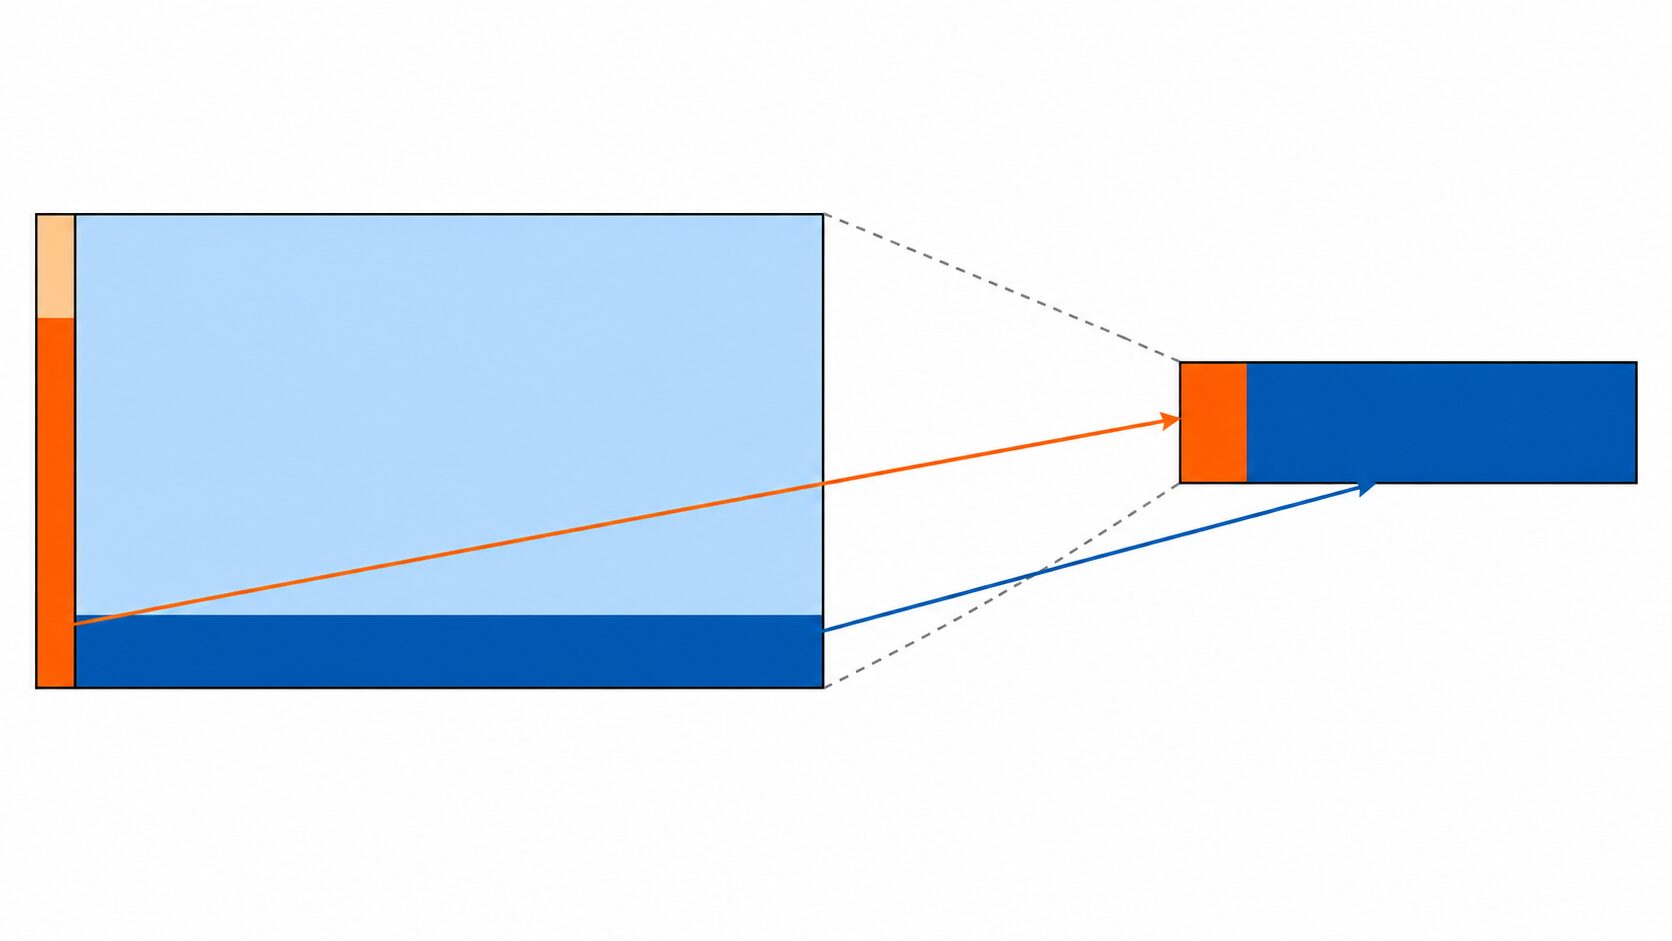
偽陽性率は割合なので、陰性の母数が大きいと誤検出の件数も大きくなります。この例より偽陽性率を低く抑えていても、大量の対象を処理する用途では実件数を確認する必要があります。ROC上の位置だけで、陽性と予測した結果の信頼性まで判断しないことが大切です。
そこで併用したいのがPR曲線です。PRはPrecision(適合率)とRecall(再現率)を指し、閾値を変えたときの二つの関係を描きます。ROCとPRでは、横軸と注目する問いが異なります。
| 比較項目 | ROC曲線 | PR曲線 |
|---|---|---|
| 横軸 | 偽陽性率 | 再現率 |
| 縦軸 | 真陽性率(再現率) | 適合率 |
| 確認しやすい関係 | 陰性の誤検出を抑えながら、陽性をどれだけ拾えるか | 陽性を多く拾うとき、候補のうち本物がどれくらいを占めるか |
| 陽性割合との関係 | クラス内のスコア分布が同じなら、陽性割合だけでは変わらない | 適合率が陽性割合の影響を受ける |
前半の100件の例と今回の10,000件の例は、真陽性率も偽陽性率も同じですが、適合率は約66.7%と約7.5%で大きく違います。各クラス内のスコア分布が保たれるなら、陽性と陰性の混合割合が変わってもROC曲線は変わりません。一方、適合率は変わるため、まれな陽性を探す用途ではPR曲線も合わせて確認すると実態をつかみやすくなります。
PR曲線にも曲線下面積の指標がありますが、ROC-AUCとは軸も意味も異なります。単に「AUC」と書かれた結果を見るときは、どちらの曲線に基づく数値なのかを確認してください。また、陽性割合の異なるデータ同士では、PRの数値の差をモデル性能だけの差と解釈しないようにします。
ROC曲線の限界と評価を補う視点
ROC曲線とAUCが直接評価するのは、陽性と陰性を見分ける能力です。誤分類による損失、出力した確率の信頼性、未知の環境での安定性は、それぞれ別に確認する必要があります。評価の目的に合わせて、足りない視点を補いましょう。
まず、AUCが高くても予測確率が正しいとは限りません。例えば「陽性確率80%」と予測した集団で、実際に陽性となる割合も約80%かどうかは、確率の校正という別の問題です。スコアの大小関係と同点関係を変えずに値だけを変換しても、ROC曲線は変わりません。順位付けに優れたモデルでも、出力値を確率として使う場合には、予測確率と実測の割合を照らし合わせる必要があります。
また、ROC曲線は二値分類が基本ですが、多クラス分類にも拡張できます。One-vs-Restでは、あるクラスを陽性、それ以外を陰性としてクラスごとに評価します。One-vs-Oneでは、クラスの組を取り出して二者間の識別を評価します。方式によって集計の意味が変わるため、「多クラスAUC」という数値だけでは評価条件を十分に説明できません。
クラス別の値を同じ重みで平均するマクロ平均と、クラスの件数に応じて重みを付ける加重平均でも結果は変わります。使った評価方式と平均方法を明示し、平均値に隠れたクラスごとの弱点を確認してください。特に件数の少ないクラスで重要な見逃しが起きていないかは、クラス別の混同行列や再現率で補えます。
評価データ自体の条件も結果を左右します。次の点は、ROC-AUCを比較する際に併せて確認したい事項です。
- 陽性の例が少ないと、数件の順位の違いで結果が変わります。必要に応じて信頼区間や、適切な交差検証による評価のばらつきを確認します。
- 学習用と評価用に同じ対象や関連の強いデータが混ざると、実力以上の値が出ることがあります。前処理も含め、評価データの情報が学習に入り込まないようにします。
- 利用者層、時期、入力の傾向が変わると、各クラス内のスコア分布も変化し、ROC曲線やAUCが変わる場合があります。運用後も評価を続けます。
モデルを採用するときは、ROC曲線とAUCで識別の特徴を見たうえで、選んだ閾値で何件を見つけ、何件を見逃し、何件を誤検出するのかまで確認します。適合率や確認作業の負担も合わせて判断することで、グラフ上の性能を実際の使いどころにつなげられます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月24日 | 閾値の説明を修正し、混同行列の計算例と不均衡データでの注意点を補足 |