
最長距離法とは?計算例と最短距離法との違いを解説

AIの初心者
「最長距離法」って、どういう意味ですか? 一番遠いデータ同士を先にまとめるのでしょうか?

AI専門家
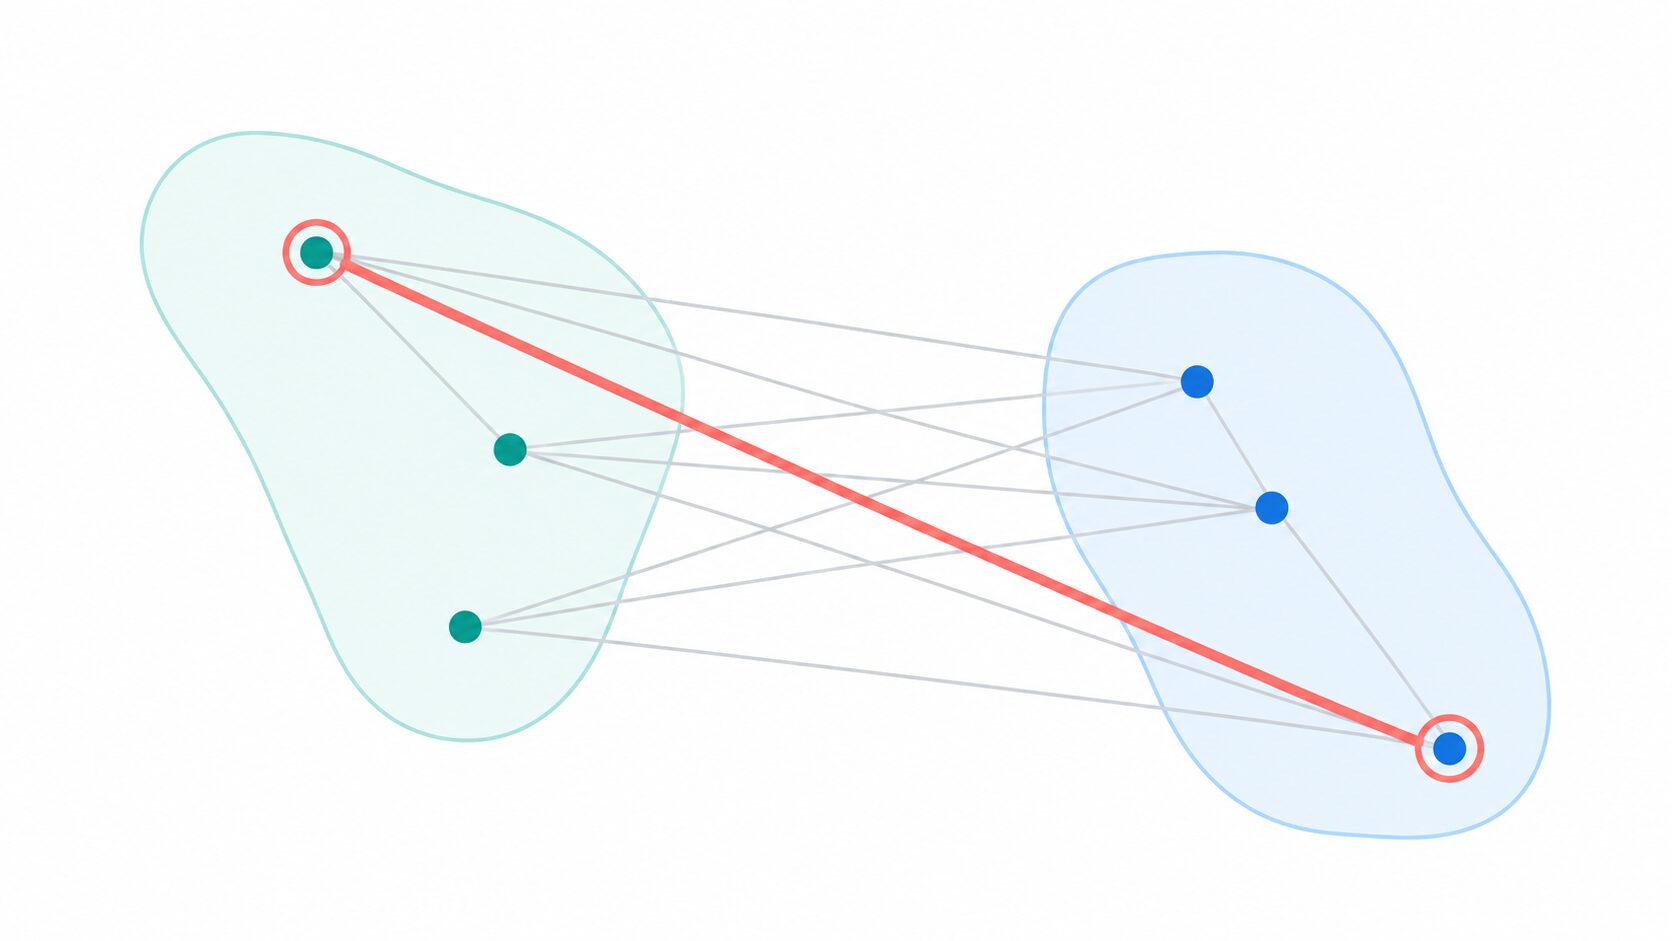
「最長」は、グループ間の距離の測り方を表しているんだ。二つのグループから一つずつデータを選び、その全組み合わせのうち最も遠い距離を使う。その距離をグループの組ごとに比べて、値が一番小さい組からまとめるんだよ。
AIの初心者
距離を測るときは最大の値を使い、まとめるときはその値が最小の組を選ぶのですね。離れたデータが一つあるだけでも影響しそうです。
AI専門家
その通り。互いに離れすぎないグループを作りやすい一方、極端に離れた点があると距離や統合の順番が変わることがある。小さな数値例で、計算と注意点を一緒に確かめてみよう。
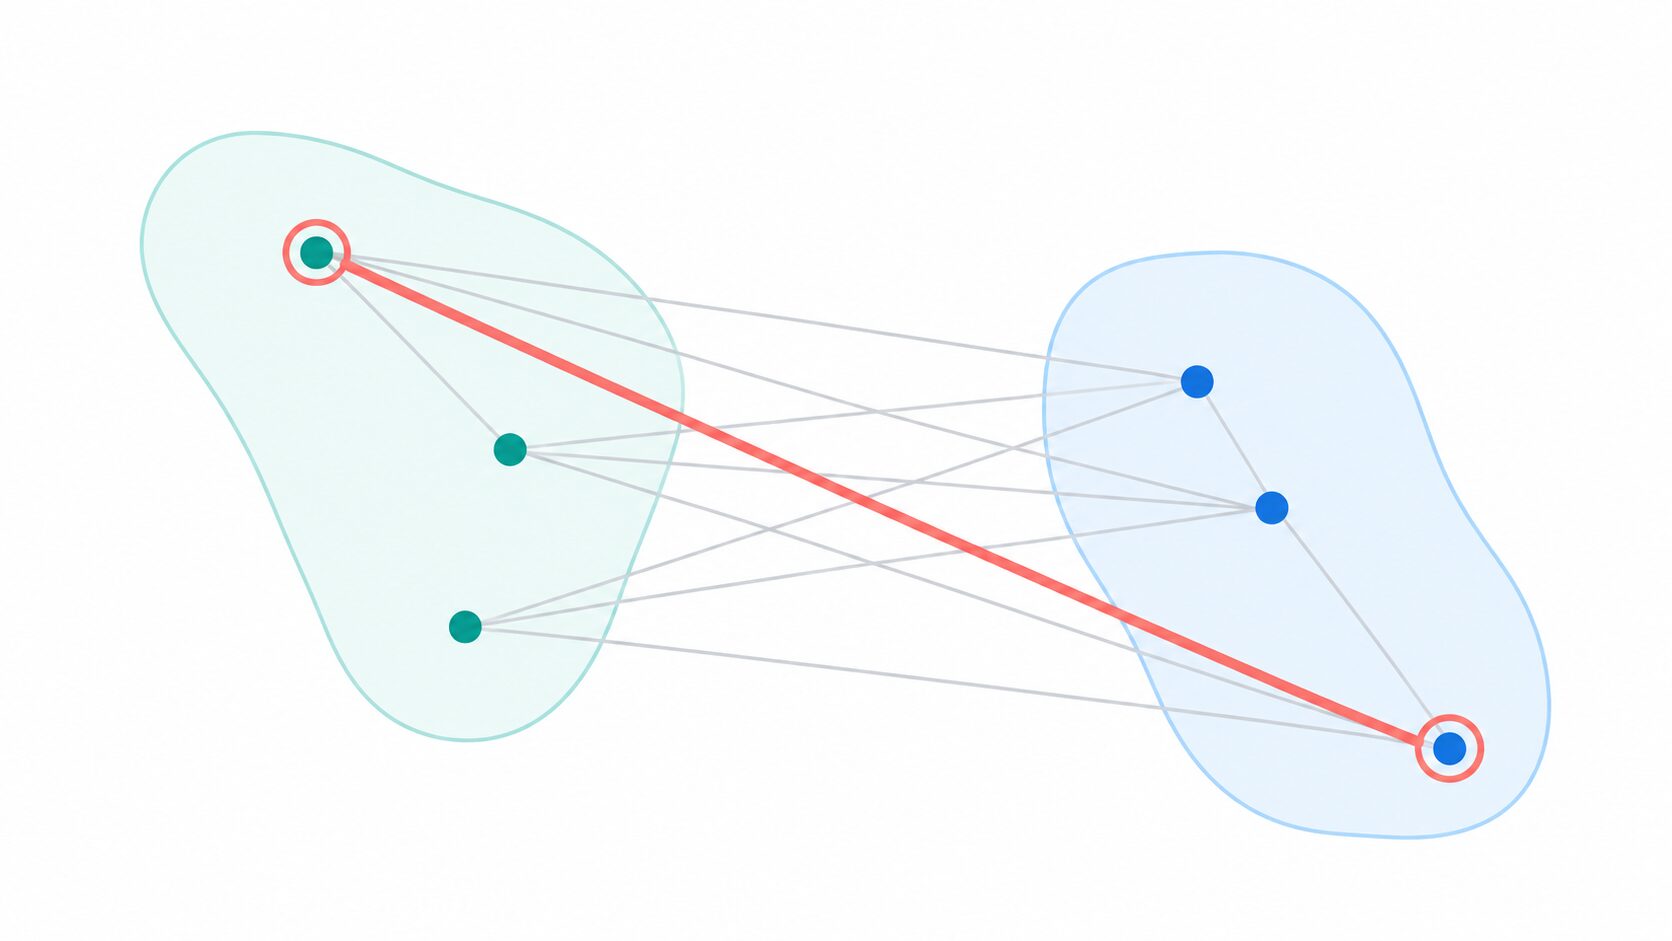
最長距離法は、二つのクラスタをまたぐすべての点の組のうち、最大の距離をクラスタ間距離とする方法です。完全連結法、英語では complete linkage とも呼ばれ、データを段階的にまとめる階層的クラスタリングで使われます。
名前を理解する鍵は、「クラスタ間距離をどう測るか」と「次にどのクラスタをまとめるか」を分けて考えることです。この記事では、4点の計算例から統合の流れを追い、最短距離法などとの違い、活用例、前処理の判断まで確認します。
最長距離法(完全連結法)とは
クラスタとは、似た特徴を持つデータの集まりです。たとえば顧客を購入回数や購入金額で表せば、購買傾向の近い顧客を一つのクラスタとして扱えます。このように、あらかじめ正解の分類ラベルを与えず、データの特徴から集まりを見つける処理をクラスタリングといいます。
階層的クラスタリングのうち、各データを一つのクラスタとして出発し、近いクラスタを順に統合するものが凝集型の階層的クラスタリングです。最長距離法は、この統合で必要になる「クラスタ同士の近さ」を決める基準の一つです。統合の履歴を残すため、細かい分け方から大きなまとまりまで階層として確認できます。
ここでいう距離は、データがどれほど異なるかを示す非類似度です。地図上の距離に限らず、金額や回数などの数値から計算できます。一般に値が小さいほど似ていると扱いますが、何を似ているとみなすかは、選んだ特徴量と距離の測り方によって変わります。
二つのクラスタを比べる際、最長距離法では片方から1点、もう片方から1点を選ぶ全組み合わせを対象にします。その最大距離が小さければ、二群をまたぐどの点の組も大きく離れていないと判断できます。両群の中心点だけを見る方法とは異なり、端に位置する点同士の離れ方も統合判断に反映されます。
実際の統合では、このように求めた距離をすべてのクラスタ対について比較し、クラスタ間距離が最も小さい組を選びます。「最長」は候補となる二群の評価に使う値を指しており、統合は近い候補から進みます。
最大距離を使う計算手順と具体例
クラスタ間距離の定義を式にすると、次のようになります。
\(D(A,B)=\max\{d(x,y)\mid x\in A,\;y\in B\}\)\(A\) と \(B\) は比較する二つのクラスタ、\(x\) と \(y\) はそれぞれに属するデータです。\(d(x,y)\) は点同士の距離、\(D(A,B)\) はクラスタ間の距離を表します。\(\max\) は、対象となる値の中から最大値を取るという意味です。
計算は、各点を一つのクラスタにして距離を求め、最小距離のクラスタ対を統合し、新しいクラスタとの距離を更新する、という順で進めます。全体の階層を作る場合は、一つのクラスタになるまで繰り返します。
具体例として、数直線上の0・1・4・6という4点を考えます。点同士の距離には絶対差 \(d(x,y)=|x-y|\) を使います。たとえば0と4の距離は4、1と6の距離は5です。初期状態の距離表は次のとおりです。
| 点 | 0 | 1 | 4 | 6 |
|---|---|---|---|---|
| 0 | 0 | 1 | 4 | 6 |
| 1 | 1 | 0 | 3 | 5 |
| 4 | 4 | 3 | 0 | 2 |
| 6 | 6 | 5 | 2 | 0 |
表の対角線にある0は、同じ点との距離なので統合候補には含めません。異なるクラスタ間の値を使うと、統合は次の順番になります。
- 距離1で0と1を統合する。異なる点の組で最小の距離は1です。これにより、0と1を含むクラスタができます。
- 距離を更新し、距離2で4と6を統合する。0と1のクラスタから点4までの距離は、4と3の大きい方で4です。点6までの距離は、6と5の大きい方で6です。一方、点4と点6の距離は2なので、この二つを次にまとめます。
- 残った二群を距離6で統合する。0と1のクラスタ、4と6のクラスタの間で最大距離を求め、最後の統合を行います。
最後の計算を詳しく見ると、\(A=\{0,1\}\) と \(B=\{4,6\}\) をまたぐ点の組は、0と4、0と6、1と4、1と6です。それぞれの距離は4・6・3・5なので、\(D(A,B)=\max\{4,6,3,5\}=6\) となります。二群の中心の差や、最も近い1と4の距離を採用しない点に注目してください。
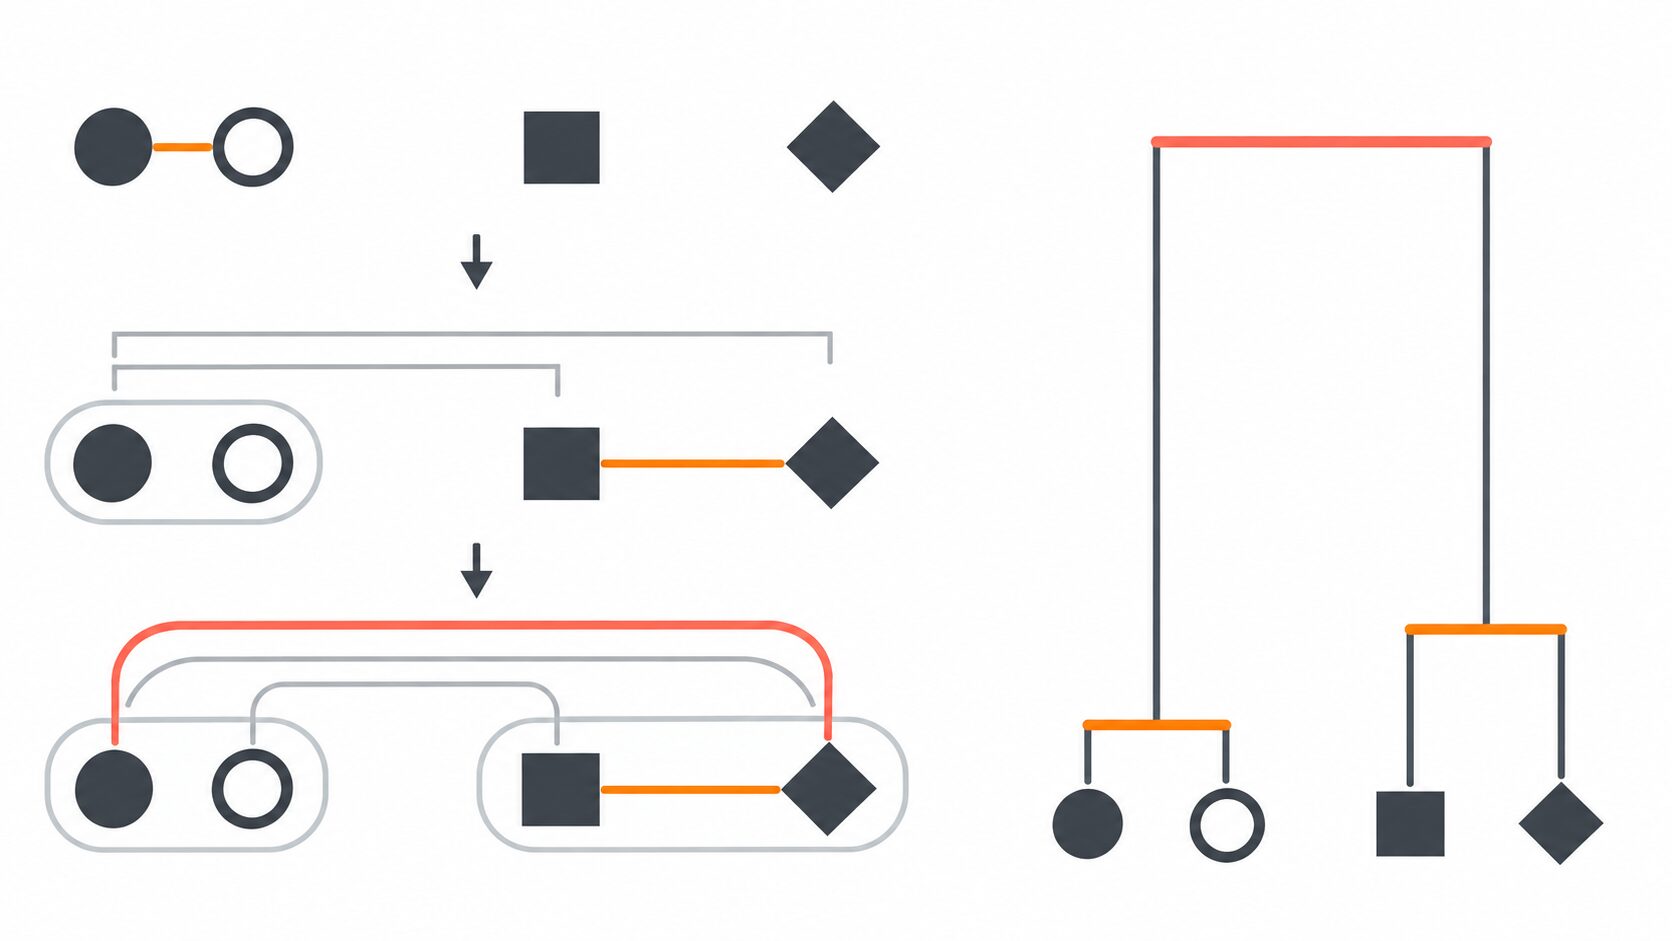
この履歴を枝分かれの形で表した図が、樹形図(デンドログラム)です。距離を縦軸に取る場合、枝がつながる高さは統合時のクラスタ間距離を表します。この例では0と1の枝が高さ1、4と6の枝が高さ2でつながり、両群が高さ6で合流します。枝の高さを見ると、どの程度の違いを許してまとめたのかが分かります。
なお、統合のたびに元の点の組をすべて調べ直す必要はありません。既存の距離が分かっていれば、クラスタ \(A\) と \(B\) を統合した後、別のクラスタ \(C\) までの距離は次の式で更新できます。
\(D(A\cup B,C)=\max\{D(A,C),D(B,C)\}\)\(A\cup B\) は両クラスタを合わせた集合です。もとの二つの距離のうち大きい方を残せば、統合後の最大距離になります。また、最小距離の候補が同点で並ぶデータでは、どの候補を先に選ぶかによって後の統合結果が変わる場合があります。
最短距離法・群平均法・ウォード法との違い
同じ \(A=\{0,1\}\) と \(B=\{4,6\}\) でも、クラスタ間距離の決め方を変えると評価値が変わります。二群をまたぐ距離4・6・3・5に対し、最短距離法では最小の3、最長距離法では最大の6、群平均法では平均の4.5です。
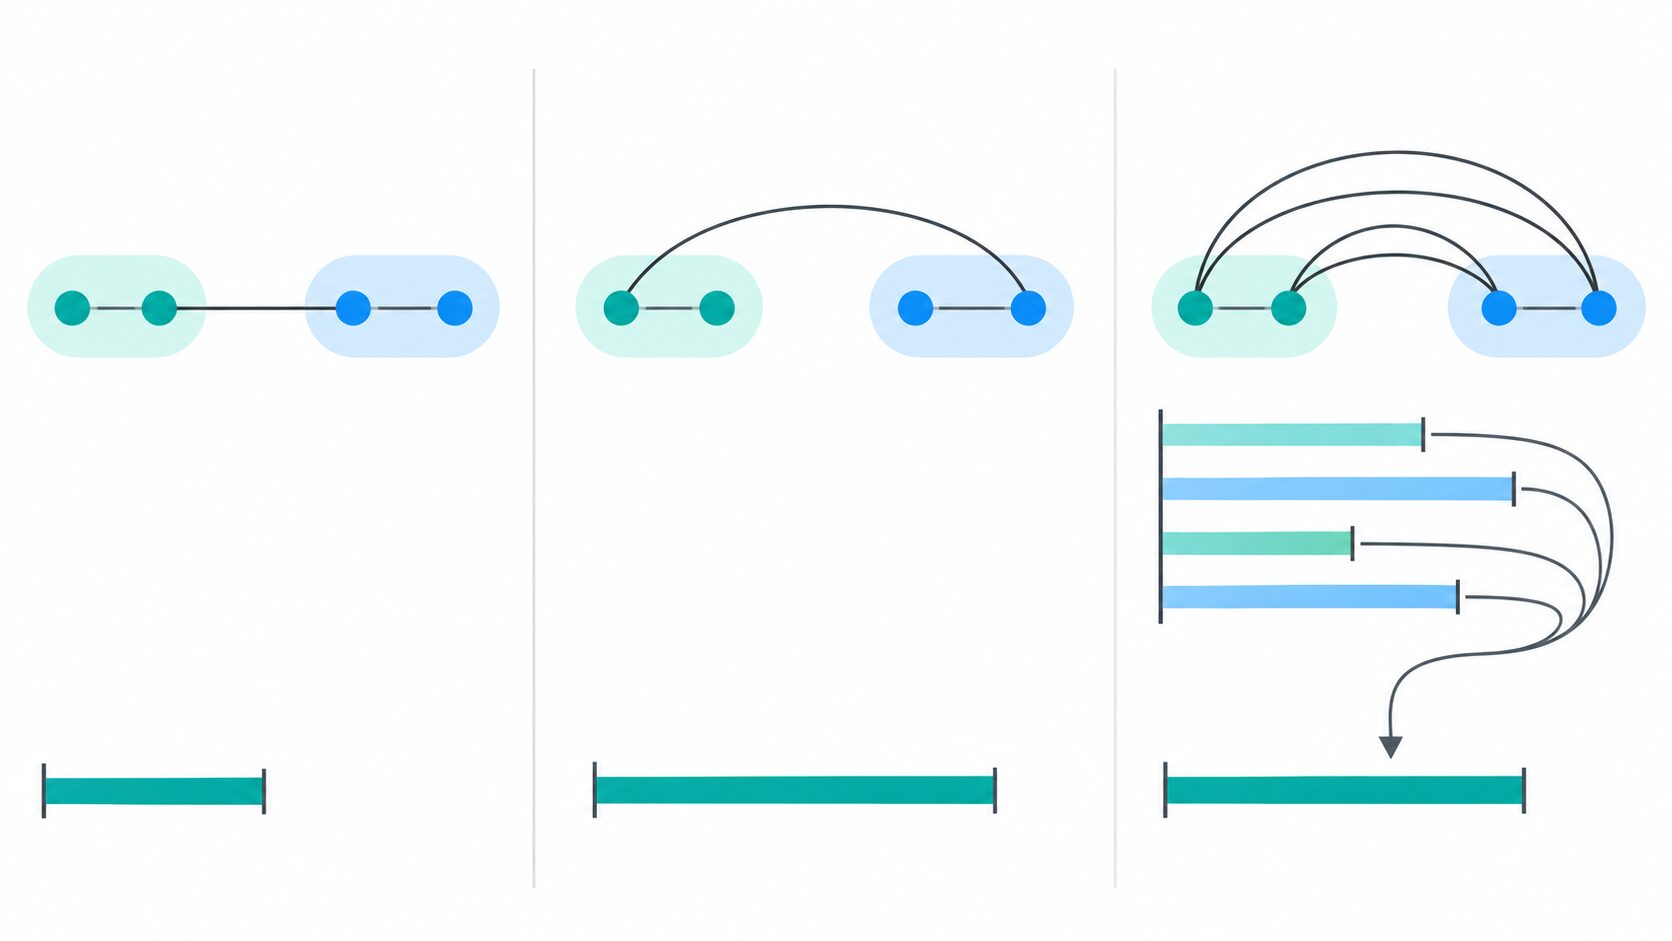
階層的クラスタリングでよく使われる四つの基準を比べると、次のようになります。
| 手法 | 統合を判断する基準 | まとまり方の傾向 | 注意点 |
|---|---|---|---|
| 最短距離法(単連結法) | 二群をまたぐ点対距離の最小値 | 近い点がつながり、細長い集団もまとまりやすい | 少数の点が橋渡しすると、離れた集団まで連鎖的につながる |
| 最長距離法(完全連結法) | 二群をまたぐ点対距離の最大値 | クラスタ内の広がりが小さい集団を作りやすい | 遠い点の影響を受け、細長い集団を分ける場合がある |
| 群平均法 | 二群をまたぐ全点対の距離の平均値 | 最も近い点や遠い点だけでなく、二群全体の関係を反映する | 距離の分布やクラスタの構成に左右され、外れ値の影響もなくならない |
| ウォード法 | 統合によるクラスタ内平方和の増加 | クラスタ内のばらつきが小さくなるようにまとめる | 通常はユークリッド空間で用い、尺度や外れ値の影響に注意する |
最短距離法では、二群のどこかに近い点の組があれば統合候補になりやすくなります。このため、点が鎖のようにつながり、両端が遠く離れたクラスタができることがあります。これが連鎖効果です。最長距離法では、遠い点の組も含めた最大距離で評価するため、このような連鎖を抑えやすくなります。
群平均法の平均は、二群をまたぐ点の組すべての距離を足し、その組数で割って求めます。二群の中心点間の距離とは別の基準です。ウォード法が使うクラスタ内平方和は、各点から所属クラスタの中心までの距離を二乗し、合計したものです。ウォード法は統合によってこの合計がどれだけ増えるかを見るため、最長距離法の最大距離とは数値の意味が異なります。
手法の選択では、「どのような集まりを一群とみなしたいか」を考えます。最短距離法なら細かい分類、最長距離法なら大まかな分類、と一律に使い分けることはできません。分類の細かさは、樹形図を切る高さや選ぶクラスタ数にも依存します。
関連する手法にk-meansがあります。こちらは通常、クラスタ数を先に指定し、各点の所属とクラスタの中心を更新する非階層的な手法です。統合の履歴を樹形図として確認したい場合と、決めた個数のグループを得たい場合では、手法に求める役割も変わります。
顧客・画像・生物データでの活用例
最長距離法は、特徴を数値で表し、データ同士の違いを距離として定められる場面で利用できます。得られるのは、選んだ特徴量と距離に基づくグループです。業務上の意味を付けるには、各クラスタにどのようなデータが入っているかを確認する必要があります。
顧客分析では、購買傾向の近い集団を探します。たとえば同じ集計期間の購入頻度と購入金額を用意し、互いの違いが大きすぎない顧客をまとめます。できた各群の分布を調べると、「少額の商品を頻繁に購入する」「購入回数は少ないが1回の金額が大きい」といった傾向が見つかる場合があります。
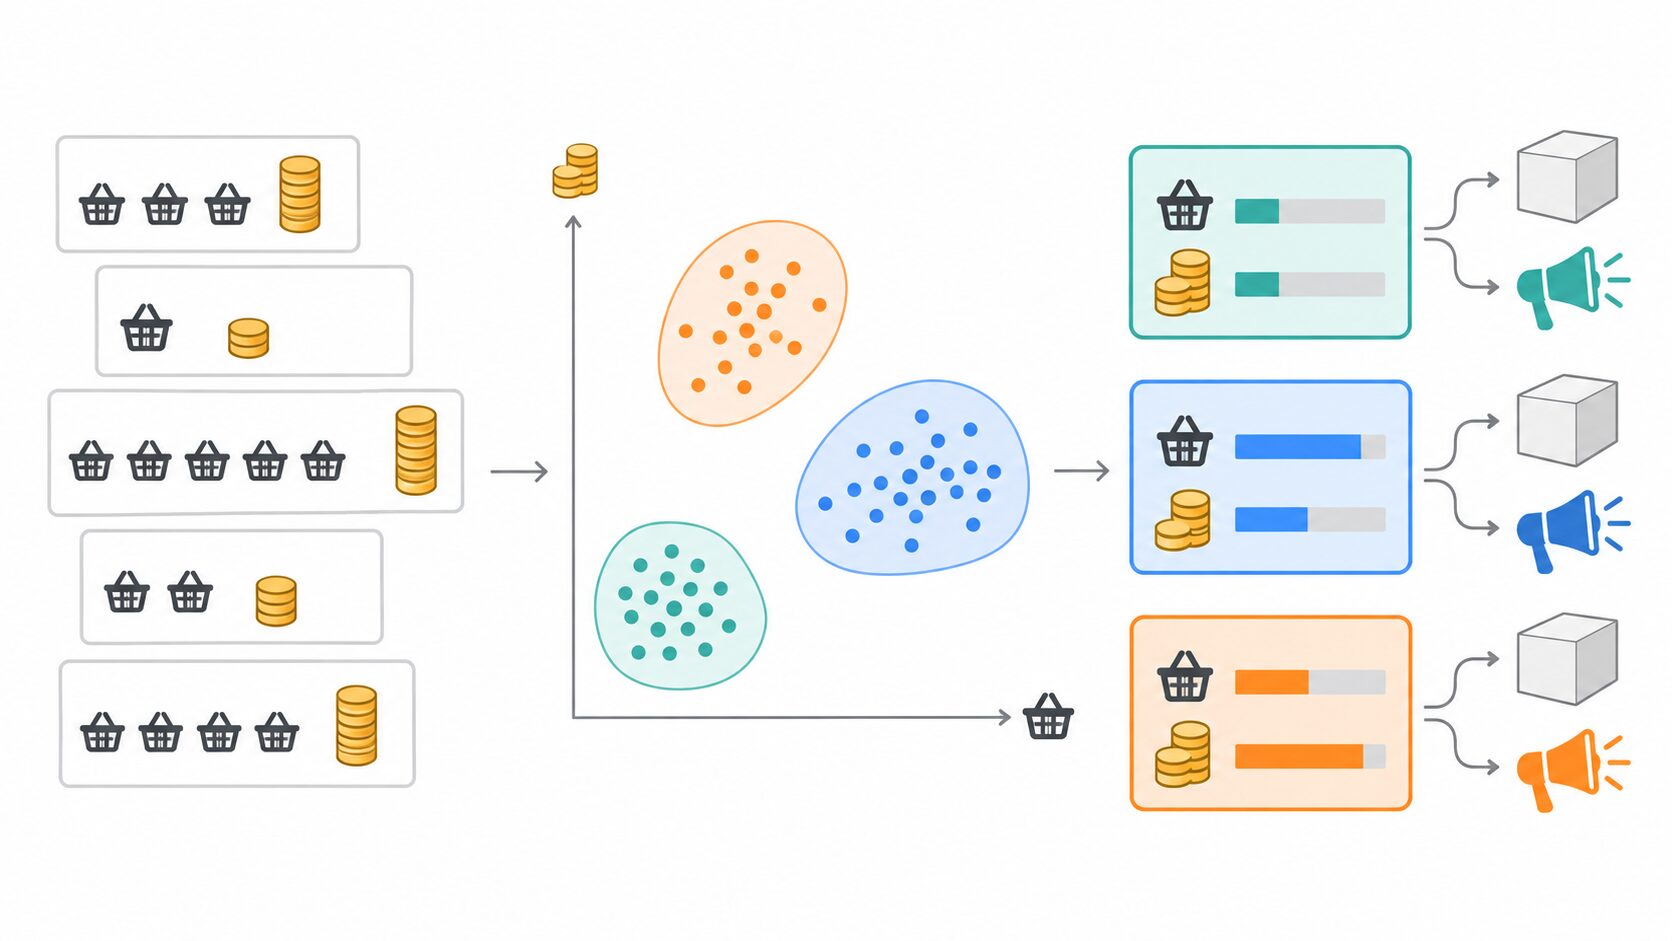
この結果は、おすすめ商品の選定や案内頻度の検討に使えます。ただし、クラスタを作るだけで広告効果や売上向上が保証されるわけではありません。群ごとの人数や購入商品の違いを確認し、実施する施策の効果は別に測定します。群に名前を付けるときも、実際のデータで裏付けられる特徴を使うことが大切です。
画像の整理では、見た目の特徴が近い画像をまとめます。色、形、模様などを数値化した特徴量や、画像を数値のベクトルに変換した埋め込み表現を利用します。果物画像の整理なら、赤く丸い画像が同じ群に集まることがありますが、その群がそのまま一つの果物の種類を表すとは限りません。背景や照明の似ている画像が集まる場合もあります。
製品画像でも、似た表面模様や形状を持つ画像の抽出に使えます。検査担当者が確認する対象を整理する助けにはなりますが、少数のクラスタに入ったことだけで不良品と判断するのは適切ではありません。正解ラベルや検査結果と照合して、何の違いを捉えた分類なのかを確かめます。
生物データでは、遺伝子発現などの類似性を探索します。複数の試料について遺伝子の発現量を測り、似た発現パターンの試料をまとめる、といった使い方が考えられます。樹形図はデータの似かより方を表しますが、その枝分かれだけで進化上の系統関係や分岐時期を断定することはできません。進化系統の推定には、分析目的に応じたデータや進化モデルなどが必要で、単なる類似性のクラスタリングとは区別します。
最長距離法の長所と注意点
最長距離法の長所は、連鎖効果を抑え、互いに離れすぎないコンパクトなクラスタを作りやすいことです。「同じグループの中で特徴が大きく異なりすぎないようにしたい」という目的に合う場合があります。ここでいうコンパクトとは、採用した距離で測った広がりが小さいという意味で、必ず球状の集団になるという意味ではありません。
一方、最大値を使う性質上、外れ値への注意が必要です。離れた点が一つ加わり、その点と相手のクラスタ内の点との距離が従来の最大値を超えると、クラスタ間距離が大きくなります。それまで近い候補だった組が、別の候補より遠いと評価される可能性もあります。
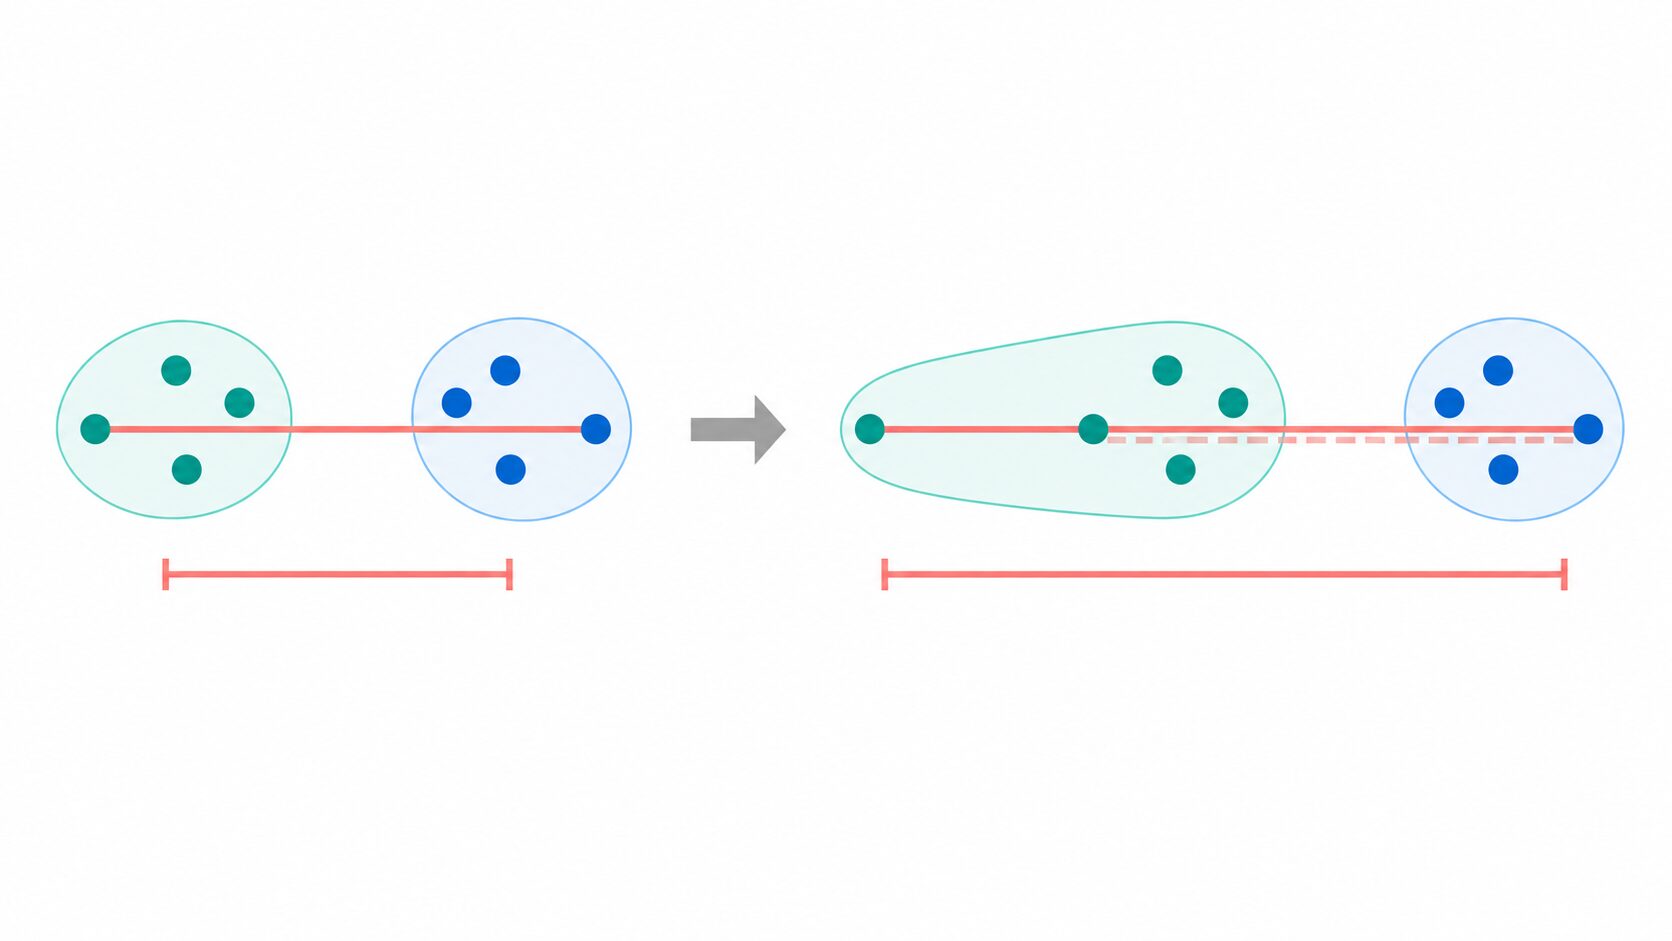
つまり、最長距離法は外れ値に強いと一律に評価できません。極端な点が独立したクラスタとして残ることもありますが、それをもって他の統合への影響がないとはいえません。最大距離や統合順がどう変わるかを確認する必要があります。
データの形にも向き不向きがあります。たとえば細長く伸びた一つの集団では、隣り合う点は近くても両端は遠くなります。最長距離法はその遠さを評価するため、人が一続きと見なす集団を複数に分ける場合があります。曲がった形や、密度の異なる集団が混在するデータでは、散布図と照らし合わせ、他の手法とも比較すると判断しやすくなります。
データ数が増える場合は、計算資源も確認します。距離行列を保持する一般的な実装では、必要なメモリは点数の二乗規模で増えます。同じ保存方法なら、点数が10倍になると距離の保存量はおおむね100倍になります。計算時間は距離の算出方法や統合処理の実装によっても変わるため、まず一部のデータで実行時間とメモリ使用量を確かめるとよいでしょう。
すべての点対の距離を評価に含めること自体は、分類の正しさを保証しません。何を正しいまとまりとするかは分析目的次第です。計算量の多さと分析の妥当性を分けて考え、得られた群が目的に合っているかを確かめます。
前処理とクラスタ数を決めるポイント
結果を左右するのは、統合基準だけではありません。最長距離法を適切に使うには、特徴量の選択、尺度の調整、欠損値や外れ値への対応、最終的な分割の選択を一続きの作業として考えます。
最初に、何の違いを距離に反映したいかを決めます。顧客の購入金額と購入回数をそのままユークリッド距離に入れると、数値の幅が大きい金額が結果を支配する場合があります。各特徴量を平均0・標準偏差1にそろえる標準化などを検討し、回数の違いも適切に反映できるようにします。ただし、すべての特徴量を同程度に扱うことが目的に合うかは、別に判断が必要です。
距離尺度も目的に合わせて選びます。数値の大きさの差を重視するのか、変動のパターンを重視するのかによって、適した非類似度は変わります。欠損値がある場合は、その原因と割合を確認し、補完などの処理によって距離が不自然にならないかを点検します。顧客番号のような識別用の数値は、値の近さに分析上の意味がない限り、距離を計算する特徴量には含めません。
外れ値は、背景を確かめてから扱います。入力ミスや単位の取り違えであれば訂正が必要ですが、実在する大口顧客のように、分析上意味のある少数例かもしれません。離れているという理由だけで機械的に削除せず、含めた場合と適切な処理をした場合で、統合の順番や群の特徴がどう変わるかを比べます。
クラスタ数は、樹形図と利用目的から決めます。0・1・4・6の例では、距離を示す高さ3の位置で樹形図を横に切ると、0と1の組、4と6の組の二群になります。高さ1と2での統合は済んでいて、高さ6での最後の統合には達していないためです。一群までの統合は全体の階層を表すための手順であり、実際の分類では途中の分割を使います。
統合距離が大きく跳ね上がる手前は、分割を考える手掛かりになります。ただし、その位置が常に唯一の正解とは限りません。候補となるクラスタ数ごとに、次の点を確認します。
- 各群を、購入傾向や画像の特徴など、分析目的に沿った言葉で説明できるか。
- 群の人数や件数が用途に合っているか。極端に小さな群にはどのようなデータが入っているか。
- 対象データや前処理を少し変えても、主要なまとまりが大きく崩れないか。
- 群平均法やウォード法などと比べて、最長距離法の結果を採用する理由を説明できるか。
最長距離法では、二群をまたぐ最大距離を求め、その値が最も小さい組から統合します。この仕組みと外れ値への感度を押さえたうえで、距離の設計と得られた群の解釈を確かめることが、分析や学習で使いこなすための要点です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月24日 | 4点の計算例と手法比較を加え、外れ値の影響と樹形図の説明を修正 |