

AIの初心者
「ラッソ回帰」って、どんな方法ですか?普通の回帰分析との違いを知りたいです。

AI専門家
たとえば、広さや築年数、駅までの距離から住宅価格を予測するとしよう。ラッソ回帰は予測式を学習しながら、一部の項目の係数をゼロにして、使う項目を絞り込める方法なんだ。
AIの初心者
係数がゼロになると、その項目を使わずに予測できるんですね。残った項目が、価格を決める本当の原因だと考えてよいですか?
AI専門家
そこは区別が必要だよ。選ばれるのは、今回のデータと設定で予測に使われた項目なんだ。原因まで特定できるわけではないけれど、予測式を簡潔にして、どの項目を使っているか確認しやすくなるよ。
ラッソ回帰(Lasso回帰)は、線形回帰にL1正則化を加え、説明変数の係数の一部をゼロにできる手法です。特徴量が多いデータから予測に使う変数を絞り込み、モデルの複雑さを抑えたいときに候補になります。
ただし、変数を減らせば必ず予測が当たるわけではありません。この記事では、係数がゼロになる仕組みとスパース性、リッジ回帰やElastic Netとの違い、標準化・交差検証を含む使い方を順に説明します。

ラッソ回帰とは:L1正則化で変数を選ぶ回帰モデル
回帰分析は、入力となる情報から数値を予測したり、その関係を調べたりする方法です。住宅価格を予測する場合、価格が「目的変数」、広さ・築年数・駅までの距離などが「説明変数」です。機械学習では、説明変数を「特徴量」と呼ぶこともあります。
重回帰分析では、各説明変数に係数を掛け、それらを足して予測値を求めます。係数は、ほかの説明変数を一定にしたとき、その変数の変化が予測値にどう反映されるかを表します。通常の最小二乗法は、実測値と予測値のずれの二乗の合計が小さくなるように係数を決めます。
ラッソ回帰は、この学習に「係数の絶対値の合計を大きくしすぎない」という条件を加えます。その結果、一部の係数がちょうどゼロになり、対応する変数は予測値の計算に寄与しなくなります。これがモデルの学習と同時に特徴量選択を行えるという特徴です。
たとえば、売上予測に価格、広告費、気温、店舗面積など多数の項目を入れている場合、係数が残った項目に注目して予測式を確認できます。ただし、どの項目が残るかはデータ、前処理、正則化の強さで変わります。「本当に重要な変数を必ず発見する装置」と捉えないことが大切です。
L1正則化の数式と過学習を抑える仕組み
ラッソ回帰の目的関数は、代表的には次のように表せます。
\(\displaystyle \min_{\beta_0,\boldsymbol{\beta}}\left\{\frac{1}{2n}\sum_{i=1}^{n}\left(y_i-\beta_0-\sum_{j=1}^{p}x_{ij}\beta_j\right)^2+\lambda\sum_{j=1}^{p}|\beta_j|\right\}\)式の前半は「予測のずれ」、後半は「係数を大きくすることへのペナルティ」です。ラッソ回帰は、この二つの合計を最小にする係数を探します。記号の意味は次のとおりです。
- \(n\):データ件数、\(p\):説明変数の数。
- \(y_i\):データの実測値、\(x_{ij}\):そのデータに含まれる各説明変数の値。
- \(\beta_j\):説明変数に掛ける係数、\(\beta_0\):予測の基準となる切片。
- \(\lambda \geq 0\):正則化の強さを決める値。通常、切片は正則化の対象に含めません。
\(\sum_{j=1}^{p}|\beta_j|\)は、係数ベクトルのL1ノルムです。原点からのマンハッタン距離と考えることもできます。係数が正でも負でも、その絶対値が大きいほどペナルティは大きくなります。なお、誤差項の定数倍や正則化パラメータの名前は実装によって異なるため、異なるソフトウェア間で値だけを比較しないようにします。
説明変数を増やすと、学習データの偶然のばらつきまで拾ってしまうことがあります。学習データではよく当たるのに、新しいデータでは誤差が大きい状態が「過学習」です。正則化は係数の自由な変動を抑え、学習データに合わせすぎることを防ぐために使います。
この調整では、学習データへの当てはまりをある程度犠牲にしても、未知のデータでの予測を安定させることを目指します。統計的には、係数の推定に偏りを加える代わりに、データの違いによる推定のばらつきを抑える考え方です。強く抑えすぎると必要な関係まで失うため、効果は検証データで確かめます。
なぜ係数がゼロになる?スパース性の意味
スパース性とは、係数などの多くの要素がゼロで、非ゼロの要素が少ない性質です。ラッソ回帰では、単に係数を小さくするだけでなく、一部をちょうどゼロにする点が重要です。ゼロにする対象は説明変数の係数であり、観測データそのものではありません。
L1正則化に使う絶対値の関数は、ゼロの位置で折れ曲がっています。この形により、ある変数を加えて予測誤差を少し改善するより、その係数をゼロにしてペナルティを減らすほうが目的関数を小さくできる場合があります。結果として、ゼロが最適な値として選ばれます。
この動きは、ほかの係数を固定して一つの係数を更新する場面で理解しやすくなります。説明変数を中心化し、二乗和の尺度をそろえた場合、その変数と残差との結びつきが一定のしきい値以下なら係数をゼロにし、超えていれば絶対値をしきい値分だけ縮めます。これを「ソフトしきい値処理」と呼びます。変数同士に相関がある一般のデータでは、各変数の状態を繰り返し更新して解を求めます。
係数が少数だけ残ると、何を使って予測しているかを確認しやすくなります。選ばれた変数だけで運用できる仕組みにすれば、推論時の計算やデータ収集の負担を減らせる場合もあります。ただし、学習中には候補変数を評価する必要があり、スパースな解が得られるから学習も必ず速いとは限りません。

図の棒は係数、基準線上の点はゼロを表します。同じ位置の特徴量を左右で対応させた模式図で、実際の推定結果ではありません。
正則化の強さはどう決める?
正則化係数\(\lambda\)は、予測への当てはまりと係数の縮小のバランスを決めます。\(\lambda=0\)では正則化項がなくなり、目的関数は通常の最小二乗法と同じになります。
| 正則化の強さ | モデルに起こりやすい変化 | 確認する点 |
|---|---|---|
| 弱い | 係数の縮小が小さく、多くの変数が残りやすい | 学習時と検証時の誤差に大きな差がないか |
| 適度 | 一部の係数がゼロになり、簡潔さと予測性能の両立を目指せる | 未知のデータへの誤差と、残る変数の数 |
| 強すぎる | 必要な係数まで縮み、すべてゼロになることもある | 単純すぎて関係を捉えられない過少適合がないか |
切片を学習し、係数がすべてゼロになった場合、モデルは入力によらず同じ値を予測します。上の二乗誤差を使う設定では、その値は学習データの目的変数の平均です。変数を大幅に減らしても、この状態では住宅ごとの価格差を捉えられません。
実際には、複数の強さを試して交差検証で予測誤差を比較します。データをいくつかに分け、一部を検証用、残りを学習用として入れ替えながら評価する方法です。最小の誤差だけでなく、そのばらつきや変数数も見ると、性能が近い候補の中から運用しやすいモデルを選びやすくなります。
正則化を強くすると全体として係数の縮小が進みますが、相関した説明変数がある場合、個々の係数の大きさや非ゼロ係数の数が常に単調に変わるとは限りません。棒が順番に消える図は、方向性を理解するための単純化です。

ラッソ回帰・リッジ回帰・Elastic Netの違い
ラッソ回帰とよく比較されるのが、L2正則化を使う「リッジ回帰」です。さらに、L1正則化とL2正則化を組み合わせた「Elastic Net(エラスティックネット)」もあります。いずれも係数を調整する方法ですが、変数を絞るか、複数の変数を残して安定させるかに違いがあります。
| 手法 | 正則化 | 係数の特徴 | 選択の目安 |
|---|---|---|---|
| 通常の最小二乗法 | なし | 誤差を小さくするように推定し、変数削減の仕組みは持たない | 変数が比較的少なく、基準となるモデルを作りたい |
| ラッソ回帰 | L1:係数の絶対値の和 | 一部の係数をちょうどゼロにできる | 予測に使う変数を絞りたい |
| リッジ回帰 | L2:係数の二乗の和 | 係数を縮めるが、通常はちょうどゼロにはしない | 多くの変数の情報を残し、推定を安定させたい |
| Elastic Net | L1とL2の組み合わせ | 係数のゼロ化と、相関した変数を一緒に残す傾向を併せ持つ | 変数選択をしつつ、相関の強い特徴量も扱いたい |
住宅価格の例では、「延べ床面積」と「居室面積」のように似た情報を持つ変数があると、ラッソ回帰は片方を残してもう片方をゼロにすることがあります。データを少し変えるだけで選ばれる側が入れ替わる場合もあります。リッジ回帰は係数を複数の変数に分散させやすく、Elastic Netは相関した変数群を扱いながら変数削減も狙える方法です。
少数の変数が強い予測力を持つと考えられるときにはラッソ回帰が候補になります。一方、多数の変数がそれぞれ少しずつ役立つ場合には、リッジ回帰のほうがよい予測をすることもあります。Elastic Netも含め、同じデータ分割と評価指標で比較するのが基本です。
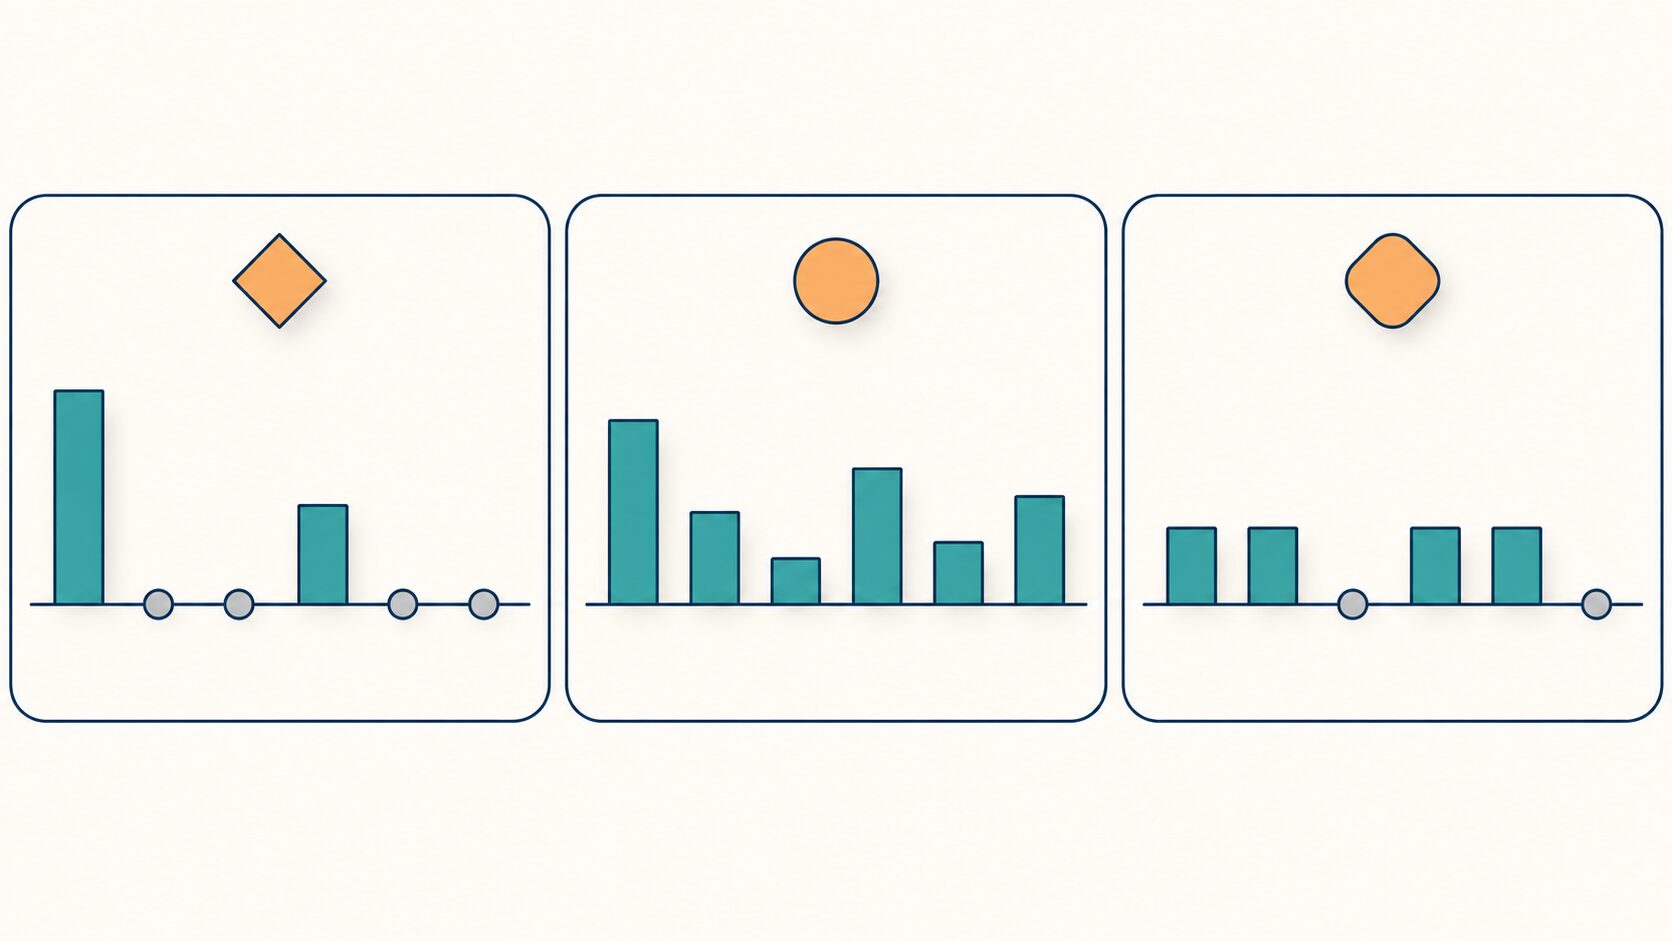
図は左からラッソ、リッジ、Elastic Netのイメージです。残る変数の数や組み合わせが、この図のとおりに決まるわけではありません。
住宅価格の例で見る変数選択
広さ、築年数、駅までの距離、部屋数、物件管理番号から住宅価格を予測する場面を考えます。広さと部屋数は似た情報を含み、管理番号は通常、予測に使う意味を事前に検討すべき識別子です。こうした項目を無条件に増やすと、説明しにくい関係まで学習するおそれがあります。
次の数値は、仕組みを説明するための架空の係数です。説明変数と目的変数の両方を平均ゼロ・標準偏差1にそろえた想定で、実際の住宅価格の推定値や相場を表すものではありません。
| 説明変数 | 正則化なしの係数例 | ラッソ回帰の係数例 | この例での扱い |
|---|---|---|---|
| 広さ | 0.70 | 0.58 | 係数を縮めて残す |
| 築年数 | −0.35 | −0.24 | 負の係数を縮めて残す |
| 駅までの距離 | −0.20 | −0.09 | 負の係数を縮めて残す |
| 部屋数 | 0.12 | 0 | 予測式から外れる |
| 物件管理番号 | 0.03 | 0 | 予測式から外れる |
この例では、ラッソ回帰の予測式に広さ・築年数・駅までの距離が残ります。部屋数がゼロになっても、「部屋数は住宅価格と無関係」と結論づけることはできません。広さがすでに似た情報を表しているため、今回の設定では追加しても誤差の改善が小さかった可能性があります。
また、意味のない識別子がいつも自動で消えるとは限りません。偶然の相関やデータの偏りによって残ることもあるため、管理番号のような列を使う妥当性は、学習前に人が確認します。特徴量選択は、データの意味を理解する作業を置き換えるものではありません。
ラッソ回帰を使う手順:標準化と交差検証
実務では、モデルを当てはめる前後の処理が結果を左右します。特に重要なのは、特徴量の尺度をそろえることと、評価用データの情報を学習に混ぜないことです。次の順序で進めると、予測性能を過大評価しにくくなります。
-
予測対象と利用できる情報を決めます。何を、いつの時点で予測するかを明確にし、予測時には入手できない情報が特徴量に混ざっていないか確認します。
-
最終評価用のテストデータを先に分けます。将来の売上を予測するなら時間の前後関係を守り、同じ顧客の記録が何度もあるなら顧客単位の分割を検討します。
-
欠損値の補完やカテゴリ変数の数値化を設計します。地域名などは適切に符号化し、単なる番号の大小に意味があるように扱わないことが基本です。変換方法は学習部分で決めます。
-
数値の特徴量を標準化します。平均を引いて標準偏差で割る方法が代表例です。平均との差や標準偏差は学習部分から計算し、検証部分にはその値を適用します。定数の列や疎なデータ、0と1の列では前処理の設定も確認します。
-
交差検証で正則化の強さを選びます。前処理とモデルを一続きの処理にし、分割ごとに学習部分だけで前処理を学習します。MAEやRMSEなど、目的に合う予測誤差で候補を比較します。
-
選んだ設定でテスト以外のデータを使って学習し直し、最後にテストデータで評価します。リッジ回帰などの比較対象と同じ条件で確認し、残った変数の数や選択の安定性も記録します。
標準化が必要になる理由は、L1正則化が係数の大きさに直接かかるからです。たとえば距離をメートルで表すかキロメートルで表すかによって、同じ予測をするための係数の大きさは変わります。そのままでは、情報の有用性だけでなく単位の選び方がペナルティに影響します。
なお、テストデータでよく当たるまで設定を選び直すと、そのデータも実質的に調整に使ったことになります。最終評価用のデータは判断の最後まで分けておきます。交差検証の各分割の外側で全データを標準化してしまう処理も、情報漏洩を起こすため避けます。
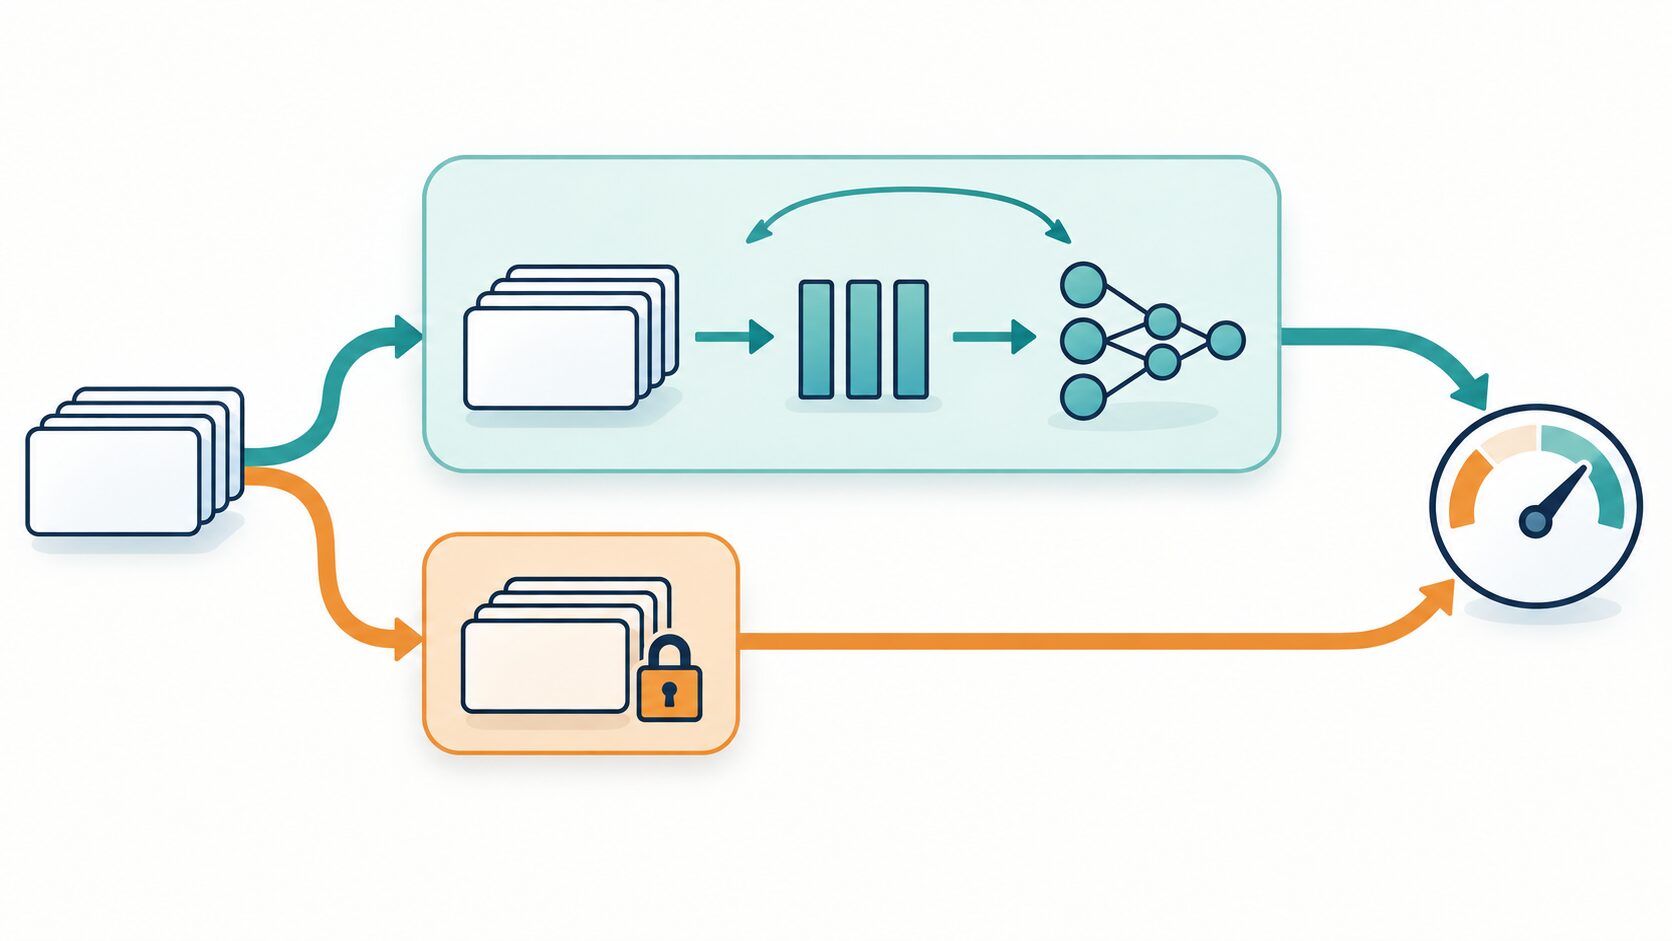
図の上側は学習・検証、下側は最後まで分けておくテストデータの流れです。標準化を含む前処理も、学習・検証の分割に合わせて扱います。
計算方法:微分できない点をどう扱う?
L1正則化で使う絶対値は、ゼロ以外では微分できますが、ゼロで通常の微分ができません。そのため、最小二乗法のように微分した式を連立させるだけでは、一般のラッソ回帰の解を同じ形で求められません。
ただし、これは「最適な解を求められない」という意味ではありません。二乗誤差とL1正則化の和は凸な目的関数であり、微分できない点を扱う最適化手法が使えます。代表的なのが、次の二つです。
- 座標降下法:ほかの係数を固定し、一つの係数ずつ更新する処理を繰り返します。係数をゼロにするソフトしきい値処理と相性のよい方法です。
- 近接勾配法:滑らかな誤差項を減らす更新と、L1正則化に対応するソフトしきい値処理を組み合わせます。
どちらも反復計算を使い、目的関数の変化や最適性の指標などが十分小さくなったところで停止します。一般に解析式を一度計算して終わる方法ではありませんが、必要な精度まで解を求めることができます。係数の解が一意かどうかは説明変数の構造にも依存します。
計算量は、データ件数、変数数、変数同士の相関、試す正則化の強さの数、停止条件などで変わります。「反復計算だから常に遅い」「リッジなら常に簡単」とは一概に言えません。大規模なデータでは、近い設定の解を次の初期値に使う方法や、疎なデータ構造を扱う実装が役立つ場合があります。
計算が収束しないという警告が出た場合は、そのまま結果を採用せず、特徴量の尺度、反復回数の上限、許容誤差などを確認します。係数が十分に安定したかどうかも、モデルを評価する前提になります。
ラッソ回帰が役立つ分野と使い分け
ラッソ回帰は、候補となる説明変数が多く、比較的少ない変数で連続値を予測したい場面で役立ちます。データ件数より特徴量が多い場面でも候補になりますが、データが少なくても正しい変数を必ず選べるわけではありません。元の項目を減らせるという性質を、目的に合わせて使うことが大切です。
| 分野 | 考えられる活用例 | 使うときの確認点 |
|---|---|---|
| 販売促進・需要予測 | 価格、広告費、天候などから販売数量や購入金額を予測する | 季節性や将来の予測時点で使える情報を考慮する |
| 医療・生命科学の研究 | 多数の測定項目から、連続値の検査指標や治療反応を予測する候補を絞る | 研究上の変数選択だけで診断の妥当性や治療効果を確定しない |
| 金融・経済の分析 | 複数の指標から連続値の収益率や損失額をモデル化する | 時間順の検証を行い、過去の関係が将来も続くと決めつけない |
| 画像・自然言語の特徴量分析 | 抽出済みの画像特徴や単語の特徴量から、数値のスコアを予測する | 特徴量の作り方、疎性、非線形な関係の有無を確認する |
一方、「病気かどうか」「購入するかどうか」のようにカテゴリを予測する課題は分類です。標準的なラッソ回帰をそのまま使うのではなく、たとえばL1正則化付きロジスティック回帰のように、分類に合った損失関数を使う方法を検討します。正則化の考え方を共有していても、予測する対象とモデルは区別します。
変数が多いことだけで採用を決めず、予測式を簡潔にしたいのか、予測誤差を小さくしたいのか、収集する項目を減らしたいのかを明確にすると、評価基準を選びやすくなります。
使う前に知っておきたい注意点
ラッソ回帰の結果を読むときは、係数がゼロかどうかだけで判断しないことが重要です。特に次の点は、使いどころと限界を理解するうえで押さえておきたいポイントです。
-
相関した変数の選択は揺れることがあります。似た情報を持つ項目のどちらが残ったかを過度に重視せず、データ分割を変えたときの選択頻度や、Elastic Netとの違いも確認します。
-
L1正則化は外れ値対策そのものではありません。通常のラッソ回帰の誤差項は二乗誤差なので、大きく外れた観測値が学習に強く影響する場合があります。係数をゼロにすることと、その観測値を取り除くことは別です。
-
残った係数にも縮小の影響があります。正則化なしの推定値と同じ意味で効果の大きさを読み取ったり、変数選択を行った事実を無視して通常の有意性検定を適用したりしないようにします。
-
元の特徴量に対して線形なモデルです。価格と需要の関係が曲線になる、広告の効果が季節で変わるといった構造は、特徴量の変換や交互作用を入れなければ十分に表現できないことがあります。必要に応じて別のモデルとも比較します。
-
予測への寄与と因果関係は異なります。ゼロになった変数も現実には関係があるかもしれず、残った変数を操作すれば結果が変わるとも限りません。施策の効果を知りたい場合は、実験設計など別の検討が必要です。
このように、ラッソ回帰は変数を絞るための有用な選択肢ですが、データの品質や検証設計を代わりに判断してくれるものではありません。予測誤差、残る変数の意味、データを変えたときの安定性を合わせて確認します。
まとめ
ラッソ回帰は、二乗誤差にL1正則化を加えることで係数の一部をゼロにし、スパースな予測式を作る手法です。説明変数が多いときに、予測に使う項目を絞り、モデルを確認しやすくする効果が期待できます。
使う際には、特徴量の尺度をそろえ、交差検証で正則化の強さを選び、独立したテストデータで性能を確かめます。変数を多く残して安定させたい場合はリッジ回帰、相関した特徴量を扱いながら変数選択もしたい場合はElastic Netも比較対象になります。
係数がゼロになった理由をデータと設定の中で読み取り、予測性能と簡潔さの両方を評価することが、ラッソ回帰を適切に使う基本です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月2日 | 初回公開 |
| 2026年9月26日 | 係数がゼロになる仕組みを補足し、外れ値の説明と手法比較を修正 |