
画像認識の鍵、フィルタの役割とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「フィルタ」って、画像から特徴を見つけるためのものですよね?どんな仕組みなんですか?

AI専門家
画像の小さな範囲に、重みと呼ばれる数値を掛けて足し合わせるんだ。重みの並び方によって、明るさが変わる境界を取り出したり、画像をなめらかにしたりできるよ。
AIの初心者
同じ画像でも、使う重みを変えると、取り出せる情報が変わるんですね。それだけで何が写っているかも分かるんですか?
AI専門家
まず分かるのは、どの場所にどんな特徴があるかだよ。「猫」や「車」と判断するには、その特徴を組み合わせる後の処理も必要なんだ。フィルタを少しずつ動かす計算から見ていこう。
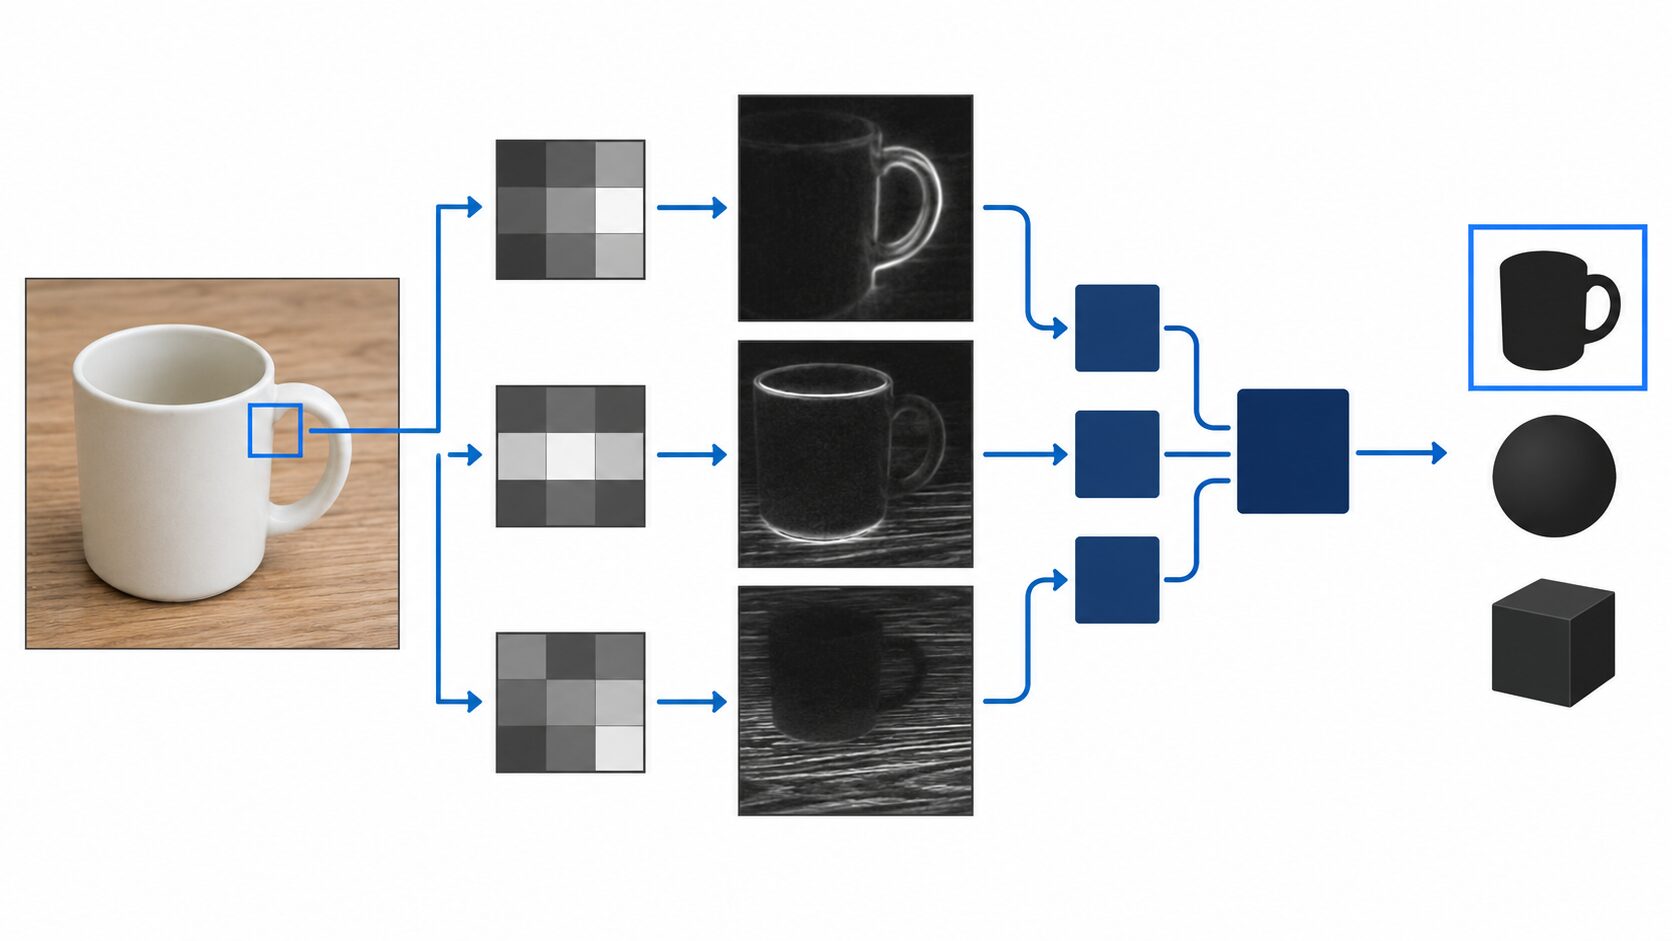
画像認識におけるフィルタとは、画像の輪郭、色の変化、模様などの特徴を取り出すために使う仕組みです。特に畳み込み処理では、数値を並べた小さな配列をフィルタとして使い、画像の各部分に同じ計算を繰り返します。
写真のぼかしも、AIによる画像認識も、画像に含まれる数値を処理する点では共通しています。ただし、見た目を整える画像処理と、何が写っているかを判定する画像認識では、処理の目的が異なります。この記事では、フィルタの意味と計算方法から、種類ごとの効果、CNNでの学習、使う際の注意点まで順に説明します。
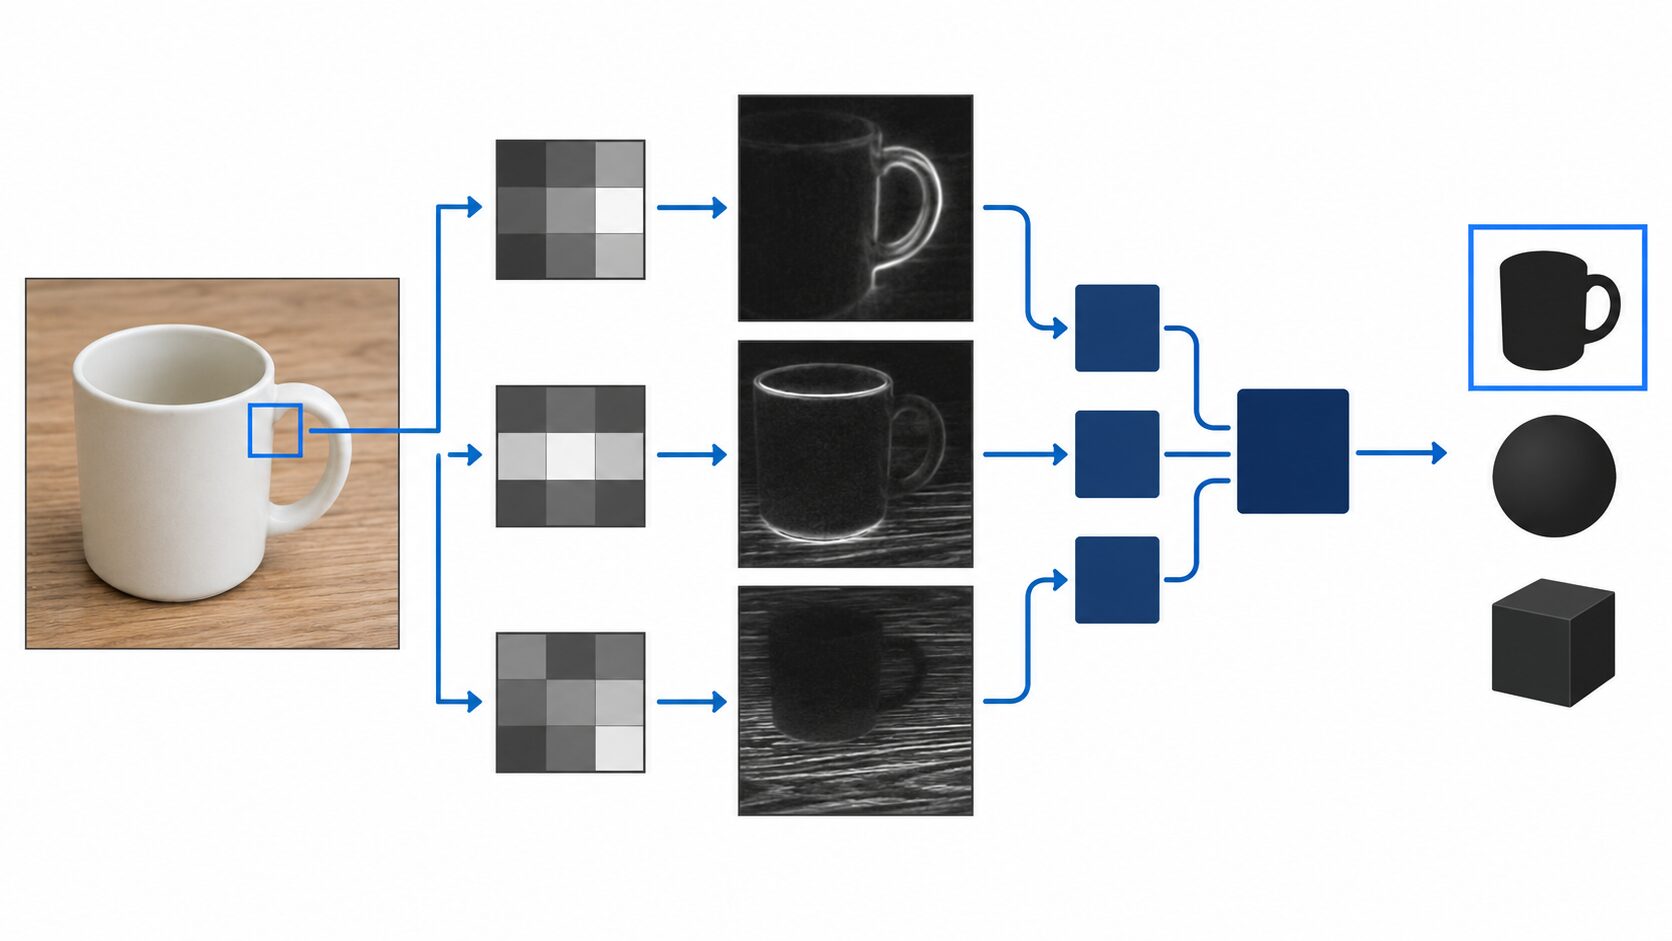
フィルタが担うのは、認識に使う手掛かりを取り出す部分です。取り出した特徴をどう組み合わせて最終的な判定につなげるかまで含めて、画像認識の仕組みを捉えると理解しやすくなります。
フィルタとは:画像の特徴を捉える重み
デジタル画像は、画素という小さな点の集まりです。白黒の濃淡で表すグレースケール画像では、各画素に明るさを示す数値が入っています。例えば8ビットの画像では、一般に0が黒、255が白で、その間の値が灰色の濃淡を表します。コンピュータは、この数値の並びとして画像を扱います。
畳み込みに使うフィルタは、近くにある複数の画素へ掛ける重みの集まりです。縦3個、横3個の数値を並べた3×3の表なら、画像の3×3画素の範囲と重ねて使います。それぞれの重みは、対応する画素をどの程度計算に反映させるかを決めます。正の値だけでなく、0や負の値も使います。
例えば、9個の画素を同じ割合で足し合わせれば、局所的な明るさを平均できます。一方、片側の画素に正の重み、反対側に負の重みを置けば、両側の明るさの差を取り出せます。つまり、フィルタが捉える特徴は、単に数字の大きさだけでなく、重みの正負と位置関係によって変わります。
この重みの配列は「カーネル」とも呼ばれます。画像処理ではフィルタとカーネルをほぼ同じ意味で使う場面がありますが、フィルタは処理そのものを指すこともある、より広い言葉です。例えば、周囲の画素の中央値を選ぶメディアンフィルタは、固定した重みを掛けて足す計算では表せません。ここでは、まず畳み込みに使う重みの配列を中心に扱います。
計算結果を画像上の位置に対応させて並べると、その特徴への反応を示す数値のまとまりができます。CNN(畳み込みニューラルネットワーク)では、こうした出力を特徴マップと呼びます。これは「どこで、どの程度反応したか」を表すもので、その時点で物体名が決まるわけではありません。また、出力には負の値や元の画素値の範囲を超える値が含まれることがあり、そのまま表示用の画像の明るさになるとは限りません。
畳み込み処理の仕組み:掛けて足してずらす
畳み込み処理では、画像の局所領域とフィルタの対応する値を掛け、すべて足し合わせて出力の1点を作ります。具体例として、画像の3×3画素の範囲を取り出し、中心だけが9、残りの8画素が0だった場合を考えます。フィルタの重みをすべて9分の1にすると、計算は次のようになります。
\(9\times\frac{1}{9}+8\times\left(0\times\frac{1}{9}\right)=1\)最初の項は中心の画素と重みの積、次の項は残り8画素の積の合計です。画像から取り出した範囲を表にすると、以下の並びになります。
| 0 | 0 | 0 |
| 0 | 9 | 0 |
| 0 | 0 | 0 |
9個の値にそれぞれ9分の1を掛けて足すので、これは9画素の平均を求める処理です。出力の1点は1になります。中心の9だけを見るのではなく、周囲の0も含めた平均になるため、局所的な明るさの突出がならされます。
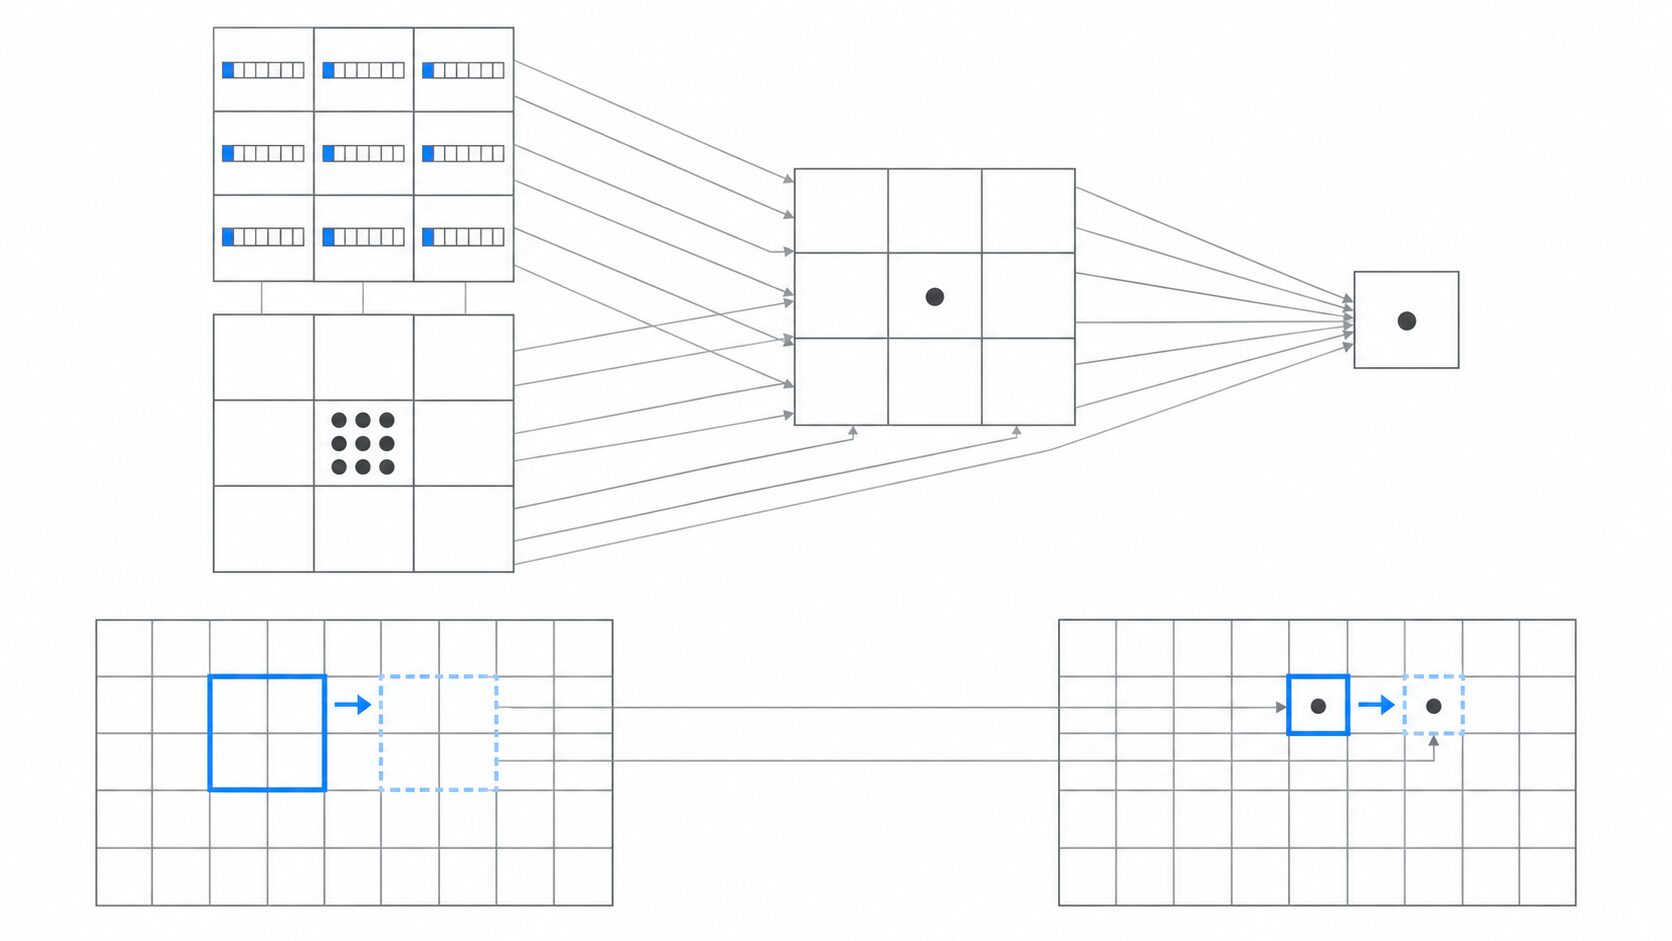
この1回の計算で、画像全体の処理が終わるわけではありません。次にフィルタを右へずらし、新しい3×3画素に同じ重みを掛けて足します。横方向の計算が終わったら縦方向にも移動し、出力を順に並べます。移動先では入力値の組み合わせが変わるので、出力も変わります。同じ重みを画像内の各位置で繰り返し使うことが、畳み込みの大きな特徴です。
フィルタを動かす幅はストライドと呼びます。ストライドが1なら1画素ずつ、2なら2画素ずつ進みます。移動幅を大きくすると一般に出力の縦横のサイズは小さくなり、細かな位置の情報も失われやすくなります。
画像の端には、その外側に対応する画素がありません。そこで、周囲に0などの値を補うパディングを使うことがあります。例えば、5×5画素に3×3のフィルタをストライド1で適用すると、パディングなしでは出力は3×3です。周囲に1画素ずつ補えば、出力を5×5にできます。端を0で埋めるか、近くの値を延長するかといった補い方によって、境界付近の出力も変わります。
なお、数学でいう畳み込みはカーネルを反転して計算しますが、CNNで「畳み込み」と呼ぶ演算は、通常、反転しない相互相関です。まずは「対応する値を掛けて足し、同じ重みで位置をずらす」という流れを理解すれば十分です。今回の平均化カーネルは反転しても同じ並びなので、この用語の違いによって計算結果は変わりません。
フィルタの種類と効果の違い
フィルタは、画像から何を取り出したいか、どのような変化を加えたいかに応じて選びます。ぼかし、輪郭検出、鮮鋭化はよく使われる処理ですが、目的も出力の意味も異なります。
| 種類 | 狙う変化 | 主な用途 | 注意点 |
|---|---|---|---|
| ぼかし:平均化、ガウシアン | 近くの画素を平均して細かな変動をなだらかにする | ざらつきの低減、輪郭検出の前処理 | 細い線や小さな傷など、必要な特徴も弱まる |
| 輪郭検出:Sobelなど | 明るさが変化する位置や方向を取り出す | 形状や境界の手掛かりの抽出 | ノイズや影の境界にも反応し、物体の輪郭だけが得られるとは限らない |
| 鮮鋭化 | 元画像の細部や境界付近のコントラストを強める | 写真や文書画像の細部の強調 | ノイズや境界周辺の不自然な明暗も目立ちやすい |
| 方向・周期に反応するフィルタ:Gaborなど | 特定方向の線や一定間隔の明暗変化を取り出す | 木目、織物、レンガなどの模様の分析 | 模様の向きや間隔が変わると反応も変わる |
平均化フィルタは、範囲内の画素を同じ重みで平均します。ガウシアンフィルタも周囲の値を使ってなめらかにしますが、中心に近い画素ほど大きな重みを与えます。どちらも細かな明るさの変動を抑える一方で、画像に残したい細部までぼける可能性があります。
輪郭検出は明るさの変化を取り出す処理、鮮鋭化は元画像の細部を強める処理です。例えばSobelフィルタでは、左右または上下の明るさの差に反応するカーネルを使います。左右の変化を調べるものは縦方向に延びる境界に反応しやすく、上下の変化を調べるものは横方向に延びる境界に反応しやすくなります。両方向の結果を組み合わせると、境界の強さを調べられます。
ここで重要なのは、明るい場所なら必ず強く反応するわけではないことです。係数の合計が0になる輪郭検出カーネルでは、対象範囲の画素がすべて同じ明るさなら、正と負の寄与が打ち消し合って出力は0になります。明るさの差がある場所で反応し、暗い側から明るい側へ変わるのか、その逆なのかによって、出力の符号が変わる場合もあります。
一方、鮮鋭化では、元の画像に細部を強調する成分を加えるなどして、輪郭や質感を目立たせます。中心が正、周囲が負のカーネルでも、係数の組み合わせによって輪郭検出になったり鮮鋭化になったりするため、数字の配置だけでなく処理全体の意味を確認する必要があります。
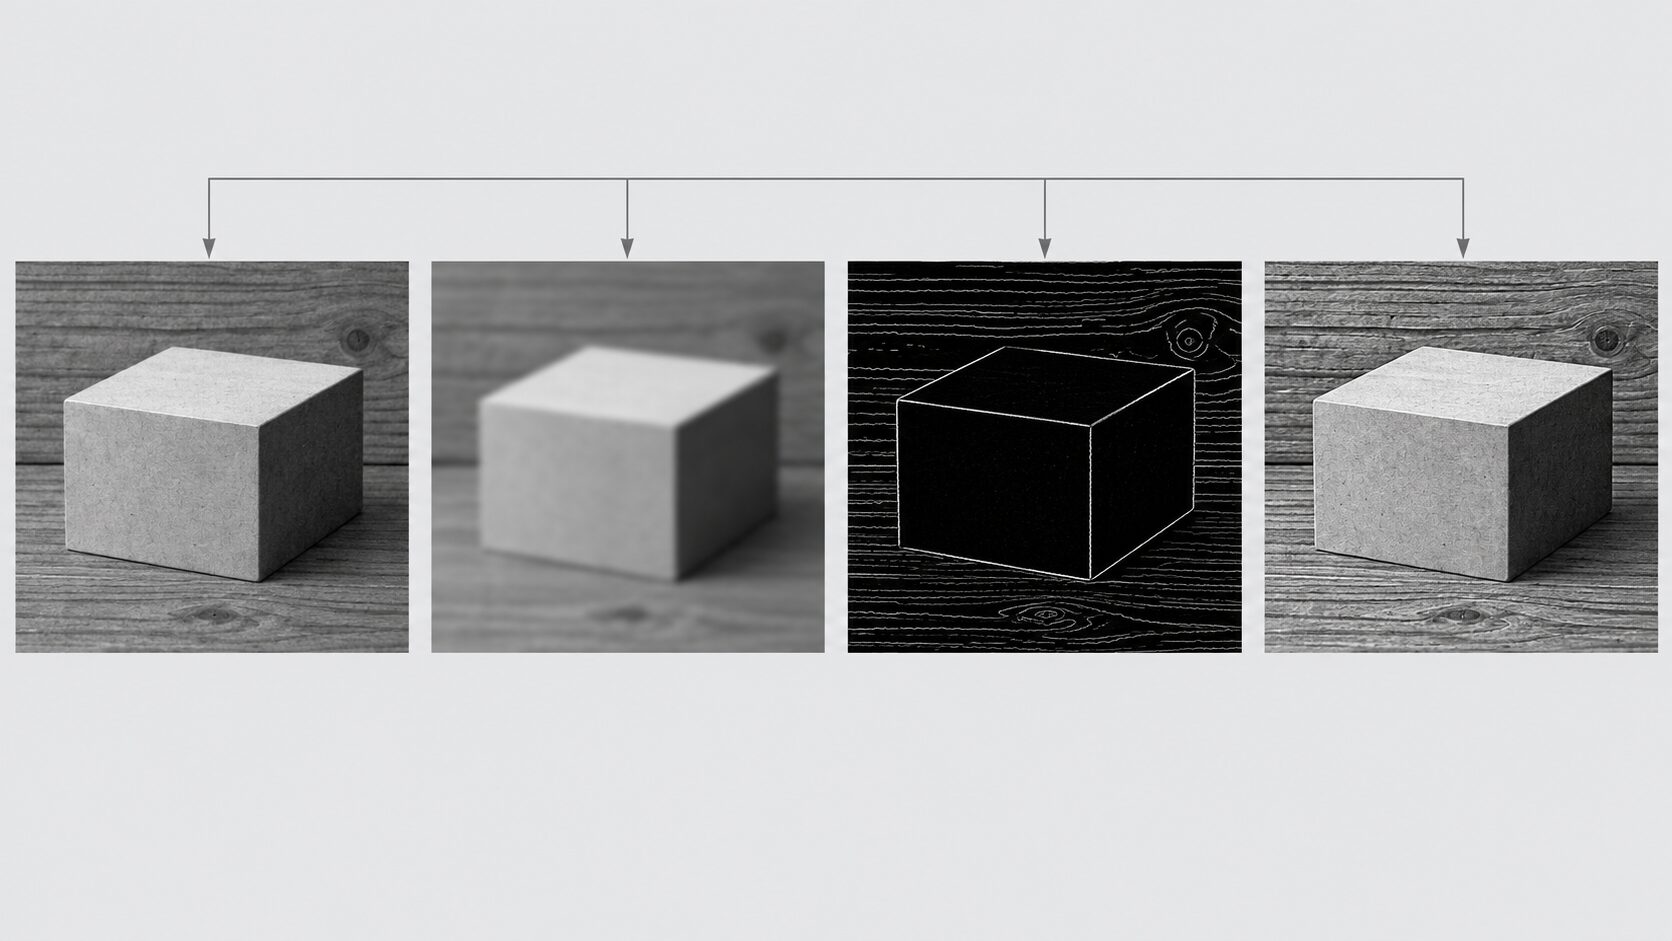
効果を比べるときは、画像全体がなめらかになるのか、境界への反応が取り出されるのか、元画像の細部が強まるのかに注目してください。見た目がくっきりしたという理由だけでは、認識に役立つ情報が増えたかどうかは判断できません。
木目やレンガのような模様を調べる場合は、線の方向に加えて、明暗が繰り返す間隔も手掛かりになります。方向や周期の異なるフィルタを複数使うと、模様の性質を比べられます。ただし、木目を検出するフィルタが木の形をしているわけではありません。フィルタの数値の見た目と、検出対象の形が、そのまま一致するとは限らない点に注意しましょう。
CNNではフィルタをどのように学習するか
平均化やSobelなどの固定フィルタでは、人が目的に合わせて係数を決めます。これに対してCNNでは、学習データを使い、課題に役立つようにフィルタの重みを調整します。人が「この線を検出する」と一つずつ指定する代わりに、最終的な予測の誤りを減らす方向へ、ネットワーク内の重みを更新していきます。
教師ありの画像分類を例にすると、学習は次の流れで進みます。
- 画像と、「猫」「犬」などの正解ラベルを用意します。
- 画像をCNNに入力し、畳み込みなどの処理を経て、各クラスの予測を出します。
- 予測と正解の食い違いを、損失という数値で評価します。
- 誤差逆伝播によって、各重みの変化が損失にどう影響するかを計算します。
- 最適化の手法を使って重みを少しずつ更新し、複数の画像で処理を繰り返します。
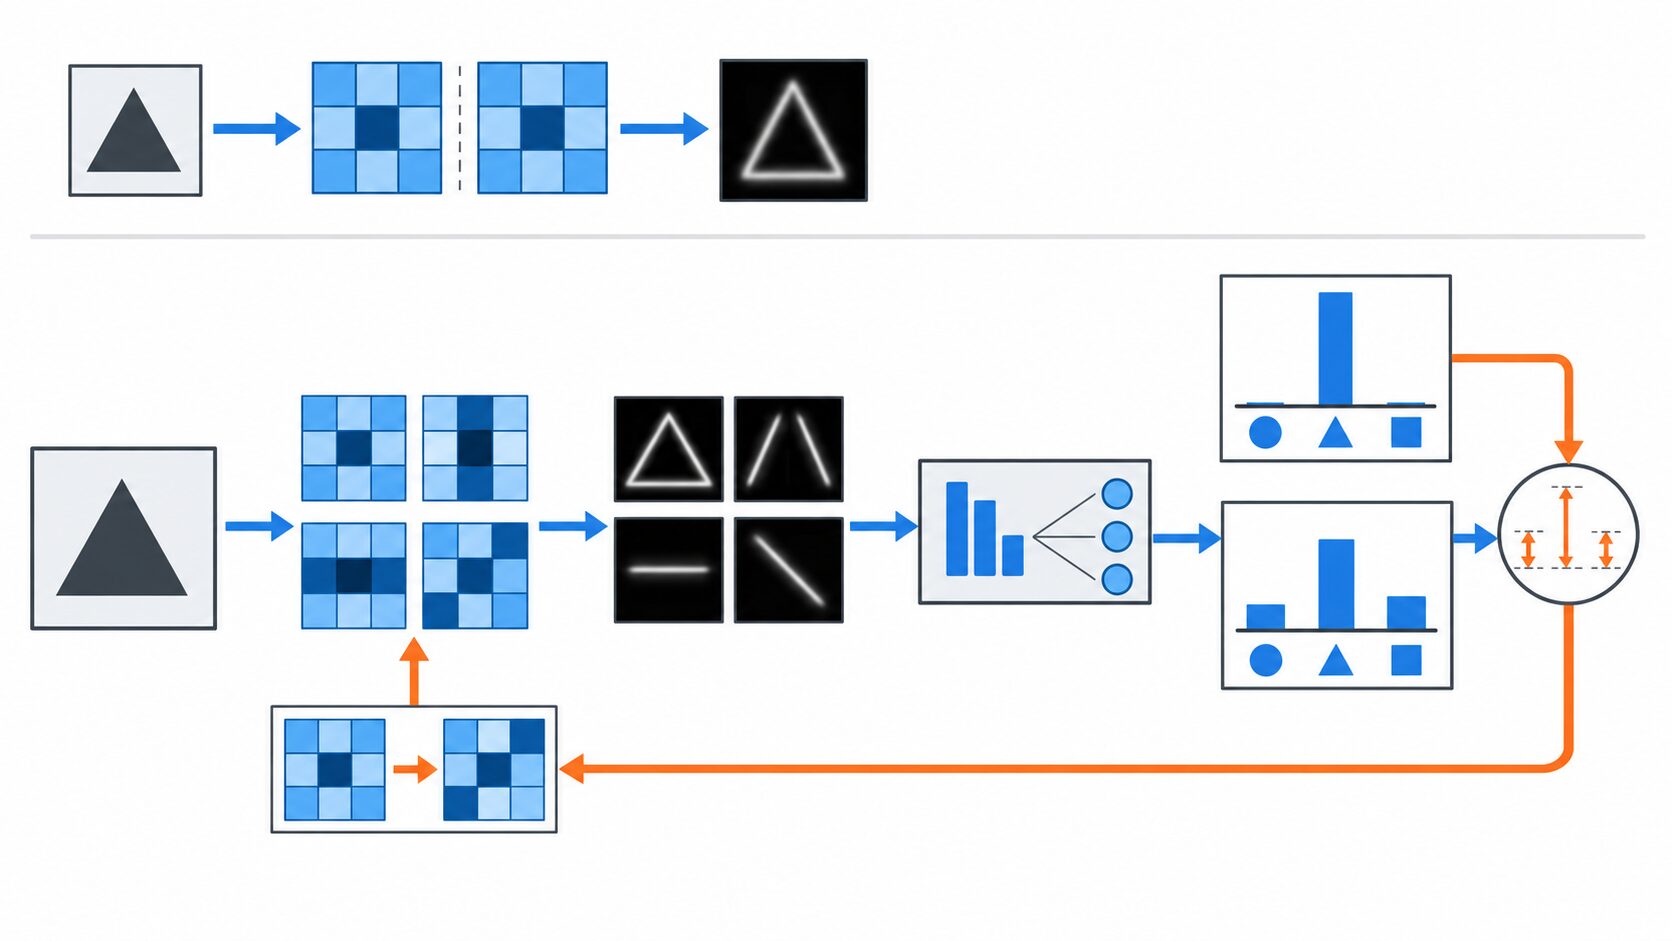
学習では予測から重みの更新へと処理がつながりますが、学習済みモデルで画像を判定する推論時には、通常、その重みを固定して使います。新しい画像を入力するたびにフィルタが自動で学び直すわけではありません。
CNNの1つの層には、一般に複数のフィルタがあります。それぞれが異なる特徴マップを作り、次の層がその情報を組み合わせます。浅い層で捉えた局所的な明暗や色の変化を、後の層でより広い範囲のパターンとして扱えるため、単一のフィルタだけでは表しにくい特徴も利用できます。ただし、各フィルタに人が理解しやすい名前や役割が必ず割り当てられるわけではありません。
色画像では、赤・緑・青のRGBなど、複数のチャネルがあります。通常の畳み込みでは、フィルタも入力チャネルごとに重みを持ち、位置とチャネルの両方について積を足し合わせます。例えばRGB画像に使う3×3のフィルタ1個なら、重みは3×3×3個です。これらを合計し、必要に応じてバイアスという調整値を加えて、1つの出力チャネルを作ります。
畳み込み以外の処理も大切です。ReLUなどの活性化関数は非線形性を加え、単純な重み付き和の繰り返しだけでは表せない関係を扱えるようにします。プーリングは領域内の最大値や平均値などで特徴を要約する処理で、畳み込みとは役割が異なります。最後に特徴を集約し、クラスごとのスコアを計算するなどの後段の処理を経て、画像全体の分類につなげます。
固定フィルタと学習するフィルタには、それぞれ使いどころがあります。目的が明確なノイズ低減などでは固定フィルタが扱いやすく、複雑な見た目の違いを捉える課題では学習した特徴が役立ちます。両者を組み合わせることもでき、「手で設計したものは低精度、学習したものは必ず高精度」とは言えません。
また、データ量を増やすだけで最適な重みや高い認識精度が保証されるわけではありません。学習画像の背景や撮影条件に偏りがあると、対象物以外の手掛かりに頼ることがあります。学習データに適応しすぎる過学習にも注意し、学習に使っていない画像で、実際の利用条件に合う性能を確かめることが必要です。
フィルタの活用例と前処理の注意点
フィルタは、画像を認識しやすい形へ整えたり、判定に使う特徴を取り出したりする工程で使われます。用途によって必要な情報が違うため、同じ処理をすべての画像に当てはめるのではなく、何を残して何を抑えたいかを先に決めることが大切です。
- 工業製品の検査:表面の傷や模様の乱れを捉えるために、方向性のある変化や局所的な濃淡を調べます。細い傷を見つけたい場合は、その特徴がぼかしで消えないようにする必要があります。
- 文書画像の文字認識:文字の線を読み取りやすくするために、背景のざらつきを抑えたり、線と背景の違いを強めたりします。小さい文字では、処理による線の欠落やにじみが認識に影響します。
- 自動運転の周辺認識:車載画像から車線、歩行者、車両などの手掛かりを得る工程で、学習した特徴が使われます。フィルタだけで周囲の状況を判断するわけではなく、位置や時間の情報を扱う処理などと組み合わせます。
- 医療画像の解析支援:濃淡、境界、質感などを解析するための特徴抽出に利用されます。取り出した特徴は解析システムの一部であり、フィルタの出力そのものが診断になるわけではありません。
よく使われる前処理の流れに、「ぼかしで細かなノイズを抑えてから、輪郭を検出する」というものがあります。輪郭検出は明るさの急な変化に反応するので、小さなノイズにも反応しやすくなります。先に軽くなめらかにすることで、ノイズによる余分な反応を減らせる場合があります。
ただし、ノイズを抑える処理は、残したい特徴も弱める可能性があります。細い傷、文字の細い線、小さな模様などは、ノイズと同じく細かな変化として扱われるためです。輪郭検出の前にぼかす方法でも、対象の大きさに対してぼかしが強すぎれば、必要な境界が見えにくくなります。
結果を左右するのは、フィルタの種類だけではありません。カーネルが覆う範囲、重みの設定による処理の強さ、複数の処理を適用する順序も関係します。特に途中でしきい値処理や値の切り詰めなどを行う場合は、順序によって残る情報が変わります。まず処理なしの画像を基準にし、設定を少しずつ変えて比較すると、何が効果を生んでいるかを確認しやすくなります。
CNNへ入力する前にフィルタを使う場合は、学習時と推論時の前処理条件をそろえることも重要です。学習では鮮明な画像を使い、実運用だけで強いぼかしを加えると、モデルが想定していない見た目になることがあります。処理後の画像が見やすいかだけでなく、目的に合う検証画像を使い、傷の見逃しや文字の読み違いなどが実際に減るかを評価してください。
フィルタの可視化で分かることと限界
フィルタの働きを調べるときは、数値を色や濃淡に置き換えて表示する可視化が役立ちます。ただし、フィルタの重みを見ることと、画像を入力した後の特徴マップを見ることは別です。何を表示しているのかを区別すると、図から読み取れる範囲が明確になります。
| 可視化する対象 | 表示する内容 | 確認できること |
|---|---|---|
| フィルタの重み | 係数の大きさ、正負、位置関係 | どのような局所的な変化に反応しそうかを考える手掛かり |
| 特徴マップ | ある入力画像を処理したときの位置ごとの出力 | その画像のどの場所で強い反応や弱い反応が生じたか |
例えば、左右で正負が分かれた重みなら、左右方向の明るさの差に反応する可能性を読み取れます。一方、特定の写真を入力した特徴マップを見ると、被写体の境界や背景の模様など、実際にどこで反応が起きたかを調べられます。同じフィルタでも、入力画像が変われば特徴マップは変わります。
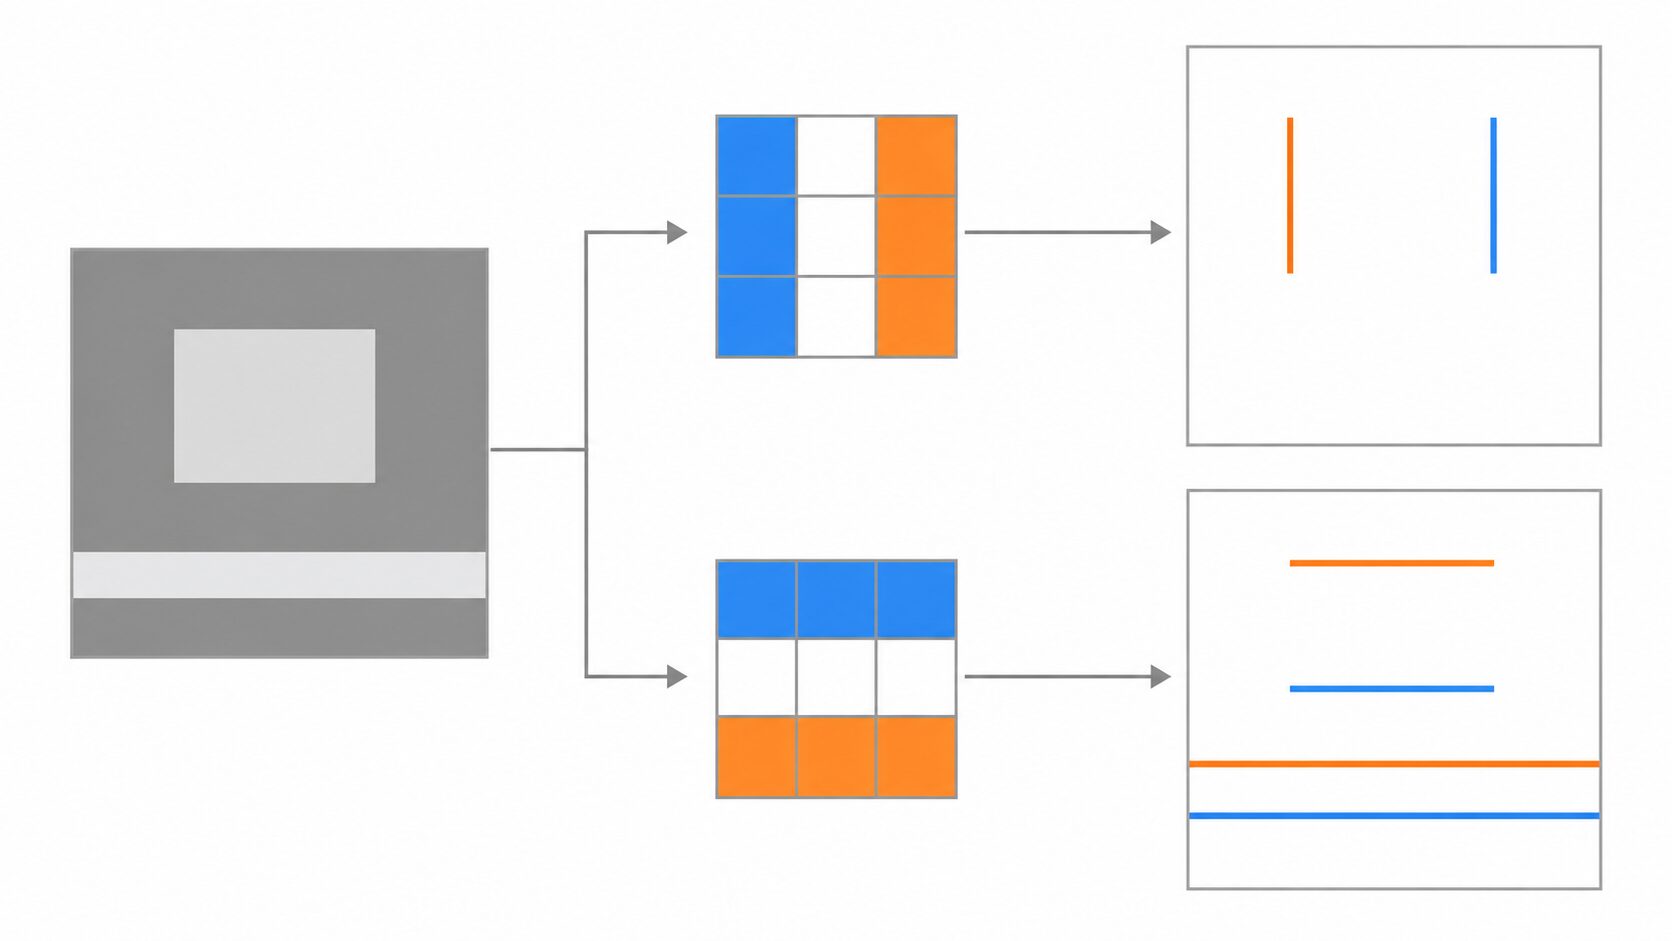
浅い層では、線の向きや色の違いへの反応を比較的読み取りやすい場合があります。しかし、深い層は前の層の複数の特徴マップを入力として使うため、重みをそのまま表示しても、単純な縞模様や物体の形として理解できるとは限りません。多チャネルの情報を1枚にまとめる場合も、表示方法によって一部の情報が省かれます。
可視化の際は、色の意味や表示範囲も確認しましょう。負の値を含む畳み込みの出力と、負の値を0にするReLU適用後の出力では、見える反応が異なります。また、特徴マップごとに最小値と最大値をそろえて表示すると、色が濃いという理由だけで別のマップより反応が大きいとは判断できません。
可視化は、ノイズに反応しすぎていないか、対象物より背景に強く反応していないかを調べる手掛かりになります。ただし、ある場所で反応が強いことだけでは、その場所が最終的な判定を決めたとは言い切れません。後段の処理で複数の特徴が組み合わされるため、特徴マップ1枚から判断理由の全体やモデルの安全性を証明することはできません。
フィルタを理解する出発点は、小さな数値の表が画像の局所的な変化をどう捉えるかを確かめることです。平均化の計算、輪郭検出と鮮鋭化の違い、CNNによる重みの学習を押さえたうえで、可視化と実際の認識結果を合わせて見ると、フィルタが担う役割と、その限界を具体的に理解できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月3日 | 輪郭検出と鮮鋭化の違いを明確にし、計算例とCNNの学習・可視化の限界を追記 |