
AI文章の電子透かしとは?Claudeの仕組みとAI検出ツールとの違い

AIの初心者
AIが書いた文章には電子透かしが入ると聞きました。見えない文字が隠れていて、コピーすればAIだと分かるのでしょうか?

AI専門家
この記事で扱うClaudeやSynthID-Textの方式では、隠し文字を足すのではなく、文章を生成するときの言葉の選び方に統計的なパターンを残します。対応する検出方法が、そのパターンを調べる仕組みです。
AIの初心者
では、検出できれば全文がAIの作品で、検出できなければ人が書いたと考えてよいですか?校正や翻訳だけ頼んだ場合も気になります。
AI専門家
結果だけでそこまでは断定できません。対象の方式、文章の長さ、編集の経緯などが関係します。透かしが示す手掛かりと、著者や利用ルールについての判断を分けて見ていきましょう。
AI文章の電子透かしとは。
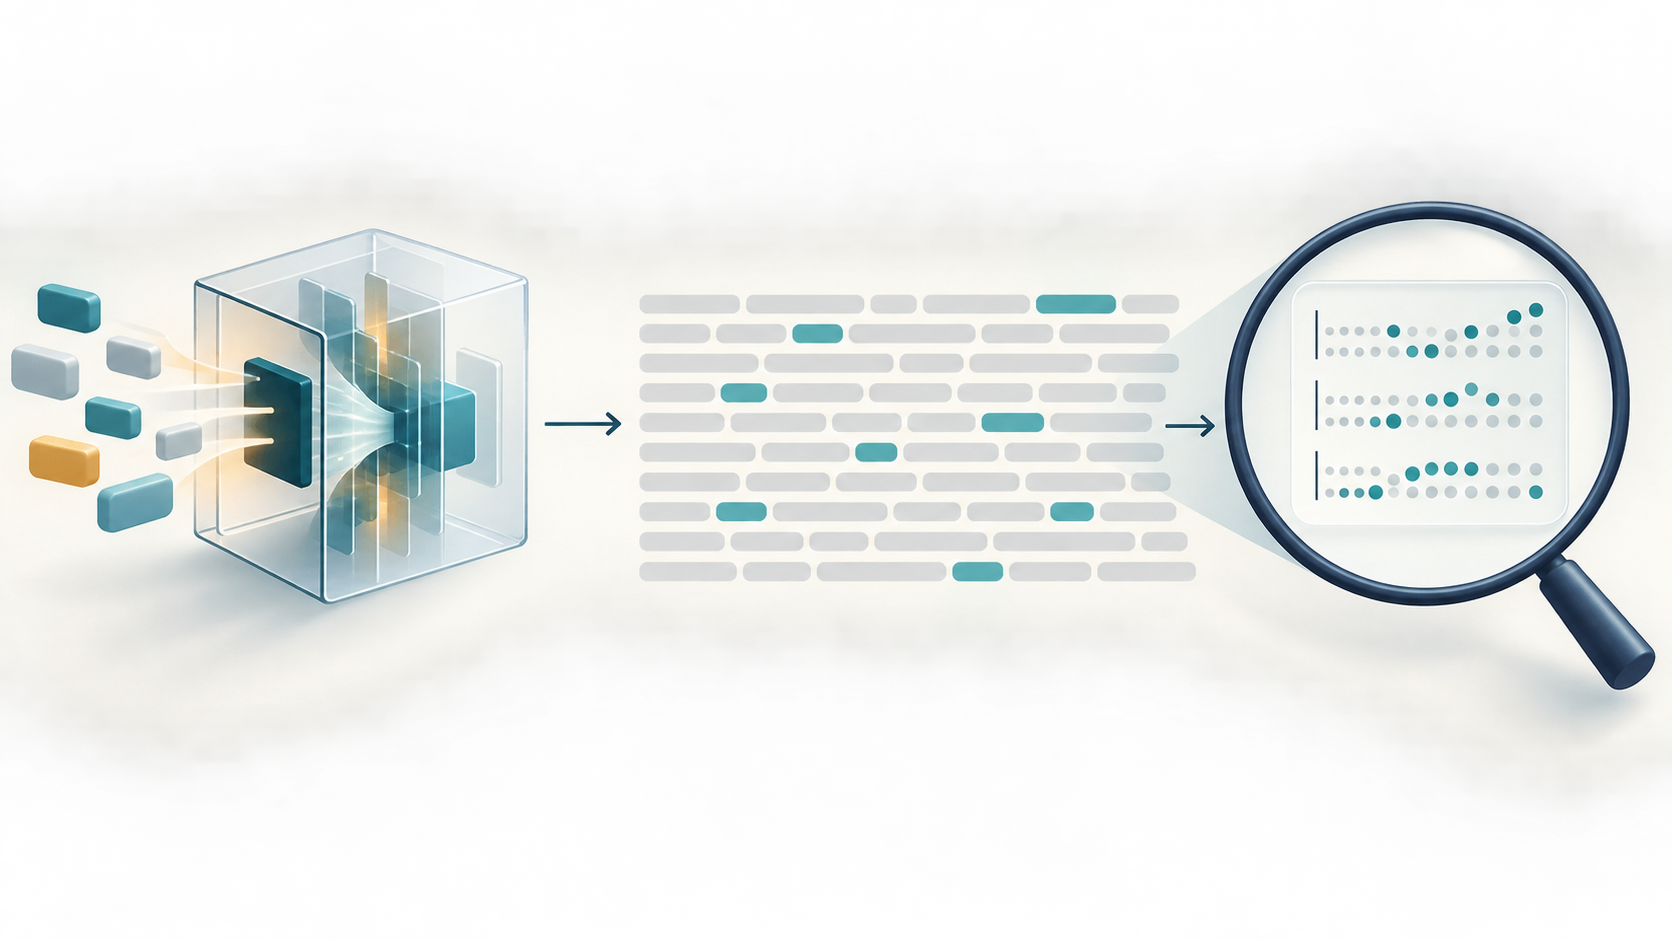
AIが文章を生成する際に、後から対応する方法で検出できる特徴を出力へ組み込む技術です。本記事で扱う統計的な方式では、自然な文章の候補を選ぶ過程に規則を導入し、その規則に沿ったパターンを調べます。文章だけを後から分析する一般的なAI検出ツールとは仕組みが異なり、内容の正しさや執筆者の本人確認を保証するものでもありません。
AIの文章利用が広がると、読者や編集者は「この文書はどのように作られたのか」を確かめたくなります。電子透かしは、その確認を助ける技術の一つです。ただし、あらゆる生成AIの文章を見つける共通の印があるわけではありません。何のパターンを、どの条件で検出するのかを理解することが、結果を適切に使う出発点になります。
以下では仕組みから説明し、Claudeの対応状況、AI検出ツールやC2PAとの違い、校正・翻訳した文章の考え方を整理します。製品の提供状況は2026年9月30日時点です。案内文や業務場面の例は仕組みを説明するための架空例であり、実際の検出試験の結果ではありません。
電子透かしで分かることと、分からないこと
電子透かしが答えようとするのは、主に「この文章に、対応する生成方式が残すパターンが見られるか」という問いです。人間の筆跡を読むように文体の印象から作者を推測するのではなく、生成側が意図的に導入した規則との一致を調べます。この違いにより、見た目が自然な文章でも、対応する検出器には統計的な手掛かりが得られる場合があります。
一方、あるモデルが生成に関与したことと、文書のすべてをそのモデルが作ったことは同じではありません。例えば、人が書いた社内報にAIが作成した説明文を一段落加えたとします。その部分に由来する信号が検出されても、人が取材した事実や自分で書いた感想までAIが作ったとはいえません。文書全体を検査した結果を、各文の作者の一覧として読むことはできないのです。
また、生成経路と内容の品質も別です。透かしのある文章に正しい説明が含まれることもあれば、透かしのない文章に誤情報が含まれることもあります。出典のない数字、誤った引用、古い製品情報などは、透かしの有無とは別に確認します。コピー元との一致を調べる盗用確認や、画像・動画の偽造を扱うディープフェイクの問題とも、調べる対象が異なります。
さらに、AIの使用が認められている仕事では、検出されること自体に問題があるとは限りません。必要なのが利用の申告であれば申告内容を、必要なのが成果物の正確さであれば事実と根拠を確認します。技術が示す生成過程の手掛かりと、組織が決めた利用ルールへの適合は別々に判断することが大切です。
反対に、透かしを検出しなかったときも、生成AIの利用全般を否定できません。そもそもその方式を導入していないモデルの出力は検出対象に入りません。対象モデルであっても、短い抜粋や加工された原稿では十分な材料が得られないことがあります。「対象の信号が見つからなかった」と「人間が一から書いた」は、証明しようとしている内容が違います。
仕組みは「候補の選び方」に残る統計的なパターン
大規模言語モデル、つまりLLMは、ここまでの文脈を受けて次の出力候補を選ぶ処理を繰り返します。このとき扱う単位は厳密には単語だけではなく、トークンです。トークンは言葉の一部、記号、短いまとまりなどになり、日本語の一単語と一対一で対応するとは限りません。初心者はまず、文章を小さな単位で少しずつ組み立てると考えると理解しやすくなります。
例えば、施設の案内文を書く場面を想像してください。「館内では足元にお気をつけください」「館内を移動する際は段差にご注意ください」など、同じ用件にも複数の自然な表現があります。実際のモデルはこのような完成文を丸ごと二択するわけではありませんが、生成途中にも選択の余地があります。透かしは、その余地を利用して、後から調べられる特徴を残す発想です。
単純な説明用の比喩として、候補を選ぶたびに「秘密の合図と、その場の文脈をもとに決まるくじ」を使うと考えてみましょう。目の前の一回の結果だけでは普通の選択に見えても、同じ規則が文章の各所で作用すると、規則を知る側が集計したときに手掛かりが現れます。これは実装そのものを再現した説明ではなく、局所的には目立たない特徴を全体で検出する考え方を示しています。
この比喩でいう秘密の合図に相当するのが、方式によって使われる鍵や設定です。鍵は利用者が文章へ手入力する合言葉ではなく、生成・検出の規則を定めるための情報です。文脈が変われば規則の作用も変わるため、「この形容詞が出たらAI」「この助詞を使うと透かしになる」といった固定の単語リストとして読むのは適切ではありません。
検出側は、対応する規則に照らして複数の位置の情報を集め、偶然でも起こり得る程度か、信号があると考えるだけの材料があるかを評価します。文章の中に、目で読める署名が一つ埋まっている状況とは異なります。そのため、一語を見つけて即座に確定する方法ではなく、集められる証拠の量や判定基準が結果に関係します。
仕組みを学ぶ際には「自然さを保ちながら信号を残すこと」と「後からその信号を見つけること」をセットで捉えましょう。強い信号を求めること、表現の自由度を保つこと、編集後も検出できることは、それぞれ評価が必要な観点です。方式の名称が同じでも、設定や対象文章が違う評価結果を、そのまま自分の用途へ当てはめることはできません。

Claudeでは何が導入されているのか
Anthropicは、Claudeの本文透かしについて、SynthID-Textを基に、生成時の選択に使う乱数を鍵と文脈に関連付ける方式だと説明しています。隠し文字を追加する仕組みではありません。また、品質への影響は見られなかったという説明は、同社が行った評価の結果として読む必要があります。利用する言語や作業のすべてについて、影響がないと独立に証明されたという意味ではありません。Anthropicの本文透かしに関する発表を参照してください。
2026年9月30日時点の公式ヘルプの対応表では、次のモデルが本文透かしに対応しています。モデルの世代だけでなく、どの提供面で使うかにも違いがあるため、「Claudeという名前の付く出力にはすべて同じ条件で入る」とまとめないことが重要です。
| 確認項目 | 2026年9月30日時点の整理 |
|---|---|
| 本文透かしの対応モデル | Fable 5.1、Mythos 5.1、Opus 5.5、Opus 5、Sonnet 5.5 |
| 過去のモデル | 全旧モデルの対応が完了したわけではない |
| 本文検出API | 適格組織・対象企業向けのprivate preview |
| 確認時の注意 | モデルと提供面を確認し、全サービス一律の対応とみなさない |
この表の対応状況と提供範囲は、Claude公式ヘルプに基づきます。private previewは限定された対象への提供段階を意味し、一般利用者がすぐに使える公開の検出機能とは区別します。利用できるという確認がない段階で、本文を貼り付ければ判定されると案内したり、未確認のAPIの操作方法を組み立てたりすることはできません。
基礎となる技術にも来歴があります。Googleは2024年5月にGeminiアプリとWebでのテキスト透かし導入を発表しており、電子透かしが2026年に初めて生まれた技術というわけではありません。Google DeepMindの2024年の発表で背景を確認できます。SynthID-Textの原論文は2024年10月23日に公開されています。論文での評価条件と、Claudeや日本語の業務文書の条件は分けて考える必要があります。原論文「Scalable watermarking for identifying large language model outputs」もその前提で参照するとよいでしょう。
実務では、製品名を覚えるだけでなく「原稿を作ったときのモデルと環境は何だったか」を残すことが役立ちます。後から対応表が変わっても、その原稿を作成した時点の条件まで自動的に変わるわけではないからです。モデル名が不明な過去の原稿については、不明であるという情報も含めて扱います。
AI検出ツール・C2PAとの違いを比較
文章に関する検出や来歴の仕組みは、一つの技術ではありません。比較の軸は「いつ情報を得るか」「何を証拠として使うか」「何について答えるか」です。ここでいう一般的なAI検出ツールは、あらかじめ生成側に透かしを入れなくても、完成した文章の特徴からAI由来らしさを推定する事後分類の方式を指します。実際の製品が複数の方式を組み合わせる場合は、名称ではなく説明されている機能を確認してください。
| 比較する点 | 文章の電子透かし | 一般的なAI文章分類 | Content Credentials/C2PA |
|---|---|---|---|
| 主に情報を持たせる・調べる段階 | 生成時に規則を作用させ、後から検出する | 完成後の文章を分析する | ファイルの生成・編集に関する来歴情報を記録・確認する |
| 手掛かり | 対応する方式が残す統計的パターン | 文章の特徴と分類モデルなどによる推定 | ファイルに関連付けられた来歴情報 |
| 生成側への前提 | 対象の方式を導入した生成過程が必要 | 原理上、特定の透かし導入を前提としない | 記録に対応する作成・編集の仕組みが必要 |
| 対応関係の確認 | 方式・鍵・設定などの適合を確認する | 対象言語・文章の種類・評価条件を確認する | 対象ファイルと残っている来歴情報を確認する |
| それだけでは確定できないこと | 全文の作者、内容の真偽、ルール違反 | 生成経路の確定、作者の特定、内容の真偽 | 記録だけを根拠とした内容の正しさ |
電子透かしは、生成側と検出側の対応関係を利用します。一方、一般的な分類器は、入力した文章が学習・評価時のどの特徴に近いかなどを手掛かりにします。そのため、ある分類器が「AIらしい」と判定しても、Claudeの透かしを見つけたことにはなりません。透かし検出で信号が見つからない文章を、別の分類器がAIらしいと推定することも、問いの違いとして理解できます。
例えば「大変お世話になっております」で始まる連絡文を想像してください。人が定型文を使うことも、AIが同じ表現を選ぶこともあります。丁寧で整った言い回しだけを見て、生成過程を断定することはできません。電子透かしも見た目の丁寧さを調べるのではなく、対応する規則の統計的な信号を調べます。どちらの方式でも、検査の材料と判定条件を確かめる必要があります。
Content Credentials/C2PAは、本文中の言葉の選び方ではなく、ファイルの来歴情報を扱う別の仕組みです。Claudeの公式ヘルプも本文透かしとファイルの来歴を区別しています。例えば、受け取ったファイルと、そこから本文だけを抜き出した文字列は、確認できる情報の範囲が同じとは限りません。原稿の出所を調べたいときには、文章だけを残せば十分だと決めつけず、受領した元ファイルも扱いのルールに沿って保管することが役立ちます。
こうした違いから、検出器を選ぶ前に問いを具体化すると整理しやすくなります。「特定の生成方式が関与したか」「幅広いAI文章を推定したいか」「受け取ったファイルの来歴を確かめたいか」では必要な手段が異なります。単にAI検出という共通の名前でまとめると、得られた結果に本来ない意味を持たせやすくなります。

陽性・陰性・不確かをどう読むか
統計的な検出では、結果を絶対的な真偽のラベルとして受け取らないことが大切です。Googleの開発者向け資料では、SynthIDの検出が確率的であること、透かしあり・なし・不確かという扱いや、閾値による誤検出と見逃しの調整が説明されています。SynthIDの開発者向け資料を参照してください。すべてのサービスが同じ表示や同じ判定段階を採用しているとは限りません。
陽性は対応する信号があるという判断、陰性はその基準で信号が検出されなかったという判断として読みます。不確かは、無理にどちらかへ決めるだけの材料が足りない状態です。結果を二つに絞ることより、判断を保留する必要がある場面を残すことが、実務では役立ちます。特に、その判断が人の評価や取引上の対応につながる場合は、保留を失敗とみなさない設計が必要です。
誤検出は、本来その透かしがない文章をあると判定することです。見逃しは、本来ある透かしを検出できないことです。閾値は、どの程度の信号で陽性とするかという境目です。同じ検出スコアを使う場合、一般に陽性の条件を厳しくすると誤検出を抑えやすくなる一方、弱い信号を見逃しやすくなります。逆に、弱い信号も拾おうとすると、偶然のパターンを陽性とみなす危険が増えます。
例えば、編集部が「追加確認する原稿の候補を選ぶ」目的で使う場合と、学校が「提出者に不利益な判断をする」場面では、誤りの影響が異なります。前者であっても機械の結果だけで結論を出す必要はありませんが、後者では誤検出による影響がさらに大きくなります。どの間違いがどんな負担を生むかを先に考え、それに合う確認手順を用意することが重要です。
スコアの数字にも注意してください。画面に高い数値が出ても、それが「文章の何割をAIが書いたか」を表すとは限りません。判定への確信度、信号の強さ、内部的な指標など、製品ごとに意味が違い得ます。説明のない数値を「AI執筆率」と言い換えると、段落が混在する文書や人が修正した原稿を誤って説明してしまいます。
さらに、利用者が知りたい「陽性だった文章が実際に対象方式で作られた割合」は、対象の集まり方にも左右されます。対象方式の文章がほとんどない集団では、少数の誤検出でも確認対象に占める重みが大きくなります。検出器の性能表だけを見ず、どのような原稿群へ適用するのかも考えましょう。誤りの基本的な違いは、偽陽性・偽陰性の解説で補足しています。
短文や編集された文章で判断が難しくなる理由
統計的なパターンを調べるには、材料の量と、信号が残る機会の両方が関係します。短い文章では集められる材料が少なく、答え方がほぼ決まっている文章では、生成時に表現を選ぶ余地が小さくなります。単に文字数が多ければ何でもよいという話ではなく、どのような内容をどのように生成したかも見る必要があります。
架空の社内案内を二つ比べてみましょう。一つは「受付は午前九時からです」という一行です。もう一つは、受付の場所、当日の流れ、持ち物、初めて来る人への注意を数段落にまとめた説明です。後者には言い回しや説明順を選ぶ場面が多くあります。この違いが、信号を残せる機会の違いを考える助けになります。ただし、長い説明なら必ず検出できるという保証を示す例ではありません。
GoogleはSynthIDのテキスト透かしについて、長く表現の選択肢が多い文章に向き、短文や定型的な事実回答では弱くなること、軽微な編集後にも残る場合がある一方、大幅な書き換えや翻訳で検出の確信度が下がり得ることを説明しています。Google DeepMindの技術説明に基づく一般的な性質であり、個別原稿の検出成否を予告するものではありません。
編集の影響は「一文字でも直したら消える」「意味が同じなら必ず残る」という二択では捉えられません。本文中に分散した選択の特徴を調べる以上、文章の一部が保たれている場合と、表現や構造が広く置き換わっている場合では、検出に使える材料が変わります。見出しだけを抜き出した記事一覧と、元の説明文を含む記事全体も、同じ検査対象とはいえません。
このため、引用部分だけを見て記事全体の生成経路を判定したり、長文に対する評価結果を短い広告見出しへそのまま当てはめたりするのは避けます。業務で使うなら、普段扱う原稿の長さ、抜粋の有無、編集工程を整理します。対象サービスが示していない最小文字数を独自に決めて、「この長さ以上なら確実」と説明することもできません。
文章を確認する担当者は、原稿を受領した形と、検査へ回した形を区別して記録するとよいでしょう。例えば「本文の一部のみ」「見出しを除いた全文」といった範囲の記録です。検出条件を振り返れるようにするためであり、透かしを弱める加工を探すことが目的ではありません。材料が足りない場合は、推測で補って決めるのではなく、確認できる範囲を狭く伝える姿勢が役立ちます。

校正・翻訳・共同執筆は生成経路を分けて考える
「AIを使った文章」という言い方には、誤字を数か所直した原稿から、指示だけを人が与えて全体を生成した原稿まで含まれます。電子透かしを考えるときは、その幅を一つのラベルにまとめず、AIが新しく言葉を選んだ部分と、人の表現が維持された部分を分けると理解しやすくなります。
人が書いたお知らせをAIに渡し、句読点や誤字だけを直したとします。元の表現がほぼ残るなら、AIが自由に選び直した部分は限られます。「AIに一度通した」という履歴だけで、十分な透かし信号が文章全体へ加わったと考えることはできません。逆に、校正と呼んでいても、実際には全段落が大きく書き換えられている場合もあります。依頼の名称より、実際に何が変わったかが重要です。
翻訳では二つの方向を区別します。一つは、透かしの入った既存の文章を別の方法で翻訳し、元の表現にあったパターンが変化する場合です。もう一つは、人の文章を本文透かしに対応したClaudeで翻訳し、新しい出力が生成される場合です。後者では、その生成過程によって新しい透かしが付く可能性があります。「翻訳で元の信号が弱まる」と「翻訳結果に新たな信号が付く」は矛盾しません。
| 作業の例 | 生成過程で見る点 | 結果だけで言えないこと |
|---|---|---|
| 人の原稿の誤字を一部修正する | 新しく選ばれる表現がどれだけあるか | AIに渡しただけで、全文が透かし付きになるとは限らない |
| 人の原稿を対応するモデルで翻訳する | 翻訳文として新しい出力が生成される | 透かしがあっても、元の着想や事実までAI由来とはいえない |
| 透かし付き原稿を別の方法で翻訳する | 元の語の選択や文脈が変化する | 元の透かしが保たれることも、必ずなくなることも保証できない |
| 人とAIの段落をまとめて編集する | 生成・編集の経路が部分ごとに異なる | 文書全体の検出結果だけでは各段落の作者を確定できない |
例えば、人が取材した内容を日本語でまとめ、それをAIで英訳してから担当者が用語を修正した記事を考えます。この英文に信号が見られたとしても、取材をしたのが誰か、元の事実確認を誰が行ったかまでは分かりません。文章の生成と知的な貢献の範囲が異なるためです。制作の説明には「取材・原稿作成は人、英訳補助にAI、最終確認は担当者」といった工程の記録の方が直接役立ちます。
共同執筆でも、生成経路を無理に二分する必要はありません。下書き、翻訳、要約、校正、見出しの提案など、AIの役割を必要な粒度で残せば、検出結果と実際の工程が食い違って見えるときに説明しやすくなります。すべての操作を細かく保存するかは業務の事情によりますが、少なくとも「何のために使ったか」が分かる記録は判断の助けになります。
編集・教育・社内確認での使いどころ
電子透かしは、対象と利用条件が合う場合に、原稿の作られ方を確認する補助情報として使えます。ここでは三つの架空の場面で、技術が役立つ点と、別に確認すべき点を考えます。いずれも特定の検出サービスを実際に使った報告ではありません。
編集部で寄稿文を確認する場面では、最初に掲載方針を明らかにします。例えば、AIの校正補助は認める一方、本文の生成には申告を求める運用なら、確認したいのは申告と実際の工程の関係です。透かしに関する陽性結果があれば、追加説明を求める材料にはなりますが、申告漏れや虚偽をその場で確定するものではありません。人が書いた原稿を翻訳しただけという経路も考えられます。
編集者が次に確かめるのは、草稿の変遷、AIを使った作業、取材や引用の根拠です。掲載品質に直結する事実確認は、透かしが検出されなくても続けます。検出結果を寄稿者へ伝える場合は、検査した範囲と結果の意味を限定して説明し、作成経緯を補足できるようにします。「機械がAIだと判定したから説明は不要」という対応では、確認のための技術が対話を止めてしまいます。
教育現場でレポートを確認する場面では、課題の目的と許可された支援を分けて考えます。表現の推敲が認められる課題もあれば、文章を自力で組み立てる力を評価する課題もあります。同じ検出結果でも、その意味は課題の条件によって変わります。事前に条件が曖昧だった場合、その曖昧さを検出結果で埋めることはできません。
内容の理解を確かめるなら、参考にした資料の説明、主張へ至った理由、草稿からの変更点などが直接的な情報になります。例えば、提出者が自分の結論の根拠を説明できるかという確認と、対応する透かしがあるかという検査は、それぞれ別の役割を持ちます。検出のみで成績や不正の認定を自動的に決めず、説明の機会と再確認の手順を用意する運用が適しています。
社内文書の作成工程を確認する場面では、まず確認の目的を絞ります。AIの利用状況を把握したいのか、承認を受けたツールが使われたかを調べたいのか、内容の誤りを減らしたいのかで必要な情報が違います。透かしの検出から、会社の契約アカウントを使ったのか、入力時に機密情報を渡したのかまで推定してはいけません。
例えば、公開用の商品説明でAIの下書き利用が許可されているなら、重要なのは担当者による仕様確認と公開承認かもしれません。電子透かしは工程の確認を助けても、仕様が正しいことを保証しません。利用履歴や承認記録など、目的に直接結び付く情報と組み合わせることで、余計な推測を減らせます。導入の価値は検出件数そのものではなく、確認したい問題の解決に役立ったかで見ます。
検出結果を扱うときの確認手順
利用資格と対応する検出手段がある場合でも、入力して結果を見るだけでは確認が完結しません。次の順番で前提と記録をそろえると、結果の意味を必要以上に広げずに扱えます。これは特定APIの操作手順ではなく、文書の確認を進めるための実務上の整理です。
-
確認したい問いを決めます。「この方式の生成が関与したか」「利用の申告に追加確認が必要か」など、結果が答えられる範囲に合わせます。作者本人の特定や内容の真偽は、別の確認に分けます。
-
対象と検出手段の対応を確認します。方式、モデル、提供面、利用条件を把握し、不明な項目を残します。対象外の可能性を無視して陰性結果だけを根拠にしないようにします。
-
検査する原稿の範囲と経緯を整理します。全文か抜粋か、どの版か、翻訳や編集が行われたかを記録します。個人情報や機密情報を外部へ送ってよいかも、この段階で確認します。
-
結果は提供された意味のまま記録します。判定名、説明されている指標、検査日時、対象範囲を残し、見慣れないスコアを独自に執筆率へ変換しません。不確かという結果を勝手に陽性へ寄せないようにします。
-
草稿や申告などの情報と合わせて確認します。結果と作成経緯が合わない場合は、対象の不一致、原稿の版、混在した工程などを点検します。人に影響する判断は、追加説明を受ける担当者と手順を決めて行います。
ここで役立つのは、記録を増やすこと自体ではなく、何について結論を出したかを後から説明できることです。例えば「提出された第三稿の本文を対象に、対応方式の信号について確認した」と残せば、別の版や引用部分に同じ結果を当てはめる誤りを避けやすくなります。「AIだった」という一言だけの記録では、この区別が失われます。
また、複数のツールへ同じ文章を入れて多数決を取れば、必ず信頼性が上がるわけではありません。対象方式や指標が違えば、各ツールは別の問いに答えています。似た性質の分類器が同じ弱点を持つ可能性もあります。結果が一致した数だけを見るより、それぞれが何を調べたのか、どんな評価条件が示されているのかを確認する方が重要です。
原稿を細かく分割して何度も判定し、その中の陽性だけを取り上げる方法にも注意が必要です。短い断片では材料が減るうえ、試す回数を増やすほど偶然の結果を拾う機会も増えます。文書全体と断片のどちらを調べるかは、対応する機能と業務目的に合わせて先に決めます。望む結論が出るまで条件を変える使い方では、結果の解釈が難しくなります。
プライバシーと文書の送信先は別に確認する
Anthropicは、Claudeの透かし自体に個人・組織・会話を特定する情報は含まれないと説明しています。これは同社の発表に示された透かしの性質です。本文に個人情報が含まれないことや、検出サービスへ送信した文章が保存されないことまで意味するわけではありません。
三つの層を分けて考えると混同を避けられます。一つ目は透かしの信号に何が含まれるか、二つ目は文章そのものに何が書かれているか、三つ目は文章を送った先でどのように扱われるかです。例えば、透かしに利用者の識別情報がなくても、本文に顧客名や未公開の取引条件があれば、その文書を外部へ送る判断は別途必要です。
検出のために外部サービスを使う場合は、業務で許可された送信先か、何を入力してよいか、保存や利用の条件を確認します。公開前の記事、応募書類、学校の提出物なども、担当者が自由に第三者へ送ってよいとは限りません。確認の権限があることと、外部への送信が認められることを一緒にしないようにします。
情報を減らして検査する場合も、元の文章からどこを除いたかという条件が変わります。例えば、個人名を伏せた原稿や一部の段落だけを使った結果を、そのまま原本の検出結果として扱うのは適切ではありません。必要な情報管理と検出条件の記録を両立させ、送信できる材料が足りなければ、草稿や本人の説明など別の確認方法を使います。
また、透かしに個人の識別情報がない以上、それを利用者の追跡用番号のように扱うこともできません。アカウントの利用や文書の受け渡しの経路を調べる必要がある場合は、適切に管理された別の記録が必要です。生成AIと個人情報の扱いの背景は、生成AIとプライバシーの解説でも整理しています。
導入前に決めたい運用と評価の基準
検出を業務へ取り入れるなら、「どの製品が高精度か」という比較の前に、対象原稿と結果の使い道を決めます。長い説明記事での評価が良くても、自分たちが確認したいのが短い見出しや定型メールなら、同じ結果は期待できません。必要なのは、自分たちの仕事に近い条件で、誤りや保留がどのように生じるかを把握することです。
評価に使う原稿は、作成経緯が確認できるものを用意するのが基本です。出所の分からないインターネット上の文章を集め、推測で「人」「AI」と正解ラベルを付けると、検出器ではなく準備したラベルの誤りを測ってしまうことがあります。人が作成した文章、対象方式で生成した文章、翻訳・編集を経た文章は、目的に合わせて分けて記録します。
| 事前に決める項目 | 整理の例 | 判断に役立つ理由 |
|---|---|---|
| 対象原稿 | 公開記事、社内説明文、短い案内文など | 長さや表現の自由度が違う文章を一括評価しないため |
| 生成・編集の履歴 | モデル、作成時期、翻訳、校正、抜粋の有無 | どの条件の結果なのかを後から確認するため |
| 結果の使い道 | 追加確認の候補を選ぶ、作成経緯を確認する | 技術が答えられる範囲と業務目的を合わせるため |
| 保留の扱い | 追加資料を確認する担当者と期限を決める | 不確かな結果を無理に二択へ変えないため |
| 誤りへの対応 | 説明を受ける、再確認する、記録を訂正する | 誤検出や見逃しが起きた際の負担を小さくするため |
結果をまとめるときは、全体の正解率だけではなく、誤検出、見逃し、判断を保留した件数を分けると実態が見えます。短文では保留が多く、長文では判定が付くという差があるなら、その差も業務上の情報です。保留を評価対象から除いて高い数字だけを出すと、実際にどれくらいの文書を確認できるかが伝わりません。
言語や原稿の種類も記録します。ある条件で公表された精度を、日本語のあらゆる文章に対する精度として引用しないことが重要です。論文の数字、メーカーの評価、自分たちの試行結果は、それぞれ対象と方法を伴って初めて比較できます。本記事では個別の検出試験を行っていないため、特定製品の精度や必要文字数を数値で保証していません。
導入後も、モデルや検出手段の更新があった場合には、前の評価と条件が変わっていないか確認します。過去の判定結果と新しい結果を比べるなら、対象原稿の版や判定条件を合わせる必要があります。業務のルールに組み込む範囲は、説明できる性能と実際の運用負担に合わせて決めるとよいでしょう。
よくある疑問
SynthIDの公開実装があれば、どのAI文章でも判定できますか。
公開された実装を利用できることと、他社が運用する鍵や設定に対応した検出を使えることは別です。Googleの資料は設定や鍵を秘密にする設計を説明しており、任意のサービスの文章を万能に調べられるという意味ではありません。自分の環境で実装を学ぶ場合も、他社の検出結果を再現できると決めつけないようにします。SynthIDの実装と利用上の説明を参照してください。
Geminiの検証画面に文章を貼れば、本文の透かしも確認できますか。
一般向けのGeminiの検証機能として公式に明示されている対象は、画像・動画・音声です。テキスト透かし技術が存在することから、同じ画面で文章も誰でも検証できると推測することはできません。本文用の機能が必要な場合は、その対応と利用条件を個別に確認します。SynthIDの公式案内で対象を区別してください。
透かしが検出されなければ、安心して公開してよいですか。
公開前に必要な事実確認、引用の確認、個人情報や秘密情報の点検は残ります。透かしは原稿の作成過程に関する手掛かりであって、内容審査の完了を示す印ではありません。反対に、透かしがあっても利用方針に沿って作成され、内容が確認された文章はあり得ます。
対応する検出手段を利用できないときは、どう確認すればよいですか。
検出ができないことを、AI利用がなかったことに置き換えず、確認可能な作成経緯を整理します。申告、草稿、出典、翻訳や校正の工程などを必要に応じて確かめます。証拠が足りなければ判断を保留し、確認できた事実と推測を分けて記録する方が、根拠の薄い断定をするより有用です。
まとめ
AI文章の電子透かしは、生成時の選択に規則を導入し、出力に残った統計的なパターンを後から調べる技術です。Claudeの方式を理解するときは、対応モデルと提供面、検出手段の利用条件を確認します。文章の見た目から推定する一般的なAI検出ツールや、ファイルの来歴を扱うContent Credentials/C2PAとは、手掛かりも答えられる問いも異なります。
読み解くうえでの要点は、生成過程の手掛かりを、全文の作者・内容の真偽・不正の証明へ広げないことです。陽性、陰性、不確かの意味を区別し、校正や翻訳などの工程も合わせて考えます。実務では、検出結果を草稿や申告、内容の確認と組み合わせることで、原稿の作られ方を説明するための補助情報として活用できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年9月30日 | 初回公開 |