


AIの初心者
「損失関数」って何ですか?AIの正解率とは違うのでしょうか?

AI専門家
損失関数は、予測が正解からどれくらいずれているかを数値にするものだよ。猫の画像を分類する場合なら、正解したかだけでなく、「猫である確率」をどれくらい高く予測できたかも学習の手がかりにできるんだ。
AIの初心者
そのずれを数値にすると、どうやって予測がよくなるのですか?
AI専門家
その値が小さくなるように、モデル内部の数値を少しずつ調整するんだ。ただし、練習したデータで損失が小さいだけでは十分ではないよ。学習に使っていないデータでも予測できるか、一緒に確かめることが大切なんだ。
損失関数とは、機械学習モデルの予測と正解のずれを数値化し、学習で何を改善するかを定める関数です。住宅価格などの数値を予測する回帰では平均二乗誤差(MSE)、画像などを分類する問題ではクロスエントロピーが代表的です。
損失関数を選ぶと、大きな誤差を強く減らしたいのか、予測確率を正解に近づけたいのかといった学習の方針が決まります。この記事では、代表的な種類と計算例、評価指標との違い、勾配降下法による最適化、学習結果を見る際の注意点を順に説明します。
損失関数とは?予測のずれを学習の手がかりにする仕組み
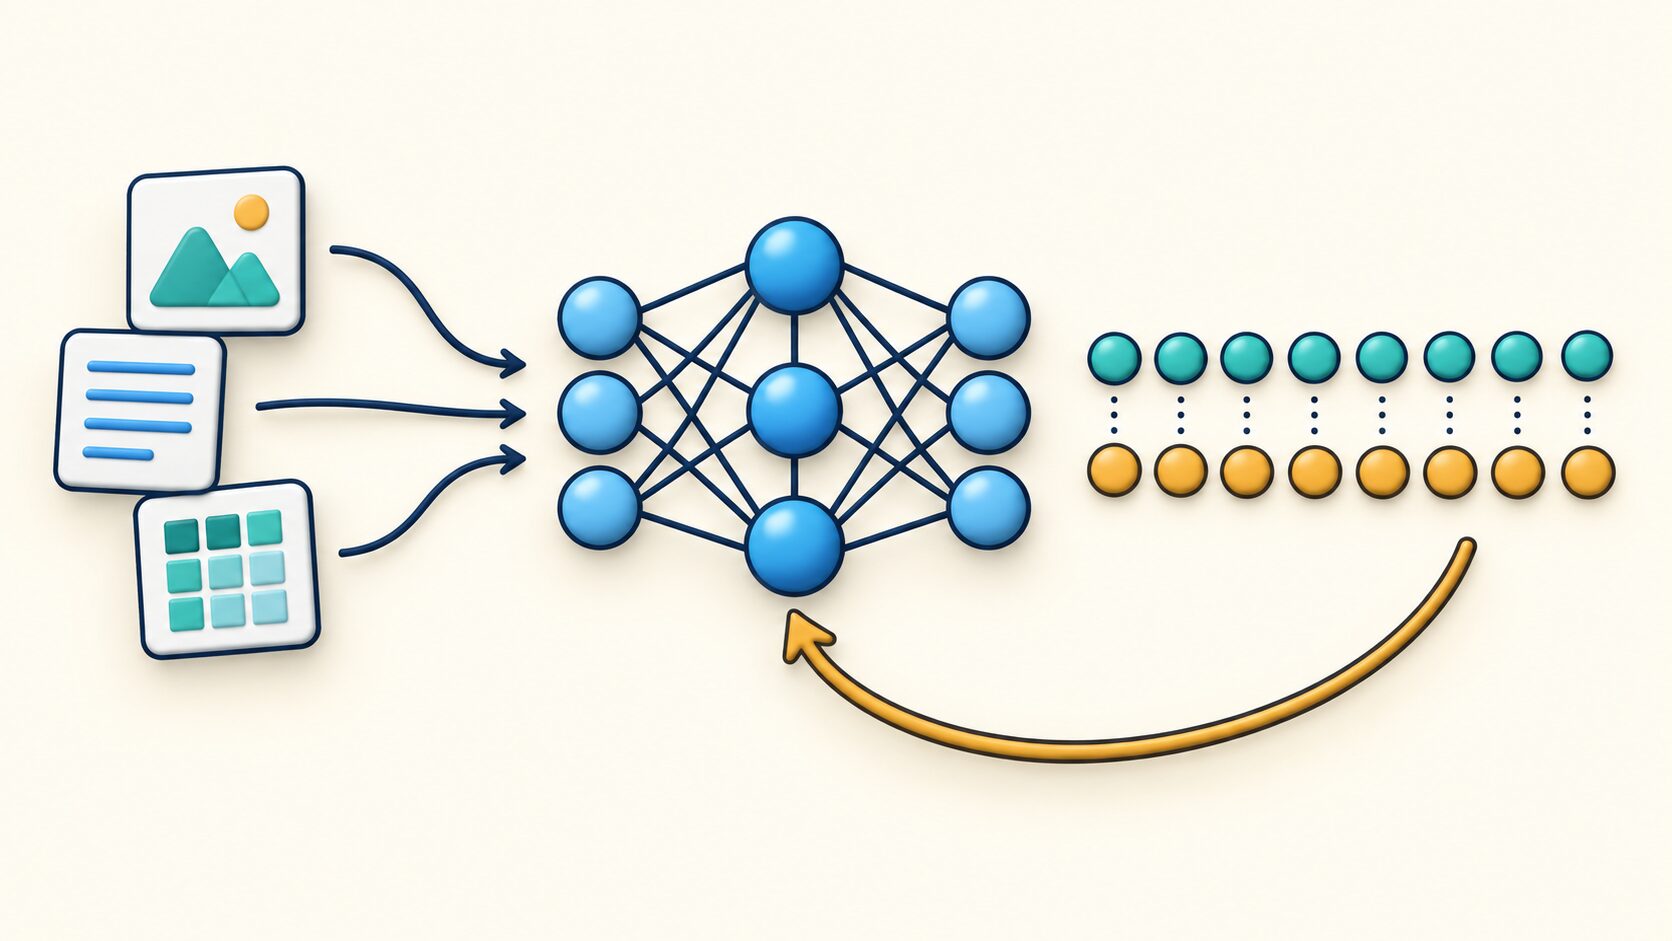
機械学習では、モデルが出した予測を正解と比べ、その差を使ってモデルを調整します。このとき、ずれの大きさを一定のルールで計算するのが損失関数で、計算結果を「損失」や「loss」と呼びます。損失は、いわばモデルが次に改善すべき点を知るための採点結果です。
たとえば、実際の価格が3,000万円の住宅に対し、3,100万円と予測した場合と4,000万円と予測した場合では、後者のほうが大きく外れています。回帰用の損失関数は、こうした数値のずれを評価します。一方、猫の画像を分類する場合は、猫という正解にどれだけ高い確率を与えたかを評価する方法がよく使われます。
学習の基本的な流れは、次のとおりです。
- 学習データをモデルに入力し、予測値や予測確率を得る。
- 予測と正解を損失関数に渡し、損失を計算する。
- 損失を小さくする方向を調べ、重みやバイアスなどのパラメータを更新する。
- 別のデータでも同じ処理を繰り返し、検証データで性能を確認する。
通常、損失関数は値を小さくする「最小化」の対象です。尤度や報酬など、大きくしたい量を直接扱う問題もありますが、その場合は最大化する目的関数として考えます。たとえば対数尤度にマイナスを付ければ、最大化の問題を損失の最小化に置き換えられます。「損失は大きいほどよい場合もある」と一括りに覚えないようにしましょう。
損失関数・目的関数・評価指標の違い
損失関数、コスト関数、目的関数は、似た意味で使われることがあります。ただし、何を集計した値か、モデルの複雑さに対する罰則が含まれるかを区別すると、学習の仕組みを理解しやすくなります。
| 用語 | 主な役割 | 具体例・確認点 |
|---|---|---|
| 損失関数 | 予測と正解のずれを計算する | 1件の誤差を指す場合も、複数件の平均を指す場合もある |
| コスト関数 | 複数のデータの損失をまとめる | データ全体やミニバッチの平均損失。損失関数と同じ意味で使う文献もある |
| 目的関数 | 最適化で最小化・最大化したい量を定める | 平均損失に、過度に複雑なモデルを抑える正則化項を加えたものなど |
| 評価指標 | モデルの性能を目的に照らして確認する | 正解率、適合率、再現率、F1、MAE、RMSEなど |
損失関数と評価指標の大きな違いは、学習でパラメータを動かすために使うのか、できあがった予測の性能を判断するのかという役割です。MSEやMAEのように、両方に使えるものもあります。
たとえば、正解が猫の画像に対して、猫の確率を51%と予測しても99%と予測しても、最終的に猫と判定すれば正解率では同じ「正解」です。しかし、クロスエントロピーはその確率の違いも評価します。正解・不正解だけを数える指標に比べ、予測をどの方向へ変えるべきかを学習に反映しやすくなります。
そのため、学習に使う損失と、実務で重視する評価指標は両方を確認することが大切です。不良品の見逃しを減らしたいなら、全体の正解率だけでなく、不良品をどれだけ検出できたかを示す再現率なども確認します。
損失関数の種類と選び方を一覧で確認
損失関数は、まず予測したい対象に合わせて候補を絞ります。数値を出すのか、クラスを選ぶのか、画像の中の位置を求めるのかによって、出力と正解を比べる方法が変わるためです。
| 問題・目的 | 代表的な損失関数 | 選ぶ際の着眼点 |
|---|---|---|
| 回帰:価格や需要などの数値を予測 | MSE、MAE、Huber損失 | 大きな誤差をどれだけ強く罰するか、外れ値をどう扱うか |
| 回帰:実測値に対する誤差の割合を重視 | MAPE | 実測値が0や0に近い場合に問題がある。評価指標として使うことも多い |
| 二値分類:迷惑メールかどうかなど | 二値クロスエントロピー | 一方のクラスの確率と、0・1の正解を対応させる |
| 多クラス分類:猫・犬・鳥から1つを選ぶ | 多クラスのクロスエントロピー | 互いに排他的なクラスを扱い、各クラスの確率の合計を1にする |
| マルチラベル分類:1枚の写真に複数のタグを付ける | ラベルごとの二値クロスエントロピー | 各ラベルの有無を個別に扱う。複数クラスから1つだけ選ぶ問題と区別する |
| SVMによる分類 | ヒンジ損失 | 正しく分類できたかに加え、分類スコア上の余裕を考える |
| 物体検出:種類と位置を予測 | 分類損失と、IoU系・座標回帰の損失の組み合わせ | クラスの誤りと検出枠のずれを別々に評価する |
同じ回帰でも「大きな予測ミスを特に避けたい」のか「典型的な誤差の大きさを抑えたい」のかで選択は変わります。外れ値があるという理由だけで機械的にMAEへ切り替えるのではなく、その値が測定ミスなのか、予測すべき重要な事例なのかも確認しましょう。
回帰の損失関数:MSE・MAE・MAPEを計算例で比較
\(\mathrm{MSE}=\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2\) \(\mathrm{MAE}=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i|\) \(\mathrm{MAPE}=\frac{100}{n}\sum_{i=1}^{n}\frac{|\hat{y}_i-y_i|}{|y_i|}\quad(y_i\ne 0)\)ここで、\(n\)はデータの件数、\(y_i\)は各データの実測値、\(\hat{y}_i\)は予測値です。MAPEの式は誤差の割合を百分率で表しています。いずれも回帰で使われますが、誤差を二乗するか、絶対値を取るか、実測値で割るかという違いがあります。
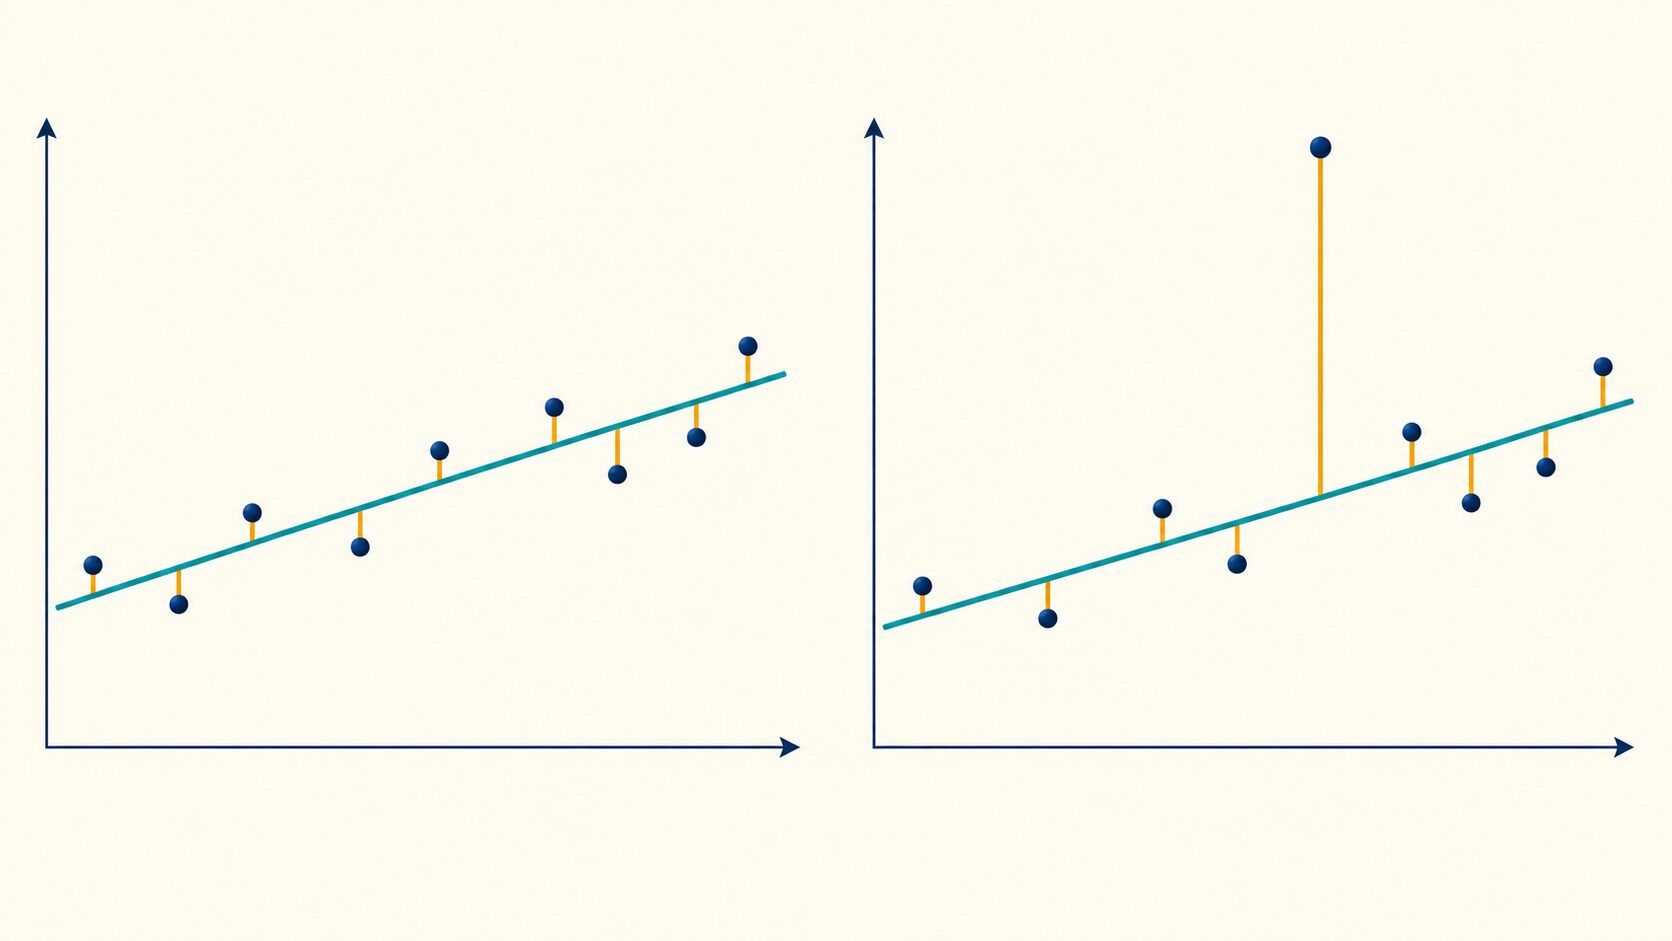
MSE(平均二乗誤差)は、大きな誤差を特に強く罰する損失関数です。実測値が10と20、予測値が11と17なら、誤差の大きさは1と3です。二乗すると1と9なので、MSEはその平均の5になります。誤差が3倍になると、二乗誤差への寄与は9倍になります。
この性質は大きな予測ミスを減らしたい場面に適していますが、極端な値の影響も受けやすくなります。また、MSEの単位は元の量の二乗です。価格を万円で扱えば単位は万円の二乗になり、そのまま平均的な価格差とは読めません。平方根を取ったRMSEなら元の単位に戻せるため、評価結果の説明によく使われます。
MAE(平均絶対誤差)は、誤差の大きさをそのまま平均します。同じ例では1と3の平均なので、MAEは2です。予測対象と同じ単位で解釈でき、MSEと比べると一部の大きな誤差に引っ張られにくい特徴があります。ただし、外れ値の影響がなくなるわけではありません。誤差が0になる点では通常の微分ができないため、勾配に基づく学習ではその点の扱いも必要になります。
MSEとMAEの中間的な選択肢として、Huber損失もあります。小さな誤差には二乗、大きな誤差には線形のペナルティを与える方法です。どこで切り替えるかを決める値が必要なので、データの尺度に合わせて調整します。
MAPE(平均絶対誤差率)は、実測値に対して何%ずれたかを見ます。実測値90に対して予測値100なら約11.1%、実測値10に対して予測値20なら100%です。同じ10の差でも、実測値に対する重みが異なります。
一方、実測値が0なら分母が0になり、上の式では計算できません。実測値が0で予測値が10のときに「100%」や「1,000%」になるわけではありません。実測値が0に近い場合も、わずかな絶対誤差が非常に大きな割合になります。需要が0の日を含むデータなどでは特に注意が必要です。
| 比較する点 | MSE | MAE | MAPE |
|---|---|---|---|
| 誤差の扱い | 二乗する | 絶対値を取る | 絶対誤差を実測値の絶対値で割る |
| 読み方 | 大きな誤差を強く反映する | 元の単位で平均的なずれを示す | 実測値に対する誤差率を示す |
| 主な注意点 | 外れ値に敏感で、単位が二乗になる | 大きな誤差への罰則はMSEより弱い | 実測値0で定義できず、小さな実測値の影響が大きい |
予測値の範囲が広いからといって、必ずMAPEが適切になるわけではありません。正の値で意味のある比率を扱えるかを確認し、必要なら学習にはMSEやMAEを使い、別途、目的に合う評価指標を計算する方法も検討します。
分類の損失関数:クロスエントロピーとヒンジ損失
\(L=-\log p_{\mathrm{correct}}\)正解クラスが1つの多クラス分類では、1件のクロスエントロピーをこの形で表せます。\(p_{\mathrm{correct}}\)はモデルが正解クラスに割り当てた確率で、ここでは自然対数を使います。クロスエントロピーは「交差エントロピー」とも呼ばれます。
正解が猫である画像について、猫の確率を0.8と予測すると損失は約0.223、0.2と予測すると約1.609です。正解クラスの確率を高く予測するほど損失が小さくなり、自信を持って誤ると大きな損失になります。複数の画像を学習する場合は、こうした値を平均するなどして使います。
多クラス分類の一般的な表記は、次のとおりです。
\(L=-\sum_{k=1}^{K}y_k\log p_k\)\(K\)はクラス数、\(p_k\)は各クラスの予測確率です。正解クラスだけを1、それ以外を0にしたラベルを\(y_k\)とすると、正解クラスの項だけが残り、先ほどの式になります。猫・犬・鳥のいずれか1つを選ぶ問題などに対応します。
二値分類では、正解ラベルを\(y\in\{0,1\}\)、クラス1の予測確率を\(p\)として、次の二値クロスエントロピーを使えます。
\(L=-\{y\log p+(1-y)\log(1-p)\}\)実装では、確率に変換する前のスコアを受け取る損失関数もあります。確率を渡すのか、未変換のスコアであるロジットを渡すのかを確認し、変換を二重に適用しないようにします。また、確率が0付近のときの対数計算を安定させる処理も必要です。

SVMでよく使うヒンジ損失は、確率ではなく、正解ラベルと分類スコアの関係を評価します。二値分類では、次の形が代表的です。
\(L=\max(0,1-yf(x))\)ここでの正解ラベル\(y\)は、クロスエントロピーの例と異なり、−1か+1です。\(f(x)\)は入力に対する分類スコアで、符号によってクラスを判定します。正しい側に分類できても、\(yf(x)\)が1未満なら損失が残り、分類スコア上の余裕を確保するように学習します。
ただし、ヒンジ損失だけで境界からの幾何学的な距離が最大になるわけではありません。SVMでは通常、重みの大きさを抑える正則化項と組み合わせ、マージンと誤分類のバランスを取ります。境界付近のデータに強くなることを目指しますが、曖昧な画像や未知のデータを必ず正しく分類できる保証はありません。
分類では、データの偏りにも注意します。たとえば正常な製品が圧倒的に多いと、全体の損失を下げても少数の不良品を十分に学習できない場合があります。クラスごとの重み付けやデータの抽出方法を検討し、クラス別の再現率や適合率も確認しましょう。重みを変えた場合は、損失の数値を変更前と単純に比較しないことも大切です。
物体検出のIoUと複数の損失を組み合わせる方法
\(\mathrm{IoU}=\frac{|A\cap B|}{|A\cup B|},\qquad L_{\mathrm{IoU}}=1-\mathrm{IoU}\)物体検出では、「何が写っているか」に加えて「どこに写っているか」も予測します。IoU(Intersection over Union)は、予測した検出枠\(A\)と正解の検出枠\(B\)について、重なった面積を、両方を合わせた領域の面積で割る指標です。和集合では、重なった部分を二重には数えません。

面積のある枠どうしなら、完全に一致したときのIoUは1、まったく重ならないときは0です。共通部分の面積が30、和集合の面積が50ならIoUは0.6になります。
IoUそのものは大きいほどよい指標なので、最小化する損失として使う場合は、たとえば「1−IoU」に変換します。この例なら損失は0.4です。ただし、重ならない枠ではIoUが0のまま変わらない領域があり、位置をどちらへ動かせばよいかという学習の手がかりが乏しくなる場合があります。そのため、IoUを拡張した損失や、座標の差を使う回帰損失も用いられます。
物体の種類と位置を同時に学習するときは、複数の損失を重み付きで足し合わせる方法が使えます。
\(L=\lambda_{\mathrm{cls}}L_{\mathrm{cls}}+\lambda_{\mathrm{box}}L_{\mathrm{box}}\)\(L_{\mathrm{cls}}\)は分類の損失、\(L_{\mathrm{box}}\)は位置の損失です。\(\lambda_{\mathrm{cls}}\)と\(\lambda_{\mathrm{box}}\)は、それぞれをどの程度重視するかを決める係数です。単純に足すだけでは数値の大きい項に学習が偏ることがあるため、合計値だけでなく各項の推移と検出結果も確認します。
損失関数を最小化する仕組み:勾配降下法と学習率
\(\theta_{t+1}=\theta_t-\eta\nabla_{\theta}L(\theta_t)\)勾配降下法は、損失が小さくなる方向へパラメータを少しずつ動かす方法です。\(\theta_t\)は更新前のパラメータ、\(\eta\)は学習率、\(\nabla_{\theta}L(\theta_t)\)は損失の勾配を表します。勾配は局所的に損失が増える方向を示すため、その反対側へ進むように引き算します。
損失を地面の高さ、パラメータを地面上の位置と考えると、周囲の傾きを調べながら低い場所を探すイメージです。ニューラルネットワークでは、逆伝播(誤差逆伝播法)によって各パラメータに対する勾配を効率よく計算し、その勾配を使って最適化手法が更新量を決めます。

勾配の計算に何件のデータを使うかによって、更新の仕方を次のように分けられます。
| 方法 | 1回の更新に使うデータ | 特徴 |
|---|---|---|
| バッチ勾配降下法 | 学習データ全体 | 全体の損失に対する勾配を求める。データが多いと1回の更新に時間がかかる |
| 確率的勾配降下法(狭い意味のSGD) | 通常はランダムに選んだ1件 | 1回の計算は軽いが、データごとに更新方向が揺れやすい |
| ミニバッチ勾配降下法 | 学習データの一部をまとめた小さな集まり | 計算効率と勾配のばらつきのバランスを取る。実務ではこの方法もSGDと呼ぶことがある |
全データを使えば、その学習データ全体に対する勾配を計算できますが、最短経路で最小値へ到達する保証はありません。また、一部のデータを使った更新方向に揺らぎがあっても、最終的な予測精度が必ず低くなるわけではありません。
学習率は、勾配に沿ってどれくらい大きくパラメータを変えるかを決める値です。大きすぎると損失の小さい領域を通り過ぎたり、損失が増え続けたりします。小さすぎると、改善する方向が分かっていても学習がなかなか進みません。学習の途中で学習率を下げるなど、進み具合に応じて調整する方法もあります。
RMSpropは主に過去の勾配の二乗の移動平均を、Adamはそれに加えて勾配自体の移動平均も使い、パラメータごとの更新を調整する最適化手法です。これらは損失関数の種類ではなく、「選んだ損失をどう小さくするか」を担います。使えば自動的に最良のモデルになるわけではなく、学習率などの設定は引き続き重要です。
特にニューラルネットワークの損失は複雑な形になるため、毎回損失が下がることや、全体で最も小さい値に到達することは一般には保証されません。1回ごとの上下だけで判断せず、一定期間の推移と検証データでの性能を見ます。
損失が下がらない・低いのに精度が出ないときの確認点
学習中のlossは重要な手がかりですが、値だけでは原因を特定できません。まず、パラメータ更新に使う訓練データの損失と、更新に使わない検証データの損失を分けて確認します。
| 見えている状況 | 考えられる原因 | 確認・調整の例 |
|---|---|---|
| 訓練損失も検証損失も高い | 学習不足、モデルの表現力不足、特徴量や前処理の問題 | 入力と正解の対応、出力形式、学習時間、学習率を確認する |
| 訓練損失は下がるが検証損失は上がる | 訓練データへの過学習など | 早期終了、正則化、データ量、訓練・検証間の分布の違いを確認する |
| 損失が大きく振動する、発散する | 学習率が高すぎる、数値計算が不安定、極端なデータがある | 学習率、入力の尺度、外れ値、損失への入力値を確認する |
| 損失は下がるが目的の性能が伸びない | 損失と評価目標のずれ、クラス不均衡、判定しきい値の問題 | クラス別の指標や誤りの内訳を確認し、検証データで設定を調整する |
ミニバッチ学習では、難しいデータが多いバッチと簡単なデータが多いバッチで損失が上下します。そのため、1ステップだけ上がったことを異常と決めつけず、複数ステップの平均や、データ全体を一巡するエポック単位で傾向を見ましょう。
また、「lossが0.1以下ならよい」といった共通の合格ラインはありません。損失関数、目的変数の単位、合計か平均か、データの難しさによって値の尺度が変わるためです。同じ予測でも、価格を円で表すか万円で表すかでMSEは大きく変わります。比較するときは、計算方法とデータ条件をそろえる必要があります。
訓練損失が低いことと、未知のデータで役立つことは別に確かめます。設定の調整には検証データを使い、最終確認用のテストデータは調整に繰り返し使わないようにします。損失のグラフに加えて、実際に大きく外れた予測や見逃した事例を見ると、改善すべき点が具体的になります。
まとめ:損失関数は「何を改善したいか」で選ぶ
損失関数は、モデルの予測をどのように採点するかを決める仕組みです。回帰ではMSE・MAEなど、分類ではクロスエントロピーやヒンジ損失などを使い、物体検出では分類と位置の損失を組み合わせます。
選ぶときは、次の順に考えると判断しやすくなります。
- 数値・クラス・位置など、予測したい対象を決める。
- 大きな誤差、見逃し、確率のずれなど、減らしたい誤りを明確にする。
- 外れ値、実測値0、クラスの偏りなど、データの性質を確認する。
- 損失を最適化し、検証データで実際の評価指標も確かめる。
損失関数が「何を改善するか」を定め、勾配降下法やAdamなどの最適化手法が「どう改善するか」を担います。この役割の違いを押さえると、lossの数値だけを追うのではなく、目的に合ったモデルを作るために学習結果を読み取れるようになります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月28日 | MAPEのゼロ除算とIoUの説明を修正し、損失の計算例と選択基準を追記 |