

AIの初心者
「RNN」って難しそうですが、簡単に言うとどんなものですか?

AI専門家
RNNは、前に受け取った情報を次の処理に引き継ぐニューラルネットワークだよ。文章や音声のように、並び順が意味を持つデータを扱うときに役立つんだ。
AIの初心者
前の情報を引き継ぐというのは、データを全部そのまま覚えているということですか?
AI専門家
全部を保存するわけではなく、これまでの入力から作った「隠れ状態」という数値のまとまりを使うんだ。それと新しい入力を組み合わせて、次の単語を予測したり、文章を分類したりする。ただし、長い文章の情報を保つのは苦手なこともあるよ。
RNN(再帰型ニューラルネットワーク)は、過去の入力から得た情報を引き継ぎながら、順序のあるデータを処理する機械学習モデルです。文章の単語、音声の波形、時間ごとの気温などは、値だけでなく「どの順番で現れたか」が意味を持ちます。RNNは、そのつながりを学ぶための仕組みを備えています。
この記事では、RNNの定義から隠れ状態と学習の仕組み、自然言語処理・時系列予測での活用例、長い系列を扱う際の弱点まで説明します。LSTM・GRU・双方向RNNや、CNN・Transformerとの違いも確認し、どのような場面で使えるのかを考えていきましょう。
RNNとは?順序のあるデータを扱うニューラルネットワーク
RNNは「Recurrent Neural Network」の略で、日本語では再帰型ニューラルネットワーク、またはリカレントニューラルネットワークと呼ばれます。ニューラルネットワークは、数値を変換する計算を組み合わせ、データから入力と出力の関係を学習するモデルです。RNNでは、そこに直前の状態を次の計算に戻す接続があります。
RNNが対象とするのは、主に「系列データ」です。系列とは、順番を持つデータの並びを指します。そのうち、毎時の気温や日別の売上のように、時間に沿って観測されたものが時系列データです。文章も単語や文字の順番が大切な系列ですが、必ずしも一つひとつの要素に観測時刻が付いているわけではありません。
例えば、「犬が人を追う」と「人が犬を追う」は、使っている単語が似ていても、並びによって意味が変わります。気温についても、同じ20度でも、その直前まで上昇していたのか、下降していたのかで予測の手掛かりは変わります。RNNは、こうした前後関係を出力に反映するよう学習できます。
出力は未来の値だけとは限りません。単語の並びからレビューを肯定的・否定的に分類する、音声の並びから文字列を求める、といった使い方もあります。「RNNは未来予測専用の技術」と考えず、系列を入力として予測や分類に使えるモデルと捉えると、用途を理解しやすくなります。
RNNの仕組み:隠れ状態を次の時刻へ渡す
単純なRNNの状態更新は、次のような式で表せます。まずは「今の入力と一つ前の状態から、新しい状態を作る」という関係を押さえれば十分です。
\(h_t = \tanh(W_x x_t + W_h h_{t-1} + b)\)式の\(x_t\)は現在の入力、\(h_{t-1}\)は一つ前の隠れ状態、\(h_t\)は更新後の隠れ状態です。\(W_x\)と\(W_h\)は入力や状態の影響を調整する重み行列、\(b\)はバイアスと呼ばれる調整項です。\(\tanh\)は数値を非線形に変換する関数で、単純な足し算だけでは表せない関係を学習するために使います。
隠れ状態とは、それまでの入力から作られた情報を数値のまとまりとして保持する内部状態です。文書をそのまま保存するメモリーとは異なり、入力を変換した表現が次の時刻へ渡されます。単純なRNNでは隠れ状態の大きさをあらかじめ決めるため、文章が長くなっても、その大きさが自動的に増えるわけではありません。
- 最初の状態を用意する。ゼロで初期化するのは一般的な方法の一つです。
- 系列の最初の入力と初期状態を組み合わせ、新しい隠れ状態を計算する。
- 次の入力を受け取り、直前の隠れ状態を使って更新する。
- 目的に応じて、各時刻の状態または最後の状態を出力層へ渡す。
文章分類なら、最後の状態を使って分類結果を求める構成が考えられます。次の単語を予測するモデルなら、各位置の状態を出力層で変換し、候補となる単語の確率を求めます。RNNだけで最終的な答えが決まるのではなく、出力層と学習目標も用途に合わせて設計します。
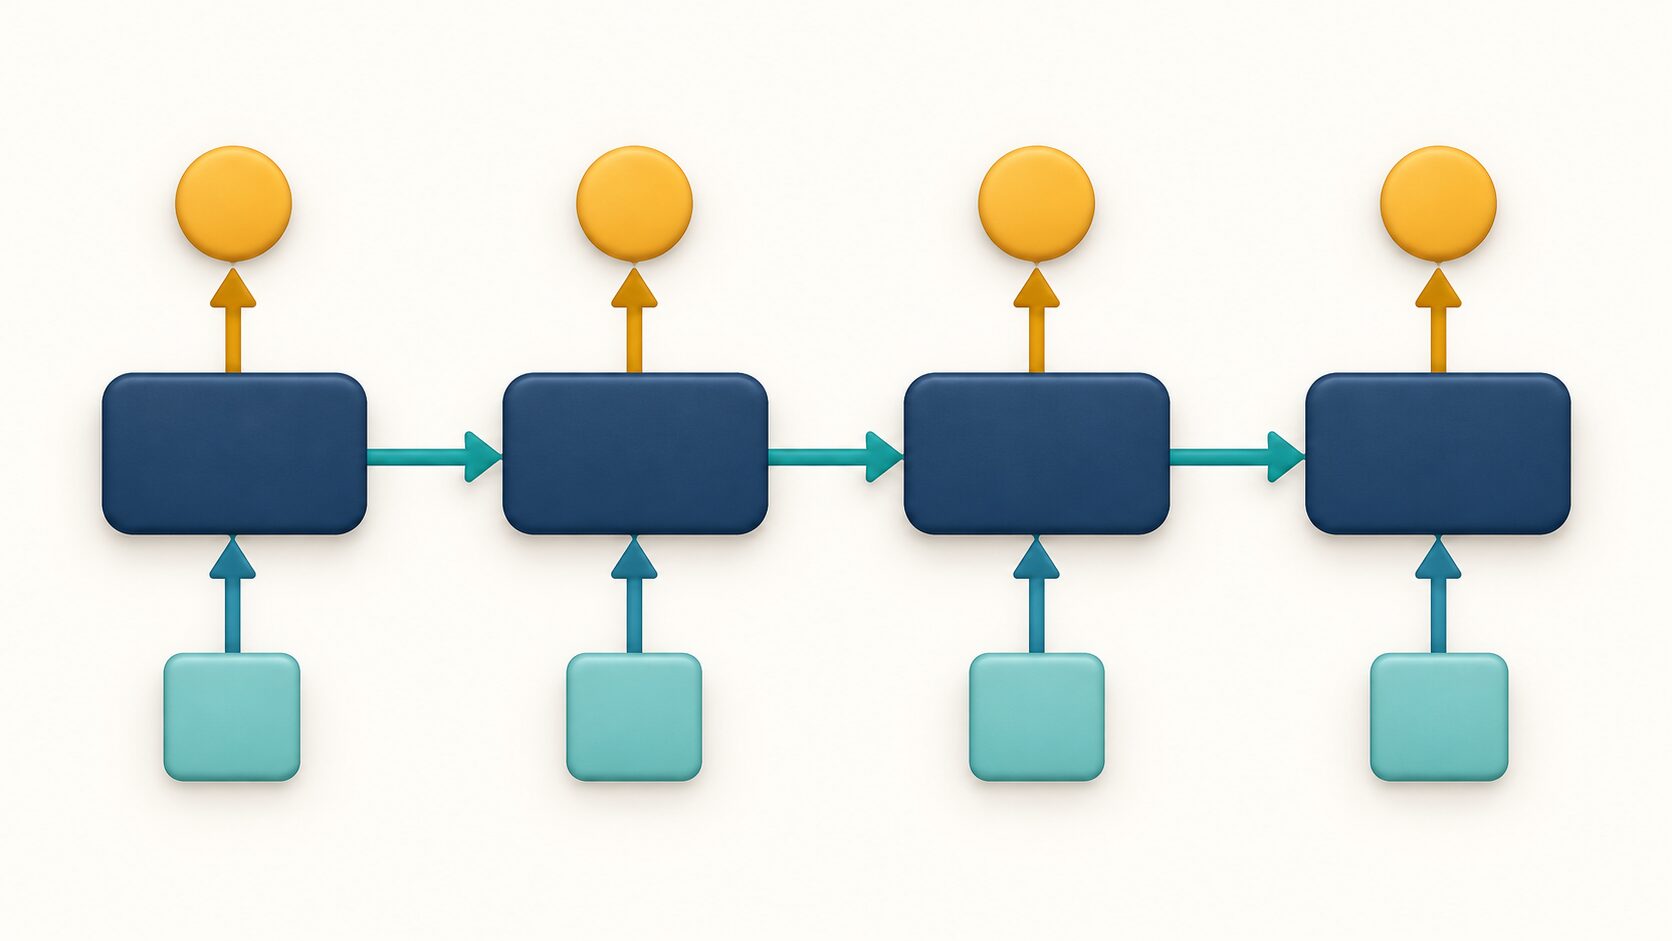
図の横方向は処理の順序、下からの矢印は各時刻の入力、上への矢印は出力を表しています。このようにループを時間方向に広げて描くことを「展開」と呼びます。並んだ処理ブロックは別々のモデルではなく、同じ重みを使う処理です。フィードバックループという言葉も、過去のデータが際限なく巡回するというより、更新した状態を次の処理に再利用する意味で理解すると正確です。
RNNは何を学習する?重みの共有とBPTT
RNNの学習では、出力と正解のずれを損失として数値化し、その損失が小さくなるように重みを調整します。例えば、実際の文章から次の単語を当てる学習では、正解の単語に高い確率を割り当てられるように更新します。気温予測では、予測値と観測値の差に基づいて更新する方法が考えられます。
RNNの特徴は、時刻ごとに別の重みを用意するのではなく、同じ重みを系列全体で共有することです。文章の冒頭でも末尾でも、共通の更新規則を使います。一方、隠れ状態は入力を読むたびに変化します。学習して身につける「重み」と、処理中に変化する「状態」は別のものです。通常の推論では、入力のたびに重みまで学び直すわけではありません。
系列を時間方向に展開し、後の時刻で生じた損失の影響を前の計算へさかのぼって求める学習方法を、BPTT(Backpropagation Through Time、時間方向の誤差逆伝播法)と呼びます。どの重みをどちらへ動かせば損失が減るかを示す「勾配」を計算し、更新に利用します。
ここで、「RNNは新しい情報に必ず大きな重みを付ける」という説明には注意が必要です。基本的なRNNに、情報が新しいという理由だけで優先度を決める規則が組み込まれているわけではありません。過去の情報がどれほど残るかは、入力、状態更新の計算、学習した重みによって変わります。遠い過去の影響が弱まることはありますが、それは情報の重要度を常に正しく判断できているという意味ではありません。
「昼食はカレーだった」「おいしかった」という発言のつながりを利用する場合も、モデルが文脈に対応する表現を学べていることが前提です。人間の記憶にたとえると入口はつかみやすいものの、人間と同じ理解や記憶の仕組みを再現しているわけではありません。
自然言語処理での活用例:文章生成・翻訳・音声認識
自然言語処理は、人が使う言葉をコンピューターで扱う技術です。文章をRNNへ渡す際には、文字や単語などに分けた「トークン」を数値ベクトルに変換し、その並びを処理します。RNNは、直前までに読んだ内容を隠れ状態へ反映することで、単語一つだけでは分からない手掛かりを利用できます。
| 用途 | 入力と出力の例 | 系列のつながりを使う点 |
|---|---|---|
| 文章生成 | ここまでのトークン列から次のトークンの確率を求める | 選んだトークンを次の入力に加え、続きを順に生成する |
| 機械翻訳 | ある言語の文から、別の言語の文を作る | 入力文を符号化し、その表現を使って訳文を出力する |
| 音声認識 | 短い時間区間ごとの音響特徴から文字列を求める | 一瞬の音だけでは判断しにくい音のつながりを扱う |
| 文章分類 | レビュー全文から肯定的・否定的などの分類を求める | 単語の順序や否定表現を含む文脈を判断材料にする |
文章生成では、例えば「明日の天気は」という入力に続く候補を確率として出します。候補から一つを選び、また次の候補を求める処理を繰り返すため、長い文章も生成できます。ただし、一つ先の候補が自然でも、文章全体の事実関係や論理が正しいとは限りません。生成できることと、内容を正確に理解・検証できることは区別して考えます。
RNNによる翻訳には、入力文を読み取るエンコーダーと、訳文を作るデコーダーを組み合わせる構成があります。入力側の各位置の表現を参照する注意機構を組み合わせることもできます。翻訳は単語を一対一で置き換えるだけではなく、語順や文脈を扱う問題であり、RNN以前の翻訳方式にもさまざまな工夫がありました。
音声認識では、波形をそのまま一つの値として見るのではなく、短い区間から取り出した特徴の系列を入力にする方法があります。音の長さと文字数は一致しないため、入力と出力の対応を扱う仕組みも必要です。RNNは時間的な特徴を表現する部分を担い、認識システム全体を一つのループだけで実現するわけではありません。音楽についても、音符や音響特徴の系列を学び、次の要素の推定などに利用できます。

時系列予測での活用例:気温・需要・センサーデータ
時系列予測では、過去の観測値から将来の値を推定します。RNNは、直前の値だけでなく、それまでの増減や繰り返しのパターンを状態へ反映できるため、気温、商品の需要、設備のセンサーデータなどを扱うモデルの候補になります。
例として、1時間ごとの気温を使い、過去24時間から次の1時間の気温を予測する問題を考えます。一つの学習例は「24個の観測値の並び」と「その直後の気温」の組です。この組を時間窓をずらしながら作り、予測と正解のずれが小さくなるよう学習します。24時間という長さは説明用の設定であり、すべてのデータに適した期間ではありません。
入力には、気温だけでなく湿度、時刻、過去の消費電力など、複数の特徴を含めることもできます。需要予測なら、曜日や祝日など、予測時点で分かっている情報も手掛かりになります。ただし、予測する時点でまだ観測できない値を、既知の入力として使わないことが大切です。未来の実測値を混ぜると、検証上はよく当たっても運用時には再現できません。
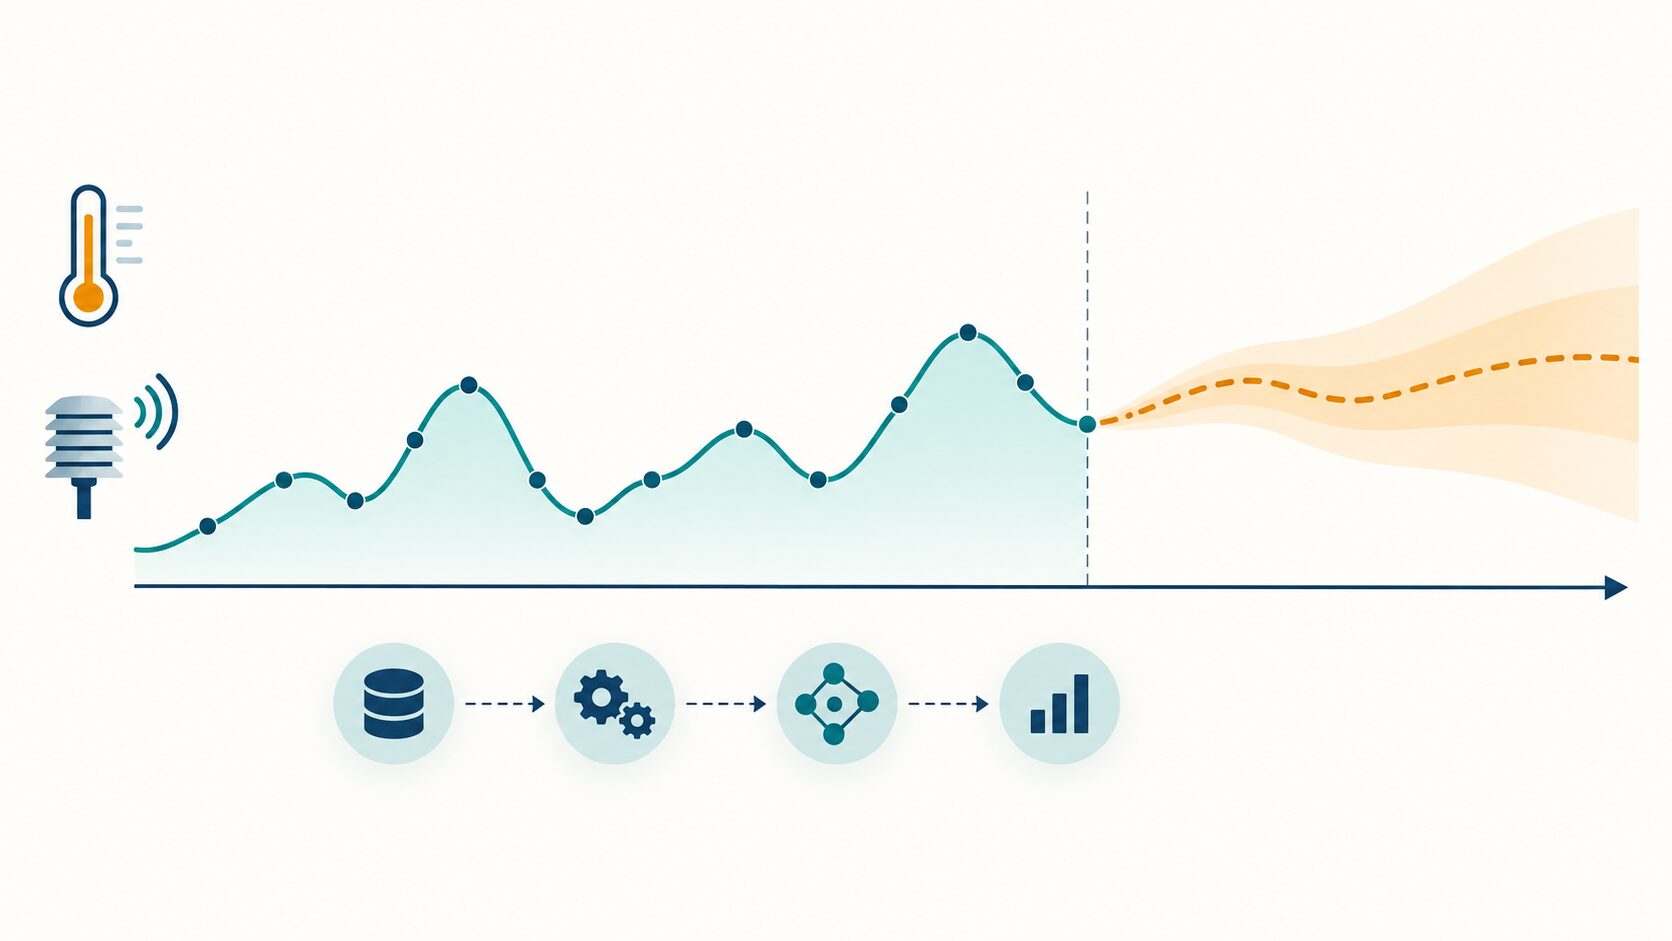
図の左側は過去の観測、右側は将来の推定を表す模式図です。帯は不確実性を表すイメージであり、実測した精度や信頼区間ではありません。通常の点予測を行うRNNが、自動的にこのような区間を返すわけでもありません。複数時刻先を予測するときは、予測値を次の入力へ戻す方法や、複数の将来値をまとめて出す方法があり、前者では誤差が後の予測へ伝わることも考慮します。
医療のバイタルデータ、金融市場の観測値、自動運転に関連する車両・周辺環境のセンサー系列も、時間的な変化を扱う対象です。ただし、RNNを使うだけで診断、市場動向、運転判断が正確になるわけではありません。観測条件や環境が変われば、過去に学んだ関係が通用しない場合もあります。活用の価値は、対象のデータと評価方法を定めて確かめる必要があります。
RNNの弱点:長い依存関係と勾配の問題
単純なRNNの代表的な課題は、離れた位置同士の関係を学びにくいことです。文章の冒頭で出てきた人物の情報を、何十語も後の判断に使う場面を考えると、その情報を多くの状態更新の間、保ち続ける必要があります。固定サイズの隠れ状態に何でも残せるわけではなく、途中の入力によって必要な情報が薄れることがあります。
学習面では、BPTTでさかのぼる途中に微分の値が繰り返し掛け合わされます。その結果、勾配が非常に小さくなる「勾配消失」や、非常に大きくなる「勾配爆発」が起こり得ます。勾配消失では遠い過去の計算へ学習信号が届きにくくなり、勾配爆発では重みの更新が不安定になります。
- 勾配消失への対策として、情報を保ちやすいLSTMやGRUなどの構造を検討します。
- 勾配爆発には、勾配の大きさに上限を設ける「勾配クリッピング」が使われます。ただし、長期記憶の問題全体を解決する方法ではありません。
- 長い系列の計算負荷には、逆伝播する範囲を区切る方法があります。その分、区切りを超えた関係に学習信号を直接伝えることは難しくなります。
また、RNNの状態更新は直前の状態に依存するため、同じ系列内の各時刻をすべて独立に計算することはできません。異なる系列をまとめた計算は可能ですが、時間方向には逐次処理が残ります。長い入力では、記憶の難しさだけでなく、処理時間や学習に必要なメモリーも確認することが大切です。
LSTM・GRU・双方向RNNの違い
LSTMとGRUは、情報を残したり取り込んだりする量を調整するゲートを持つRNNの仲間です。一方、双方向RNNは、系列を読む向きに関する構成です。この二つの違いを押さえると、用語を混同しにくくなります。
| 種類・構成 | 主な特徴 | 利用を考える際のポイント |
|---|---|---|
| 単純RNN | 入力と直前の隠れ状態から次の状態を作る | 基本構造を学びやすいが、長い依存関係の学習が課題 |
| LSTM | 隠れ状態に加えてセル状態を持ち、複数のゲートで情報を調整する | 長い範囲の情報を保ちやすくする設計。計算量やパラメーター数も確認する |
| GRU | 更新ゲートとリセットゲートで状態の引き継ぎを調整する | 標準的な構成ではLSTMより構造が簡潔。精度や速度の優劣は条件による |
| 双方向RNN | 順方向と逆方向の系列処理を組み合わせる | 各位置で前後の文脈を使えるが、入力系列をどこまで観測できるかに注意 |
LSTMは「Long Short-Term Memory」の略で、セル状態を通じて情報を引き継ぐ経路を持ちます。入力ゲート、忘却ゲート、出力ゲートが、取り込む情報、残す情報、出力に使う情報を調整します。GRUは「Gated Recurrent Unit」の略で、より少ない種類のゲートで状態更新を制御します。どちらも残す量を学習しますが、必要な情報を無制限に記憶できるわけではありません。
双方向RNNでは、一つの系列を先頭から末尾へ読む処理と、末尾から先頭へ読む処理を行い、両方の表現を組み合わせます。全文が手元にある文章解析などでは、ある単語の前だけでなく、後に続く単語も手掛かりになります。LSTMを双方向に使うこともできるので、「LSTMか双方向RNNか」は必ずしも二者択一ではありません。

図は構造の考え方を比較したもので、LSTMやGRUの厳密な内部配線図ではありません。実装ではセルの種類と処理方向を別々に検討します。
将来予測で双方向処理を使うときも、利用してよいのは予測時点までに分かっている入力です。過去24時間の観測窓を両方向から読む構成は考えられますが、予測対象である次の1時間の実測値まで含めてはいけません。また、入力が順次届くリアルタイム処理では、まだ届いていない後続の入力を待つ必要がある構成は、応答の遅れにつながります。
RNNとCNN・Transformerの違い
RNNの特徴は「順序を扱える唯一のモデル」という点ではありません。ほかのニューラルネットワークも、入力や構造を工夫すれば系列を扱えます。比較するときは、情報をどのように結び付けるか、予測時点で何が観測できるかに注目しましょう。
| モデル | 情報の扱い方 | 系列データで確認したい点 |
|---|---|---|
| フィードフォワード型 | 入力から出力へ計算を進め、基本構造には時刻間の状態更新を持たない | 過去の値をまとめて入力する設計なら、履歴も使える |
| RNN | 前の状態と現在の入力を組み合わせる | 系列を順に処理しやすいが、長い依存関係と逐次計算が課題 |
| CNN | 近隣の要素に共通のフィルターを適用する | 1次元の畳み込みで系列も扱える。参照できる範囲や未来を見ない設計を確認する |
| Transformer | 注意機構で系列内の要素間の関係を計算する | 位置や順序の情報、参照範囲、長い入力の計算負荷を考慮する |
CNNは画像で知られる構造ですが、時間方向へフィルターを動かすことで、波形や時系列の局所的なパターンも捉えられます。したがって、「CNNは画像専用、RNNは文章専用」という区分は正確ではありません。同様に、通常のコンピューターが過去の情報を保存できないわけでもなく、比較しているのはモデル内で履歴を利用する構造です。
Transformerの基本構成では、RNNのような時刻間の再帰的な状態更新を使わず、注意機構によって各要素の関係を扱います。入力系列の処理を並列化しやすい一方、文章を一つずつ生成する方法では生成手順に逐次性が残ります。どれが適しているかは、系列の長さ、データ量、許容できる遅延、計算資源、予測目的に基づいて比較します。構造の名前だけで精度を決めつけないことが大切です。
RNNを学習・実装するときの進め方と注意点
初めてRNNを試すなら、複雑な会話生成から始めるより、短い系列の分類や、一つ先の観測値を予測する課題で、入力・状態・出力の関係を確認すると理解が進みます。精度を見る前に、モデルへ何を渡し、何を正解とするかを明確にしましょう。
- 課題を決める。分類なのか数値予測なのか、何時刻先を予測するのかを定めます。
- 系列を整える。観測間隔、欠損値、特徴量の単位を確認し、入力期間と正解の対応を作ります。欠損値の補間でも、予測時点より後の実測値を使わないようにします。
- 評価用データを分ける。将来予測では、古い期間を訓練、その後を検証、さらに後をテストにするなど、時間の順序を保ちます。
- 前処理を決める。平均や標準偏差などの正規化に使う値は訓練データから求め、検証・テストには同じ変換を適用します。
- 比較基準とモデルを学習する。直前値や前日の同時刻を予測に使う単純な方法も用意し、RNNを使う効果を比較します。
- 誤差を確認する。数値予測ならMAEやRMSEなど、分類ならクラスの偏りも踏まえた指標を選び、失敗する条件を調べます。
時系列のデータを無造作にランダム分割すると、未来の傾向を学習へ混ぜたり、非常によく似た時間窓を訓練と評価の両方へ入れたりする恐れがあります。評価側の過去の履歴が訓練期間と重なること自体は、運用時にもその履歴が分かるなら不自然ではありません。大切なのは、評価する未来の正解が訓練や前処理に混ざらず、実際の予測条件を再現することです。
隠れ状態の扱いも確認します。別の顧客の履歴や、独立した文章に切り替わったのに状態を引き継ぐと、無関係な情報が混ざります。連続した系列を区切って処理する場合にだけ状態を持ち越すのか、毎回リセットするのかを、タスクに合わせて決めます。長さの違う系列を余白でそろえる場合は、その余白が実データとして計算や損失に影響しない設定も必要です。
MAEは予測のずれの絶対値を平均した指標、RMSEは大きな誤差の影響を受けやすい指標です。平均的な誤差だけでなく、急な変化の時刻や特定の季節に失敗していないかも確認します。訓練データだけでよく当たる状態を避け、同じ条件で単純な方法やLSTM・GRUと比較することが、モデル選びの出発点になります。
まとめ:RNNは過去の情報を次の処理につなぐ仕組み
RNNは、系列を順番に読み、隠れ状態を受け渡して過去の情報を現在の処理へ反映するニューラルネットワークです。文章生成、翻訳、音声認識、文章分類、時系列予測など、並び順が手掛かりになる課題に利用できます。
一方で、隠れ状態は過去のすべてを保存するものではなく、単純なRNNには長い依存関係の学習や勾配の問題があります。LSTM・GRUは状態の保ち方を工夫した構造、双方向RNNは系列を読む向きを工夫した構成です。まずは入力・状態・出力と重みの共有を押さえ、次にデータの分割と評価を確かめると、RNNを使う理由や関連技術との違いを具体的に理解できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月29日 | 隠れ状態と重みづけの説明を修正し、発展形の比較と予測時の注意点を追記 |