
文章を解きほぐす形態素解析とは?品詞分解の仕組みと活用例

AIの初心者
「形態素解析」って難しそうですが、文章に対して何をする技術なんですか?

AI専門家
文章を言葉の単位に区切って、名詞や動詞などの情報を付ける技術だよ。例えば「私はご飯を食べる」なら、「私/は/ご飯/を/食べる」と分けて、「私」は名詞、「食べる」は動詞、というように調べるんだ。
AIの初心者
区切るだけでなく、言葉の種類も調べるんですね。それが検索やAIでどう役立つんですか?
AI専門家
検索に使う語を取り出したり、口コミでよく話題になる言葉を数えたりするときに役立つよ。ただ、区切りや品詞が分かることと、文章の意味を理解できることは別なんだ。AIでの使われ方も、処理の方式によって違うよ。
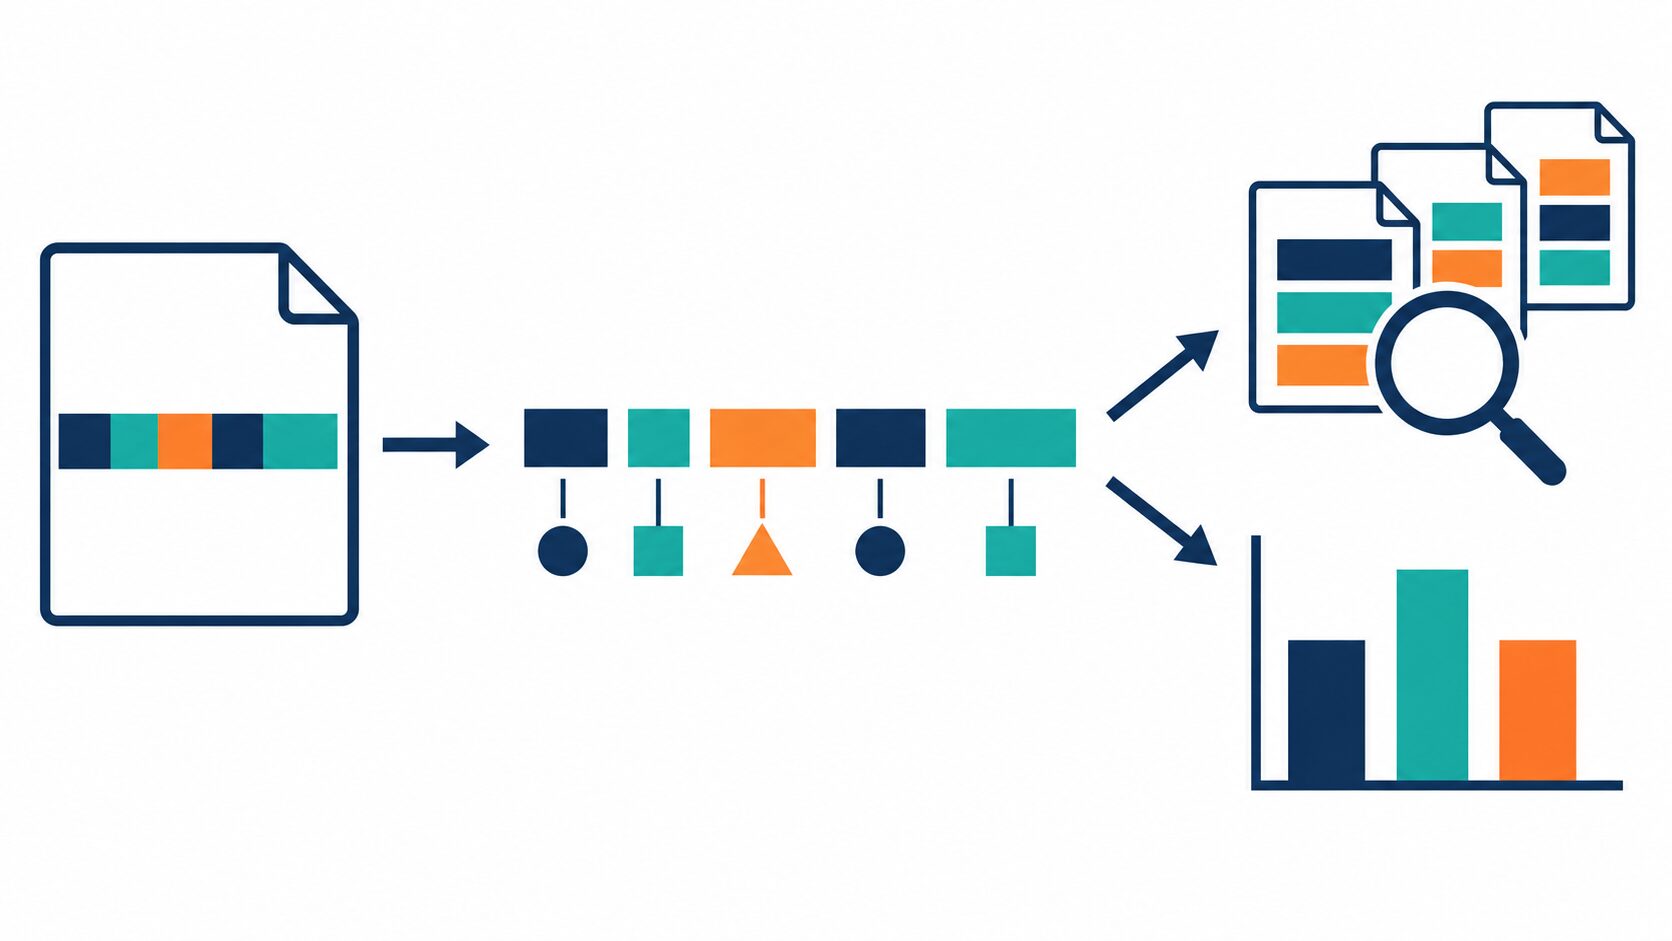
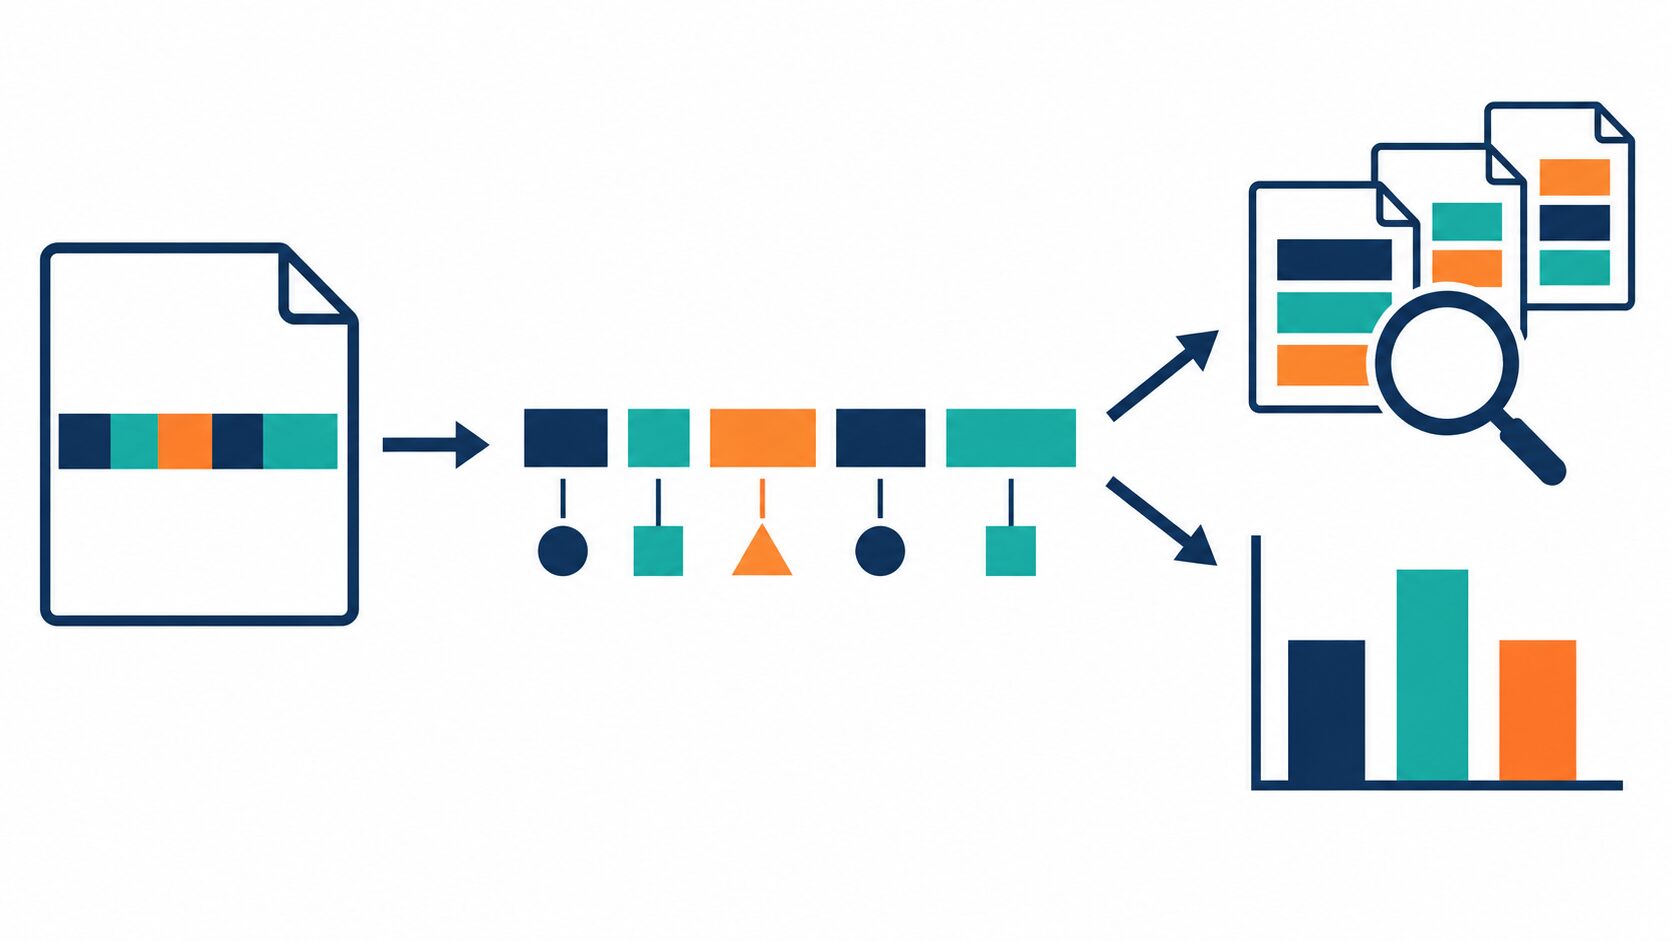
形態素解析とは、文章を形態素という言葉の単位に分け、各単位の品詞や原形、活用などの情報を推定する処理です。人間の言葉をコンピュータで扱う「自然言語処理」の一つで、情報検索や文章データの分析に利用されます。
日本語は普段、単語の間に空白を入れません。そのため、コンピュータで語を取り出すには、まず「どこで区切るか」を判断する必要があります。この記事では、短い例文から分割と品詞の関係を確認し、辞書を使う仕組み、似た用語との違い、活用時の注意点へと進みます。
形態素解析とは何か
形態素は、意味や文法上の働きを担う最小の単位を指します。物や動作を表す部分だけでなく、言葉同士の関係や時制などを表す部分も含まれます。例えば、助詞の「を」は物の名前ではありませんが、「ご飯を食べる」では「ご飯」が食べる対象であることを示す働きがあります。
ここでいう単位は、文字数だけで決まりません。「ご飯」は複数の文字からなりますが、一つの語として扱えます。一方、「読みました」は一続きの表現でも、動作を表す部分、丁寧さを表す部分、過去を表す部分に分けて調べられます。形態素は、一文字や日常的な意味での「単語」と常に一致するわけではありません。
ただし、実際の解析器が出力する単位は、辞書や設計によって変わります。複合語をまとめて扱うものもあれば、構成する語に分けるものもあります。理論上の「最小単位」という説明だけから、どの解析器でも同じ区切りになると考えないことが大切です。
日本語では、区切りと品詞を合わせて考える必要があります。空白のない文字列に対して、辞書にある語を見つけるだけでなく、前後のつながりから適切な候補を選びます。このため、形態素解析の結果は、単に文章へ機械的に空白を挿入したものとは異なります。
学校の文法などで使う「品詞分解」は、文章中の語が名詞・動詞・助詞などのどれに当たるかを調べる説明につながります。形態素解析にもこの作業が含まれますが、コンピュータによる区切りの推定や原形の取得まで扱うため、厳密な同義語ではありません。まずは「文章を区切り、それぞれに文法情報を付ける」と捉えると理解しやすくなります。
文章を分けて品詞と原形を調べる
「私はご飯を食べる」を例にすると、分割結果の一例は「私/は/ご飯/を/食べる」です。区切りを入れたうえで品詞を対応させると、どのような情報が得られるかが分かります。
| 取り出した語 | 品詞 | この文での働き |
|---|---|---|
| 私 | 名詞 | 話し手を指す |
| は | 助詞 | 何について述べるかを示す |
| ご飯 | 名詞 | 食べる対象を表す |
| を | 助詞 | 動作の対象を示す |
| 食べる | 動詞 | 動作を表す |
表の「この文での働き」は理解のために添えた説明であり、解析器がそのまま文章で出力するものではありません。また、ここでは品詞を大まかに示しています。「私」を名詞の下位分類である代名詞とするか、代名詞を独立した品詞とするかなどは、採用する品詞体系によって異なります。
活用する表現では、文中の形と元の形を区別することも役立ちます。「読みました」は、例えば「読み/まし/た」と分け、それぞれを次のように整理できます。
| 表層形 | 品詞 | 原形 | この例で表すこと |
|---|---|---|---|
| 読み | 動詞 | 読む | 読むという動作 |
| まし | 助動詞 | ます | 丁寧さ |
| た | 助動詞 | た | 過去のこととして述べる働き |
表層形は文中に実際に現れた形、原形は活用する前の基本となる形です。「読み」は動詞「読む」が変化した形で、学校文法では連用形に当たります。「まし」も助動詞「ます」の連用形です。このような変化の種類を示す情報が「活用形」であり、原形とは別の項目です。
原形を取り出せると、「読みます」「読めば」に含まれる動詞を、共通の「読む」として集計できます。ただし、丁寧さや過去といった情報まで不要になるわけではありません。何を調べたいかに合わせて、表層形や助動詞も残しておく必要があります。

解析結果では、区切った語だけでなく、こうした項目の対応を見ることがポイントです。解析器によっては読み方や品詞の細分類も得られますが、項目名や分割単位は共通とは限りません。初めて結果を見るときは、短い例文で各列の意味を確かめておくと、後の検索や集計で取り違えを防げます。
辞書と接続の情報で解析候補を選ぶ
形態素解析の代表的な仕組みは、辞書から語の候補を探し、前後のつながりを評価して、文全体として適切な候補の並びを選ぶものです。辞書にある語を順に切り出すだけでは、曖昧な区切りや品詞を十分に判断できません。
例えば「はし」には、橋・箸・端などに対応する候補が考えられます。また、同じ文字列の途中に短い語と長い語の両方が見つかる場合もあります。一つの位置で候補を決め打ちせず、その先の文字列をどのようにつなげられるかも考慮します。ただし、候補を選べることが、文脈上の意味を完全に判別できることを示すわけではありません。
- 語の候補を探す:入力された文字列と辞書を照合し、各位置から始まる語、その品詞、活用などの情報を取り出します。
- 候補のつながりを調べる:候補同士を並べたときに、語や品詞の接続がどの程度自然かを評価します。
- 文全体の候補列を選ぶ:各語の出やすさや接続の評価を合わせて、最も適切と判断した並びを求めます。
- 解析情報を出力する:選んだ区切りごとに、表層形・品詞・原形などを返します。
この辞書は、言葉の意味を文章で説明する国語辞典とは用途が異なります。主に、解析対象となる語の表記、品詞、活用、読み、ほかの語との接続に必要な情報などを保持します。登録する情報の種類や形式は解析器によって異なり、語の詳しい意味説明が必ず含まれているわけではありません。
候補の評価には「接続コスト」や統計的なスコアなどが使われます。コストを使う方式では、語や接続に割り当てた値を組み合わせ、全体のコストが小さい並びを選ぶ、と考えると流れをつかめます。ここでいう文法情報は、例えば動詞の活用した形と助動詞がどうつながるかに関わるものです。文中の主語と述語の関係を確定する処理とは区別します。

学習データから候補の評価に使う重みを学ぶ方式や、機械学習モデルで区切りや品詞を予測する方式もあります。そのため、すべての形態素解析を「辞書と固定した文法規則だけで動く」と説明することはできません。辞書の充実と学習の両方が改善に役立ちますが、対象分野の文章に合っているかは、実際の出力で確認する必要があります。
分かち書き・構文解析・トークン化との違い
自然言語処理には、文章を区切る処理、語同士の関係を調べる処理、意味を扱う処理があります。似た説明に見えても、目的と出力は異なります。「何を一つの単位とし、どの情報を得たいか」に注目すると、用語の違いを捉えやすくなります。
| 処理 | 主な目的 | 出力・扱う情報の例 |
|---|---|---|
| 分かち書き | 文章を語などの単位に区切る | 「私 は ご飯 を 食べる」のような区切り |
| 形態素解析 | 区切りと各単位の文法情報を調べる | 「青い」は形容詞、「空」は名詞などの情報 |
| 構文解析 | 語や句の結び付き、文の構造を調べる | 「青い」が「空」を修飾する関係 |
| 意味解析 | 語や文が表す意味を扱う | 文脈を踏まえた語の意味や、誰が何をしたかなどの関係 |
| トークン化 | モデルやプログラムが扱う単位に変換する | 単語・サブワード・文字などの列。モデル入力では対応するID列など |
分かち書きは、区切りを得ることに注目した呼び方です。形態素解析の結果から品詞などを省き、語の列だけを取り出して分かち書きに使う場合もあります。したがって、両者は無関係な処理ではありませんが、品詞や活用まで必要なのか、区切りだけでよいのかという違いがあります。
「青い空」で「青い」が形容詞、「空」が名詞だと調べるのは形態素解析の役割です。一方、「青い」がどの語を修飾しているかという関係は、構文解析で扱います。短い表現では人には同時に分かることでも、処理の目的として分けて考えると、形態素解析に任せられる範囲が明確になります。さらに、比喩や前後の文脈を踏まえて意味を捉えることは、別の検討が必要です。
トークン化の「トークン」は、処理に使う単位という広い意味の言葉です。形態素をトークンとして使うこともありますが、モデルによっては、語をさらに小さくした「サブワード」や文字などを用います。これらはモデルの語彙や分割規則で決まり、人が考える形態素の境界とは一致しないことがあります。
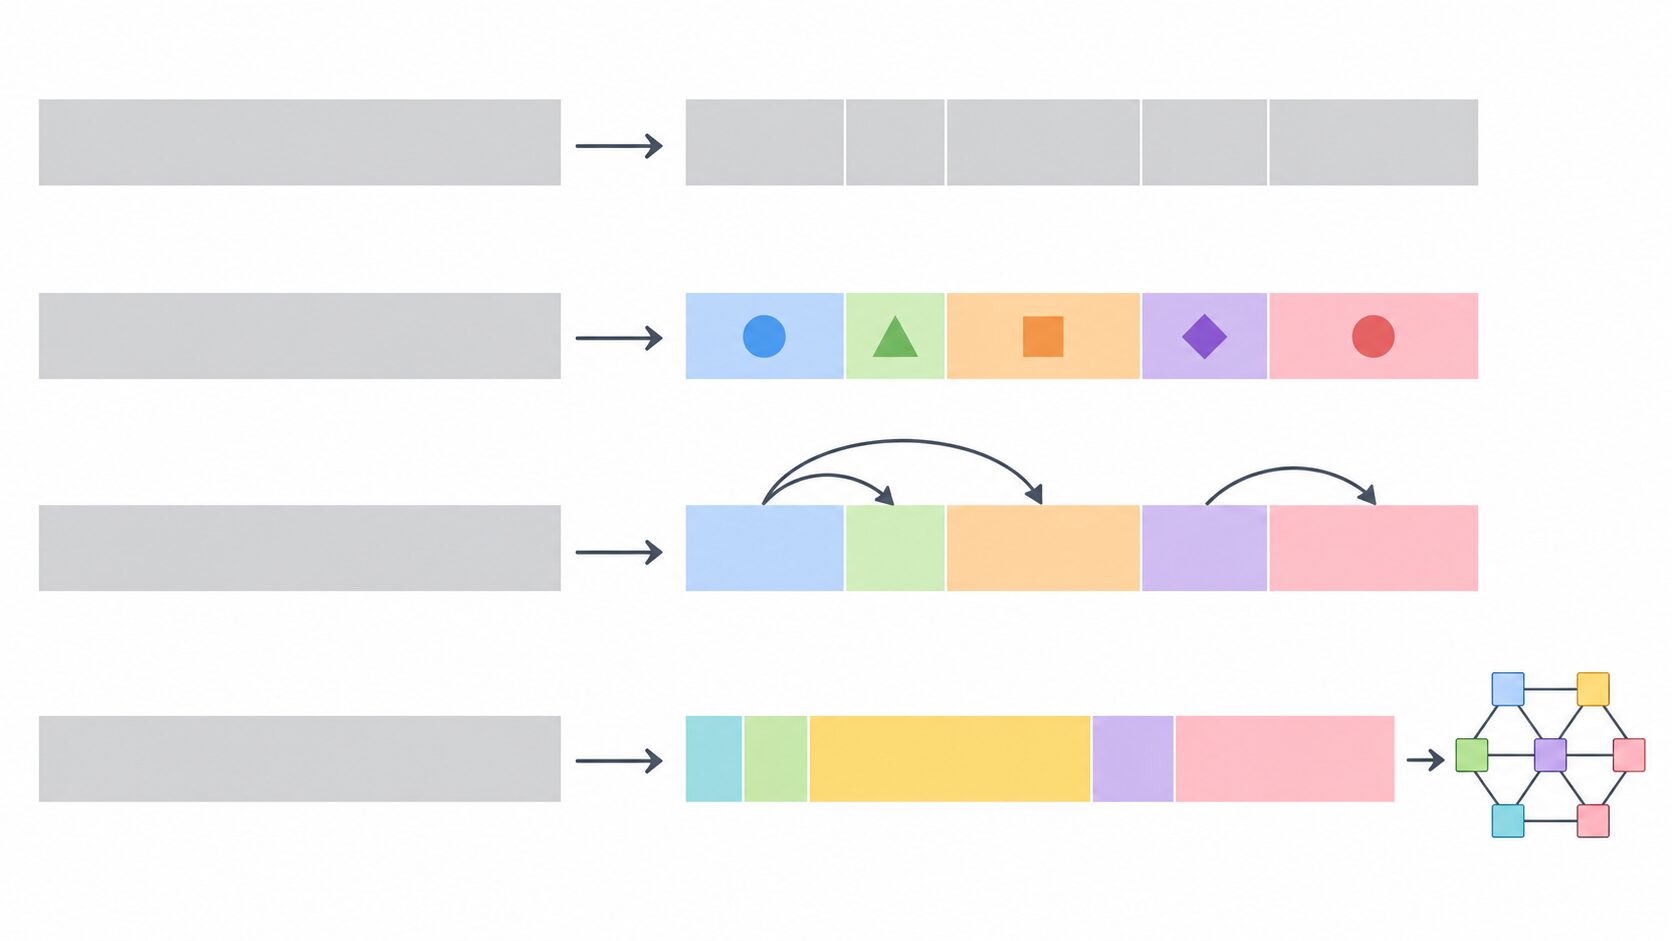
この違いから、すべてのAIが文章を読む前に、独立した形態素解析を行うとは限りません。モデル用のトークン化を通じて文章を処理する方式もあります。形態素解析は、品詞を指定して語を取り出したい場合などに役立つ技術として、目的に合わせて位置付けることが大切です。
検索や文章分析での活用例
形態素解析が役立つのは、文章を語単位で探したり、種類別に集めたりしたい場面です。検索語と文書を対応付ける情報検索や、多数の文章から傾向を調べるテキストマイニングでは、区切り・品詞・原形が処理の手掛かりになります。
情報検索では、検索対象の語を取り出すために利用できます。文書から語を抽出して、どの文書にどの語が含まれるかを記録しておけば、検索時の照合に使えます。例えば、原形にそろえることで「走る」と「走った」に含まれる動詞を共通の語として扱いやすくなります。検索語側と文書側で分割や原形化の方針をそろえることも、検索漏れを減らすうえで重要です。
ただし、「車」と「自動車」のような同義語は、活用の違いではありません。原形にそろえる処理だけで、同じ意味の語をすべてまとめることはできません。同義語辞書や、意味の近さを扱う別の仕組みが必要になります。また、検索語の切り出しが正しくても、それだけで利用者の意図や検索結果の順位が決まるわけではありません。
口コミ分析では、話題や評価に関わる語を抽出できます。店舗への口コミから「接客」「価格」「料理」といった名詞や、「丁寧」「安い」など評価に関わる表現を取り出せば、何が話題になっているかを調べる材料になります。品詞を条件に語を選び、表記を必要な範囲でそろえ、出現回数や含まれる口コミの件数を数える、といった手順です。
ここでは、語を数えるだけで結論を出さないことが大切です。「価格は高くない」から「高い」に対応する部分だけを残し、否定の「ない」を落とすと、割高だという評価に読み違えるおそれがあります。「料理はおいしいが、接客は良くない」のように、同じ口コミの中で対象ごとに評価が異なる場合もあります。評価語と対象の関係、否定を含む周辺の表現を一緒に確認します。

集計方法によっても結果の意味が変わります。一人が「価格」を何度も書けば出現回数は増えますが、価格に言及した人が多いとは限りません。「語が何回出たか」と「何件の口コミに出たか」を使い分け、頻度の高い語について元の文を確認すると、分析の解釈が安定します。重要語の抽出でも、頻度に加えて、ほかの文書ではあまり使われない語かどうかなどを考慮する方法があります。
機械翻訳、文章要約、音声認識でも、方式によっては形態素解析の結果や語の情報が利用されます。ただし、それぞれの処理には形態素解析以外の役割があります。
| 分野 | 語や品詞の情報が役立つ場面 | 形態素解析だけでは扱いきれないこと |
|---|---|---|
| 機械翻訳 | 原文の語や活用を捉える前処理など | 文脈に合う訳語の選択、語順の調整、自然な訳文の生成 |
| 文章要約 | 重要語の候補や話題を捉える処理など | 要点の選択、文同士の関係の把握、意味を保った文章化 |
| 音声認識 | 文字列候補の評価を支える語の情報の利用や、認識後のテキスト処理など | 音声信号からの推定や、音声ノイズへの対処そのもの |
翻訳は語ごとの訳を置き換えるだけでは成立せず、要約も重要語を並べるだけでは十分ではありません。音声認識においても、文字列の解析だけで音声のノイズを取り除けるわけではありません。形態素解析を前処理として使うかどうかを含め、システム全体の方式によって役割が変わります。
解析が苦手な表現と精度を高める工夫
形態素解析の結果は常に正しいとは限りません。新しい商品名、人物名、専門用語、略語、くだけた話し言葉などは、辞書や学習データで十分に扱われていない場合があります。その結果、一つにまとめたい語が細かく分かれたり、品詞が想定と異なったりすることがあります。
辞書に登録されていない語は「未知語」と呼ばれます。解析器には文字の種類や学習した傾向から未知語を扱う仕組みもありますが、固有名詞や専門用語を必ず適切に認識できるわけではありません。例えば、新製品名が既知の短い語に分かれると、製品ごとの口コミ集計で数え漏れにつながる可能性があります。
一方、結果の違いがすべて誤りとは限りません。複合語を一まとまりで出すか、構成する語に分けるかは、辞書や分割粒度の設計によっても変わります。「機械学習」を一つの用語として数えたい場合と、「機械」「学習」を含む文書まで広く探したい場合では、適した単位が異なります。出力の細かさは用途に照らして判断します。
| 困りやすいこと | 改善の工夫 | 確認する点 |
|---|---|---|
| 商品名・専門用語が意図しない単位に分かれる | 専門辞書やユーザー辞書で必要な語を補う | 対象の語だけでなく、ほかの文での分割にも悪影響がないか |
| 複合語のまとまりが目的に合わない | 辞書や解析器の分割粒度を選ぶ | 検索のしやすさや集計単位に合うか |
| 全角・半角などの違いで語が別々に数えられる | 目的に必要な範囲で表記を統一する | 商品コードなど、残すべき区別を消していないか |
| 口語や省略の多い文章で誤りが増える | 対象分野に合う辞書・モデルを検討し、実例で調整する | 実際の入力に近い文章で改善しているか |
ユーザー辞書へ登録するときは、表記だけでなく、品詞や読みなど必要な情報も適切に設定します。また、英字の大文字・小文字、全角・半角などをそろえる正規化は便利ですが、用途によっては識別に必要な違いも失われます。元の文章を残しておくと、集計結果の確認や処理方針の見直しに役立ちます。
正しく分割できることと、文脈上の意味を正しく捉えることは別の課題です。「橋をかける」は、川に橋を造ることを指す場合もあれば、人と人との間を結ぶという比喩で使われる場合もあります。どちらも同じように区切れて品詞が付いたとしても、物理的な橋なのか比喩なのかは、それだけでは確定しません。
「工事で川に橋をかける」と「交流を通じて人と人との間に橋をかける」では、周辺の表現が解釈の手掛かりになります。形態素解析が提供する語の情報を出発点に、語同士の関係や文脈を扱う処理を組み合わせる必要があります。辞書の更新や学習によって解析精度が上がっても、完全な文章理解が保証されるわけではありません。
実務では、最初に実際の入力を代表する短い文を集め、区切り、品詞、原形、最終的な用途への影響を順に確認すると進めやすくなります。一般的な文に加え、商品名、否定表現、口語、表記ゆれを含む文も用意し、期待する結果と照らし合わせます。辞書を変更した後は、直したい例の改善だけでなく、ほかの代表文の結果も確認します。
評価の着地点は、解析結果の見た目だけではありません。検索なら必要な文書を見つけられるか、口コミ分析なら対象の語を正しく数えられるかを確かめます。形態素解析で得られる情報と限界を理解し、目的に合った単位で使うことが、文章データを役立てる第一歩になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | 用語と分割例を訂正し、関連処理との違いや口コミ分析の注意点を追記 |