
AI評価の二重盲検とは?モデルと試験問題を保護して性能を測る仕組み

AIの初心者
AIの性能試験では、問題を先に知られないことが大切だと聞きました。でも、問題を渡さなければAIは答えられませんよね。非公開のAIをどうやって公平に試すのでしょうか?

AI専門家
そこで考えられるのが、モデルの中身と試験問題を互いに保護し、隔離された実行環境で評価する方法です。AIはその中で問題を処理しますが、問題をモデル提供者へそのまま開示する必要を減らせます。
AIの初心者
それなら、点数が高いAIを安心して選べるのですか? モデル名を隠して回答を比べる評価との違いも気になります。
AI専門家
ここで隠す対象は、主にモデルの重みと非公開の問題です。問題を守れても、問題の選び方や採点が適切とは限りません。誰が何を見られるのかと、その点数で何を判断できるのかを、順に整理しましょう。
二重盲検AI評価とは。
本記事で扱う二重盲検AI評価は、評価者に非公開モデルの重みを開示せず、モデル提供者に非公開の試験プロンプトを開示しない形で、合意した処理を通じて性能を調べる評価設計です。重みとは学習で調整されたモデル内部の数値、プロンプトとはAIへ与える指示や質問などの入力を指します。双方の機密を守りながら評価を成立させることが中心であり、AI自身が問題を処理できなくなる仕組みではありません。
AIのランキングや評価報告を読むときは、点数だけでなく、試験問題がどのように扱われたかも気になります。一方、独自の問題で外部モデルを調べたい組織にとっては、問題集を渡すことと、モデルを受け取ることの両方に難しさがあります。この記事では、情報の受け渡し、実行の仕組み、採点と結果共有をたどり、評価の信頼性を判断する材料を整理します。
以下では一般的な設計の説明、2026年に公表された実証、理解のための架空例を区別します。公開実証に関する情報の確認日は2026年9月30日です。画像は役割や情報の流れを説明するための独自の概念図として配置しています。
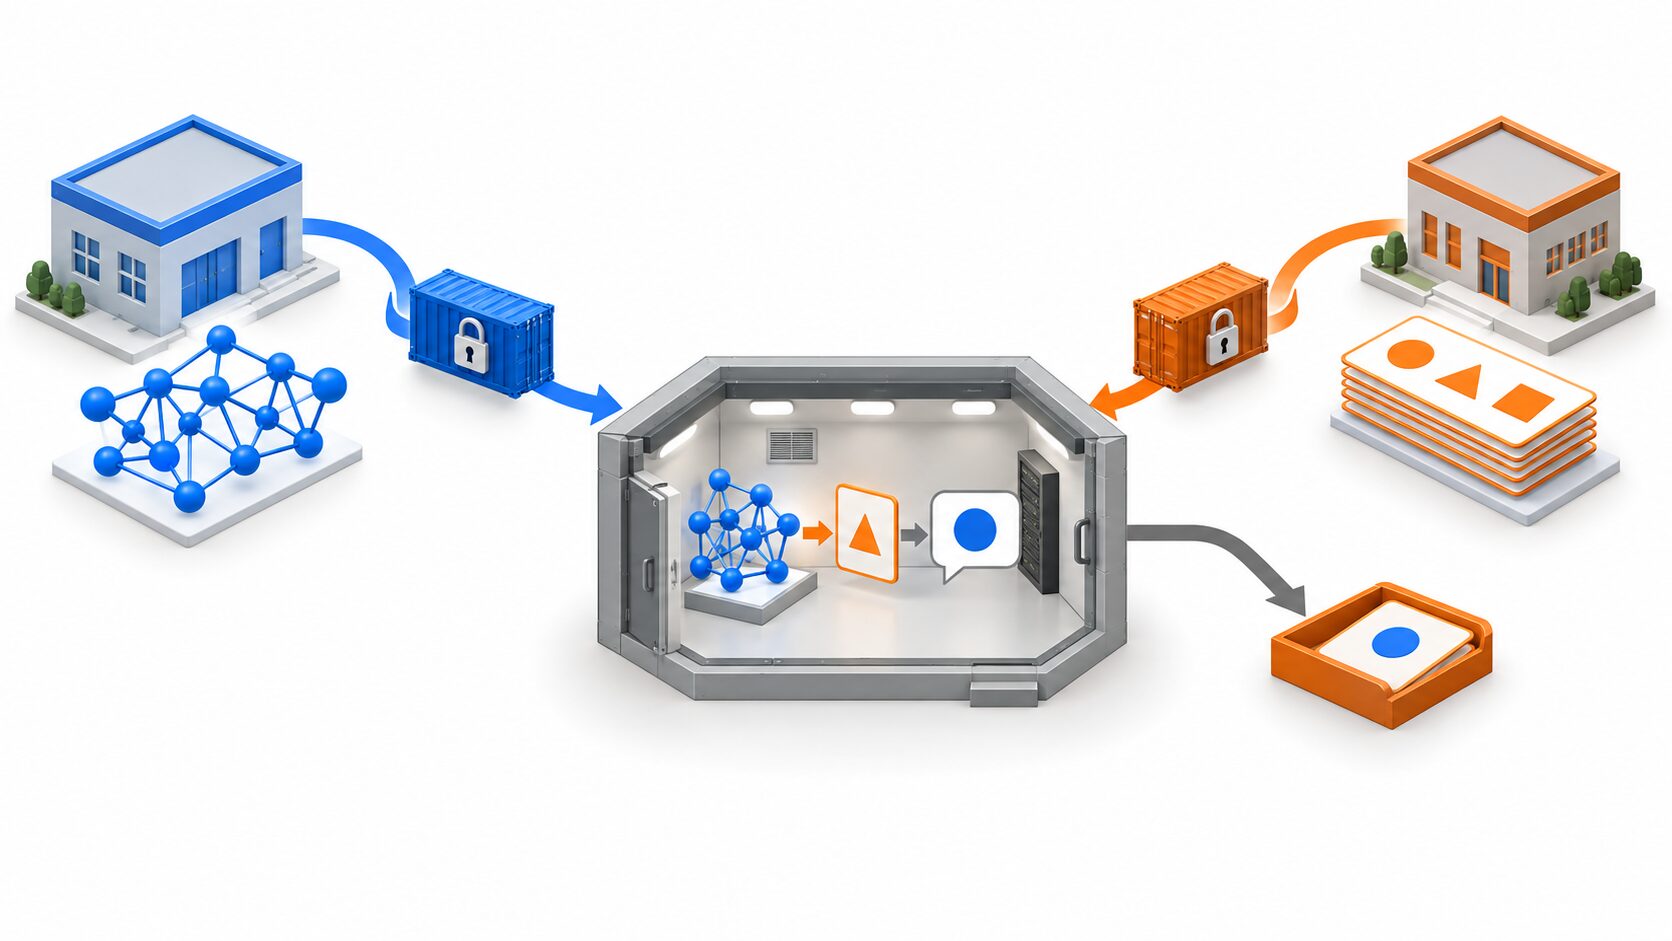
モデルと試験問題を同時に守る理由
第三者によるAI評価には、評価者が確かめたいことと、提供者が外に出したくない情報が同時に存在します。評価者は自分たちが選んだ問題を使い、回答を確かめたいと考えます。提供者は評価に協力したくても、開発に関わる資産である重みを、そのまま他の組織へ渡せるとは限りません。モデルを全面的に公開する方法だけでは、評価の対象にできないAIが生まれます。
逆に、評価者が問題集をモデル提供者へ渡す方法にも課題があります。未公開の問題集は、将来の評価にも使う資産です。一度問題が広く知られると、同じ問題にうまく答えるための調整が可能になり、未知の状況への対応力を測りにくくなります。問題の作成には、業務知識の整理、正解の確認、採点基準の整備といった手間もかかるため、簡単に使い捨てにはできません。
試験対策そのものがすべて不適切というわけではありません。評価結果を見て弱点を改善することは有益です。ただし、試験用の特定の文章や正解に合わせた改善と、その分野の能力全体が高まることは区別する必要があります。たとえば、決まった返品の質問には答えられても、購入条件を少し変えると誤るなら、その点数だけで問い合わせ対応力全体を判断するのは難しくなります。
ここでの二重盲検は、モデルを守ることと、問題の事前露出を抑えることを両立させるための設計です。試験会場に、開ける権限が異なる二つの封筒を持ち込む場面を考えると理解しやすいでしょう。会場内では解答に必要な情報を使いますが、問題の持ち主がモデル一式を持ち帰ったり、モデルの持ち主が問題集を受け取ったりする必要はありません。ただし、この比喩だけでは保護は実現せず、実際には実行環境や情報の出口の設計が必要です。
また、今回の評価で問題の流出を防ぐことと、過去の学習データを調べ尽くすことは別です。モデルが学習した資料の中に似た問題や答えの手掛かりがあった可能性まで、この方式だけで否定できません。学習と評価に同じ内容が混ざる「データ汚染」については、問題の由来や管理方法も検討します。機密保護は、新たな露出経路を減らす手段であり、学習履歴全体を証明する機能ではありません。
匿名比較や通常のベンチマークとの違い
「二重盲検」という言葉だけでは、何を誰から隠すのかが分かりません。AI評価では、モデル名を伏せて二つの回答を人に見せ、どちらを好むか選んでもらう方法もあります。この匿名比較は、ブランド名や提供元への先入観が判断に混ざることを抑えるための工夫です。本記事の主題である、モデルの重みと問題集の相互保護とは、隠す対象が異なります。
医薬品の試験などで使う盲検も、割り当てを知ることによる判断への影響を抑える文脈で用いられます。その意味をそのままAIの実行環境に当てはめると、「評価者も提供者も結果を知らない」「AIが問題を見ない」といった誤解につながります。呼び方が似ていても、誰のどの情報を、どの場面で見えなくする設計なのかを確認することが先です。
| 考え方 | 主に決めること | それだけでは決まらないこと |
|---|---|---|
| ベンチマーク | どの課題をどの基準で測るか | 問題を誰に見せるか、実行環境をどう守るか |
| ホールドアウト | 学習や調整に使わず評価用に取り置く範囲 | 評価時の送信先や、その後の情報管理 |
| モデル名を隠す匿名比較 | 回答を判断する人に提供元を知らせるか | 問題集とモデルの重みの相互保護 |
| 本記事の二重盲検 | 提供者と評価者の機密を、合意した実行の中でどう保護するか | 課題の妥当性、採点の公平さ、業務への適合性 |
これらは、一つを選んだら他を使えなくなる関係ではありません。取り置いた問題でベンチマークを構成し、保護された環境で推論を行い、その回答をモデル名なしで人が採点する設計も考えられます。それぞれの役割を分けると、「匿名だから問題は漏れない」「未公開の試験だから提供者も入力を見られない」といった飛躍を避けられます。
通常のAPI評価では、評価者の端末からサービス側へ入力を送って回答を受け取ります。問題を一般公開していなくても、処理のために送信先のシステムへ渡していることには変わりません。その後の保存、アクセス、学習への利用などの扱いは、個別の契約や設定、構成に依存します。非公開テストであることだけから、相互の機密保護が実現しているとは判断できません。
一方、通常のAPIでも目的に合う評価はできます。一般的な文章要約の使い勝手を試す場合と、長く秘匿したい独自問題で複数組織が評価する場合では、必要な保護の程度が違います。評価方式の名前を比べるだけでなく、守りたい情報と知りたい能力を先に整理すると、必要な仕組みを選びやすくなります。
誰が何を見られるのか
役割の基本は、モデル提供者が重みを保有し、評価者が問題を保有することです。合意した実行環境では、それらを使ってAIが推論し、許可された受領者が結果を受け取ります。情報を計算に使えることと、相手組織がその情報を自由に閲覧できることを分ける点が、この方式の理解の中心です。
次の表は、評価者が生の回答を受け取って採点し、提供者には集計を返す場合の設計例です。すべての実装がこの権限配置になるわけではなく、公表された実証の全アクセス権を示すものでもありません。結果を誰に返すかによって、回答や設問別採点の扱いは変わります。
| 情報 | モデル提供者 | 評価者 | 許可された実行処理 |
|---|---|---|---|
| 非公開モデルの重み | 自ら保有する | 受け取らない | 推論に必要な形で利用する |
| 非公開の試験問題 | 生の問題を受け取らない | 作成・管理して投入する | AIへの入力として処理する |
| AIが生成した生の回答 | この例では受け取らない | 受け取り採点する | 生成し、許可先へ返す |
| 設問別の点数と採点理由 | この例では受け取らない | 保持して分析する | 採点を環境外で行うなら保持する必要はない |
| 分野別の集計や失敗類型 | 合意した範囲で受け取る | 取りまとめて共有する | 作成場所と送信方法は別途決める |
モデルは問題を知らずに答えを当てるわけではありません。たとえば文章から条件を読み取る評価なら、その文章は隔離環境内でモデルの入力になります。入力を処理する主体としてのAIと、サービスを開発・提供する組織を同一視しないことが大切です。実行のためのアクセスと、人が運用上閲覧するためのアクセスを区別して考えます。
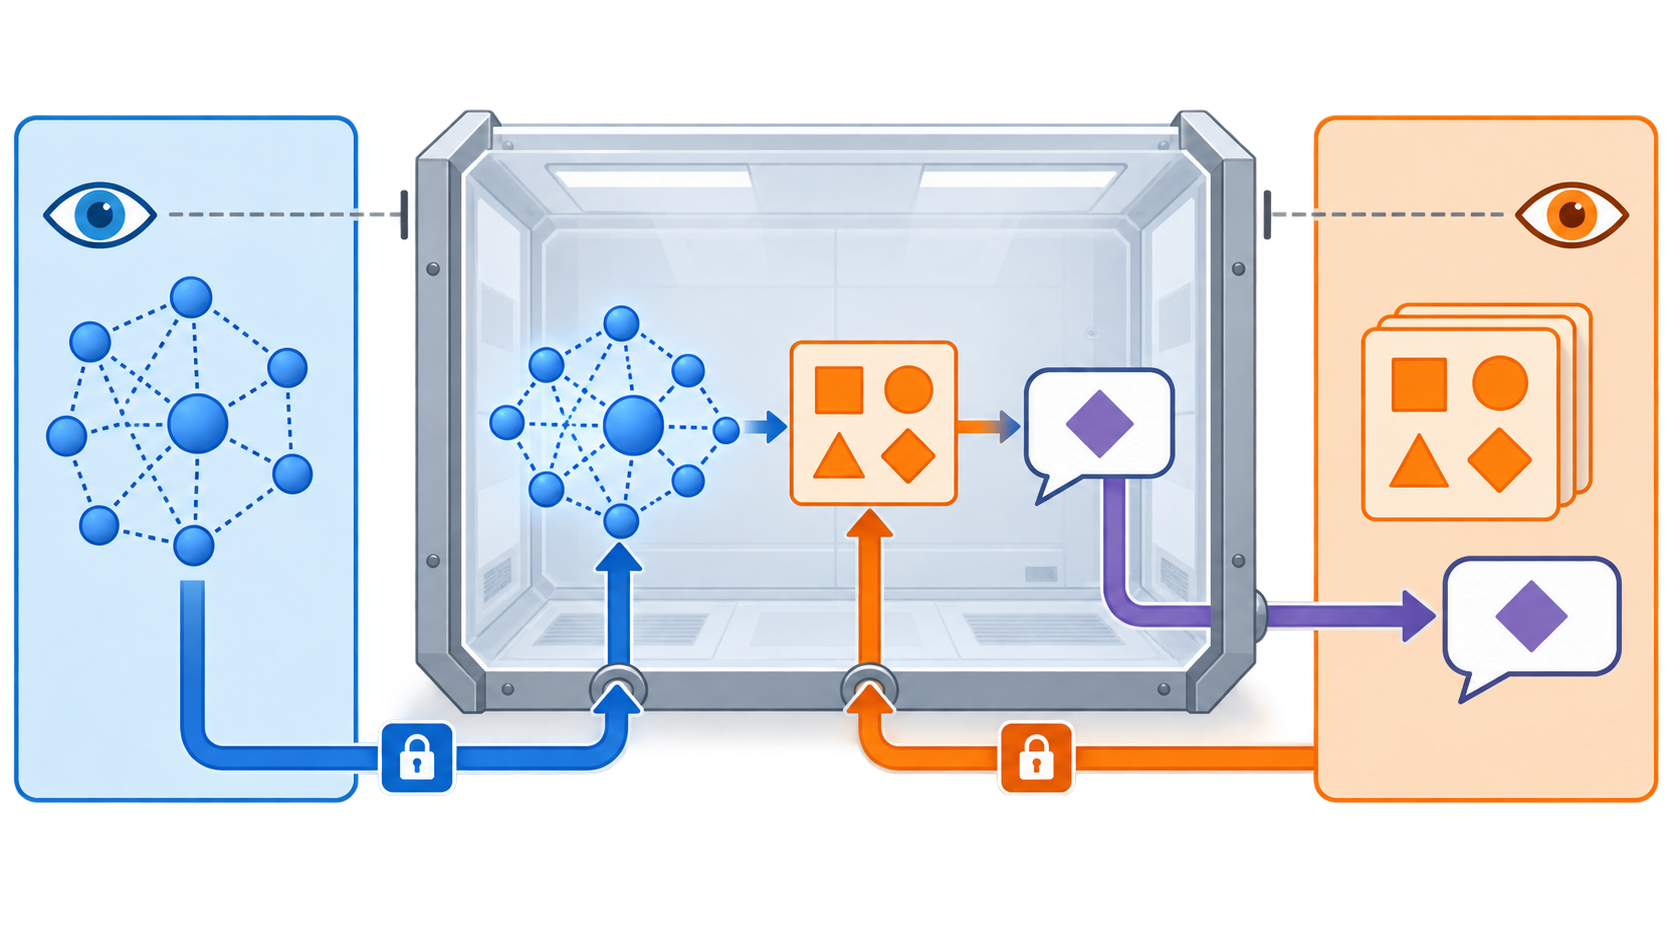
さらに、実行用コードを書く人と、計算環境を起動・運用する人も区別します。コード作成者は入力から出力までの処理を設計し、運用者はその処理を動かしますが、運用できるという理由だけで機密情報を自由に読める構成にしてよいわけではありません。データ所有者、コード作成者、実行運用者の役割を整理すると、確認や承認を誰が担当するかも明確になります。
同じ組織が複数の役割を担う場合も、役割ごとの権限を文章にしておくことが有用です。「第三者評価」という名称だけでは、実行環境を誰が準備し、処理を誰が点検したのかまでは分かりません。役割の分離、実際の組織の分離、技術によるアクセス制限はそれぞれ確認します。特にログや一時ファイルの扱いは、重みと問題の説明から自動的には決まらない項目です。
暗号化と隔離環境で評価を進める仕組み
相互の機密保護では、暗号化して送るだけでなく、情報を使っている間の扱いも考えます。通信や保存が暗号化されていても、通常の処理では計算のために内容を利用する場面があるからです。その実行中の保護を担う考え方がConfidential Computingであり、保護された計算領域であるTEEがその土台になります。TEEは「決められた境界の内側で処理し、外側からのアクセスを制限する場所」と捉えるとよいでしょう。
一般的な流れは次のように整理できます。ここでは仕組みを理解するための順序を示しており、特定サービスの設定手順や、公表された実証のすべての内部処理を再現するものではありません。
- 処理と受領者を合意する。どのモデルと評価コードを使い、何を入力し、どの情報を誰へ返すかを決めます。許可する外部通信や、結果の形式も確認対象です。
- 入力とモデルを保護して用意する。それぞれの所有者が機密情報を準備し、許可された処理で利用するための条件を設定します。暗号化されたデータが届くことと、その場で復号を許すことは分けて考えます。
- 実行環境の証明情報を確認する。動かそうとしている実行イメージなどの情報が、合意した条件と一致するかを検証し、秘密情報へのアクセス判断に使います。
- 保護された環境で推論する。条件を満たした処理が入力と重みを利用し、モデルが回答を生成します。モデルはここで問題の内容を処理します。
- 許可した範囲の結果を渡す。回答や集計を、決められた受領者へ返します。環境内で採点するか、回答を受け取った評価者が採点するかも設計によって異なります。
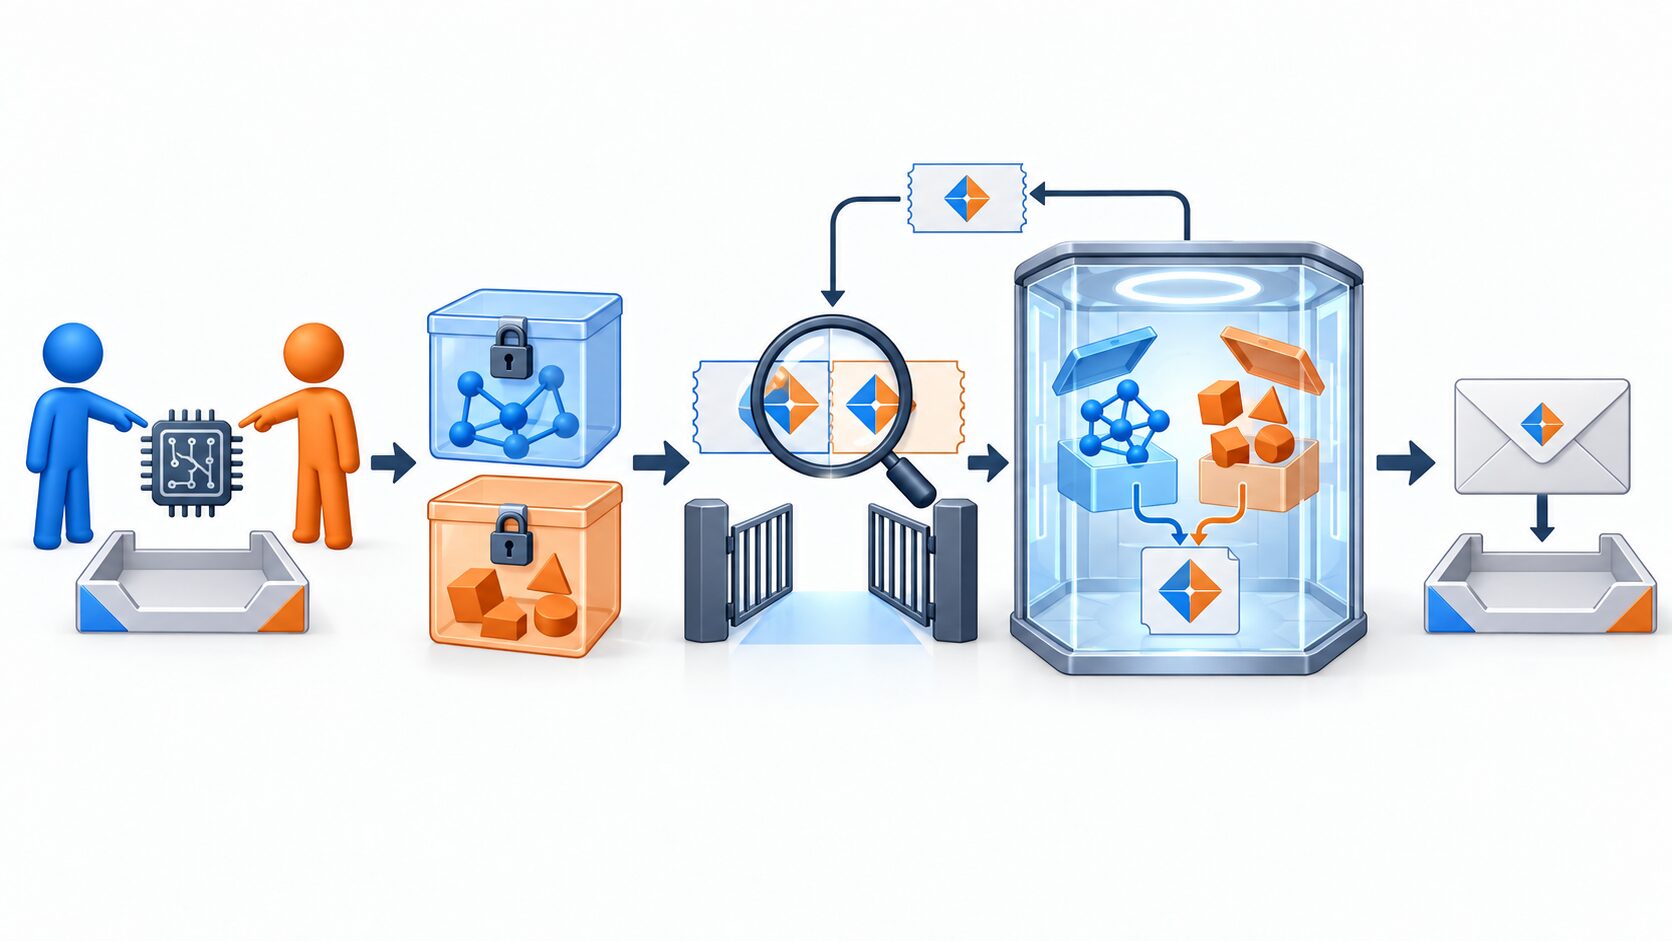
この証明情報を使う確認を「アテステーション」と呼びます。人が「予定どおりの環境です」と申告するだけでなく、実行イメージなどの測定値を条件と照合する考え方です。TEEによる実行中の保護と、アテステーションによるアクセス判断は役割が違います。Google Cloudの説明では、Confidential Spaceはこうした仕組みを用いて、複数主体の機密情報を合意した処理で利用する環境として整理されています。(確認日:2026年9月30日。出典:Confidential Spaceの概要、Confidential Spaceのセキュリティ概要)
実行イメージとは、動かすプログラムとその実行に必要な内容をまとめたものです。想定したイメージであると確認できても、その中の採点ルールが妥当かどうかは別途検討します。たとえば、丁寧な文体なら誤答でも加点する評価コードを正確に動かしても、回答の正確さを適切に測ったことにはなりません。合意した処理が動くことと、その合意内容が良い評価であることは別です。
また、プラットフォームが備える一般機能を、そのまま特定の実証で全機能が使われた証拠にしてはいけません。どの設定で、どの部分を検証し、何を関係者の信頼に委ねたのかは、個別の実施報告で確かめます。技術名だけを根拠に、第三者の確認がすべて完了していると読むことはできません。
実行前に決める問題と採点の条件
保護の仕組みを決める前後に、何を測りたいかを具体化します。「優秀なAIを選ぶ」という目的だけでは、問題の選び方も点数の意味も定まりません。問い合わせ対応なら、規程に沿った案内、足りない情報の確認、人への引き継ぎなど、実際に任せたい行動に分けます。業務で必要な能力を先に定め、その能力が回答から判定できる問題を作る順番が有効です。
通常の問い合わせだけを並べると、条件が曖昧な場合の弱さを見落とします。逆に、難しい例外問題だけでは、日常の利用場面を代表できません。利用頻度が高い問題、判断に必要な情報が不足する問題、誤答すると影響が大きい問題を分け、なぜその構成にしたかを説明できるようにします。重大な失敗を見つけるために多めに入れた問題は、通常業務の頻度をそのまま表していない点も残します。
| 実行前にそろえる条件 | 記録する内容の例 | そろえる理由 |
|---|---|---|
| モデル | 識別できる版、提供形態、評価対象の範囲 | 後の更新や別構成との混同を防ぐ |
| 指示と参考情報 | 共通指示、渡す規程、会話履歴の有無 | 同じ質問でも前提が違えば答えが変わるため |
| 生成条件 | 出力長の上限、利用できる生成設定、試行回数 | 回答の変動や途中終了の影響を把握するため |
| 外部ツール | 検索、文書取得、計算などの使用可否 | モデル単体とツール込みの能力を区別するため |
| 採点 | 基準、判定担当、意見が割れた場合の手順 | 結果を見た後に都合よく基準を動かさないため |
| 失敗した実行 | 欠測、通信エラー、再実行の条件 | 成功した回答だけを選ぶ集計を避けるため |
複数モデルの比較では、条件をそろえる意味も先に決めます。モデル本体の能力を比べたいなら、入力情報やツールの条件をできるだけ共通にします。完成した問い合わせサービスを選びたいなら、各サービスの文書検索を含めて調べる選択もあります。ただし後者の点数には検索や指示設計の影響が入るため、「モデル単体の性能」として紹介しないことが必要です。
採点基準には、正しい結論だけでなく、根拠と保留の適切さも含めます。規程に書かれていない条件を勝手に補った回答は、文章が自然でも問題があります。一方、必要な情報を尋ねて判断を保留した回答は、すぐに結論を出さなかったという理由だけで誤答にすべきとは限りません。期待するのは、いつでも答えを言い切ることではなく、与えられた情報に見合った応答です。
エラーの処理も比較の一部です。回答が得られなかった試行をすべて除外すると、安定して応答できないモデルの弱点が見えなくなることがあります。回答品質の集計と実行成功率を分けて示すなど、評価目的に応じた扱いを決めます。再実行する場合も、理由と回数を記録し、良い回答が出るまで繰り返す運用にならないようにします。
回答と採点結果をどこまで共有するか
二重盲検の評価でも、誰かが回答を確認しなければ採点できない場合があります。「機密保護されているから誰も回答を見られない」と考えると、評価者の役割を見失います。重要なのは、生の回答、設問別の判定、集計、失敗の類型を分けて、受領者を決めることです。すべてを同じ範囲に共有する必要はありません。
たとえば評価者が生の回答を確認できれば、どこで条件を読み違えたかを調べられます。その分析から、提供者向けには「情報不足の場面で断定しやすい」「複数の条件を同時に扱うと誤りやすい」といった類型を返せます。問題文そのものを渡さずに改善の方向を伝える方法です。ただし、分類が粗すぎると何を直すべきか分からないため、機密性と説明の具体性を両立させる工夫が要ります。
| 共有する情報 | 判断に役立つ点 | 共有範囲を決める際の注意 |
|---|---|---|
| 生の回答 | 誤りの文脈や表現を細かく確認できる | 問題文や参考資料の内容を含む可能性がある |
| 設問別の点数と理由 | 採点を見直し、弱点を調べられる | 理由の説明から問題の条件が推測される場合がある |
| 分野別の集計 | 得意・不得意の傾向を比較できる | 件数や分野の定義がないと解釈しにくい |
| 成功・失敗の類型 | 改善すべき行動を伝えられる | 抽象化しすぎると具体的な改善につながりにくい |
公表されたAVERIの試行では、AVERIが入力を暗号化し、返された出力を復号して採点しました。Googleへの機密報告には数値結果と成功・失敗の類型を含めつつ、生の問題と出力は非公開を維持したと報告されています。これは、評価者が回答を扱い、提供者には別の粒度の結果を返す実例です。(確認日:2026年9月30日。出典:AVERIのパイロット報告)
この実例を「点数しか外へ出ない方式」と一般化するのは適切ではありません。また、入力と出力の説明だけから、すべてのログの閲覧範囲を断定することもできません。運用記録、エラーの詳細、一時的な保存物などは、それぞれの設計と開示情報で確認すべき対象です。報告に記載がなければ、見えないことが保証されたと補って読むのではなく、未確認の範囲として扱います。
一般向けに結果を公開するときは、集計の分母や評価対象の範囲も添えます。問題文を伏せても、「条件不足の問い合わせを含む」「回答の根拠を確認した」「この領域は対象外」といった方法の説明は可能です。機密を守ることと、方法をまったく説明しないことは同じではありません。どの粒度なら外部の読者が判断できるかを、実行前から考えておくと報告の質が上がります。
2026年の公開実証で確認できたこと
Google DeepMindは2026年8月27日、非公開モデルを対象とした二重盲検評価の試行を発表しました。Confidential Spaceを用い、評価者に重みを渡さず、Googleに試験プロンプトを開示しない評価を目指す取り組みです。発表ではSingapore AI Safety Institute、OpenMined、AVERI、MLCommonsがパートナーとして挙げられています。(確認日:2026年9月30日。出典:Google DeepMindによる実証の発表)
AVERIの報告で扱われる試行は2026年7〜8月に実施され、対象モデルはGemini 2.5 Flash-Liteでした。Googleが構成した環境でOpenMinedのソフトウェアを利用したとされています。前節で紹介した入力の暗号化と回答の採点は、この試行での役割分担です。ここから、あらゆるモデルや組織が同じ手順で直ちに評価できると結論づけることはできません。
MLCommonsは、未使用で取り置いていたAILuminate系列の問題の一部を、この概念実証に提供したと説明しています。「未使用の一部」という範囲に注目すると、公開済みの問題集全体の順位を調べた取り組みとは読み分けられます。(確認日:2026年9月30日。出典:MLCommonsによる実証の説明)
また、技術報告ではAVERI・MLCommonsの問題群と、Singapore AISIの問題群を別に実行した実証が説明されています。異なる参加者の問題や実施内容を混ぜ、一つの共通試験のように扱わないことが必要です。(確認日:2026年9月30日。出典:二重盲検評価の技術報告)
この公開実証を読む際の中心は、相互の機密を守りながら評価を行う構成を試したことです。小規模な定量評価を含むパイロットであり、あらゆる監査項目を網羅したものでも、一般提供された評価サービスや標準認証制度でもありません。取り組みの意義を理解することと、実証していない範囲まで保証されたと受け取ることは分けます。
したがって、この事例から独自のモデル順位や万能な安全性の結論を作ることはできません。導入を考える読者には、参加者の名前だけでなく、対象モデル、問題の範囲、実施した確認、残った前提を読む姿勢が役立ちます。技術的な実現可能性の確認、測定された能力、現場への適用判断は、それぞれ別の問いとして整理しましょう。
架空の問い合わせ対応AIを評価する具体例
ここからは仕組みを具体化するための架空例であり、実在の企業の試験や実測結果ではありません。ある企業が、社員向けの備品貸出について案内するAIを選ぶとします。外部のモデル提供者は重みを公開せず、企業の評価担当者も、今後の比較に使う未公開の問い合わせ問題を提供者へ渡したくありません。
この企業の仮の規程では、出張用端末の標準の貸出期間を5営業日以内、申請期限を利用開始の3営業日前までとします。ただし、条件を満たしても貸出の確約には管理担当者の在庫確認が必要です。標準期間を超える利用は個別承認の対象とします。これらは説明用に設定した条件であり、一般的な社内規程として推奨している数字ではありません。
評価では、モデルにこの規程の抜粋と問い合わせを入力します。答えの根拠となる規程は渡す一方、正解例と採点表は評価担当者が保有する設計にします。非公開だからといって、回答に必要な条件までモデルから隠すと、規程を読んで答える能力を試せません。モデルに渡す情報と、採点する人だけが持つ判定用の情報を分けることが大切です。
| 問題の種類 | 仮の問い合わせ | 期待する応答 | 採点で見る点 |
|---|---|---|---|
| 必要な条件が示されている | 利用開始の4営業日前に、3営業日の貸出を申請したい。在庫はまだ確認していない。 | 期限と期間は標準条件に合うと案内し、貸出の確約には在庫確認が必要だと伝える。 | 条件の読み取りと、申請できること・予約確定の区別 |
| 判断に必要な情報が足りない | 来週から何日か端末を借りたい。標準の手続きで大丈夫か。 | 利用開始日と期間を確認し、情報がそろう前に可否を断定しない。 | 不足情報を特定し、必要な確認に絞れるか |
| 担当者の承認が必要 | 端末を8営業日借りたい。そのまま申し込めば利用できるか。 | 標準期間を超えるため、管理担当者への相談と個別承認が必要だと案内する。 | 権限のない承認を作らず、適切な引き継ぎを示せるか |
一つ目に対して「もちろん借りられます。予約は確定です」と答えるAIは、利用者には親切に見えるかもしれません。しかし、在庫確認を飛ばして確約しているため、規程に沿った回答ではありません。「期間と申請期限の条件は満たしています。貸出の確定は管理担当者の在庫確認後です」という回答なら、分かることと未確定のことを分けています。
二つ目では、すぐに結論を言わない回答に価値があります。ただし、必要のない個人情報まで大量に尋ねることを高く評価するわけではありません。開始日と利用期間という、判断に必要な情報を選んで確認できるかを見ます。三つ目は、どれほど丁寧に説明しても、AIが承認権限を持つように振る舞えば不適切です。「承認が必要」という結論と、利用者が次に取れる行動をセットで案内できることが重要です。
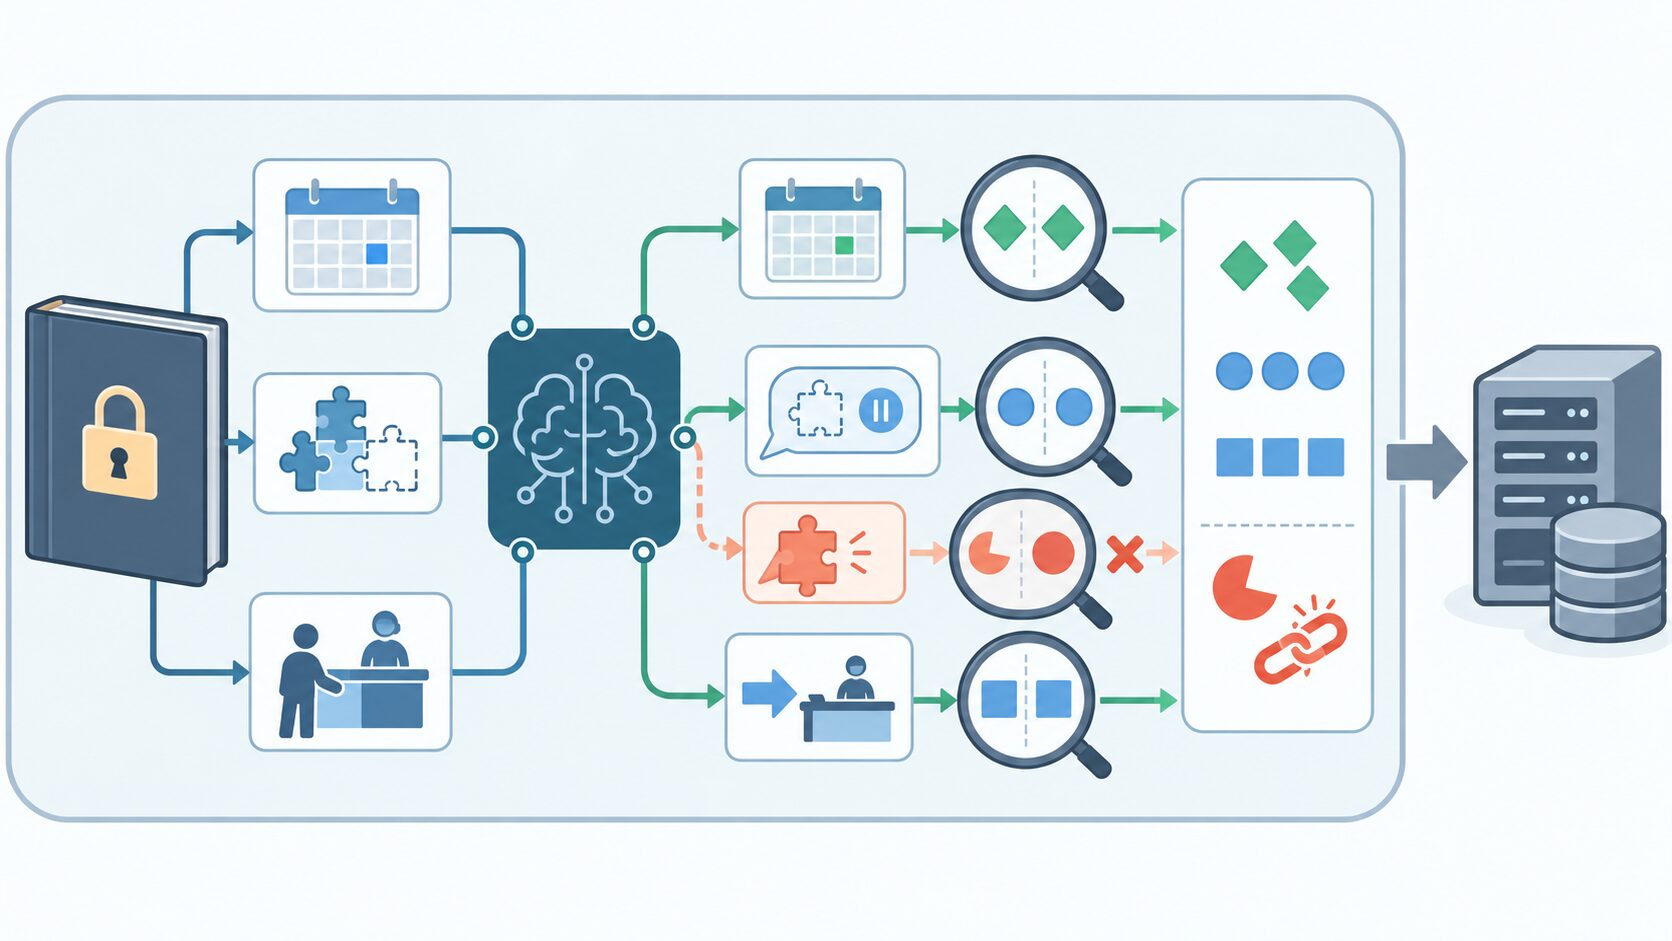
実行時には、合意した保護環境で規程と問題を処理し、評価担当者が返された回答を採点するものとします。提供者へは問題文を含めず、「標準条件は読めるが在庫確認を省略する」「期間が曖昧な場合に確認せず断定する」などの失敗類型と集計を共有します。この共有方法は説明用の設計であり、前節の実在する試行が同じ問い合わせや採点方法を使ったという意味ではありません。
誤りが見つかった後は、修正すべき場所も切り分けます。規程の抜粋に在庫確認の条件が欠けていたなら、入力資料の整備が必要です。条件が書かれているのに無視したなら、指示やモデルの振る舞いを見直す材料になります。文書検索を使う構成で規程が取得できなかったなら、検索の段階を調べます。回答だけを見て、すべての失敗をモデル本体の能力に帰さないことが改善につながります。
修正後の確認では、同じ文章への対応だけで終わらせず、条件の組み合わせや言い方を変えた別の評価問題も使います。ただし、修正に使った問題を再び完全な未知の試験として扱うことはできません。改善用に確認した問題と、最終判断のために取り置く問題を分けることで、特定の問いへの対策と、応答全体の改善を見分けやすくなります。
問題の品質と点数の読み方は別に検証する
試験問題が守られていても、その問題が実際の利用場面を代表していなければ、導入判断の根拠は弱くなります。問い合わせ対応に使うモデルを、知識の一問一答だけで選ぶと、曖昧な依頼の確認や担当者への引き継ぎを評価できません。まずは、その点数が、自分たちが知りたい能力をどこまで測っているかを確認します。
問題の構成を見る際には、対象業務、難易度、使用言語、利用者の表現の幅を点検します。整った文章だけで高得点でも、短いメモや言い直しを含む問い合わせには対応しにくいかもしれません。専門用語に詳しい社員と、新しく入った社員では質問の仕方も違います。誰の使い方を想定した試験なのかが分かると、成績を自分の現場へ当てはめられる範囲が明確になります。
総合点は便利ですが、異なる失敗を一つの数字にまとめています。簡単な案内で多く加点されると、承認が必要な手続きを勝手に確定する重大な誤りが目立たなくなる場合があります。課題別の点数、問題数、重大な失敗の有無を一緒に読みます。合計点が高いことと、任せたい操作で必要な条件を満たしていることは、別々に確認する必要があります。
問題数が少ないと、数問の成否が順位に大きく影響します。また、生成AIの回答は試行ごとに変わることがあり、一度の成功だけでは安定性まで分かりません。同じ問いを繰り返して出力の変動を調べることは有用ですが、それだけでは扱った業務場面の種類は増えません。「何種類の問題を試したか」と「各問題を何回試したか」を分けて読むことが必要です。
僅差を見たときは、差の大きさだけでなく、特定の問題への依存や、試行を変えた場合の変動を考えます。順位が一つ上だから常に優れていると断定するよりも、用途別の強みが安定しているかを確認します。評価報告に変動の説明がなければ、公開された条件でその結果が得られた、という範囲で理解するのが適切です。
採点する人の意見が割れる場合も、単なる作業上の雑音として片付けないようにします。「確認質問を返すべきか」「注意書きがあれば許容できるか」という不一致は、期待する業務行動の定義が曖昧な兆候かもしれません。判断が割れた例を整理し、基準を修正したならその影響範囲を確認します。採点基準が途中で変わった結果を、同じ基準の点数として並べないことも大切です。
未使用の問題でも、似た内容が学習データに含まれていないと証明されたことにはなりません。問題の作成経緯、使用履歴、公開状況を管理し、露出した問題は用途を見直します。また、業務規程が変われば以前の正解も古くなるため、問題と正解の版をそろえて更新します。機密性の維持と内容の更新を続けて初めて、評価問題を長く役立てられます。
機密保護があっても残る信頼とリスク
保護された実行環境を使っても、ハードウェア、ソフトウェア、クラウド基盤への信頼がすべて不要になるわけではありません。どの情報を守り、誰によるどの操作を防ぐのか、どの構成要素が正しく働くと仮定するのかを整理する必要があります。この前提の整理を「脅威モデル」と呼びます。万能な防御を意味する言葉ではなく、保護の範囲を読み取るための説明です。
公表された技術報告では、独自メソッドの完全な検査と許可リスト化、OSビルドの独立した再現、Googleから独立した証明の署名・検証に未達の部分があるとされています。つまり、この実証は関係者や基盤への信頼を完全になくした方式ではありません。双方の機密を保護する構成を試したことと、考えられる改ざん経路をすべて検証したことを区別します。(確認日:2026年9月30日。出典:二重盲検評価の技術報告)
一般的な評価設計でも、許可した出力は情報の出口になります。回答に問題文が引用されれば、入力を直接共有しなくても内容が伝わる可能性があります。また、極端に細かい結果の分類や設問別の説明から、問題の条件が推測されることも考えられます。こうした可能性は、外部からの侵入対策だけでは整理できません。出力形式や受領者を含めて、処理内容を確認することが必要です。
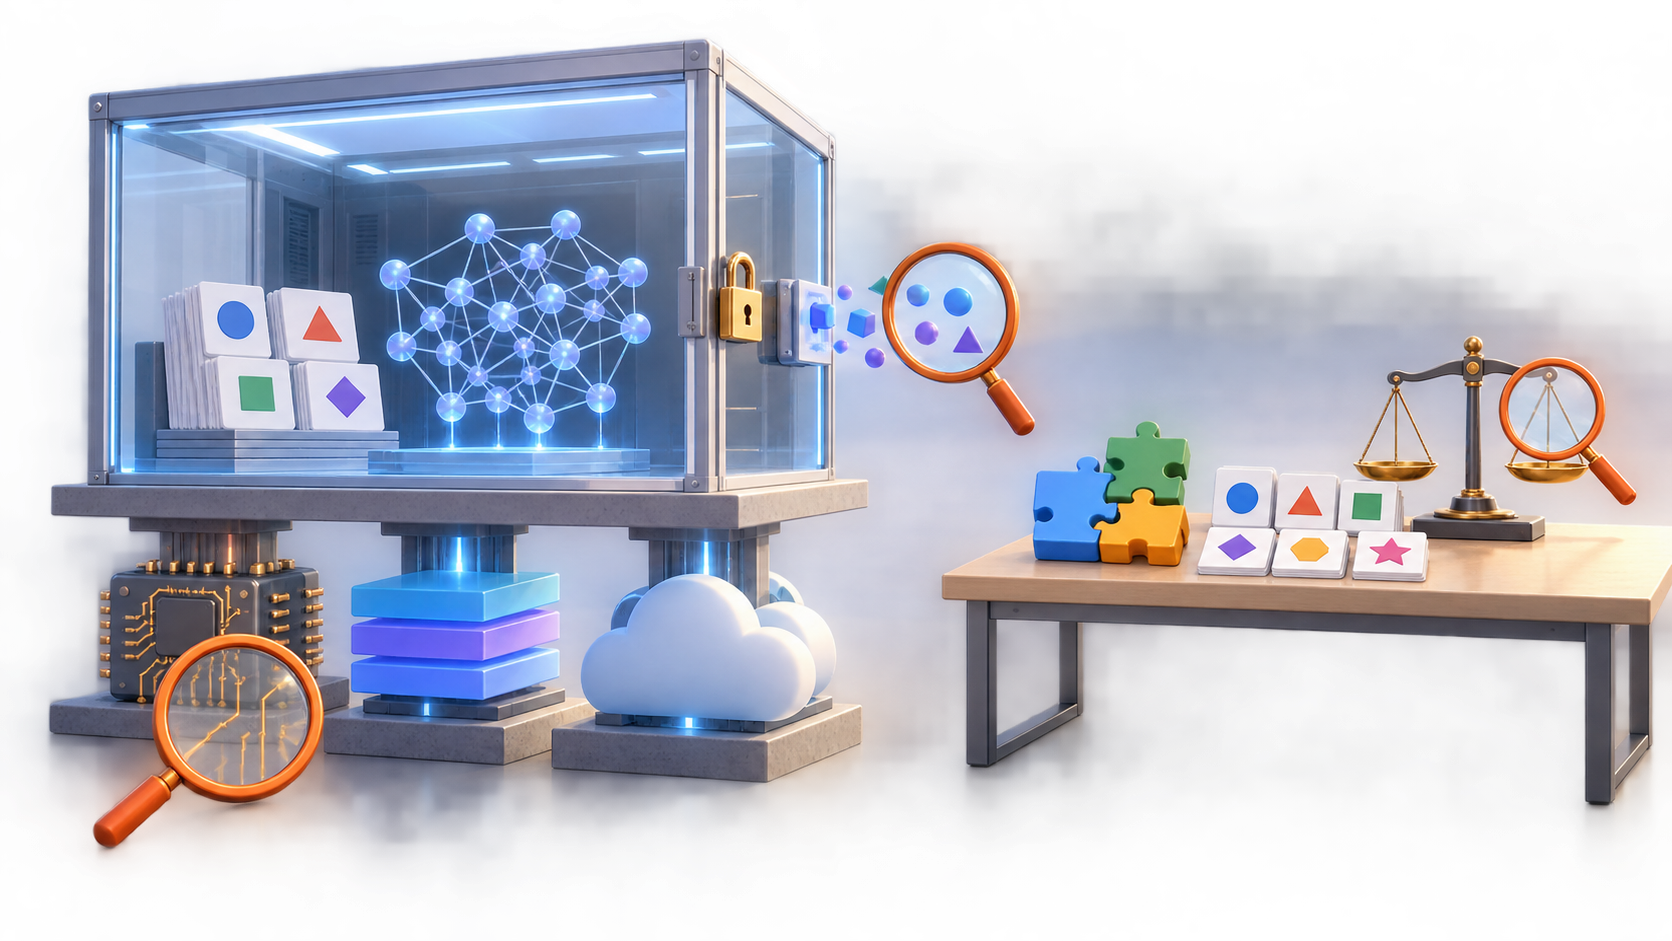
保護環境は、投入された問題が正しいことまで保証しません。誤った正解表を安全に保管し、そのまま採点すれば、誤った判定が出ます。特定の利用者に偏った問題を秘匿しても、偏りが解消されるわけではありません。入力の品質、採点の公平さ、実務上の安全性は、それぞれ専門的な確認や実際の利用条件に沿った検証を必要とします。
実行コードの依存関係や基盤の更新も、確認した構成との関係で考えます。ある時点でレビューした処理と、その後に部品が変わった処理を同じものとして扱えるとは限りません。技術の名前だけで安心するのではなく、評価報告がどの構成と時点を対象にしているかを押さえます。ここで必要なのは、個別の鍵管理手順を暗記することより、どこまで確認済みで何が前提として残るかを読み分けることです。
どの評価方法を選ぶときに役立つか
この方式が特に役立つのは、モデル側と評価側の双方に、相手へ全面開示したくない資産がある場合です。非公開モデルを独自の問題で外部評価する場面や、複数組織がそれぞれの機密を維持して比較に参加する場面が考えられます。評価者が必要な回答を受け取り、提供者も合意した結果を得られるなら、情報の全面共有を前提とせずに評価を進める選択肢になります。
一方、すべての試験に同じ構成が必要とは限りません。公開問題で傾向を把握する、通常のAPIで試作を確かめる、自社環境で保有モデルを調べるなど、目的に応じた方法があります。次の比較は一般的な検討の目安であり、特定の製品の機能や提供条件を示すものではありません。
| 方法 | 機密性の検討点 | 実施負担と結果の確かめやすさ |
|---|---|---|
| 公開ベンチマークを使う | 問題の秘匿を目的としないため、既知問題への対応力が混ざる可能性を考える | 共通課題で比較しやすいが、対象モデルの版や実行条件の確認が必要 |
| 通常のAPIで独自問題を試す | 問題の送信先と、保存・利用・閲覧の扱いを確認する | 着手しやすい場合がある一方、サービス更新が再試験へ影響することがある |
| 自社環境で利用可能なモデルを評価する | 自社が管理する入力とモデルの保護範囲を整理する | 構成を保持しやすい反面、計算資源や運用の負担を自社で担う |
| 相互の機密保護を伴う評価を組む | 重みと問題を相互に保護し、出力と権限を合意する | 環境や処理の確認に手間がかかり、再実行には関係者と条件の調整が必要 |
再現可能性にも段階があります。公開された方法を誰でも試せること、同じ参加者が同じ構成で再実行できること、実行記録から条件を追跡できることは同じではありません。非公開問題を使う場合は、問題を一般公開せずにどこまで再確認できるかを決めます。外部の読者が全問を追試できないなら、その制約を報告で説明することも必要です。
導入時には、課題に対する精度評価だけでなく、実際の作業の流れで使う業務試行も組み合わせます。文書検索の失敗、応答時間、利用者の誤解などは、問題への回答だけでは十分に分からないためです。運用開始後も問い合わせの変化やモデル更新を追い、必要な再評価を行います。相互の機密保護は、この一連の評価のうち、情報の扱いに関する重要な部分を担います。
採点方法全体を整理したい場合は生成AIのさまざまな評価方法、共通課題で性能を比べる考え方はベンチマークによる性能評価も参考になります。まず測りたい能力を定め、その後に情報保護と実行の方法を選ぶと、それぞれの評価手法の役割がつながります。
評価報告を読むときの確認項目
評価報告に「二重盲検」と書かれていたら、名称だけで信頼性を判断せず、情報の扱いと評価条件を確かめます。特に、何を隠したか、何を確認したか、何が未確認かが読み取れる報告は、自分の用途へ結び付けて検討しやすくなります。次の項目を順に見ると、機密保護と性能評価を混同せずに整理できます。
- 保護対象と相手:重み、問題、回答のうち、どの情報を誰から保護したのか。匿名の回答比較を意味しているのか、相互の機密保護を意味しているのか。
- 実行処理の確認:どのコードと環境を使い、誰がどの方法で確認したのか。証明情報の確認と、処理内容のレビューが区別されているか。
- 結果の受領者:生の回答、設問別採点、集計を誰が受け取ったのか。公開されていない情報の範囲が説明されているか。
- モデルと実行条件:対象の版、指示、参考情報、生成設定、外部ツール、試行回数が分かるか。本番で使う構成と一致するか。
- 問題の範囲と件数:どの業務や能力を対象にし、何を対象外としたか。問題の種類ごとの件数と、選んだ理由が示されているか。
- 採点と失敗の扱い:何を正解とし、保留や引き継ぎをどう判定したか。欠測や再実行、採点者の不一致をどう処理したか。
- 限界と残る信頼:ハードウェアやサービスへの前提、未検証の範囲、出力の変動、重大な失敗が説明されているか。
すべての問題文を公開しなくても、対象分野、問題の作り方、件数、採点手順、結果の概要は説明できる場合があります。反対に、問題を公開していても、実行条件が不明なら点数の比較は難しくなります。秘密にする情報と、読者の判断に必要な説明を分けることが、機密性を保ちながら評価への理解を得るための設計になります。
失敗例も、生の問題をそのまま公開する方法だけではありません。元の機密情報を含めない説明用の例を別に作り、実際の試験問題ではないと明記して傾向を伝える方法が考えられます。その場合も、例示から実際の発生率は分からないため、件数や集計の説明とは分けます。具体性のある説明と、実測された事実の境界を保つことが大切です。
最後に、本番で使うものが評価されたものと同じかを確認します。同じモデル名でも版が変わったり、参考文書、検索機能、指示が変わったりすれば、利用時の結果も変わり得ます。過去の好成績をそのまま引き継ぐのではなく、変更の内容に応じて確認すべき範囲を考えます。評価は、一度の順位付けだけで終わる作業ではありません。
二重盲検AI評価を理解する要点は、非公開モデルと非公開問題の双方を守りながら、必要な計算と採点を成立させることです。その価値を生かすには、適切な問題、明確な採点基準、説明できる結果共有が必要です。機密保護の確かさと評価内容の確かさを両方確認することで、得られた点数を、現実のモデル選定や改善に使える判断材料にできます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年9月30日 | 初回公開 |