
プロンプトキャッシュとは?LLMの費用と待ち時間を減らす仕組み・効かない原因

AIの初心者
社内の長い業務マニュアルをAIに毎回渡しています。同じ資料を送るたびに費用と待ち時間がかかるのですが、減らす方法はありますか?

AI専門家
共通する入力の処理を再利用する、プロンプトキャッシュが役立つ場合があります。マニュアルが共通でも質問は変えられ、回答はその都度生成されます。
AIの初心者
一度聞いた質問への答えを保存する機能とは違うのですね。同じマニュアルなのに、再利用されないこともあるのでしょうか?
AI専門家
あります。入力の先頭や設定が変わる場合、保持期限が過ぎた場合などです。文章の並べ方、対象APIの条件、実際に再利用された量を順番に確認すると、原因を整理できます。
プロンプトキャッシュとは。
LLMに渡す入力のうち、繰り返し使われる共通部分の処理状態を保存し、後のリクエストで再利用する仕組みです。長い指示や資料が入力の先頭で共通していると、対応する条件のもとで入力処理の費用や待ち時間を減らせます。過去の回答をそのまま返す機能ではなく、個別の質問に対する回答は新しく生成します。
導入を判断するには、「何が再利用されるか」「なぜ再利用されないか」「初回を含めて得になるか」の三つを分けて考えると整理しやすくなります。この記事では、架空の返品窓口を例に、設計から原因の切り分け、費用と速度の測り方まで説明します。API仕様の説明は、2026年9月30日を確認日とする情報に基づきます。

共通の入力を再利用する仕組み
LLMは、受け取った文章をそのまま一文字ずつ扱うのではなく、トークンという処理単位に分けて扱います。入力を読み取る処理と、そこから回答を生成する処理があり、プロンプトキャッシュが主に対象とするのは前者です。長い資料を含む入力を繰り返すとき、すでに処理した共通部分について、その処理状態を利用します。
たとえば、毎回同じ業務規則を読み、その後に続く問い合わせへ答える仕事を考えてください。規則の説明が入力の大半を占めるなら、その部分の処理を毎回繰り返す負担は無視できません。共通部分を再利用できれば、今回だけの問い合わせなど、残りの入力の処理と回答の生成に進みやすくなります。ただし、人が資料を暗記するように、モデルの知識が恒久的に書き換わるわけではありません。
ここで鍵になるのが、入力の共通する先頭部分です。先頭部分は英語でプレフィックスとも呼ばれます。「文章のどこかに同じ段落があればよい」とは限りません。冒頭から同じ情報が同じ順序で続いているか、対象サービスが再利用できる条件を満たしているかが重要です。共通入力の再利用と、新しい回答の生成という基本的な区別は、OpenAIのプロンプトキャッシュガイドでも確認できます。
処理の流れは、次の三段階で捉えられます。ここでは、保存対象にできる十分な長さの共通入力があり、対応する設定が整っている場合を想定しています。
- 初回は、共通資料も個別質問も処理します。再利用するための処理状態が作られる段階であり、初回から同じ効果が得られるとは限りません。
- 次回は、条件が合えば共通部分を読み取って再利用します。前回とは異なる質問が続いても、その質問に対する回答は改めて生成します。
- 期限切れや内容変更が起きると、該当する部分を再び処理する必要が生じます。必要に応じて新たな再利用の起点を作ることになります。

図で整理する際も、保存と読取の間に「有効な期間と一致条件」があることを意識してください。単に二回目のリクエストだから速くなるのではありません。同じ質問を送ったかどうかより、どの範囲の入力が、どの条件で再利用可能だったかが判断の軸になります。
また、保存した処理状態は、後から人が読む業務記録や資料の原本とは役割が違います。規則の正式な保存場所や、改定履歴の管理は引き続き必要です。キャッシュの期限が切れても業務を続けられるよう、通常どおり必要な情報を渡せる構成、または対象APIで定められた参照方法を維持します。
費用と待ち時間のどこに効くのか
プロンプトキャッシュの効果を考えるときは、リクエストの負担を入力処理、回答生成、通信やアプリ側の処理に分けます。長い共通資料の入力処理が大きな割合を占める業務では、再利用の効果が現れやすくなります。一方、回答を長く書かせる業務や、外部システムの検索に時間がかかる業務では、別の部分が全体の待ち時間を左右します。
たとえば、分厚い規則集を渡して「受付できるかを一文で答えて」と指示する場合と、短いテーマから長文の研修資料を作る場合を比べてみましょう。前者は入力を読む負担が相対的に大きく、後者は出力を生成する負担が大きいと考えられます。同じキャッシュ機能を使っていても、利用者が感じる改善幅まで同じになるわけではありません。
待ち時間には、少なくとも二つの観点があります。応答が始まるまでの時間と、回答が完成するまでの時間は別に測ります。ストリーミング表示では最初の文字が早く見え始めても、長い回答を書き終えるまでには時間がかかります。逆に、アプリが回答全文を受け取ってから一度に表示する設計では、応答開始の改善を利用者が直接感じにくいこともあります。
| 確認する対象 | 再利用によって期待できること | 別に確認すること |
|---|---|---|
| 共通資料の入力処理 | 同じ部分を繰り返し処理する負担を減らす | 実際に再利用されたトークン量と適用単価 |
| 回答の表示開始 | 入力処理の短縮が開始の早さにつながる可能性がある | 通信、混雑、検索などを含む実測時間 |
| 回答の完成 | 入力側で減った時間が全体にも反映される可能性がある | 出力の長さと生成にかかる時間 |
| 回答の内容 | 共通資料を踏まえて、その都度回答を生成する | 正確さ、規則への適合、説明の過不足 |
キャッシュが外れることをキャッシュミス、再利用できることをキャッシュヒットと呼びます。ミスは、一般に「回答不能になった」という意味ではありません。再利用できなかった部分を処理して、リクエストは続きます。ミスをすべてアプリのエラーとして扱うと、正常に返ってきた回答まで失敗扱いしてしまいます。通常のAPIエラーと、最適化が効かなかった状態を分けて記録するのが適切です。
入力の上限を広げる機能でも、回答の品質を自動的に高める機能でもありません。また、毎回新たに生成する出力の料金が、入力のキャッシュによって一律に安くなるとは考えないでください。削減を期待する部分を明確にし、総額と体感の双方で改善を確かめることが大切です。
固定情報を前に置くプロンプト設計
基本となる配置は、変わりにくい情報を前へ、今回だけの情報を後ろへ置くことです。業務上の役割、共通規則、回答例、共通資料などを一定の順序でまとめ、その後に個別の問い合わせを置きます。これは必要な情報を減らす工夫というより、共通部分が冒頭から続くように並べる工夫です。
架空の通販窓口なら、次のように情報を分けられます。これは実際のAPIリクエスト形式ではなく、入力を組み立てる順序の説明です。役割を表すメッセージやツール定義などは、利用するAPIの形式に合わせて管理します。
【毎回共通する部分】
役割:返品相談の一次受付を支援する。
業務規則:返品の期限、対象条件、例外対応、確認事項。
回答例:結論、根拠、追加で確認することの順に書く。
共通資料:返品規則 第3版の本文。

【今回だけの部分】
問い合わせ日時:今回の判断に必要な場合に記載。
購入・到着情報:今回の注文の情報。
質問:商品が未開封のとき、次に何を確認すればよいか。
よくあるつまずきは、追跡用のリクエストIDや現在時刻を入力の冒頭に入れることです。資料そのものは同じでも、先頭が毎回変われば、長い共通部分として扱いにくくなります。追跡のためだけに必要な値は、アプリのログなど適切な管理場所で扱えるかを検討します。回答の判断に日時が必要なら削除せず、個別情報として渡す位置を考えます。
たとえば「本日の日付」「注文番号」「共通規則」「質問」という並びでは、共通規則に到達する前に差分が入ります。「共通規則」「本日の日付」「注文番号」「質問」という並びなら、規則の部分が共通の先頭を作れます。ただし、元の指示の役割や優先関係を壊すような移動は避け、移動後も期待した判断になるかを確認します。

一致の確認では、「意味が同じだから大丈夫」と判断しないことも大切です。毎回、同じ規則を別の表現に言い換えたり、段落を並べ替えたりすると、人には同じ内容でも入力としては変わります。資料を動的に組み立てる場合には、項目の並びや改行、見出しの付け方が意図せず変わっていないかを見ます。
本文だけでなく、ツールや出力形式などの設定も確認対象です。たとえば注文照会、返品登録、担当者への引き継ぎという三つのツールを使うなら、内容を更新していないのに定義の順序だけが毎回入れ替わる設計は避けます。一方、業務に必要なツール変更まで抑える必要はありません。変更は管理したうえで、その後の再利用状況を改めて確かめれば十分です。
共通部分は一定に保ち、変更が必要なときは正しく変更するという考え方が実務に向いています。ヒット率を上げるために規則を固定し続けるのではなく、版を付けて管理し、同じ版を使うリクエスト間で安定した入力を作ることが目標です。
架空の返品窓口で初回と再利用を追う
ここからは、説明用の架空の業務を使います。ある通販窓口では、返品規則と回答例を合わせた共通部分が6,000トークンあり、個別の注文情報と質問が毎回1,000トークンあるとします。各リクエストの入力は合計7,000トークンです。これらは仮定の数値で、実在する会社の規則や、特定の文章を実際に数えた値ではありません。
規則には「到着後14日以内の未開封品は受付対象。ただし、破損品などは別の確認手順を使う」と書かれているとします。最初の利用者は、到着から5日目の未開封品について相談します。AIは共通規則と個別事情を読み、受付条件と追加の確認事項をまとめます。この時点では共通部分を初めて処理するため、キャッシュの作成に相当する扱いを想定します。
次の利用者は、到着から20日目の商品について相談します。質問は異なりますが、使う規則は同じです。対応条件を満たして共通部分を再利用できれば、6,000トークン分の処理状態を利用し、今回の1,000トークンの事情を処理して回答します。「前の人が返品できたから今回もできる」と答える仕組みではありません。期限超過の扱いや例外の有無を、今回の情報に沿って判断します。
| 場面 | 共通規則の扱い | 個別情報と回答の扱い |
|---|---|---|
| 初回:到着5日目の未開封品 | 共通の6,000トークンを初めて処理する | 個別の1,000トークンを処理し、今回の回答を生成する |
| 再利用時:到着20日目の商品 | 条件を満たせば同じ6,000トークンの処理を再利用する | 別の1,000トークンを処理し、期限超過を踏まえた回答を生成する |
| 規則改定後:新しい受付条件 | 旧版と同じ範囲は保証されず、変更した部分を含め再処理が必要になる | 新版の規則と今回の情報から回答を生成する |
三回目の前に、共通規則が第3版から第4版へ改定されたらどうなるでしょうか。新版の内容を渡すことを優先し、旧版の再利用を無理に続けてはいけません。改定箇所より前に一致部分が残る場合も考えられますが、どこまで再利用されるかは実際の条件と記録で確認します。「一文字変わったら必ず全体がゼロ」「一段落しか変えていないから大半は使える」と決めつけないことが大切です。
この例では、問い合わせが変わることと、共通規則が変わることを分けて考えています。前者は日常的な利用そのものであり、可変部分を後ろに置く設計で扱えます。後者は業務知識の更新なので、新版の内容が適切に使われたかという品質確認が必要です。再利用率の低下だけを見て、規則改定を失敗と評価しないようにします。
また、共通規則に個々の顧客情報を混ぜない構成は、入力の安定性を見通しやすくします。ただし、それ自体が顧客ごとのアクセス権を保証するわけではありません。どの資料と注文情報を誰のリクエストへ渡してよいかは、アプリ側の権限判断として別に設計します。
効果が出やすい用途と出にくい用途
利用に向くかどうかは、資料の長さだけでは決まりません。長く安定した共通部分があり、それを有効な期間内に何度も使うかが判断の軸です。「多くの人がAIを使う」だけでは不十分で、実際の入力にどれだけ共通性があるかを見ます。同じ部署でも、一人ずつ異なる資料を一度だけ読む仕事では、共有できる部分が小さいかもしれません。
| 用途 | 共通にしやすい情報 | 効果を左右する点 |
|---|---|---|
| 業務規則に沿った問い合わせ対応 | 受付基準、案内手順、回答例 | 同じ版の規則を使う問い合わせがどれだけ続くか |
| 一つの長い資料への複数の質問 | 対象資料の本文と読み取り方の指示 | 資料を差し替えず、近い時間に何度も質問するか |
| 定型基準に沿った文書審査 | 審査項目、判定基準、記述例 | 審査対象の文書を可変部分として分けられるか |
| 一度限りの短い依頼 | 共通部分が少ない | 再利用の機会や対象となる入力長が足りるか |
| 内容が頻繁に変わる資料の分析 | 役割や分析手順などに限られる可能性がある | 資料の更新間隔と利用間隔の関係 |
たとえば、担当者が午後の一時間に同じ審査基準で20件の文章を確認するなら、基準を共通部分として整理する価値があります。対象文書の中身は毎回違っても構いません。一方、一週間に一度だけ異なる会議資料を要約するなら、共通の指示はあっても資料本体は再利用しにくく、保持条件によっては利用間隔も合わないでしょう。
一つの資料に対する質問でも、資料を毎回要約し直してから渡していると、その要約文が一定にならない場合があります。このときは、安定した原文を使うのか、版を固定した要約を使うのかを業務目的から考えます。原文を大量に追加することが最善とは限りません。必要な根拠を残しながら、読みやすく管理しやすい入力を選ぶことが先です。
特に避けたいのは、最小入力長を超えるためだけに不要な説明を足すことです。文章を増やすと、初回の処理量が増え、改定時の点検範囲も広がります。短い依頼なら、そのまま通常の処理を使うほうが総費用も運用も軽くなる可能性があります。キャッシュは必要な入力を繰り返すときの工夫であり、長いプロンプトを作ること自体が目的ではありません。
APIごとに異なる有効化と保持条件
同じ「プロンプトキャッシュ」という名称でも、有効化の方法、対象となる長さ、保持時間、料金の扱いは共通ではありません。サービス名だけで判断せず、使っているAPIとモデルを特定することから始めます。以下は2026年9月30日時点の確認事項です。将来の変更や旧モデルへの適用まで保証するものではないため、導入時には対応する公式資料の条件を確認してください。
| 対象 | 方式と確認事項 | 保持・料金で注意する点 |
|---|---|---|
| OpenAI | 利用モデルとモードに応じて、対応条件や最小入力長を確認する | 保持条件と、通常入力・読取・書込に適用される単価を確認する |
| Claude API | 最上位のcache_controlを使う自動方式と、ブロック単位の明示方式がある | 標準TTLは5分。追加料金の1時間もあり、最小入力長はモデルに依存する |
| Gemini Interactions API | Gemini 2.5以降では暗黙的キャッシュが標準で有効。明示的方式は非対応 | モデルごとの最小入力長を確認し、共通内容を先頭に置く |
| Gemini generateContent API | 暗黙的方式と、作成したキャッシュオブジェクトを参照する明示方式がある | 明示方式の未指定TTLは1時間。トークン量と保存時間に応じた保管料金も考慮する |
TTLは、キャッシュを保持する期間を表す用語です。長く保持できれば常に有利というわけではなく、利用が続く時間と料金の関係で選びます。たとえば短時間に処理をまとめる業務と、一日のうちに断続的に質問する業務では、必要な保持の考え方が変わります。保持時間の数値だけでなく、いつ作られ、いつ再利用される予定なのかを業務の流れに当てはめます。
Claudeについては「明示方式しかない」と理解しないことが大切です。上記の自動方式はClaude APIを対象とした説明であり、すべてのクラウド連携で同じように利用できると一般化はできません。また、書込と読取は料金が異なり、キャッシュ区間には完全一致が必要です。方式と適用範囲の詳細は、Claudeの公式キャッシュ資料を参照してください。
Geminiでは、APIの区別が特に重要です。Interactions APIのキャッシュ資料は、共通内容を先頭に置き、近い時間に再利用する暗黙的方式の説明です。一方、generateContent APIのキャッシュ資料では明示方式も扱います。後者の明示的キャッシュは確認日時点でBeta(v1beta)です。キャッシュ済み入力もコンテキスト上限に含まれるため、保管料とともに入力総量の確認が必要です。
用語としては、暗黙的方式はサービス側の条件に沿って再利用が判断される方式、明示的方式は利用者が対象区間や参照するオブジェクトなどを指定する方式と捉えると理解しやすくなります。ただし、実際に何を指定するかはサービスごとに異なります。別サービスのサンプルにあるパラメータを、そのまま自分のAPIへ移しても同じ動きになるとは限りません。
運用を始める前に、API名、モデル名、選んだ方式、保持条件、資料の版を一組として記録しておくと、後で原因を追いやすくなります。「昨日までは効いていた」という相談でも、モデル変更なのか資料改定なのかを分けられるからです。料金表や最小長を社内メモに転記する場合は、確認日も残して更新対象にします。
キャッシュが効かない原因を順に切り分ける
再利用されないときは、文章の書き換えを繰り返す前に、成立条件を順番に点検します。一度にモデル、資料、ツール、保持設定を変えると、どの変更が結果に関係したのか分からなくなります。比較の基準となるリクエストを決め、原則として一つずつ条件を変えると、修正の根拠が明確になります。
- 対象APIとモデルを確認する。利用中の機能が対応しているか、選んだ方式がそのAPIで使えるかを見ます。キャッシュそのものへの対応と、後述する診断機能への対応は別の確認事項です。
- 対象となる入力長を確認する。文章全体が長くても、共通している先頭部分が短い場合があります。最小長の判定がどの範囲に適用されるかも、対象モデルの仕様に沿って確認します。
- 実際に送った共通部分を比べる。テンプレートの原文だけでなく、日時や資料を差し込んだ後の入力で差分を探します。冒頭のID、見出しの表記、資料の順序などが候補になります。
- ツールや出力形式を比べる。本文が同じでも、モデルに渡す設定が変わっていないかを確認します。ツールの定義や順序を動的に生成している箇所も点検します。
- 利用間隔と保持条件を確認する。初回から長い時間が空いていないか、想定した保持設定で運用できているかを見ます。入力が一致していることだけで、保持の成立まで決めつけません。
たとえば、テストでは連続して二回送ると再利用されるのに、本番では少ないという状況を考えます。まず本番の利用間隔と入力の組み立て方を確認します。テストと本番で送信間隔が大きく違うなら、文章の内容を直すだけでは解決しない可能性があります。本番だけ毎回時刻を先頭に追加しているなら、共通部分の配置に原因を絞れます。
また、ヒットの有無と、再利用された量は別の情報です。7,000トークンの入力でヒットが記録されても、その7,000トークンすべてが再利用されたとは限りません。冒頭の短い共通指示だけが対象だったのか、長い資料まで含まれたのかでは、費用への影響が違います。結果表示だけでなく、利用量の記録も並べて確認します。
原因を一つ直した後も、そこで作業を終えずに再比較します。先頭の時刻を移動したことで次の差分が見えるようになるなど、複数の条件が重なっている場合があるためです。改善しない場合は、変更前の基準を保ったまま、次の確認項目へ進みます。関係の薄い文言まで変えてしまうと、品質への影響も追いにくくなります。
なお、キャッシュミスでも通常の回答が得られるなら、直ちに業務を停止する必要はありません。再利用がない場合の費用と待ち時間も見積もり、許容範囲で通常処理を続けながら原因を調べられる構成にすると、最適化の問題をサービス全体の障害にしにくくなります。
Prompt Cache Diagnosticsで比較結果を読む
OpenAIには、比較対象を指定してキャッシュの診断結果を確認するPrompt Cache Diagnosticsがあります。2026年9月30日の確認情報では、対象はResponses APIのGPT-5.6以降の対応モデルです。公式更新履歴にある2026年9月8日は、この診断機能の一般提供日であり、プロンプトキャッシュという技術そのものが初めて登場した日ではありません。
使い方の要点は、基準にする応答IDをprompt_cache_options.comparison_response_idに指定し、結果のprompt_cache_diagnosticsを確認することです。この指定は比較のためのもので、過去の会話を読み込む操作でも、キャッシュヒットを保証する操作でもありません。対応する設定や結果の詳細は、Prompt Cache Diagnosticsの公式資料を参照してください。
読み取る際には、次のように、再利用の結果と比較自体の成立状況を分けます。下表は判断の整理であり、実際のAPIレスポンスを転載したものではありません。
| 結果の区分 | そこから分かること | 次にすること |
|---|---|---|
| ヒット(cache_hit) | 再利用できたことを示すが、入力全量の再利用を意味するとは限らない | usageの再利用量と、費用・待ち時間を確認する |
| ミス | 期待した再利用が成立していない | 示された理由を確認し、一項目ずつ修正する |
| 比較記録がない | 基準との比較に必要な記録を使えていない | 基準応答IDなど比較の指定を確認する |
| 判定できない | その診断だけでは理由を確定できない | 入力・設定の記録と利用量を確認し、比較条件を整える |
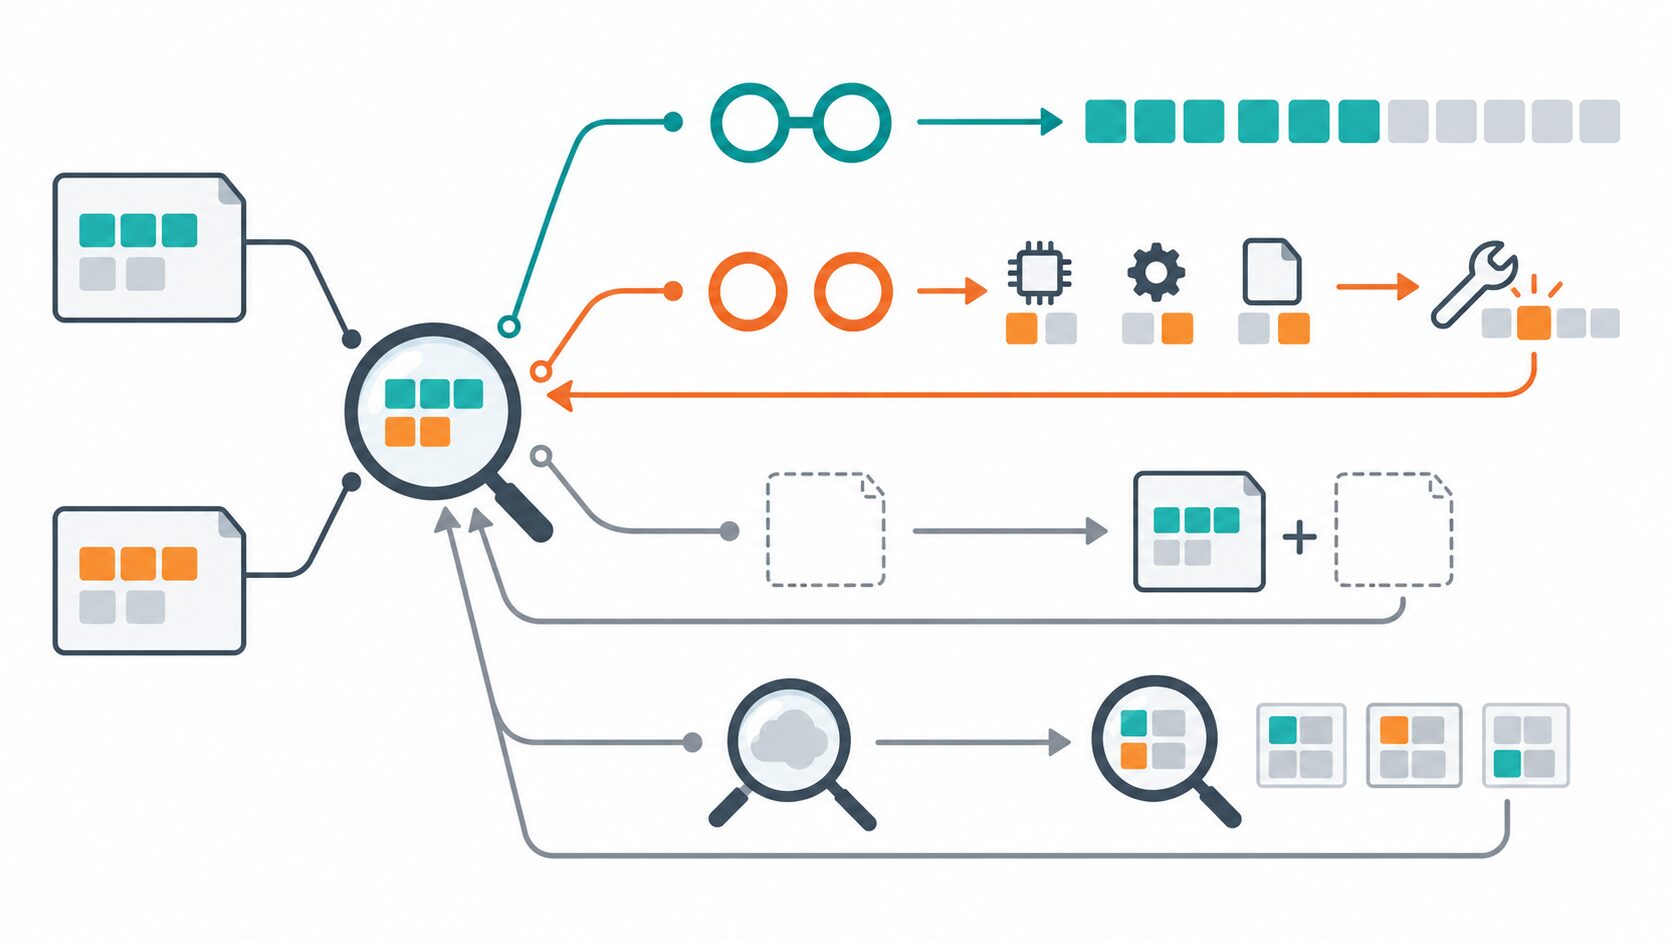
モデル、ツール、入力などに差分があると、その変更が理由として示されることがあります。ただし、診断が最初の理由だけを示す場合には、表示された一項目を直しただけで全条件が整ったとは限りません。修正後に再比較し、残る理由があるかを確かめます。診断結果を読んだ後に利用量を見る、という順序も大切です。
実務では、診断を一度で正解を出す判定器とみなすより、調査の出発点として使うと扱いやすくなります。たとえば、基準の規則と同じ版を使ったつもりなのに入力変更が示されたら、差し込み後の本文を確認します。末尾の個別質問が変わることは想定内でも、冒頭に追加された処理時刻は想定外かもしれません。その違いを見つける材料にします。
この記事ではAPIを実行して診断結果を測定していません。実際の導入では、自分のリクエストで比較し、示された理由と修正内容を対応付けて記録します。比較できない結果を無理に「ミス」と集計せず、調査に必要な情報が不足している状態として分けると、ヒット率の読み違いも防げます。
初回を含めた総費用を計算する
費用は、通常の入力、キャッシュの読取、書込、保存、出力に分けると整理しやすくなります。ただし、すべてのサービスで同じ料金項目が発生するわけではありません。特にOpenAIの書込単価は、該当するトークンへ適用される別の単価であり、通常入力単価への追加料金として二重に足すものではありません。対象の料金表が何を一つの課金対象としているかを確認します。
以下は仕組みを理解するための独自の計算例です。単価はすべて架空の「費用単位」で、円やドル、実在サービスの料金を示していません。共通部分6,000トークン、個別部分1,000トークン、出力500トークンのリクエストを10回実行すると仮定します。初回に共通部分の全量を書き込み、以降の9回はその全量を読み取れた場合を計算します。
| 料金項目 | 仮定する単価・条件 |
|---|---|
| 通常入力 | 1,000トークン当たり1費用単位 |
| キャッシュ書込 | 1,000トークン当たり1.2費用単位。通常入力と重複して課金しない仮定 |
| キャッシュ読取 | 1,000トークン当たり0.1費用単位 |
| 出力 | 1,000トークン当たり4費用単位 |
| 保存とその他の費用 | この計算例では0とする |
キャッシュを使わない場合、1回の入力は7,000トークンなので7費用単位、出力は500トークンなので2費用単位です。合計は1回当たり9、10回で90になります。共通規則を毎回処理する分も、通常入力として含めています。
使う場合の初回は、共通6,000トークンの書込が7.2、個別1,000トークンの通常入力が1、出力が2で、合計10.2です。初回は通常処理より高くても、その後の読取で総額が下がる場合があります。この例で、通常入力を7としてから書込7.2を加えると、共通部分を二重計上してしまいます。
2回目以降は、共通部分の読取が0.6、個別部分の通常入力が1、出力が2となり、1回当たり3.6です。これを9回繰り返すと32.4なので、初回10.2と合わせた10回の総額は42.6になります。キャッシュを使わない90との差は47.4です。これは仮定に基づく算術上の差であり、実測された節約額や、現実のサービスで保証される結果ではありません。
| 利用回数 | キャッシュなしの累計費用 | 初回書込・以降読取の累計費用 |
|---|---|---|
| 1回 | 9 | 10.2 |
| 2回 | 18 | 13.8 |
| 5回 | 45 | 24.6 |
| 10回 | 90 | 42.6 |

利用回数をnとすると、この仮定では通常処理が9n、キャッシュを使う処理が10.2+3.6×(n−1)です。初回の追加負担は1.2ですが、再利用が一度成功するたびに通常処理との差が5.4ずつ生まれるため、2回目で累計が逆転します。これが、この条件での損益分岐の考え方です。「どのサービスでも2回使えば得」という意味ではありません。
現実には途中で期限が切れて再度の書込が発生したり、共通資料を改定したり、一部だけが再利用されたりします。保存料金がある方式では、使わずに保持していた時間の費用も加わります。そのため、再利用が成功した1回だけの単価を比較するより、朝の初回から業務終了までなど、一連の利用をまとめた総額で評価するほうが実態に合います。
また、キャッシュ導入と同時に回答を短くした場合、出力料金の減少も総額に表れます。その改善自体は有用ですが、キャッシュによる入力側の削減とは分けて記録します。何が効いたのかを区別しておくと、別の業務へ展開するときも、同じ効果を期待できる条件を説明しやすくなります。
再利用量・速度・品質を同じ条件で測る
導入の評価では、ヒット率だけを目標にしないことが重要です。多くのリクエストがヒットしていても、再利用された範囲が小さければ総費用はあまり変わらないかもしれません。逆に、ヒットする回数は少なくても、一度に非常に長い共通資料を再利用できれば、入力側の負担に影響します。回数とトークン量を分けて見ます。
OpenAIの利用量では、usage.input_tokens_details.cached_tokensやcache_write_tokensなど、対応する項目を確認します。入力総量と、書込・読取の対象量を同じリクエストに結び付けて記録してください。APIや応答形式によって項目の位置と意味を確認する必要があり、他社の利用量フィールドまで同じ名前で扱わないようにします。
先ほどの架空例なら、10回中9回がヒットしたと数えるため、回数によるヒット率は90%です。一方、全入力70,000トークンのうち、読取によって再利用された量は6,000×9=54,000トークンなので、入力全体に対する割合は約77.1%です。同じ利用状況でも数字が違うのは、各回の個別部分と初回の共通部分を、読取による再利用へ含めていないためです。
ここで、入力総量にcached_tokensをさらに足して総入力を求める、といった計算は避けます。再利用量は、入力の内訳として報告される情報かどうかを確認して扱う必要があります。回数、入力総量、読取量、書込量を別々の列にしておくと、請求額との対応も追いやすくなります。
| 記録する項目 | 見る目的 | 比較時の注意 |
|---|---|---|
| API・モデル・資料の版 | 同じ条件で比べているかを確かめる | モデル更新や規則改定を同じ集計へ無条件に混ぜない |
| 入力総量・読取量・書込量 | 何がどれだけ再利用されたかを把握する | 内訳と総量を重複して足さない |
| 初回を含む総費用 | 実際の利用期間で得になるかを判断する | 保存、出力、再書込など必要な料金も含める |
| 送信から応答開始までの時間 | 利用者が待ち始めてから反応を見るまでを測る | 表示方法と計測開始点をそろえる |
| 送信から回答完了までの時間 | 一件の仕事を終えるまでを測る | 出力トークン量と外部処理の影響を確認する |
| 回答の品質 | 必要な判断と根拠が保たれているかを見る | 通常ケースだけでなく例外や情報不足も含める |
速度を比べる場合は、同じモデル、同じ共通資料、同程度の個別入力と出力条件を使います。送信間隔も記録し、初回、再利用時、時間が空いた後を分けて見ます。たまたま速かった一回だけで結論を出さず、繰り返しの中央値や遅い側の値なども確認すると、利用者が遭遇するばらつきを把握しやすくなります。
暗黙的方式などでキャッシュの有無を自由に切り替えられない場合、初回と再利用時の比較には時間帯や通信などの違いも入り得ます。そのときは、完全に条件を統制した測定と同じだと扱わず、比較条件を記録したうえで傾向を読みます。キャッシュを外すためだけにモデルや資料を大きく変えると、別の要因を測ってしまいます。
品質確認には、返品の例なら「期限内の未開封品」「期限を超えた品」「破損がある品」「到着日が不明な品」を使えます。結論だけでなく、必要な確認を省いていないか、存在しない規則を補っていないかも見ます。入力の並べ替えで速度が改善しても、規則の解釈が変わるなら、その構成を採用する前に修正が必要です。
回答キャッシュ・会話メモリ・RAGとの違い
「以前の情報を使う」という点では似ていても、何を保存し、何のために使うかで仕組みは分かれます。プロンプトキャッシュを正しく設計するには、回答そのものの保存、会話の情報保持、外部資料の検索との違いを理解しておくと役立ちます。すべてを一つのキャッシュ機能で代用しようとすると、必要な情報の扱いが曖昧になります。
| 仕組み | 主に再利用・保持するもの | 判断の軸 |
|---|---|---|
| プロンプトキャッシュ | 共通入力の処理状態 | 先頭部分や設定が再利用条件に合うか |
| 回答キャッシュ | すでに作成した回答 | 保存済みの回答を今回も返してよいか |
| 意味的キャッシュ | 意味の近い質問などに対応する保存済みの回答 | 質問の類似性と回答を流用できる条件 |
| 会話メモリ | 利用者の希望や過去のやり取りなどの情報 | 次の会話にどの情報を引き継ぐか |
| RAG | 外部から検索した関連資料や根拠 | 今回の問いに必要な情報を取り出せるか |
| モデル内部のKVキャッシュ | 処理済みトークンに対応する内部状態 | 生成処理で過去部分の再計算をどのように避けるか |
回答キャッシュは、たとえば「受付時間は何時ですか」という質問への回答文を保存し、条件が合うときに返す仕組みです。回答を再生成しなくて済む場合がある一方、営業時間が変わったら保存内容の更新が必要です。プロンプトキャッシュでは、受付時間を含む共通資料の処理を再利用しても、回答文自体は今回の依頼に合わせて生成します。
意味的キャッシュでは、「返品の締切を知りたい」と「いつまでなら返品できますか」のような、表現が違う質問を近いものとして扱うことがあります。ただし、返品窓口なら商品区分や購入条件によって答えが変わるので、似た質問かどうかだけで回答を流用できるとは限りません。これに対してプロンプトキャッシュは、文章の意味が似ていることだけで共通先頭部分の一致を代用する仕組みではありません。
会話メモリは、たとえば利用者が「説明は短めがよい」と伝えたことを、後の応答へ反映するための情報保持です。キャッシュを指定したから、その希望が将来の会話へ自動的に引き継がれるわけではありません。何を記憶し、いつ取り出し、どの入力へ加えるかは、会話を管理する機能として考えます。業務上必要な記録を、期限のある処理状態だけに任せないことが重要です。
RAGは、質問に応じて外部資料を検索し、その内容を回答の根拠として渡す方法です。返品の例なら、固定の基本規則を先頭に置き、検索で得た商品別の注意事項や今回の質問を後ろに置く構成が考えられます。検索結果が毎回変わる部分まで安定した共通入力とはみなせませんが、固定規則の部分は再利用候補になります。検索結果を最新のまま渡すことと、安定した規則を再利用することは両立を検討できます。
検索結果の並びが変わった場合にも、関連性や根拠の読みやすさを優先します。ヒット率だけのために古い検索結果を使い続けると、RAGで新しい情報を取り込む目的を損ないます。検索と生成の役割を詳しく知りたい場合は、RAGの仕組みを解説した記事も参考になります。
内部のKVキャッシュは、モデルが扱うKeyとValueに関わる処理状態を保持し、すでに扱った部分の再計算を避けるための技術です。プロンプトキャッシュと技術的なつながりはありますが、利用者がAPIで気にする条件とは説明の階層が違います。単一の回答生成中の再計算回避と、別のリクエスト間での共通入力の再利用を分けて理解すると混乱しません。実装の数式を知らなくても、入力配置と利用量を確認する導入判断はできます。
資料の鮮度と機密情報を守る運用
運用で最優先にするのは、正しい資料を必要な相手の処理に使うことです。キャッシュの再利用率は、その条件を満たしたうえで改善する指標です。業務規則が変わったのに、以前の入力を使えば安く済むという理由で旧版を残すと、誤った回答を効率よく繰り返すことになりかねません。
共通資料には版を付け、どの版をどのリクエストへ適用したかを追えるようにします。たとえば返品規則の受付期限が改定されたなら、新版への切り替え時点を決め、代表的な問い合わせで回答を確認します。切り替え直後の再利用量が下がっても、それは新しい資料を正しく処理するために必要な変化かもしれません。
入力を安定させる工夫と、更新を避けることは区別してください。規則の版番号を一定の位置に置き、同じ版の本文を同じ手順で組み立てることは有効です。一方、新版なのに版番号を変えない、改定箇所だけ別の場所へ追記して旧文を残す、といった運用は内容の矛盾を生みます。改定後の一つの正しい資料を基準にするほうが、回答と原因調査の両方を見通しやすくなります。
頻繁に変わる情報を固定規則と分けることも役立ちます。基本的な受付方針は共通資料に置き、現在の在庫、今回の注文状況、当日の個別対応などは必要に応じて取得して後ろへ渡す構成です。ただし、情報を分けた結果、例外条件が伝わらなくなると本末転倒です。必要な関係が回答時に分かる形で整理します。
機密情報を扱う場合は、利用サービスの保持、削除、データの取り扱い設定を確認します。キャッシュの保持期限と、業務ログや会話履歴の保存期間は同じものだと考えないでください。また、キャッシュがあることはアクセス権の管理を代行することでも、業務資料の永続保存を保証することでもありません。誰の情報をどの処理へ渡せるかは、権限に沿って判断します。
原因調査のために入力を記録する場合も、本文を無条件にすべて保存する方法だけが選択肢ではありません。モデル、資料の版、入力長、再利用量、設定の識別情報で確認できる範囲を先に整理します。個別の内容を確認する必要がある場合には、業務上のルールに沿って扱います。診断しやすさと、必要以上に顧客情報を複製しないことを両立させる考え方です。
担当者の引き継ぎでは、ヒット率の数値だけでなく、「何を共通部分にしたか」「どの変更で再評価するか」を残すと役立ちます。モデルの更新、資料の改定、ツール定義の変更、利用間隔の変化を再確認のきっかけとして決めておけば、以前の好結果を条件の違う運用へそのまま当てはめずに済みます。
小さく試して継続利用を判断する
最初から全業務へ適用するより、一つの用途で共通部分と評価方法を決めると、導入の意味を確認しやすくなります。たとえば同じ業務規則で繰り返す問い合わせ対応を選び、どの資料が固定で、何が一件ごとに変わるのかを担当者と開発者でそろえます。文章が長いという理由だけで選ぶより、実際に繰り返しがある仕事から始めるのが合理的です。
- 利用のまとまりを決める。一時間の受付、一日の審査など、初回から最後まで評価する範囲を選びます。期待する改善が費用なのか、応答開始の早さなのかも明確にします。
- 共通情報と個別情報を分ける。規則、例示、共通資料を一定の順序で前に置き、個別の質問や注文情報を後ろへ配置します。
- 対応条件を確認する。API、モデル、方式、最小入力長、保持条件、料金の扱いを確認し、選んだ業務の利用間隔に合うかを見ます。
- 初回と再利用時を記録する。入力総量、読取・書込量、出力量、費用、応答開始と完了の時間をそろえて記録します。
- 品質と総額から継続を決める。例外を含む回答の確認を行い、運用の手間に見合う改善があるかを判断します。
結果が期待に届かないときには、原因に応じて対応を変えます。先頭の変動情報が問題なら入力の配置を直します。共通部分が短く、利用も一度限りなら、通常処理を続ける判断が自然です。保持のための費用が大きい場合には、方式や利用のまとめ方を検討します。回答品質に問題が出た場合は、費用の改善だけを理由にその設計を採用しません。
基礎から整理したい場合は、文字数との違いを説明するトークンの解説と、入力・出力の範囲を考えるコンテキストウィンドウの解説がつながります。継続的な評価や変更管理まで進めるなら、LLMOpsの基本も、単発の試験を日常運用へ移す際の参考になります。
プロンプトキャッシュの価値は、必要な共通情報を繰り返し使う仕事で、入力処理の無駄を減らせることにあります。固定情報の配置を整え、条件を満たした範囲の再利用量を確認し、初回を含む費用・時間・品質で判断してください。その手順があれば、ヒットしたという表示だけに頼らず、自分の業務で使い続ける理由を説明できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年9月30日 | 初回公開 |