

ベンチマークとは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「ベンチマーク」という言葉をよく聞きますが、AIの分野では何を指すのでしょうか?

AI専門家
AI、特に大規模言語モデル(LLM)のベンチマークは、決められた課題を解かせて性能を測る評価の枠組みです。質問に答える、文章を要約するなどの結果を、あらかじめ定めた方法で採点します。
AIの初心者
テストに似ていますね。課題によって、測れる能力や点数の意味も変わるのでしょうか?
AI専門家
その通りです。数学の問題で推論力を測るテストと、文章の要約を評価するテストでは、課題も採点方法も異なります。複数のベンチマークを使うと、モデルの得意なことや苦手なことをより具体的に把握できます。
ベンチマークとは、性能や成果を一定の基準で測り、対象同士を比べるための評価枠組みです。大規模言語モデル(LLM)の評価では、質問応答や文章作成などの課題をモデルに与え、知識、推論、文章生成といった能力を調べます。コンピューターやソフトウェアの処理性能を比べるときにも使われる考え方です。
ベンチマークは、単に問題を集めたものではありません。評価に使うデータや課題、結果を数値にする指標、モデルに入力して採点する手順が組み合わさって初めて、比較の基準として機能します。スコアが示すのは設定された課題での結果であり、モデル全体の優劣や、あらゆる実務能力を一つの数字で表すものではありません。
この記事では、ベンチマークの仕組みや種類、開発・モデル選びでの活用方法を解説します。評価指標やリーダーボードとの違い、スコアを読む際の注意点も押さえておきましょう。

ベンチマークとは何か
ベンチマークは、ものの性能を測る「物差し」にたとえられます。長さを測るときに同じ物差しを使うように、対象や条件をそろえた課題を使って結果を比べれば、モデルごとの違いを捉えやすくなります。人の印象だけで比べるのではなく、何を試し、どう評価したのかを明確にできる点が特徴です。
LLMでは、たとえば事実に関する質問への回答、文章の読解、数学や論理の問題、要約などを課題にします。質問に正しく答えた割合を測るテストなら知識や読解の一面を確認できますし、文章を作らせる課題なら出力の質を評価できます。ただし、一つのテストで測れるのは、その課題と採点方法が対象にしている能力です。
そのため、ベンチマークはモデルの順位を決めるだけでなく、開発時に改良前後の変化を見たり、利用者が候補モデルを絞り込んだりするためにも使われます。結果を読むときは「どのモデルが一番か」だけでなく、「自分が必要とする能力を測っているか」を確かめることが大切です。
ベンチマークは何でできているか
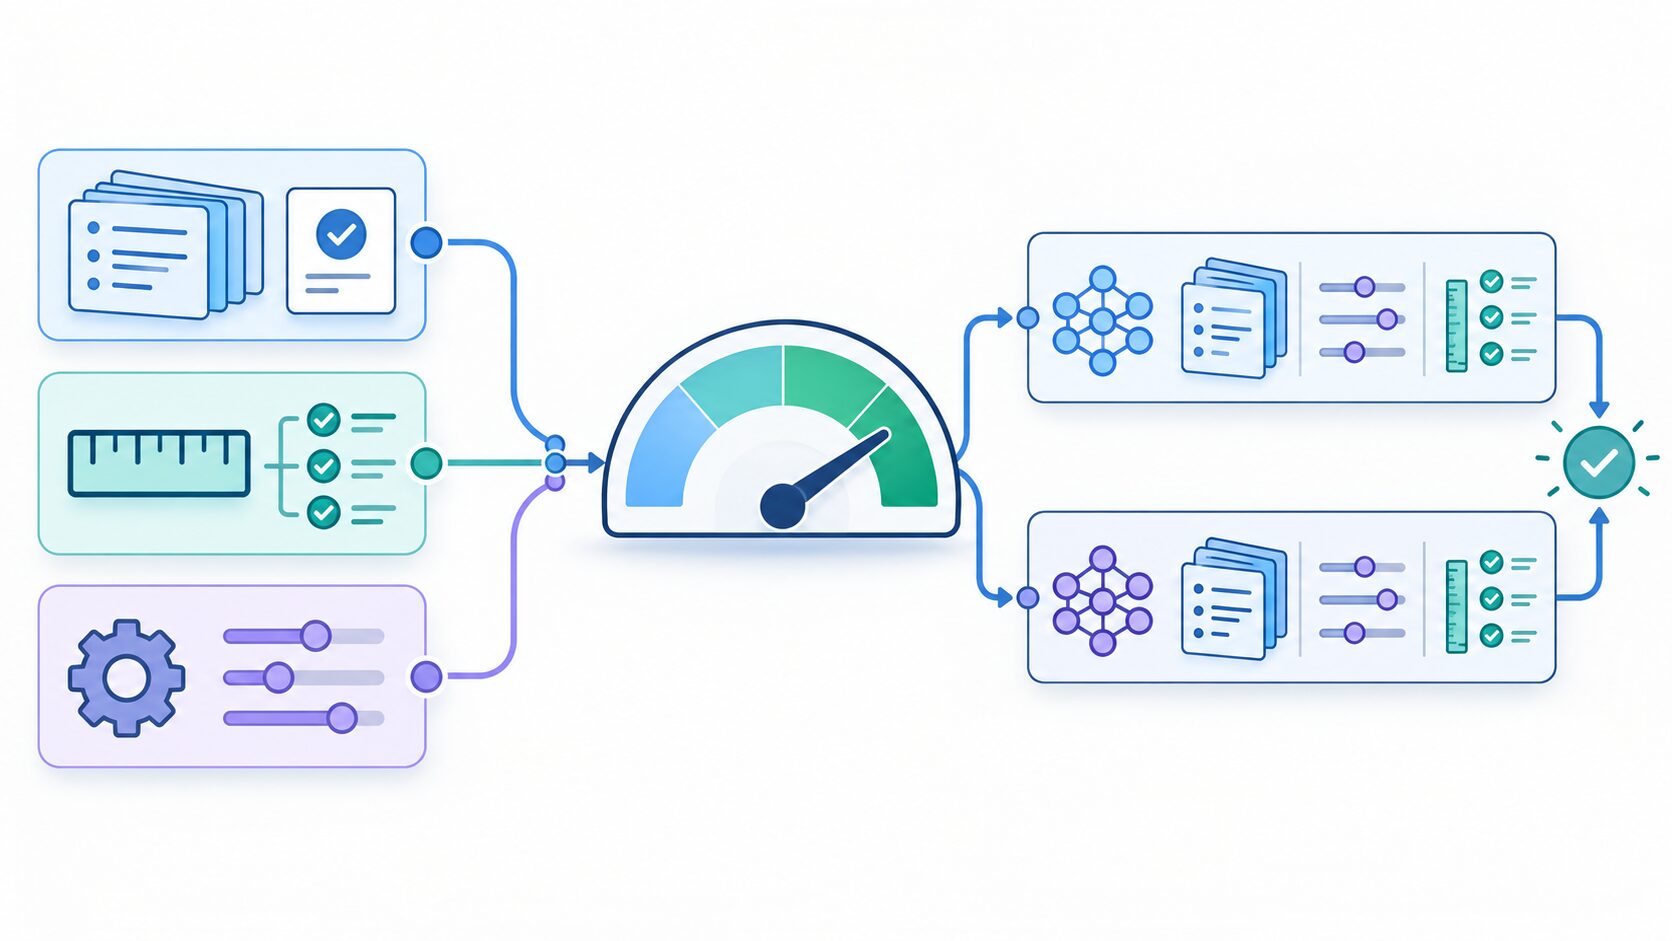
ベンチマークの基本要素は、評価データ、評価指標、評価手順の三つです。たとえば文章理解を測る場合は、入力する文章や質問、正解例などのデータを用意します。何を測るかによって適切な課題は変わり、文章生成を評価したいのに選択式の知識問題だけを見る、といった設計では目的に合った結果を得られません。
- 評価データ:モデルに解かせる質問や作業、その正解例など。データの内容や難しさが測定結果に影響します。
- 評価指標:モデルの出力を採点し、比較できる数値にする尺度です。選択式の問題では正答率、実運用を想定する場合は応答時間などが使われます。
- 評価手順:入力の仕方、採点方法、集計の仕方などを決めたものです。生成された文章は、自動採点に加えて人が評価する場合もあります。
同じモデルでも、プロンプトや例示の有無、モデルのバージョン、実行条件、採点器が違えば結果が変わることがあります。モデルを公平に比べるには、こうした条件をそろえ、手順を記録・公開して再現できるようにする必要があります。
測る能力によって種類が異なる
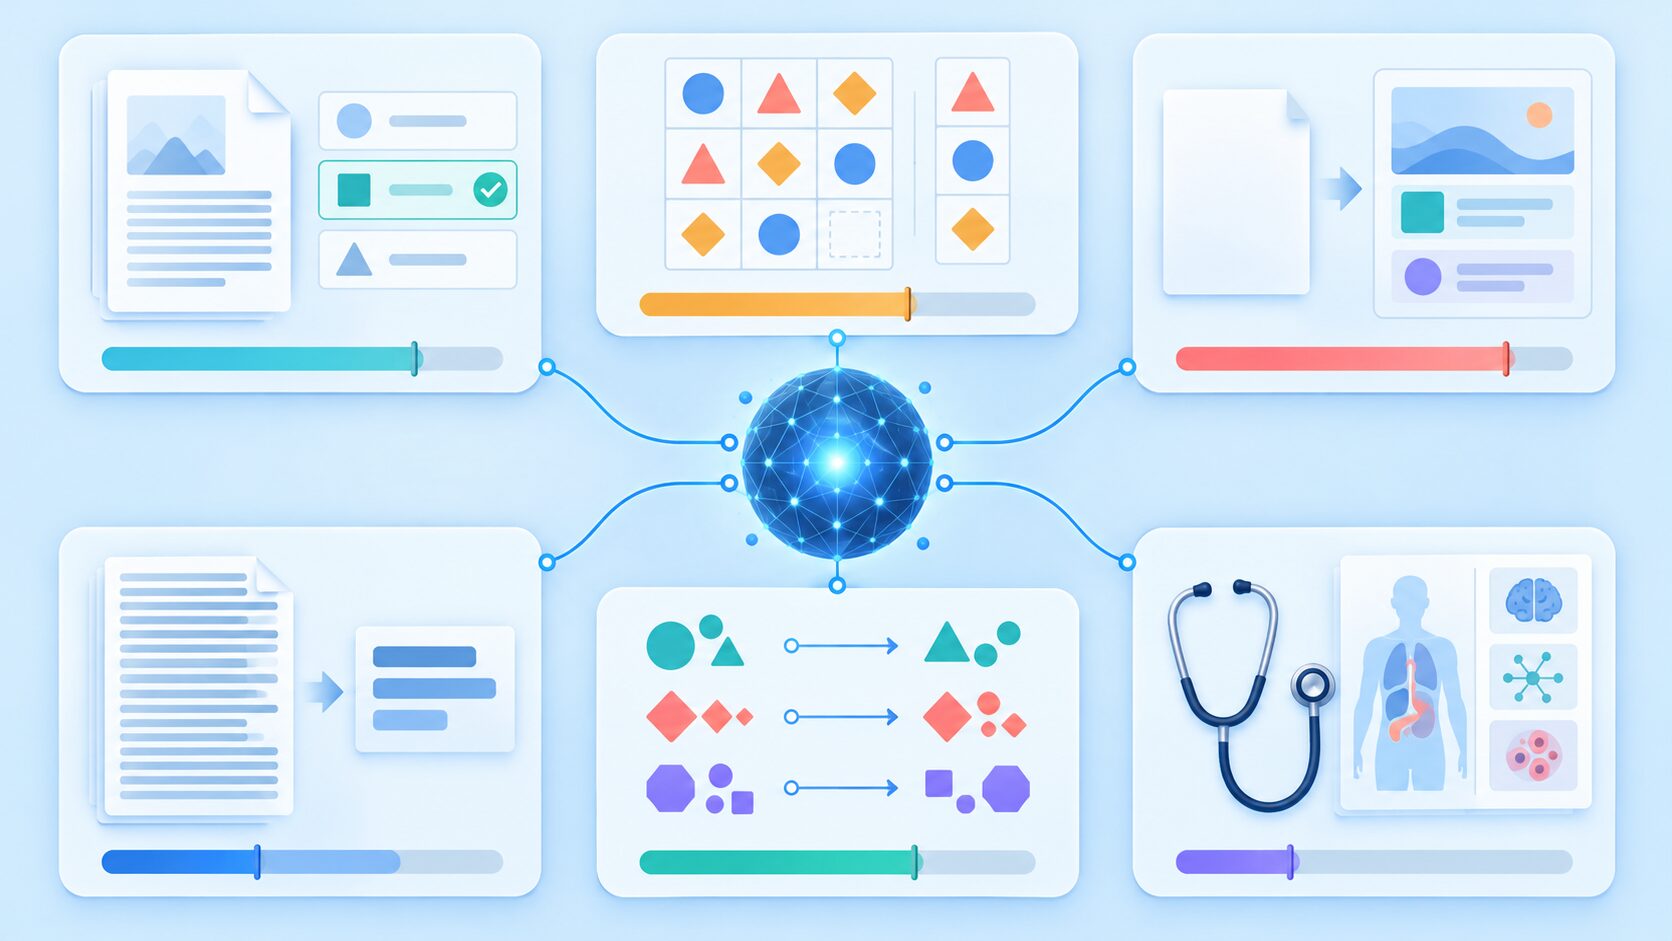
ベンチマークには、測りたい能力に応じてさまざまな種類があります。代表的な分類と課題の例は次のとおりです。
- 知識・読解・質問応答:質問への正確さや、与えられた文章の内容を理解できるかを調べます。
- 数学・論理推論:計算問題や条件を整理して答えを導く課題を通じて、段階的に考える力を評価します。
- 文章生成・要約:指定されたテーマで文章を作る、あるいは入力文の要点を保って短くまとめる能力を見ます。
- 多言語理解・翻訳:複数の言語で内容を理解したり、意味を保って別の言語に置き換えたりできるかを調べます。
- 専門分野の知識:医療など特定領域の質問や課題を使い、その分野に関係する回答の適切さを評価します。
課題が異なれば、採点方法も変わります。事実質問なら正解との一致を判定できますが、要約や文章生成では、内容の正確さ、読みやすさ、指示への適合など複数の観点が必要です。自動採点で判定しにくい品質は、人による評価を組み合わせることもあります。
同じモデルでも、知識問題では高い点を取り、長い文章の要約では苦戦することがあります。用途を先に定め、その用途に近い課題を複数選んで結果を見ると、総合スコアだけでは見えにくい強みと弱みを捉えられます。
開発・モデル選びにどう使うか
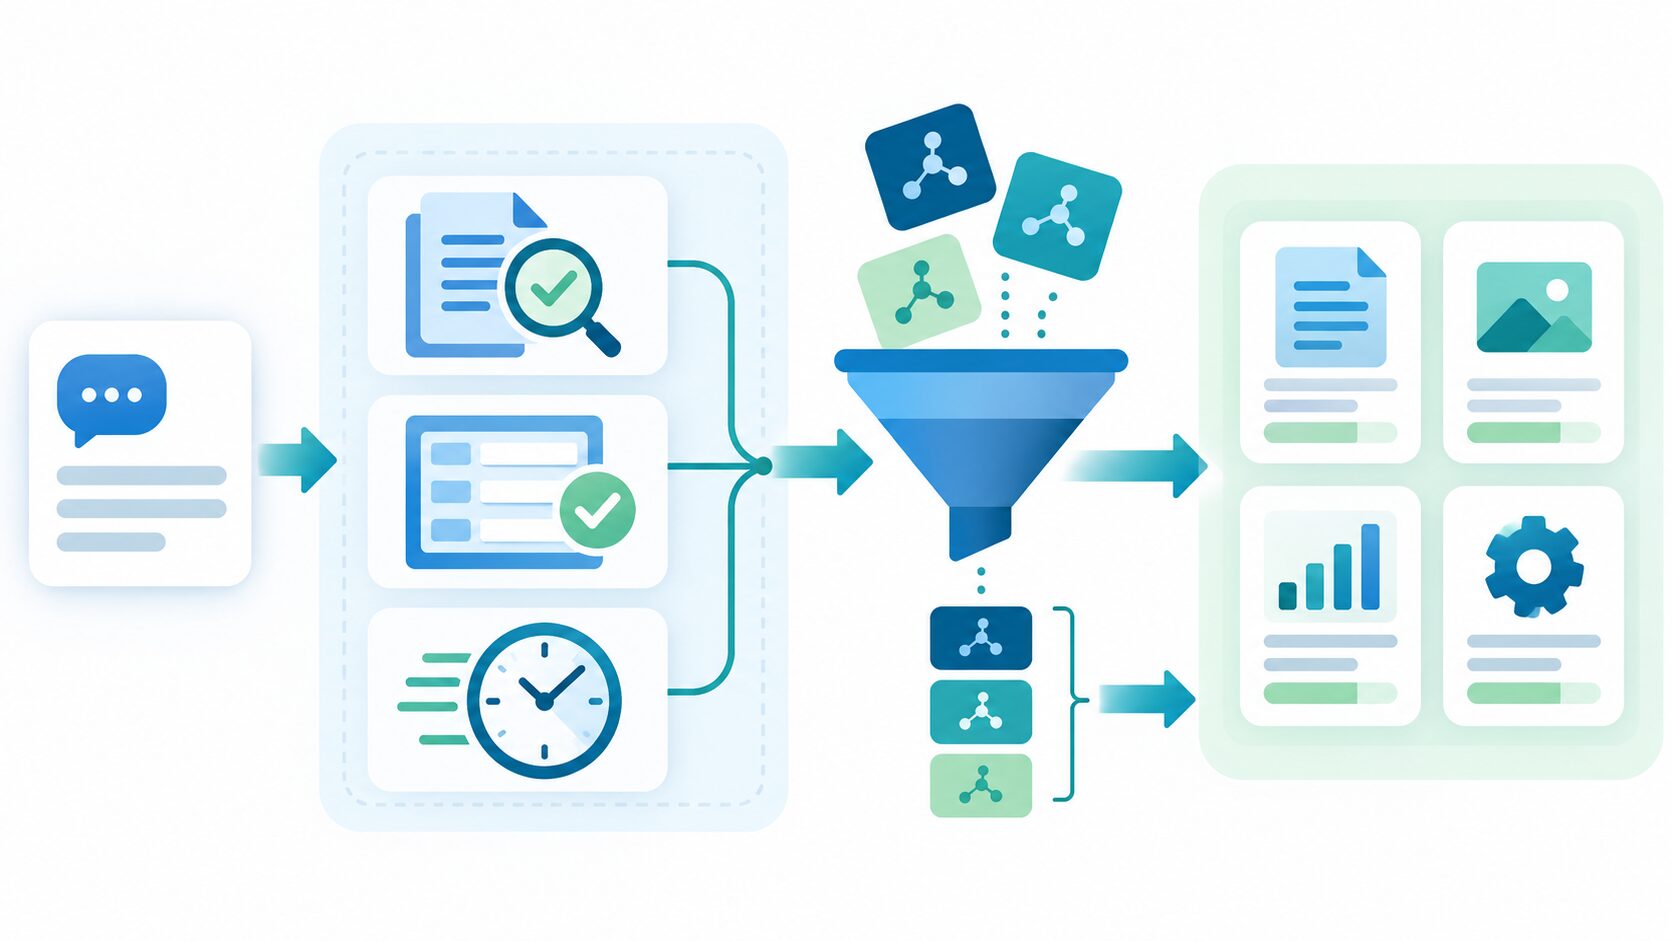
開発者は、改良の前後でベンチマークの結果を比べ、どの能力が伸びたか、どの課題で誤りが続くかを確認できます。たとえば質問応答の正確さが改善しても、要約の品質が下がっていれば、変更の影響を分けて調べられます。評価の結果は、次に手を入れる箇所を決める手がかりになります。
利用者や導入担当者は、まず自分の用途で必要な品質を具体化し、それを測る評価を選びます。公開スコアは候補を絞るのに役立ちますが、最終判断の前には自社の質問やデータに近い条件でも試すのが実践的です。
たとえば問い合わせ対応に使うモデルを選ぶなら、事実質問への正確さだけでなく、指定した形式で回答するか、必要な応答時間を満たすかも確認します。該当する複数の評価結果から候補を選んだ後、実際の問い合わせ例を使って試用すれば、公開ベンチマークでは見えにくい業務との相性を確かめられます。
このように、ベンチマークは開発の改善点を見つけるときにも、モデル選定の初期比較にも使えます。スコアをそのまま採用判断に置き換えず、用途に合う評価か、実際の運用条件で期待どおりに動くかを段階的に確かめましょう。
ベンチマーク・評価指標・リーダーボードの違い
「ベンチマーク」「評価指標」「リーダーボード」は関連していますが、指すものが異なります。ベンチマークは何をどのように評価するかをまとめた枠組みで、評価指標は結果を採点する尺度、リーダーボードはモデルごとの結果を一覧にしたものです。
| 用語 | 役割 | 例 |
|---|---|---|
| ベンチマーク | 課題データや評価指標、実施手順を含む評価の枠組み | 質問応答の課題を用意し、共通の手順でモデルを評価する |
| 評価指標 | 出力の結果を数値として採点する尺度 | 選択式問題の正答率、応答時間 |
| リーダーボード | 各モデルの評価結果を並べて示す一覧 | 同じ評価で得たモデル別スコアのランキング |
リーダーボードで順位を見るときは、評価名やスコアだけで比較せず、データの分割、プロンプト、例示、モデルの版、採点方法などの条件も確認してください。同じ名前のベンチマークでも実施条件が異なると、結果をそのまま横並びにできない場合があります。
スコアを読むときの限界と注意点
ベンチマークの高得点は、決められた課題で良い結果を出したことを示しますが、実務での成功を保証するものではありません。評価データが実際の利用場面をどれほど代表しているか、特定の分野や問題形式に偏っていないかによって、スコアを現場に当てはめられる範囲は変わります。モデルにとって課題の形式が実際の依頼と違えば、順位だけで使い勝手を予測するのは困難です。
評価データや正解例がモデルの学習データに混入していると、未知の課題を解く力ではなく、既知の問題への記憶がスコアに反映される可能性があります。また、特定のベンチマークで点数を上げる調整が進みすぎると、その課題では優れていても、別の問題への対応力が伴わないことがあります。評価データが古く、現在の利用状況とずれていないかも確認したい点です。
文章生成の評価では、自動採点の基準によって、意味が合っていても表現の違いが不利に働いたり、自然に見える回答の誤りを捉えきれなかったりすることがあります。何を良い回答とするかが一つの数値に収まりにくいため、必要に応じて人による確認や誤答の内容の分析を加えます。
スコアだけでモデルを決めず、能力別の複数評価、採点条件、苦手な課題の傾向を合わせて見ましょう。そのうえで、実際の質問や業務データに近い試用を行うと、期待する品質との差や追加の確認事項を判断できます。
これからのAI評価に求められること
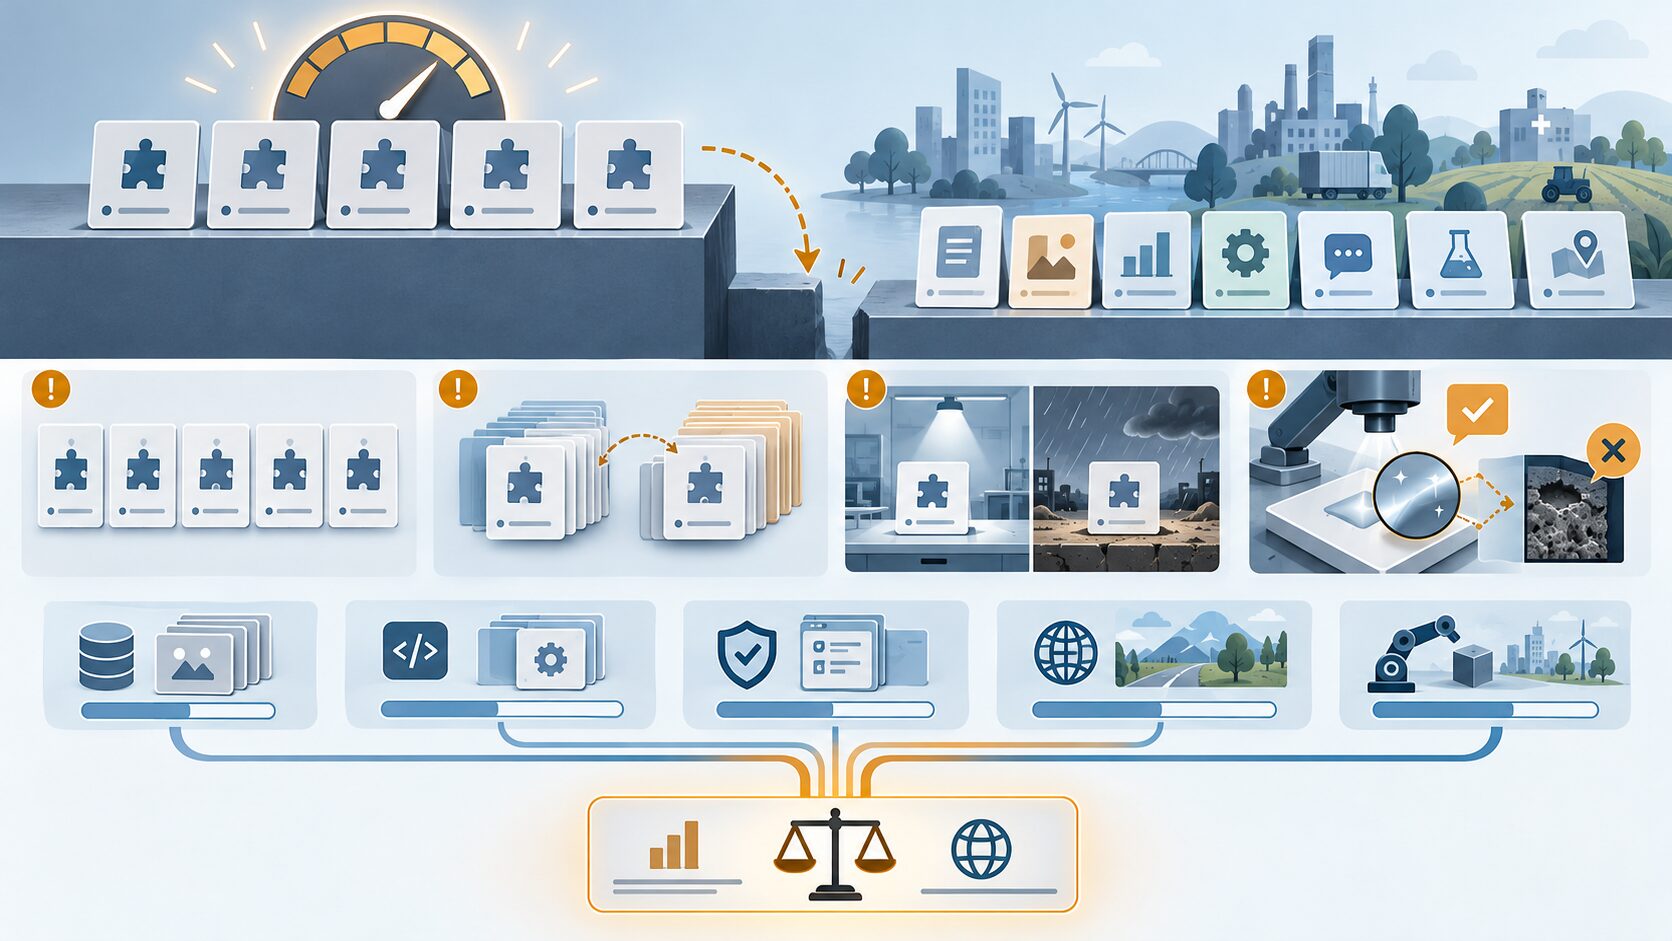
AIの使われ方が広がるにつれて、単純な知識問題だけでは測りにくい能力も増えています。複数の段階を踏む推論や、現実の作業に近い課題を取り入れることで、実際の利用に役立つ評価を増やすことが求められます。一方で、現実に近い課題ほど採点が複雑になり、結果を再現しやすい手順を整える必要があります。
自然さや創造性など、単一の数値にしにくい品質には、人間の判断を組み合わせる方法が有効です。評価者の基準や人数によって結果がぶれないよう、何を評価するかを明確にし、手順や判断の根拠を記録する工夫も欠かせません。
さらに、評価条件や報告形式の共通化が進めば、異なるモデルの結果を再現し、比べやすくなります。ただしベンチマークは固定の最終判定ではありません。モデルや用途、利用環境が変われば、課題や評価方法も見直しながら、性能を判断する道具として使うことが大切です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月17日 | 評価の構成と比較条件を整理し、用途別の選び方とスコアの限界を補足 |