 学習
過学習とは?機械学習で起きる原因・見分け方・対策を初心者向けに解説
機械学習の目的は、未知のデータに対しても正確な予測を行うことができるモデルを作ることです。しかし、学習の過程で思わぬ落とし穴にはまることがあります。それが「過学習」です。過学習とは、まるで特定の試験問題と解答だけを暗記した生徒のように、訓練データに過度に適応しすぎてしまう現象のことを指します。
例えるなら、ある生徒が過去の試験問題を全て暗記して、その試験では満点を取れるようになったとします。しかし、試験の出題範囲は同じでも、新しい問題が出題された場合はどうでしょうか。暗記した内容だけでは対応できず、良い点数は取れないでしょう。これは、その生徒が問題の本質を理解するのではなく、解答だけを丸暗記してしまったからです。
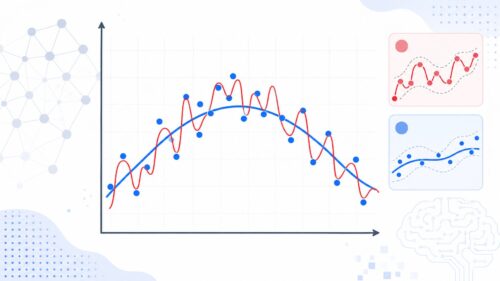
機械学習モデルもこれと同じことが起こります。訓練データに含まれる特徴や傾向を細部まで捉えすぎて、まるで訓練データを丸暗記したかのような状態になってしまうのです。訓練データに対する精度は非常に高いものの、新しい未知のデータに直面すると、そのデータの特徴をうまく捉えることができず、予測精度が低下してしまいます。
これは、モデルが訓練データのみに特化しすぎて、データに含まれるノイズや例外的なパターンまで学習してしまったことが原因です。本来であれば、データ全体の傾向や本質的な特徴を捉えるべきなのですが、過学習状態では、それらを見失い、木を見て森を見ずの状態になってしまいます。
このように、過学習は機械学習モデルの汎用性を損ない、本来の目的である未知のデータへの予測精度を低下させるため、避けるべき問題です。過学習を防ぐためには、様々な手法が用いられます。例えば、学習データの量を増やす、モデルの複雑さを抑える、正則化と呼ばれる技術を用いるなど、モデルが訓練データに過度に適応しすぎないように調整することで、汎用性の高いモデルを作ることが可能になります。