


AIの初心者
「学習データのカットオフ」って、どういう意味ですか?

AI専門家
基本は、学習に使うデータをある時点で区切ることだよ。AIの説明では「いつごろまでの情報を学習に含めているか」という意味で使われるね。
AIの初心者
では、古いデータを除外することとは違うんですか?
AI専門家
関係はあるけれど、分けて考えると理解しやすいよ。学習データの終了時点を決めることと、古いデータや条件に合わないデータを対象から外すことは別の判断なんだ。どの範囲を使うかは、予測の目的と検証結果に合わせて決めよう。
学習データのカットオフとは、学習に使うデータを区切る時点や境界のことです。AIの説明で見かける「知識のカットオフ」は、学習に含まれる情報の時間的な範囲を示す目安です。一方、機械学習では、過去のどの期間を使うか、どの条件のデータを対象にするかも検討します。
「いつまでの情報を使うか」と「どのデータを学習対象から外すか」は、関連していても同じ意味ではありません。この記事では、その違いを出発点に、時系列データへの適用、地域・商品による絞り込み、精度を落とさないための検証方法を説明します。
学習データのカットオフとは
カットオフは、対象に含める範囲と含めない範囲の境界を指します。学習データについて使う場合は、まず「何を基準に、どちら側を対象から外すのか」を確認すると意味を取り違えにくくなります。たとえば、6月末を学習データの終了時点にするなら、7月以降に得られる情報はその学習には含めません。
また、ある時点より古いデータを使わず、最近の記録だけで学習する運用もあります。これは学習期間の開始側を決める話です。さらに、地域や商品などの条件で対象を限定する操作は、通常「フィルタリング」や「データ選別」と呼ぶほうが目的を具体的に伝えられます。
学習対象から外すことは、元のデータを削除することとは別です。元データを保持していれば、採用基準を変えた再検証や、除外によって失った傾向の確認に使えます。実務では、期間や条件を記録したうえで、学習用のデータセットを切り出すと比較がしやすくなります。
| 用語 | 何を決めるか | 例 |
|---|---|---|
| 知識のカットオフ | AIが学習に含めた情報の時間的な範囲の目安 | ある時期より後の出来事は学習に含まれていない可能性がある |
| 学習期間の絞り込み | いつからいつまでの記録を使うか | 直近1年間の売上で学習する |
| 条件によるフィルタリング | どの対象の記録を使うか | 特定地域の店舗の売上を抽出する |
| データクリーニング | 記録上の誤りや重複などをどう扱うか | 同じ取引の二重登録を修正する |
| 分類のしきい値 | モデルの出力をどこで判定に分けるか | 予測スコアが基準以上なら検知対象にする |
同じ「カットオフ」という言葉でも、分類の判定基準を指す場合があります。学習データの期間を決める話なのか、学習後の出力を判定する話なのかを分けて読むことが大切です。
AIの知識のカットオフは「いつまで学んだか」の目安
生成AIなどで示される知識のカットオフは、学習に使った情報の時間的な範囲に関する目安です。たとえば、ある年の6月までの情報を学習対象としているなら、その後に起きた出来事について、学習済みの知識だけで正確に答えられるとは限りません。モデルの公開日や、会話している今日の日付とは別のものです。
ただし、カットオフ以前の出来事をすべて知っている、という保証でもありません。学習に含まれなかった情報もあれば、誤った説明を出す場合もあります。「期限内だから正しい」「期限後だから一切扱えない」と、日付だけで回答の信頼性を判断しないようにしましょう。
検索機能や外部データベースへの接続、ユーザーが渡した資料を使えば、学習後に公開された情報を参照して回答できる場合があります。これは回答時に情報を取り込む仕組みであり、モデルの学習済み知識そのものが更新されたことを意味しません。参照できる機能の有無と、参照先の内容を確認する必要があります。
新しい出来事を調べる場面では、回答が何を根拠にしているか、その資料がいつ公開・更新されたかを確認します。知識のカットオフは、AIの情報がどこまで届きそうかを考える手がかりであって、正確さを保証する印ではありません。
学習の終了時点と古いデータの除外は別の判断
時系列の機械学習では、学習データの「終了時点」と「開始時点」を分けて設定します。終了時点は、予測するときに利用できる過去の情報を区切る境界です。開始時点は、そこからどれだけ過去にさかのぼって学ぶかを決める境界です。
架空の例として、6月末に翌7月の売上を予測するとします。学習に使う売上実績は6月末までに確定したものとし、前年7月から今年6月までの1年間を使う案と、今年4月から6月までの3か月を使う案を比べます。どちらも終了時点は同じですが、開始時点とデータ量が異なります。
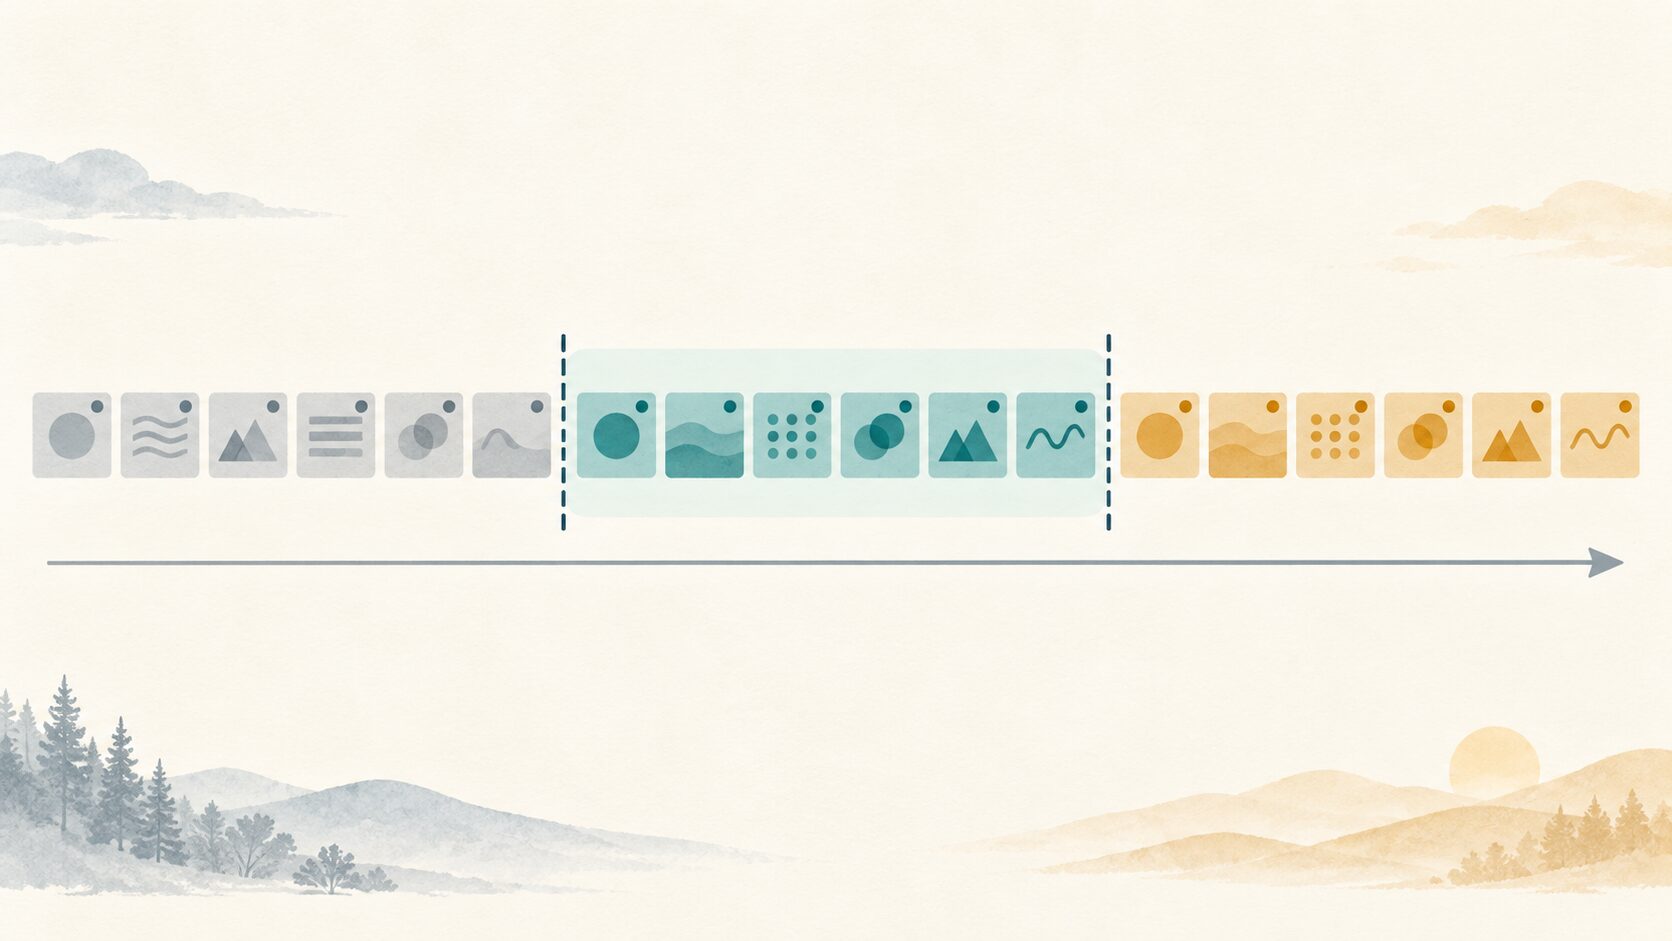
1年間のデータは季節の変化を含めやすく、3か月のデータは最近の販売傾向を反映しやすい一方で、季節や事例の種類が限られます。どちらがよいかは、商品特性や変化の大きさ、観測数によって変わります。この期間は説明用の候補であり、一般的な最適値ではありません。
また、データに付いた日付だけでは十分でないこともあります。6月分の集計が7月に確定するなら、6月末の予測ではまだ使えません。記録の対象日と、その情報を実際に入手できる日は区別して管理します。
時系列データでは季節性と環境の変化を両方見る
時系列データは、売上、気温、株価など、時間の順に記録されたデータです。時間とともに利用者の行動や市場の状況が変わると、過去に成り立っていた関係が現在の予測に合わなくなることがあります。こうした関係の変化は、コンセプトドリフトと呼ばれます。
たとえば、販売価格や販売チャネルが大きく変わった後は、変更前の購買傾向をそのまま当てはめると誤差が増えるかもしれません。最近の期間に絞って学習すると、現在の条件に合う傾向を捉えやすくなる可能性があります。データ量が減れば、学習時間や保管・処理の負担を抑えられる場合もあります。
一方で、古いという理由だけでデータを除くのは早計です。夏に売れる商品の予測では前年の夏が役立ち、気温の分析では季節性や年ごとの違いを見るために長い記録が必要になることがあります。市場データでも、昔の記録に現在と似た変動局面が含まれている可能性があります。
| 学習データの使い方 | 利点 | 確認したい点 |
|---|---|---|
| 直近の一定期間を使う(スライディングウィンドウ) | 最近の傾向を反映し、データ量を抑えやすい | 季節性やまれな出来事を失っていないか |
| 過去の開始時点を固定し、新しいデータを追加する(拡大ウィンドウ) | 事例を蓄積でき、長期的な傾向を学びやすい | 古い関係の影響や計算量が大きくなっていないか |
| 古いデータを残し、最近のデータの重みを大きくする | 過去の情報を残しながら新しい傾向を重視できる | 手法が重み付けに対応するか、重みが適切か |
短期間・長期間・重み付けという複数の方法を比較し、目的とする将来期間での誤差を確認しましょう。季節周期を一巡含むかは検討の出発点になりますが、それだけで十分なデータ量が確保できたとは限りません。
地域・商品などの条件でデータを絞り込む
時間以外の条件で学習データを選ぶ場合も、最初に決めるのは「誰に、何に対して使うモデルか」です。ある地域の購買行動だけを分析したいなら、その地域の顧客データを抽出すると、地域特有の傾向を調べやすくなります。特定商品の評価を集計するなら、その商品に関するレビューが直接の分析対象になります。
ただし、集計の対象を限定することと、予測モデルの学習に他のデータを使わないことは別です。対象地域のデータが少ない場合には、他地域の事例と地域を表す特徴を組み合わせたほうが、安定した予測につながる可能性があります。新商品の場合も、類似商品の販売実績が参考になることがあります。
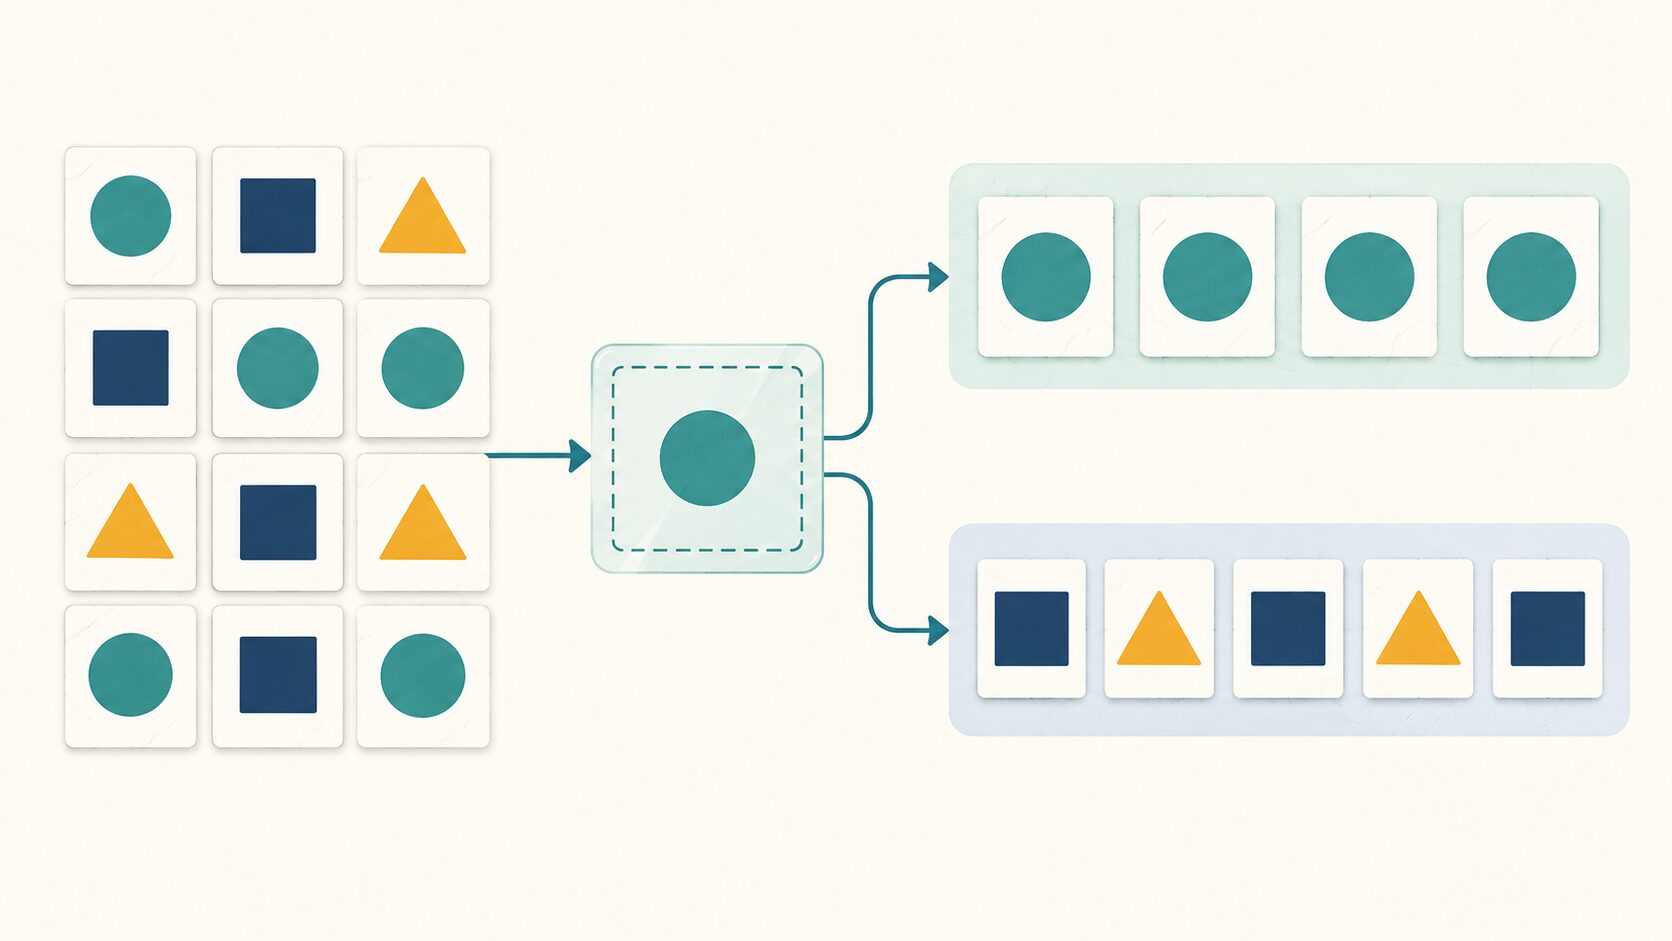
地域限定のモデルを全国向けに使えば、学習に含まれない地域の傾向を捉えにくいかもしれません。データを絞る条件と、モデルを利用する範囲を一致させることが基本です。利用範囲を広げる場合には、追加データを用意するか、対象外だった集団でも性能が保たれるかを検証します。
また、条件に合わないデータと、記録に誤りがあるデータを一緒に扱わないようにします。重複や明らかな入力ミスへの対応はデータクリーニングの論点です。大きな売上や珍しい反応も、実際に起きた事象なら重要な学習例になり得るため、目立つ値というだけで除外しないことが大切です。
カットオフや学習期間を決める手順
学習データを切り替えるときは、削減した件数よりも、利用時と同じ条件で性能が保たれるかを重視します。比較の前に予測対象と評価方法を決めることで、都合のよい結果だけを採用する判断を避けやすくなります。
- 予測対象と利用時点を決める。たとえば「毎月末に翌月の店舗別売上を予測する」と定義します。対象店舗、予測する期間、その時点で入手できる情報を明確にします。
- データの量と構成を調べる。期間別の件数、欠損、季節、地域・商品構成、価格や集計方法の変更時期を確認します。件数が多くても、ほぼ同じ状況の記録ばかりなら学べる変化は限られます。
- 比較する候補を用意する。全期間、直近1年、直近3年などを候補とし、必要なら条件による絞り込みや重み付けも比べます。これらは候補の例であり、対象に合わせて設定します。
- 時間順に学習用・検証用のデータを分ける。過去で学習し、その後の期間で予測を評価します。まずは同じモデル、評価期間、指標を使って、データの範囲による差を見ます。
- 複数の予測時点で比較する。予測の基準日を順に進めて評価し、特定の月や季節だけに有利な設定ではないか確認します。売上なら平均的な誤差だけでなく、繁忙期や主要商品での誤差も見ます。
- 採用後に未使用のテスト期間で最終確認する。候補選びには検証用データを使い、最後のテスト用データは判断に繰り返し使わず保留します。精度と学習時間、更新の負担を合わせて採用基準を決めます。
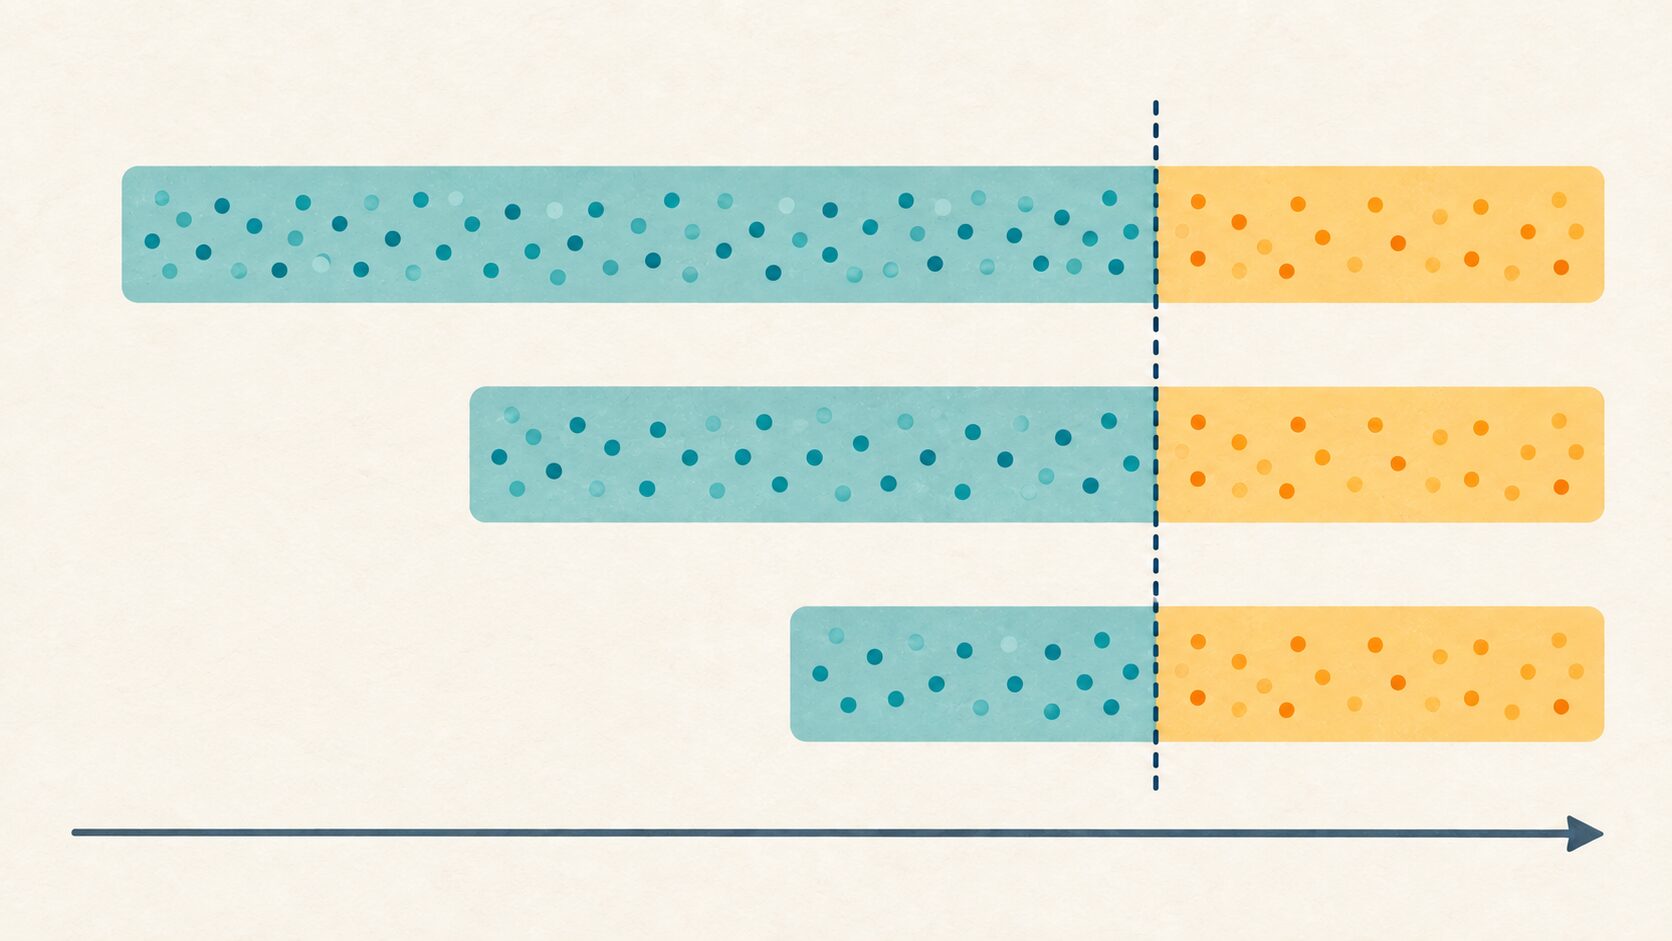
特に注意したいのが、予測時点では使えない情報が学習や前処理に混ざる「データリーク」です。7月の売上を予測するのに7月の確定売上を特徴として入れれば、検証ではよく当たっても実際の予測には使えません。記録が過去の日付でも、後日確定・修正された値なら同じ問題が起きます。
欠損値を埋める平均や、数値の尺度を揃える標準化の基準も、各比較の学習用データで求め、検証用データに適用します。時系列の将来予測では、単純にデータをランダム分割すると前後の関係が崩れ、実運用より評価がよく見えることがあります。複数時点で検証するときも、その時点で利用可能だった情報だけを使う条件を守りましょう。
なお、予測に使う情報がすべて過去の観測値である必要はありません。事前に決まっている翌月の祝日や営業時間などは、予測時点で把握できる情報です。問題は「未来に関する値か」ではなく、「予測するときに知り得た値か」です。
データ不足と偏りを防ぐための確認ポイント
対象を絞るほどデータが目的に合うとは限りません。期間を短くすると事例が不足し、厳しい条件で抽出すると一部の集団だけが残る可能性があります。モデルが似た事例ばかりに合わせて学習すれば、少し違う条件での予測が不安定になりかねません。
たとえば、過去1年間がたまたま好景気だった場合、その期間だけでは売上が落ち込む局面を学びにくくなります。気温が高い年に偏れば、季節商品の売れ方も通常年とは異なるかもしれません。1年、3年、5年といった期間を比較すると、切り取り方による結果の違いを確認できます。ただし、長い期間なら必ず偏りが消えるわけではありません。

| 確認すること | 起こり得る問題 | 対応の例 |
|---|---|---|
| 期間別・対象別のデータ件数 | 一部の商品や地域の事例が極端に少ない | 期間を広げる、該当するデータを追加収集する |
| 季節や状況の幅 | 繁忙期、低需要期、異常気象などを十分に含まない | 必要な状況が含まれる期間を選び、状況別に誤差を確かめる |
| 除外前後のデータ分布 | 顧客層や価格帯などの構成が利用対象からずれる | 棒グラフや分布図で比較し、条件の見直しや重み付けを検討する |
| 集団別の予測誤差 | 全体では改善しても、特定の地域や顧客層で悪化する | 集団ごとの件数と誤差を併記し、利用範囲や採用基準を再検討する |
| 除外した珍しい事象の意味 | 障害や急な需要変動など、対応したい事象を失う | 入力ミスと実際の例外を区別し、必要な事象を保持する |
データの偏りは、単に各地域や各商品の件数を同じにすれば解決するものではありません。モデルを使う対象の構成や、見逃したときの影響を踏まえて判断します。少数の集団は評価結果自体も変動しやすいため、誤差の数値と一緒に評価件数を見ることが重要です。
異なる期間で学習した複数のモデルの予測を組み合わせる「アンサンブル」も選択肢になります。短期の変化と長期の傾向を補い合える可能性はありますが、すべてのモデルに同じ不足や偏りがあれば解消できません。単独のモデルよりよくなるかを、同じ検証条件で確認する必要があります。
運用ではカットオフの基準を定期的に見直す
一度よい結果が出た学習期間でも、そのまま使い続けられるとは限りません。顧客層、販売方法、データの取得方法が変われば、有効な期間や対象条件も変わります。予測誤差に加えて、期間別の件数や商品・地域の構成を確認し、変更があったときに再検証できる運用にします。
学習期間の候補を自動で比較したり、データの変化を検知して再学習を促したりする仕組みは、基準の調整を助けます。ただし、全体の誤差が最も小さい設定を自動採用するだけでは、特定集団での悪化や計算負荷を見落とすかもしれません。性能、対象別の影響、処理時間など、守る条件を先に定めておくことが必要です。
学習の開始・終了時点、除外条件、残った件数、評価期間、評価結果を記録すると、性能が変わった理由を追いやすくなります。データの特性に応じた柔軟な調整や、偏りを見つける仕組みを取り入れる際も、この記録が比較の土台になります。
見直しの頻度も一律ではありません。日々変化する需要と、ゆっくり変化する傾向では必要な更新間隔が異なります。定期点検に加え、価格改定やサービス変更など、学習時の前提が変わる出来事を見直しのきっかけにするとよいでしょう。
まとめ
学習データのカットオフを理解するときは、まず何の境界なのかを確かめます。AIの知識のカットオフは学習した情報の時間的な範囲の目安であり、古いデータの除外や地域・商品によるフィルタリングとは分けて考えます。
機械学習では、最近の傾向を反映することと、季節性・事例の多様性を残すことの両方が大切です。元データと選別基準を記録し、未来の情報を混ぜずに複数の期間や条件を比較しましょう。データを減らすこと自体を目的にせず、利用する場面で役立つかを検証して範囲を決めることが、精度と信頼性を保つ基本です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年9月26日 | 知識の期限とデータ選別を区別し、学習期間の検証手順と偏りへの対策を追記 |