
画像認識の革新:SENetの仕組みと活用例

AIの初心者
「エス・イー・ネット」って何ですか?画像認識に役立つ技術だと聞いたのですが。

AI専門家
SENetは、正式にはSqueeze-and-Excitation Networksというんだ。画像から取り出した特徴に重みを付けて、認識に役立つ情報を活用しやすくする仕組みを持っているよ。2017年の画像認識の大会でも成果を上げた技術なんだ。
AIの初心者
重みを付けるというのは、猫の写真なら耳や目の場所を選んで見るようなことですか?
AI専門家
SEの仕組みが調整するのは、特徴を表す「チャネル」ごとの重みだよ。猫の輪郭や模様などに反応する特徴を、写真に応じてどれくらい重視するかを学習するんだ。画像の位置を直接選ぶ仕組みとは、区別して考えると理解しやすいよ。
SENetとは、CNNが抽出した特徴チャネルの重要度を、入力画像に応じて調整するネットワークです。中心となるSEブロックは既存の画像認識モデルに組み込める部品で、特徴どうしの関係を使って認識精度の改善を目指します。
「何に注目するか」を学ぶ注意機構の一種ですが、その対象は画像上の場所ではなく、主に特徴の種類に当たるチャネルです。猫の画像を例に、SEブロックの処理、CNN・ResNetとの関係、大会成績の読み方、実際の用途で確かめたい点を順に見ていきましょう。
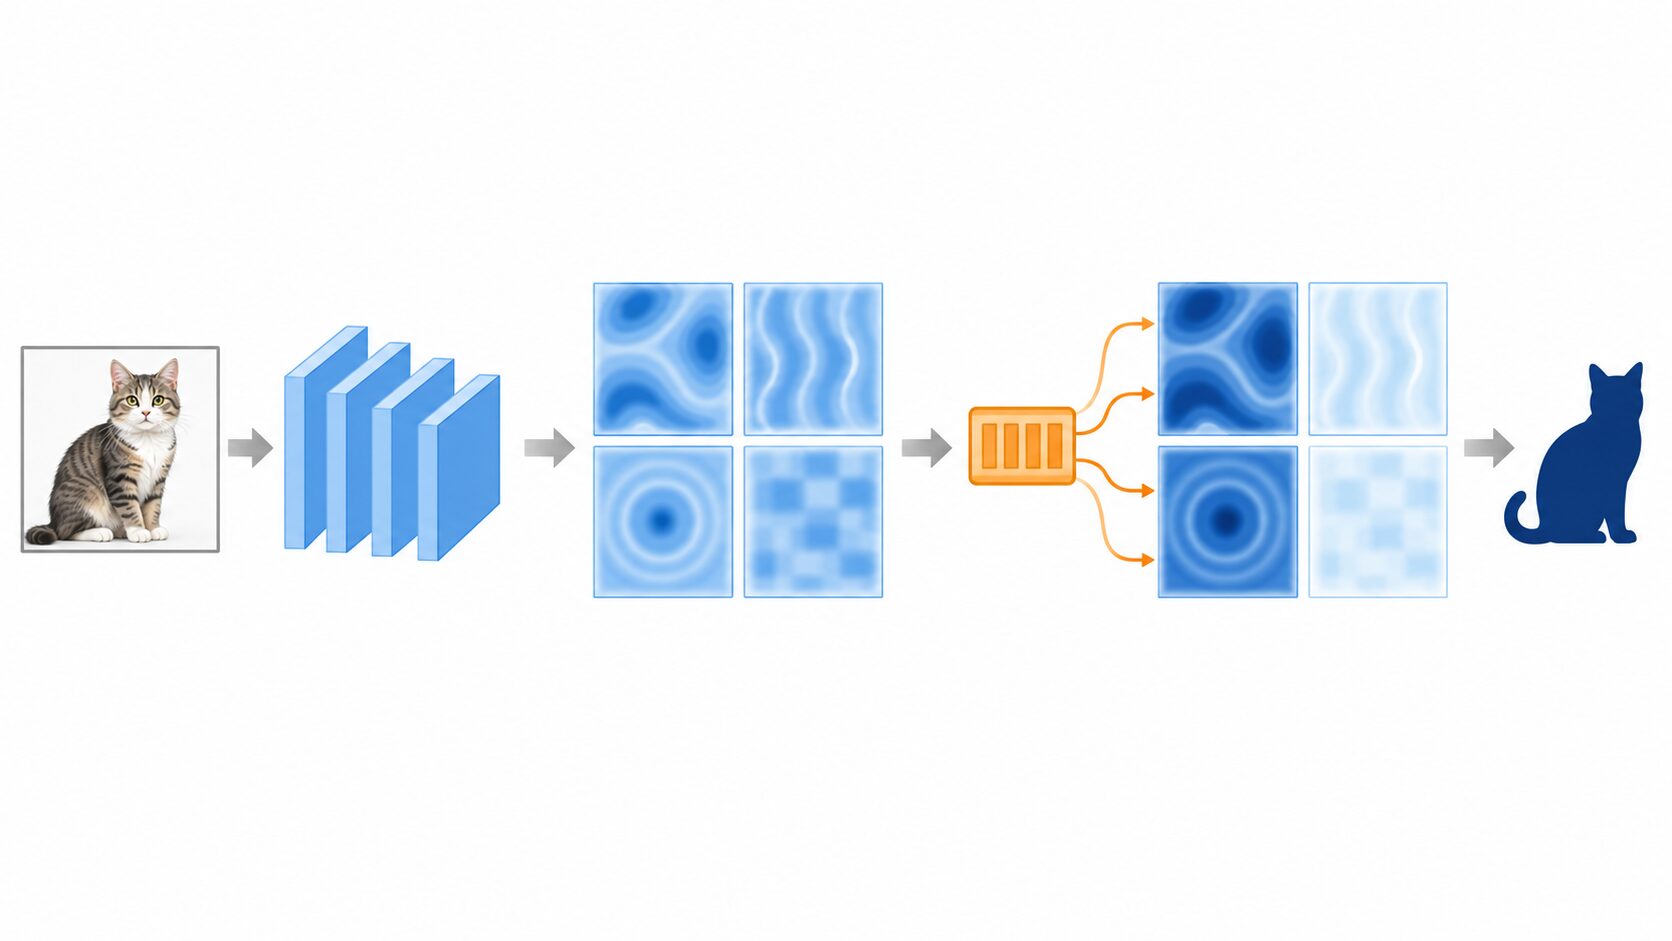
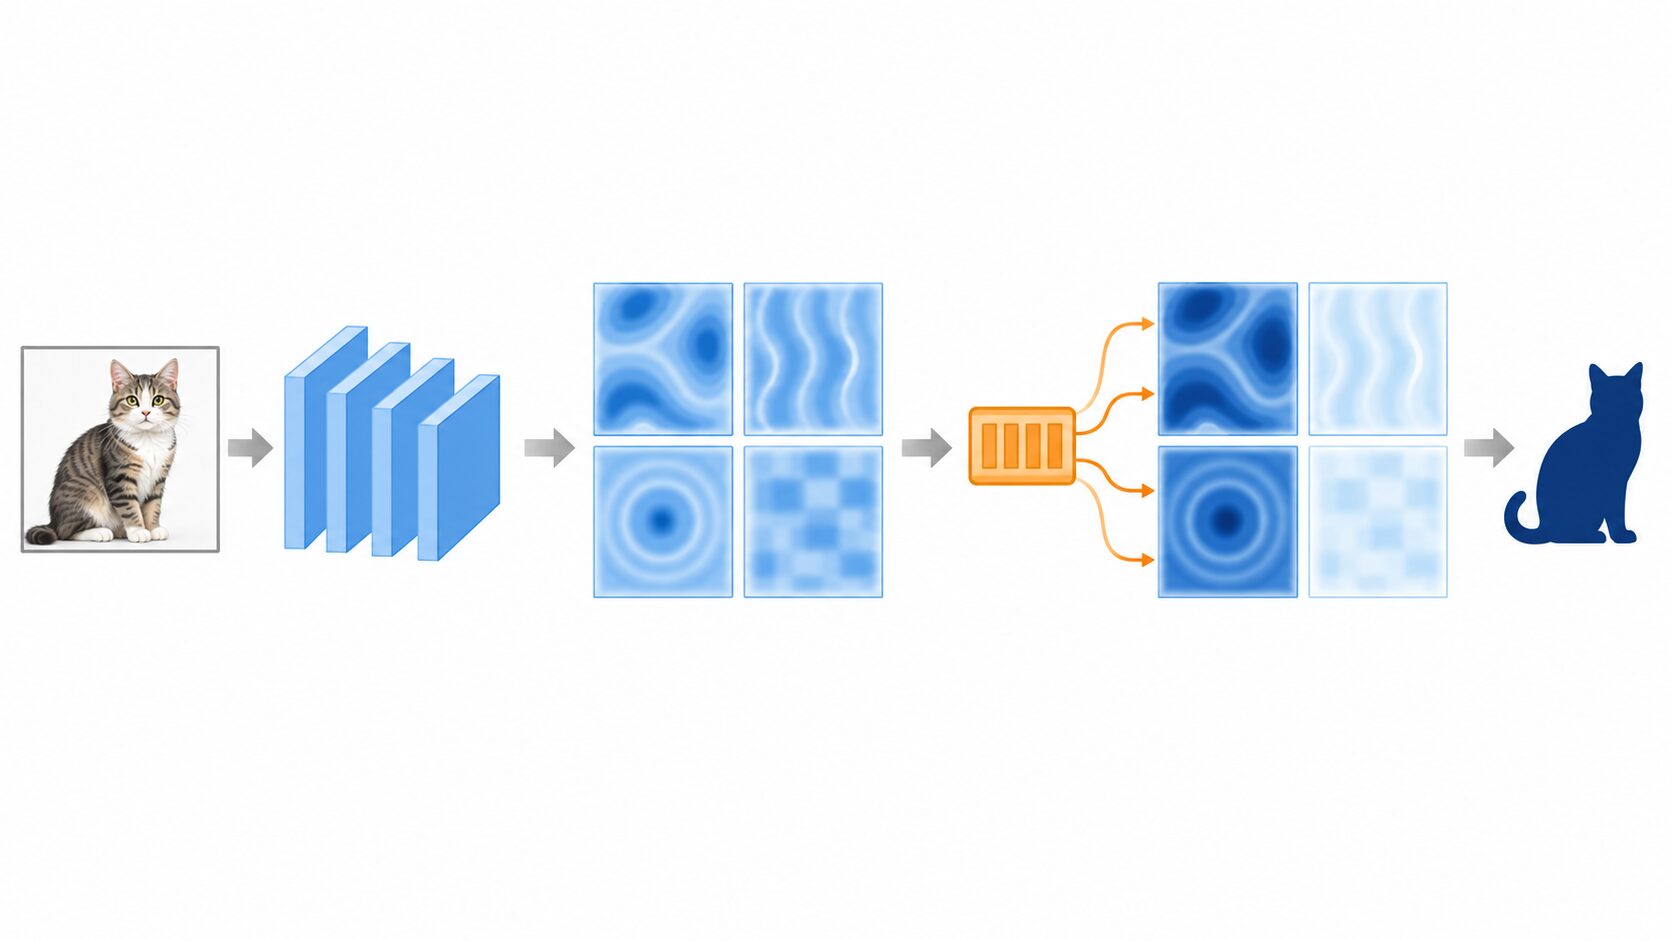
全体の流れは「画像を入力する→特徴を抽出する→SEで特徴の重みを調整する→分類する」です。SEブロックは、認識モデルの途中で特徴の使い方を調整する役割を担います。
SENetとは:特徴チャネルの重要度を調整するネットワーク
SENetの正式名称は、Squeeze-and-Excitation Networksです。Squeezeは特徴の情報を集約する処理、Excitationは集約した情報からチャネルの重みを求める処理を指します。この仕組みをひとまとまりにした部品がSEブロックで、それを組み込んだネットワークがSENetです。部品としてのSEブロックを理解すると、ResNetなどの既存モデルと組み合わせられる理由も見えてきます。
まず、CNN(畳み込みニューラルネットワーク)は、画像にフィルタを適用しながら特徴を抽出するモデルです。浅い層では輪郭や模様などに関係する特徴が、深い層ではそれらを組み合わせた複雑な特徴が学習されます。ある特徴への反応を画像上の位置ごとに数値として並べたものが、特徴マップです。
特徴マップを複数枚重ねたときの、一枚一枚に相当するのがチャネルです。入力カラー画像の赤・緑・青もチャネルですが、CNNの途中で使われるチャネルはRGBだけを意味しません。畳み込みによって学習された、さまざまな特徴の反応を表しています。
猫の写真を考えると、輪郭に関係する反応や毛の模様に関係する反応などが、判断の手がかりになります。ただし、一つのチャネルが必ず「耳」「目」「ひげ」のような部位に対応するわけではありません。特徴の意味は学習によって決まり、人が名前を付けやすいものばかりではないためです。
SEブロックは、複数チャネルの反応をまとめて見て、今回の入力ではどのチャネルを重視するかを計算します。同じ猫でも、横向きか正面向きか、模様がはっきりしているかなどによって特徴の現れ方は変わります。そうした入力ごとの差に応じて特徴のバランスを調整できる点が、SEの特徴です。
SEブロックの仕組み:集約・重みの計算・再調整
1枚の画像について、SEブロックに入る特徴マップの大きさを\(H \times W \times C\)とします。\(H\)は高さ、\(W\)は幅、\(C\)はチャネル数です。処理は、空間方向の集約、チャネルの重みの計算、元の特徴への掛け戻しという3段階で進みます。
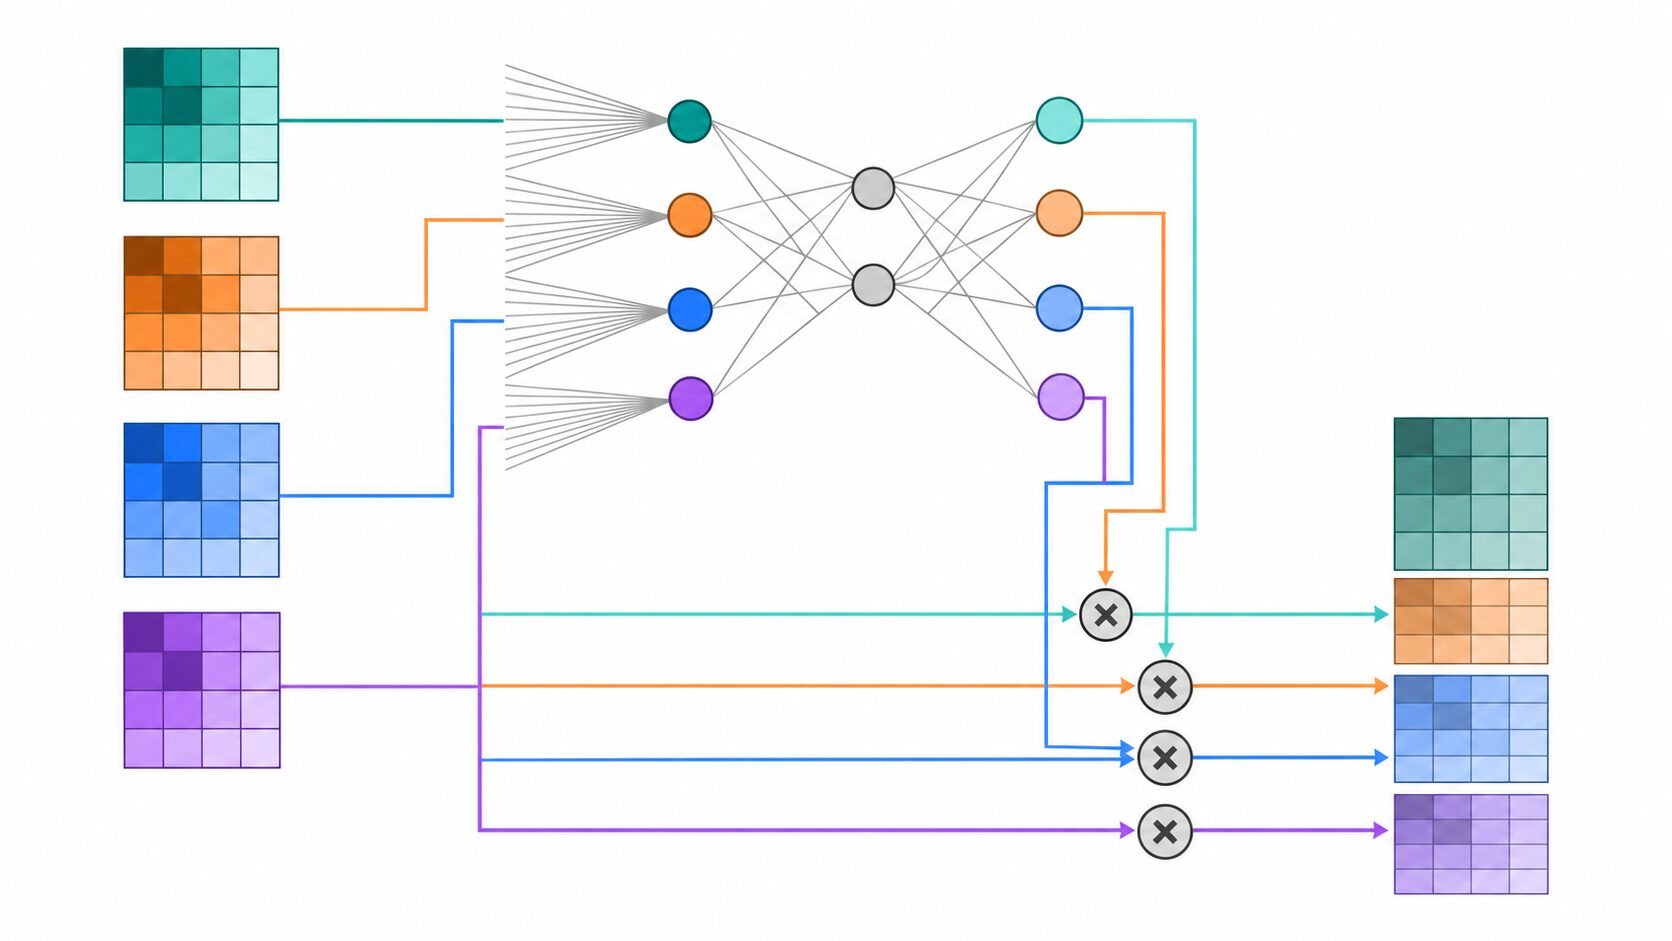
途中では各チャネルを一つの数値で表しますが、元の特徴マップは保持されています。最後に重みを掛けるため、SEブロックの出力も入力と同じ高さ・幅・チャネル数になります。
-
Squeeze:各チャネルの反応を一つの値にまとめる
各チャネルについて、高さと幅の方向に並ぶ値の平均を求めます。これが大域平均プーリング(Global Average Pooling)です。入力を\(U\)、チャネル番号を\(c\)、その平均値を\(z_c\)とすると、次のように表せます。
\(z_c = \frac{1}{HW}\sum_{i=1}^{H}\sum_{j=1}^{W}U_{i,j,c}\)\(i\)と\(j\)は特徴マップ上の位置を示します。数式は「一つのチャネル内の全位置の値を足し、位置の数で割る」という意味です。これを全チャネルで行い、画像全体でどのような反応が出ているかを\(C\)個の値に要約します。平均を取った値だけでは、反応がどの位置にあったかという細かな情報は分かりません。
-
Excitation:チャネル間の関係から重みを求める
集約した値を全結合層に通し、\(C \rightarrow C/r \rightarrow C\)の順に次元を変換します。\(r\)は中間の次元を減らす縮小率です。例えばチャネル数が64、縮小率が16なら、64個の値をいったん4個に変換し、再び64個に戻す構成になります。
最初の全結合層の後にはReLU、二つ目の後にはsigmoidという活性化関数を使います。ReLUは負の値を0にする非線形な処理で、sigmoidは出力を0〜1の範囲に収めます。全結合層で複数チャネルの情報を組み合わせるため、あるチャネルの重みは、そのチャネルの平均値だけで決まるわけではありません。
求められる重みはチャネルごとに一つです。sigmoidの出力には合計を1にする制約がないので、複数のチャネルに同時に大きな重みを付けられます。重みは分類先の確率ではなく、各特徴をどれくらい通すかを調整する値と考えると理解しやすいでしょう。
-
再調整:重みを元の特徴マップに掛ける
チャネル\(c\)の重みを\(s_c\)とすると、そのチャネルの全位置に同じ重みを掛けます。調整後の特徴\(\widetilde{U}\)は、次のようになります。
\(\widetilde{U}_{i,j,c} = s_c U_{i,j,c}\)例えば重みが0.9のチャネルは反応を比較的多く残し、0.2のチャネルは強く抑えます。重みが0〜1なので、掛け算だけで元の特徴値の絶対値を大きくする処理ではありません。「重要な特徴を強調する」とは、主にほかのチャネルに対する相対的な重要度を高めることを意味します。
この重みは入力ごとに計算し直されます。一方、全結合層のパラメータは、CNNのほかの部分と一緒に学習データから更新されます。人が画像ごとに重要なチャネルを指定する必要はなく、分類などの目的に沿って、重みを計算する方法そのものを学習する仕組みです。
CNN・ResNet・空間注意との違いと組み合わせ方
CNNは画像から特徴を抽出し、SEは抽出された特徴のチャネルを再調整します。したがって、SEブロックはCNNの特徴抽出に組み合わせて使う部品です。畳み込みの構造をすべて作り直さなくても追加できる点が、さまざまなモデルへの応用につながっています。
代表的な組み合わせがSE-ResNetです。ResNetでは、処理を行う残差分岐と、入力を先へ渡すショートカットを設け、その結果を加算します。こうした残差接続は、深いネットワークの学習を助けるための構造です。一方、SEが担うのは特徴チャネルの重み付けであり、役割が異なります。
代表的なSE-ResNetでは、残差分岐で畳み込みなどを行った後、その特徴をSEブロックで調整してからショートカット側と加算します。残差接続を保ったまま、加算する特徴のバランスを入力に応じて変える構成です。ほかのCNNにも導入できますが、挿入位置や周囲の層とのつながりは、モデルの設計に合わせて決める必要があります。
| 仕組み | 主な処理対象 | 役割 |
|---|---|---|
| CNNの畳み込み | 画像や特徴マップの局所的な領域 | 周辺の値を組み合わせて特徴を抽出する |
| ResNetの残差接続 | 残差分岐とショートカットの出力 | 情報を加算して先へ伝え、深いモデルの学習を助ける |
| SEによるチャネル注意 | 特徴マップの各チャネル | チャネルごとの重みを計算し、同じチャネル内の全位置に掛ける |
| 空間注意 | 特徴マップ上の各位置 | 位置に応じた重みを使い、注目する領域を調整する |
注意機構はアテンションとも呼ばれます。SEのようなチャネル注意が「どの特徴を重視するか」を調整するのに対し、空間注意は「どの位置を重視するか」を調整します。両者は調整する軸が違うため、組み合わせて使う設計も考えられます。
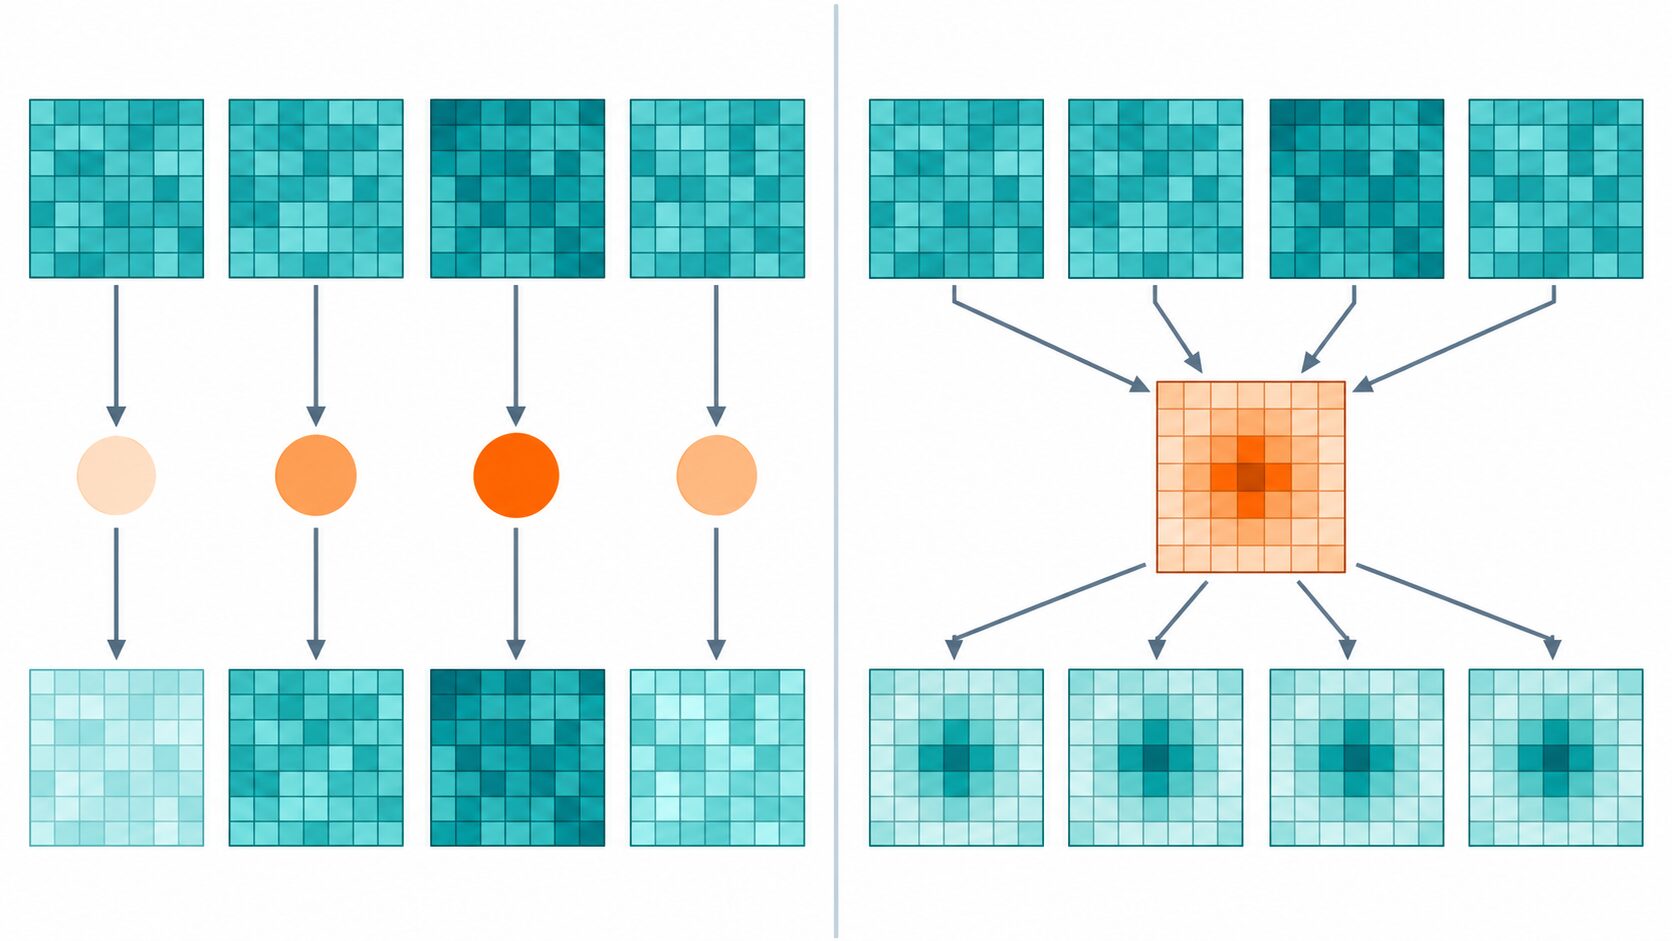
猫の写真で説明する場合も、SEが耳の座標を見つけ、その位置だけに重みを付けると理解すると混乱します。SEは特徴チャネル全体を調整するため、結果として役立つ反応が残ることはあっても、位置ごとの注目度を直接出力しているわけではありません。SEの重みをそのまま画像上のヒートマップとして扱うことはできません。判断に関係する領域を調べたい場合には、位置情報を扱う可視化方法を別途用いる必要があります。
ILSVRC 2017の成果と2.25%の正しい読み方
ILSVRCは、ImageNetのデータを用いて画像分類などの性能を競った大規模な視覚認識の競技です。2017年の画像分類では、SENetを用いた手法が優勝しました。この成果は、ネットワークの深さなどに加えて、特徴チャネルどうしの関係を利用する設計の有効性を示した出来事です。
ここでよく紹介される約2.25%という数値は、大会に提出されたアンサンブルによるtop-5誤り率です。アンサンブルとは、複数モデルの予測を組み合わせる方法です。SEブロックを追加した任意の単一モデルが、同じ数値を達成するという意味ではありません。
top-5誤り率は、モデルが挙げた上位5候補の中に正解が入っていない割合です。例えば正解が猫の画像で、予測の1位が犬、3位が猫なら、top-1では誤りですが、top-5では正解として数えます。
| 指標 | 確認する内容 |
|---|---|
| top-1精度 | 最上位の予測が正解と一致する割合 |
| top-5誤り率 | 正解が上位5候補に含まれない割合 |
つまり、2.25%を「100枚中およそ98枚を、一つの答えで正しく言い当てる」と読み替えることはできません。97.75%という値に言い換える場合も、同じ評価条件で正解が上位5候補に含まれる割合を指します。
また、大会と業務では、画像の種類、分類する対象、撮影条件、評価方法が異なります。大会成績は設計の有効性を示す実績であり、医療画像や工場の検査画像などに対する精度の保証ではありません。SENetの意義は、この記録に加え、チャネル間の関係を学習する比較的組み込みやすい仕組みを示し、その後の注意機構の研究に影響を与えた点にあります。
SENetの活用例:分類から検査・認識支援まで
SENetを理解する基本例は、猫や犬などの画像分類です。画像全体を入力し、CNNで得た特徴をSEブロックで調整した後、どのクラスに当たるかを予測します。似た対象を見分ける課題で、判断に役立つ特徴を使いやすくすることが期待されますが、改善の程度はデータやモデルによって変わります。
分類に加え、物体検出や領域分割のモデルでも、特徴を抽出する部分にSEブロックを組み込むことが考えられます。物体検出は対象の位置と種類を求め、領域分割は画素ごとの領域を求める処理です。SEを加える場合も、位置や領域を出力するための構造は別に必要です。
具体例として、製造業の外観検査を考えます。製品画像をCNNに入力し、表面の模様や形状などに関わる特徴を抽出します。その後、SEブロックでチャネルの重みを調整し、最終的に良品か不良品かを判定する流れです。欠陥に関係する特徴を判定に生かせれば、検査性能の改善につながる可能性があります。
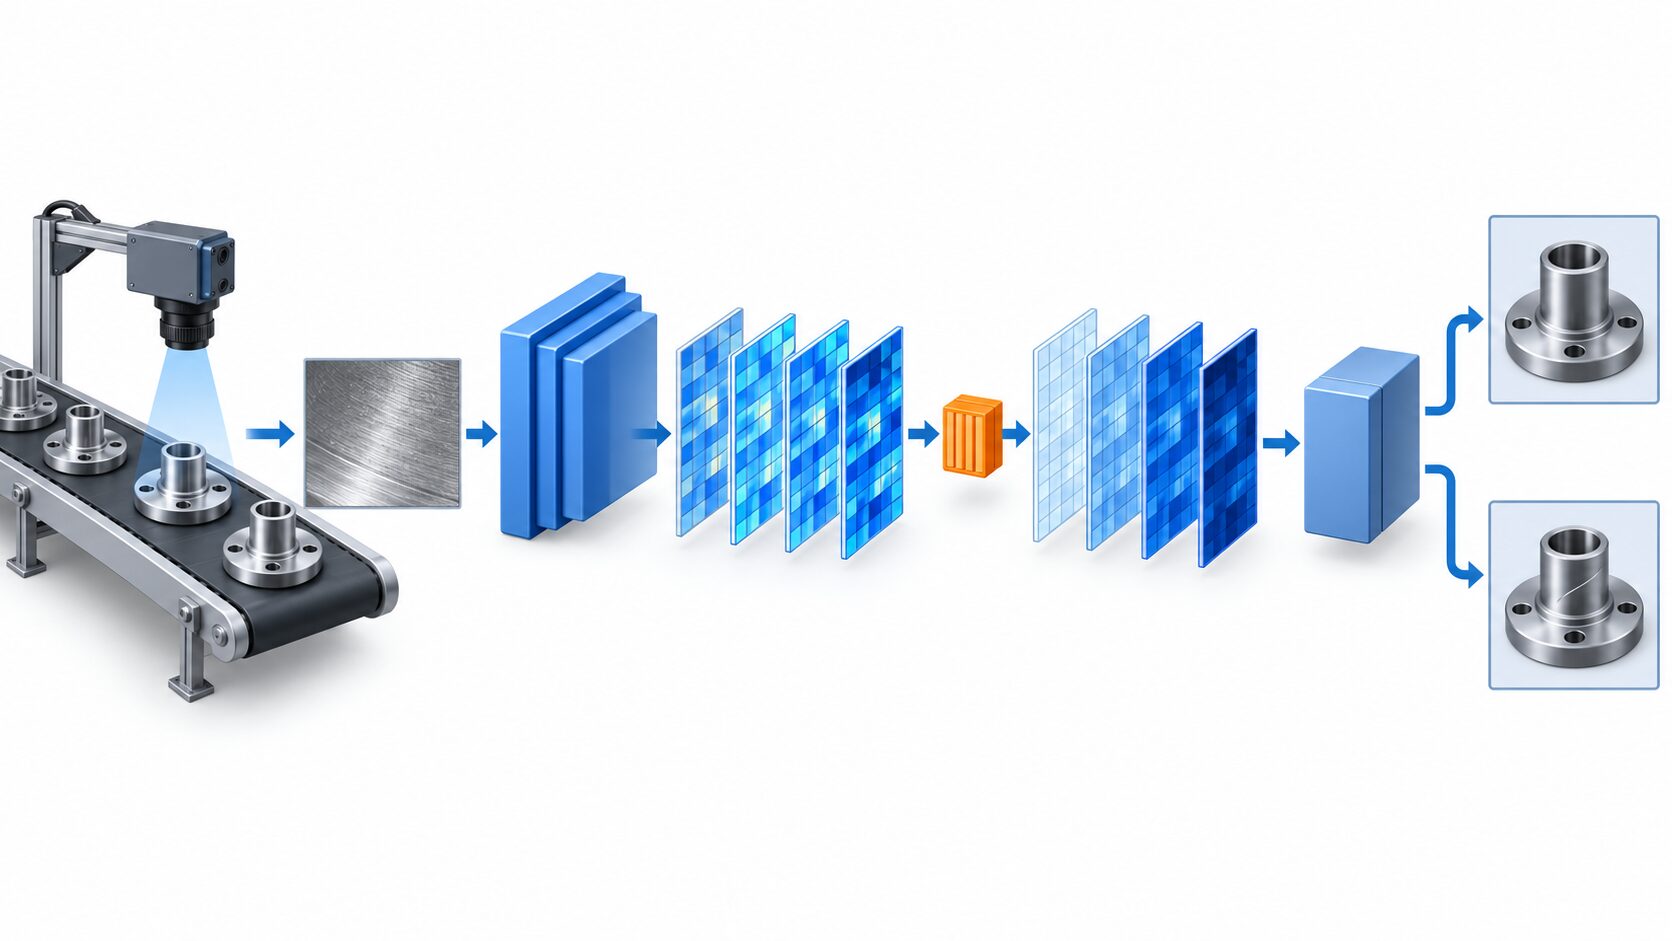
ただし、良否を分類するモデルが、そのまま傷の場所まで示せるわけではありません。「不良品か」を知りたいのか、「どこに、どの程度の傷があるか」も必要なのかによって、分類・検出・領域分割を選びます。SEは、その目的に応じたモデルの中で特徴を調整する部品として位置付けます。
そのほか、画像を手がかりにする次のような分野も用途の候補です。
- 自動運転や運転支援:車両、歩行者、信号などを認識するモデルの特徴抽出部分への組み込み。
- 医療画像:X線、CT、MRIなどの画像解析を支援するモデルでの特徴調整。
- ロボット:周囲の物体や作業対象を識別する視覚処理への応用。
- 防犯・監視:映像内の人や物体を認識し、確認作業を支援するモデルへの応用。
これらはSEを利用できる課題の例であり、各分野での実導入や性能を一律に示すものではありません。例えば自動運転では認識結果に基づく判断や制御も必要で、医療画像では用途に合ったデータでの評価や専門家による確認が必要です。SEの採用だけで、診断の正確さやシステム全体の安全性が保証されるわけではありません。
導入の注意点:精度と計算負荷を条件に合わせて評価する
SEブロックは既存のCNNに追加しやすい一方、集約処理、全結合層、特徴への掛け算が増えるため、パラメータ数や演算量も増えます。元のモデルに対する追加負荷が比較的小さくても、実際の推論時間やメモリへの影響は、端末、チャネル数、挿入する箇所や数によって変わります。
調整項目の一つが、Excitationで中間次元を減らす縮小率です。縮小率を大きくすると中間の次元が小さくなり、全結合層のパラメータ数を抑えやすくなりますが、重みを計算する部分の表現能力にも影響します。小さくした場合も必ず精度が上がるわけではないため、配置と併せて用途に合う設定を探します。
導入効果を確かめるには、SEあり・なしを、同じデータと学習条件で比較することが基本です。入力サイズ、データの分け方、前処理、学習回数などが異なると、改善がSEによるものか判断しにくくなります。評価には学習に使っていないデータを用い、差が小さい場合は学習時のばらつきも考慮します。
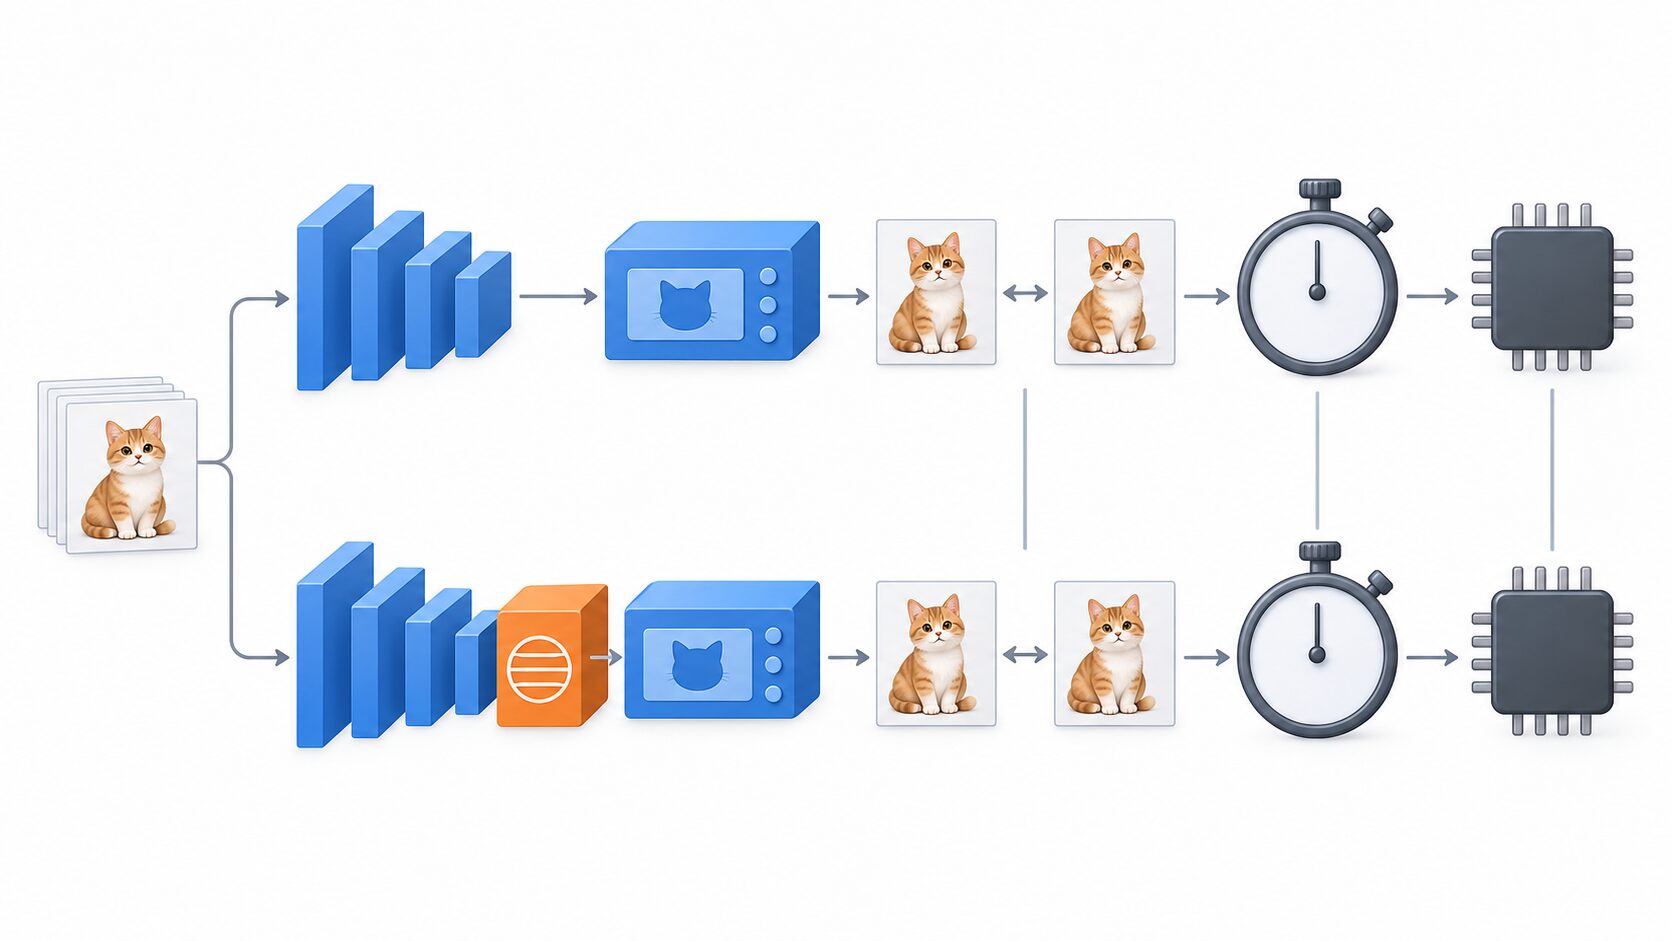
この比較で大切なのは、精度だけで採否を決めないことです。例えば工場の検査では、見逃しが減っても処理が生産ラインの速度に間に合わなければ、その構成をそのまま運用できません。使用する機器と入力条件で測定し、求める品質と速度を両方満たすかを確認します。
| 評価する点 | 確認の例 |
|---|---|
| 認識性能 | 分類精度に加え、クラスごとの誤りや重要な対象の見逃しを確認する |
| 推論時間 | 実際に使う端末と画像サイズで、必要な処理速度を満たすか測る |
| メモリ使用量 | モデルのパラメータだけでなく、推論中の特徴データも含めて確認する |
| 撮影条件への対応 | 照明、背景、カメラ、対象の向きなどが変わった画像でも評価する |
SEを追加しても、データの偏りや背景への依存が自動的になくなるわけではありません。例えば猫の学習画像に特定の背景ばかり写っていれば、背景に関する特徴が予測の手がかりになる可能性があります。SEの重みも学習データをもとに獲得されるため、人が望む特徴を必ず重視するとは限りません。
実務では、実際の撮影条件に近い評価データを用意し、どの画像で間違えるのかまで調べることが重要です。学習を始めたばかりなら、まず同じCNNにSEを加えた場合と加えない場合を比べ、予測結果と処理時間の変化を確認すると、役割を具体的に理解できます。
SENetの中心にある考え方は、特徴を抽出するだけでなく、入力に応じて特徴チャネルの使い方を調整することです。この仕組みと評価指標を押さえておけば、大会成績の意味を正しく捉え、自分の画像認識課題にSEブロックを加える価値があるか検討しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | SEの計算手順と空間注意との差を補い、大会成績の指標を修正 |