学習

不均衡データとは?問題点と対策を初心者向けに解説

機械学習の分野では、扱うデータによっては特定の性質を持つものが含まれる場合があります。その一つに「不均衡データ」と呼ばれるものがあります。これは、データ全体の中で特定の種類のデータが他の種類に比べて極端に少ない状態を指します。 例として、クレジットカードの不正利用を検知するシステムを考えてみましょう。通常、クレジットカードの利用は正規の取引が大多数を占め、不正利用はごく少数です。このようなデータで機械学習モデルを訓練すると、不正利用の検知精度が低くなる可能性があります。なぜなら、モデルは大多数の正規取引データに偏って学習するため、少数派である不正利用の特徴を十分に捉えきれないからです。 具体的には、モデルは「ほとんどの取引は正規である」というパターンを学習してしまいます。その結果、不正利用が発生しても、それを正規の取引と誤って判断してしまう可能性が高まります。これは、不正利用を見逃してしまうという重大な結果につながりかねません。 他にも、医療診断における希少疾患の判別や、製造ラインにおける不良品検出など、様々な分野で不均衡データの問題が発生します。これらのケースでは、少数派のデータこそが重要な意味を持つにもかかわらず、データの偏りのためにモデルが正確な予測をできないという課題が生じます。 このように、不均衡データは機械学習モデルの性能に大きな影響を与えます。そのため、不均衡データに適切な対処を行うことは、機械学習モデルの精度向上、ひいては実社会における様々な問題解決に不可欠です。
セキュリティ

偽ニュースの脅威と対策

偽ニュースとは、真実ではない情報を、まるで本当の出来事のように仕立て上げて伝える、作り話の報道のことです。単なる間違いによる誤報とは違い、わざと人々を騙したり、世の中の意見を操作したりする目的で作られます。その中身は政治的なものから、社会的なもの、経済的なものまで様々です。 例えば、ある政治家に関する事実無根の噂を広めて評判を落とそうとしたり、経済的に不安定な時期に、ある商品が品薄になるとの嘘の情報を流して買い占めを誘発したりするといったケースが考えられます。また、個人の名誉を傷つけたり、社会全体に不安を広げたりする危険性も持っています。ある人物の写真に悪意のある説明を付けて拡散することで、その人の社会生活に大きな影響を与える可能性もありますし、災害時にデマを流すことで人々の混乱を招き、避難行動を妨げるといった事態も起こりえます。 インターネットや携帯電話で情報をやり取りする仕組みが広まったことで、偽ニュースはあっという間に広がり、多くの人々に影響を与えるようになりました。以前は新聞やテレビなど、限られた手段で情報が伝えられていましたが、今では誰もが手軽に情報を発信し、受け取ることができるようになりました。そのため、偽ニュースは以前よりもはるかに速く、広範囲に拡散するようになったのです。このような状況の中で、偽ニュースを見分ける目を養い、正しい情報を選ぶ力は、現代社会を生きる上で非常に大切になっています。情報に振り回されることなく、冷静に情報の内容を吟味し、情報の真偽を確かめる習慣を身につける必要があるのです。
AI活用

OpenAI Five:電脳が挑む複雑なゲーム

今回ご紹介するオープンエーアイファイブが挑んだ対戦型競技は、ドータツーと呼ばれる、多人数で同時に競い合う、リアルタイム戦略型競技です。この競技は、五対五のチーム戦で行われ、各競技者はそれぞれ異なる特徴を持つ英雄と呼ばれる操作役を操り、相手チームの本拠地を破壊することを目指します。ドータツーの大きな特徴は、操作可能な英雄の種類が非常に多く、それぞれが独自の技や能力を持っている点です。剣を振るう者、魔法を使う者、回復を得意とする者など、多種多様な英雄が存在し、その数は百種類を超えます。どの英雄を選ぶかによって、チームの戦略も大きく変わってくるのです。また、競技中は常に状況が変化するため、適切な道具を選び、戦略を組み立てていく必要があります。例えば、攻撃力を高める道具、防御力を上げる道具、移動速度を上げる道具など、様々な道具が存在します。状況に応じて最適な道具を選択することは、勝利への鍵となるでしょう。刻一刻と変化する戦況において、競技者は瞬間的な判断力と、長期的な戦略を組み立てる能力が求められます。相手の行動を予測し、味方との連携を図りながら、勝利を目指すには、高度な思考力と状況判断能力、そしてチームワークが不可欠です。このように、ドータツーは非常に複雑で奥深い競技であり、世界中で多くの競技者や観戦者を魅了しています。まさに、戦略と戦術、そしてチームワークの極致と言えるでしょう。
アルゴリズム

勾配ブースティング:機械学習の進化

機械学習とは、計算機に学習能力を与えることで、人間のようにデータからパターンや法則を見つけ出す技術のことです。この技術は、様々な分野で活用されており、今後の発展が大きく期待されています。その中でも、予測の正確さを高めるための様々な方法が研究開発されています。多くの手法の中でも、勾配ブースティングは近年注目されている強力な予測手法です。 勾配ブースティングは、複数の単純な予測モデルを段階的に組み合わせることで、複雑なデータの規則性を捉え、高い精度で予測を行います。それぞれの単純なモデルは単独では精度は高くありませんが、これらのモデルを改良しながら重ね合わせることで、全体としての予測能力が向上していきます。これは、過去の誤りを次のモデルで修正していくという考え方によるものです。 勾配ブースティングの大きな特徴の一つは、様々な種類のデータに対応できる汎用性の高さです。画像、音声、文章など、様々なデータ形式に対応できるため、幅広い分野で活用されています。例えば、医療分野では病気の診断支援に、金融分野では融資の審査に、マーケティング分野では顧客の行動予測に利用されるなど、その応用範囲は多岐にわたります。 勾配ブースティングは、高い予測精度と汎用性から、多くの場面で有効な手法です。しかし、モデルが複雑になりやすく、計算に時間がかかる場合もあるため、適切な調整が必要となります。今後の研究開発により、より効率的で解釈しやすい勾配ブースティングの手法が開発されることが期待されています。これにより、様々な分野での更なる活用が見込まれます。
AI活用

表面処理後の外観検査の重要性

製品の検査は、製品が市場に出る前の最終段階における重要な工程です。特に、表面処理を終えた後の外観検査は、製品の品質保証に直結するため、非常に重要視されています。 顧客にとって、製品の表面は最初に目にする部分であり、その第一印象は製品全体の評価を大きく左右します。たとえ製品の機能に問題がなくても、微細な傷や汚れ、異物が付着しているだけで、顧客は品質に疑問を抱き、購入をためらう可能性があります。つまり、外観の良し悪しは、顧客の購買意欲に直接影響を与えるのです。表面の仕上がりは、製品の価値を左右する重要な要素と言えるでしょう。 外観検査の目的は、単に表面の傷や汚れをチェックするだけではありません。顧客満足度を維持し、企業のブランドイメージを守ることも重要な目的の一つです。高品質な製品を提供することで、顧客の信頼を獲得し、長く愛される製品づくりに繋がります。また、不良品の出荷を防ぐことで、企業の信用を守り、ブランドイメージの低下を防ぐことにも繋がります。 熟練した検査員による検査は、高品質な製品を提供するための要です。長年の経験で培われた鋭い観察眼と、微細な欠陥も見逃さない高度な技術は、機械による自動検査では代替できない重要な役割を担っています。検査員は、厳しい基準に基づいて製品一つ一つを丁寧に検査し、合格基準に満たない製品を排除することで、顧客に安心して使用してもらえる製品を提供することに貢献しています。 人の目による検査は、製品の品質保証における最後の砦と言えるでしょう。
セキュリティ

設計段階からのプライバシー保護

「埋め込み型個人情報保護」とは、仕組みやサービスを設計する最初の段階から、個人の情報保護を念頭に置いて作り込んでいく考え方のことです。これは1990年代に初めて提唱され、近年、個人の情報保護の大切さが増すにつれて、多くの人々が関心を寄せています。 従来の個人情報保護の対策は、仕組みを作り終えた後に、付け足しのように行われることがほとんどでした。しかし、このようなやり方では、設計の段階で考えられていなかった情報保護上の危険にきちんと対応できない、あるいは対応に莫大な費用がかかってしまうといった問題がありました。 「埋め込み型個人情報保護」は、まさにこれらの問題を解決するために考え出されました。開発の初期段階から情報保護について深く考えることで、より効果的で無駄のない情報保護を実現しようとするものです。 仕組みやサービスが個人の情報を取り扱う場合、設計の段階から情報保護への影響をしっかりと見極め、必要な対策を組み込んでおくことが重要です。そうすることで、後から修正したり、費用を追加したりする手間を省き、より強固な情報保護を実現できます。 たとえば、新しい会員制の買い物サイトを作る場合を考えてみましょう。従来の方法では、サイトが完成した後で、個人情報の暗号化やアクセス制限といった対策を追加していました。しかし、「埋め込み型個人情報保護」では、サイト設計の最初の段階から、どのような個人情報を集めるか、どのように保管するか、誰がアクセスできるかなどを綿密に計画します。会員登録の入力項目を必要最小限にする、個人情報の保管場所を安全な場所に設定する、アクセス権限を適切に設定するといった対策を、最初から組み込んでいくのです。 このように、最初から情報保護を設計に組み込むことで、後から問題が発生するのを防ぎ、利用者の信頼を得ることができます。また、開発費用や運用費用を抑えることにもつながります。「埋め込み型個人情報保護」は、これからの情報化社会において、ますます重要になっていく考え方と言えるでしょう。
動画生成

ディープフェイクとは?仕組み・見分け方・危険性をわかりやすく解説

近ごろ、人工知能の技術がめざましく進歩し、今までに考えられなかったような新しい技術が次々と生まれています。中でも、大きな注目を集めている技術の一つが「ディープフェイク」です。ディープフェイクは、人工知能の高度な技術を駆使して、まるで現実にあるかのような、偽の動画や音声、画像などを作る技術です。 ディープフェイクは、人の顔を別人の顔に違和感なく合成したり、実際には言っていない言葉を話しているかのように見せかけることができます。この技術によって、まるで本物と見分けがつかないほど精巧な偽物が作れるようになり、娯楽の世界などでの活用が期待されています。例えば、映画の制作過程で俳優の替え玉を必要とする場面や、亡くなった俳優をデジタルで復活させるといった場面での活用が考えられます。また、教育の分野でも、歴史上の人物を現代によみがえらせて講義をさせるなど、様々な可能性を秘めていると言えるでしょう。 しかし、その一方で、悪用される危険性も指摘されています。ディープフェイクを用いて偽の情報を流布したり、個人の名誉を傷つけたりするなどの犯罪行為がすでに発生しています。また、政治的なプロパガンダに利用されたり、社会不安を引き起こしたりする可能性も懸念されています。ディープフェイクは使い方次第で大きな影響力を持つため、その倫理的な側面についても深く議論する必要があります。今後、ディープフェイク技術はさらに進化していくと予想され、より高度な偽物が出現する可能性があります。そのため、私たち一人一人もディープフェイクに対する正しい知識を持ち、情報を見極める力を養っていく必要があると言えるでしょう。
アルゴリズム

画像を縮小するプーリングの仕組み

画像を扱う時、情報の量がとても多くて大変なことがあります。そのような時に役立つのが縮小処理です。この縮小処理のことをプーリングと言い、画像の大きさを小さくすることで、扱う情報量を減らし、処理を速くすることができます。 プーリングは、決められたやり方に従って元の画像から情報を抜き出し、小さな画像を作ります。例えば、2×2の正方形の範囲を見て、その範囲の中で一番大きい値だけを抜き出す方法があります。これを最大値プーリングと言います。他にも、範囲内の値の平均値を計算する平均値プーリングなど、色々なやり方があります。 プーリングには、単に画像を小さくするだけでなく、画像のずれや小さな変化を吸収する働きもあります。例えば、手書きの数字を認識する場面を考えてみましょう。同じ数字でも、書く人や書き方によって、線の太さや位置が微妙に変わることがあります。プーリングを使うと、このような小さな違いを無視して、数字の特徴を捉えやすくなります。 プーリングは、畳み込みニューラルネットワークという、画像認識によく使われる技術の重要な部分です。この技術は、人の目と同じように、画像の中から重要な特徴を見つけて、画像に何が写っているかを判断します。プーリングはこの中で、画像の特徴をより強くし、処理を効率化する役割を担っています。そのため、物の見分けや位置の特定といった作業で高い性能を発揮するのに役立っています。
AIサービス

表情で感情を読み取るAIとは?仕組み・活用例・限界を解説

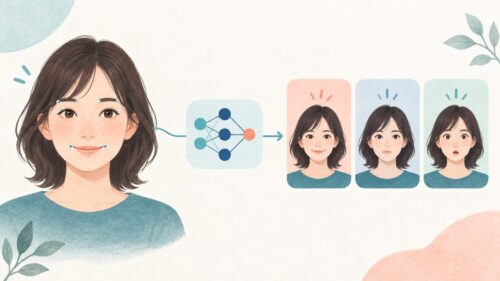
近年、機械による知能の技術革新は目覚しく、様々な場所で活用されています。中でも、人の表情から気持ちを読み取る『表情の気持ち認識機械』は、私たちの暮らしに大きな変化をもたらす可能性を秘めています。この技術は、どのように実現されているのでしょうか。 私たちは、相手の表情を見て、その人がどんな気持ちなのかを理解します。例えば、口角が上がっていれば嬉しい、眉間にしわが寄っていれば怒っている、といった具合です。この時、私たちは無意識のうちに、相手の顔の筋肉の動きや、目線、瞳の大きさといった、ごくわずかな変化を読み取っています。表情の気持ち認識機械も、これと同じ仕組みで人の気持ちを読み取ります。 具体的には、カメラで撮影した人の顔の画像を解析し、目や口、眉などの位置や形状を特定します。そして、これらの情報をもとに、喜び、悲しみ、怒り、驚き、恐怖といった様々な感情を判別します。まるで私たちが日々行っている表情の読み取りを、機械が代行してくれるかのようです。 この技術は、様々な場面で活用されることが期待されています。例えば、接客業では、顧客の表情から満足度を測り、より良いサービスを提供することに役立ちます。また、教育の場では、生徒の表情から理解度や集中度を把握し、学習指導に活かすことができます。さらに、自動車の運転支援システムに搭載すれば、運転手の眠気や注意散漫を検知し、事故を未防ぐことも可能になります。 このように、表情の気持ち認識機械は、人と人との意思疎通をより円滑にするだけでなく、様々なサービスの向上に繋がる技術として、今後ますますの発展が期待されています。
セキュリティ

AIを欺く攻撃:敵対的攻撃とは?

私たちの暮らしの中に、まるで空気のように溶け込み始めた人工知能。自動車の自動運転や病気の診断など、様々な場面で活躍しています。しかし、便利な道具であると同時に、思いもよらない危険性も潜んでいるのです。その危険性のひとつが「敵対的な攻撃」です。これは、人工知能の判断能力を狂わせ、間違った動作をさせる悪意のある攻撃です。 人工知能は、大量の情報から学び、見つけた規則性を使って判断します。敵対的な攻撃は、この学習方法や規則性を見つける能力の弱点を突いてきます。例えば、画像を見分ける人工知能の場合を考えてみましょう。私たち人間には全くわからない程度の、ごく小さなノイズを画像に混ぜると、人工知能が全く違うものだと勘違いしてしまうことがあります。これは、自動運転システムで考えると、標識を間違えて認識し、事故につながる危険性があります。 もう少し具体的に説明すると、停止の標識に、人間には見えない模様を貼ることで、人工知能がそれを制限速度の標識だと誤認識してしまうのです。この結果、車は停止せずに進んでしまい、事故につながる可能性があります。また、医療診断の画像にノイズを混ぜることで、人工知能が病気を誤診する危険性も考えられます。このように敵対的な攻撃は、私たちの安全を脅かす可能性があるのです。 敵対的な攻撃は、人工知能の信頼性と安全性を揺るがす重大な問題です。そのため、人工知能を守るための対策が急がれています。人工知能の学習方法を改良したり、敵対的な攻撃を検知する技術を開発したりするなど、様々な対策が研究されています。人工知能が安全に使えるように、対策をより一層強化していく必要があるでしょう。
アルゴリズム

バギングとランダムフォレストとは?意味・仕組み・活用例をわかりやすく解説

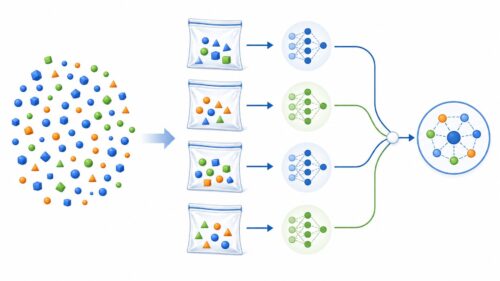
複数の予測模型を組み合わせて、より精度の高い予測を行う手法のことを、集団学習と言います。この集団学習の中でも、よく知られている手法の一つに「バギング」があります。バギングは、様々なデータの偏りに対応できる、より汎用的な予測模型を作ることを目指す手法です。 バギングの仕組みは、まず複製を許しながら、元の学習データからランダムにデータを取り出して、複数の学習データの組を作ることから始まります。この手法は「ブートストラップ標本抽出法」と呼ばれています。元の学習データと同じ大きさのデータの組を複数作って、それぞれの組で予測模型を学習させます。それぞれの学習データの組は、元の学習データの一部を重複して含む一方で、一部のデータを含まないため、一つ一つが微妙に異なるものになります。 こうして学習させた複数の予測模型を使って、新しいデータに対して予測を行う場合、それぞれの模型が個別に予測を行い、その結果をまとめて最終的な予測結果を出します。例えば、分類問題では、多数決によって最終的な予測結果を決定します。つまり、多くの予測模型が「A」と予測したなら、最終的な予測結果も「A」とする、といった具合です。回帰問題では、各模型の予測値の平均値を最終的な予測値とすることが多いです。 このように、複数の予測模型の結果を組み合わせることで、一つの模型だけでは捉えきれないデータの特性を反映した、より正確で安定した予測が可能になります。また、ブートストラップ標本抽出法を用いることで、学習データの特定の傾向に過剰に適応してしまうことを防ぎ、より汎用的な予測模型を作ることができるのです。
セキュリティ

信頼できるデータを実現する技術

現代社会において、データは宝のような存在であり、様々な決定を下す上での土台となっています。しかし、そのデータの質が常に確かなものであるとは限りません。データの信頼性を揺るがす様々な課題が存在し、それらを理解し対処することが重要です。 まず、データには不要な情報、いわゆる雑音が混入している場合があります。これはデータの精度を低下させ、本来の姿を歪めてしまう可能性があります。また、データがある特定の方向に偏っている、いわゆる偏りも問題となります。偏りのあるデータに基づいて分析を行うと、現実とは異なる結論が導き出される可能性があります。 さらに、人為的なミスによって誤ったデータが入力されることもあります。入力担当者の不注意や疲れ、あるいは入力システムの不具合など、様々な要因が考えられます。このような誤入力はデータの信頼性を大きく損ないます。また、悪意を持った第三者によるデータの改ざんも無視できません。データの改ざんは、意図的に誤った情報に基づいた判断を引き起こし、大きな損害をもたらす可能性があります。 これらの雑音、偏り、誤入力、改ざんなどの問題は、データの信頼性を揺るがし、誤った解釈や判断につながる重大なリスクとなります。データに基づいた意思決定がますます重要性を増している現代において、データの信頼性を確保することは喫緊の課題です。そのためには、データの収集、入力、加工、分析といった全ての過程において、厳格な品質管理を行う必要があります。また、データの正確性を常に確認し、問題があれば速やかに修正する体制を構築することも重要です。そして、データの安全性を確保するための対策も不可欠です。不正アクセスや改ざんのリスクを最小限にするために、適切なセキュリティ対策を講じる必要があります。
AIサービス

動画広告BGM自動生成ツール:Odd-AISound

近ごろのインターネット販売促進活動において、動画を使った広告は、なくてはならないものになってきています。人々の目を引きつける動画広告を作るには、美しい映像だけでなく、背景に流れる音楽も大切です。心に響く音楽を使うことで、動画の伝えたい思いをより強く届けることができます。 そこで、株式会社セプテーニと株式会社Soundrawは協力して、「Odd-AISound」という新しい道具を開発しました。これは、人工知能を使って動画広告にぴったりの音楽を自動で作ってくれるすぐれものです。動画の内容や売りたい物の特徴を分析し、広告効果を高める音楽を作り出します。 これまで、広告に使う音楽を選ぶのは大変な作業でした。時間もお金もかかっていました。「Odd-AISound」を使えば、そのような手間や費用を減らし、もっと手軽に動画広告を作ることができます。例えば、落ち着いた雰囲気の音楽で商品を上品に見せたり、明るい音楽で楽しい印象を与えたり、様々な工夫が可能です。 動画の長さに合わせて音楽の長さを調整することもできますし、色々な楽器の音色を組み合わせることもできます。さらに、季節や流行に合わせて音楽の雰囲気を変えることもできるので、常に新鮮な動画広告を作ることができます。この技術によって、動画制作者は音楽選びに悩まず、より質の高い動画制作に集中できるようになります。 「Odd-AISound」は、これからの動画広告制作に大きな変化をもたらすでしょう。手軽に効果的な音楽を使えるようになることで、もっと多くの人が動画広告を活用し、消費者を惹きつける魅力的な動画が増えていくと期待されます。
学習

表現学習とは?意味・仕組み・活用例を初心者向けに解説

表現学習とは、データの中に隠された本質的な特徴を機械学習の手法を用いて自動的に抽出する技術のことです。従来の機械学習では、例えば猫を認識させるためには、人間が「耳の形」「目の色」「ひげ」といった特徴を一つ一つ定義し、それをコンピュータに教える必要がありました。これは、まるで子供に猫の絵を見せて、「これが耳だよ」「これが目だよ」と説明するようなものです。 しかし、表現学習では、大量のデータを与えるだけで、コンピュータが自ら重要な特徴を学習します。多くの猫の画像を見せることで、コンピュータは猫の特徴を自然と理解していくのです。これは、子供が多くの猫と触れ合うことで、猫とはどんなものかを自然に理解していく過程に似ています。人間が特徴を定義する必要がないため、従来の方法では捉えきれなかった複雑な特徴や関係性を捉えることができます。例えば、猫の様々なポーズや毛並み、表情など、人間が全てを定義するのは困難な特徴も、表現学習では自動的に学習することが可能です。 この自動的な特徴抽出は、データの背後に潜む複雑な構造や規則性を明らかにする上で非常に重要です。そして、この表現学習で得られた特徴は、画像認識だけでなく、自然言語処理や音声認識など、様々な分野で活用されています。例えば、文章の意味理解や音声の感情分析など、従来の手法では難しかった高度なタスクの精度向上に大きく貢献しています。表現学習の発展により、機械学習はより人間の認知能力に近い処理を実現しつつあります。
セキュリティ

十分性認定:データ越境の近道

昨今、個人の大切な情報の保護は、世界規模で関心が高まっています。国境を越えた情報のやり取りが日常茶飯事となった現代社会において、適切な保護の仕組みはなくてはならないものです。保護が不十分な国に情報を送ることは、大きな危険をはらんでいます。こうした背景から、ヨーロッパ連合(EU)は、個人情報の保護に関するしくみとして、一般データ保護規則(GDPR)を定めました。 このGDPRは、EU域内での個人情報の扱いに関する広範囲にわたる規則であり、世界でも最も厳しい個人情報保護の法律の一つとして認識されています。GDPRは、EU域内から域外への個人情報の移動についても厳しいルールを設けており、情報の行き先となる国がEUと同程度の保護の水準を満たしていない場合には、特別な対応が必要となります。たとえば、特別な契約を結ぶ、EUが承認した標準契約条項を採用する、拘束的企業準則を整備するといった対策が求められます。これらの対策を怠ると、高額な制裁金が科される可能性があります。 GDPRのしくみの中で、重要な役割を担うのが「十分性認定」です。これは、EU域外の国がEUと同等の個人情報保護の水準を満たしているとEUが判断した場合に与えられるものです。十分性認定を受けた国に対しては、EU域内から特別な手続きなしで個人情報を送ることが認められます。これは、企業にとって管理の手間やコストを削減できるという大きなメリットがあります。 つまり、十分性認定は、個人情報の保護と国際的なデータ流通のバランスを保つための重要な鍵となっているのです。認定を受けるためには、その国の法律や制度、監督機関の独立性、権利救済の手段など、様々な要素が総合的に評価されます。この認定を受けることは、その国が個人情報保護において国際的な信頼を得ている証と言えるでしょう。
セキュリティ

ブルートフォースとは?総当たりの仕組み・攻撃手法・対策をわかりやすく解説

「あらゆる可能性を試す」とは、まさにその言葉の通り、問題を解くために考えられる全ての選択肢を一つずつ検証していく方法です。これは「力任せ探索」とも呼ばれ、例えるなら、暗証番号を忘れてしまった金庫を開ける際に、0000から9999まで全ての数字の組み合わせを順番に試していくようなものです。この方法は、一見非効率的に思えるかもしれませんが、複雑な理論や専門的な知識を必要としないため、誰でも簡単に実行できるという利点があります。まるで迷路の中で、全ての道を一つずつ進んでいくようなイメージです。行き止まりに突き当たったら、戻って別の道を試す。これを繰り返すことで、最終的には必ず出口にたどり着くことができます。 具体的な例として、数独を考えてみましょう。数独は、空いているマスに1から9までの数字を適切に配置していくパズルです。力任せ探索を使うなら、空いているマス全てに、順番に数字を入れていき、ルールに合っているかを確認します。合わない場合は、数字を変えてまた確認する、という作業を繰り返します。この方法を使えば、最終的には必ず正解にたどり着くことができますが、非常に時間がかかる可能性があります。また、コンピューターを使ったパスワード解読も、この方法の応用と言えるでしょう。設定可能な文字の種類と文字数を元に、考えられる全てのパスワードの組み合わせを生成し、一つずつ試していくことで、いつかは正しいパスワードにたどり着くことができます。 力任せ探索の最大の弱点は、問題の規模が大きくなると、探索に必要な時間と計算資源が爆発的に増大してしまうことです。例えば、パスワードに使える文字の種類が多かったり、パスワードの文字数が長かったりすると、組み合わせの数が膨大になり、現実的な時間内での解読は不可能になります。そのため、この方法は、比較的小規模な問題、あるいは他の解決策が見つからない場合の最終手段として用いられることが多いです。
アルゴリズム

標準偏差とは?意味・仕組み・活用例をわかりやすく解説

標準偏差とは、数値データのばらつき具合、つまり散らばり具合を表す指標です。平均値だけではデータの全体像を掴むことができません。例えば、ある学校の算数のテストで、A組とB組の平均点がどちらも70点だったとします。しかし、A組は全員が70点付近の点数を取っていたのに対し、B組は30点の人もいれば100点の人もいるなど、点数のばらつきが大きかったとしましょう。このような場合、平均点は同じでも、二つの組のテスト結果には大きな違いがあります。標準偏差は、まさにこの違いを数値化してくれるのです。 標準偏差は、個々のデータが平均値からどれくらい離れているかを平均的に示しています。計算方法は、まず各データと平均値の差を二乗します。これは、平均値からの離れ具合を強調するためです。次に、それらの二乗した値の平均を求めます。最後に、その値の平方根を計算することで標準偏差が得られます。平方根をとる理由は、二乗した値を元のスケールに戻すためです。 標準偏差が小さいということは、データが平均値の近くに集まっていることを意味します。例えば、工場で生産されるネジの長さを測った結果、標準偏差が小さければ、どのネジもほぼ同じ長さで生産されていると判断できます。これは、製品の品質が安定していることを示しています。逆に、標準偏差が大きい場合は、データが平均値から大きく散らばっていることを意味します。先ほどのネジの例で言えば、標準偏差が大きい場合は、ネジの長さにばらつきがあり、品質が安定していない可能性があります。 このように、標準偏差はデータのばらつき具合を数値化することで、データの性質をより深く理解するのに役立ちます。この指標は、品質管理や金融、医療など、様々な分野で活用されています。例えば、金融では投資のリスクを評価する際に、医療では検査データの分析などに用いられています。
学習

アンサンブル学習:多数の力で予測精度を高める

いくつもの予測模型を組み合わせ、全体として精度の高い予測を可能にする手法があります。これは、複数の専門家に意見を求め、それぞれの見解をまとめ上げて最終的な結論を出す過程に似ています。それぞれの専門家は得意分野や不得意分野、知識のばらつきなどがあるでしょう。しかし、複数の専門家の意見を総合的に判断することで、より確実で信頼できる答えに近づく可能性が高まります。 この手法は「集団学習」と呼ばれ、様々な予測模型から得られた結果を組み合わせることで、単一の模型では到達できない高い精度を実現します。これは、個々の模型の短所を補い、長所を活かす効果があるためです。例えるなら、「三人寄れば文殊の知恵」のようです。多くの場合、最終的な予測は多数決や平均値を取ることで決定されます。 集団学習には大きく分けて二つの種類があります。一つは、同じ種類の予測模型を複数組み合わせる方法です。これは、同じ種類の専門家を複数人集めるようなものです。それぞれの専門家の経験や知識には多少の違いがあるので、複数の意見を聞くことでより正確な判断ができます。もう一つは、異なる種類の予測模型を複数組み合わせる方法です。これは、様々な分野の専門家を集めて意見を聞くようなものです。それぞれの専門家が異なる視点から問題を捉えるため、より多角的な分析が可能になり、より精度の高い予測に繋がります。 このように、集団学習は複数の予測模型の力を組み合わせることで、単一の模型よりも高い精度と安定性を実現します。これは、様々な分野で活用され、より正確な予測に基づいた意思決定を支援しています。まさに、集合知を活用した予測手法と言えるでしょう。
アルゴリズム

標準化とは?データ分析で使う意味・計算方法・正規化との違いを解説

情報をきちんと整えることは、たくさんの情報を扱う上でとても大切な作業です。この作業の一つに標準化というものがあります。標準化は、様々な種類の情報を同じように扱えるようにするための工夫です。 例えば、色々な人の体の大きさを比べるとします。ある人は身長で測り、別の人は体重で測っていては、比べようがありません。標準化は、このようなバラバラな情報を同じ尺度に変換する作業に似ています。 データ分析では、年齢や収入など、様々な種類の情報を扱います。これらの情報は、それぞれ数値の範囲や単位が異なります。例えば、年齢は0歳から100歳くらいまで、収入は数百万円から数億円までと、大きな差があります。このようなデータをそのまま分析に使うと、数値の大きい情報の影響が強くなりすぎて、小さい情報の影響が見えにくくなってしまうことがあります。収入の大きな変動に隠れて、年齢による変化が分かりにくくなる、といった具合です。 標準化は、この問題を解決する有効な手段です。標準化では、全てのデータを平均0、ばらつき1に変換します。 このように変換することで、年齢や収入といった異なる種類の情報も、同じ土俵で比べることができるようになります。例えるなら、異なる通貨を共通の通貨に換算するようなものです。 標準化は、特に機械学習で重要な役割を果たします。機械学習では、大量のデータからパターンや規則性を自動的に学習しますが、データの尺度や範囲がバラバラだと、学習がうまくいかないことがあります。標準化によってデータを整えることで、機械学習の効率を高め、より正確な結果を得ることができるようになります。 つまり、標準化は、たくさんの情報を扱う際に、それぞれの情報の特性を揃え、分析をスムーズに進めるための重要な下準備と言えるでしょう。
開発環境

Numpy入門:データ分析を加速する最強ツール

ナンパイとは、パイソンというプログラミング言語で使える便利な道具集のことです。この道具集は、特に数値計算をたくさん行う必要がある場面で力を発揮します。例えば、データの分析や、機械学習、それから科学技術の分野における計算などでよく使われています。このナンパイは誰でも無料で使うことができ、とてもありがたい存在です。 ナンパイの最も重要な役割は、たくさんの数字をまとめて扱うことを簡単にしてくれることです。例えば、縦横に数字が並んだ表のようなもの(行列)や、数字がずらっと一列に並んだもの(ベクトル)を、簡単に作ったり、計算したりすることができます。普段パイソンだけでこれらの計算をしようとすると、一つ一つ順番に計算していく必要があり、時間も手間もかかります。しかしナンパイを使うと、これらの計算をまとめて一度に行うことができるので、計算速度が格段に速くなります。まるで計算機を使う代わりにスーパーコンピュータを使うようなイメージです。 この計算速度の速さが、ナンパイの大きな魅力です。データ分析や科学技術計算では、膨大な量の計算を行う必要があるため、少しでも計算時間を短縮することはとても重要です。ナンパイのおかげで作業効率が大幅に向上し、研究者はより多くの実験や分析を行うことができるようになります。また、機械学習の分野でも、ナンパイは重要な役割を担っています。複雑な計算を高速に処理できるため、より精度の高い学習モデルを短い時間で作り上げることが可能になります。 このように、ナンパイはデータ分析や科学技術計算、機械学習といった幅広い分野で必要不可欠な道具となっています。多くの専門家がナンパイを頼りに日々の研究や開発に取り組んでおり、今後も様々な分野で活躍していくことが期待されています。まるで縁の下の力持ちのように、ナンパイは科学技術の発展を陰ながら支えていると言えるでしょう。
AIサービス

商談解析を進化させるブリングアウト

近年の商取引の世界では、経験や勘に頼るだけでなく、確かな情報に基づいた判断が求められています。膨大な話し合いの記録は、貴重な財産となるはずですが、その記録を聞き直して分析するには多くの時間と手間がかかります。株式会社ブリングアウトが提供する画期的な商談解析の技術は、まさにこのような課題を解決するものです。 ブリングアウトは、人工知能を用いて、商談の音声記録を自動的に文章化し、分析する技術を開発しました。これまで活用が難しかった音声データに新たな価値を与え、企業の業績向上に貢献しています。この技術により、営業担当者は商談の内容を細かく振り返り、成功や失敗の要因を分析することが容易になります。例えば、商談中の顧客の発言から、関心の度合いや購買意欲を把握したり、競合他社との比較で自社の強み弱みを再確認したりすることが可能です。また、成約につながった商談の特徴を分析することで、効果的な営業方法を学ぶこともできます。 このサービスは、営業担当者個人だけでなく、営業チーム全体の能力向上にも役立ちます。チーム内で優れた営業担当者の手法を共有したり、共通の課題を把握したりすることで、組織全体の営業力を高めることができます。さらに、蓄積された商談データは、今後の営業戦略立案にも役立ちます。顧客のニーズや市場の動向を的確に捉え、より効果的な販売戦略を展開することが可能になります。このように、ブリングアウトの商談解析サービスは、企業の営業活動を様々な側面から支援し、収益拡大に大きく貢献できる革新的な技術と言えるでしょう。
セキュリティ

個人情報保護の要、GDPRとは?

近年、個人の大切な情報の保護に対する意識が高まり、世界中でさまざまな対策が取られています。中でも、ヨーロッパ連合(EU)で定められた一般データ保護規則、いわゆるGDPRは、個人情報の保護に関する新しい決まりとして注目を集めています。GDPRは、個人の情報の取り扱いに関する包括的な決まりであり、会社や団体が個人の情報を扱う際に守るべき基準を示したものです。この決まりは、EU内だけでなく、EU外にも適用される場合があり、国をまたいで事業を行う会社にとっては特に重要な決まりとなっています。 GDPRの目的は、個人の情報の適切な管理と保護を通して、個人の権利と自由を守ることです。そのため、GDPRでは、個人の情報の集め方、使い方、保管方法、消し方など、あらゆる段階において、厳しい決まりが定められています。例えば、個人の情報を集める際には、その目的を明確に示し、本人の同意を得ることが必要です。また、集めた情報を安全に管理し、不正なアクセスや漏えいから守るための対策を講じなければなりません。さらに、個人が自分の情報の開示や訂正、削除を求めた場合には、速やかに対応する必要があります。 GDPRは、違反した場合には高額な罰金が科せられるなど、厳しい罰則が設けられています。そのため、会社や団体は、GDPRのルールをよく理解し、適切な対策を講じることが重要です。個人の情報を扱う際には、常にGDPRのルールを意識し、個人の権利と自由を尊重しながら、適切な管理と保護に努める必要があります。これは、社会全体の信頼を高め、より良い社会を作る上で不可欠な取り組みと言えるでしょう。
学習

微調整:機械学習モデルの最適化

機械学習は、多くの情報から規則性を見つけ出し、未来を予測したり、物事を分類したりする技術です。この学習の過程で、模型の調整は非常に大切です。適切な調整を行うことで、模型の働きは良くなり、より正確な結果が得られます。この調整方法の一つとして、微調整という手法が広く使われています。微調整とは、既に学習済みの模型を土台として、新しい仕事に合うように調整する方法です。 微調整は、いわば熟練の職人が作った道具を、自分の仕事に合うように少しだけ手を加えるようなものです。ゼロから道具を作るよりも、早く、簡単に、質の高い道具を手に入れることができます。同様に、機械学習の世界でも、既に大量のデータで学習済みの模型を微調整することで、少ないデータと短い時間で、高い性能の模型を作ることができます。これは、特にデータを集めるのが難しい場合や、計算資源が限られている場合に非常に有効です。 微調整の具体的な手順は、まず学習済みの模型を選び、次に新しい仕事に合わせた少量のデータで追加学習を行います。この際、学習の度合いを調整することが重要です。度合いが強すぎると、元の模型の特徴が失われ、逆に弱すぎると新しい仕事に適応できません。ちょうど良い具合を見つけることが、微調整の成功の鍵となります。 微調整は強力な手法ですが、注意点もあります。元の模型が学習した内容と、新しい仕事の内容が大きく異なると、うまくいかない場合があります。例えば、猫を判別する模型を、車の判別に使うのは難しいでしょう。また、元の模型に偏りがあると、その偏りが新しい模型にも引き継がれてしまう可能性があります。そのため、元の模型の特性を理解し、適切なデータで学習することが重要です。微調整は、機械学習をより手軽で効率的に行うための、大変役に立つ手法と言えるでしょう。
アルゴリズム

リッジ回帰:過学習を抑える

リッジ回帰は、予測のひな形を作る際に、行き過ぎた学習を防ぐための手法です。行き過ぎた学習とは、学習に使う情報にぴったり合いすぎてしまい、新しい情報に対する予測の正確さが落ちてしまう現象のことです。 例えば、たくさんの点の情報から線を引くことを考えてみましょう。普通の線形回帰という手法では、点にできるだけ近い線を求めます。しかし、点が複雑に散らばっている場合、普通の線形回帰では、点の散らばりに完全に合わせて曲がりくねった線になってしまいます。これは、点の配置の特徴だけでなく、本来関係のない細かなずれまで学習してしまっているためです。このような状態が行き過ぎた学習で、新しい点の情報が来た時に、うまく予測できないという問題が起きます。 リッジ回帰は、この行き過ぎた学習を抑えるために、線の形を滑らかにする工夫をしています。具体的には、線の傾き具合を表す数字に罰則を加えることで、線が複雑になりすぎるのを防ぎます。この罰則の強さを決めるのが調整値で、この値が大きいほど、線の傾きは緩やかになり、単純な形になります。 調整値を加えることで、学習に使う情報の特徴を捉えつつ、細かなずれは無視するような線を作ることができます。結果として、新しい情報に対しても、より正確な予測ができるようになります。 このように、リッジ回帰は、調整値をうまく調整することで、行き過ぎた学習を防ぎ、予測の正確さを高める有効な手法です。