AIサービス

物体認識:画像の理解

ものの認識とは、写真や映像の中から、写っているものが何かをコンピュータに見分けさせる技術のことです。まるで人が目で見て判断するように、コンピュータが絵の情報を読み取って、何が写っているかを理解します。この技術は、近年目覚ましい進歩を遂げており、私たちの暮らしの様々な場面で使われています。 ものの認識の仕組みは、大きく分けて二つの段階から成り立っています。まず、写真や映像をコンピュータが読み込み、形や色、模様といった特徴を捉えます。この特徴を手がかりに、データベースに保存されている様々なものの情報と照らし合わせます。そして、一番よく似たものを見つけ出し、それが何かを判断します。例えば、りんごとみかんの写真を見せると、形や色の違いから、それぞれをりんご、みかんとして見分けることができます。 この技術を支えているのが、人工知能、特に深層学習と呼ばれる技術です。深層学習は、人間の脳の仕組みを模倣した複雑な計算によって、コンピュータに自ら学習する能力を与えます。大量の写真や映像データを使って学習させることで、コンピュータはものの特徴をより正確に捉え、認識の精度を向上させることができます。 ものの認識は、すでに私たちの生活に深く浸透しています。例えば、持ち運び電話の顔認証や、自動で運転する車に搭載されている歩行者や信号の認識などは、私たちの安全を守る上で欠かせない技術となっています。また、医療の現場では、病気の診断を助けるために使われています。さらに、工場では、製品の不具合を見つける検査にも役立っています。このように、ものの認識は様々な分野で活用され、私たちの生活をより便利で安全なものにしています。 ものの認識は、単に何が写っているかを見分けるだけでなく、そのものの位置や大きさ、形なども把握することができます。これにより、写真や映像からより多くの情報を引き出すことが可能になります。例えば、自動で運転する車では、歩行者の位置や動きを正確に把握することで、安全な運転を支援します。また、工場では、製品の大きさや形を検査することで、品質管理の向上に役立ちます。このように、ものの認識は、様々な分野で応用され、私たちの社会に大きく貢献しています。
セキュリティ

データ保護と法律

近ごろ、情報技術を使った社会が急速に進歩するのに伴い、個人の情報や会社の機密といった情報の大切さは、今まで以上に増しています。情報は、会社が活動するための土台となるだけでなく、個人の暮らしを守る大切なものでもあります。そのため、情報を使う人と情報を持つ人のどちらも守ることは、健全な社会を保つ上で欠かせない問題となっています。適切な情報の保護は、会社の信頼を高め、情報を使う人に安心感を与えるだけでなく、社会全体を安定させることにも役立ちます。 情報を守ることは、法律でも定められています。例えば、個人の情報を取り扱う際には、その目的を明確にし、使う人にきちんと知らせる必要があります。また、集めた情報を適切に管理し、漏洩や不正なアクセスから守るための対策を講じることも必要です。もし、これらのルールを守らずに情報を扱うと、罰則が科せられることもあります。 情報を使う人にとって、自分の情報がどのように扱われているかを知ることは大切な権利です。情報を持つ人は、情報を使う人からの問い合わせにきちんと対応し、情報の開示や訂正、削除といった要望に応じる必要があります。また、情報を使う人が安心してサービスを利用できるよう、分かりやすい言葉で情報保護の方針を説明することも重要です。 安全な情報活用のためには、技術的な対策だけでなく、一人ひとりの意識も大切です。パスワードをしっかり管理することや、怪しいメールに注意することはもちろん、周りの人にも情報の大切さを伝えることで、より安全な情報社会を作ることができます。技術の進歩とともに、情報の活用方法はますます広がっていきます。情報を使う人と持つ人がお互いに協力し、責任ある行動をとることで、情報化社会の恩恵を安全に享受できるはずです。
アルゴリズム

PReLUとは?パラメトリックReLUの仕組みとReLUとの違いを解説

人の脳の仕組みをまねた数理模型である人工神経回路網は、近ごろ話題の人工知能の重要な部分を担っています。この回路網の中には、たくさんの結び目があり、複雑につながりながら情報をやり取りしています。この情報のやり取りの中で、活性化関数は大切な働きをしています。活性化関数は、入力された情報を受け取り、出力信号の強さを決める、いわば門番のような役割を担っています。 結び目に入ってきた情報が、次の結び目にどのくらい影響を与えるかを調整することで、回路網全体の学習能力を高めます。もし活性化関数がなければ、回路網はただの線形変換の繰り返しになってしまい、複雑な模様を学ぶことができません。分かりやすく言うと、直線しか描けない状態です。複雑な曲線や模様を描くには、非線形性という性質が必要です。活性化関数は、この非線形性を取り入れることで、回路網をより表現力豊かにし、複雑な問題を解けるようにします。 例えるなら、活性化関数は画家のパレットのようなものです。パレットに様々な色の絵の具がなければ、画家は単色でしか絵を描くことができません。しかし、たくさんの色の絵の具があれば、画家はより複雑で豊かな表現の絵を描くことができます。活性化関数も同様に、回路網に非線形性という様々な色の絵の具を与えることで、回路網がより複雑な問題を解くことを可能にしています。つまり、活性化関数は人工神経回路網にとって、複雑な問題を解くための不可欠な要素と言えるでしょう。
AI活用

AIプロジェクト、体制構築の鍵

人工知能を作る仕事がうまくいくためには、誰と一緒に仕事をするのかがとても大切です。特に、色々な考え方を持った人たちが集まることが欠かせません。なぜなら、人工知能は、与えられた情報をもとに考えたり、これから起こることを予想したりするからです。もし、その情報に偏りがあれば、人工知能の答えにも同じ偏りが出てしまいます。 例えば、ある人種や性別について間違った情報で人工知能を学習させると、人工知能も同じように間違った考えを持つようになります。アメリカで使われていた犯罪の起こりやすさを予測するシステム「コンパス」は、肌の色が違う人に対して犯罪を起こしやすいと判断する傾向があり、差別につながると大きな問題になりました。このようなことを防ぐためには、人工知能を作るチームに色々な人種、性別、年齢、経験を持った人を集めることが大切です。色々な人が集まれば、偏りに気づき、正すための話し合いが活発になり、みんなにとって公平で正しい人工知能を作ることができます。 人工知能は社会全体で使う道具なので、特定の人たちに不利な結果をもたらす偏りはなくさなければなりません。色々な考え方は、人工知能の正しさを高めるだけでなく、社会全体の公平さを作るためにも必要です。偏りのない情報を集めること、そして、様々な背景を持つ人々が協力して人工知能を作ることで、より良い社会の実現につながると考えられます。
AI活用

画像認識の基礎:物体識別タスク

「物体識別」とは、写真や動画などの視覚情報から、写っているものが何かを計算機に判断させる技術のことです。私たち人間にとっては、写真を見てそこに写っているのが犬か猫か、車か自転車かを判別するのは簡単なことです。しかし、計算機にとっては、これは大変難しい問題でした。計算機は、画像を数値の集まりとして認識するため、私たち人間のように視覚的に理解することができません。 近年、人工知能、特に深層学習という技術が大きく進歩したことで、計算機も人間に近い正確さで物体を識別できるようになってきました。深層学習とは、人間の脳の仕組みを模倣した学習方法で、大量のデータから特徴を自動的に学習することができます。この技術のおかげで、計算機は画像に含まれる様々な特徴、例えば色、形、模様などを捉え、それらを組み合わせて複雑な物体を識別できるようになったのです。 この物体識別技術は、様々な分野で活用され、私たちの暮らしを大きく変えつつあります。例えば、自動運転車では、周囲の状況を把握するために、歩行者、車、信号などを識別することが欠かせません。物体識別によって、自動運転車は安全に走行するための判断材料を得ることができるのです。また、工場の生産工程では、製品の不具合を見つけるために物体識別技術が使われています。人の目では見逃してしまうような小さな傷も見つけることができ、品質管理の向上に役立っています。さらに、医療の分野でも、レントゲン写真やCT画像から病変を見つけ出すために活用されています。医師の診断を支援し、より正確な診断を可能にしています。 このように、物体識別は現代社会においてなくてはならない重要な技術となり、今後も様々な分野での応用が期待されています。 私たちの生活をより便利で安全なものにするために、この技術はますます進化していくことでしょう。
AI活用

機械学習モデルの本番運用:成功への鍵

機械学習の模型を作り、学習を終え、いよいよ実際の現場で使い始めます。しかし、開発の場と実際の現場では情報の性質や量が違います。そのため、模型の動きも大きく変わる事があります。この変化に早く気づき、適切な対処をするには、模型の性能を常に監視することが欠かせません。 具体的には、模型の予測の正確さや誤りの割合、変わった値の出る回数を監視します。想定外の動きが見られた場合は、すぐに原因を調べ、対策を考えます。 監視する項目は、模型の特徴や仕事での必要性に合わせて適切に決める必要があります。例えば、お金の取引で不正を見つける模型であれば、見つける正確さだけでなく、誤って見つけてしまうことで利用者に与える影響も考える必要があります。 常に監視することで、模型が安定して動き、信頼性を保つことができます。また、模型の劣化も監視の重要な点です。時間の経過と共に、模型の性能が落ちる場合があります。これは、実際の現場の情報の性質が変化する事が原因です。例えば、流行の移り変わりや経済状況の変化によって、商品の売れ行き予測模型の精度は下がることがあります。このような劣化を早期に発見し、再学習などの対策を行うことで、模型の性能を維持する事ができます。 さらに、監視体制を整えることも大切です。誰が、いつ、どのように監視を行うのか、また、異常が発生した場合、誰に報告し、どのような手順で対応するのかを明確に決めておく必要があります。責任の所在を曖昧にせず、迅速な対応ができるようにしておくことが、模型の安定稼働と信頼性の確保につながります。継続的な監視と適切な対応によって、機械学習模型を最大限に活用し、ビジネスの成功に貢献することが期待できます。
アルゴリズム

多層パーセプトロン入門

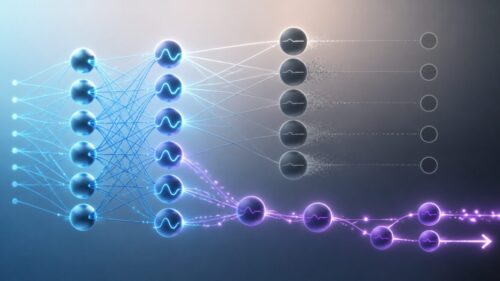
人間の脳の神経回路の仕組みを真似た計算モデルである、ニューラルネットワークの一種に多層パーセプトロンがあります。これは、ちょうど層が重なったような構造をしています。一番最初の層を入力層、最後の層を出力層と呼び、その間にある層を隠れ層と呼びます。 それぞれの層は、結び目のような役割を果たすノードと呼ばれる単位で構成されており、これらのノードは互いに繋がって情報を伝達します。入力層に入力された情報は、これらのノード間の繋がりを介して隠れ層へと伝わり、そこで何らかの処理が行われます。隠れ層は、入力された情報を処理し、より抽象的な特徴を抽出する役割を担います。そして最終的に、出力層から結果が出力されます。 多層パーセプトロンと単純パーセプトロンの違いは、この隠れ層の有無にあります。単純パーセプトロンは入力層と出力層のみで構成されるため、直線で区切れるような単純な問題しか扱うことができません。しかし、多層パーセプトロンでは、隠れ層の存在により、曲線で区切られるような複雑な問題も扱えるようになります。これは、ちょうど複雑に絡み合った糸を解きほぐすように、複雑な情報を整理し、分析することを可能にします。 この複雑な問題を扱えるという特性は、現実世界の問題を解決する上で非常に重要です。例えば、写真に写っているものが何であるかを判断する画像認識や、人間の声を理解する音声認識、そして私たちが日常的に使っている言葉をコンピュータに理解させる自然言語処理など、様々な分野で応用されています。多層パーセプトロンは、まさに現代社会を支える技術の一つと言えるでしょう。
アルゴリズム

PR-AUCとは?適合率と再現率で分類モデルを評価する指標

機械学習の分野では、様々な指標を用いてモデルの良し悪しを評価します。その中で、PR曲線下面積(PR-AUC)は、特に偏りのあるデータにおいて、モデルの性能を測る際に重要な指標となります。偏りのあるデータとは、例えば、全体のデータの中で、注目したい事象の発生割合が非常に少ない場合を指します。クレジットカードの不正利用の検出や、稀な病気の診断などが、この例に当てはまります。このような状況では、単に全体的な正答率だけでモデルを評価すると思わぬ落とし穴に陥る可能性があります。 例えば、不正利用が全体の0.1%しかないとします。この時、常に「不正利用ではない」と予測するモデルを作ったとしましょう。このモデルは、一見99.9%の正答率を誇りますが、実際には不正利用を全く見つけることができません。このような状況で役立つのが、PR-AUCです。PR-AUCは、「精度」と「再現率」という二つの指標を基に計算されます。精度は、モデルが「不正利用あり」と予測した中で、実際に不正利用だった割合を表します。一方、再現率は、実際に不正利用だったもの全体の中で、モデルが正しく「不正利用あり」と予測できた割合を表します。PR-AUCは、様々な閾値における精度と再現率の組み合わせをプロットしたPR曲線の下部の面積を計算することで得られます。この値は、0から1の範囲を取り、1に近いほど、精度と再現率のバランスが良く、モデルの性能が高いことを示します。つまり、PR-AUCを用いることで、単純な正答率では見落とされてしまう、偏りのあるデータにおけるモデルの真の性能を評価することができるのです。具体的には、不正検知や医療診断など、偽陰性を極力減らしたい状況、つまり、実際には不正利用や病気であるにも関わらず、見逃してしまうことを避けたい状況において、PR-AUCは非常に有効な指標となります。
その他

プロジェクトマネージャ試験のすべて

情報処理推進機構(IPA)が実施する国家資格であるプロジェクトマネージャ試験は、情報システム開発プロジェクトを成功させるために必要な知識や技術力を測る試験です。情報処理技術者試験の中級試験に位置づけられており、プロジェクトマネジメントに関する一定以上の能力を持っていることを証明できます。 この試験の出題範囲は、プロジェクトマネジメントの国際標準であるPMBOKガイドに基づいて設定されています。PMBOKガイドは、プロジェクトマネジメントにおける知識体系を網羅的にまとめたもので、プロジェクトの立ち上げから終結までの流れ、必要な工程、そして各工程で求められるスキルなどを体系的に学ぶことができます。試験を通してこれらの知識を習得することで、プロジェクトの計画、実行、監視、そして終結といった一連のプロセスを効果的に管理できるようになります。 近年、社会全体のデジタル化が急速に進んでおり、システム開発プロジェクトの重要性はますます高まっています。それに伴い、プロジェクトを適切に管理できる人材への需要も増加しています。プロジェクトマネージャ試験に合格することで、このような需要に応えられる人材であることを示すことができます。キャリアアップや転職を目指す方にとって、市場価値を高める有力な資格となるでしょう。 高度な専門知識と実践的な技術力を身につけることで、プロジェクトの成功確率を高め、所属する組織への貢献度を高めることができます。この試験は受験資格が特になく、誰でも挑戦できます。情報システム開発に携わる方はもちろん、他の分野でプロジェクトマネジメントのスキルを活かしたい方にもおすすめの資格です。
セキュリティ

AI成果物の知的財産保護

近頃、人工知能(AI)の技術は目覚ましい進歩を遂げ、様々な分野で大きな変化をもたらしています。ものづくりやサービス、医療など、あらゆる産業で革新が起きており、私たちの暮らしにも影響を与え始めています。こうした技術革新の波に乗り、企業は競争力を高めるため、AI技術の活用に力を入れています。AI技術によって生まれた成果物は、企業にとって大変貴重な財産です。他社に真似されたり、不正に利用されたりすると、大きな損害を受ける可能性があります。そのため、AIが生み出した成果物をどのように守り、活用していくかが、企業の成長にとって重要な課題となっています。 AIの成果物は、プログラムや学習済みモデル、AIが作った設計図や文章、音楽、画像など多岐に渡ります。これらの成果物を守るには、知的財産の考え方が役立ちます。特許権や著作権といった知的財産権は、新しい発明や創作物を法律で保護する仕組みです。AIの成果物も、これらの権利で守ることができる場合があります。また、不正競争防止法も重要な役割を果たします。これは、他社の技術やノウハウを不正に取得したり利用したりする行為を禁じる法律です。特に、企業秘密として扱われる情報、つまり「営業秘密」を守るための規定が重要になります。AIの成果物は、開発に多くの時間や費用、労力がかかっているため、営業秘密として保護することで、競争力を維持することができます。 本稿では、AIの成果物を知的財産として守る方法、特に不正競争防止法の営業秘密という観点から、詳しく解説していきます。具体的には、営業秘密として認められるための条件や、具体的な保護対策、注意点などについて説明します。これらを理解することで、企業はAIの成果物を適切に管理し、競争優位性を維持しながら、更なる成長を目指すことができるでしょう。
学習

活性化関数とは?ニューラルネットワークでの役割と種類を初心者向けに解説

人工知能の中核を担う人工神経回路は、人間の脳神経細胞の働きを模倣するように設計されています。この神経回路において、活性化関数は信号の伝達を制御する門番のような役割を担っています。まるで人間の脳神経細胞が、特定の刺激にのみ反応して信号を伝えるように、活性化関数も入力された情報に対して、特定の計算を行い、その結果に基づいて信号の強さを調整します。 具体的には、ある層から次の層へと情報が伝達される際、活性化関数がその情報の変換を行います。入力された数値を受け取り、活性化関数独自の計算式を用いて出力値を生成します。この出力値が次の層への入力信号となります。この変換こそが、人工神経回路の学習能力を飛躍的に向上させる鍵となります。 もし活性化関数が存在しないと、神経回路は単純な線形変換の繰り返しになってしまいます。線形変換とは、入力と出力が比例関係にある変換のことです。このような単純な変換だけでは、現実世界に存在する複雑な事象を表現することは困難です。例えば、画像認識や音声認識といったタスクは、高度な非線形性を持ちます。このような問題を解決するためには、神経回路に非線形性を導入する必要があります。活性化関数はまさに、この非線形性を提供する役割を担っています。 活性化関数の種類は多岐にわたり、それぞれの関数には独自の特性があります。例えば、よく使われるものとして、段階関数、シグモイド関数、ReLU関数などがあります。これらの関数はそれぞれ異なる計算式を用いており、問題の種類やデータの特性に合わせて適切な関数を選択することが重要です。活性化関数は、神経回路の学習能力と表現力を向上させる上で、必要不可欠な要素と言えます。
アルゴリズム

主成分分析:データの次元削減

たくさんの情報を持つデータを扱う場面は、世の中にあふれています。しかし、情報の数が多すぎると、データの全体像を掴むことが難しくなります。また、情報を処理するための時間も費用もかかってしまい、非効率です。このような問題を解決する手法の一つに、主成分分析というものがあります。 主成分分析は、たくさんの数値で表されるデータを、少ない数値で表現できるようにする手法です。たとえば、10個の数値で表されるデータを、2、3個の数値で表現できるように変換します。この変換によって、データの全体像を掴みやすくなります。また、無駄な情報を省くことで、処理の効率化にも繋がります。 主成分分析は、データが持つ性質をなるべく損なわないように変換を行います。具体的には、データのばらつきが大きい方向に新しい軸を設けます。この軸を主成分と呼びます。元のデータは、この新しい軸を使って表現されます。主成分は、データのばらつきが最も大きい方向に最初に作られます。2つ目の主成分は、1つ目の主成分と直角になるように、残りのばらつきが最も大きい方向に作られます。こうして順番に主成分が作られていきます。 主成分分析は、様々な分野で活用されています。例えば、商品の売れ行きに影響を与える要素を分析したり、顧客をグループ分けしたりする際に用いられます。また、画像認識や音声認識といった分野でも、データの次元を減らすことで処理の効率化に役立っています。このように、主成分分析は、高次元データを扱う上で欠かせない手法と言えるでしょう。
学習

プルーニングとは?ニューラルネットワークを軽量化する仕組みを解説

木の枝を切り落とす剪定作業のように、人工知能の学習モデルを小さく軽くする技術のことを「枝落とし」と呼びます。この技術は、不要な部分を切り落とすことで、木の成長を助ける剪定と同じように、人工知能の学習モデルの働きを良くする効果があります。 具体的には、人工知能の学習モデルは、たくさんの数字が複雑につながり合ってできています。この数字のつながりを「枝」に例えると、「枝落とし」はこの「枝」の一部を削除する作業に相当します。 「枝落とし」を行うことで、モデルの大きさが小さくなり、計算に使う資源を減らすことができます。計算に使う資源が減ると、学習にかかる時間や電気代を節約できるだけでなく、持ち運びに便利な小さくて軽い人工知能を作ることができます。これは、電気をあまり使えない機器や、小さな機器に人工知能を組み込む際に役立ちます。 さらに、「枝落とし」は、人工知能の学習における「過学習」を防ぐ効果もあります。「過学習」とは、人工知能が学習データの特徴を覚えすぎてしまい、新しいデータにうまく対応できなくなる状態のことです。「枝落とし」によって不要な「枝」を取り除くことで、過学習を防ぎ、新しいデータにも対応できる、より賢い人工知能を作ることができます。 近年、人工知能の学習モデルはますます複雑で大きくなってきています。そのため、「枝落とし」技術は、人工知能をより効率的に、そして幅広い場面で使えるようにするために、ますます重要になっています。
AI活用

AIシステムの継続的な改善

近頃、人工頭脳(じんこうとうのう)と呼ばれる技術が、私たちの暮らしや仕事に大きな影響を与え始めています。自動車の自動運転や、病気の診断、お客さま対応など、様々な場面で使われており、私たちの暮らしを便利で効率的にしてくれています。しかし、この人工頭脳は、一度作ってしまえばそれで終わりというわけではありません。技術は常に進歩し、社会も変化していくため、作った後も、より良いものになるよう、常に改良や修理を続ける必要があります。 人工頭脳は、大量の情報から学習することで賢くなっていきます。この学習データは、時代の変化や社会の動きに合わせて、常に新しいものにしていく必要があります。そうでないと、古い情報に基づいた判断をしてしまい、役に立たなくなってしまうかもしれません。また、人工頭脳を使う人からの意見や要望も大切です。使いにくい部分や、もっとこうだったら良いのにという点を改善していくことで、より多くの人に満足してもらえるものになります。 さらに、人工頭脳の技術自体も日進月歩で進化しています。新しい技術を取り入れることで、処理速度が速くなったり、より正確な判断ができるようになる可能性があります。常に最新の技術に目を向け、必要に応じてシステムを更新していくことが重要です。そして、改良を加える際には、きちんとテストを行い、問題がないかを確認する作業も欠かせません。思わぬ不具合が生じて、本来の機能を果たせなくなってしまうことがないように、慎重に進める必要があります。このように、人工頭脳は、継続的な改善と努力があってこそ、真価を発揮できるものと言えるでしょう。
AIサービス

OpenCV:画像処理の万能ツール

画像や動画を扱う技術は、現代社会で大変重要になっています。例えば、携帯電話での顔認証や、自動車の自動運転技術など、私たちの生活に欠かせないものとなっています。そのような技術を支えるのが、「オープンシーヴイ」と呼ばれる、無料で使える便利な道具集です。正式名称は「オープンソース・コンピュータ・ビジョン・ライブラリ」と言い、まさに名前の通り、画像や動画をコンピュータで扱うための様々な機能が詰まっています。 この道具集は、誰でも自由に利用でき、変更も加えることができます。さらに、営利目的で利用することも可能です。これは、「ビーエスディー・ライセンス」と呼ばれる、利用に関する規約で認められているためです。このライセンスのおかげで、多くの企業や研究者が気軽に利用し、技術開発を進めています。 この道具集は、様々な種類のプログラム言語に対応している点も大きな特徴です。例えば「シー」「シーぷらぷら」「ジャバ」「パイソン」「マットラブ」など、多くの言語で利用できます。そのため、開発者は自分の使い慣れた言語で、画像処理や解析、機械学習といった高度な機能を簡単に利用できます。 オープンシーヴイは、画像認識を初めとするコンピュータビジョンの分野で幅広く利用されています。具体的には、製造業における製品検査の自動化や、医療分野での画像診断支援、防犯カメラによる人物検知など、様々な場面で活躍しています。今後も、様々な分野での応用が期待される、大変重要な技術です。
その他

利害関係者の声に耳を傾ける

人が集まって何かを行う時、色々な人や団体に影響を与えます。会社でいえば、そこで働く人は、お給 Schaefer や仕事の経験を得て生活の糧にしています。会社の周りの地域に住む人は、会社から仕事をもらったり、時には、騒音や公害といった困りごとを抱えることもあります。会社にお金を出している人は、会社がうまくいくことで、出したお金が増えることを期待しています。このように、会社が行う事柄によって、良くも悪くも何かしらの影響を受ける人や団体のことを、まとめて関係者と呼びます。 会社が何かをする際に、これらの関係者の存在を無視することはできません。会社は、関係者に支えられて初めて成り立つからです。関係者と良い関係を築き、彼らが何を求めているのかを理解することは、会社が長く続くために欠かせません。会社は、関係者の声にしっかりと耳を傾け、その声に応えるための努力を続けなければなりません。これは、単に道徳的な話ではなく、会社が生き残るための大切な方法なのです。 たとえば、従業員の声を無視して長時間労働を強いたり、低いお給 Schaefer で働かせ続けたりすれば、従業員は会社を辞めてしまい、会社は人手不足に陥ります。また、地域住民の反対を押し切って環境を汚染するような工場を建てれば、会社の評判は地に落ち、商品を買ってくれる人がいなくなるかもしれません。さらに、お金を出している人の利益を無視して、会社のお金を無駄遣いすれば、会社は倒産してしまうでしょう。 このように、会社が長く続くためには、あらゆる関係者との良好な関係を築き、彼らの幸せを考えながら活動することが重要です。これは、会社を経営していく上で、最も大切なことの一つと言えるでしょう。
AIサービス

生成AIを牽引するOpenAI

人間社会の進歩を目的とした団体であるオープンエーアイは、利益を追求する部署と、利益を追求しない部署の二つの部署から成り立っています。この仕組みは、人工知能技術の成長と世の中への広がりというみんなにとって良い目標と、活動を続けるための資金集めという利益を求める活動を両立させるためのものです。利益を追求しない部署は、人工知能技術を倫理的に正しく安全に使うことに力を入れています。利益を追求する部署は、新しい人工知能の道具を作り、提供することでお金を得て、その一部を利益を追求しない部署の活動に使っています。この独自の仕組みによって、オープンエーアイは社会への貢献と技術の進歩のバランスを取ろうとしています。近年、人工知能技術が急速に発展する中で、倫理的な問題や社会への影響についての議論が盛んになっています。このような状況の中で、オープンエーアイは責任ある人工知能開発の大切さを理解し、透明性のある運営と様々な立場の人との話し合いを通じて、人工知能技術が健全に発展するように努めています。具体的には、研究成果や開発中の技術に関する情報を積極的に公開し、外部の専門家や団体と意見を交わし、倫理的な課題や社会への影響について深く考えています。また、人工知能技術が悪用されたり、間違って使われたりするのを防ぐための対策にも力を入れており、人工知能システムの安全性と信頼性を高める努力をしています。加えて、オープンエーアイは人工知能技術が人々の生活をより良くするために、教育や医療、環境問題など、様々な分野への応用も積極的に進めています。人工知能技術が持つ可能性を最大限に引き出し、誰もがその恩恵を受けられるように、オープンエーアイはたゆまぬ努力を続けています。
アルゴリズム

単純パーセプトロン:機械学習の基礎

単純パーセプトロンとは、機械学習の根本をなす基本的な学習のひな形の一つです。まるで人間の脳を形作る神経細胞、ニューロンの働きをまねたような単純な構造をしていて、様々な課題を解決するために使われています。 具体的には、複数の入力信号を受け取ります。そして、それぞれの信号に重要度に応じて重みを付けます。重みを付けた信号を全て合計し、その値がある基準値を超えた場合に1、超えない場合に0を出力するのです。 これは、人間の脳細胞が電気信号をやり取りすることで情報を処理する過程を簡単にしたものと捉えることができます。例えば、目から入った様々な視覚情報(色、形、動きなど)が脳細胞に送られ、それぞれの情報に重みが付けられます。そして、それらの合計値がある基準値を超えると、「何かがある」と認識する、といった具合です。 単純パーセプトロンは、AND回路やOR回路といった論理回路を表現することができます。AND回路は、二つの入力が両方とも1の場合のみ1を出力する回路です。OR回路は、二つの入力のうち少なくとも一つが1の場合に1を出力する回路です。これらの回路は、入力信号と出力信号の関係を単純な式で表すことができます。単純パーセプトロンも同様に、入力信号と出力信号の関係を式で表すことができ、適切な重みと基準値を設定することで、AND回路やOR回路と同じ働きをするように設定できます。 このように単純な仕組みでありながら、この単純パーセプトロンは、より複雑な学習のひな形の基礎となっています。複数の単純パーセプトロンを組み合わせることで、より複雑な問題を解決できるようになります。そして、この単純パーセプトロンの考え方を発展させたものが、現在広く使われている深層学習などのより高度な学習手法につながっているのです。
学習

プラトー現象とは?機械学習で学習が停滞する原因と対策

学習の過程で、まるで登山の途中で平坦な高原地帯に迷い込んだかのように進歩が止まってしまう現象があります。これを、一般的に「プラトー」と呼びます。特に、機械学習、とりわけ多くの層を持つ深層学習と呼ばれる分野では、このプラトー現象がよく見られます。 この現象は、山を登るように最適な値を探し出す勾配降下法という手法を用いる際に起こります。勾配とは、山における傾斜のようなもので、学習の進むべき方向を示しています。この傾斜がほとんどない平らな領域に迷い込んでしまうと、学習は停滞し、プラトー状態に陥ってしまうのです。この平坦な領域は鞍点とも呼ばれ、一見すると最適な地点に辿り着いたように見えますが、実際には目的地ではありません。 プラトー状態では、モデルの性能は向上せず、学習は事実上停止してしまいます。例えるなら、深い霧の中に迷い込み、進むべき道を見失ってしまったような状態です。この状態から抜け出すのは簡単ではなく、適切な工夫を凝らさなければ、貴重な時間と計算に使う資源を無駄にしてしまうかもしれません。 プラトー現象が発生する主な原因の一つとして、学習率の設定が挙げられます。学習率とは、一度にどれくらい大きく学習を進めるかを調整する値です。学習率が大きすぎると、最適な地点を通り過ぎてしまい、逆に小さすぎると、プラトーに陥りやすくなります。そのため、適切な学習率の設定が重要となります。その他にも、モデルの構造やデータの質など、様々な要因がプラトー現象に影響を与えます。この問題に対処するために、学習率を調整する手法や、最適化手法を工夫するなど、様々な対策が研究されています。
アルゴリズム

幅優先探索で迷路を解くとは?仕組み・最短経路・注意点をわかりやすく解説

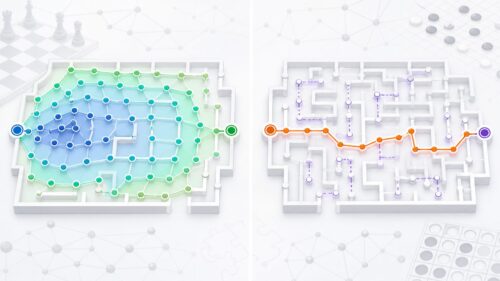
迷路は、昔から多くの人を惹きつけてきた、考えさせる遊びの一つです。入り組んだ道筋から出口を見つけるという行為は、易しいものから非常に難しいものまで、様々な難しさを与えてくれます。遊戯としてだけでなく、計算機の世界でも、迷路は大切な役割を担っています。計算の手順の効率や、問題を解く力を測るための題材として、まさにうってつけなのです。 迷路を解く方法はいろいろありますが、中でも基本となるやり方のひとつに「幅優先探索」というものがあります。これは、出発点から近い場所から順番に、行ける範囲をできるだけ広く調べていく方法です。水たまりに水がゆっくり広がっていく様子を思い浮かべてみてください。一歩一歩、確実に調べられる範囲を広げていくことで、最後には出口にたどり着くことができるのです。 具体的には、まず出発点を記憶します。次に、出発点からすぐに行ける場所を全て調べ、まだ訪れたことのない場所を記憶します。そして、記憶した場所から、さらにその隣にある訪れたことのない場所を探し、また記憶します。これを繰り返すことで、出発点から近い順に、迷路全体をくまなく調べていくことができます。あたかも波紋のように、探索の範囲が徐々に広がっていく様子が想像できるでしょう。 この幅優先探索の利点は、必ず出口にたどり着けることです。もし出口が存在するならば、この方法できちんと探索を続ければ、必ず見つけることができます。ただし、迷路が非常に複雑な場合、探索範囲が広くなりすぎて、多くの記憶領域が必要になることがあります。これは、計算機の負担が大きくなることを意味します。しかし、確実に解を見つけられるという点で、幅優先探索は迷路を解くための基本的な、そして強力な方法と言えるでしょう。
開発環境

OpenAI Gymで学ぶ強化学習

近頃、人の知恵を模倣する技術である人工知能の分野で、強化学習という学習方法が注目を集めています。この学習方法は、試行錯誤を通じて学習を進めるという、人間の学習方法に似た特徴を持っています。しかし、強化学習を行うためには、適切な学習環境を用意する必要があります。そこで登場するのが、オープンエーアイ・ジムというプラットフォームです。 このプラットフォームは、電気自動車会社の設立者としても有名なイーロン・マスク氏らが設立した非営利団体であるオープンエーアイによって開発されました。オープンエーアイ・ジムは、強化学習を行うための様々な環境を提供しています。まるで遊園地のように、様々なアトラクションが用意されていると想像してみてください。それぞれの環境は、それぞれ異なる課題やルールを持っています。例えば、ロボットの歩行を学習させるための環境や、ゲームの攻略方法を学習させるための環境など、多種多様な環境が用意されています。 オープンエーアイ・ジムの最大の魅力は、その使いやすさにあります。初心者の方でも、手軽に強化学習の世界に触れることができます。まるで、初めて自転車に乗る子供に補助輪が付いているように、安心して学習を進めることができます。もちろん、上級者の方にとっても、様々な設定をカスタマイズできるため、より高度な学習を行うためのツールとして活用できます。 この記事では、オープンエーアイ・ジムの魅力をさらに詳しく解説し、強化学習の基礎知識についても説明していきます。強化学習の仕組みや、オープンエーアイ・ジムで提供されている様々な環境について、具体例を交えながら分かりやすく解説していきます。これから強化学習を始めたいと考えている方や、オープンエーアイ・ジムに興味を持っている方は、ぜひこの記事を読んでみてください。きっと、強化学習の魅力に引き込まれることでしょう。
アルゴリズム

カーネル法:高次元への扉

近年の情報量の爆発的な増加に伴い、様々な分野で大量の情報を扱う機械学習が重要性を増しています。同時に、扱う情報の複雑さも増しており、単純な手法では対応が難しくなっています。例えば、写真や動画など視覚的な情報や、文章のような言語情報は、そのままではコンピュータが理解できる形になっていません。これらの情報を分析するには、複雑な関係性を捉える必要があります。そこで注目されているのが、カーネル法と呼ばれる手法です。 カーネル法は、直接データを分析するのではなく、データをより高次元の空間に写像することで、隠れた関係性を明らかにします。例えるなら、たくさんの星が散らばっている夜空を想像してみてください。地上から見ると、星の明るさや位置だけが手がかりです。しかし、特別な望遠鏡を使ってより詳細な情報を得ることができれば、星の温度や組成、距離など、より多くの特徴が見えてきます。カーネル法は、この特別な望遠鏡のような役割を果たし、データの隠れた特徴を捉えることで、分析を容易にします。 高次元空間への写像は、カーネル関数と呼ばれる特別な計算式によって行われます。カーネル関数は、2つのデータ間の類似度を測る役割を担っています。この類似度を基に、データ同士の関係性を高次元空間で表現することで、複雑なパターンを捉えることが可能になります。例えば、手書きの文字認識を例に挙げると、従来の手法では、文字の形を単純な線や円で表現しようとしますが、カーネル法では、文字の線の太さや曲がり具合、線のつながり具合など、より多くの特徴を捉えることができます。これにより、人間のように複雑な文字でも正確に認識することが可能になります。 このように、カーネル法は、高次元空間への写像を通じて、複雑なデータの分析を可能にする強力な手法です。画像認識や音声認識、自然言語処理といった様々な分野で応用され、機械学習の発展に大きく貢献しています。今後、ますます複雑化する情報を扱う上で、カーネル法の重要性はさらに高まっていくでしょう。
AI活用

アルゴリズムバイアス:公平性を欠く人工知能

計算手順の偏りとは、人工知能が特定の集団に対して不公平な結果をもたらす現象のことです。これは、人工知能の学習に用いる情報に偏りがある場合に起こりやすい問題です。 たとえば、顔認証の学習情報に特定の人種が多く含まれていると、その人種に対しては高い精度で認識できる一方で、他の少数派の人種に対しては認識精度が低くなることがあります。 採用活動や融資の審査など、重要な決定に用いられる人工知能において、このような計算手順の偏りは深刻な差別や不平等につながるため、大きな問題となっています。 計算手順の偏りは、学習情報だけでなく、計算手順そのものの設計にも起因することがあります。 たとえば、過去のデータに基づいて将来を予測する計算手順の場合、過去のデータに偏りがあれば、将来の予測にも偏りが生じます。過去のデータが男性優位の社会を反映したものであれば、将来の予測も男性優位の結果となり、女性の活躍を阻害する可能性があります。 また、計算手順の目的設定自体が偏っている場合も、偏った結果を生み出す可能性があります。 たとえば、利益最大化のみを目的とした計算手順は、社会全体の利益よりも特定の企業の利益を優先する結果をもたらす可能性があります。 計算手順の偏りを防ぐためには、学習情報の多様性を確保することが重要です。 さまざまな属性の人々を均等に含む学習情報を用いることで、特定の集団に対する偏りを軽減することができます。また、計算手順の設計段階から偏りを意識し、公平性を考慮した設計を行う必要があります。 さらに、計算手順の結果を常に監視し、偏りが生じていないかを確認することも重要です。もし偏りが発見された場合は、計算手順の修正や学習情報の追加など、適切な対策を講じる必要があります。 計算手順の偏りは、人工知能が社会に広く普及していく中で、ますます重要な課題となっています。偏りのない、公平な人工知能を実現するためには、技術的な対策だけでなく、社会全体での議論も必要です。
セキュリティ

顧客データ活用とプライバシー保護の両立

近頃、様々な機器を使った人の動きや状態を捉える技術が大きく進歩しました。お店では、買い物客がどのように店内を動き、どの商品に興味を示すのかといった行動を細かく調べることが可能になりました。これらの情報は、商品の陳列場所を最適化したり、より良い接客サービスを提供するために活用され、お店の売り上げ増加に大きく貢献しています。 例えば、ある商品棚の前で立ち止まる人が多いにも関わらず、購入に至る人が少ないといったデータが得られれば、商品の配置場所や価格設定に問題がある可能性を検討することができます。また、特定の商品を手に取った客がその後どのような商品を購入したのかを分析することで、関連商品の提案やセット販売といった販売戦略に役立てることができます。 しかし、このような技術の進歩は、買い物客の個人情報の保護に対する心配も高めています。カメラや様々な機器によるデータ収集は、買い物客に漠然とした不安感を与える可能性があります。「誰が、何のために、どのように自分の情報を使っているのか」が分からない状態では、不信感を抱くのも当然です。企業は、このような顧客の不安に真摯に向き合い、適切な対応策を示す必要があります。 顧客のプライバシーを尊重しながら、データの利点を活かすには、透明性の高い仕組み作りが不可欠です。具体的には、どのようなデータをどのような目的で収集し、どのように利用するのかを、分かりやすく顧客に説明する必要があります。また、収集したデータの管理体制を明確にし、不正アクセスや情報の漏洩を防ぐための安全対策を徹底することが重要です。さらに、顧客自身が自分の情報の利用状況を確認できるような仕組みを設けることで、安心感を高めることができます。データの活用とプライバシー保護の両立は、企業にとって大きな課題ですが、顧客との信頼関係を築き、持続的な成長を実現するためには、避けて通れない重要な取り組みです。