

OpenAI Gymで学ぶ強化学習:仕組み・活用例・注意点を解説

AIの初心者
「OpenAI Gym」って、ゲームを作るためのものですか?

AI専門家
主な用途は、AIに試行錯誤で行動を学ばせる「強化学習」の実験だよ。棒立てやゲームなどの課題と、課題をプログラムから操作するための共通の仕組みを用意しているんだ。
AIの初心者
課題を動かしていれば、AIは自然に上達するのでしょうか?
AI専門家
上達するには、経験を使って行動の選び方を改善する学習方法も必要だよ。Gymは課題を動かし、行動の結果を返す役割を担うんだ。環境と学習する側を分けて考えると、仕組みを理解しやすくなるよ。
OpenAI Gymとは。
OpenAI Gym(オープンエーアイ・ジム)は、強化学習の実験に使う環境と、環境を共通の方法で操作するAPIを提供するPythonのツールキットです。APIとは、プログラム同士がやり取りするための窓口を指します。用意された課題を利用することで、課題そのものを一から作る負担を減らし、学習方法の実装や比較に取り組めます。
強化学習を始めるときは、「何を学ばせるか」と「どう学ばせるか」を分けることが出発点です。この記事では、棒立て課題のCartPoleを例に、観測・行動・報酬の関係から実験の始め方、成績の見方まで説明します。旧Gymの教材を読む際に必要な、後継のGymnasiumとの関係も確認していきましょう。
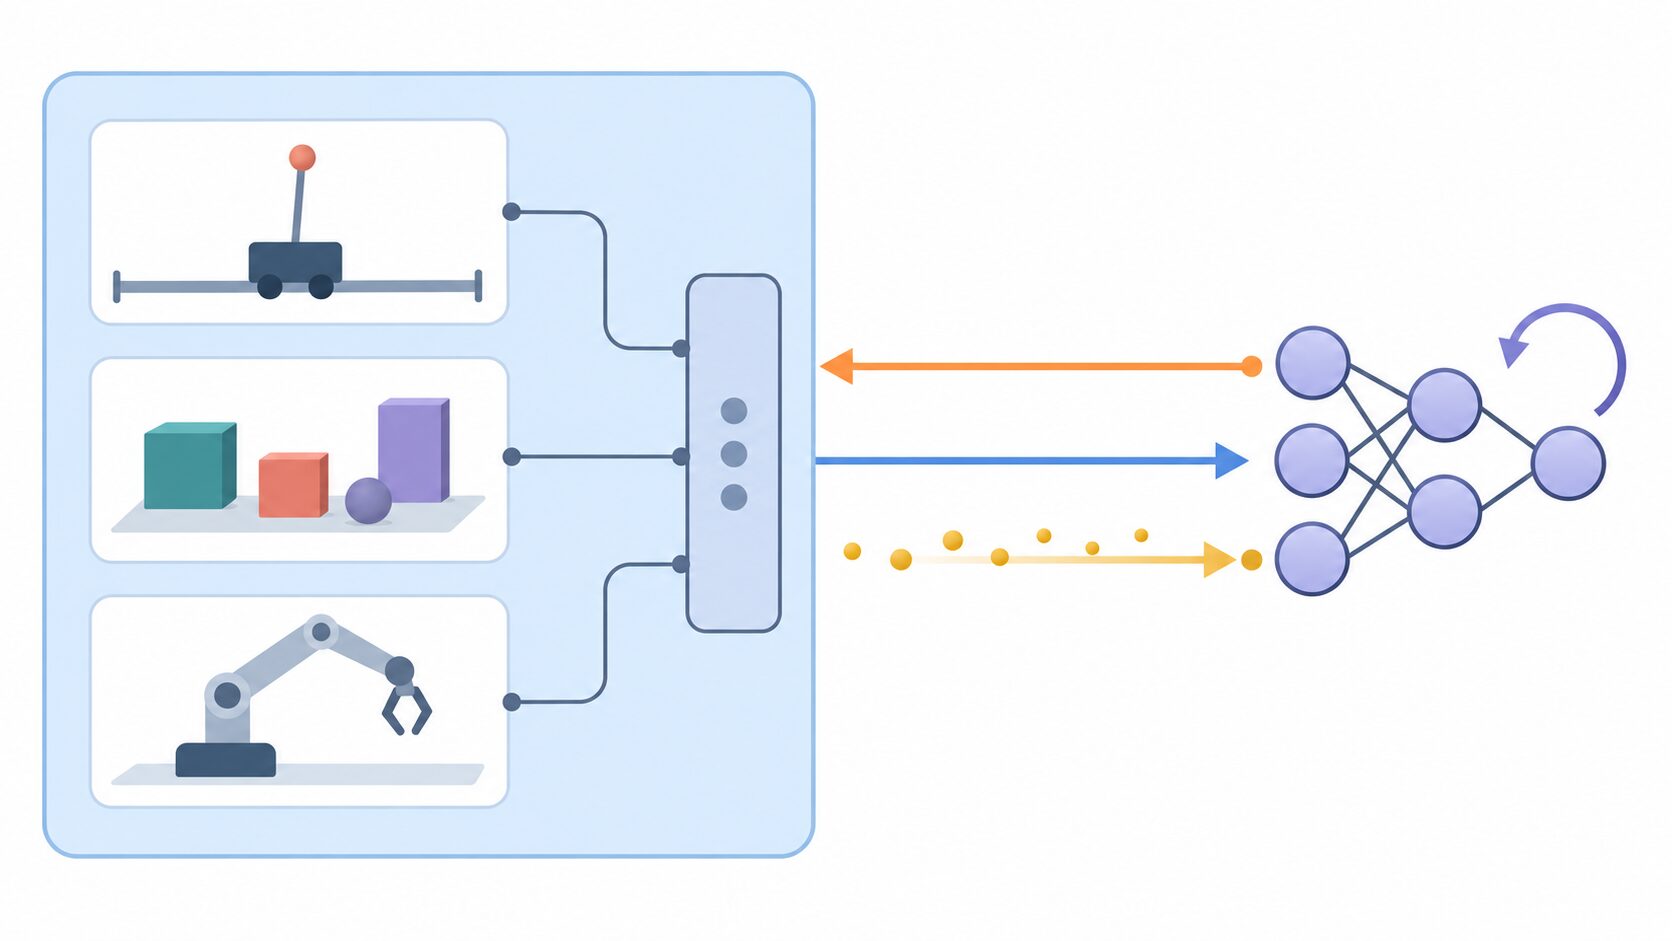
棒立てやゲームなどで課題の内容は違っても、環境へ行動を渡し、その結果を受け取るという基本の流れは共通です。この窓口をそろえることが、Gymの中心的な役割です。
OpenAI Gymとは何を提供する道具か
OpenAI Gymは、OpenAIが開発した強化学習用のツールキットです。特徴は、複数の課題環境を利用できることと、それらを共通のAPIで扱えることにあります。ここでいう「環境」は、Pythonの実行環境ではなく、エージェントの行動に応じて状況が変わり、観測や報酬を返す課題の世界を意味します。
例えば棒立て課題では、台車と棒の動きを計算する仕組みが環境に当たります。一方、台車をどちらに動かすかを決める主体がエージェントです。さらに、その判断を経験から改善するのが学習アルゴリズムです。実装上は一つのプログラムにまとめることもありますが、役割を分けて理解すると、何を用意すれば学習が始まるのかが見えてきます。
| 要素 | 役割 | CartPoleでの具体例 |
|---|---|---|
| 環境 | 課題のルールに沿って状態を更新し、観測・報酬・終了情報を返す | 台車と棒の運動を計算し、棒の角度などを返す |
| エージェント | 得られた観測をもとに行動を選ぶ | 台車に左向きか右向きの力を加えることを選ぶ |
| 学習アルゴリズム | 経験から行動の選び方や評価を更新する | 棒を長く支えられた経験を使って判断を改善する |
Gymはゲーム制作を主目的としたツールではありません。ゲームは、行動の良し悪しを評価できる課題の一例です。また、Gymを導入しただけでエージェントが自動的に学習するわけでもありません。学習する側の処理は、自分で実装するか、対応する強化学習ライブラリを組み合わせて用意します。
準備済みの環境を使う利点は、物理計算やゲームのルールを一から作らずに実験できることです。初心者は強化学習の流れに集中でき、研究や開発では同じ課題を使って手法を比べやすくなります。ただし、課題によって導入に必要な依存ソフトウェアや計算資源は異なります。
観測・行動・報酬で進む強化学習の仕組み
強化学習では、エージェントが環境とやり取りしながら、より良い行動の選び方を学びます。この選び方を「方策」と呼びます。目標は、一回の行動で高い点を取ることだけではなく、その後の結果も含めた累積報酬を高めることです。目先の報酬が小さくても、将来の成功につながる行動が有利になる場合があります。
- 環境から観測を受け取り、今どのような状況かを把握する。
- 方策に従って行動を選び、環境へ渡す。
- 環境が変化し、次の観測、報酬、終了に関する情報を受け取る。
- 得られた経験を学習に利用し、行動選択と環境とのやり取りを繰り返す。
CartPoleでは、台車の上に立つ棒を倒さずに支え続けることを目指します。観測には台車の位置と速度、棒の角度と角速度が含まれます。エージェントが選ぶ行動は、台車に左向きの力を加えるか、右向きの力を加えるかの二つです。棒がどちらに傾いているかだけでなく、どれくらいの速さで傾いているかも判断に関係します。
標準的なCartPoleではステップごとに報酬が与えられるため、棒を長く支えられるほど、エピソード全体の累積報酬も大きくなるように設計されています。「ステップ」は行動によって環境を一段階進める単位、「エピソード」は開始から終了までの一回の試行です。棒の傾きや台車の位置が許容範囲を超えた場合、あるいは設定された時間制限に達した場合などに、その試行を終えます。

観測はエージェントが利用できる情報であり、環境の内部状態がすべて見えるとは限りません。例えば、ゲーム画面だけが観測として渡される課題では、画像から物体の位置や動きを読み取る工夫が必要です。何が観測できるかによって、学習に必要な処理も変わります。
教師あり学習では、入力と対応する正解ラベルを使って予測を学ぶのが基本です。これに対して強化学習では、各場面の正解行動があらかじめ渡されるとは限りません。行動の結果として報酬を受け取り、どの選択が将来の成果につながったかを学びます。そのため、まだ十分に試していない行動を選ぶ「探索」と、すでに良さが分かっている行動を使うことの両方が必要になります。
なお、ランダムな行動を繰り返すだけでも環境は動きますが、それだけでは方策は改善しません。経験を蓄え、一定の規則に沿って方策や行動の評価を更新して初めて、学習としての変化が生まれます。
共通APIとGymnasiumの関係
Gymの共通APIは、課題固有の処理と学習する側の処理を分離するための仕組みです。開始状態の準備にはreset()、行動による一段階の更新にはstep()を使う、という基本を共有することで、課題ごとに操作方法を覚え直す負担を減らせます。
旧OpenAI Gymの保守は終了し、その後継としてGymnasiumが引き継がれています。新しく実験を始める場合はGymnasiumを前提に準備し、旧Gymの教材を読む場合は対象のバージョンを確認しましょう。パッケージ名だけを置き換えても、返り値の受け取り方や周辺ライブラリとの互換性までそろうとは限りません。この記事のコード例はGymnasiumのAPIで統一します。
| 操作 | 役割 | Gymnasiumで確認する点 |
|---|---|---|
reset() |
新しいエピソードの開始状態を準備する | 初期の観測と補助情報のinfoを返す |
step(action) |
行動を受け取り、環境を一段階進める | 観測、報酬、terminated、truncated、infoの五つを返す |
render() |
環境の様子を表示したり、画像を取得したりする | 利用できる描画モードは環境によって異なり、通常は環境作成時に指定する |
close() |
環境の利用を終え、関連するリソースを解放する | 実験終了時に呼び出し、描画ウィンドウなどを閉じる |
terminatedは、成功や失敗など、課題の定義に基づく終端に達したことを示します。truncatedは、時間制限などによって試行が打ち切られたことを示します。例えばCartPoleでは、棒が許容範囲を超えて傾いた場合と、棒を支えたまま最大ステップ数に達した場合で意味が異なります。
次の試行を始める判断では、どちらの場合もreset()が必要です。一方、学習の計算ではこの区別が重要です。将来の価値を推定する手法では、時間制限による打ち切りを、課題そのものが終わった状態と同じに扱うと、価値の見積もりが不適切になることがあります。
古い教材では、reset()が観測だけを返したり、step()が一つの終了フラグdoneを含む四つの値を返したりします。ただし、Gymにも版によるAPIの違いがあるため、「Gymなら必ず四つ」とは判断できません。教材、導入したパッケージ、学習ライブラリの対象APIを一組として確認することが大切です。

共通APIがあると、同じ環境で学習方法を変更したり、一つの手法を別の環境で試したりしやすくなります。ただし、どの手法もそのまますべての環境で動くわけではありません。観測の形式を表すobservation_spaceと、選べる行動を表すaction_spaceを確認し、数値と画像、離散的な選択と連続的な制御などの違いに対応する必要があります。
棒立て・ブロック崩し・ロボット制御の使いどころ
環境は、学びたい内容に合わせて選ぶと効果的です。最初から複雑な課題に取り組むと、動かない原因が環境構築、入力の処理、学習方法のどこにあるのかを切り分けにくくなります。まずは数値の観測と少数の行動で仕組みを追える課題を使い、その後に画像や連続制御へ進むと理解を積み重ねやすくなります。
| 代表的な課題 | 観測の例 | 行動の例 | 学べる内容・用途 |
|---|---|---|---|
| CartPole(棒立て) | 台車の位置・速度、棒の角度・角速度 | 左右どちらかへの力という離散的な選択 | 環境とのやり取り、報酬とエピソード、基本的な手法の比較 |
| Atariのブロック崩し | 画像観測を使う設定ではゲーム画面 | パドルを左右に動かすなどの離散的な操作 | 画像から状況を捉える処理、動きの予測、先の展開を考えた行動 |
| ロボットの歩行などの制御課題 | 関節角度、速度、胴体の姿勢など | 関節に加える力などの連続的な値 | 連続制御、姿勢の安定化、複数の動作を組み合わせる学習 |
CartPoleでは、台車を動かして棒の傾きを修正する関係が見えやすく、入門用の実験に向いています。ブロック崩しでは、ボールをパドルで打ち返してブロックを壊すことを目指します。画像を入力にする場合、一枚の画面だけでは動く方向を判断しにくいこともあり、複数フレームを使うなど、時間的な情報の扱いが課題になります。
ロボット制御では、「右か左か」の選択だけでなく、どの関節にどれくらいの力を加えるかを扱います。このような連続的な行動に対応するアルゴリズムが必要です。また、前進する速さだけを報酬にするのか、転倒やエネルギー消費も考慮するのかによって、身につける動作は変わります。
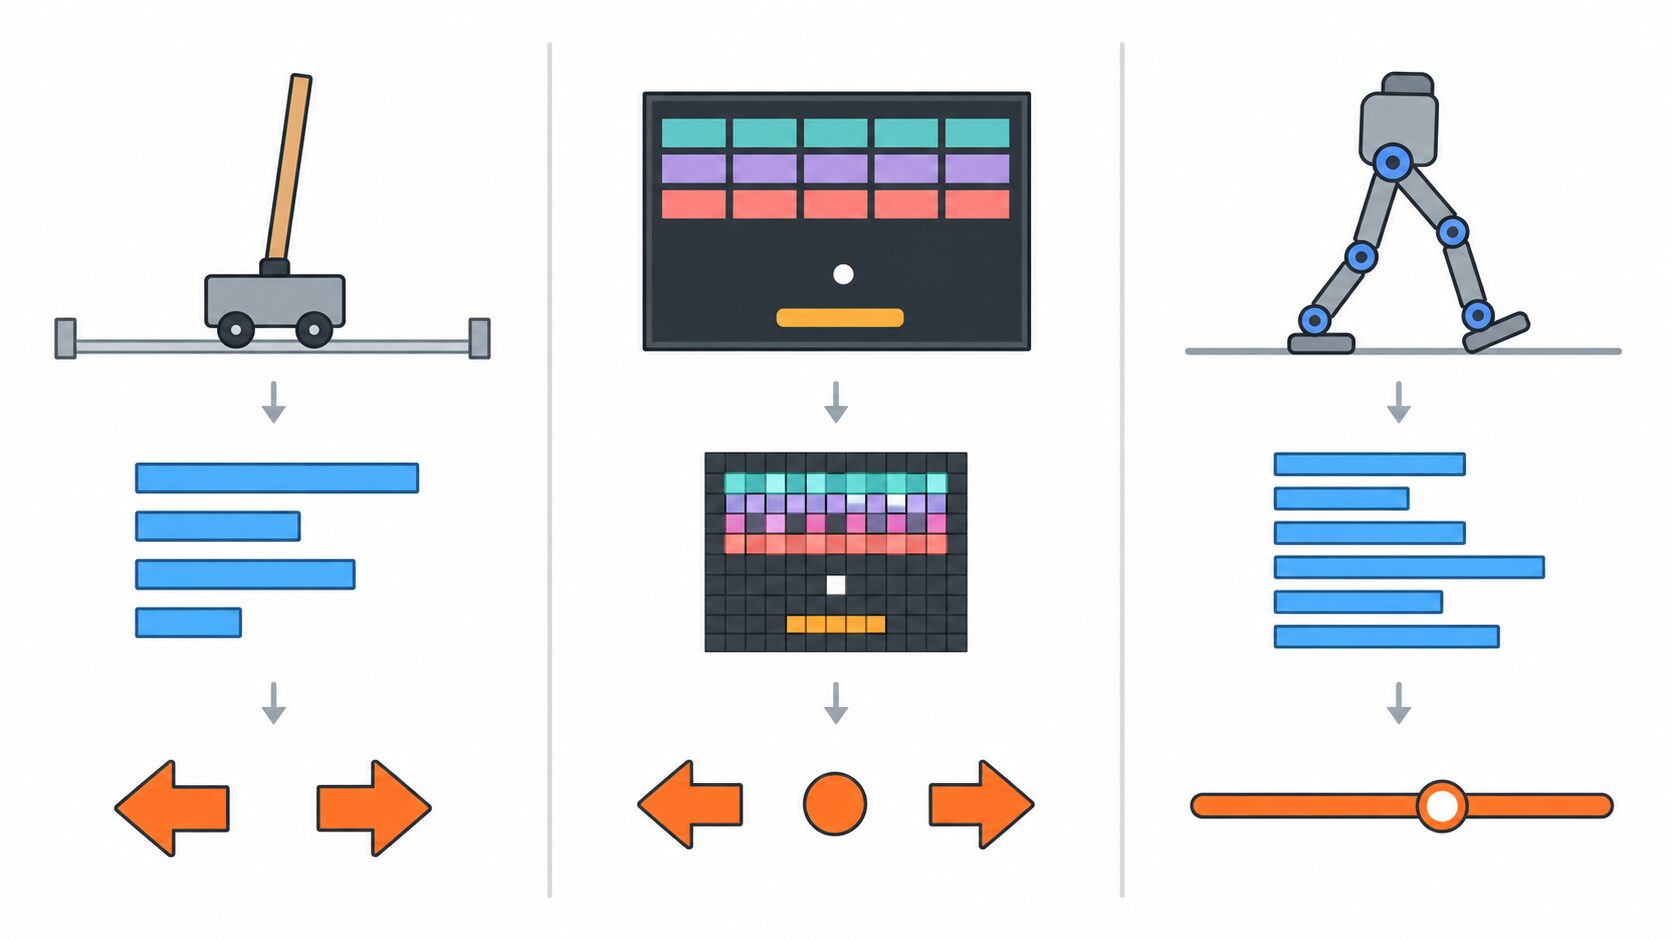
これらの環境は、基礎学習だけでなく、手法の性能比較や制御研究にも利用できます。独自の課題を作る場合も、観測、行動、報酬、終了条件を定義し、reset()とstep()などの共通APIに合わせて実装すれば、学習する側の処理と接続しやすくなります。ただし、報酬を設計するときは、得点を上げる行動が本来達成したい目的にも合っているかを確かめる必要があります。
なお、標準のパッケージを入れるだけで、すべての課題が使えるわけではありません。Atari環境では関連パッケージやゲームデータ、ロボット制御では物理シミュレータなどが必要になる場合があります。使用条件、対応する環境ID、導入方法を対象のパッケージと版に合わせて確認してください。
Pythonで実験を始める手順と注意点
最初の実験では、学習の成績より先に、環境とのやり取りが正しく動くことを確認します。Pythonの仮想環境を用意し、教材と学習ライブラリが対応するGymnasiumの版をそろえましょう。仮想環境は、別のプロジェクトの依存関係と混ざるのを防ぐために役立ちます。導入時には、Pythonの対応バージョンも確認します。
CartPoleなどの古典制御環境に必要な依存関係を含めて導入するコマンドの例は、次のとおりです。再現したい教材や実験がある場合は、その指定に合わせてパッケージの版も固定します。
python -m pip install "gymnasium[classic-control]"基本の手順は、「環境を作る→開始状態を用意する→行動を選んで一段階進める→終了したら開始し直す→最後に閉じる」です。次のコードは、CartPoleでランダムな行動を選び、終了したエピソードの累積報酬と長さを表示する動作確認例です。方策の更新は行わないため、このコードだけでは学習は進みません。
import gymnasium as gym

env = gym.make("CartPole-v1")

try:
    observation, info = env.reset(seed=42)
    env.action_space.seed(42)
    episode_reward = 0.0
    episode_length = 0

    for _ in range(1000):
        action = env.action_space.sample()
        observation, reward, terminated, truncated, info = env.step(action)
        episode_reward += reward
        episode_length += 1

        if terminated or truncated:
            print(
                f"reward={episode_reward:.1f}, "
                f"length={episode_length}, "
                f"terminated={terminated}, truncated={truncated}"
            )
            observation, info = env.reset()
            episode_reward = 0.0
            episode_length = 0
finally:
env.close()action_space.sample()は、環境で許される行動の中からランダムに一つを選びます。この例では合計1,000ステップで実行を終えるため、最後のエピソードが途中のまま終わることもあります。画面は描画せず、数値と終了フラグを確認する構成です。
この動作確認ができたら、行動を選ぶ部分に方策を組み込み、観測、行動、報酬、次の観測、終了情報などを使う学習処理を追加します。対応ライブラリを使う場合は、そのアルゴリズムがCartPoleの離散的な行動に対応しているかを確認します。自分で実装する場合も、経験を使って何を、いつ更新するのかを明確にすることが大切です。
学習中の試行と、学習済みの方策を測る評価は分けてください。評価では方策を更新せず、あらかじめ決めた条件で複数のエピソードを実行します。学習中には探索のために不利な行動を選ぶことがあるため、そのときの報酬だけでは身についた方策の性能を判断しにくいからです。
動きを目で確かめたい場合、CartPoleでは環境作成時にrender_mode="human"を指定できます。このモードでは環境の進行に合わせて描画されますが、表示できる画面が必要です。描画は挙動の確認に役立つ一方、大量の試行では処理時間が増えるため、学習は描画なしで進め、必要な場面で表示する方法もあります。画像観測や複雑な物理計算を含む環境では、さらにメモリや計算時間を見積もる必要があります。
また、シミュレーションで高い成績を出しても、その方策が現実のロボットで同じように動くとは限りません。摩擦、センサーの誤差、通信や制御の遅れなどが異なるためです。実機への適用では、こうした差を見込んだ調整と、段階的な動作確認が別途必要になります。
学習の進捗を記録して改善につなげる
学習が進んでいるかを確認する基本の指標は、エピソードごとの累積報酬とエピソードの長さです。CartPoleでは、棒を支えられたステップ数が長くなっているかを見ることで、行動の改善を捉えやすくなります。ただし、最大ステップ数に達した試行は時間制限で終わるため、長さだけでなく、どの条件で終了したかも記録すると状況を理解しやすくなります。
役割を分けると、環境は一ステップごとの報酬や終了情報を返し、記録処理がそれらをエピソード単位に集計します。GymnasiumのRecordEpisodeStatisticsのような統計記録用ラッパーも利用できます。ラッパーとは、環境を包んで記録や前処理などの機能を追加する仕組みです。
Gymを使うだけで、すべての学習曲線や分析画面が自動的に作られるわけではありません。集計した値をファイルやログに保存し、必要に応じてグラフ描画ライブラリやログ管理ツールで可視化します。学習ライブラリが記録機能を持つ場合も、何を集計しているかを確認しましょう。
| 記録する項目 | 確認できること | 読み取る際の注意 |
|---|---|---|
| エピソードの累積報酬 | 一回の試行で得た成果と、その推移 | 報酬の定義が違う課題の数値は単純比較できない |
| エピソードの長さと終了理由 | どのくらい続き、何によって終わったか | 長く続くことが成功を意味するかは課題による |
| 累計の環境ステップ数 | 成果を得るまでに必要だった経験量 | 一回のエピソードの長さが変わっても比較しやすい |
| 学習済み方策の評価結果 | 方策を更新しない条件での性能 | 学習中の探索を含む報酬と区別して記録する |
| 実行時間 | 実験に必要な時間や処理の負担 | 機材や描画設定などにも左右される |
グラフを作る場合、横軸を累計の環境ステップ数、縦軸を累積報酬や評価成績にすると、経験を増やすにつれて何が変わったかを追えます。エピソード数だけを横軸にすると、早く失敗する試行と長く続く試行で経験量が異なるため、解釈に注意が必要です。
成績が横ばいなら、報酬が目的に合っているか、探索が不足していないか、学習率などの設定が適切かを点検します。ただし、CartPoleで上限まで安定して続いているなら、横ばいは失敗ではなく課題の上限に達した結果かもしれません。大きなばらつきも、探索、開始状態の違い、学習の不安定さなど複数の原因で起こります。
曲線だけで原因を断定せず、終了理由や実際の動きも合わせて確認してください。条件を一度にいくつも変えると改善の理由を追いにくくなるため、変更点と結果を対応づけて記録します。移動平均などで曲線を滑らかにすると傾向をつかみやすくなりますが、元のばらつきも残しておくと急な悪化を見落としにくくなります。
同じ条件で比較し再現性を確かめる
共通の環境を使うと学習方法を比較しやすくなりますが、同じ環境名を選ぶだけでは公平な実験にはなりません。環境の版や前処理が違えば、見えている情報や課題の難しさが変わることがあります。比較する条件をそろえ、何回か繰り返した結果の平均とばらつきを見ることが大切です。
- 環境IDとバージョン、最大ステップ数、報酬に関する設定をそろえる。
- 画像の縮小やフレームの重ね合わせ、観測の正規化などの前処理とラッパーを記録する。
- 学習に使う環境ステップ数をそろえ、計算時間や設定調整に使った予算も必要に応じて示す。
- 評価するエピソード数、評価時の行動選択、評価用の開始条件をそろえる。
「最終的にどこまで高い成績を出せたか」と「そこに達するまでにどれだけ経験が必要だったか」は、異なる評価軸です。例えば、一方の手法が少ないステップで早く上達し、別の手法が時間をかけるとより高い成績に達することもあります。最終値だけでなく学習曲線も見ることで、用途に合う特徴を判断できます。実行時間を比べる場合は、使用機材や並列実行数なども条件に含めます。
実験条件を再現するには、乱数の生成を制御する「シード」を記録します。環境の開始状態だけでなく、行動のサンプリングや学習側の初期化・探索にも乱数が使われます。先ほどのコードではreset(seed=42)で環境側を、action_space.seed(42)でランダム行動のサンプリングを設定しました。本格的な学習では、使用する数値計算や機械学習ライブラリの乱数設定も必要です。
ただし、シードの固定は完全に同じ結果を保証するものではありません。ライブラリの版、ハードウェア、並列処理、一部の演算などによって結果が変わる場合があります。再実行しやすくするには、シードに加えて、依存ライブラリの版、学習設定、前処理、使用機材を記録しておきます。
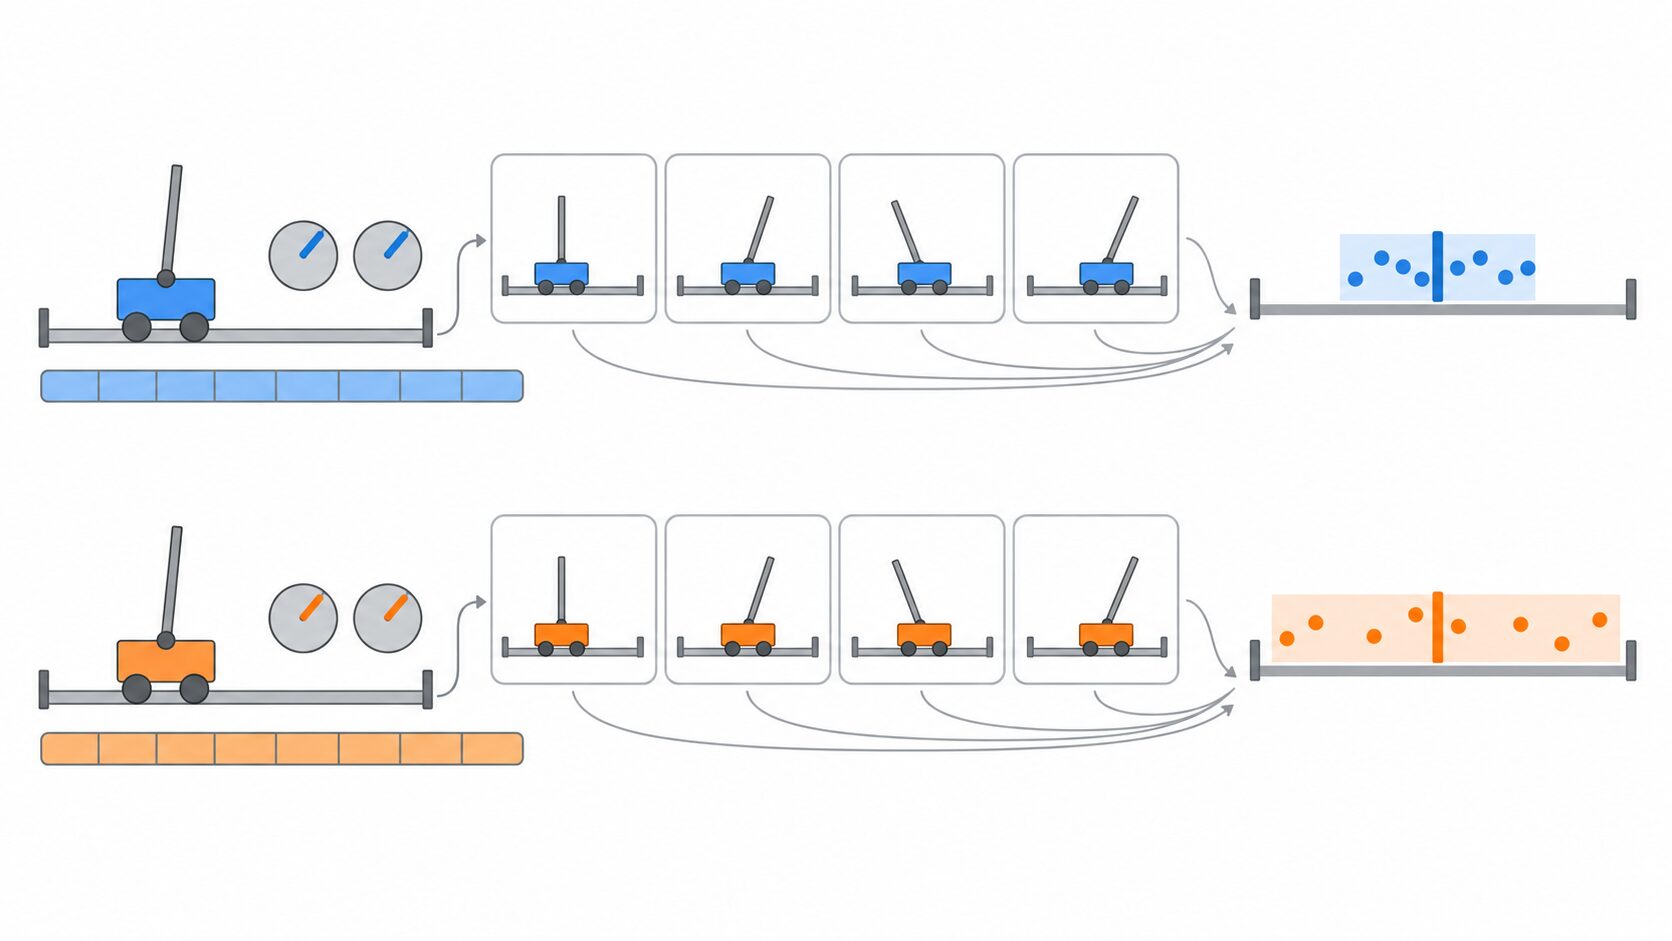
この比較図は評価の考え方を説明する模式図です。図中に数値や曲線を用いる場合も説明用の例であり、特定のアルゴリズムの実測成績を示すものではありません。実際の比較では、自分の実験条件で得た結果を使って判断します。
評価では、一つの学習済み方策を複数エピソードで試すことと、シードを変えて学習そのものを繰り返すことを区別しましょう。前者は開始状態や試行による変動を見るため、後者は学習結果自体の安定性を見るために役立ちます。一回だけ高得点が出ても、繰り返すと成績が大きく変わるなら、その不安定さも結果として伝える必要があります。
また、CartPoleで優れた手法が、画像を使うゲームや連続制御でも優れるとは限りません。汎用性を評価したい場合は、性質の異なる複数の課題で検証します。まず一つの軽い環境で仕組みを理解し、記録と評価の方法を整えてから対象を広げると、各実験で得られた知見を次の学習につなげやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月3日 | GymnasiumのAPIと実行例を補い、進捗記録と再現性の説明を修正 |