
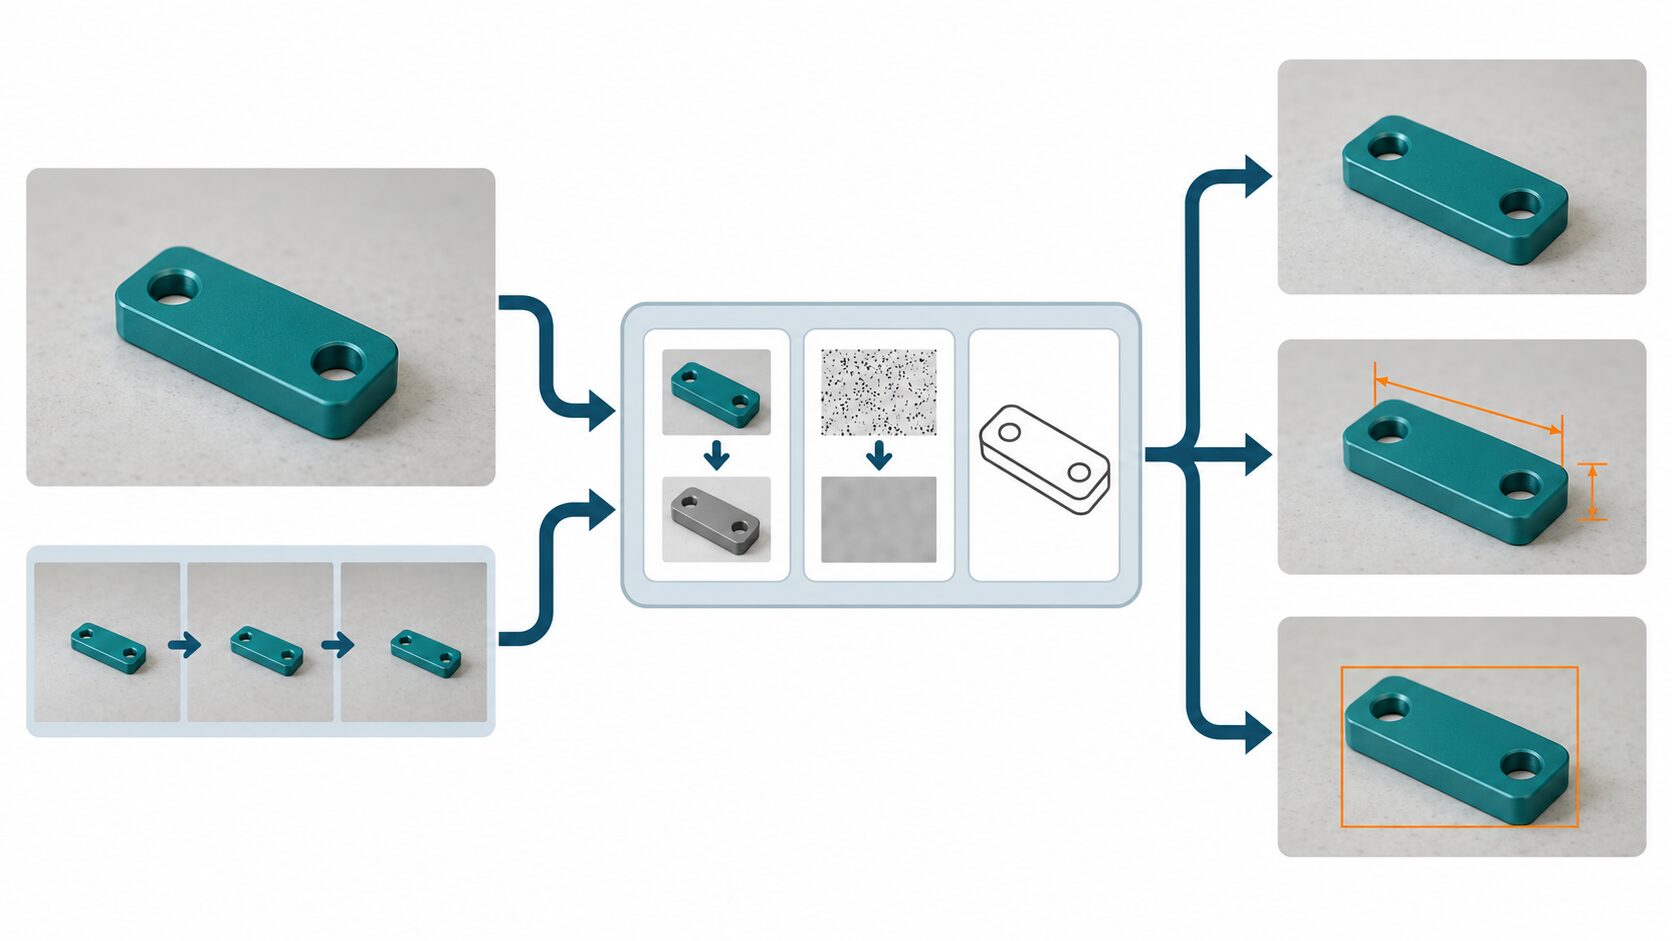
OpenCVとは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「OpenCV」ってよく聞くんですけど、どんなものなんですか?画像を認識するAIのことですか?

AI専門家
OpenCVは、画像や動画を扱う機能を集めた、プログラム用の道具箱だよ。画像の大きさを変える処理から、物の形や動きを調べる処理まで組み合わせられるんだ。AIと一緒に使うこともあるよ。
AIの初心者
道具箱なんですね。例えば、写真に写っている部品の数を数えたり、動画から人を見つけたりできますか?
AI専門家
そうした仕組みを作るのに使えるよ。ただし、写真の撮り方に合った処理を選んだり、目的に応じた学習済みモデルを用意したりする必要があるんだ。まずは、画像から何を取り出したいのかを決めると理解しやすいよ。
OpenCVとは。
OpenCV(オープンシーブイ)は、画像処理やコンピュータビジョンの機能をプログラムに組み込むためのオープンソースライブラリです。写真の加工、画像内の形状の計測、カメラ映像の解析などに利用でき、AIによる画像認識の前後の処理も支えます。
「OpenCVで何ができるのか」「AIとどう違うのか」をつかむには、入力する画像と、得たい結果を結び付けて考えるのが近道です。この記事では、部品の個数を数える例を軸に仕組みを説明し、活用分野、Pythonでの始め方、実用化に必要な確認事項まで紹介します。
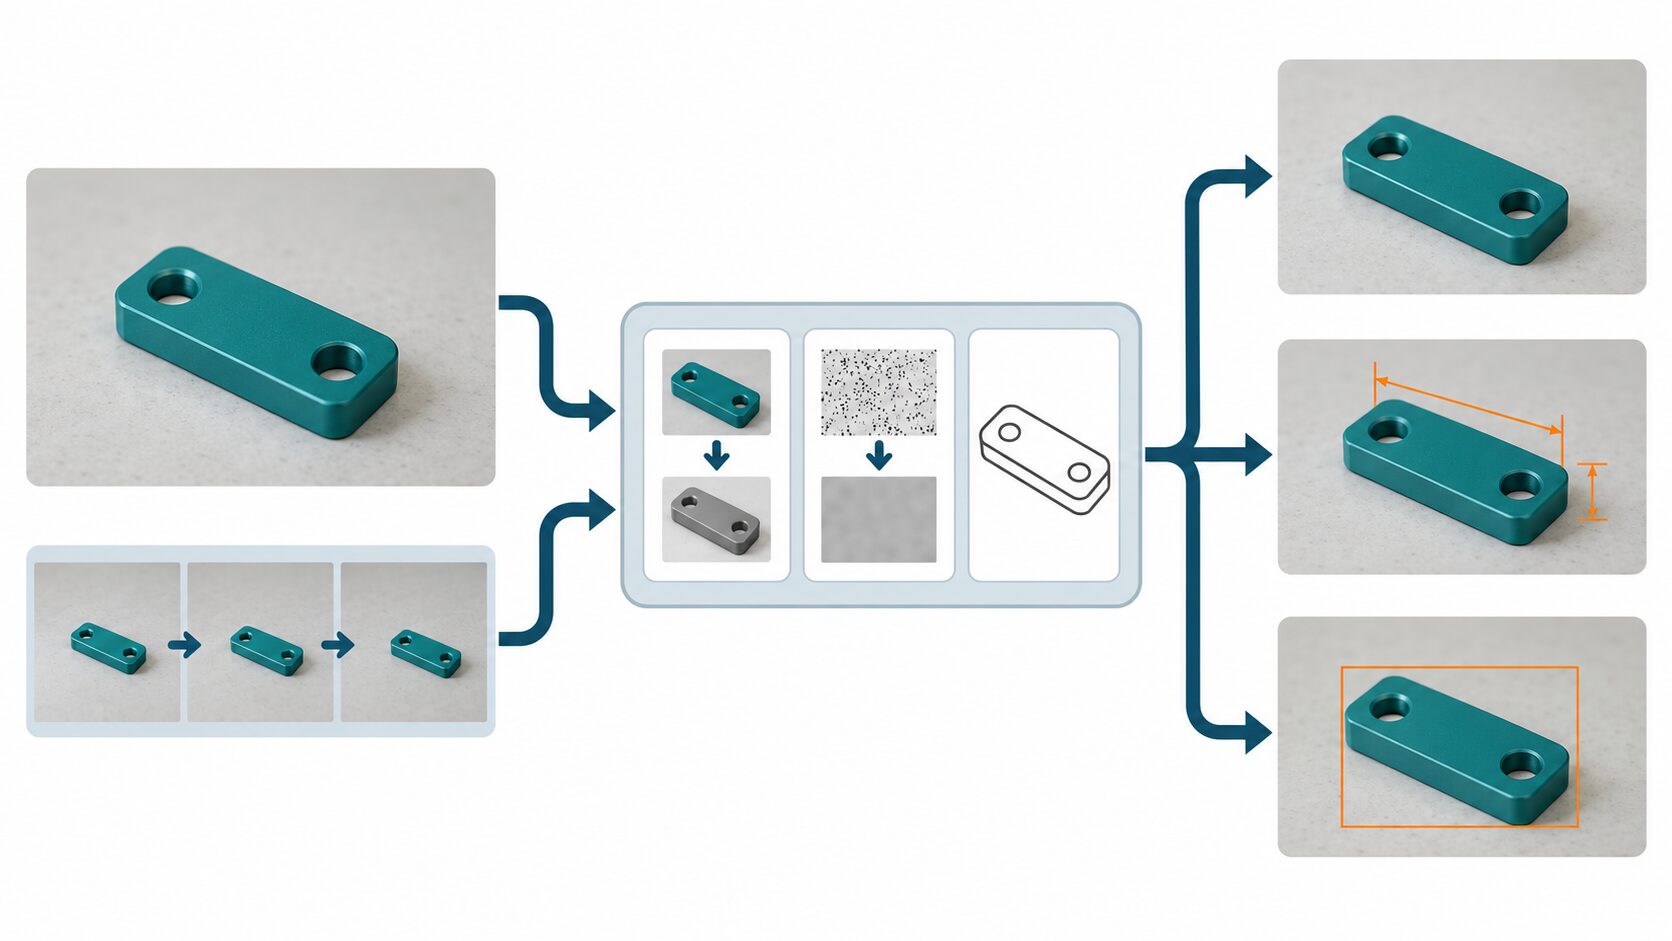
OpenCVとは:画像と動画を扱うライブラリ
OpenCVの正式名称は「Open Source Computer Vision Library」です。ライブラリとは、よく使う処理を再利用できるようにまとめたプログラムの部品集を指します。OpenCVを使うと、画像ファイルを読み込む、色を変換する、輪郭を探すといった処理を、用意された関数を呼び出して実行できます。
画像編集ソフトのように画面上のボタンだけで作業するものではなく、基本的には自分のプログラムから利用します。そのため、同じ条件で大量の写真を加工したり、カメラから届く映像を繰り返し解析したりする用途に向いています。処理を一つずつ自作する負担が減り、目的に合う条件の調整や結果の確認に時間を使えます。
関連する言葉に「画像処理」と「コンピュータビジョン」があります。画像処理は、縮小やノイズ低減など、画像を変換・加工する技術です。一方、コンピュータビジョンは、画像から物の位置、種類、動きなどの情報を取り出す技術分野です。例えば、部品の写真を明るさだけの画像に変えるのは画像処理、その画像から部品の個数を求めるのはコンピュータビジョンの課題に当たります。両者の境界は重なり合い、OpenCVはどちらにも使えます。
主な利用言語にはC++、Python、Javaがあり、Windows、Linux、macOSなどで利用できます。Pythonは短いコードで処理を試しやすく、C++は既存のアプリケーションや機器向けのプログラムに組み込む選択肢になります。ただし、使える機能や導入方法は、言語、配布パッケージ、ビルド時の設定によって異なります。
古い解説に登場するC向けAPIや、MATLABとの連携も、同じ条件で使えるとは限りません。旧APIの情報か、別の連携ツールを介する方法かを区別し、利用する言語とバージョンに合った資料を選ぶと混乱を減らせます。
主な機能と画像処理の仕組み
コンピュータは、画像を小さな点である「画素」の集まりとして扱います。各画素には明るさや色を表す数値があり、画像全体は数値を縦横に並べた配列として表現できます。OpenCVは、この数値を変換したり、周囲の画素と比較したりすることで、画像の加工や特徴の抽出を行います。
例として、明るい台の上に間隔を空けて置いた、暗い色の部品を数えてみましょう。背景と部品が明確に分かれる条件なら、次のような手順で候補を取り出せます。
- 画像を読み込んで整える:写真を読み込み、必要に応じて処理しやすい大きさに調整します。細かなざらつきが判定を妨げる場合は、ぼかしなどでノイズを減らします。
- グレースケール化する:カラー画像を明るさ中心の画像に変換します。色の違いを使わない課題では、扱う情報を絞って処理しやすくできます。
- 二値化する:明るさの境界値である「しきい値」を決め、画素を二つの値に分けます。暗い部品の部分を白、明るい背景を黒にするなど、対象を取り出しやすい状態にします。
- 輪郭を検出して数える:取り出した領域の境界を探し、面積や形で候補を選びます。結果を元画像に描き込み、個数とともに保存すると、何を数えたのか確認できます。
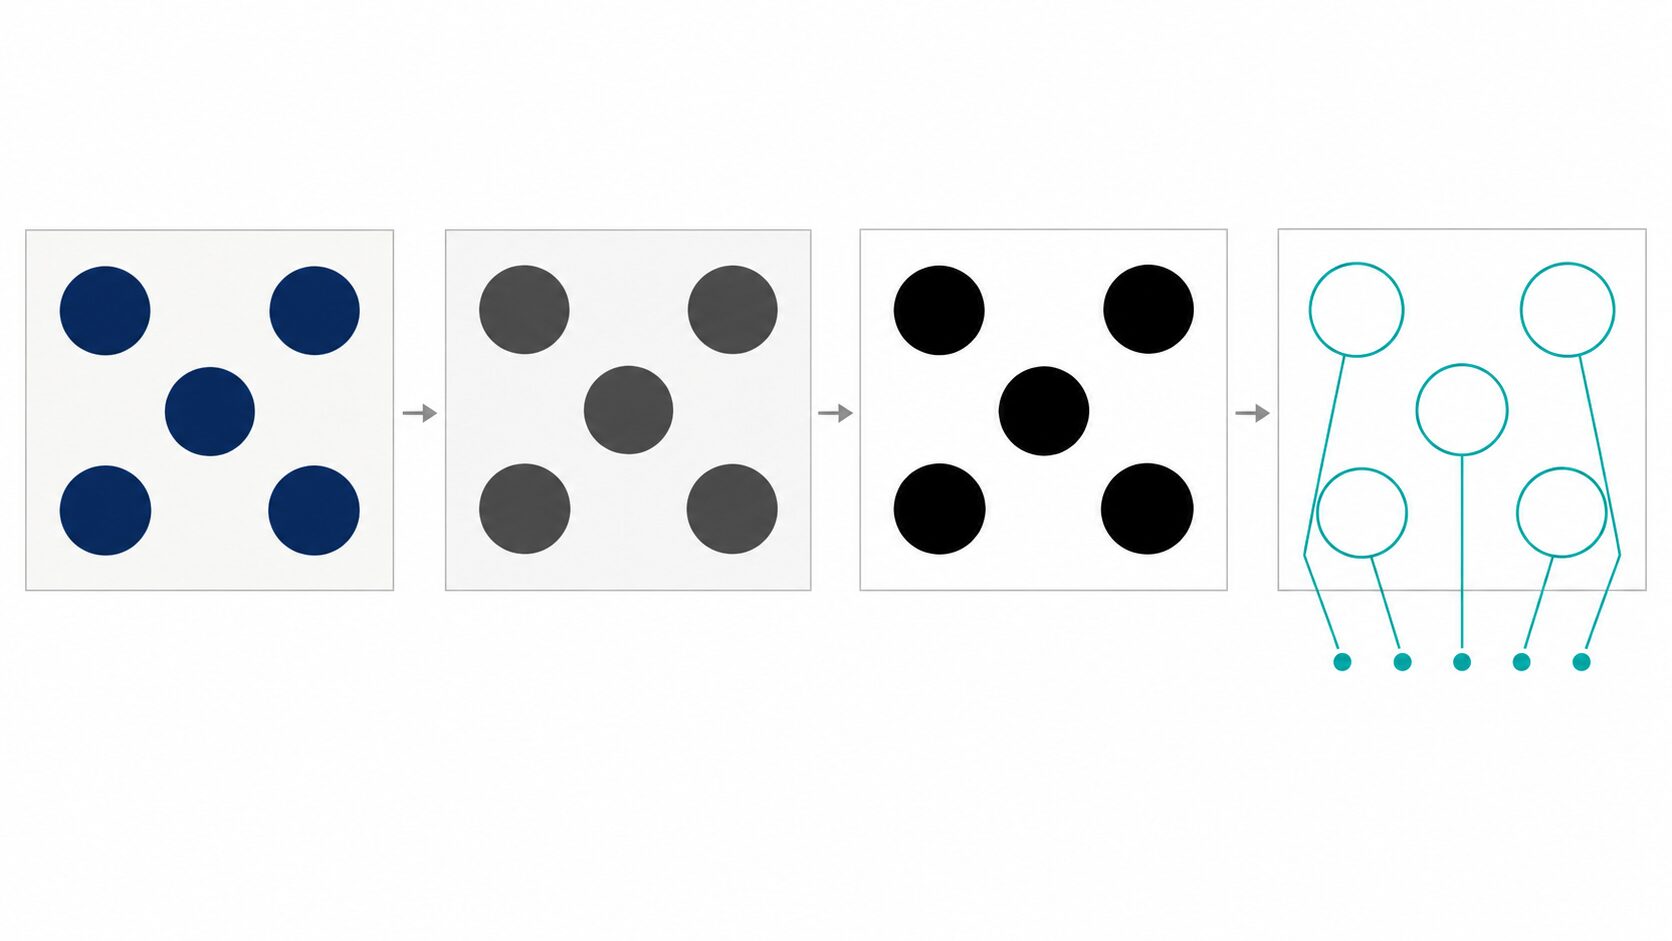
この方法が成り立つのは、背景と部品を明るさで分けられるからです。部品同士が接触すると一つの領域につながり、影が強ければ影まで部品として数えることがあります。また、部品の穴や背景の小さな汚れが輪郭として見つかる場合もあります。輪郭の数をそのまま正解とせず、対象の大きさや形に合う条件で絞り込むことが大切です。
OpenCVには、このほかにも目的に合わせて選べる機能があります。何のために使う処理なのかを把握すると、関数名を暗記するだけの場合より組み合わせを考えやすくなります。
| 機能 | 役割と使いどころ |
|---|---|
| 色変換 | グレースケールや色相・彩度などを扱う色空間へ変換し、明るさや特定の色に着目した処理につなげる。 |
| フィルタ処理 | 周囲の画素を使ってノイズを抑える。ただし、細い傷など必要な情報まで弱めないように調整する。 |
| エッジ検出 | 明るさが急に変わる場所を抽出する。形の手がかりになるが、物体の外周以外の模様にも反応する。 |
| 特徴点の抽出・照合 | 角や模様など、対応付けに使える点を探す。複数の画像の位置合わせや、対象の見え方の比較に利用する。 |
| カメラ補正 | 校正用の画像などからカメラの特性を求め、レンズによるゆがみの補正や計測の準備に使う。 |
動画は、時間順に並んだ静止画である「フレーム」の列として扱えます。フレームごとに対象を検出し、前後の情報を結び付ければ動きを追えます。ただし、画像の解像度、処理の複雑さ、機器の性能で速度は変わります。動画を読み込めることと、撮影速度に追い付いてリアルタイムで処理できることは別に確認する必要があります。
AI・機械学習との関係と役割の違い
OpenCVを使った画像処理が、すべてAIや機械学習に当たるわけではありません。例えば、先ほどの部品計測で「この明るさより暗い画素を取り出す」と指定する処理は、人が決めた条件に従って動きます。背景や撮影条件をそろえられる課題では、このような方法でも目的を達成できます。
機械学習では、データから判定に必要な規則やパラメータを学びます。深層学習はその一種で、ニューラルネットワークを使う方法です。見た目の変化が大きい物体の検出などで利用されますが、学習データと大きく異なる画像でも正しく判断できるとは限りません。モデルの用途と、実際に与える画像の条件を合わせる必要があります。
OpenCVには機械学習に関する機能や、対応する学習済みの深層学習モデルで推論を行う機能があります。「推論」とは、学習を終えたモデルに新しい入力を与えて結果を得ることです。一方、大規模な深層学習モデルを学習する工程では、PyTorchやTensorFlowなどの学習用の基盤が使われます。モデルを学習する役割と、そのモデルをアプリケーションで使う役割を分けて考えると理解しやすくなります。
例えば、OpenCVでカメラ画像を読み込み、モデルが必要とするサイズや色の順序に整え、推論後に検出位置を画像へ描画する構成が考えられます。モデルの実行もOpenCVで行える場合がありますが、モデル形式や内部の演算、実行環境が対応しているかの確認が必要です。
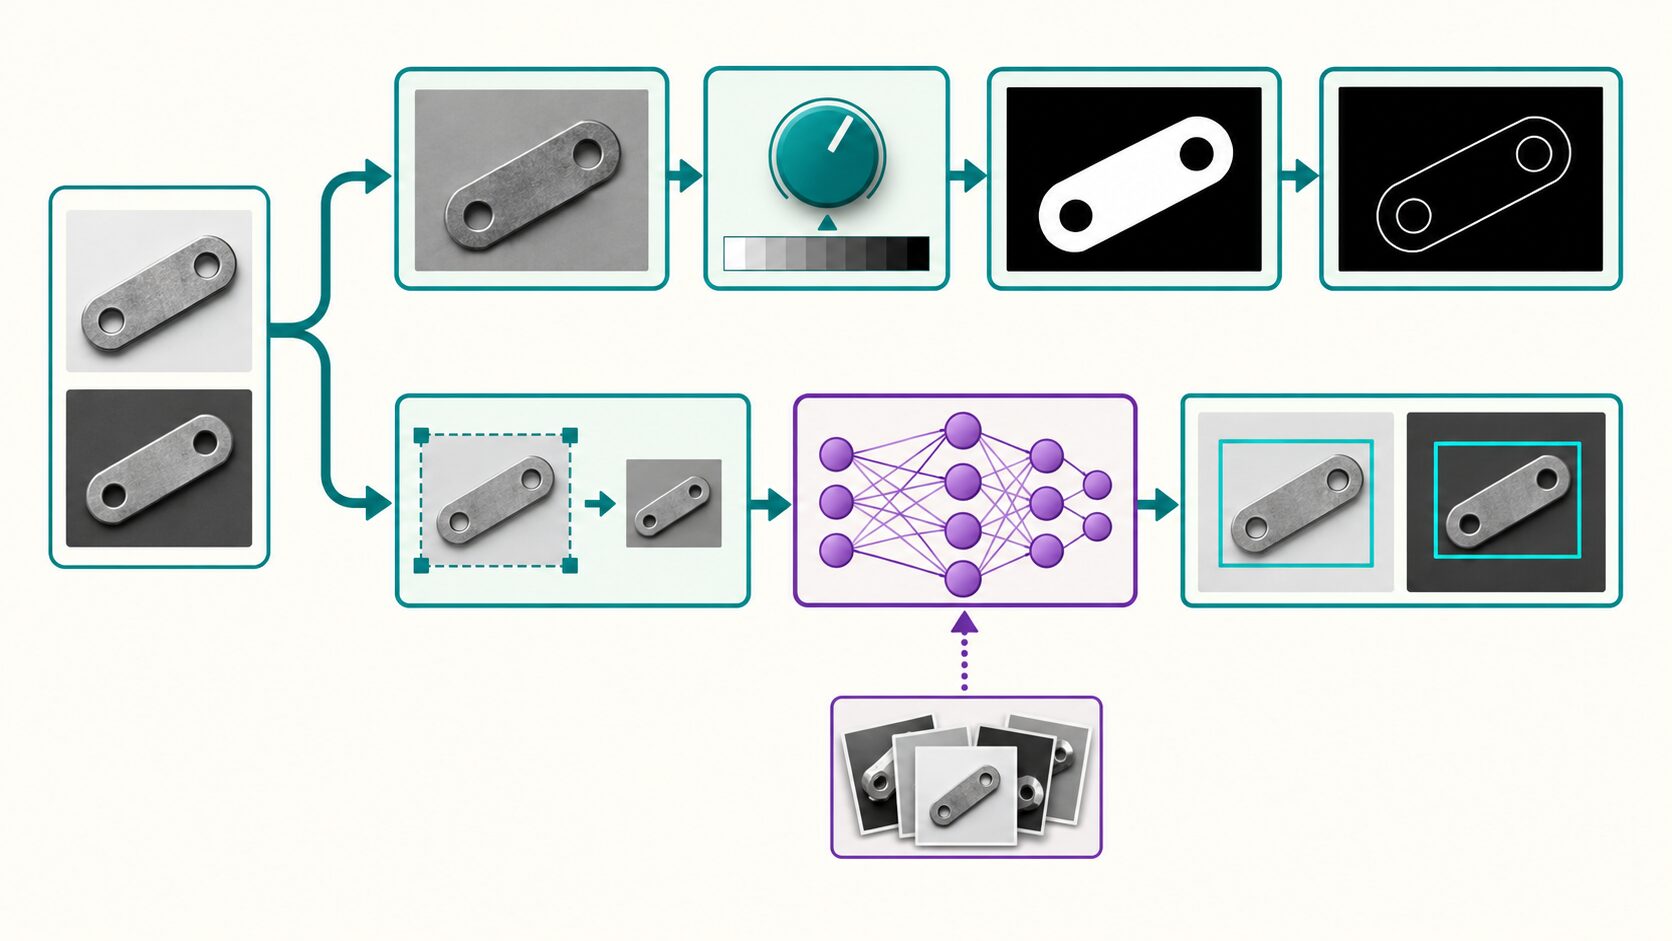
「画像認識」という言葉だけでは、求める結果が曖昧になりがちです。次のように出力を分けると、必要な処理やモデルを選びやすくなります。
| 課題 | 主な出力 | 具体例 |
|---|---|---|
| 画像分類 | 画像が属する種類や、その確からしさを表すスコア | 部品の写真を良品・不良品に分ける。 |
| 物体検出 | 対象の位置を示す枠、対象の種類、スコアなど | 映像内で人がいる場所を見つける。 |
| 追跡 | 時間を通じた対象の位置や、対象を区別するための番号 | 同じ人物の移動経路をフレーム間で追う。 |
顔についても、「顔がどこにあるか」を探す顔検出と、「誰の顔か」を判別する顔認識、登録された本人かを確かめる本人確認は異なります。顔の位置を囲めるだけでは、個人の識別はできません。目的に応じたモデルや登録データ、照合条件が必要で、動画の追跡番号もその人の実際の身元を表すものではありません。
製造・医療・カメラ映像での活用例
OpenCVの活用を考えるときは、「どの画像を入力し、何を処理して、どの情報を得るか」を具体化すると役割が見えてきます。業務システムでは、カメラ、学習済みモデル、判定ルール、人による確認などと組み合わせて使います。
| 分野 | 入力 | 処理の例 | 得られる情報 |
|---|---|---|---|
| 製造・品質管理 | 製品や部品を撮影した画像 | 輪郭抽出、基準画像との比較、傷や汚れの候補抽出 | 個数、寸法の推定値、確認が必要な箇所 |
| 医療画像の研究・解析支援 | X線、CT、MRIなどの画像 | ノイズ低減、画像の位置合わせ、関心領域の抽出 | 比較や計測に使う領域・特徴 |
| 監視カメラ・施設管理 | カメラの映像 | 人物検出、領域への進入判定、追跡 | 人の位置、通過人数、移動の傾向 |
| 自動運転・ロボット | 車両やロボットのカメラ画像 | カメラ補正、特徴点の対応付け、モデルと連携した周辺認識 | 位置推定や制御の判断材料となる視覚情報 |
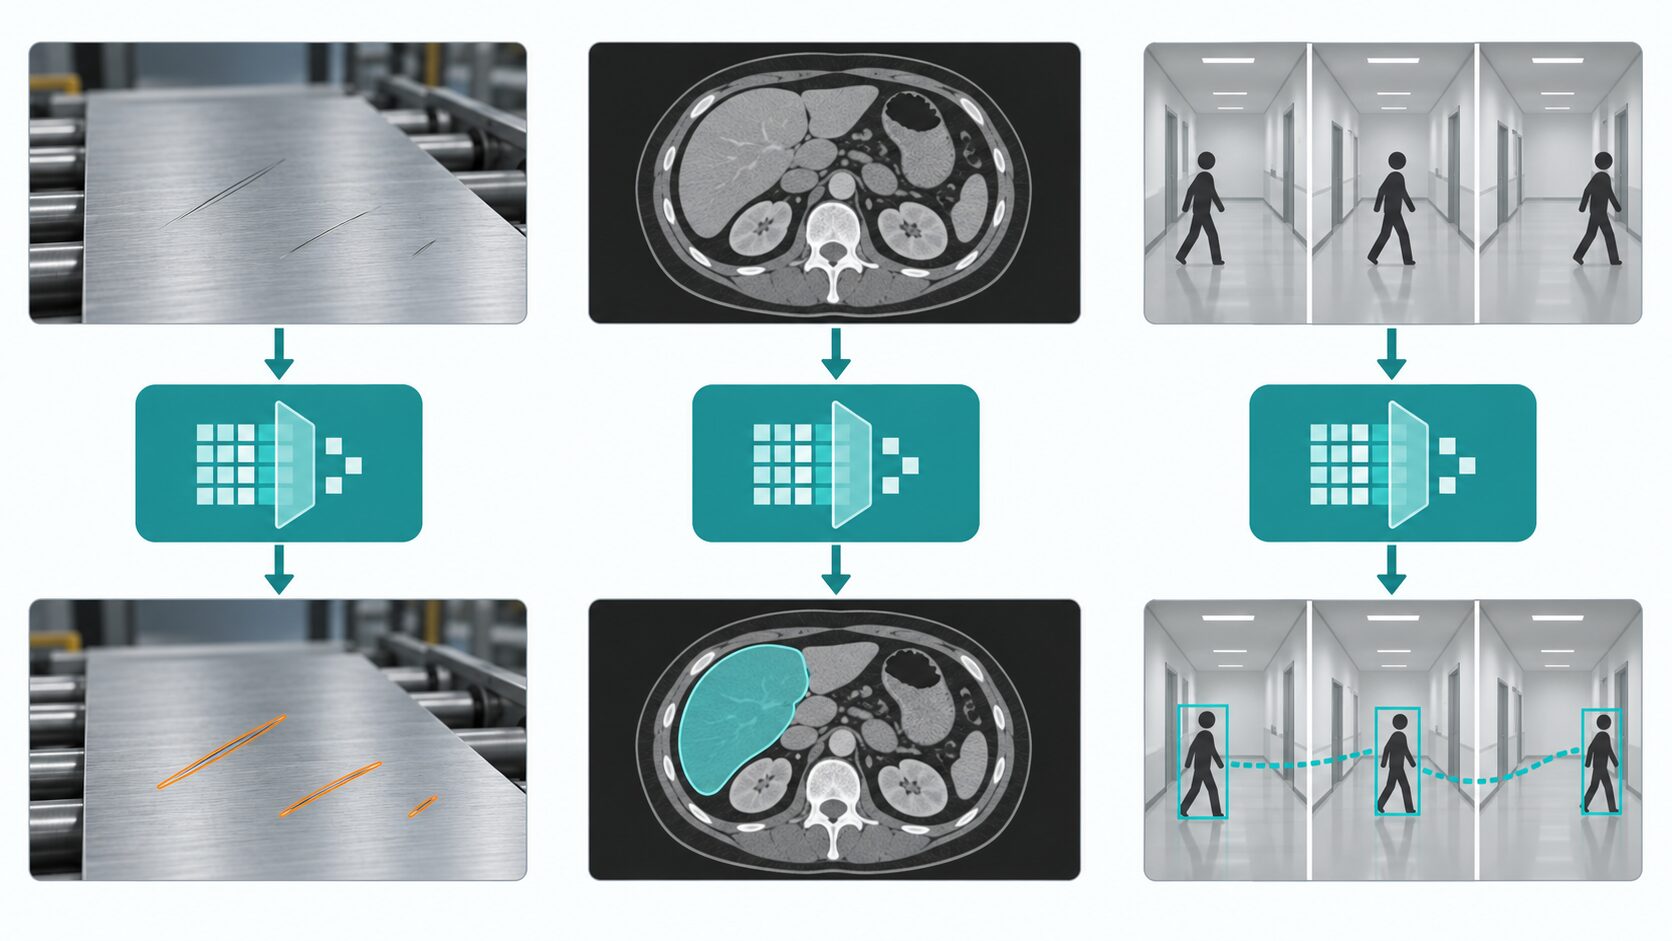
製造業では、同じ位置に固定したカメラと一定の照明を使えると、形状や表面の変化を比較しやすくなります。ただし、画像上の長さはまず画素数として得られます。実際のミリメートルへ換算するには、基準物や撮影距離、レンズのゆがみなどを考慮する必要があります。また、光の反射が傷に見えることもあるため、抽出した候補をどの条件で不良とするかは別に決めます。
医療では、画像の前処理や特定領域の抽出を、研究や解析支援の工程に組み込む用途があります。画像形式や画素値の意味を適切に扱うことが前提であり、見やすさを目的とした変換が計測に必要な情報を失わせる場合もあります。OpenCVの導入だけで診断精度の向上や病気の早期発見が保証されるわけではなく、用途に応じた専門的な評価が必要です。
カメラ映像から人の存在や移動を検出できても、その人が不審者かどうかを断定できるわけではありません。自動運転やロボットでも、画像から得た情報は判断材料の一部です。安全な動作には、ほかのセンサー、制御、異常時の対応を含むシステム全体の設計が関わります。
Pythonで使い始める手順
最初はPythonで一枚の画像を読み込み、変換して保存するところから始めると、処理の前後を確認しやすくなります。ここでは、Python 3とパッケージ管理ツールのpipが使える環境を前提にします。プロジェクトごとに仮想環境を作ると、ほかの作業で使うライブラリとの混在を避けやすくなります。
以下はPython 3をpythonコマンドで呼び出せる場合の例です。環境によっては、仮想環境を作る際にpython3などのコマンドを使います。作業用のフォルダーで、次のコマンドを実行します。
python -m venv .venv作成した仮想環境を有効にします。macOS・Linuxの一般的なシェルではsource .venv/bin/activate、Windowsのコマンドプロンプトでは.venv\Scripts\activate.batを使います。WindowsのPowerShellでは.\.venv\Scripts\Activate.ps1のように、使うシェルに応じてコマンドが異なります。
仮想環境を有効にした状態で、OpenCVのPython向けパッケージを導入します。次の二つ目のコマンドでバージョンが表示されれば、そのPythonからOpenCVを読み込めています。
python -m pip install opencv-python
python -c "import cv2; print(cv2.__version__)"pipで指定する配布パッケージ名はopencv-python、Pythonのコードで読み込む名前はcv2です。エディターやノートブックから実行する場合も、パッケージを入れた仮想環境のPythonを選びます。別のPythonを使うと、インストール済みでもモジュールが見つからないエラーになることがあります。
続いて、作業フォルダーにinput.jpgを置き、次のコードをfirst_opencv.pyとして保存します。同じフォルダーでpython first_opencv.pyを実行すると、元画像とは別名のoutput_gray.pngへグレースケール画像を保存します。
import cv2

image = cv2.imread("input.jpg")
if image is None:
    raise FileNotFoundError("input.jpgを読み込めません。場所や形式を確認してください。")

gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

if not cv2.imwrite("output_gray.png", gray):
    raise OSError("画像を保存できません。保存先や書き込み権限を確認してください。")
cv2.imreadは、画像を読み込めないとNoneを返すため、変換前に確認します。相対パスのinput.jpgは、基本的にプログラムを実行している作業フォルダーを基準に探されます。ファイル名の違い、実行場所、画像形式などを確かめると、読み込みに失敗した原因を絞り込めます。
色の順序にも注意が必要です。通常のカラー画像をOpenCVで読み込むと、青・緑・赤の順に並ぶBGRとして扱います。ほかの画像ライブラリやモデルが赤・緑・青のRGBを求める場合は、cv2.cvtColor(image, cv2.COLOR_BGR2RGB)などで変換します。この違いを見落とすと、表示色が変わったり、モデルに想定と異なる入力を渡したりします。
画面を表示しないサーバーなどでは、GUI機能を省いたopencv-python-headlessが選択肢になります。これは通常版に追加するのではなく、用途に応じて選ぶ配布パッケージです。通常版、headless版、追加モジュールを含むcontrib版などは同じcv2を提供するため、同じ環境へ重複して入れないようにします。上の例は表示用ウィンドウを使わず、ファイル保存で結果を確認できます。
Javaで利用する場合は、選ぶ配布物に応じてJava側の設定に加え、OSやCPUに合うネイティブライブラリの読み込み設定も確認します。MavenやGradleに依存関係を書くだけで、どの環境でも準備が完了するとは限りません。また、pipなどの管理ツールを使っても、導入済みのライブラリが常に自動更新されるわけではありません。更新は使用中のコードへの影響を確認しながら行います。
実用化で確認したい精度・速度・利用条件
サンプル画像で期待どおりに動いても、実際の撮影条件では結果が変わります。照明の強さや方向、背景の模様、カメラの角度、対象の重なりは、画素値や見える形を変えるためです。部品の計測なら、昼と夜、反射の強い面と弱い面、単独と接触した状態など、運用時に起こる条件で確かめます。
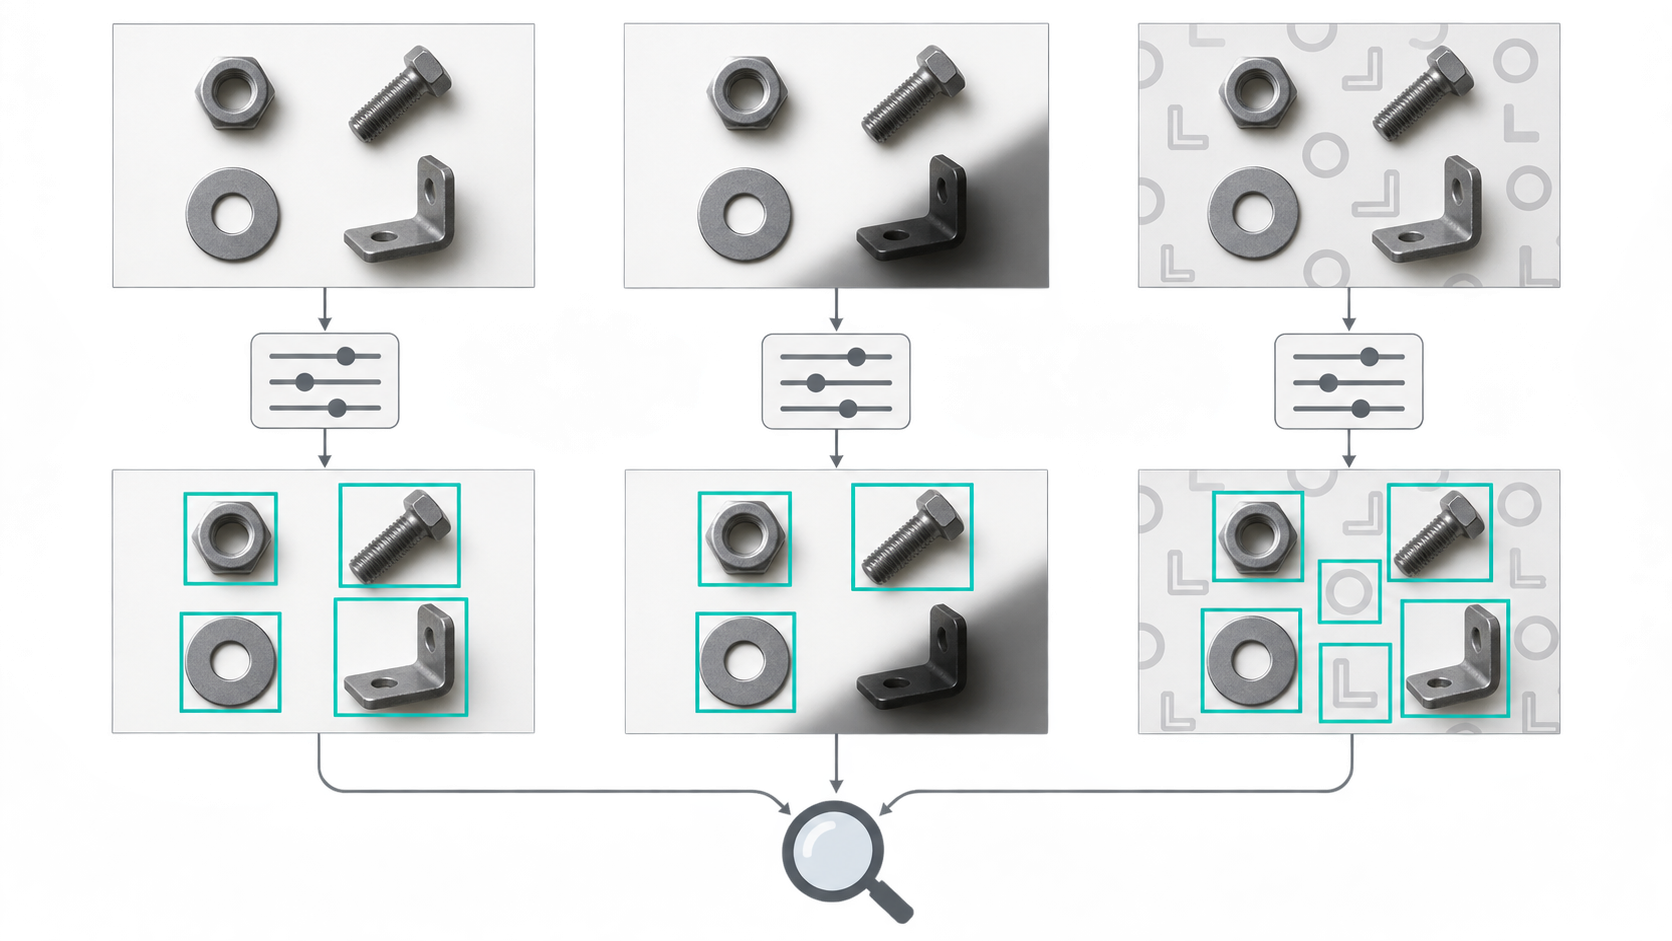
結果を評価するときは、対象があるのに見つけられない「見逃し」と、対象ではないものを拾う「誤検出」を分けます。しきい値を緩めて多くの候補を拾うと見逃しは減っても、余計な候補が増える場合があります。検査で何を見逃すと困るのか、確認担当者がどれだけ候補を調べられるのかによって、適切な設定は変わります。
比較用には、人が正解を確認した画像を用意し、設定を調整した画像とは別の画像でも性能を確かめます。失敗した画像を撮影条件と一緒に残すと、処理方法の改善が必要なのか、照明やカメラ位置を変えれば解決できるのかを判断しやすくなります。アルゴリズムを複雑にする前に、撮影条件を安定させることが有効な場合もあります。
リアルタイム性は、使う機器で画像取得から結果出力までの時間を測って判断します。例えば、毎秒30枚を逐次処理するなら、1枚当たり約33ミリ秒の処理時間が目安になります。ただし、読み込み、画像変換、推論、描画、通信などにも時間がかかります。平均の速さに加えて遅延や処理待ちが蓄積しないかを確かめ、必要なら解像度や処理する範囲を調整します。
医療や運転のように誤りが重大な影響につながる用途では、画像処理部分の性能だけでなく、システム全体の検証や異常時の対応が欠かせません。人を撮影する場合は、撮影目的、保存する範囲と期間、閲覧できる人なども運用の一部として決め、プライバシーに配慮します。
利用条件についても、無料であることと無条件に使えることは同じではありません。OpenCV本体を一律に「BSDライセンス」と説明せず、使用するバージョンに付属するライセンス文書を確認します。本体、同梱・追加するライブラリ、外部から入手した学習済みモデルやデータは、条件が別の場合があります。商用サービスや再配布を考える際には、それぞれの利用範囲や表示条件を確認しておく必要があります。
学習の進め方と広がる応用
学習の出発点には、利用しているOpenCVのバージョンに合う公式ドキュメントとサンプルが適しています。関数の説明では、引数だけでなく、入力画像の型や色の順序、返り値も確認します。まず一枚の画像で途中結果を保存し、どの処理がどこを変えたのかを見比べると、原因を追いやすくなります。
- 静止画の基本操作:読み込み、保存、サイズ変更、切り抜き、色変換を試します。画像の幅・高さや画素の値と、表示結果の関係をつかみます。
- 形や特徴の抽出:二値化、輪郭、エッジ、特徴点を扱います。しきい値などを一つずつ変え、結果が変化する理由を考えます。
- 動画とカメラ入力:フレームを繰り返し処理し、検出結果や処理時間を確認します。静止画では目立たなかった照明変化や動きの影響も調べます。
- モデルとの連携:分類や物体検出など、目的が明確なモデルを選びます。必要な前処理と出力の意味を確認し、手元の画像でも期待どおりに動くか評価します。
書籍やオンライン講座は、基礎から順序立てて学ぶときに役立ちます。動画教材は操作の流れを確認しやすく、コミュニティは環境に依存する問題を相談する場になります。個人ブログの解説も参考になりますが、公開時期や対象バージョンを確認し、古い関数の使い方をそのまま混ぜないようにします。
質問する際には、OS、PythonとOpenCVのバージョン、再現に必要な短いコード、入力画像の条件、エラーメッセージをそろえると状況が伝わります。仕事で扱う画像には機密や個人情報が含まれることがあるため、公開できるサンプル画像でも同じ問題が起こるか確認してから共有します。
応用先は、工場やカメラ映像に限りません。スポーツでは選手や道具の動きを調べる処理、農業では葉や果実の面積・色・個数の計測、モバイルやARではカメラ画像の補正や特徴の対応付けに利用できます。エンターテイメントでは、動きに合わせて表示を変える作品や、映像への効果の追加なども考えられます。
こうした応用には、AIモデルとの連携や処理速度の改善が役立ちます。ただし、画像から計測した値を競技の評価や収穫量の予測につなげるには、別のデータや評価方法が必要です。利用できる機能、端末の性能、撮影条件を踏まえて考えるべきであり、将来の成果や開発予定が保証されているわけではありません。
OpenCVを学ぶ第一歩は、「この画像から何を知りたいか」を一つ決めることです。部品を数える、色の違いを取り出す、動く対象を追うといった小さな課題で、入力、処理、結果を順に確かめていくと、画像処理の仕組みと実際の使いどころが結び付きます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月4日 | 部品計測の流れとPythonの実行例を加え、AIとの役割分担や利用条件を補足 |