その他

システムを守る番犬:ウォッチドッグタイマ

計算機組織は、様々な理由で誤作動を起こすことがあります。プログラムの欠陥や、思いがけない機械の故障など、組織の安定した動きを脅かす様々な問題が起こりうるからです。このような問題が起こると、組織が止まってしまったり、間違った動きをしてしまう可能性があります。このような事態を防ぐために、組織には「番犬」のような監視役が必要です。見張り時計は、まさにこの番犬の役割を果たす仕組みです。 組織が正常に動いている間は、見張り時計に定期的に合図を送ります。これは、見張り時計の針をリセットし続けることを意味します。もし組織が何らかの異常で止まったり、合図を送れなくなると、見張り時計の針は進み続けます。そして、一定の時間を過ぎると、見張り時計は時間を知らせ、組織を強制的に再起動させるのです。これは、ちょうど番犬が異常事態を察知して吠えるように、組織の異常を早期に発見し、対応を促す役割を果たします。 この仕組みのおかげで、組織の異常な状態が長く続くことを防ぎ、早期の回復を可能にします。例えば、工場の機械が突然停止した場合、見張り時計の仕組みがあれば、すぐに再起動を試みることができ、生産への影響を最小限に抑えられます。また、ネットワーク機器で通信が途絶えた場合も、見張り時計が自動的に再起動を試みることで、通信の復旧を早めることができます。このように、見張り時計は、計算機組織の安定稼働に欠かせない重要な役割を担っていると言えるでしょう。
アルゴリズム

ResNet:画像認識の革新

絵や写真を見てそれが何かを当てる人工知能の分野では、近年目覚ましい発展が見られています。その進歩を支える技術の一つに、畳み込みニューラルネットワークと呼ばれるものがあります。これは、人間の脳の仕組みを真似た情報処理のしくみで、層と呼ばれる部分を何層も重ねることで、複雑な形や模様を捉えることができます。層を深くすればするほど、より細かい特徴を捉え、認識の正確さを高めることができると考えられてきました。しかし、ただ層を重ねるだけでは、学習がうまく進まないという問題がありました。深い層に情報が届くまでに、だんだん薄れて消えてしまう、まるで遠くの音が聞こえなくなるような現象が起きるためです。これを勾配消失問題と呼びます。 この問題を解決するために、二〇一五年にマイクロソフト研究所のカイミン・ヒー氏によって、残差接続と呼ばれる新しい方法が考案されました。これは、幾つかの層を飛び越えて、手前の層からの情報を直接奥の層に伝える経路を作るという画期的な仕組みです。奥の層へは、飛び越えてきた情報と、幾つかの層を通ってきた情報の両方が届きます。これにより、層を深くしても情報が薄れて消えてしまうことを防ぎ、学習をうまく進めることができます。残差接続を導入したニューラルネットワークは、残差ネットワークと呼ばれ、画像認識の分野に大きな革新をもたらしました。残差ネットワークは、層を深くしても学習が安定し、高い認識精度を達成できるため、現在では様々な画像認識の課題に応用されています。まさに、人工知能の分野における、重要な技術の一つと言えるでしょう。
学習

k分割交差検証とは?5分割・10分割の仕組みと精度評価をわかりやすく解説

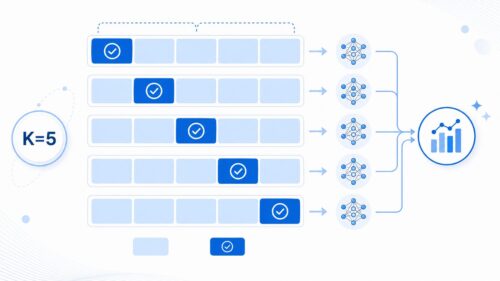
機械学習の模型の良し悪しを見極める作業は、限られた資料をうまく活用するために欠かせません。様々な手法がありますが、その中で「交差検証」と呼ばれるやり方は、模型の本当の力をより正確に測るための優れた方法です。特に、資料を均等に分割して検証する「k分割交差検証」は、広く使われています。 この手法では、まず手元にある資料を同じ大きさのk個のグループに分けます。たとえば、資料が100個あって、kを5に設定すると、20個ずつのグループが5つできます。次に、これらのグループの中から一つを選び、これを試験用の資料として取っておきます。残りのk-1個のグループは全てまとめて、模型の訓練に使います。kが5の場合は、5つのグループのうち1つを試験用、残りの4つを訓練用とするわけです。 この訓練と試験をk回繰り返します。k回目の検証が終わる頃には、それぞれのグループが一度ずつ試験用の資料として使われたことになります。つまり、全ての資料が模型の訓練と試験の両方に役立ったことになり、限られた資料を無駄なく使えるわけです。 分割数であるkの値は、状況に合わせて自由に決めることができます。ただし、一般的には5か10が使われることが多いです。kの値が小さいと、検証の回数が少なくなり、計算の手間は省けますが、検証結果のばらつきが大きくなる可能性があります。逆にkの値が大きいと、検証の精度が上がりますが、計算に時間がかかります。k分割交差検証を使うことで、限られた資料を最大限に活かし、模型の性能をより確実に見積もることができます。
動画生成

Renderforestとは?動画作成の使い方・AIロゴ機能・注意点を解説

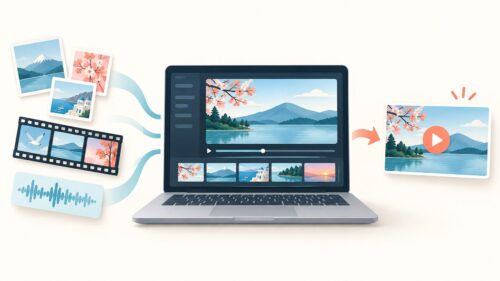
動画の利用が増えている今の時代、動画作りは会社から個人の趣味まで、色々なところで大切になっています。動画は商品の宣伝や説明、教育、娯楽など、様々な目的で活用され、情報伝達の手段として非常に効果的です。しかし、動画を作るための編集ソフトは、専門的な知識や技術が必要なものが多く、使いこなすのが難しいという声もよく聞かれます。 そのような中、誰でも手軽に高品質な動画を作れるオンライン動画編集のサービスが注目を集めています。インターネットにつながったパソコンがあれば、ソフトをインストールする手間もなく、すぐに動画編集を始められます。これらのサービスは、初心者でも直感的に操作できるよう設計されており、動画編集の経験がない人でも、まるで積み木を組み立てるように簡単に動画を作成できます。 数あるオンライン動画編集サービスの中でも、RenderForestは豊富なデザインのひな形と分かりやすい操作方法で人気です。あらかじめ用意された様々な種類のひな形を使うことで、動画の構成を考える時間や手間を省き、写真や動画、音楽などの素材を組み合わせるだけで、プロが作ったような動画を短時間で完成させることができます。また、RenderForestは、動画編集に必要な機能が豊富に揃っていることも魅力の一つです。例えば、文字入れ、音楽の追加、動画の切り取り、効果音の追加など、様々な編集作業を簡単に行うことができます。さらに、作った動画はすぐにインターネット上に公開したり、パソコンに保存したりすることも可能です。 この記事では、RenderForestの便利な機能や特徴、そしてRenderForestを使うメリットについて、さらに詳しく説明していきます。動画編集に慣れていない初心者の方から、もっと手軽に動画を作りたいと考えている経験者の方まで、RenderForestの魅力を理解し、動画制作の可能性を広げるためのお手伝いをさせていただきます。
AI活用

予測の精度低下:ラベルドリフトとは

機械学習は、まるで人間の学習のように、与えられた情報から規則性を見つけて、将来を予測する技術です。大量の情報から自動的に規則性を学ぶことができるため、様々な分野で活用されています。例えば、商品の売れ行き予測や、病気の診断支援など、私たちの生活を豊かにする可能性を秘めています。 しかし、機械学習にも弱点があります。現実の世界は常に変化しており、一度学習した規則が、時間の経過とともに役に立たなくなることがあります。これは、まるで一度覚えた知識が、時代の変化とともに通用しなくなるのと同じです。 特に「ラベルドリフト」と呼ばれる現象は、機械学習における大きな課題です。ラベルドリフトとは、予測したいものと、それに影響を与えるものとの関係性が変化することを指します。例えば、ある商品の売れ行きを予測するモデルを考えてみましょう。過去には、気温が高い日に売上が伸びていたとします。しかし、消費者の嗜好が変化し、気温が高い日には別の商品が売れるようになり、元の商品の売上は下がったとします。このように、予測したいもの(商品の売上)と、それに影響を与えるもの(気温)との関係が変わってしまうと、過去の情報に基づいて学習したモデルは正確な予測ができなくなってしまいます。 ラベルドリフトへの対策は、機械学習モデルを正しく運用するために不可欠です。対策を怠ると、予測の精度が下がり、ビジネスに悪影響を与える可能性があります。例えば、商品の売れ行き予測が外れると、過剰な在庫を抱えてしまったり、逆に品不足に陥ったりする可能性があります。そのため、常に変化する状況に合わせて、モデルを更新していく必要があります。まるで、常に新しい知識を学び続ける必要があるのと同じです。
LLM

AIのスケーリング則とは?仕組み・数式・限界を初心者向けに解説

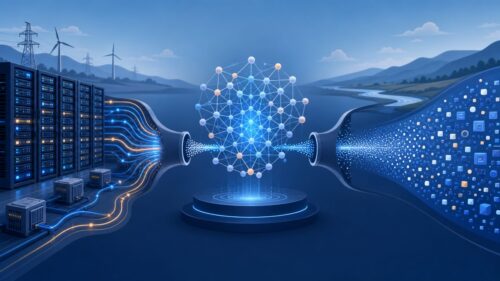
「規模の法則」とも呼ばれるスケーリング則は、人工知能モデルの性能向上が、モデルの規模拡大とどのように関係しているかを示す重要な法則です。この法則は、モデルの性能に影響を与える要素を数学的に表しています。具体的には、モデルの中に含まれるパラメータの数、学習に使うデータの量、そして計算に使う資源の量が、モデルの精度にどのように関わってくるかを説明します。 一般的に、これらの要素を増やすほど、モデルの誤りは少なくなります。そして、この減少の仕方は、対数スケールで見るとほぼ比例関係にあることが分かっています。つまり、パラメータの数やデータ量、計算資源などを10倍に増やすと、誤りは一定の割合で減るのです。例えば、誤りが半分に減るのに必要な規模の増加量が分かれば、さらに誤りを半分に減らすのに必要な増加量も同じだけだと予測できます。 この比例関係は、冪乗則と呼ばれています。冪乗則は、ある変数の変化が、他の変数の変化にどのように影響するかを表す法則で、人工知能の分野では特に重要な役割を果たします。スケーリング則は、この冪乗則を用いて表現されます。 スケーリング則を理解することで、より高性能な人工知能モデルを開発するために必要な資源を予測することができます。例えば、目標とする精度を達成するためには、どれだけのデータが必要か、どれだけの計算資源を用意すれば良いのかを、ある程度の精度で見積もることが可能になります。このため、スケーリング則は、人工知能研究において重要な指針となっています。近年、大規模言語モデルの開発が盛んですが、スケーリング則は、こうした巨大なモデルの設計や性能予測にも役立っています。 より多くのデータで、より大きなモデルを学習させることで、どこまで性能が向上するかを予測し、開発の指針とすることができます。
その他

ウォークスルー法で品質向上

ウォークスルー法とは、開発した仕組や仕事の手順をより良くするために、情報がどのように作られ、扱われ、最後にどのように使われるのか、その全行程を細かく調べる方法です。まるで情報の旅路を始まりから終わりまで追いかけるように、徹底的に調べます。 この方法は大きく分けて二つのやり方があります。一つは机上で行う、書類を使った確認方法です。もう一つは実際に仕組を動かして行う、実践的な確認方法です。 書類を使った確認では、情報の動きを図にして分かりやすくしたり、関係者同士で情報のやり取りの手順を文書で共有したりします。このようにして、実際に動かしてみる前に、書類上で問題点を見つけ出すことができます。例えば、情報が不足している部分や、手順に無駄がある部分などを見つけ、改善につなげることができます。 一方、実践的な確認では、試験用の情報を使って実際に仕組を動かしてみます。そして、情報が正しく処理されているか、思った通りの結果が出ているかを確認します。この方法では、机上で考えるだけでは気づきにくい問題点も見つけることができます。例えば、処理速度が遅すぎる、あるいは操作手順が分かりにくいといった問題を発見することができます。 このように、ウォークスルー法は二つの方法を組み合わせることで、仕組や仕事の手順の質を高めるために役立ちます。開発の初期段階で問題点を見つけることで、後になって大きな問題になるのを防ぎ、開発にかかる時間や費用を節約することにもつながります。
アルゴリズム

回帰分析:未来予測の強力な手法

回帰分析とは、ある数値と別の数値の関係性を調べて、一方の数値からもう一方の数値を予測するための統計的な手法です。例えば、日々の気温とアイスクリームの売上の関係を考えると、気温が高いほどアイスクリームの売上も増える傾向があると予想されます。回帰分析を使うことで、この関係性を数値的に捉え、気温からアイスクリームの売上を予測することができるようになります。 回帰分析は、教師あり機械学習という分野でよく使われています。教師あり機械学習とは、過去のデータから規則性やパターンを学び、それを元に未知のデータについて予測を行う手法のことです。回帰分析では、過去のデータにおける数値の関係性を分析し、その関係性を表す数式(モデル)を作ります。この数式を用いることで、新たな数値が与えられた際に、対応する数値を予測することが可能になります。 回帰分析には様々な種類がありますが、最も基本的なものは線形回帰分析です。線形回帰分析は、二つの数値の関係性を直線で表そうとする手法です。気温とアイスクリームの売上の例で言えば、気温を横軸、売上を縦軸としたグラフ上に点をプロットし、それらの点に最もフィットする直線を求めます。この直線が、気温と売上の関係性を表すモデルとなります。 回帰分析は、様々な分野で広く活用されています。例えば、企業では将来の売上予測や需要予測、株価予測などに用いられています。また、医療分野では、患者の症状から病気の進行を予測したり、治療の効果を予測したりする際に利用されています。さらに、科学研究では、実験データの分析や現象の予測にも活用されています。このように、回帰分析はデータに基づいて未来を予測するための強力なツールであり、様々な分野で重要な役割を担っています。
WEBサービス

ウェルノウンポート番号とは?意味・仕組み・代表例を初心者向けに解説

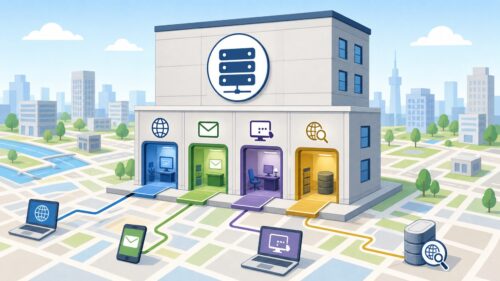
インターネットの世界では、たくさんの計算機が情報をやり取りしています。この情報の流れを整理し、正しく届けるためには、宛先を特定する住所のようなものが必要です。計算機の位置を示すのがインターネット位置情報(IPアドレス)ですが、一つの計算機の中で、同時に複数の処理が動いていることがよくあります。例えば、電子郵便を受け取ったり、情報を閲覧したり、同時に様々な活動をしています。どの処理に情報を送れば良いのかを区別するために、インターネット位置情報に加えて、送り先を示す番号が必要になります。これが、話題にしている送り先番号です。 例え話で考えてみましょう。大きな集合住宅を考えてみてください。この集合住宅の住所はインターネット位置情報と同じです。しかし、この住所だけでは、どの部屋の住人に荷物を届けたら良いのか分かりません。そこで、各部屋に番号が振られています。これが送り先番号と同じ役割です。インターネット位置情報で計算機を特定し、さらに送り先番号でその計算機の中で動いている特定の処理を指定することで、情報が正しく届く仕組みになっています。 よく使われる送り先番号には、それぞれ役割が決まっています。例えば、情報を閲覧するための処理には80番、電子郵便を受け取る処理には、状況に応じて110番や995番などが使われます。これらの番号は、インターネットの世界で共通に使われており、あらかじめ決められています。このように、送り先番号はインターネット上で情報を正しくやり取りするために欠かせない役割を果たしているのです。
LLM

データセット量の重要性:AIモデルの性能向上

近ごろの人工知能、特に言葉を扱う大きな模型の進歩には目を見張るものがあります。この進歩を支える柱の一つが、学習に使う資料の量です。模型の学習には、人間が学ぶ時の教科書のように、たくさんの資料が必要です。そして、近年の研究で、資料の量を増やすと同時に、模型の大きさも大きくすることで、模型の働きが良くなることが分かりました。これは、まるで人が多くの経験を積むことで賢くなるように、人工知能も資料という経験を通して成長を遂げていると言えるでしょう。 この法則は、量の増減の関係を示す法則として知られており、模型の規模と資料の量の両方を大きくすることで、模型の働きを向上させることができるとされています。模型が大きくなると、より複雑な事柄を理解する能力が高まります。しかし、同時に多くの資料が必要になります。資料が少ないと、模型は十分に学習できず、その能力を発揮できません。ちょうど、大きな器を用意しても、注ぐ水が少なければ器は満たされないのと同じです。 多くの資料から学ぶことで、模型は物事の複雑な繋がりや細かい違いを理解できるようになります。例えば、言葉を扱う模型の場合、多くの文章を読むことで、言葉の意味や使い方、言葉同士の関係などを深く理解し、より自然で正確な文章を作り出せるようになります。これは、人が多くの本を読むことで語彙や表現力が豊かになり、より洗練された文章を書けるようになるのと似ています。 人工知能の学習は、人間が学ぶ過程とよく似ています。人間は多くの経験を通して知識や技能を習得し、成長していきます。人工知能もまた、資料という経験を通して学習し、その働きを向上させています。今後、さらに多くの資料を用いた学習が進めば、人工知能はさらに高度な能力を獲得し、私たちの生活をより豊かにしてくれることでしょう。
アルゴリズム

バンディットアルゴリズムとは?探索と活用を初心者向けに解説

近頃では、誰もが手軽に情報を得たり、発信したりできるようになりました。その結果、様々な情報やデータが溢れかえっています。これらをうまく活用することで、私たちの暮らしは便利になり、より豊かなものへと変化しています。しかし、新しい商品やサービスを作ろうとするとき、必ずしも十分な情報やデータがあるとは限りません。むしろ、情報がほとんどない状態から開発を始めなければならないことも珍しくありません。 このような、情報が不足している状況で、どのようにすれば最適な方法を見つけられるのでしょうか。限られた情報から、試行錯誤を通じて最良の選択を探っていく方法の一つとして、「バンディットアルゴリズム」と呼ばれる手法が注目されています。バンディットアルゴリズムは、元々カジノにあるスロットマシン、通称「ワンハンド・バンディット」に由来します。複数のスロットマシンから、どのマシンで遊べば最も多くの報酬を得られるかを、限られた試行回数で見つけるという問題です。 この考え方を応用すれば、様々な場面で最適な選択を見つけるのに役立ちます。例えば、ウェブサイトに複数の広告を掲載する場合を考えてみましょう。どの広告が最も効果的かは、実際に表示してみなければわかりません。しかし、表示回数を無駄にすることなく、最もクリックされる可能性の高い広告を見つけたいところです。このような状況で、バンディットアルゴリズムは効果を発揮します。限られた表示回数の中で、様々な広告を試しながら、クリック率の高い広告に絞り込んでいくことで、全体的なクリック数を最大化することができるのです。 このように、バンディットアルゴリズムは、情報が不足している状況下でも、探索と活用のバランスを取りながら、最適な選択を見つけるための強力な道具となります。限られた情報から最良の結果を導き出すために、様々な分野で活用が期待されています。
学習

ラベル:データに意味を与えるタグ

ラベルとは、データに添えられる付箋のようなもので、データの意味や内容を示す情報のことです。 これは、人間がデータの内容を機械に理解させるための重要な役割を果たします。まるで、データに名前を付けて分類整理するようなものです。 例えば、写真に「ねこ」というラベルを付けると、その写真はねこが写っていることを示します。音声データに「おはようございます」というラベルを付けると、それは朝の挨拶であることが分かります。このようにラベルは、データが何を表しているのかを明確に示す目印となります。 機械学習では、このラベルを使ってデータのパターンや特徴を学習します。大量のデータにラベルを付けて学習させることで、機械はラベルとデータの特徴を結びつけて理解していきます。例えば、たくさんの「ねこ」とラベル付けされた画像を学習することで、機械はねこの特徴を理解し、ラベルのない新しい画像を見てもねこを認識できるようになります。 ラベルがないと、機械はデータの内容を理解することができません。 例えば、たくさんの写真を見せても、どの写真がねこで、どの写真がそうでないかを判断できません。ラベルがあることで、機械はデータの特徴を捉え、分類や識別、予測などの処理を行うことができます。 ラベルの質は、機械学習の精度に大きく影響します。正確なラベル付けがされていれば、精度の高いモデルを作ることができます。しかし、ラベルが間違っていたり、あいまいだったりすると、モデルの精度が低下する可能性があります。そのため、ラベル付けは機械学習において非常に重要な作業と言えます。大量のデータを扱う際には、ラベル付け作業の自動化なども行われます。
アルゴリズム

再現率:機械学習の精度を測る

「再現率」とは、機械学習の出来栄えを測る物差しの一つで、見つけ出すべきものを見つける能力を表す数値です。たとえば、病気の人を診断する機械があるとします。実際に病気の人がいる中で、機械が正しく病気だと判断できた人の割合が再現率です。言い換えると、本当に病気の人を見落とさずに、どれだけ捉えられているかを示す大切な数値です。 この数値は、0から1までの間の値で表され、1に近いほど性能が良いとされます。理想的には1、つまり100%を目指しますが、現実的には他の要素との兼ね合いも考える必要があるため、必ずしも100%を目指すことが最良とは限りません。たとえば、病気ではない人を誤って病気と診断してしまう可能性も考慮に入れる必要があります。 再現率が高いほど、見落としは少なくなりますが、その分、本来は病気ではない人を病気と診断する可能性も高まることがあるのです。これは、魚を捕る網の目を大きくする様子に似ています。網の目を大きくすれば多くの魚を捕まえられますが、同時に小さな魚も逃してしまいます。逆に、網の目を小さくすれば小さな魚も捕まえられますが、大きな魚は網にかかりません。つまり、状況に応じて適切な網の目、つまり適切な再現率を設定する必要があるのです。 具体的な例として、迷惑メールの判別を考えてみましょう。再現率の高い判別機は、ほとんどの迷惑メールを正しく迷惑メールと判断できます。しかし、普通のメールを迷惑メールと誤って判断する可能性も高くなります。逆に、再現率の低い判別機は、普通のメールを誤って迷惑メールと判断する可能性は低くなりますが、多くの迷惑メールを見逃してしまう可能性があります。このように、再現率は、他の要素とのバランスを考えながら調整する必要がある大切な指標です。
その他

ウェアレベリングとは?SSDの寿命を延ばす仕組みと静的・動的の違い

近頃は、携帯電話や薄型軽量の記憶装置など、様々な機器で情報の記憶にフラッシュメモリが使われています。この記憶装置は、小さくてたくさんの情報を記憶できる上に、情報の読み書きが速いという長所を持っています。しかし、何度も書き換えられる回数に限りがあるという短所も抱えています。 同じ場所に何度も書き込みを繰り返すと、その部分だけが早く劣化してしまい、記憶装置全体の寿命を縮めてしまうのです。たとえば、携帯電話の電話帳のように、頻繁に更新される情報が常に同じ場所に保存されていると、その場所だけが早く使えなくなってしまう可能性があります。記憶装置全体はまだ使えるのに、一部が壊れただけで全体が使えなくなってしまうのは、とてももったいないことです。 そこで活躍するのが、書き込み回数の平準化と呼ばれる技術です。この技術は、書き込みを記憶装置全体に均等に分散させることで、一部分だけが早く劣化するのを防ぎます。ちょうど、畑全体を均一に耕すように、記憶装置のあらゆる場所に書き込みを分散させることで、記憶装置全体の寿命を延ばすことができるのです。 この技術のおかげで、特定の場所に書き込みが集中することによる劣化を防ぎ、記憶装置を長く使えるようになります。つまり、私たちが安心して携帯電話や薄型軽量の記憶装置を使えるのは、この書き込み回数の平準化技術のおかげと言えるでしょう。この技術は、小さな記憶装置から大きな記憶装置まで幅広く使われており、私たちの生活を支える電子機器の信頼性を高める上で重要な役割を果たしています。
LLM

推論を速く賢く:効率化の秘訣

皆様、初めまして。近頃、様々な場所で話題となっている生成人工知能。まるで魔法のように、様々な問いに答えたり、絵を描いたり、文章を綴ったりと、目覚ましい発展を遂げています。この技術は、私たちの暮らしを大きく変える可能性を秘めています。では、一体どのようにして、人工知能はまるで人間のように考え、判断を下しているのでしょうか。その秘密は「推論」と呼ばれる仕組みにあります。 人工知能は、大量のデータを読み込むことで学習し、その知識を基に、未知のデータに対して予測や判断を行います。これが推論です。例えば、多くの猫の画像を学習した人工知能は、初めて見る猫の画像に対しても「これは猫だ」と判断できます。まるで人間が経験から学ぶように、人工知能もデータから学び、推論することで賢くなっていきます。 この推論をより速く、より少ない計算資源で行うことが、人工知能技術を更に発展させる鍵となります。推論の効率化とは、まさにこの推論にかかる時間と計算資源を節約しながら、精度の高い結果を得るための技術です。もし推論の効率が上がれば、今よりももっと速く、複雑な問題にも対応できる人工知能が実現するでしょう。 資源の節約という観点も重要です。人工知能の推論には、多くの計算機と電力が使われます。推論の効率化は、これらの資源の消費を抑えることにも繋がります。これからの社会にとって、環境への負荷を軽減することは重要な課題です。推論の効率化は、地球環境を守る上でも大きな役割を果たすと言えるでしょう。 本稿では、これから推論の効率化とは何か、なぜ重要なのか、そして具体的な方法について、分かりやすく解説していきます。人工知能の未来を担う重要な技術、推論の効率化について、一緒に学んでいきましょう。
アルゴリズム

ラッソ回帰:スパースなモデル推定

{ラッソ回帰とは、統計学や機械学習の分野で、予測のために使われる手法です。}たくさんのデータから、ある値を予測したい時に役立ちます。例えば、家の広さや築年数から家の価格を予測したり、気温や湿度からアイスクリームの売上を予測したりするといった具合です。 ラッソ回帰は、重回帰分析という手法とよく似ています。重回帰分析では、予測したい値に影響を与える要素(説明変数)それぞれに、どれくらい影響力があるかを示す重み付けを行います。しかし、説明変数が多すぎると、重回帰分析では複雑すぎる予測モデルを作ってしまい、学習データにはよく当てはまるのに、新しいデータにはうまく当てはまらないという問題が起こることがあります。これは、まるで試験勉強で過去問だけを完璧に覚えて、新しい問題に対応できないような状態です。このような現象を過学習といいます。 ラッソ回帰は、この過学習を防ぐための工夫がされています。具体的には、重み付けの値をなるべく小さくするように調整します。不要な説明変数の重み付けはゼロに近づき、本当に必要な説明変数だけが残るため、予測モデルをシンプルにすることができます。これは、試験勉強で重要なポイントだけを絞って学習するようなものです。 このように、ラッソ回帰は過学習を防ぎ、新しいデータにも対応できる、汎化性能の高い予測モデルを構築するのに役立ちます。そのため、様々な分野で活用されているのです。
アルゴリズム

マルコフ決定過程モデル:未来予測

人は昔から、この先何が起こるかを知りたいと願ってきました。空模様や景気の動向、病気の経過など、未来を予想することは、私たちの暮らしに欠かせません。そうした中で、これから起こる不確かな出来事を踏まえて、より良い判断をするための方法として、マルコフ決定過程モデルというものに注目が集まっています。 このモデルは、現在の状況を把握し、それに基づいて最も良い行動を選ぶことで、将来の望ましい状態へ導くための指針を示してくれます。天気予報を例に考えてみましょう。明日の天気が晴れか雨かによって、傘を持っていくかどうかを判断します。現在の状況(今日の天気や気圧配置など)から明日の天気を予測し、雨が降る確率が高いと判断した場合、傘を持っていくという行動を選びます。これがマルコフ決定過程モデルの基本的な考え方です。 このモデルは、様々な分野で応用されています。ロボットの制御では、周囲の環境を認識し、最適な動作を選択することで目的を達成するために利用されます。また、在庫管理では、将来の需要を予測し、最適な発注量を決定することで在庫切れや過剰在庫を防ぎます。さらに、医療分野では、患者の状態に基づいて最適な治療方針を決定する際にも役立ちます。 マルコフ決定過程モデルの重要な特徴は、過去の履歴を考慮しないという点です。つまり、現在の状態だけに着目し、過去の状態は意思決定に影響を与えません。これは、過去の情報が必ずしも将来の予測に役立つとは限らないという考え方に基づいています。例えば、今日が晴れでも、明日が必ず晴れとは限りません。過去の天気の情報よりも、現在の気象状況を把握する方が、明日の天気を正確に予測するために重要です。このように、マルコフ決定過程モデルは、限られた情報からでも最適な意思決定を行うことを可能にする強力なツールと言えるでしょう。
その他

安全を守る仕組み:インタロック

機械や装置を安全に使うために、なくてはならない仕組み、それがインタロックです。インタロックは、あらかじめ決められた安全条件が満たされるまで、装置の動作を止める安全装置です。危険な動作が始まる前に、安全確認を行うことで、事故を防ぎます。 例えば、工場にある大きなプレス機を考えてみましょう。プレス機は大きな力を加えて金属を加工しますが、作業中に手を入れてしまうと大変危険です。そこで、インタロックが活躍します。安全扉が完全に閉まっていないと、プレス機は絶対に動きません。扉が開いている間は、電気の流れを遮断するなどして、機械の動作を物理的に不可能にします。作業者が安全扉を開けて作業エリアに入ると、機械は自動的に停止し、作業者の安全を確保します。 インタロックは工場だけでなく、私たちの日常生活でも見られます。電子レンジを想像してみてください。扉が開いている状態で動作すると、マイクロ波が外に漏れ出て危険です。これを防ぐため、電子レンジにはインタロックが組み込まれており、扉が開いている間はマイクロ波の発生を抑えます。また、洗濯機も蓋が開いていると脱水が始まりません。これもインタロックによるものです。高速回転する脱水槽に誤って触れてしまう事故を防ぎます。 このように、インタロックは様々な場面で私たちの安全を守っています。エレベーターの扉が閉まらないと動かないのも、電車のドアが完全に閉まるまで発車しないのも、インタロックのおかげです。一見、単純な仕組みですが、安全性を最優先に考えた設計思想に基づいて作られており、私たちの生活に欠かせない重要な技術と言えるでしょう。
学習

オープンデータセット:機械学習を加速する宝の山

誰もが自由に使えるように公開されたデータの集まり、いわゆる公開データは、機械学習やデータ分析などの分野で研究開発を大きく前進させる力強い味方となっています。その利点は、費用を抑えられるだけにとどまりません。質の高いデータに容易に手が届くことも大きな魅力です。 例えば、人の顔や物の形などを機械に認識させる画像認識の研究には、大量の画像データが欠かせません。公開データを使えば、データを集める手間と費用を大幅に減らすことができます。膨大な数の画像データを集めるのは大変な労力と費用がかかりますが、公開データは、その負担を軽減してくれるのです。さらに、多くの研究者によって既に綿密に調べられ、確かな品質と認められたデータを使うことで、研究の信頼性を高めることにもつながります。 公開データは公共の利益や研究のために公開されているため、様々な種類のデータが利用可能です。気象データや人口統計データ、地図情報など、多岐にわたるデータが入手できます。これらのデータを活用することで、新しい発見や技術革新を生み出す可能性が広がります。例えば、ある地域の人口動態と商業施設の分布を組み合わせることで、新たな出店計画のヒントが得られるかもしれません。また、気象データと農作物の生育状況を分析すれば、より効率的な農業を実現できる可能性も秘めています。 公開データは、誰もが利用できることから、情報共有や共同研究を促進する効果も期待できます。研究者同士がデータを共有し、互いの成果を参考にしながら研究を進めることで、より質の高い研究成果を生み出すことができるでしょう。また、企業や自治体も公開データを利用することで、地域社会の課題解決や新たなサービス開発に役立てることができます。このように、公開データは、様々な分野でイノベーションを促し、社会の発展に貢献する貴重な資源と言えるでしょう。
アルゴリズム

活性化関数ReLUとは?仕組み・利点・注意点を初心者向けに解説

人間の脳の仕組みを模倣した人工知能技術であるニューラルネットワーク。その学習において中心的な役割を担うのが活性化関数です。 活性化関数は、ニューラルネットワークの各層に入力された信号を、ある関数に基づいて変換する働きを持ちます。この変換は、非線形変換と呼ばれるもので、これがニューラルネットワークの表現力を飛躍的に高める鍵となっています。 もし活性化関数が無く、線形変換のみが行われていたとしたらどうでしょうか。線形変換は、入力信号に比例した出力信号を生成する単純な変換です。これを幾重にも重ねたとしても、全体としては依然として線形変換にしかなりません。つまり、複雑なパターンを学習することができません。 一方、活性化関数を用いることで、ニューラルネットワークは非線形な関係性を表現できるようになります。例えば、ある活性化関数は、入力信号がある値を超えた場合にのみ大きな出力信号を生成し、それ以外の場合は小さな出力信号を生成する、といった挙動を示します。これは、生物の神経細胞が、ある一定以上の刺激を受けた場合にのみ信号を伝える仕組みに似ています。 このように、活性化関数は入力信号の強弱に応じて出力信号を調整することで、ニューラルネットワークに複雑な問題を解決する能力を与えているのです。活性化関数の種類は様々で、それぞれ異なる特徴を持っています。目的に合わせて適切な活性化関数を選ぶことで、ニューラルネットワークの性能を最大限に引き出すことができます。
IoT

ラズベリーパイで電子工作を始めよう

「ラズベリーパイ」は、その名の通り手のひらに乗るくらいの大きさの小さな計算機です。まるで果物のような可愛らしい名前ですが、その小さな箱の中には無限の可能性が詰まっています。 従来の計算機に比べてはるかに手頃な値段で手に入るため、電子工作や文字書きに挑戦してみたい人にとって、まさにうってつけの道具と言えるでしょう。気軽に買って、気軽に試せる、そんな手軽さが魅力の一つです。 ラズベリーパイの魅力は、その小さくて安価である点だけにとどまりません。この小さな計算機は、文字書きを通じて様々な機能を実現できる柔軟性を備えています。例えば、簡単なゲームを作ったり、音楽を奏でたり、温度や湿度を測る装置を作ったり、家の照明を遠隔操作したりと、アイデア次第で様々なことができます。まるで魔法の箱のようです。 子供たちの学びの道具としても注目を集めています。遊びながら学ぶことができるため、楽しみながら文字書きの基礎を学ぶことができます。難しい専門知識は必要なく、直感的に操作できるので、子供たちはまるで玩具で遊ぶように、楽しみながら計算機の仕組みを理解していくことができます。 また、ラズベリーパイは世界中で広く使われており、多くの利用者たちが情報を共有しています。そのため、困ったことがあっても、インターネットで調べれば解決策が見つかることがほとんどです。さらに、様々な部品や拡張機能が用意されているため、自分の好みに合わせて機能を拡張していく楽しみもあります。ラズベリーパイは、まさに手軽に始められる、夢が広がる計算機と言えるでしょう。
アルゴリズム

A3C:並列学習で賢く強化

近頃、人のように考える機械を作る分野で、試行錯誤を通して学ぶ方法が注目されています。この方法は、様々な分野で成果を上げており、まさに時代の寵児と言えるでしょう。その中でも、A3Cと呼ばれる方法は、特に効率的に学ぶことができると評判です。この記事では、A3Cの仕組みや利点、そしてどのように使われているのかを詳しく説明します。人のように考える機械の世界を探求する上で、この記事が皆様の最初の道案内となれば幸いです。 試行錯誤を通して学ぶ方法は、まるで子供が遊びを通して成長していくように、機械も経験から学びます。具体的には、機械がある行動をとったとき、もしそれが良い結果に繋がれば褒め、悪い結果に繋がれば罰を与えます。これを繰り返すことで、機械はだんだんと良い行動をとるように学習していくのです。A3Cは、この学習過程をより早く、より賢く進めるための工夫が凝らされています。従来の方法では、一つの機械が学習した結果を次の学習に活かすという流れでしたが、A3Cでは、複数の機械が同時に学習し、それぞれの学習結果を共有することで、より効率的に学習を進めることができます。まるで、複数の生徒が互いに教え合い、共に成長していくようなイメージです。 このA3Cの利点は、学習速度の向上だけではありません。複数の機械が同時に様々な行動を試すため、より多様な可能性を探求することができ、結果として、従来の方法では思いつかないような独創的な行動を発見できる可能性も秘めています。まるで、多様な個性を持った人々が集まり、新しいアイデアを生み出す創造の場のようなものです。 そして、A3Cは既に様々な場面で使われ始めています。例えば、ゲームの攻略や、ロボットの制御、さらには資源の効率的な配分など、その応用範囲はますます広がっています。今後、A3Cがどのように進化し、私たちの生活をどのように変えていくのか、非常に楽しみです。
セキュリティ

システム監査のインタビュー法とは?進め方・質問例・注意点を解説

組織の情報を取り扱う仕組みの良し悪しを確かめるシステム監査において、なくてはならない手順の一つが、実際に運用している人から話を聞くインタビュー法です。この方法は、情報システムがきちんと動いているか、大切な情報を守れているかを評価する上で、とても重要な役割を担っています。 システム監査では、様々な方法で調べますが、話を聞くインタビュー法は、システムに関わる人から直接話を聞き、ありのままの現状を理解することができるため、他の方法では得られない貴重な情報を得られるという利点があります。 例えば、書類や記録を調べるだけではわからない、現場での工夫や苦労、実際に運用している上での問題点などを、インタビューを通して把握することができます。また、システムの使い勝手や、普段どのような手順で操作しているかといった情報も、直接話を聞くことで初めて見えてくる部分です。 インタビューで得られた情報は、システムが抱える隠れた危険性や課題を明らかにする上で大変役立ちます。システムの記録や書類には残っていない、担当者しか知らない情報や、システムの弱点なども、インタビューを通して明るみに出る可能性があります。 このように、システム監査においてインタビュー法は、システムの現状を深く理解し、潜在的な問題点を発見するために欠かせない手法と言えるでしょう。システムに関わる様々な立場の人から話を聞くことで、より正確で詳細な情報を集め、信頼性の高い監査結果へと繋げることができるのです。
開発環境

オープンソースで拓くAIの未来

誰もが自由に使える設計図のようなもの、それがオープンソースです。 例えば、家を建てる時の設計図を想像してみてください。従来のソフトウェアは、完成した家を見たり使ったりすることはできても、設計図そのものを見ることはできませんでした。どのように作られたのか、どのような工夫が凝らされているのか、知る術もありませんでした。 しかし、オープンソースの考え方が登場したことで、状況は大きく変わりました。オープンソースでは、ソフトウェアの設計図にあたるソースコードが公開されているのです。誰でも自由にその設計図を閲覧し、どのように作られているのかを学ぶことができます。さらに、その設計図を元に、自分好みに家を改造するように、ソフトウェアを改良することも可能です。改造した設計図を他の人と共有することもできます。 オープンソースの利点は、世界中の人々が協力して開発を進めることができる点にあります。多くの技術者が改良や不具合の修正に取り組むことで、ソフトウェアの品質は向上し、開発速度も上がります。まるで、大勢の建築家が協力して、より良い家を建てるようなものです。 近年、このオープンソースの考え方は、人工知能の分野でも広がりを見せています。人工知能技術の開発にも多くの人が参加できるようになり、技術の進歩を加速させています。これまで一部の限られた人しか扱うことのできなかった技術が、より多くの人々に利用されるようになることで、社会全体に大きな変化をもたらす可能性を秘めているのです。