AIサービス

neoAIとは?生成AIに特化した企業の特徴と事業内容を解説

東京大学松尾研究室発の生まれたての企業「neoAI」は、今まさに注目を集めています。人工知能の中でも特に、新しいものを作り出す力を持つ「生成AI」に特化した、期待の新星と言えるでしょう。人工知能、とりわけ生成AIの技術は、日進月歩で急速に進化を続けており、neoAIは革新的な技術と他に類を見ない事業の進め方で、この市場に大きな変化をもたらそうとしています。 松尾研究室は、我が国における人工知能研究の第一人者として広く知られており、これまで多くの優秀な人材を育成し、世に送り出してきました。neoAIは、その松尾研究室で培われた知識と技術を受け継ぎ、高性能な生成AI技術を作り出し、様々な分野でこれまでにない画期的なサービスを提供することを目標としています。具体的には、文章や画像、音声、動画など、様々な種類の情報を作り出すことができる生成AIの技術を活かし、社会全体の進歩に貢献することを目指しているのです。 neoAIは、生成AIの技術開発に焦点を絞ることで、他の企業にはない独自の特徴を生み出し、確固たる地位を築こうとしています。生成AIは、文字情報だけでなく、絵や写真、音声、動画など、多種多様な情報の形を作り出すことができる技術であり、その活用範囲はまさに無限大と言えるでしょう。例えば、文章作成支援、画像生成、音楽制作、映像編集など、様々な分野での応用が期待されています。neoAIは、これらの技術を駆使することで、人々の生活をより豊かに、社会をより便利にすることを目指し、日々研究開発に取り組んでいます。neoAIの今後の発展に、ぜひご注目ください。
アルゴリズム

最大値プーリングで画像認識

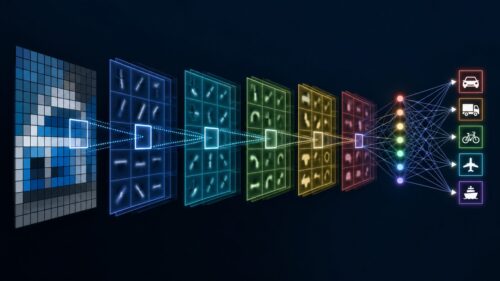
模様や物の見分けで活躍する、「画像認識」という技術があります。この技術の中で、「縮小」という大切な作業をするのが「プーリング」です。写真を思い浮かべてください。写真の粒が細かいほど、つまり画素数が多いほど、データの量は多くなり、コンピューターの負担も大きくなります。プーリングは、この写真の粒を少し粗くするようなものです。 例えば、縦横4つのマスに分けられた升目があるとします。それぞれのマスには明るさを表す数字が入っています。プーリングでは、この4つのマスのうち、一番明るい数字だけを選び出し、新しい1つのマスに記録します。これを繰り返すことで、写真の大きさを小さくしていきます。 この縮小には、二つの利点があります。一つは、処理の速さです。写真のデータ量が小さくなるため、コンピューターはより早く計算を行うことができます。もう一つは、位置ずれへの対応です。写真の中の模様が、少しだけずれていても、プーリングによってそのずれの影響を少なくすることができます。 例えば、顔認識をするとき、顔が少し傾いていても、プーリングのおかげで、きちんと顔を認識できるようになります。このように、プーリングは画像認識の精度向上にも大きく貢献しています。小さな工夫ですが、画像認識には欠かせない重要な技術と言えるでしょう。
AI活用

アドビ・エクスプレス:デザインの新時代

絵を描くのが苦手な人や、専門的な道具を持っていない人でも、簡単に綺麗な見た目を作ることができる便利な道具があります。それは「アドビ・エクスプレス」と呼ばれる、誰でも使えるように作られた模様作成の道具です。 この道具は、有名な模様作成会社であるアドビが作りました。チラシや看板、はり紙、会社の印、インターネット上に投稿するための絵など、色々な種類の模様を簡単に作ることができます。あらかじめ用意されているたくさんの模様の型を使うことで、まるで専門家が作ったかのような、洗練された模様をすぐに利用できます。模様作りに自信がない人でも、安心して使い始めることができます。 使い方もとても簡単です。まず、作りたい模様の種類を選び、気に入った型を選びます。そして、用意されている写真や絵、文字などを組み合わせたり、色を変えたりすることで、自分好みの模様に作り替えることができます。写真や絵、文字の種類もたくさん用意されているので、きっと気に入ったものが見つかるはずです。 難しい操作は一切ないので、初めて模様を作る人から、普段から模様作りをしている人まで、誰でも気軽に使うことができます。今まで模様作りに苦労していた人、もっと簡単に綺麗な模様を作りたいと思っていた人は、ぜひ一度「アドビ・エクスプレス」を試してみてください。きっと、模様作りの楽しさを実感できるはずです。
WEBサービス

フィルターバブル:情報の偏り

私たちは今や、網の目のように世界中に張り巡らされた情報網を通して、膨大な知識に瞬時に触れられる時代に生きています。日々、様々な情報を調べ、新しい出来事を知り、遠く離れた人と繋がりを持つことができます。実に便利な道具です。しかし、この便利な道具の裏には、思いもよらない落とし穴が潜んでいることを忘れてはなりません。それが、まるでシャボン玉のように私たちを包み込み、特定の情報ばかりを見せる「情報の泡」です。 私たちが情報を得る時、画面には自分の好みや過去の行動に合わせた情報が優先的に表示されます。例えば、好きな音楽を一度検索すると、その後は似たようなジャンルの曲ばかりが薦められるようになります。これは一見、私たちの時間を節約してくれる便利な機能のように思えます。しかし、知らず知らずのうちに、私たちの見ている世界は狭まっているのです。普段目にしない情報、自分とは異なる考え方、反対の意見に触れる機会が減り、まるで自分好みの情報だけでできた泡の中に閉じ込められてしまいます。 この情報の泡は、私たちのものの見方や考え方にも影響を及ぼします。自分と同じ意見ばかりが目に入ると、それが正しいと思い込みがちになり、他の考え方を認めにくくなります。また、異なる意見に触れることで生まれる新しい発見や学びの機会も失われてしまいます。多様な考え方を知り、広い視野を持つことは、より良い判断をする上で非常に大切です。情報の泡に閉じ込められないためには、意識的に異なる情報源を探したり、自分とは異なる意見を持つ人と話をするなど、自ら泡の外へ飛び出す努力が必要となります。情報の便利さに溺れることなく、主体的に情報を選び、受け取る力を養うことが、これからの情報社会で生きていく上で重要になるでしょう。
学習

割引率とは?強化学習で未来の報酬をどう評価するか

割引率とは、将来に得られる利益を現在の価値に置き換えるための数値です。これは0から1の間の値で表されます。この数値は、将来の利益をどれくらい重要視するかを決める役割を果たします。 割引率が0に近い場合は、将来の利益はあまり重視されず、目先の利益が優先されます。例えば、割引率が0の場合、将来にどれだけ大きな利益が得られるとしても、現在の価値としてはゼロとみなされます。つまり、今すぐ手に入る利益だけを追求する行動を選びます。 逆に、割引率が1に近い場合は、将来の利益も現在の利益とほぼ同じくらい重要だと考えられます。例えば、割引率が1の場合、1年後に得られる100円の利益は、現在得られる100円の利益と同じ価値を持ちます。つまり、将来の大きな利益を見込んで、今は多少我慢する行動も選択しやすくなります。 この割引率は、人工知能の学習方法の一つである強化学習で重要な役割を担います。強化学習では、試行錯誤を通じて学習する人工知能(エージェント)を扱います。エージェントは、行動を選択し、その結果として報酬(利益)を得ることで学習します。割引率は、将来得られる報酬をどの程度重視するかを調整することで、エージェントの学習方法を制御します。 割引率の設定によって、エージェントは短期的な利益を追求するのか、それとも長期的な目標達成を目指すのかが決まります。例えば、ゲームで高いスコアを出すことを目標とするエージェントを考えます。割引率が低い場合、エージェントは目先の小さな得点にこだわり、最終的なスコアを最大化できない可能性があります。一方、割引率が高い場合、エージェントは最終的なスコアを最大化するために、一時的に不利な状況も受け入れる可能性があります。 このように、適切な割引率を設定することは、強化学習モデルの性能を最大限に引き出す上で非常に重要です。適切な割引率は、扱う問題や目標によって異なります。そのため、様々な割引率を試して、最適な値を見つける必要があります。
アルゴリズム

画像認識の鍵、フィルタの役割とは?意味・仕組み・活用例をわかりやすく解説

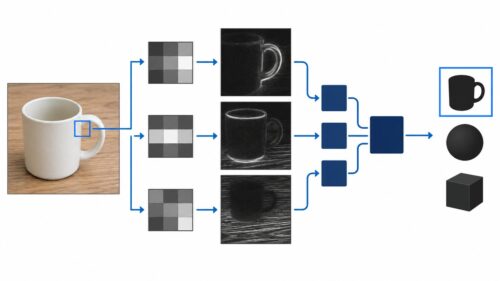
模様や輪郭、色の濃淡といった絵の様々な特徴を捉えるための道具、それがフィルタです。まるで職人の道具箱のように、画像認識の世界では様々なフィルタが用意され、目的に合わせて使い分けられます。フィルタは一体どのようなものなのでしょうか。 フィルタは、数字が格子状に並んだ小さな表のようなものです。この表は、画像の特定の部分に反応する探知機の集まりだと考えることができます。それぞれの探知機は、対応する画像の部分の明るさや色と、フィルタの数字を掛け合わせた値を計算します。この計算を画像全体で行うことで、新しい画像が作られます。これがフィルタをかける、という処理です。 例えば、輪郭を強調するフィルタを考えてみましょう。このフィルタは、中心の探知機に大きな正の値が、周りの探知機に小さな負の値が設定されています。画像の明るい部分にこのフィルタをかけると、明るい部分と中心の探知機の積は大きな正の値になり、周りの暗い部分と探知機の積は小さな正の値になります。これらの値を合計すると、結果として大きな値が得られます。つまり、明るい部分はより明るくなります。逆に、暗い部分にこのフィルタをかけると、合計値は小さな値、あるいは負の値になるため、暗い部分はより暗くなります。このように、明暗の差が強調されることで、輪郭がはっきり見えるようになるのです。 フィルタの種類は実に様々です。ぼかしを作るフィルタや、特定の方向の線を強調するフィルタなど、目的や用途に合わせて様々なフィルタが用意されています。これらのフィルタを組み合わせることで、より複雑な画像処理を行うことも可能です。フィルタは、まさに画像認識の要であり、画像に隠された情報を引き出すための魔法の道具と言えるでしょう。
学習

AdaGradとは?学習率を自動調整する仕組みと注意点をわかりやすく解説

機械学習とは、コンピュータに大量の情報を学習させ、そこから規則性や関連性を見つけ出す技術のことです。この技術の中で、最適化手法は重要な役割を果たします。最適化手法とは、予測の正確さを高めるために、計算のやり方を調整する技術のことです。様々な最適化手法が存在しますが、その中で注目されている手法の一つが「エイダグラッド」です。 エイダグラッドは、過去の学習情報を活用することで、より効率的に学習を進める手法です。具体的には、過去の情報に基づいて、各々の変数の更新の大きさを調整します。例えば、過去に大きく変化した変数は、その後は小さな変化に留めるように調整されます。逆に、過去にあまり変化しなかった変数は、その後は大きく変化させるように調整されます。このように、エイダグラッドは、変数ごとに適切な学習の度合いを調整することで、全体的な学習効率を高めることを目指しています。 従来の手法では、すべての変数に対して一律に学習の度合いを調整していました。そのため、既に最適な値に近づいている変数も、そうでない変数も、同じように更新されてしまうという問題がありました。エイダグラッドは、この問題を解決するために、変数ごとに学習の度合いを調整する仕組みを取り入れています。 エイダグラッドを使うことで、学習の速度が向上するだけでなく、より精度の高い予測モデルを構築できる可能性が高まります。そのため、エイダグラッドは、画像認識や自然言語処理など、様々な機械学習の分野で活用されています。エイダグラッドは、今後も機械学習の発展に貢献していくことが期待される、重要な最適化手法と言えるでしょう。
その他

事業の可否判断:フィージビリティスタディ

新しい仕事を始めようとする時、その仕事がうまくいくのか、儲けを生むのか、誰もが不安に思うものです。ひらめきややる気だけで突き進むのは危険が大きく、入念な計画と確かめが欠かせません。そこで大切になるのが、実現可能性調査です。このやり方を使うことで、仕事の成功する見込みを客観的に見て、危険をできるだけ少なくできます。仕事の計画を立て始める最初の段階でこの調査を行うことで、時間と資源の無駄遣いを防ぎ、成功への道を示す道しるべとなるのです。 実現可能性調査は、大きく分けて四つの段階で行います。まず、調査の準備段階では、調査の目的をはっきりさせ、必要な情報を集めます。具体的には、市場の大きさや競合相手、法律や制度などを調べます。次に、市場調査の段階では、顧客のニーズや競争の激しさなどを詳しく調べます。集めた情報をもとに、どれだけの売上が見込めるのか、どのくらいの利益が出そうなのかを予測します。三つ目の段階は、技術的な調査です。新しい仕事をする上で必要な技術や設備、人材などを確認し、実現可能かどうかを判断します。そして最後の段階では、財務分析を行います。売上や費用、投資額などを予測し、事業の収益性を評価します。具体的には、投資に対する回収期間や利益率などを計算し、事業を始めるべきかどうかを判断します。実現可能性調査は、それぞれの段階で得られた情報を総合的に判断し、事業の成功可能性を評価するものです。 実現可能性調査を行うことで、仕事がうまくいく見込みを高めるだけでなく、他にも様々なメリットがあります。まず、問題点を早期に発見することができます。調査を通して、市場のニーズと自社の提供する商品やサービスとのずれ、技術的な課題、資金不足などの問題点が明らかになります。早期に問題点を発見することで、対策を立てることができ、事業の失敗のリスクを減らすことができます。また、関係者との合意形成にも役立ちます。調査結果を共有することで、経営陣や投資家、従業員など、関係者全員が事業内容やリスク、将来性などを理解し、共通の認識を持つことができます。これは、事業をスムーズに進める上で非常に重要です。そして、事業計画の精度を高めることができます。実現可能性調査で得られた情報は、事業計画に反映されます。市場の規模や成長性、競合状況、必要な投資額など、具体的なデータに基づいて事業計画を立てることで、より現実的で精度の高い計画を作成することができます。
AI活用

AIによる新しいデザインの可能性

人工知能は近年、様々な分野で目覚ましい発展を遂げており、私たちの生活にも大きな変化をもたらしています。特に、画像を理解したり言葉を処理したりする技術の進歩は目覚ましく、様々な応用が期待されています。 その中で、「見て感じる人工知能」という考え方が注目を集めています。これは、人工知能がまるで人間のように、ものを見て、その特徴を理解する能力を持つことを意味します。「mitate」と呼ばれるこの技術は、ものづくりの分野、特にデザインの分野で革新を起こそうとしています。 従来、デザインは人間の感覚や経験に大きく頼っていました。デザイナーの感性や直感、熟練の技術が、魅力的な製品を生み出すための重要な要素でした。しかし、人工知能を活用することで、このデザインのプロセスに大きな変化が生まれます。人工知能は、大量のデータから複雑な模様や特徴を抽出することに優れています。人間が見落としてしまうような細かい違いも見つけることができ、今までにない新しいデザインを生み出すヒントになります。 例えば、椅子をデザインするとします。人間は、座り心地や見た目、材質などを総合的に判断してデザインを決めます。人工知能は、過去の様々な椅子のデータ、利用者の評価、材質の特性などを学習し、人間では思いつかないような形状や素材の組み合わせを提案することができます。また、流行の傾向や時代の変化も分析し、未来に受け入れられるデザインを予測することも可能です。 このように、人工知能は人間の感性を補完し、より創造的なデザインを生み出すための強力な道具となる可能性を秘めています。人工知能と人間の協力によって、これまでにない革新的なデザインが生まれ、私たちの生活はより豊かで便利なものになっていくでしょう。
学習

AdaDeltaとは?学習率を自動調整する仕組みをわかりやすく解説

機械学習の世界では、学習の進み具合を調整することがとても大切です。この進み具合を調整する値のことを学習率と呼びます。適切な学習率を見つけることは、まるで宝探しの地図を見つけるようなもので、モデルの性能を最大限に引き出すための重要な鍵となります。しかし、この学習率を手作業で調整するのは至難の業で、最適な値を見つけるまでに多大な時間と労力を要することがあります。 そこで、自動的に学習率を調整してくれる便利な手法として、AdaDeltaが登場します。AdaDeltaは、まるで自動操縦装置のように、最適化の過程を効率化し、より良い結果へと導いてくれます。従来の手法では、学習率を固定値として設定していましたが、AdaDeltaは過去の変化量を記憶し、それをもとに各々の学習ステップで最適な学習率を自動的に決定します。これは、山を登る際に、急な斜面では一歩一歩慎重に、緩やかな斜面では大きく足を踏み出すことに似ています。 AdaDeltaの利点は、手動での調整が不要になるだけではありません。過去の変化量を考慮することで、学習の振動を抑え、より安定した学習を実現します。さらに、学習率の初期値設定に過度に敏感になることもありません。つまり、AdaDeltaを使うことで、試行錯誤の時間を大幅に削減し、より良い結果を効率的に得ることが可能になるのです。この記事では、AdaDeltaの具体的な仕組みや利点、そして使い方について、さらに詳しく説明していきます。
学習

画像を縮小:サブサンプリング層

縮小処理は、画像認識の分野で欠かせない役割を担っています。縮小処理とは、画像の解像度を意図的に下げる処理のことです。別名「間引き処理」や「圧縮処理」とも呼ばれ、画像に含まれる情報の量を減らすことで、様々な利点をもたらします。 まず、縮小処理によって画像のデータ量が減るため、計算にかかる時間や必要な記憶容量を節約できます。これは、大規模な画像データセットを扱う場合や、処理能力に限りがある機器で実行する場合に特に重要です。膨大な数の画像を扱う場合、一つ一つの画像のデータ量が少しでも減れば、全体的な処理速度や効率に大きな違いが生まれます。 次に、縮小処理は画像に含まれる些細な違いの影響を少なくする働きがあります。例えば、手書き文字を認識する場合を考えてみましょう。同じ文字であっても、書く人や書く時の状態によって、線の太さや位置、傾きなどに微妙な違いが生じます。このような小さな違いは、文字認識の精度を低下させる原因となります。縮小処理を施すことで、これらの些細な違いを無視できるようになり、結果として文字認識の精度向上につながります。 さらに、縮小処理は画像の全体像を捉えやすくする効果も持っています。画像を縮小する過程で、細かな情報が削ぎ落とされます。これは一見すると情報の損失のように思えますが、実は重要な特徴をより際立たせることにつながります。例えば、木の葉一枚一枚の形よりも、木全体の形状や枝ぶりといった情報が重要になる場合など、縮小処理によってノイズを取り除き、本質的な特徴を捉えやすくなります。このように、縮小処理は画像認識において、計算の効率化、ノイズへの耐性向上、本質的な特徴の抽出といった重要な役割を担っているのです。
アルゴリズム

マイクロF1値とは?意味・仕組み・活用例をわかりやすく解説

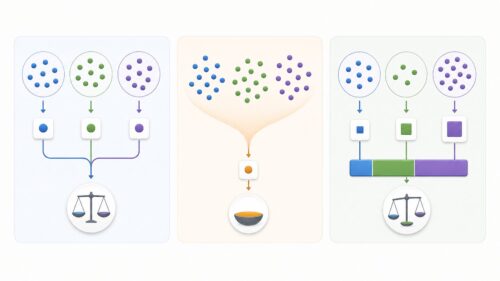
機械学習の分類モデルを評価する大切な指標の一つに、マイクロF値というものがあります。このマイクロF値は、分類モデルがどのくらい正確に分類できているかを示す数値です。分類モデルは、例えば写真を見てそれが何であるかを判断する画像認識や、迷惑メールを見分けるスパムメール検知など、様々な場面で使われています。これらのモデルが良い働きをしているかを調べるには、予測の正しさを評価する必要があります。マイクロF値は、まさにこの正しさを測るためのものです。 マイクロF値は、実際の結果とモデルが予測した結果が、どのくらい一致しているかを数値化したものです。具体的には、全体データの中で、正しく positive と予測できた数(真陽性)、間違って positive と予測した数(偽陽性)、本当は positiveなのに間違って negative と予測してしまった数(偽陰性)の三つの数から計算します。これらの数を用いることで、モデルの全体的な正確さを評価できます。 マイクロF値は、0から1までの値を取ります。値が1に近いほど、モデルの性能が良いとされます。例えば、マイクロF値が0.95のモデルは、0.7のモデルよりも正確な分類を行えていると判断できます。つまり、マイクロF値が高いモデルは、より正確な分類を行えていると言えるのです。これは、様々な分類モデルを比較する際に非常に役立ちます。より高いマイクロF値を持つモデルを選択することで、より信頼性の高い結果を得られる可能性が高まります。そのため、マイクロF値は、分類モデルの性能を測る上で重要な指標となっています。
その他

ファブレスとは?仕組み・メリットとファウンドリとの違いを解説

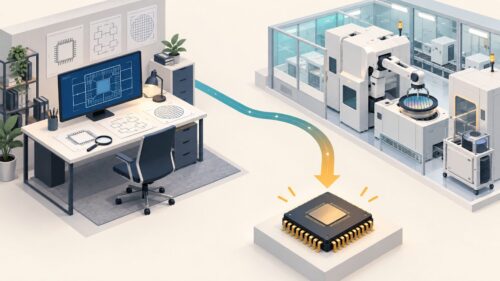
ファブレスとは、自社で製造工場を持たずに、製品の企画、設計、開発に集中する経営手法のことです。言わば、頭脳労働に特化し、ものづくりの心臓部である設計図を描くことに専念する企業形態です。工場を持たないことで、巨額な設備投資や維持管理費、人件費といった固定費を大幅に抑えることができます。浮いた費用は、製品の開発や販売促進活動といった、より収益に直結する活動に振り向けることが可能です。 この経営手法は、半導体業界で特に多く見られます。半導体の製造には、高度な技術と莫大な設備投資が必要となるため、ファブレス企業は製造工程を外部の専門業者に委託することで、効率的に事業を展開しています。近年では、家電や情報機器といった、他の製造業にもこの流れが広がりつつあります。 ファブレス企業の強みは、市場の変化への対応力の高さです。設備投資に縛られないため、市場の需要に合わせて柔軟に生産量を調整できます。また、研究開発に資源を集中できるため、常に最先端技術を取り入れた製品を市場に投入することが可能です。例えば、携帯端末に搭載される高性能な演算処理装置や、家電製品の制御を司る電子部品などを設計する企業が、ファブレス企業として知られています。彼らは、最先端技術の研究開発に力を注ぎ、その成果を製品設計に反映させることで、市場を牽引する製品を生み出しています。 一方で、ファブレス企業は、製品の製造を委託先に依存するため、委託先の生産能力や品質管理に左右されるという側面もあります。委託先との緊密な連携や信頼関係の構築が、事業の成功には不可欠です。
アルゴリズム

畳み込み処理の仕組みとは?計算方法・CNNでの役割・活用例をわかりやすく解説

畳み込みとは、画像処理や信号処理などで広く使われている大切な演算処理です。まるで画像の上を小さな虫眼鏡が滑っていくように、入力データ全体に小さなフィルター(核とも呼ばれます)を少しずつずらして適用していきます。このフィルターは、画像の特定の特徴を見つけるための道具のようなものです。 具体的な処理としては、まずフィルターと入力データの対応する部分を掛け合わせます。例えば、フィルターが3×3の大きさであれば、入力データの同じ大きさの部分と対応させ、それぞれの数値を掛け合わせます。次に、これらの掛け合わせた結果を全て足し合わせます。これが、新しいデータ(特徴地図)のある一点の値となります。フィルターを少しずつずらして、この計算を繰り返すことで、入力データ全体の特徴地図を作成します。 この畳み込みの処理によって、入力データから様々な特徴を抽出したり、不要なノイズを取り除いたりすることができます。例えば、画像の縁(境界)を見つけるためのフィルターを適用すると、縁が強調された画像が得られます。縁とは、色の明るさや濃さが急に変化する部分のことです。このフィルターは、色の変化が大きい部分を強調し、変化が小さい部分を抑えるように設計されています。 また、ぼかし効果のあるフィルターを適用すると、画像が滑らかになります。ぼかしとは、画像の細かい部分を平均化することで、滑らかな印象にする処理です。このフィルターは、周りの画素の値を平均して、急激な色の変化を和らげるように設計されています。 このように、フィルターの種類によって様々な効果を得ることができ、画像処理の分野ではなくてはならない技術となっています。フィルターは、画像処理の目的や対象に合わせて、様々な種類が考案され、使われています。どのようなフィルターを使うかによって、画像からどのような特徴を抽出できるかが決まり、最終的な処理結果に大きな影響を与えます。
アルゴリズム

AdaBound:学習の効率と安定性を両立

機械学習とは、人工知能の一分野で、まるで人が学習するようにコンピュータにデータからパターンや法則を見つけ出させる技術のことです。この学習過程で重要な役割を果たすのが最適化アルゴリズムです。人が学ぶ際に、より効率的な学習方法を模索するように、機械学習でも最適化アルゴリズムによって学習の効率と精度が大きく変わってきます。 様々な最適化アルゴリズムが提案されており、それぞれに特徴があります。例として、よく用いられる手法の一つに「勢い」を利用した学習方法があります。この方法は、過去の学習の勢いを考慮することで、学習の振れ幅を抑え、安定した学習を実現します。また、高い汎化性能、つまり未知のデータに対しても正確な予測ができる能力が期待できます。しかし、この学習方法はゆっくりと学習を進めるため、学習に時間がかかる場合があります。 一方で、「アダム」と呼ばれる学習方法は、学習の初期段階において非常に速い学習速度を実現します。まるで、人が新しいことを学ぶ際に、最初は集中的に学習する様子に似ています。しかしながら、学習が進むにつれて、汎化性能、つまり未知のデータへの対応力が劣る場合も見られます。これは、人が詰め込み学習で一時的に良い結果を出しても、真の理解が伴わず応用が利かない状況に似ています。 このように、それぞれのアルゴリズムには得意な点と不得意な点が存在します。そこで、これらのアルゴリズムの利点を組み合わせ、欠点を補う、新たな学習方法の開発が求められています。人が様々な学習方法を組み合わせて学習効果を高めるように、機械学習でもより効果的な学習方法の探求が続けられています。
学習

最適な学習率を探る旅

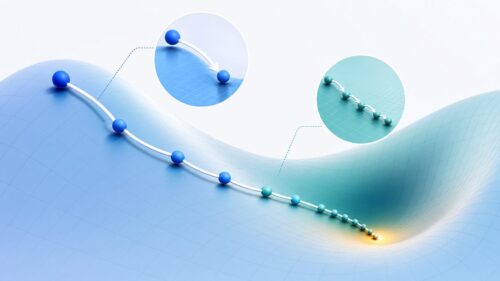
機械学習の分野では、多くの場合、山を下る動きになぞらえて最適な値を探す方法が使われます。この方法は勾配降下法と呼ばれ、集めた情報から得られる勾配を手がかりに、目指す値(最適解)へと少しずつ近づいていきます。この時、一度にどれくらいの距離を進めるかを決める大切な要素が、学習率です。 学習率は、勾配という山の斜面を進む時の、一歩の大きさを決める役割を担っています。適切な学習率を設定することで、無駄なく最適解へとたどり着くことができます。もし学習率が小さすぎると、まるで少しずつしか進めない蟻のように、最適解にたどり着くまでに長い時間がかかってしまいます。最適解まで道のりが遠く、なかなかたどり着かないイメージです。 反対に学習率が大きすぎると、まるで大股で駆け下りるように、最適解を通り過ぎてしまい、うまく落ち着かない場合があります。最適解の近くまで一気に近づきますが、行き過ぎてしまい、最適な場所を見つけられないイメージです。 ちょうど良い学習率を見つけることは、学習時間を短縮し、精度の高いモデルを作る上で非常に重要です。学習率の設定は、試行錯誤しながら最適な値を見つける必要があります。そのため、様々な値を試してみて、モデルの性能を比較することが大切です。 このように、学習率は機械学習のモデル学習において、最適解への到達速度と精度を左右する重要な役割を担っています。適切な学習率を設定することで、効率良く、精度の高いモデルを構築することが可能になります。そのため、機械学習に取り組む際には、学習率の調整に注意を払い、最適な値を見つける努力が欠かせません。
アルゴリズム

マクロF1値とは?多クラス分類の評価方法と計算の考え方を解説

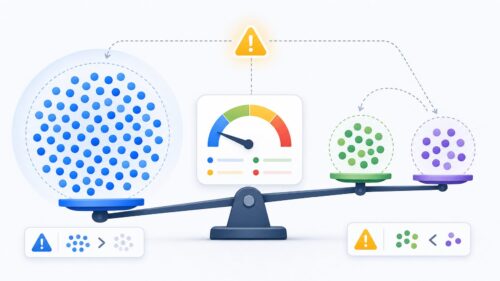
たくさんの種類に分ける問題で、作った模型がどれくらいうまく分類できるかを測る物差しの一つに、マクロF1値というものがあります。マクロF1値は、分類の正しさを示す値で、0から1までの間の数字で表されます。1に近いほど、その模型の分類能力が高いことを示しています。 分類問題では、模型がどれほど正確にそれぞれの場所にデータを分類できるかが大切です。しかし、種類ごとにデータの数が大きく違う場合、単純な正解率では模型の性能を正しく測れないことがあります。例えば、ある種類に属するデータが極端に少ない場合、その種類を全て無視して分類しても、全体の正解率は高く出てしまうことがあります。 マクロF1値を使うと、データ量の偏りに左右されずに、それぞれの種類の分類性能をまとめて評価できます。具体的には、まず種類ごとにF1値というものを計算します。F1値は、その種類の中でどれだけのデータを正しく分類できたかを示す値です。そして、計算したそれぞれのF1値を全て足し合わせ、種類の数で割って平均値を求めます。これがマクロF1値です。 つまり、マクロF1値は、少ない種類のデータも無視することなく、全ての種類の分類性能を平等に評価した結果と言えます。そのため、データの数が種類によって大きく異なるような分類問題で、模型の性能を正しく評価するために、マクロF1値は非常に役立ちます。
その他

会議を成功に導く、ファシリテータの役割

話し合いの場を作る人、つまり話し合いをより良く進めるための手助けをする人を、私たちは『話し合いのまとめ役』と呼ぶことがあります。この『話し合いのまとめ役』は、会議や話し合いの場で、参加者全員が活発に関わり、より良い成果を出せるように様々な形で支援を行います。 まず、『話し合いのまとめ役』は会議を進める役目として、発言を促したり、話の流れを整理したりといった具体的な行動を通して、参加者同士が円滑に意思疎通できるようにします。例えば、発言が少ない人がいれば、優しく意見を促したり、話が脱線しそうになったら、軌道修正を促したりします。 また、『話し合いのまとめ役』は中立的な立場を守ることがとても重要です。特定の意見に肩入れすることなく、全員の意見が尊重されるような雰囲気作りを心掛けます。まるで、話し合いという名の畑を耕し、実りある議論という名の作物を育む庭師のような存在です。 さらに、『話し合いのまとめ役』は、参加者一人ひとりの個性を尊重し、様々な視点を引き出しながら、共通の目標に向かって共に進んでいくための道筋を示す案内人の役割も担います。参加者それぞれの考えや経験を大切にしながら、それらを繋ぎ合わせ、より良い方向へ導いていくのです。 このように、『話し合いのまとめ役』がいることで、会議が効率的に進むだけでなく、組織全体の活性化や創造性の向上に大きく貢献することができます。それは、まるで多くの楽器が調和して美しい音楽を奏でるように、様々な考えが合わさり、素晴らしい成果を生み出すことに繋がるのです。
AIサービス

音声認識の精度を見極めよう

音声認識の精度は、提供されている toiminta 方式や製品によって大きな開きがあります。最新の技術を導入した高性能な仕組では、話し言葉の微妙な抑揚や訛り、周囲の騒音なども踏まえて、高い精度で音声を文字情報に変換することができます。まるで人が聞いているかのように、複雑な言い回しや早口にも対応できるものもあります。 一方、開発時期が古い、あるいは簡易的な仕組では、音声を正しく捉えることができず、誤った文字情報が作られることがあります。例えば、同音異義語を正しく認識できなかったり、周囲の雑音に影響されて聞き間違えたりするといった具合です。また、話し手の滑舌や発音の明瞭さにも影響を受けやすく、認識精度が低いと、会議の内容を記録するために多大な時間と手間がかかってしまうこともあります。 特に、会議の記録作成のように、正確さが求められる作業では、音声認識の精度は非常に重要です。もし、重要な情報が正しく記録されなければ、後々の意思決定に悪影響を及ぼす可能性もあります。そのため、音声認識の仕組を選ぶ際には、精度の高さをしっかりと確認する必要があります。無料の試用版などを活用して、実際に使ってみることで、その仕組の精度を確かめることができます。また、導入後も定期的に精度を確認し、必要に応じて設定変更などを行うことで、常に最適な状態で利用することができます。
アルゴリズム

LeNet:手書き文字認識の先駆け

1998年、アメリカ電話電信会社研究所の研究者であるヤン・ルカン氏をリーダーとする研究開発チームによって、LeNetと呼ばれる画期的な仕組みが作られました。当時、手書きの文字を読み取る技術は、郵便番号を自動で分類する作業など、様々な分野で必要とされていました。しかし、従来のコンピューターで映像を扱う技術では、一つ一つ形が違う手書き文字や、画像のノイズにうまく対応できず、正確に文字を読み取ることが難しいという問題がありました。 LeNetは、「畳み込みニューラルネットワーク」と呼ばれる新しい方法を使うことで、この問題を解決し、手書き文字の読み取り技術を大きく進歩させました。畳み込みニューラルネットワークは、人間の脳の仕組みを真似て作られたもので、画像の特徴を捉える能力に優れています。LeNetは、複数の畳み込み層とプーリング層を組み合わせることで、複雑な手書き文字の特徴を効率的に学習し、高精度な認識を可能にしました。 LeNetの登場は、その後の深層学習と呼ばれる技術の流行のきっかけとなり、画像認識技術の発展に大きく貢献しました。LeNetが実現した99.3パーセントという高い認識精度は、当時としては非常に画期的な成果でした。これは、従来の方法では考えられないほどの高精度であり、手書き文字認識の分野に大きな衝撃を与えました。LeNetの成功は、多くの研究者に深層学習の可能性を示し、更なる研究開発を促す原動力となりました。そして、今日では、画像認識だけでなく、音声認識や自然言語処理など、様々な分野で深層学習が活用され、人工知能技術の発展を支えています。
アルゴリズム

Actor-Criticとは?強化学習の仕組みと活用例をわかりやすく解説

「行動者と批評家」という手法は、機械学習の中でも特に「強化学習」と呼ばれる分野で重要な役割を担っています。この手法は、まるで舞台上の俳優と観客のように、二つの主要な要素が協調して学習を進めていくことからその名が付けられています。 まず、「行動者」は、与えられた状況に対してどのような行動をとるべきかを選択します。ちょうど舞台上の俳優が、台本や演出に基づいて演技をするように、行動者は現在の状況を把握し、それに応じた行動を選択します。行動者の選択は、必ずしも最良のものとは限りません。試行錯誤を通じて、より良い行動を見つける必要があります。 次に、「批評家」は、行動者が選択した行動を評価します。観客が俳優の演技を見て、良かった点や悪かった点を批評するように、批評家は行動の結果を観察し、その良し悪しを判断します。この評価は、単に行動が成功したか失敗したかだけでなく、どの程度目標に近づいたかといった、より詳細な情報も含んでいます。そして、批評家は評価結果を行動者にフィードバックします。 行動者は、批評家からのフィードバックを基に行動パターンを修正していきます。良い評価を得た行動は強化され、悪い評価を得た行動は抑制されます。このように、行動者と批評家が相互作用を繰り返すことで、行動者は徐々に最適な行動を学習していきます。この一連の流れは、教師が生徒に指導する過程にも似ています。教師が生徒の解答を評価し、助言を与えることで、生徒は学習内容を理解し、より良い解答を導き出せるようになります。 「行動者と批評家」という手法は、ロボット制御やゲーム戦略の学習など、様々な分野で応用されています。複雑な状況下でも効果的に学習を進めることができるため、今後の発展が期待される手法です。
その他

ファウンドリの現状と未来展望

委託製造とは、ある会社が製品の設計を行い、別の会社がその設計に基づいて実際の製造を行うという分業体制のことです。設計と製造を別々の会社が担当することで、それぞれの得意分野に資源を集中させることができます。製造を専門に行う会社は、委託製造会社、あるいは製造受託会社などと呼ばれます。 委託製造の仕組みを考えてみましょう。まず、製品を開発したい会社(委託会社)が製品の設計図を作成します。そして、その設計図を元に製造を行う委託製造会社を選定します。委託会社は、製造コストや納期、技術力などを考慮して最適な委託製造会社を選びます。委託製造会社は、委託会社から提供された設計図に基づいて製品を製造し、完成した製品を委託会社に納品します。委託会社は、納品された製品を販売したり、自社の製品に組み込んだりします。 委託製造の大きな利点は、委託会社が製造設備に投資する必要がないことです。製造設備の導入には多額の費用がかかるだけでなく、維持管理にも手間がかかります。委託製造を利用することで、委託会社はこれらの負担から解放され、製品の開発や販売に集中することができます。また、委託製造会社は製造に特化することで、高い技術力と効率的な生産体制を構築することができます。大量生産によるコスト削減も実現可能です。 半導体産業を例に挙げると、設計に特化した会社と、製造に特化した会社(ファウンドリ)が存在します。スマートフォンやパソコンに使われている高度な半導体も、多くの場合、ファウンドリによって製造されています。ファウンドリは、最先端の製造技術と設備を保有しており、高性能な半導体を大量生産することができます。委託会社はファウンドリに製造を委託することで、高性能な半導体を低コストで入手することができ、製品の競争力向上につなげることができるのです。このように、委託製造という仕組みは、様々な産業で広く活用され、現代社会を支える重要な役割を担っています。
アルゴリズム

物体検出の精度指標:mAPとは?計算方法・仕組み・注意点をわかりやすく解説

近年、画像を認識する技術はめざましい進歩を見せており、私たちの暮らしにも広く入り込んでいます。自動で車を運転する技術や、顔を見て本人かどうかを確かめる仕組みなど、様々な応用が現実のものとなっています。こうした技術を支える重要な要素の一つに、画像の中から特定のものを探し出し、その場所を特定する技術があります。この技術は、写真や動画の中から、例えば「人」や「車」といったものを探し出し、そのものの周りに枠を描くことで、そのものがどこにあるかを特定します。 この技術の正確さを測る指標として、よく使われているのが「mAP」と呼ばれるものです。「mAP」は一体どのような指標なのでしょうか? 「mAP」は「平均適合率精度」の略で、複数のものの検出精度を平均的に評価するための指標です。画像認識の分野では、様々なものが検出対象となります。例えば、自動運転の技術では、人や車だけでなく、信号や標識なども検出する必要があります。mAPは、これらの様々なものを検出する際の精度を総合的に評価するために用いられます。 mAPの値は0から1までの範囲で表され、1に近いほど精度が高いことを示します。もしmAPの値が1であれば、すべてのものを完璧に検出できていることを意味します。逆に、mAPの値が0に近ければ、ものの検出がうまくできていないことを意味します。 このmAPという指標は、物体検出技術の進歩を測る上で非常に重要な役割を果たしています。mAPの値が向上することで、より正確にものを検出できるようになり、自動運転や顔認証システムなどの技術の信頼性も向上します。このブログ記事では、mAPについてより詳しく、そして分かりやすく説明していきますので、どうぞ最後までお付き合いください。
学習

学習係数:機械学習の鍵

機械学習とは、与えられた情報から法則や傾向を見つけ出す技術のことで、近年様々な分野で活用が広がっています。まるで人が経験から学ぶように、機械も情報から学習し賢くなっていくのです。この機械学習において、学習の進み具合や成果に大きく影響を与える要素の一つが「学習係数」です。学習係数は、学習の際の「一歩の大きさ」を調整する役割を担っています。 例えるならば、山の頂上を目指す登山を想像してみてください。一歩が小さすぎると、頂上に辿り着くまでに時間がかかりすぎてしまいます。逆に一歩が大きすぎると、頂上を通り過ぎてしまったり、谷底に落ちてしまったりする危険性があります。学習係数も同様に、適切な大きさの一歩を設定することが重要です。小さすぎると学習に時間がかかり、なかなか良い結果が得られません。大きすぎると、最も良い結果を飛び越えてしまい、かえって精度が悪くなってしまう可能性があります。 この学習係数を適切に設定することで、より高い精度の結果を効率的に得ることが可能になります。そのため、機械学習を行う際には、この学習係数の調整が非常に重要になります。最適な学習係数は、扱う情報の種類や量、学習の目的などによって変化します。そのため、様々な値を試しながら、最適な学習係数を見つける作業が必要になります。 この記事では、学習係数の役割や、適切な値の設定方法について、より詳しく説明していきます。具体的には、よく使われる学習係数の調整方法や、最新の研究成果なども紹介することで、読者が実践的に学習係数を設定できるよう、段階的に解説していきます。