
セマンティックキャッシュとは?似た質問の回答を再利用する仕組みと注意点

AIの初心者
AIへの問い合わせで、同じ意味の質問にも毎回答えを作っているのは、少しもったいなく感じます。

AI専門家
そんな場面で役立つのがセマンティックキャッシュです。言い方が違っても、条件が合えば保存してある回答を返せます。
AIの初心者
似た質問なら、どれでも同じ回答にしてよいのでしょうか?
AI専門家
商品や日付が違うと答えも変わります。意味の近さに加えて、誰に、いつ、どの条件で使える回答なのかを確かめる必要があります。
セマンティックキャッシュとは。
セマンティックキャッシュは、質問の意味に近い保存済みの問答を検索し、再利用の条件を満たした回答を返す仕組みです。意味的キャッシュとも呼ばれ、ヒットしたときは大規模言語モデル(LLM)による回答の再生成を省けます。意味の近さは埋め込みベクトルで比較しますが、それだけで回答の正しさや適用範囲が保証されるわけではありません。
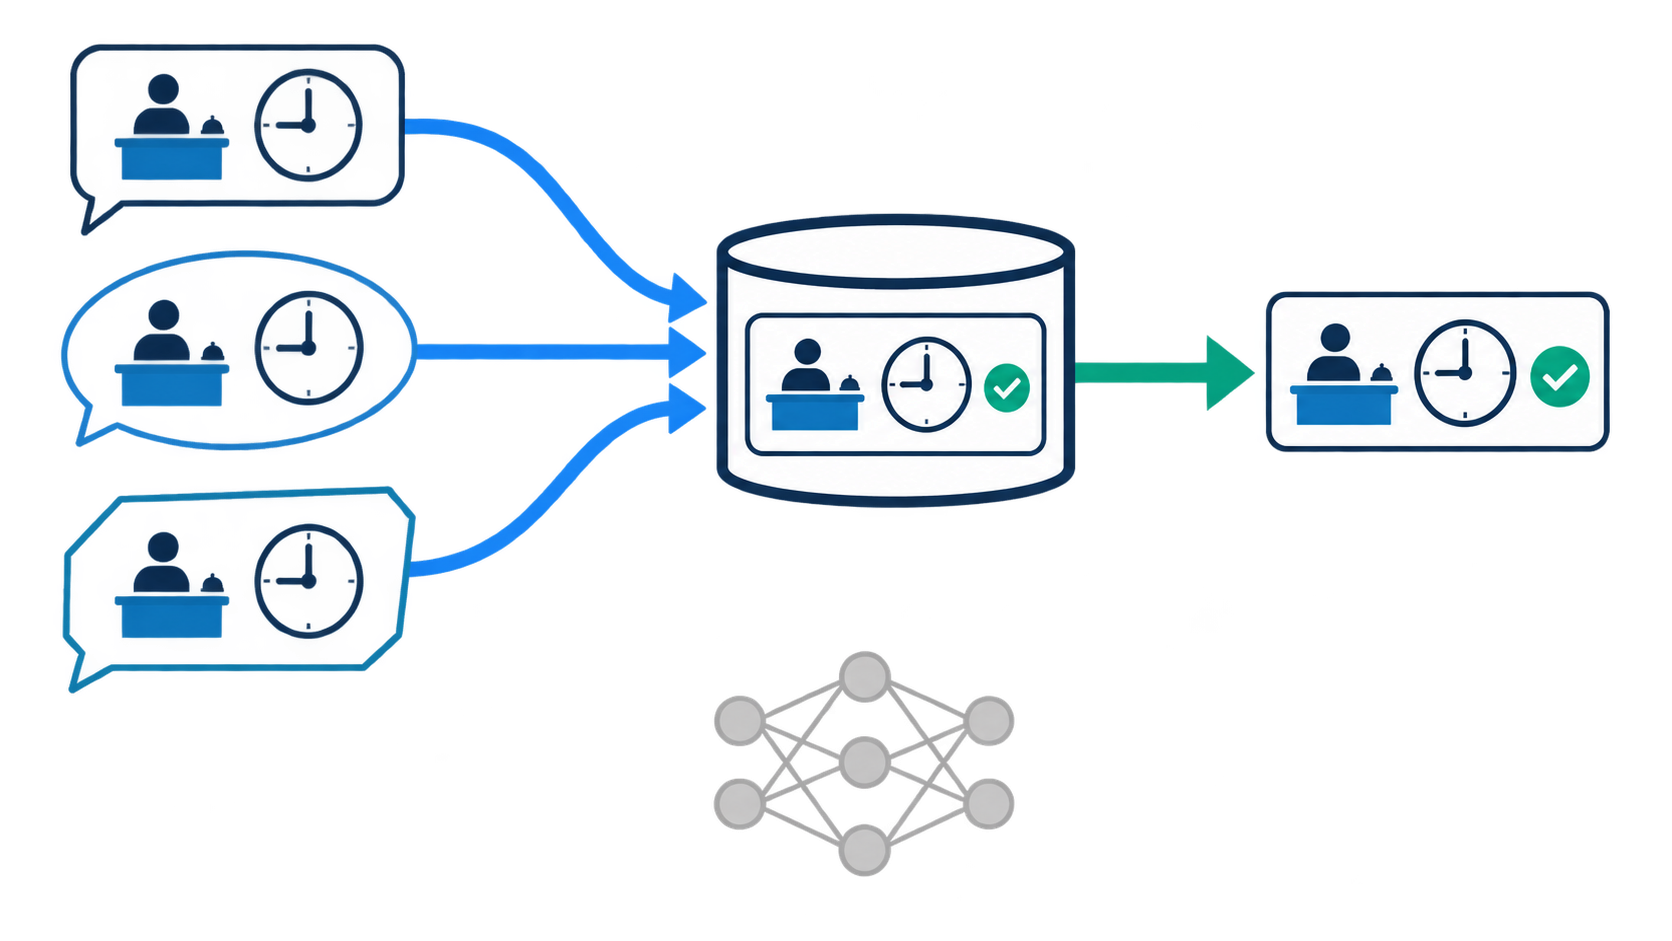
たとえば「受付は何時まで?」と「受付終了時刻は?」を共通の回答につなぐ使い方です。まず再利用できる場面を押さえ、検索から返答までの流れと、誤った使い回しを防ぐ設計を見ていきましょう。
完全一致キャッシュと何が違うのか
両者の違いは、保存した回答を探す際に、質問の文字列を照合するか、意味の近さを使うかです。キャッシュとは、一度得た結果を保存し、必要なときに再利用する仕組みを指します。セマンティックキャッシュは、その検索に意味を扱う技術を組み合わせたものです。
質問文字列をキーにする完全一致キャッシュでは、保存した「受付は何時まで?」と同じ文字列が来ると回答を返せます。一方、「受付終了時刻は?」は別の文字列なので、そのままでは一致しません。セマンティックキャッシュなら、この二つを意味が近い質問として扱い、同じ窓口の同じ営業日であれば「受付は17時までです」という回答を再利用できます。ここでの時刻は説明用の例です。
向いているのは、言い方はさまざまでも答えが共通する、安定したFAQへの反復質問です。施設の利用手順やサービスの基本操作など、同じ内容の問い合わせが多いほど効果を期待できます。利用者は表現を決まった文にそろえる必要がなく、運営側は同じ回答を何度も生成する負担を減らせます。
ただし、削減できるのは主にヒット時の回答生成にかかる時間と費用です。質問を数値に変換する処理、保存済みデータの検索、キャッシュの保存・管理には負担が残ります。毎回異なる質問ばかりならヒットが少なく、検索を挟んだ分だけ処理が増えることもあります。導入効果は問い合わせの偏りや繰り返しの多さに左右されます。
口座残高や注文の配送状況のように、人や時点によって変わる答えは慎重に扱います。「残高を教えて」という文が同じでも、別の利用者に同じ数字を返すことはできません。こうした用途では、対象者と情報の鮮度を厳密に管理できるかを判断し、難しければ回答の再利用対象から外します。
質問の埋め込みから回答を返すまで
処理の出発点は、質問を埋め込みベクトルという数値の並びへ変換することです。埋め込みモデルは文章の意味的な特徴を数値で表し、質問同士の近さを計算できるようにします。ここで探す対象は、説明資料やマニュアルそのものではなく、以前保存した質問と回答の組です。
基本的な流れは次のようになります。ヒットとは再利用できる回答が見つかった状態、ミスとは見つからず通常の処理へ進む状態です。
- 質問を受け取り、利用者の所属、言語、対象商品など、回答の適用範囲を決める条件を確認する。
- 質問を埋め込みベクトルへ変換し、条件に合う保存済みの問答から、意味が近い候補を検索する。
- 候補が近さの基準である閾値を満たし、有効期限内で、現在の質問に使えるかを判定する。
- ヒットしたら保存済み回答を返す。回答を新しく生成するためのLLM呼び出しは省く。
- 候補がない、閾値を満たさない、期限切れなどの場合は、通常の回答生成へ進む。
- 生成結果を保存してよいか確認し、質問、埋め込み、回答、適用条件、有効期間を登録する。

適用条件など、質問と回答に付ける補助情報をメタデータと呼びます。有効期間を表すTTLも、登録時に設定する項目の一つです。生成結果を無条件に保存すると、不正確な回答や個人情報を含む回答まで使い回す原因になります。保存対象を共通FAQに限る、内容を確認できた回答だけ登録するなど、検索条件とは別に保存条件も決めておきます。
検索と登録では、埋め込みモデルや文章の前処理の条件をそろえます。異なるモデルで作ったベクトルは、同じ長さの数値列であっても、そのまま比較できるとは限りません。また、ヒット時にも質問の埋め込み生成は必要になり得ます。「LLM呼び出しを省く」という説明は、ここでは完成回答を作る生成処理を指しています。
会話の続きにも注意が必要です。「それはいくら?」という質問だけでは、対象の商品が分かりません。会話履歴から対象を特定して検索条件へ反映するか、再利用を見送ります。直前の一文だけで判定すると、文面が完全に同じでも、異なる会話の答えを返してしまいます。
似た質問でも回答を使い回せない条件
意味が近いことと、同じ回答を使えることは別の条件です。「商品Aはいつまで返品できますか」と「商品Aの返品期限を知りたい」は、同じ購入条件なら再利用の候補になります。ところが、「商品Bの返品期限を知りたい」では、商品名が一つ違うだけでも返品規定が変わるかもしれません。
埋め込みは文章全体の特徴を捉えるため、答えを左右する一語の違いが、十分大きな距離になるとは限りません。たとえば「購入から7日」と「購入から30日」、「開封済み」と「未開封」、「返品できる条件」と「返品できない条件」です。数値や否定を含む質問は、文章が似ていても判断の方向が変わる場合があります。

そのため、商品ID、契約プラン、購入時期、適用する規約の日付など、答えが変わる項目を整理します。これらをメタデータとして付け、適用条件が一致する範囲で意味検索を行う設計が考えられます。「何となく近い質問か」を調べる前に、「どの範囲の回答なら使えるか」を絞ることが大切です。
複数の企業や組織が一つのサービスを利用する場合、その利用単位をテナントと呼びます。テナントが違えば、同じ「休暇の申請方法」という質問でも社内規定や案内先が異なります。共通のキャッシュを使う場合は、テナント、閲覧権限、言語などを検索条件へ適用し、別組織の回答が候補に混ざらないようにします。
メタデータに組織名を書き込むだけでは、アクセス制御にはなりません。ログイン中の利用者についてシステムが確認した所属や権限と、検索条件を結び付ける必要があります。利用者が質問文に書いた組織名をそのまま信頼して範囲を広げることは避けます。言語の指定も、同じ内容でも必要な言語で返すための条件になります。
保存済み回答に氏名や注文番号が含まれている場合は、意味が似た質問に共有してよい情報かを別途判断します。共通回答として保存するなら、個別情報を含まない内容にする方法もあります。商品や日付などの必要条件が分からないときは、確認の質問や通常処理へ進みます。候補が見つかったという理由だけで再利用を確定させない設計が必要です。
閾値はヒット率と誤再利用を見て決める
閾値は、どこまで近い質問をヒットとして受け入れるかの境目です。まず確認したいのは、使う数値が「類似度」なのか「距離」なのかという点です。類似度は通常、大きいほど近く、距離は小さいほど近いことを表します。同じ「閾値を上げる」という操作でも、判定が厳しくなるか緩くなるかは指標によって逆になります。
Redisのredis-pyによる実装例では、cosine distance(コサイン距離)は0が同一方向、2が正反対の方向を表し、距離が設定した閾値以下ならヒットとします。この例の0.5は、埋め込みモデルall-MiniLM-L6-v2を使ったデモ設定です。別のモデルや業務にもそのまま当てはまる推奨値ではありません。
距離の上限を大きくして判定を緩めると、より離れた候補まで受け入れるので、ヒットが増える一方で誤再利用の恐れも増します。上限を小さくして厳しくすると、誤再利用を抑えやすくなりますが、本来同じ答えでよい言い換えもミスとなり、再生成が増えます。
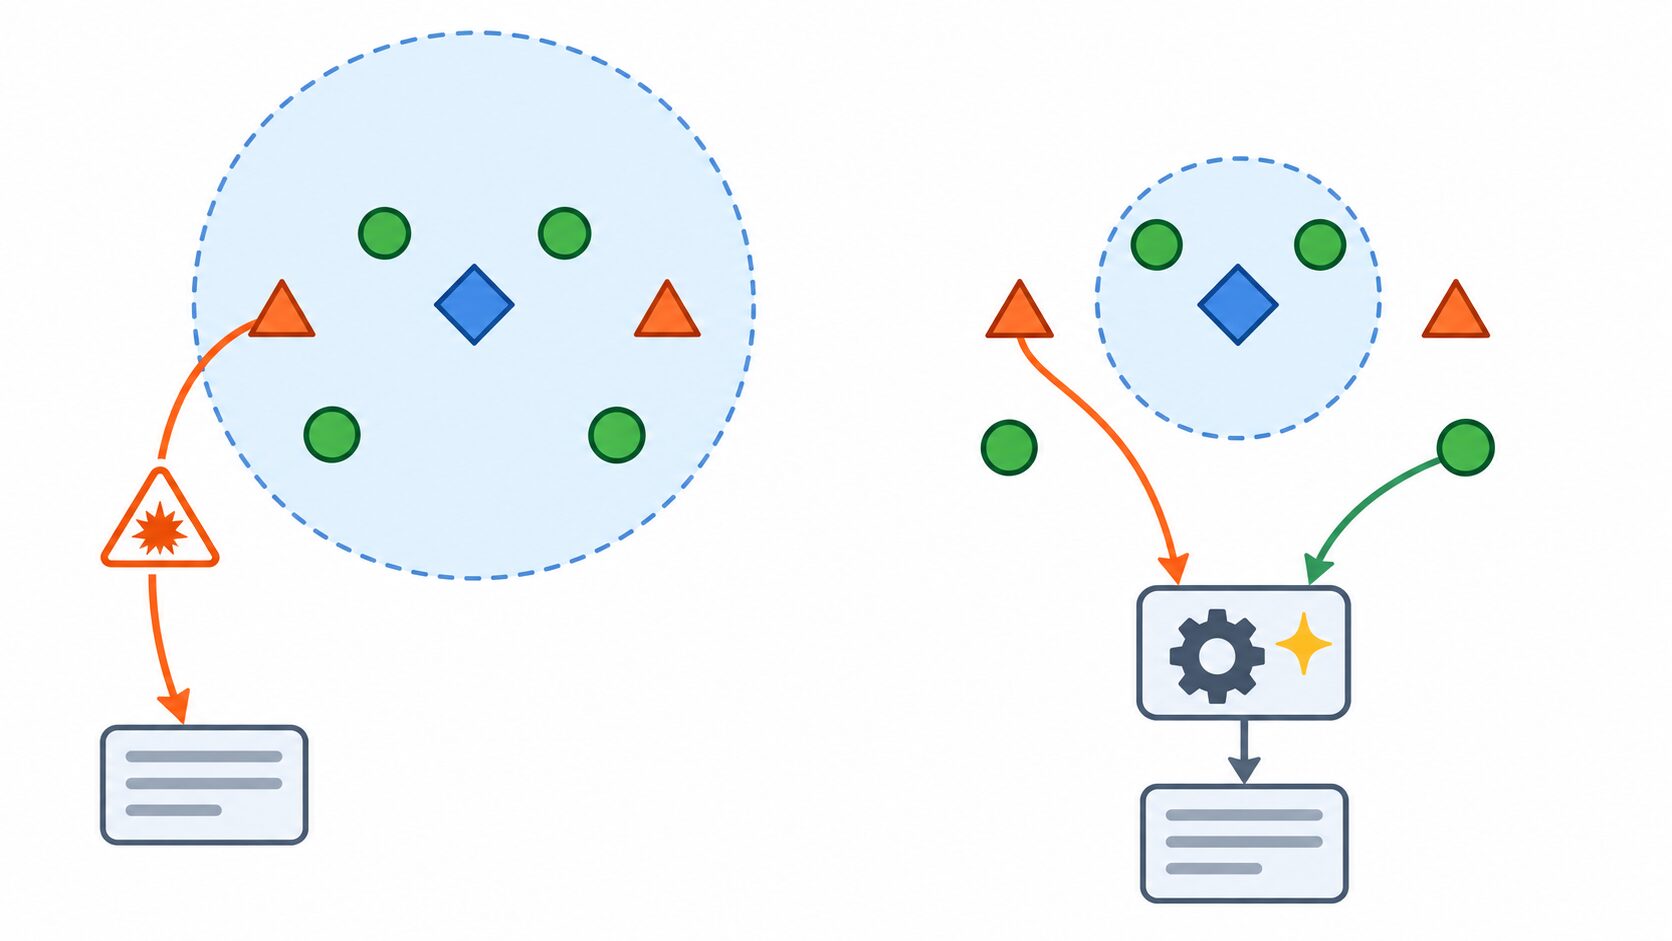
調整には、実際の問い合わせに近い評価用の質問を使います。同じ回答でよい言い換えに加え、商品、日付、数字、否定だけが違って回答を分けるべき質問も用意します。それぞれについて、保存済み回答を返してよいかを先に決めておくと、単に近い候補が出たかではなく、再利用の判断が正しかったかを評価できます。
見る指標は、全体のうち再利用できた割合であるヒット率と、ヒットした中に誤再利用が含まれた割合です。仮に100件中60件がヒットし、そのうち3件が誤再利用なら、ヒット率は60%、ヒット中の誤再利用割合は5%です。これは計算の説明用で、目標値ではありません。誤りの影響が大きい用途では、ヒット率より正しい適用を優先します。
あわせて、利用者が待つ時間と、埋め込み・検索・保存・生成を含む総費用も確認します。閾値は埋め込みモデルと対象データの組み合わせごとに調整し、実運用でも誤再利用の事例を確認します。条件の取り違えが原因なら、閾値だけを厳しくするより、商品や権限の絞り込みを直す必要があります。
TTLと更新管理で回答の鮮度を保つ
TTLはTime To Liveの略で、キャッシュに保存したデータを有効として扱う期間です。たとえば登録から24時間をTTLとすれば、その期間を過ぎた回答は再利用対象から外します。ただし、期限内であることは、内容が今も正しいことの保証にはなりません。情報の更新頻度に合わせて期間を決める必要があります。
午前9時に「受付は17時まで」と保存し、正午に当日の終了時刻が15時へ変更された場合を考えます。TTLが24時間なら、期限切れだけに任せると変更後も古い回答が残ります。この場合は、受付時間の情報を更新した時点で、関連するキャッシュを削除または無効化する仕組みが必要です。

対象を特定するために、保存時に参照した規約やFAQの識別子、知識の版をメタデータへ付ける方法があります。情報更新時に関連する回答をまとめて無効化するか、新しい版の条件で検索し、古い版を候補から除外します。TTLは長く残り続けるデータを整理する手段として使い、既知の変更は更新処理と連動させます。
ヒットするたびにTTLを延ばす方式にも注意が必要です。よく使われる回答を残しやすい一方、人気のある古い回答が繰り返し延長される可能性があります。この方式を採る場合は、登録時点からの最長保存期限を別に設ける、情報更新時の無効化を併用するなど、利用頻度だけで有効期間が決まらないようにします。
管理する版は知識だけではありません。生成モデルやプロンプトが変われば、回答に求める内容や形式も変わります。以前の回答を引き続き使えるかを確認し、必要に応じてキャッシュを分離します。埋め込みモデルを変更する際は、保存済みの質問を新しいモデルで再変換し、再登録や再索引を行うことも検討します。
また、TTLは誤答を正す機能ではありません。保存直後から誤っていた回答は、期限内に何度返しても誤答のままです。保存内容の確認に加え、問題のある回答が見つかったときに該当データを停止・削除できるようにしておくと、同じ誤りの拡大を防げます。
プロンプトキャッシュやRAGとの使い分け
関連技術を選ぶときは、何を再利用または取得し、その後に回答生成が必要かで整理すると分かりやすくなります。完全一致キャッシュと意味的キャッシュは完成回答を再利用する方式です。一方、プロンプトキャッシュとRAGは、回答を生成する処理の中で役割を持ちます。
| 方式 | 再利用・取得する対象 | 照合・検索の考え方 | 回答生成の有無 |
|---|---|---|---|
| 完全一致キャッシュ | 保存済みの完成回答 | 質問文字列などのキーの一致 | ヒット時は省ける |
| セマンティックキャッシュ | 保存済みの完成回答 | 質問の意味の近さと適用条件 | ヒット時は省ける |
| プロンプトキャッシュ | 共通する入力部分の計算結果 | 入力の先頭部分などの一致 | 通常は必要 |
| RAG | 回答の根拠となる文書やその一部 | 質問に関連する情報を検索 | 通常は必要 |
プロンプトキャッシュは、毎回共通する指示文や資料など、入力の先頭部分であるprefixの計算を再利用します。入力を処理する負担を減らせても、通常はモデルの呼び出しと出力の生成が残ります。以前の完成回答を返すセマンティックキャッシュとは、削減する処理が異なります。
RAGは検索拡張生成と呼ばれ、関連する文書の一部を検索してモデルへ渡し、それを根拠に回答を作る方法です。同じベクトル検索を使う構成でも、RAGは回答の材料を探し、セマンティックキャッシュはそのまま返せる回答を探します。資料が見つかったことと、完成回答が再利用できることを区別しましょう。
これらは併用できます。まずキャッシュを確認し、ヒットすれば保存済み回答を返します。ミスならRAGで必要な情報を取得して生成し、保存条件を満たす回答を登録します。この生成経路で共通の入力がある場合には、プロンプトキャッシュも利用できる構成が考えられます。
導入は、内容が安定し、繰り返し尋ねられるFAQから始めると評価しやすくなります。対象を決めたら、回答を共有してよい範囲、言い換えと誤再利用の判定、情報更新時の扱いを順に確認します。同じ答えを安全に返せる条件を明確にすることが、生成コストと待ち時間を減らしながら、回答品質を保つための土台になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |