
PagedAttentionとは?KVキャッシュを分割してLLMのメモリの無駄を減らす仕組み

AIの初心者
LLMを動かせるGPUでも、同時に質問する人が増えるとメモリが足りなくなるのはなぜですか?

AI専門家
モデル本体に加えて、それぞれの文章を生成するための「KVキャッシュ」が必要だからです。文章の長さも終了する時刻も違うので、メモリの割り当て方によっては未使用の場所が増えます。
AIの初心者
PagedAttentionを使うと、そのキャッシュを小さく圧縮できるのですか?
AI専門家
中心となる工夫は保存場所の管理です。小さなブロックを必要に応じて割り当て、離れた場所にあるキャッシュも順序どおりに参照します。中身と置き場所を分けて考えると理解しやすくなります。
PagedAttentionとは。
PagedAttention(ページドアテンション)は、LLMの推論で使うKVキャッシュを固定サイズのブロックに分け、メモリ上で離れて配置されたブロックを対応表から参照してAttentionを計算する手法です。2023年にvLLMで紹介され、必要に応じた割り当てやブロックの共有によって、キャッシュ用メモリの無駄を抑えます。
理解の出発点は、モデルを読み込む容量と、処理中の要求に応じて増える容量を分けることです。以下では、KVキャッシュが増える理由から、空いた領域の再利用、ほかの推論高速化手法との違いまで順番に見ていきます。
KVキャッシュはなぜメモリを圧迫するのか
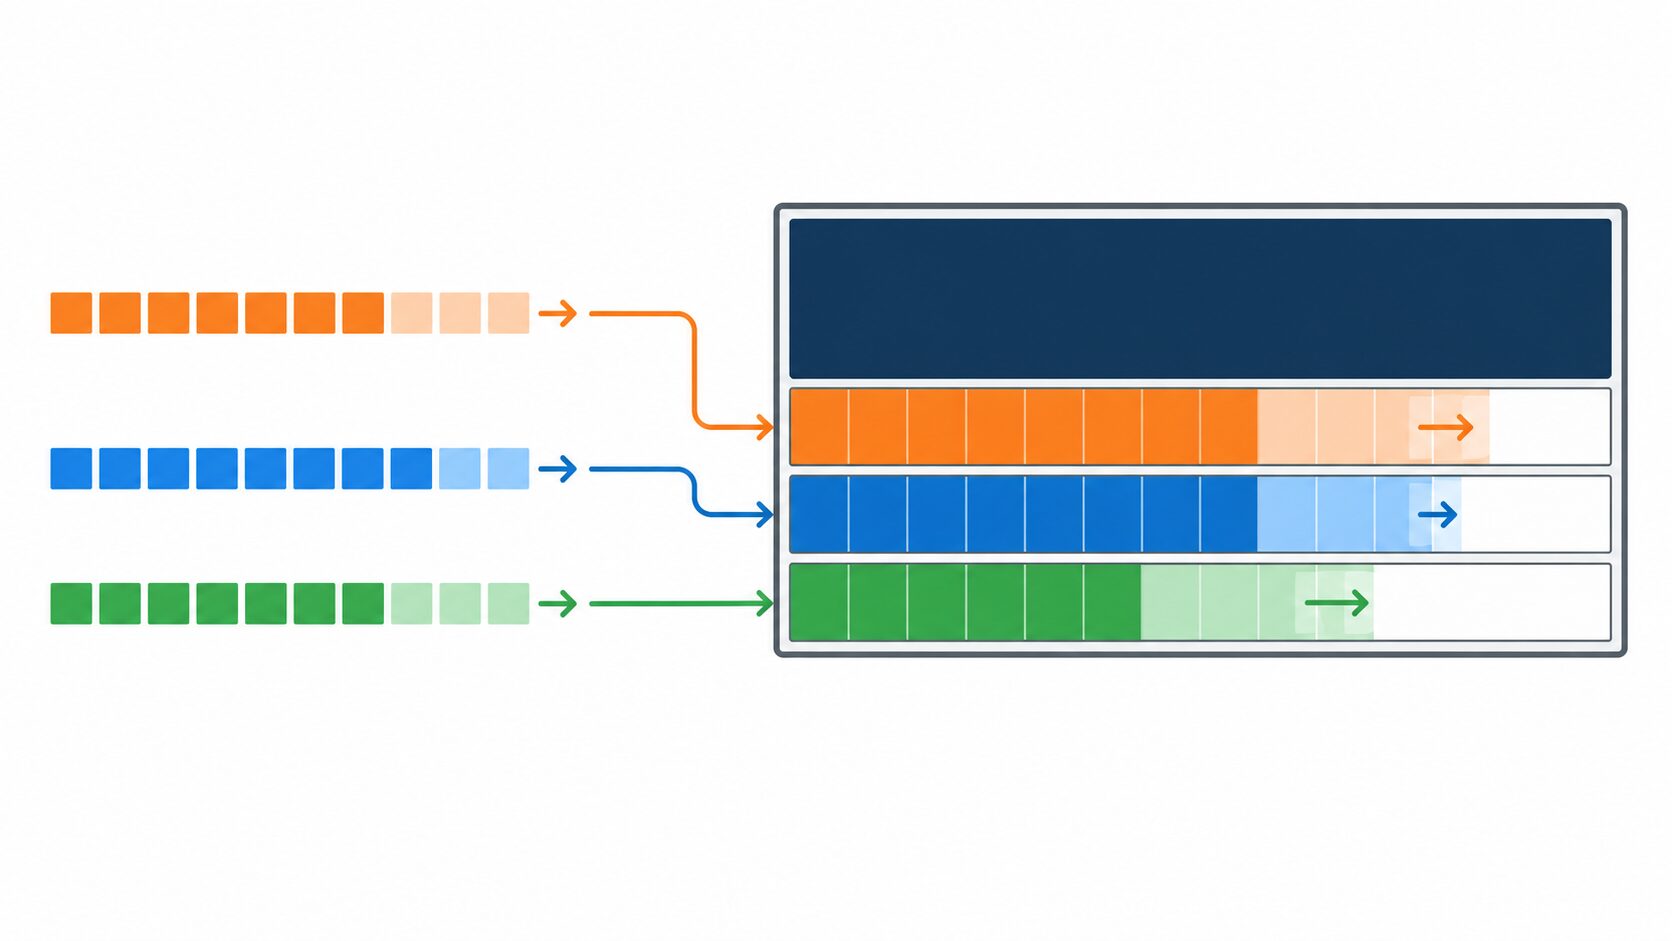
KVキャッシュは、過去のトークンについて計算したKeyとValueを保存し、後続の生成で再利用する仕組みです。トークンは文章を処理するための小さな単位で、必ずしも一文字や一単語と一致しません。Attentionは、これまでの文脈のどこを参照するかを計算する働きを持ちます。
文章を一つずつ先へ生成するとき、過去のKeyとValueを毎回作り直すのは非効率です。そこで計算済みの値をキャッシュに残し、新しいトークンの処理に使います。再計算を減らせる代わりに、過去の情報を置いておくメモリが必要になります。
この容量は、学習済みの知識を表すモデルの重みとは別です。同じモデルを使う複数の要求でも、入力された文章や生成途中の内容が違えば、それぞれに対応するKVを保持します。「モデル本体がGPUに収まる」ことだけでは、多数の要求を同時に処理できるとは限りません。
一般に、入力が長いほど最初に保持するKVが増え、出力が伸びるほど生成中の保持量も増えます。同時に処理する要求が多ければ、その分のキャッシュも必要です。短い質問への回答と長文の要約が混在するサービスでは、要求ごとに必要量もメモリを使い終わる時刻も異なります。
ここで各要求に、想定する最大長に合わせた大きな連続領域を先に確保すると、短い回答で終わった要求には使わない予約領域が残ります。また、長さの異なる領域を確保・解放すると、空きがあっても一続きの大きな領域として使いにくい隙間が生じることがあります。こうした問題がメモリの断片化です。
つまり、メモリ不足には「実際に保存すべきKVが多い」という理由と、「割り当てた領域を十分に使えていない」という理由があります。PagedAttentionが主に改善するのは後者です。必要な情報量そのものがなくなるわけではありません。
PagedAttentionはブロック表で論理順序と物理配置を分ける
PagedAttentionは、OSがメモリを小さなページ単位で管理する考え方に着想を得ています。2023年のvLLMの紹介記事で示された中心的な工夫は、KVを固定トークン数のブロックに分け、一続きの大きな保存場所を必要としないようにすることです。
ここでは「論理順序」と「物理配置」を区別します。論理順序は、文章の先頭から数えてどのブロックが何番目に来るかという順番です。物理配置は、それぞれのブロックを実際のメモリのどこへ保存したかを指します。この二つを結び付けるのが、要求ごとに用意するブロック表(block table)です。
例えば、ある文章の第1、第2、第3ブロックを、メモリ上では離れた空き領域に保存しても構いません。表に「第1ブロックの保存先」「第2ブロックの保存先」を登録しておけば、計算側は必要なKVの場所をたどれます。本の各章を別々の棚に置き、目録で順序と置き場所を結び付けるイメージです。

Attentionの計算も、この対応関係を使って分散したKVを読み出せるようにします。保存先が離れていても、トークンの順番や参照すべき文脈は保たれます。近くのブロックだけを読むことで過去の文脈を切り捨てる、という仕組みではありません。
生成中は、現在のブロックに空きがある間はそこを使い、収まらなくなった段階で次のブロックを追加します。最初から最終的な出力長を予測して、大きな連続領域を予約する必要が薄れます。ブロックの大きさは実装や設定によって異なり、全システム共通のトークン数が決まっているわけではありません。
ただし、最後のブロックを使い切らなければ、その内部には余りが残ります。また、対応表の保持や参照にも処理が必要です。無駄を抑える手法であって、すべての領域を常に隙間なく利用できるという意味ではありません。
重要なのは、これはKVの値を圧縮・削除する方法ではなく、配置と参照の工夫だという点です。「ページ」という名前でも、CPUメモリやディスクへデータを退避することが必須ではありません。GPU内のKV保存領域をブロック単位で管理する場合にも、この考え方が使えます。
要求の終了で空いたブロックを再利用する具体例
説明のため、1ブロックに4トークン分のKVが入ると仮定します。要求Aが6トークン分、要求Bが9トークン分のKVを保持している場面では、必要な割り当ては次のようになります。ここでの4という値は、仕組みを理解するための例です。
| 要求 | 保持するKV | 割り当て | 末尾の余り |
|---|---|---|---|
| A | 6トークン分 | 2ブロック=8トークン分 | 2トークン分 |
| B | 9トークン分 | 3ブロック=12トークン分 | 3トークン分 |
Aは1個目を使い切り、2個目の半分まで使います。Bは2個を使い切り、3個目に1トークン分を置きます。合計15トークン分のKVに対して20トークン分の枠を確保するため、5トークン分の余りはあります。この例からも、ブロック化してなお末尾の未使用分が残ることが分かります。
次にAが終了し、そのKVを保持する必要もなくなったとします。Aが使っていた2ブロックは空きとして返却できます。新しい要求Cが来れば、その領域をCに割り当てられます。場所がBのブロックの隣である必要はありません。

BのKVが9トークン分から12トークン分へ増える間は、すでに確保した3ブロックで足ります。13トークン分になれば4個目が必要なので、Aが返したブロックの一つを使うこともできます。Bの表に新しい保存先を加えればよく、Bの既存のKVを一つの連続領域へ詰め直す必要はありません。
このように、小さな同じ大きさの単位で空きを回すと、終了時刻の違う要求が混在しても領域を再利用しやすくなります。ただし、他の系列が共有中のブロックなど、参照が残っている領域はそのまま解放できません。
節約できた領域は、別の要求を受け入れる余地になります。一方、この仮想的な枠数だけから「実機のメモリが何%減る」「処理が何倍になる」とは判断できません。実際の容量にはモデル構造やKVの数値形式なども関係します。
共通ブロックの共有とコピーオンライト
ブロック単位の管理は、同じ内容を重複して持たないためにも役立ちます。例えば、同一のプロンプトから回答候補を三つ生成する場合、分岐する前の入力部分には共通のKVがあります。その部分を候補ごとに複製する代わりに、複数の系列のブロック表から同じ物理ブロックを参照できます。
ここでいう系列は、入力と、それに続いて生成される一つのトークン列です。共通部分を共有できても、候補ごとに生成内容が分かれた後のKVは別々に必要になります。文章中に同じ単語があるだけで、どこのブロックでも共有できるわけではありません。
共有を管理するために使うのが参照カウントです。あるブロックを何本の系列が使っているかを数えておき、一つの候補が終了しても、別の候補が利用中ならブロックを残します。参照がなくなったところで、その領域を再利用できるようにします。

注意が必要なのは、共有しているブロックへ一方の系列が書き込む場面です。例えば、共通入力の末尾ブロックに空きがあり、そこへ候補ごとに異なる生成結果のKVを追加すると、同じ保存先を使い続けることはできません。
そこでコピーオンライト(copy-on-write)を使います。書き込む側に必要なブロックを複製し、その系列の参照先を変更してから書き込みます。もう一方の系列は元の内容を引き続き参照できます。書き換えない共通ブロックまで、すべて最初からコピーする必要はありません。
ただし、この「共有しやすい構造」と、どの要求同士でKVを再利用するかという運用上の判断は別です。PagedAttentionを採用するだけで、任意の要求の共通部分が自動的に検出・共有されるとは限りません。再利用する条件や保持期間は、推論基盤の機能や設定に依存します。
Continuous Batching・prefix caching・量子化との違い
LLM推論の効率化には、保存場所、実行する要求の組み合わせ、計算結果の再利用、数値の表現といった異なる工夫があります。PagedAttentionと一緒に登場する用語も、担当する役割を分けると整理できます。
| 手法 | 主な対象と役割 | PagedAttentionとの関係 |
|---|---|---|
| PagedAttention | KVの配置と割り当てを管理し、予約領域や断片化、重複保持の無駄を抑える | ブロック表で分散したKVを参照する土台 |
| Continuous Batching | 実行中のバッチに要求を参加・退出させ、処理の機会を使う | 要求の入れ替えに伴うKVの確保・解放と組み合わせられる |
| prefix caching | 一致する先頭入力のKVを再利用し、入力部分の再計算を減らす | 再利用対象のKVをブロック単位で管理できる |
| 重みの量子化 | モデル重みの数値表現のビット幅を減らす | モデル本体の容量を減らす別の工夫 |
| KVキャッシュの量子化 | 保存するKey・Valueの数値表現のビット幅を減らす | ブロック内に保存する値の容量を減らす工夫 |
Continuous Batchingは、例えば短い回答が終わった後に新しい要求を処理へ加える仕組みです。「いつ、どの要求を計算するか」を扱います。PagedAttentionは、その要求が使うKVの置き場所を扱うため、両者は組み合わせやすい関係にあります。
prefix cachingは、同じ長い先頭入力が繰り返されるときに有用です。すでに計算した先頭部分のKVを再利用できれば、その部分の入力処理を省けます。対してブロック表そのものは、入力が一致するか、終了後もKVを残すかを決める機能ではありません。
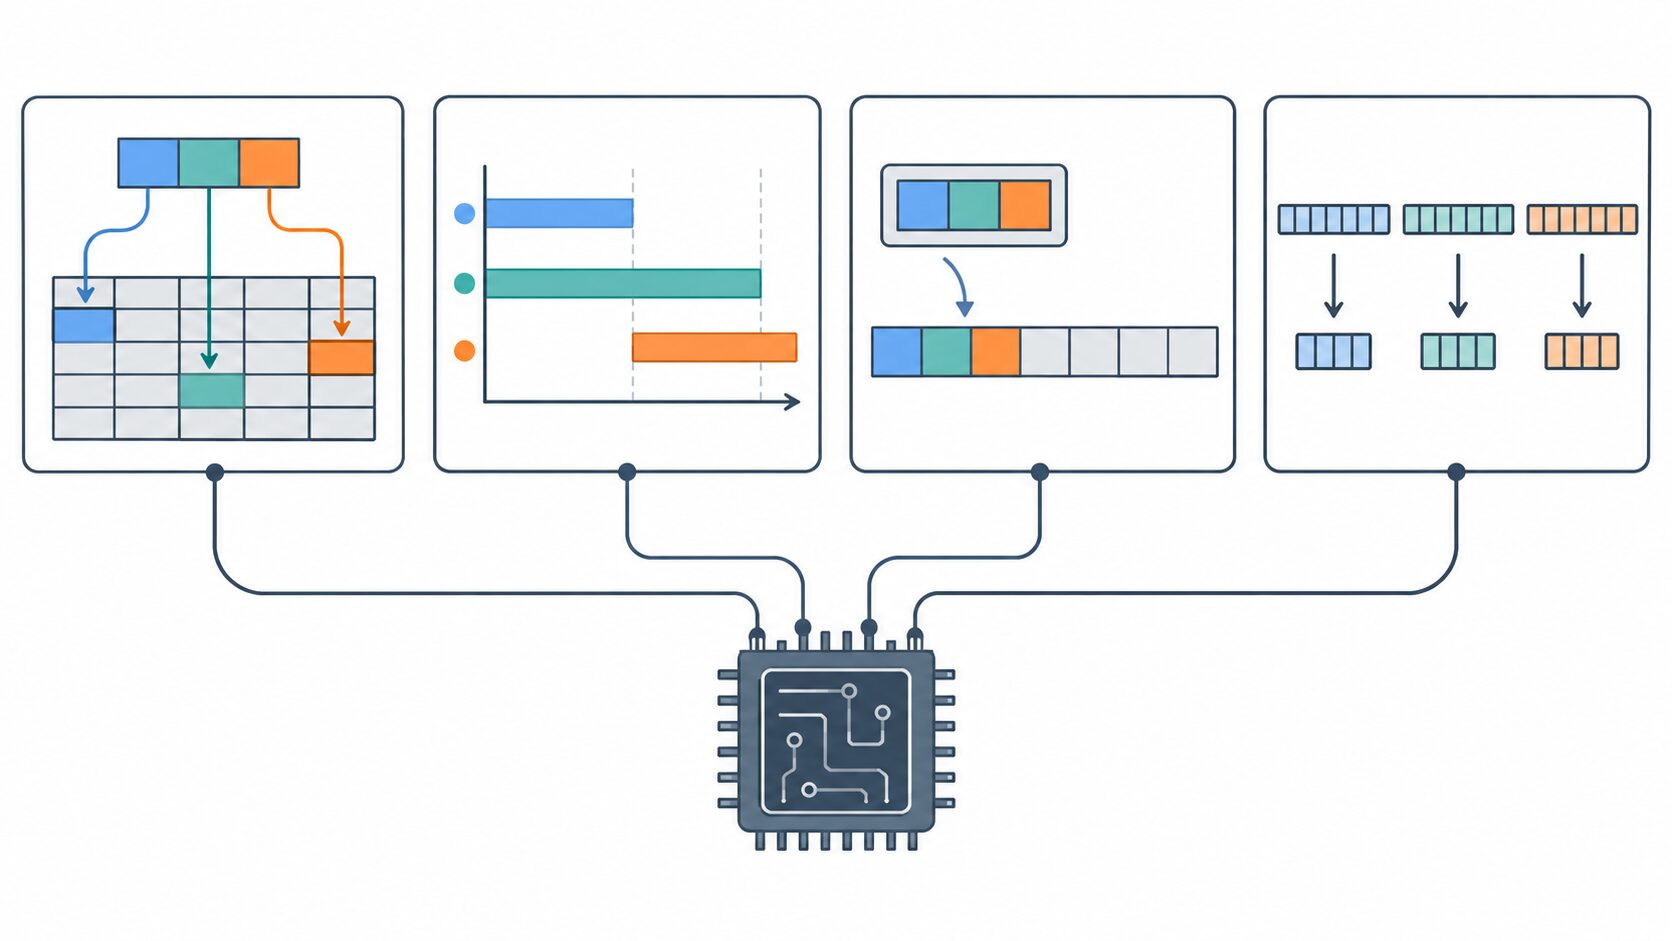
量子化では、保存する数値の表現を変えるため、方式によって精度への影響を確かめる必要があります。また、重みを量子化したからといって、KVまで同時に量子化されるとは限りません。PagedAttention自体は、数値の精度を落として容量を減らす手法ではありません。
なお、入力をまとめて処理するprefillと、一つずつ生成するdecodeを別の処理基盤へ分離する設計もあります。その際のKV転送は「どこで処理を実行するか」という別の論点です。同一の推論基盤内でKVをどう配置するかとは分けて考えます。
効果が出る使いどころと性能改善の限界
PagedAttentionの利点が分かりやすいのは、長さの異なる要求が並行して流れるチャットサービスやLLMのAPI配信です。要求が順次終了し、新しい要求が入ってくる環境では、空きブロックの再利用によって限られたメモリを活用できます。
採用例はGPUサーバーだけに限りません。2026年9月22日のvllm-metalの公式記事では、Apple Silicon上でvLLMのスケジューラーとpaged KVのブロック管理を使い、MLX/Metalでモデルを実行する構成が紹介されています。これは2023年に提案された考え方をローカル推論にも使う事例であり、2026年に初めて登場した技術という意味ではありません。
性能を読むときは、スループットとレイテンシを区別します。スループットは、一定時間に何件の要求や何トークンを処理できるかという量です。レイテンシは、個々の要求に対して応答が返るまでの時間を指します。最初のトークンが返るまでと、回答全体が完了するまででも評価は変わります。
KVの割り当ての無駄が減れば、同じメモリに収められる要求を増やせる可能性があります。それによって全体の処理量が増えても、一件だけ実行したときの生成が必ず速くなるわけではありません。同時実行数を増やしすぎれば、個々の要求の待ち時間や応答時間が長くなることもあります。
また、保存すべきKV、モデル重み、計算用の一時領域は引き続き必要です。Attentionなどの計算量やメモリ帯域の制約も残り、ブロック表の管理にも負担があります。使えるKV領域が尽きれば、要求を待機させるなどの対応が必要です。vllm-metalの紹介でも、KVプールに空きがなければページの解放を待つ構成が説明されています。
2023年のPagedAttention論文が報告するスループットの改善倍率や、公式記事のメモリ効率の数値は、それぞれの比較対象と評価条件で得られたものです。モデル、機器、入力長、生成長、並列数、量子化や実行設定が変われば結果も変わります。vllm-metalのような推論基盤全体の性能を、PagedAttention単体の効果として扱うこともできません。
導入効果を判断するなら、普段の利用に近い要求の長さと並列数で、メモリ使用量、単位時間の処理量、応答時間を一緒に確認することが大切です。PagedAttentionは、必要なKVを保ちながら、その置き場所と共有の仕方を工夫する技術です。この役割を押さえると、ほかの最適化と組み合わせる理由や、メモリ不足を解消できる範囲を判断しやすくなります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |