
Late Chunkingとは?RAGで文脈を保つ仕組みと通常のチャンク化との違い

AIの初心者
RAGで社内文書を検索すると、会社名は合っているのに、知りたい説明の段落が見つからないことがあります。

AI専門家
文書を分割した結果、後ろの段落にある「同社」が、どの会社を指すのか捉えにくくなっているのかもしれません。
AIの初心者
小さな段落に分けながら、前の文章とのつながりも検索に生かせますか?
そのための方法の一つがLate Chunkingです。長い文章を先にモデルへ入力し、文脈を反映した数値表現を後から検索単位ごとにまとめます。
Late Chunkingとは。
Late Chunking(レイト・チャンキング)は、文書全体またはモデルの入力上限内の文章から、文脈を反映したトークン単位の表現を作り、その後でチャンクごとに集約する手法です。RAGの索引作成時に用い、分割された文章の検索用ベクトルへ、同じ入力内にある周囲の情報を反映させます。
中心となるのは、文書を検索しやすい小さな単位にすることと、モデルに広い範囲を読ませることを両立させる考え方です。まず、分割によって何が失われるのかを確認しましょう。
文書を先に分割すると文脈が失われる理由
RAGは、質問に関係する資料を検索し、その内容を生成AIの回答に利用する仕組みです。検索の準備では、長い文書をチャンクと呼ぶまとまりに分け、それぞれをベクトルとして索引に登録します。チャンクは段落や一定の長さなどで区切り、必要な説明を取り出すための単位になります。
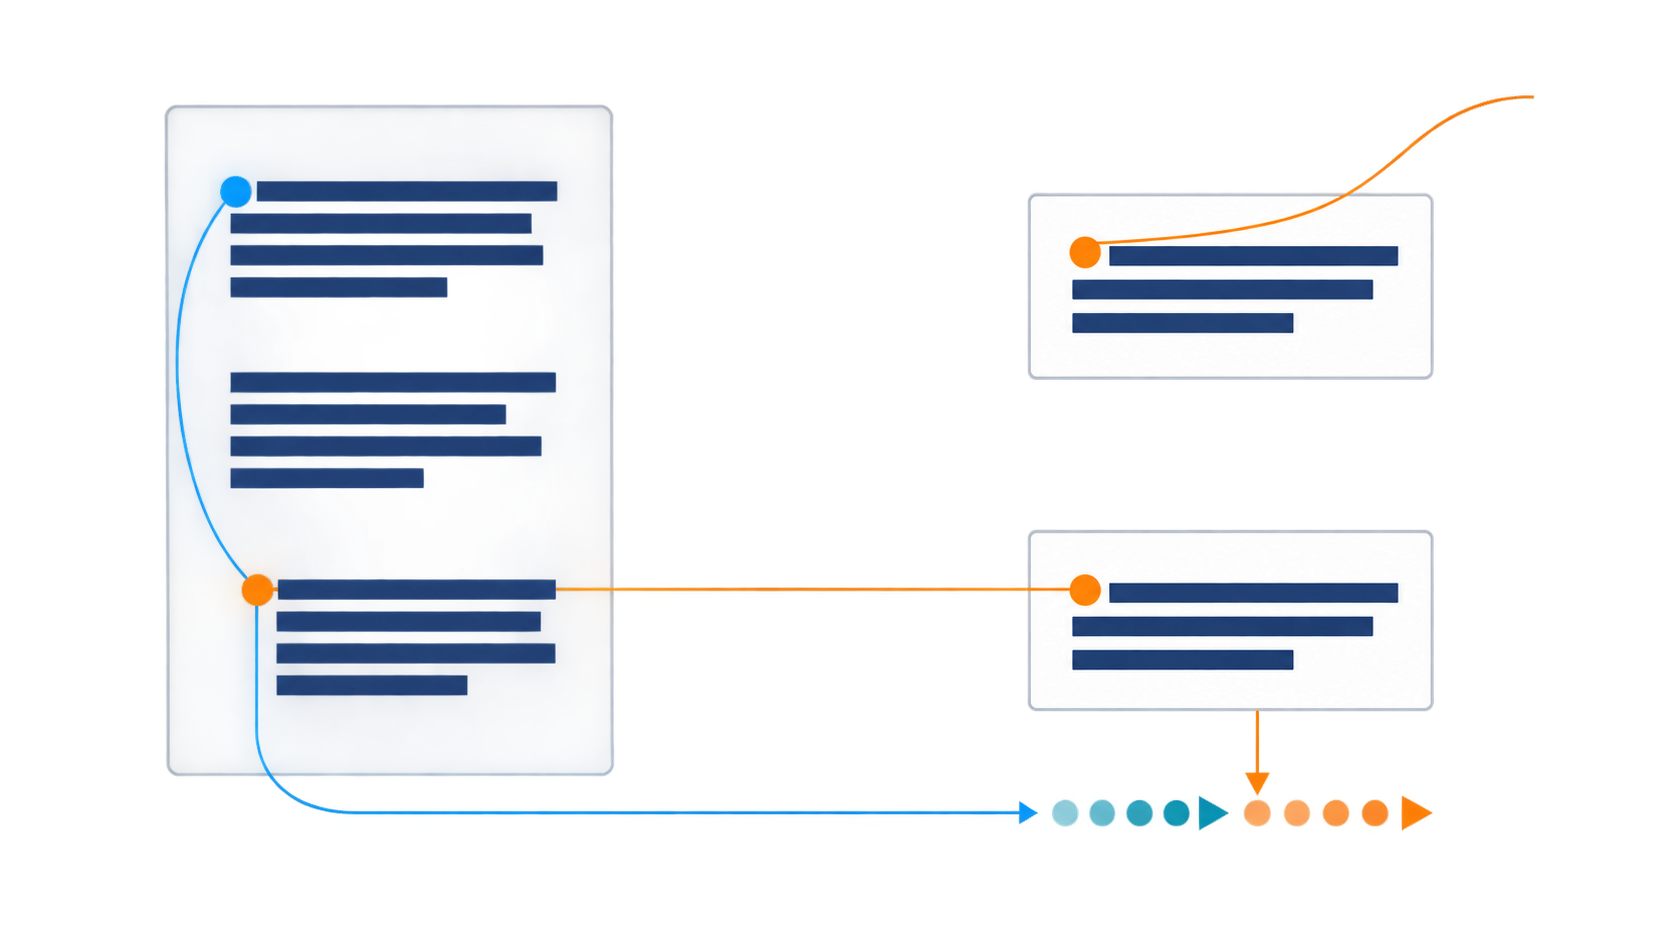
ただし、人が読む文章は、段落だけで意味が完結するとは限りません。冒頭で会社や製品を紹介した後は、「同社」「本製品」「この制度」と言い換えることがあります。後半のチャンクだけをモデルへ入力すると、そこに書かれた性質は捉えられても、何について述べた文章なのかを特定する情報が不足します。
例えば、「本製品は低温環境でも動作する」という文章には、製品名がありません。製品名を含む質問と照合するとき、別の段落にある紹介文を読めないモデルには不利な条件です。原文から情報が消えたわけではなく、検索用の表現を作る際に参照できる範囲が、分割によって狭くなることが問題になります。
チャンクを大きくすれば周辺の説明を含めやすくなりますが、一つの検索結果に複数の話題が入り、必要な箇所を絞りにくくなる場合があります。Late Chunkingは、検索単位の大きさと、表現を作る際に読む範囲を分けて考える手法です。本文に補足説明を追記するのではなく、広い文脈を踏まえた表現を各チャンクへ割り当てます。
この手法は2024年に提案された研究です。Jina AIの解説は2024年8月22日付で、arXiv論文の初稿は同年9月7日に提出されています。2025年7月7日改訂の第3稿はプレプリントとして公開されており、査読済みの論文と断定して扱うものではありません。
Late Chunkingと通常方式の処理順を比べる
違いを理解するには、「モデルが文章を読む処理」と「チャンクを一本のベクトルにまとめる処理」を分けることが大切です。ここでは、トークンの表現を集約して埋め込みを作る方式を、同じチャンク境界で比べます。トークンとは、モデルが文章を扱うために分けた語や語の一部などの単位です。
通常のチャンク化では、次の順番で処理します。
- 本文を段落や長さに応じてチャンクに分割する。
- 各チャンクを個別の入力として埋め込みモデルに渡し、その中のトークン表現を得る。
- チャンク内のトークン表現をpoolingし、検索用のベクトルを作る。
pooling(プーリング)は、複数の数値表現を一つにまとめる処理です。mean poolingでは、対象となるトークン表現を各成分について平均し、一本のベクトルにします。文章を短い説明文に書き直す「要約」とは異なり、出力は数値の並びです。
一方、Late Chunkingでは次の順番になります。
- 文書全体、またはモデルの入力上限に収まる範囲をまとめて埋め込みモデルへ渡す。
- 同じ入力内の周囲の語を踏まえた、文脈化されたトークン表現を得る。
- チャンク境界に対応するトークン範囲を取り出し、その範囲をmean poolingして各チャンクのベクトルを作る。
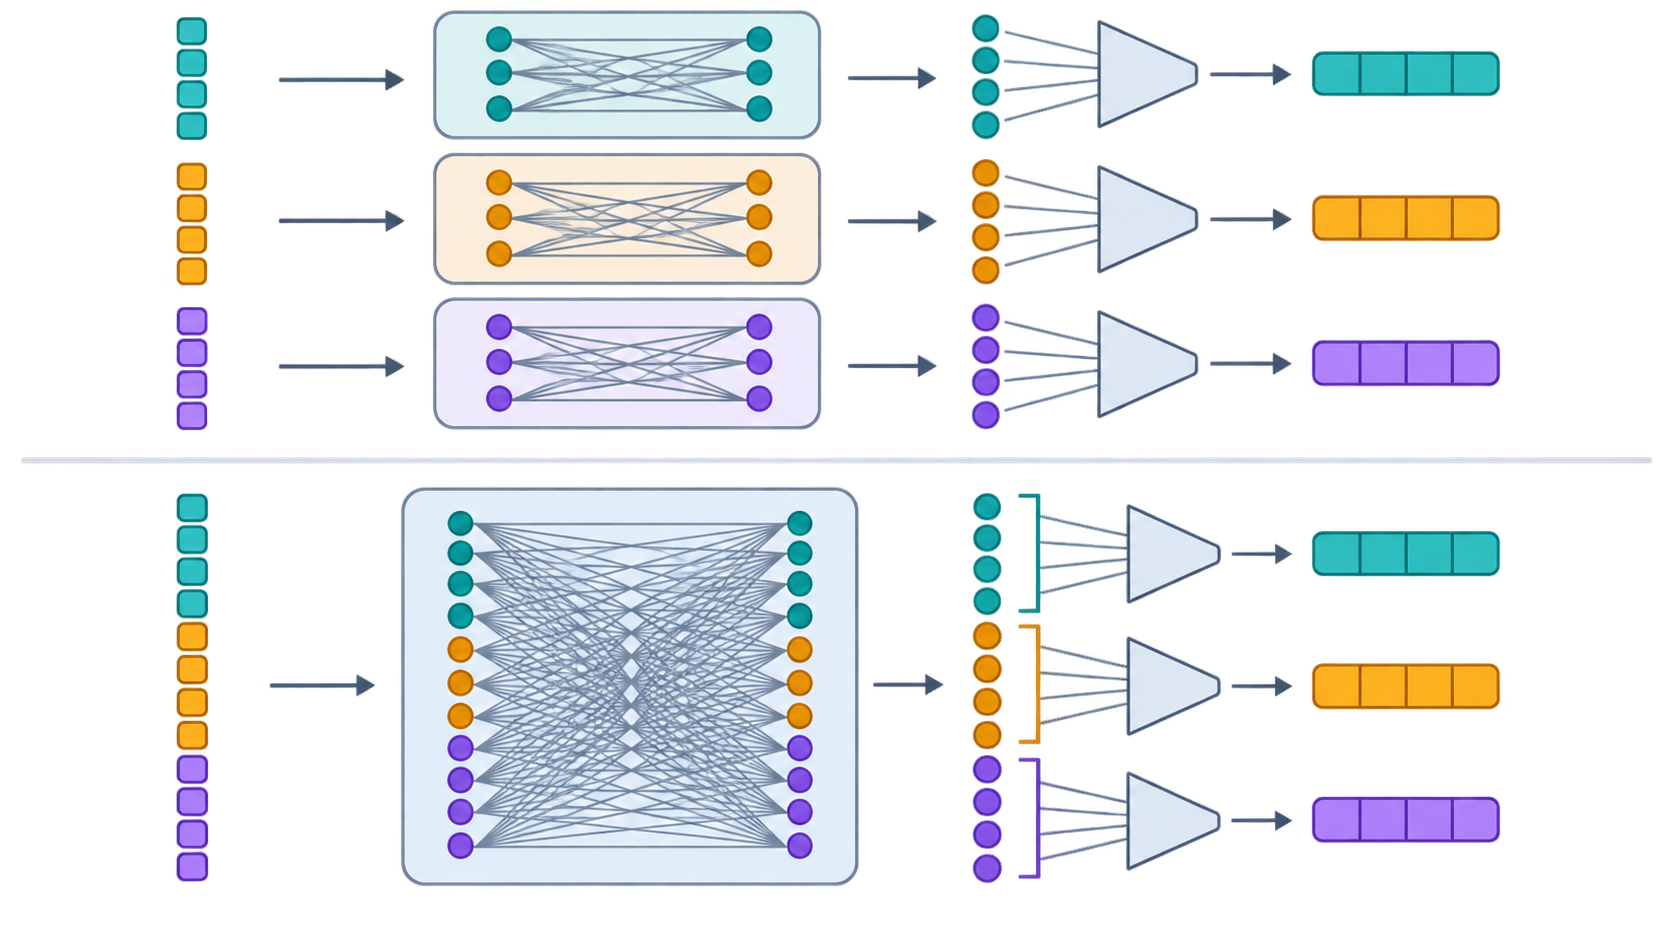
後者では、平均する対象が後半のチャンク内だけであっても、そのトークン表現を作る段階で前半の文章を参照できます。つまり、集約する範囲は小さくても、集約される表現には広い文脈が反映され得るということです。最終的には、通常方式と同じようにチャンクごとのベクトルを索引へ登録します。
「遅く分割する」という名前でも、境界を決める作業まで必ず後回しにする必要はありません。区切り位置を先に決めておき、モデルの出力後にその位置を使って集約できます。後に回すのはチャンク単位の集約であり、検索の質問が来るまで分割せずに待つ、という意味ではありません。
会社名を省略した段落で文脈保持を考える
架空の社内資料に、次の二つの段落があるとします。段落ごとに一つの検索チャンクを作る条件で考えてみましょう。
青葉電機は、家庭向けの蓄電池を開発しています。
同社は、修理部品を10年間供給します。
利用者の質問は「青葉電機の部品供給期間は?」です。答えに必要な「10年間」は後半にありますが、会社名が書かれているのは前半です。通常方式で後半だけを入力すると、モデルは部品の供給期間を表現できても、青葉電機についての説明だと判断する手掛かりを、その入力内には持てません。
両段落をまとめて入力するLate Chunkingでは、「同社」の表現を作るときに、前段の会社名を踏まえられます。その表現を含む後半のチャンクを集約することで、会社名を含む質問との対応を捉えやすくする狙いがあります。後半の本文は「同社」のままであり、検索結果の文章に会社名を自動で書き足すわけではありません。
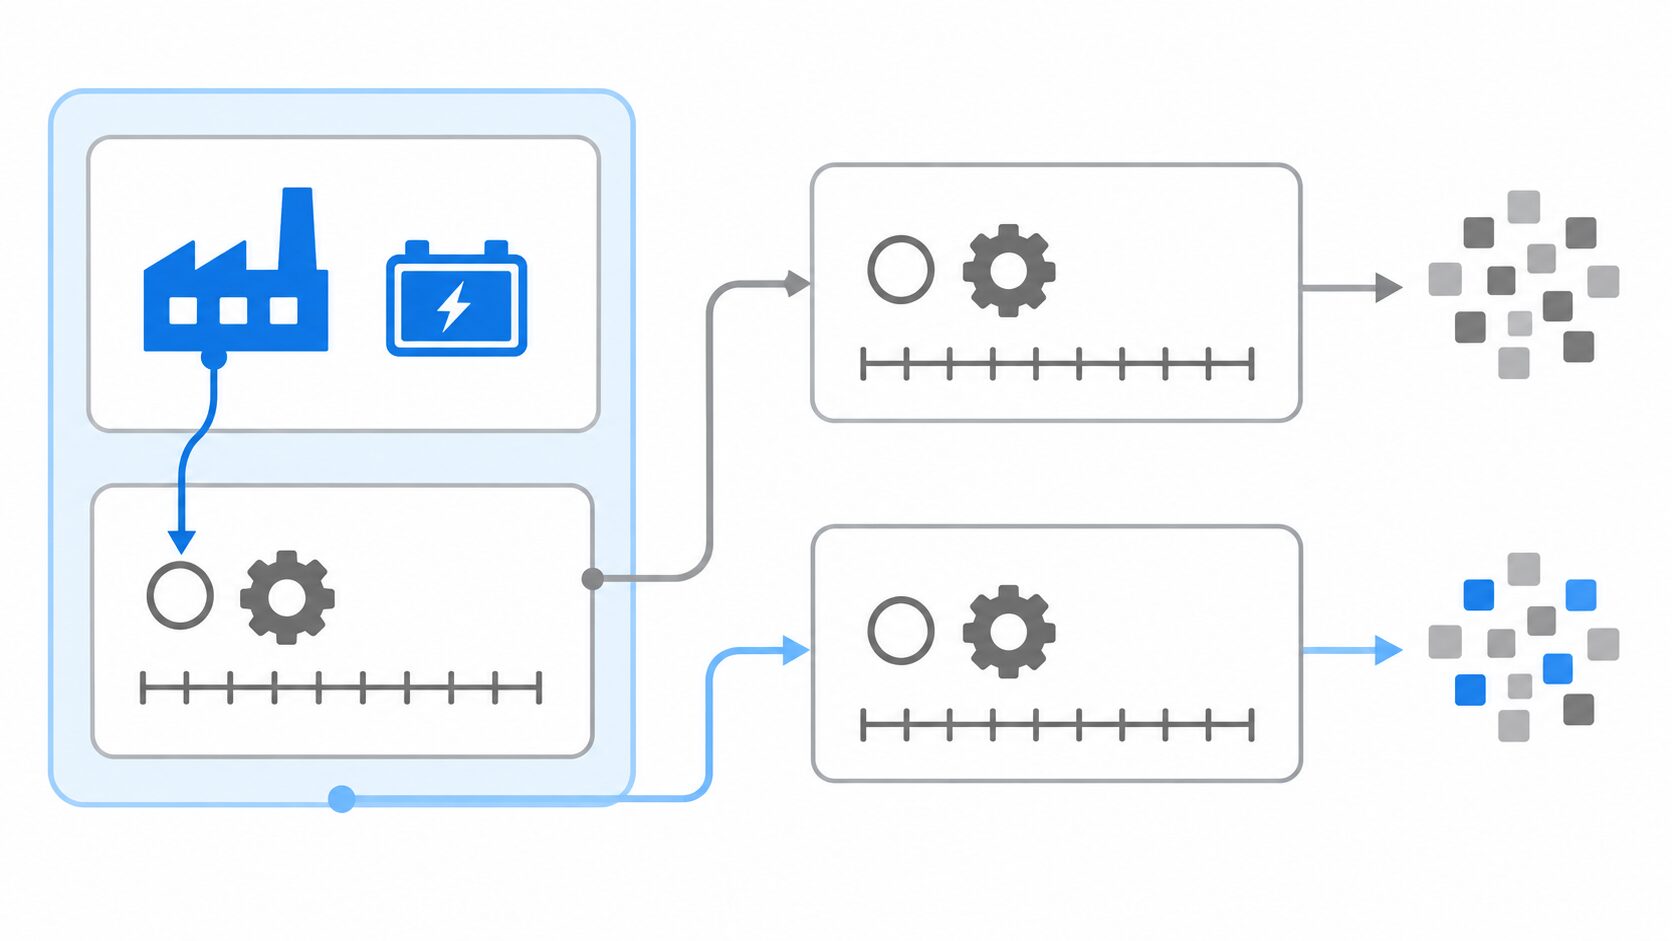
ここで、検索の改善と、回答の根拠が十分にそろうことは別に確認する必要があります。後半だけが検索されて生成AIへ渡された場合、その文章だけでは「同社」の参照先が明示されません。回答時にも会社名の確認が必要なら、文書名や隣接段落を一緒に渡すなど、検索後に渡す情報の範囲を設計します。
この会社の例は仕組みを説明するための架空例で、検索順位の改善を実測した結果ではありません。論文には、Berlinについての先行する記述と、後続する「its」「the city」のような表現を扱う例があります。後続部分がどの都市について述べているかを、埋め込みへ反映する考え方は共通しています。
論文の例で示される類似度の変化は、その文章と質問を使った条件での値です。類似度はベクトル同士の近さを示すもので、正解率や業務文書全体の検索改善率ではありません。個別の数値だけから、どの資料でも同じ効果が得られるとは判断できません。
Contextual Retrieval・チャンク重複との違い
文脈を補う方法は複数あり、どこに情報を加えるかが異なります。説明文を付け足すContextual Retrieval、トークン表現に周囲の情報を反映するLate Chunking、近くの本文を複製するチャンク重複を整理すると、使い分けの判断がしやすくなります。
| 方式 | 文脈を補う場所・本文追加 | 必要な処理 | 届く文脈の範囲 |
|---|---|---|---|
| Late Chunking | トークン表現へ反映。説明文の追加はしない | 長い入力の処理と、トークン範囲ごとの集約 | モデルへ同時に入力した範囲 |
| Contextual Retrieval | 検索対象のチャンクに文脈説明を追加 | LLMによる説明生成と、補足後の索引作成 | LLMに渡した文書のうち、説明へ取り込まれた情報 |
| チャンク重複 | 隣接チャンクに境界付近の本文を複製 | 重複幅を指定した分割と、各チャンクの埋め込み | 重複部分に含めた近隣の文章 |
Anthropicが説明するContextual Retrievalでは、文書全体と対象チャンクをLLMに渡し、そのチャンクがどのような内容かを補足する短い説明文を生成します。その説明をチャンクに加え、埋め込みによる検索と、語の一致を利用するBM25の索引作成に使います。
会社の例なら、「青葉電機の修理部品の供給方針についての記述」といった補足を加える考え方です。検索対象のテキストに会社名が入れば、語を照合する検索にも利用できます。一方、Late Chunkingでは元の文章中の語は増えません。ベクトルへの文脈反映が、BM25の索引にも自動的に及ぶわけではない点が違いです。
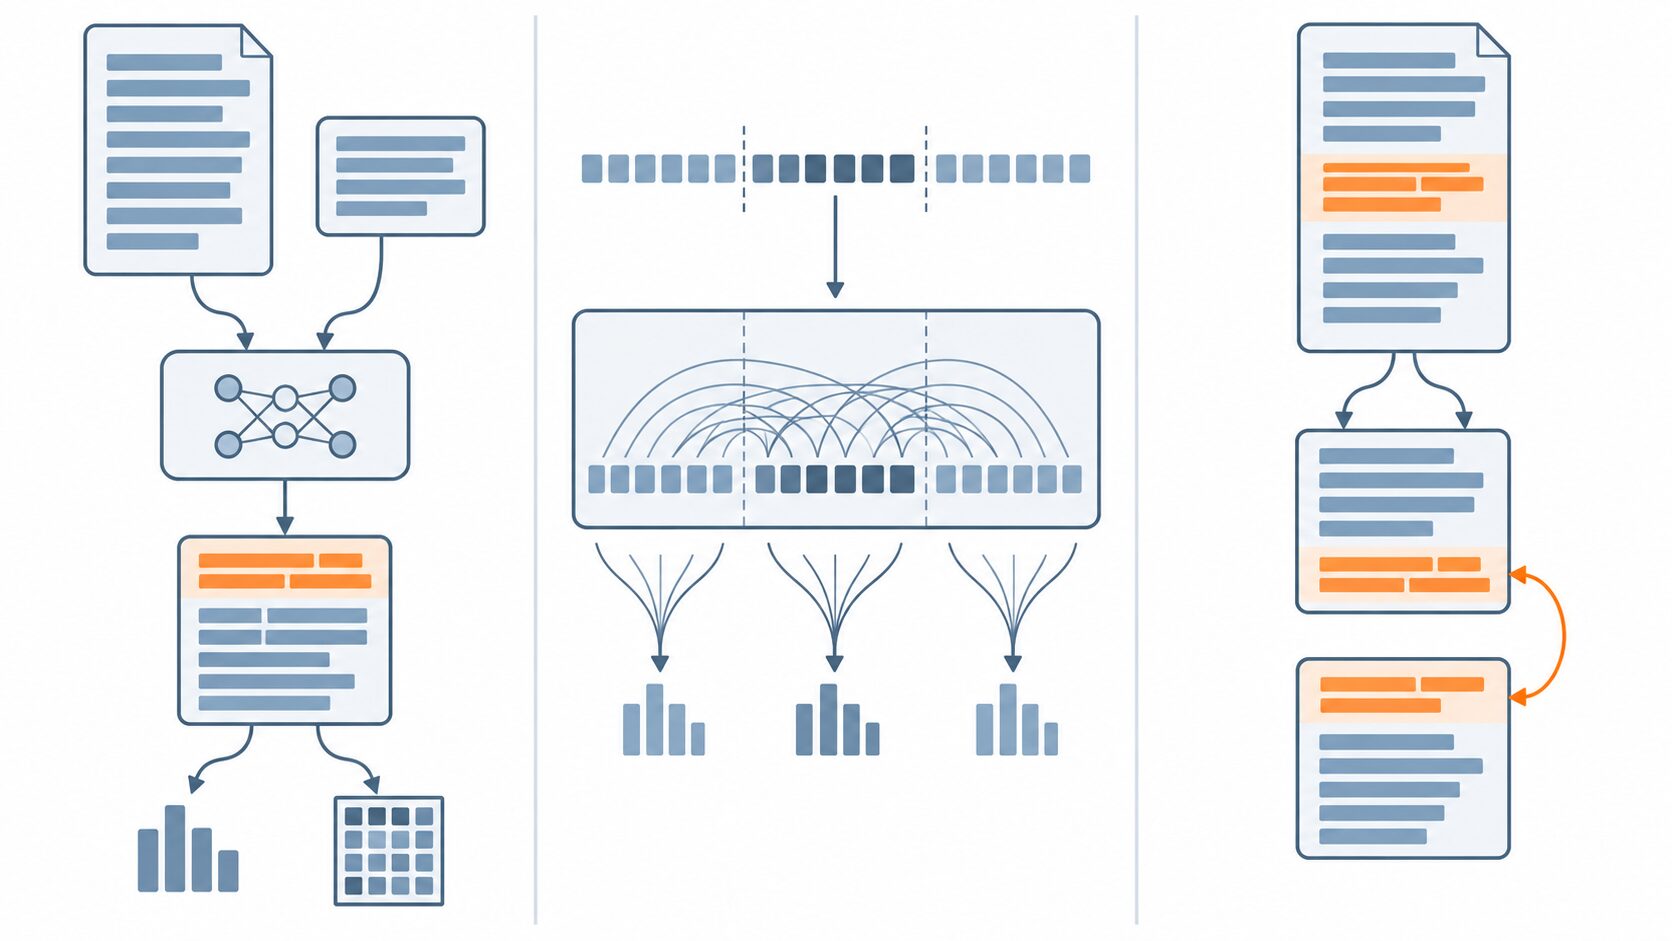
チャンク重複では、例えば前のチャンクの末尾を次のチャンクにも含めます。境界をまたぐ短い説明を残すのには役立ちますが、参照先が何段落も離れていると、設定した重複幅に入らない場合があります。重複を大きくすれば、索引に同じ文章が繰り返し入り、似た検索結果が並ぶこともあります。
三方式を一律に優劣で並べることはできません。Contextual Retrievalでは補足の正確さと生成コスト、Late Chunkingではモデルの出力仕様と長文処理、チャンク重複では重複幅と検索結果の重なりが検討点になります。資料内の参照関係と、使っている検索方式に合わせて選びます。
導入に必要なモデルと実装条件
導入の出発点は、利用中の埋め込みモデルから何を取得できるかを確認することです。単に入力可能な文章が長いだけでは、Late Chunkingを実装できるとは限りません。主に次の三つの条件が必要です。
- 長い入力に対応する埋め込み用Transformerモデル。参照元と参照先を同じ入力に含められる長さが必要です。
- pooling前のトークン単位の出力。チャンクごとの集約を自分で行える状態の表現を取得します。
- 文字位置とトークン範囲の対応付け。本文上の区切りが、モデルの出力のどこに当たるかを特定します。
多くの利用者が扱う埋め込みAPIの出力は、入力した文書やチャンクに対する完成済みのベクトルです。そのような出力だけでは、どの成分がどの段落に対応するかを切り分けられません。文書全体のベクトルを後から分割して、各チャンクのベクトルを復元する手法ではないため、取得可能な出力を確認する必要があります。
境界の対応付けも実装上の要点です。日本語の文字数とトークン数は同じではなく、一つの語が複数のトークンになることもあります。文字位置をそのままトークンの番号として使うと、違う範囲を集約しかねません。トークナイザーが返す元テキスト上の位置情報などを使い、文書ID、チャンク本文、範囲、ベクトルを対応させます。
論文では、追加学習なしで適用する方法を述べる一方、性能向上のためのfine-tuningも提案しています。したがって、導入時に必ずモデルを再学習するものではありません。ただし、トークン表現を取得できるという実装条件と、自分たちの資料で十分な検索性能が出ることは別です。採用するモデルと集約方法の組み合わせで評価します。
候補になるのは、冒頭で対象を定義し、後続の段落で条件や例外を説明する社内規程、製品の説明書、業務手順書などです。反対に、各項目に名称と説明がそろっている短いFAQでは、周囲を読むことの利点が小さい可能性があります。まずは、段落をまたぐ参照が原因と思われる検索失敗を集めると、適用の狙いが明確になります。
運用では、索引作成時間、メモリ使用量、文書更新時の再計算範囲も確認します。前半の変更が後半のトークン表現に影響し得るため、修正したチャンクだけを独立に再計算すればよいとは限りません。文書や入力範囲を単位として更新を扱う設計が必要になる場合があります。
文脈長の限界と検索品質の確かめ方
長文対応モデルにも、入力できるトークン数の上限があります。文書が上限を超えれば、全体を一度に読ませることはできません。また、上限内に収まることは、すべての参照関係が正しく表現される保証でもありません。長さ、話題の混在、参照先の曖昧さなどを含めて、実際の資料で確認する必要があります。
論文のlong late chunkingでは、長すぎる文書をmacro windowという大きな入力範囲に分ける考え方を扱います。各窓をモデルに入力し、その中のトークン表現から、より小さな検索チャンクのベクトルを作ります。窓の境界で文脈が切れる影響を抑えるため、隣り合う窓には文脈用のoverlapを設けます。
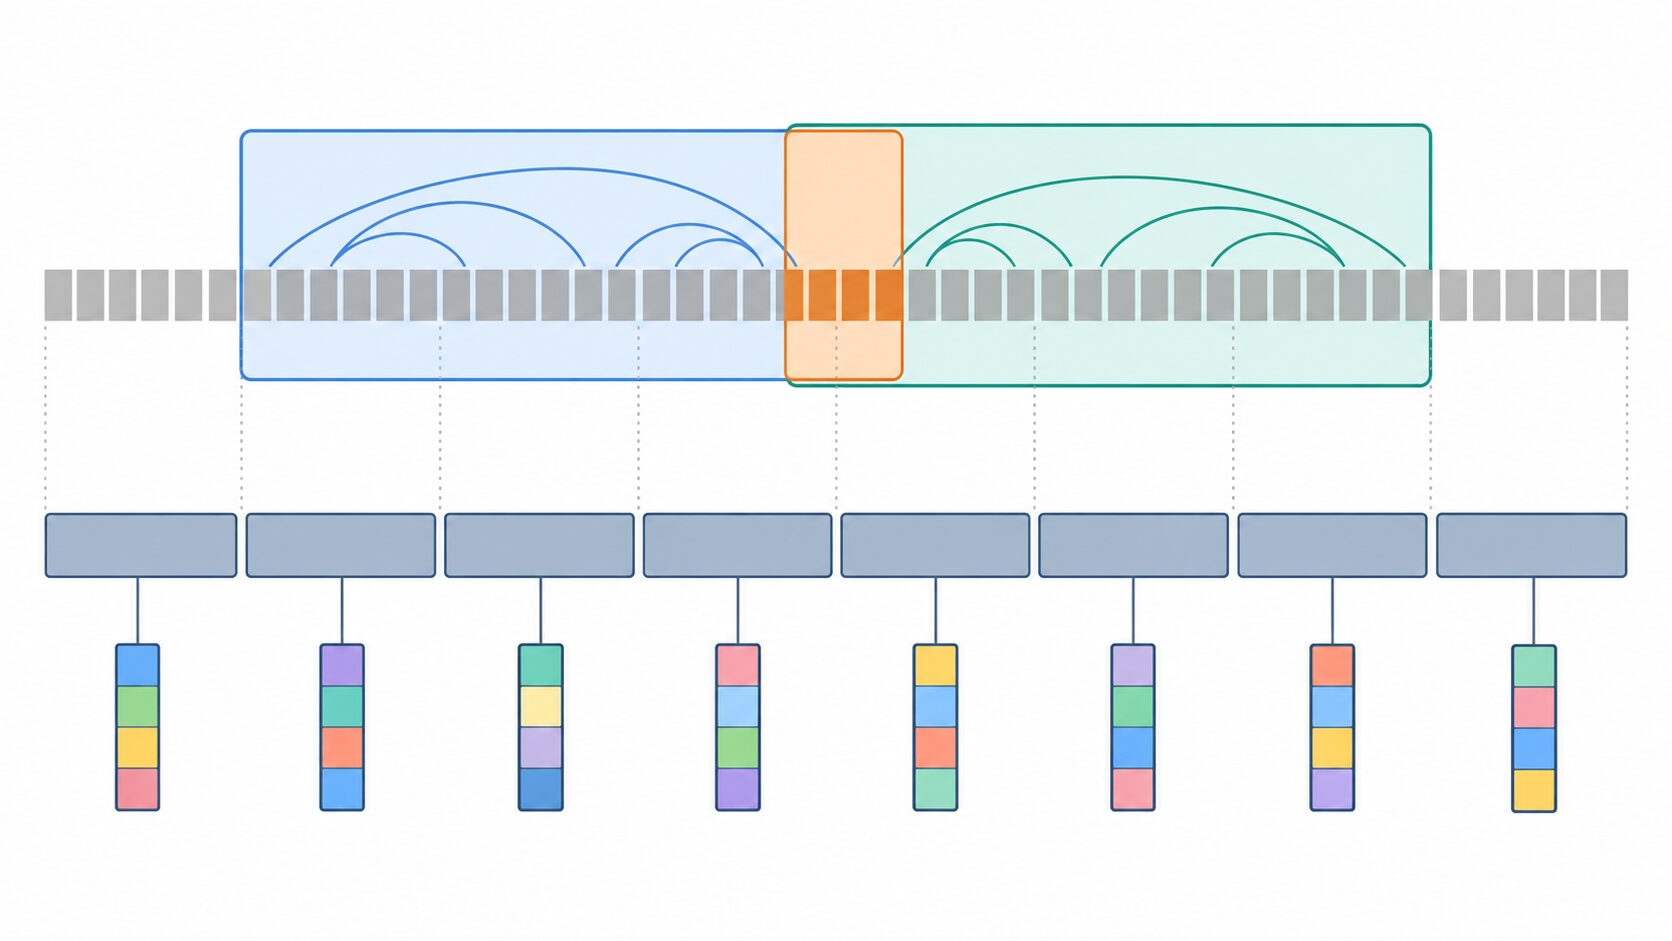
ここでの重複は、モデルが表現を作るときに読む入力範囲の重なりです。前の節で扱った、検索対象のチャンク本文を重複させる方法とは役割が異なります。窓を重ねても、同じ入力に含まれないほど離れた情報を無制限に参照できるわけではありません。見出しや節のまとまりも踏まえて窓を設計します。
効果を調べるときは、同じ文書集合、同じ質問、同じ埋め込みモデル、同じチャンク境界とサイズを使い、通常方式と比較するのが基本です。取得件数などの検索条件もそろえ、処理順を変えた効果を見ます。質問には、代名詞を含む段落を探すものだけでなく、固有名詞が明記された段落や、似た製品を区別するものも含めます。
まず、各質問で正解となる根拠の箇所を定めます。Recall@kは、正解とした検索対象のうち、上位k件にどれだけ含まれたかを見る指標です。nDCGは、関連性の高い結果を上位に並べられているかを評価します。例えば上位5件を回答に使う設計なら、その件数で必要な根拠を拾えるかが実務上の焦点になります。
検索指標に加えて、回答へ渡した文章だけで質問に答えられるかも確認します。会社名や適用条件が別の段落に残っている場合、答えの一部を含むチャンクを取得できても、根拠が足りないことがあります。隣接段落の追加などを行うなら、その後の入力内容まで含めて評価すると、検索の改善が回答に役立ったかを判断できます。
同時に、索引の作成・更新にかかった時間、必要なメモリ、検索結果に含まれる重複などを記録します。平均値の改善だけでなく、どの質問で良くなり、どこで悪くなったかを見ることも大切です。とくに複数の会社や製品が登場する文書では、周囲の文脈によって別の対象の説明と混同していないかを確かめます。
Late Chunkingは、検索単位を小さく保ちながら、その表現を作るときに広い文脈を利用する選択肢です。効果はデータ、区切り方、チャンクサイズに依存します。自分たちの文書で根拠を取り出しやすくなり、処理コストも許容できるかを確認して採否を決めることが、実用への近道です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |