
Matryoshka Embeddingsとは?次元を短くして使える埋め込みの仕組み

AIの初心者
文書検索に使う埋め込みが増えて、保存容量が気になっています。ベクトルの数値を途中で切れば、小さくできますか?

AI専門家
その使い方を想定して学習したものが、Matryoshka Embeddingsです。先頭の短い部分でも役立つように学習します。ただし、どんな埋め込みでも切ってよいわけではありません。
AIの初心者
対応モデルなら、短くするほどお得なのでしょうか。検索結果が悪くならないかも心配です。
AI専門家
容量は減らせますが、検索に必要な情報も失う可能性があります。仕組みと容量の目安を押さえたうえで、自分のデータで次元数を選ぶ方法を見ていきましょう。
Matryoshka Embeddingsとは。
Matryoshka Embeddings(マトリョーシカ埋め込み)とは、ベクトルの先頭から取り出した短い部分も有用な表現になるように学習した埋め込みです。その学習手法をMatryoshka Representation Learning(MRL)と呼びます。対応モデルが出力するベクトルの次元数を用途に合わせて選び、主に保存容量や検索時の比較処理を抑えるために使います。
入れ子の人形から小さい人形を取り出すように、一つの長い表現の中に短い表現が含まれます。大切なのは、短い表現も使うことを学習段階から想定している点です。
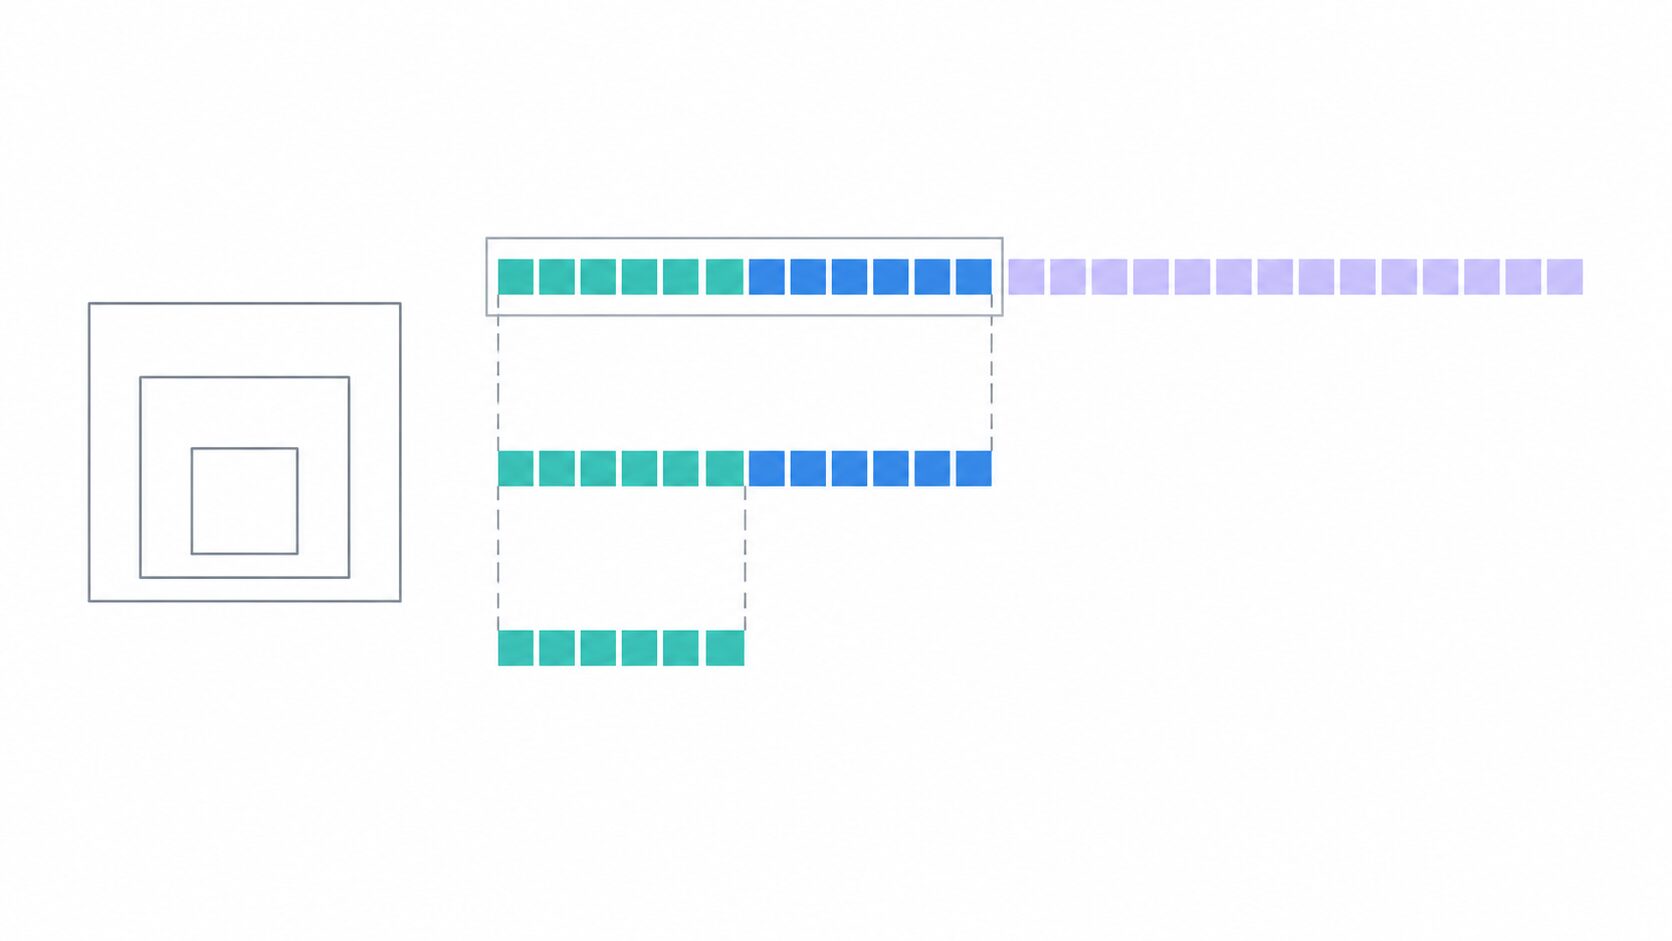
Matryoshka Embeddingsと埋め込みの次元数
埋め込みは、文章や画像の意味・特徴を数値の並びで表したものです。文章検索なら、質問と文書をそれぞれベクトルに変換し、近い表現を持つ文書を探します。たとえば「出張の交通費を申請したい」という質問に対し、同じ単語が完全には一致しなくても、旅費精算の手順を説明した文書を見つけるために使われます。
この数値の個数が「次元数」です。1024次元なら、一つの文章を1024個の数値で表します。同じ数値形式で保存するとき、成分が多いほど1件当たりの容量が増えます。また、二つのベクトルの類似度を計算する際に扱う成分も増えるため、大量の文書を保存・比較する場面では負担になります。
Matryoshka Embeddingsでは、対応する長さの先頭部分を取り出して検索に使えます。たとえば1024次元と256次元での利用を想定したモデルなら、先頭256成分を短い表現として扱います。新たに256個の数値を計算して並べ替えるのではなく、元のベクトルに含まれる先頭部分を利用する仕組みです。
ただし、短くする対象はモデルが出力するベクトルであり、主な削減対象は生成後の保存量や比較処理です。短い次元数を指定しただけで、文章を読み取るモデル自体が小さくなったり、埋め込みの生成時間が同じ割合で短くなったりするとは限りません。処理時間を見積もる際は、生成と検索を分けて考えます。
先頭の次元だけでも使える学習の仕組み
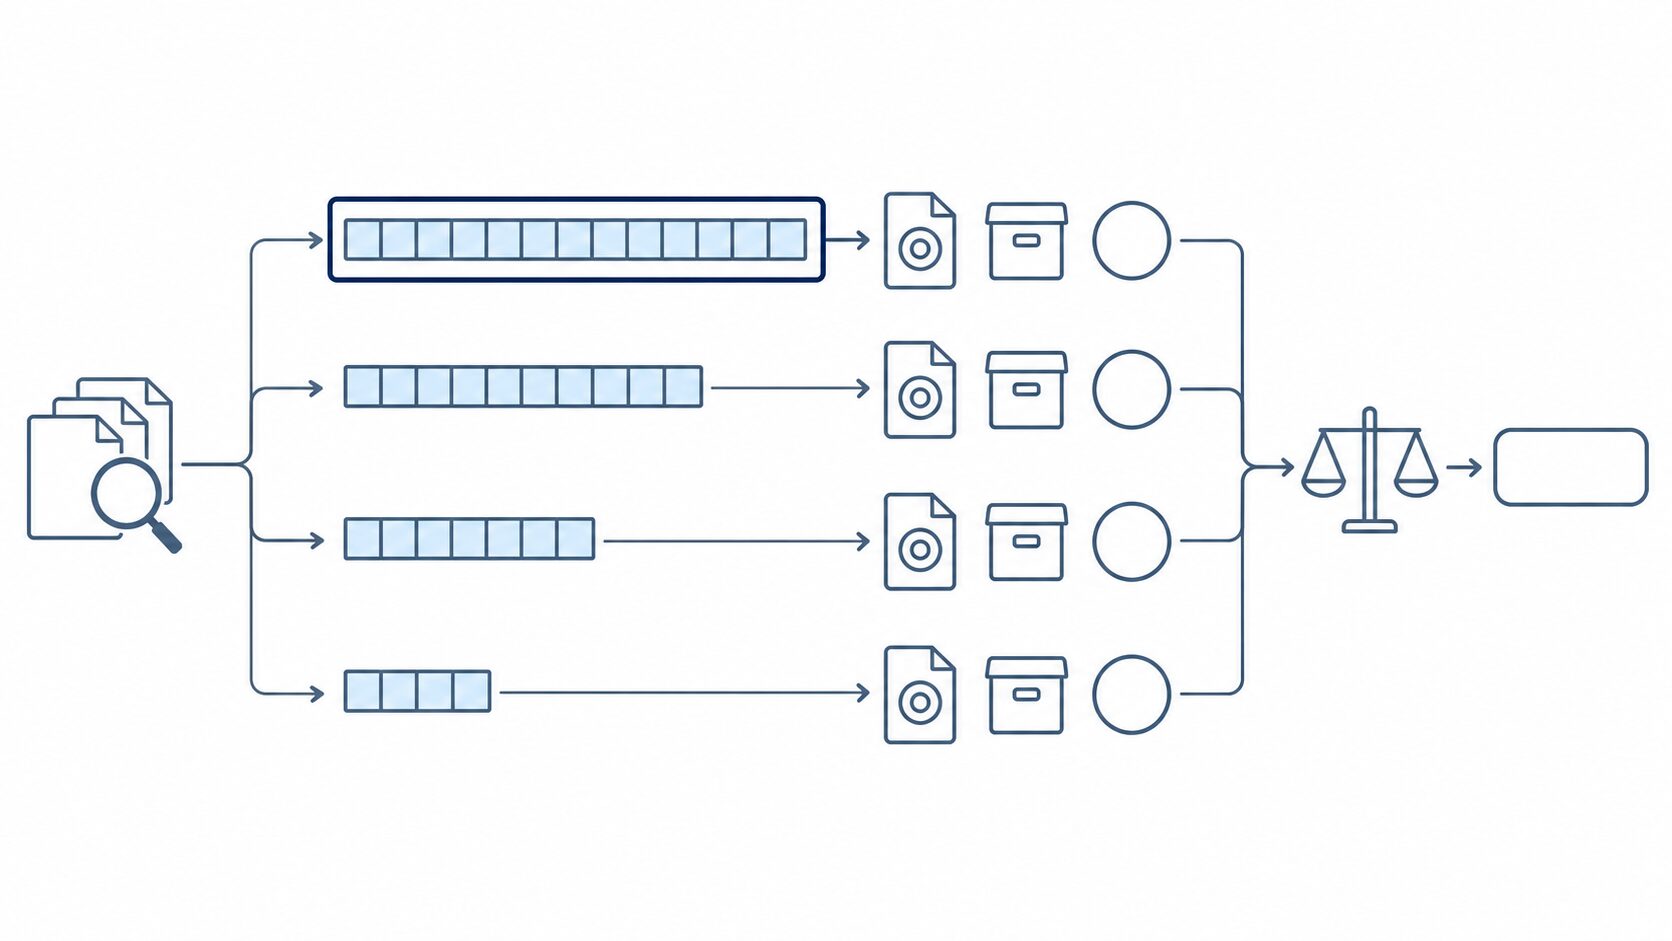
2022年に提案されたMRLでは、全次元の表現だけでなく、複数の長さの先頭部分にも学習の目的を課します。文章同士の関係を適切に表せているかを、長い表現と短い表現の両方で確かめ、その結果をモデルの更新に反映します。短い表現でも必要な情報を残すよう、学習時から働きかけるわけです。
Sentence Transformersのガイドには、768・512・256・128・64次元のそれぞれに同じ基礎損失を適用する例があります。損失とは、モデルの出力が目指す関係からどれだけ外れているかを数値で表すものです。全768次元ではうまく表せても、先頭64次元では表せない場合、その短い表現も改善の対象にします。
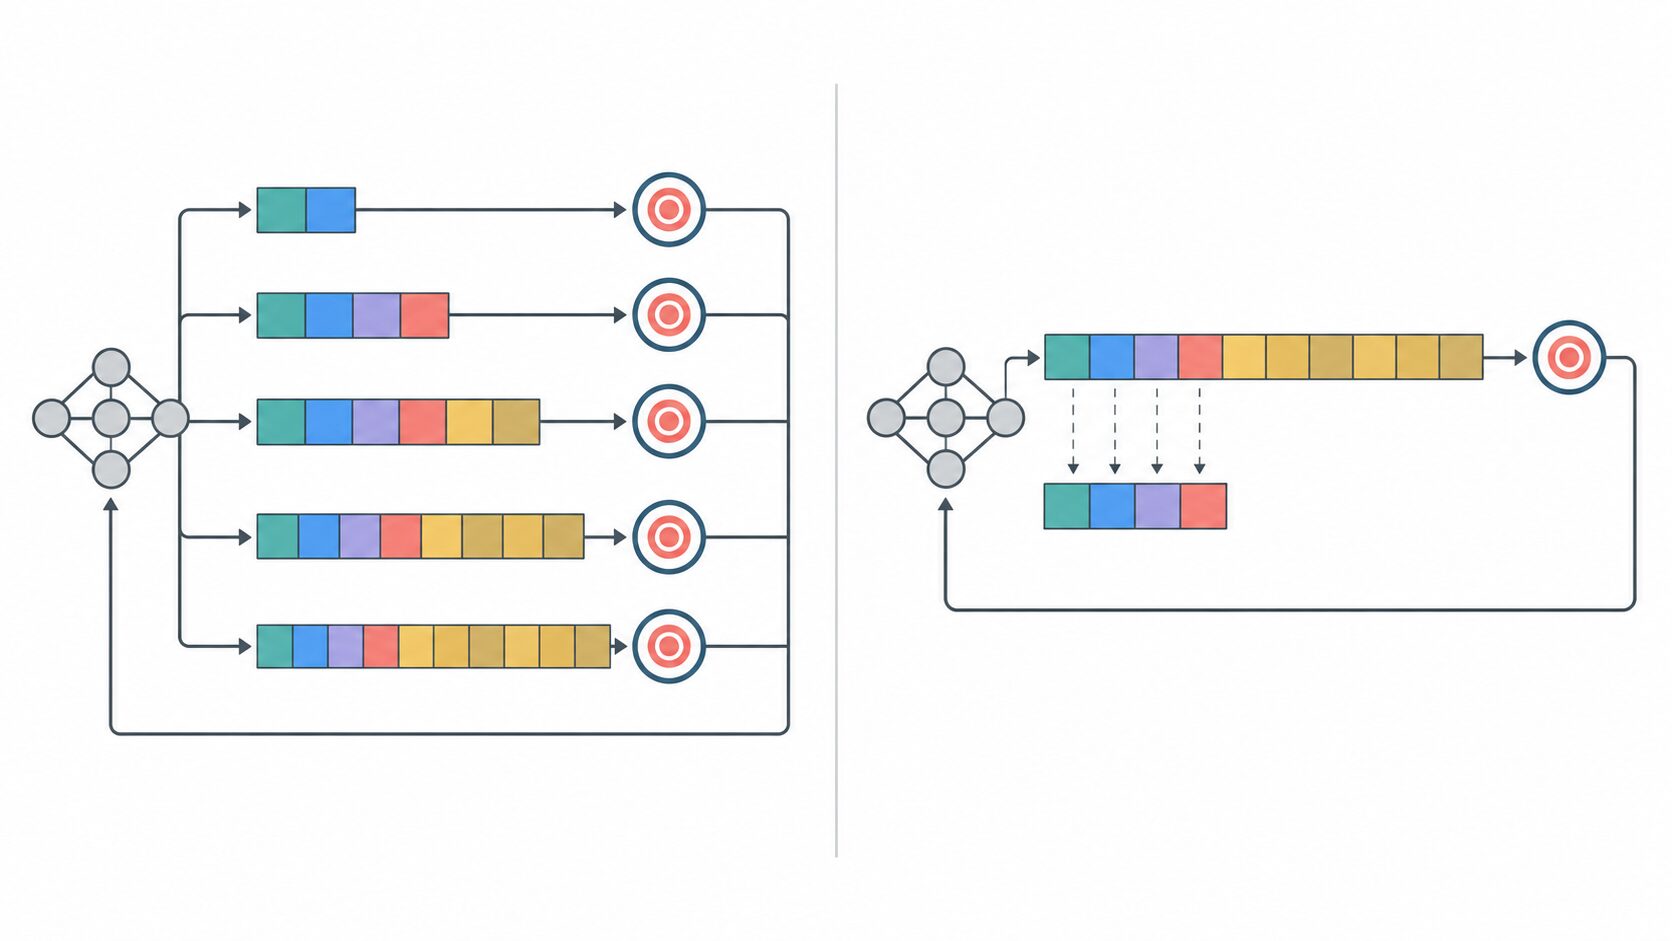
図の各長さは、別々のモデルを用意することではなく、一つの出力を異なる長さで評価することを表します。短い表現がよいかどうかも学習に含める点が、完成した通常のベクトルを後から切るだけの場合との違いです。
なお、先頭の成分が「話題」、次が「感情」という固定した項目になっているわけではありません。意味は複数の成分の組み合わせで表されます。単に長いベクトルを出せるモデルであることと、先頭部分だけで使えるよう学習されていることは別です。対応していても、極端に短くすれば細かな違いを捉えにくくなる可能性があります。利用できる長さと、その長さでの品質を確認する必要があります。
1024次元と256次元で保存量はどう変わるか
1024次元と256次元の両方で利用できるモデルを仮定します。数値形式が同じなら、256次元の生ベクトル容量は1024次元の4分の1です。float32は1成分に4バイトを使うため、計算は「件数×次元数×4バイト」になります。
| 比較項目 | 1024次元 | 256次元 |
|---|---|---|
| 1件当たりの成分数 | 1024個 | 256個 |
| float32での1件の容量 | 4096バイト | 1024バイト |
| 100万件の生ベクトル容量 | 約4.096GB | 約1.024GB |
| 容量の比率 | 4 | 1 |
ここでは1GB=10億バイトの十進表記を使っています。100万件は文書のファイル数ではなく、保存するベクトルの件数です。文書を複数の短い文章に分割し、それぞれに埋め込みを付ける場合は、分割後の件数で計算します。
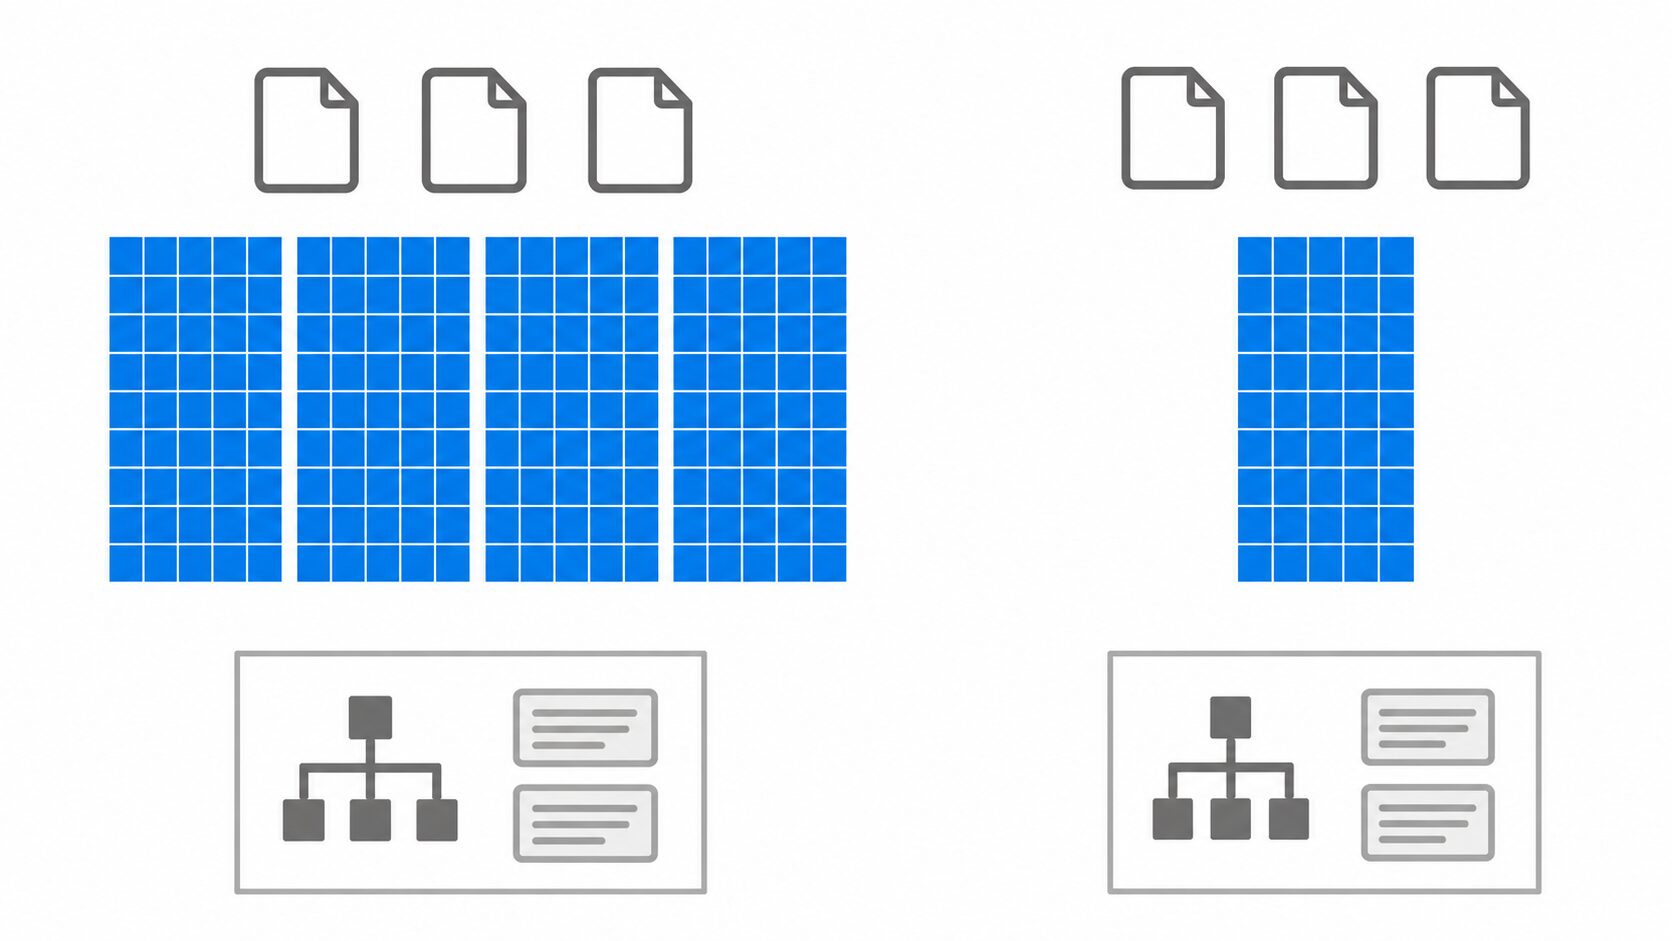
この比較に、検索を速くする索引、文書IDなどのメタデータ、原文、バックアップは含まれません。保存時の圧縮形式によっても実際のサイズは変わります。4分の1になるのは、この条件でのベクトル成分の保存量です。データベース全体やサービスの費用が、そのまま4分の1になるという意味ではありません。
同様に、検索速度が必ず4倍になるわけでもありません。検索時間には索引の探索、データの読み出し、通信なども含まれるからです。短縮で減る計算や転送量の効果と、情報を減らすことによる検索品質への影響を、実際の構成で確かめます。
ベクトル検索とRAGでの使いどころ
主な使いどころは、多数の文書を扱う意味検索や、RAGの検索段階です。RAGは、検索で取得した資料を生成AIに渡し、その内容を踏まえて回答させる仕組みです。埋め込みを短くすることで検索基盤の容量を抑えられれば、扱える文書数を増やしたり、限られたメモリ内にデータを収めたりする選択肢が広がります。
たとえば、同じ対応モデルを使いながら、社内FAQでは256次元、専門用語の細かな違いを探す検索では1024次元を候補として評価できます。ただし、FAQなら256次元で十分、専門文書なら1024次元が必要と決まっているわけではありません。質問の曖昧さ、文書の似通い方、必要な検索品質によって判断します。用途ごとにモデルを替えず、表現の長さを調整できる点が利点です。
もう一つの使い方が、短いベクトルで候補を絞り、長いベクトルで候補内の順位を付け直す二段階検索です。たとえば最初に256次元で候補文書を集め、候補だけを1024次元で質問と比較し直して、最終的に渡す文書を選びます。全件を長いベクトルで比較する負担を抑えつつ、後段でより多くの情報を使う考え方です。
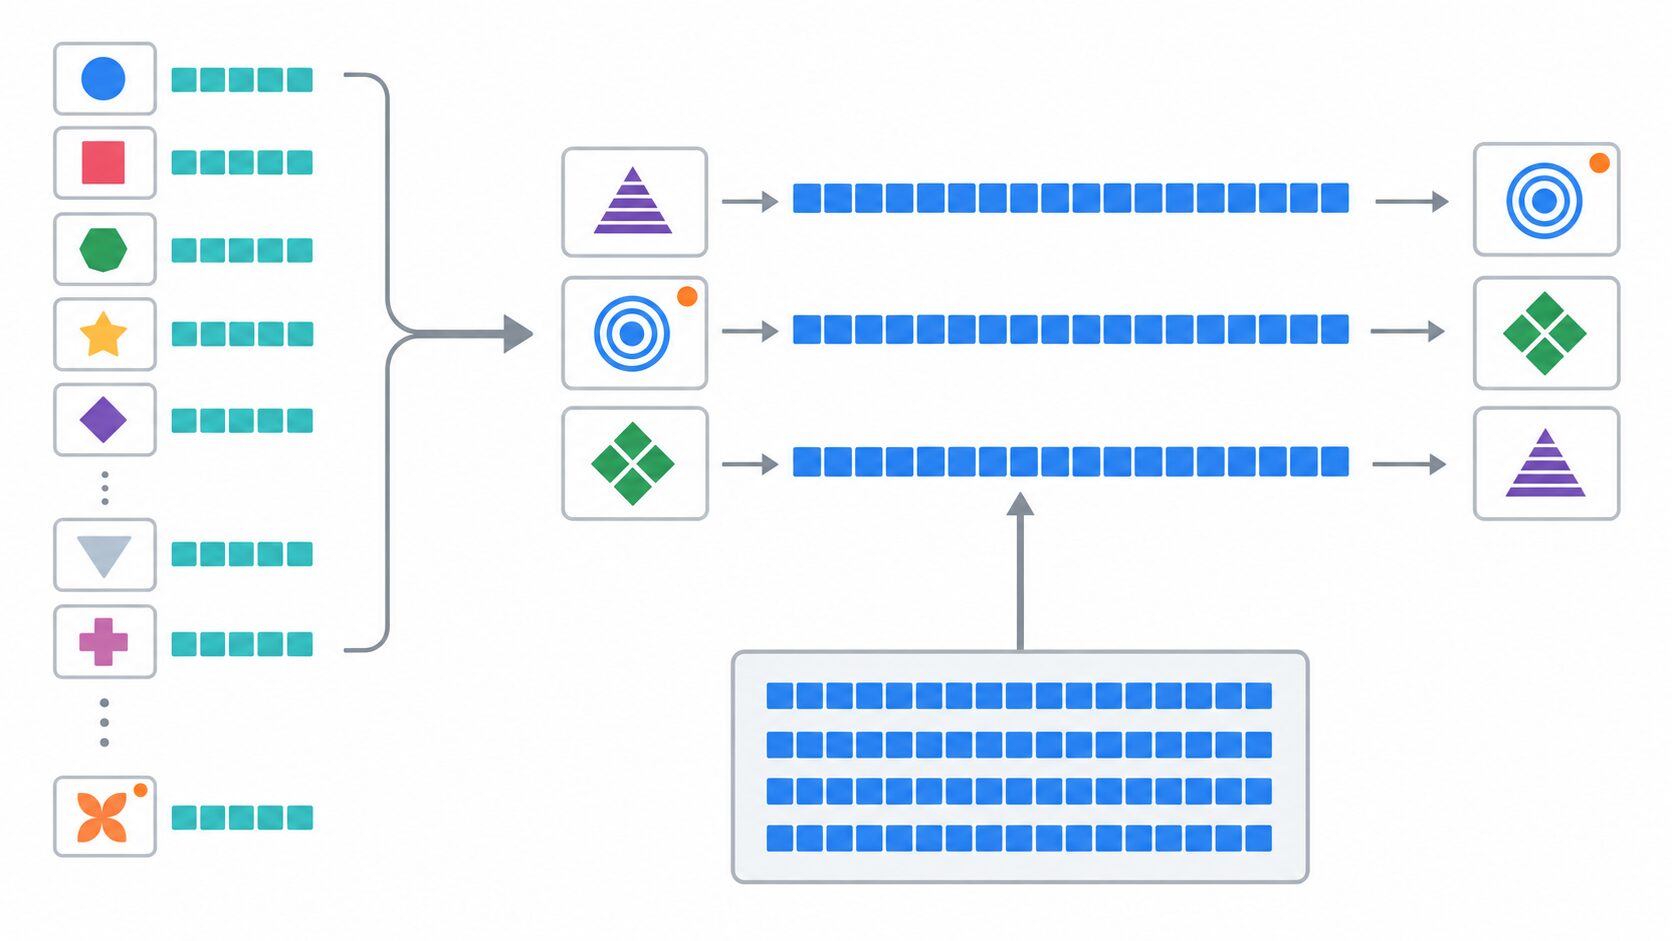
この構成では、後段で使う長い文書ベクトルをどこから取得するかも決めます。長いベクトルを保存し、短いベクトル用の索引も持つなら、両方の容量を計上しなければなりません。短いベクトルだけを保存する構成と同じ削減率にはなりません。長い表現の読み出しにかかる時間も、二段階検索全体の時間に含めます。
最初の候補抽出で漏れた正解文書は、後段で順位を付け直しても戻りません。候補件数を少なくしすぎると、この段階で検索品質の上限が決まってしまいます。また、ここでの再順位付けは同じ埋め込みの長い表現を使う方法です。質問と文書の関連度を別のモデルで判定するリランカーとは、評価に使う仕組みが異なります。
RAGで採用する場合は、検索結果の順位に加えて、回答に必要な根拠が取得できたかも確認します。保存量だけを見て短縮すると、生成AIに十分な資料が渡らず、回答の品質に影響することがあります。
通常の切り詰め・PCA・直積量子化との違い
埋め込みを軽くする方法には、次元を切るもの、別の低次元表現へ変換するもの、数値の保存方法を変えるものがあります。いずれも容量削減に使えますが、必要な準備と失われる情報の性質が異なります。
| 方法 | 何を変えるか | 事前に必要な処理 | 利用時の注意 |
|---|---|---|---|
| MRLによる埋め込みの短縮 | 対応する表現の先頭部分だけを使う | 複数の長さを考慮した学習。利用者は対応済みモデルを選ぶこともできる | 推奨次元数を確認し、短縮後の品質を評価する |
| 通常のベクトルの切り詰め | 先頭部分を残し、残りの成分を捨てる | 切り詰めるだけなら追加学習は不要 | 短い表現の有用性を学習で支えておらず、品質を保てるとは限らない |
| PCA(主成分分析) | 学習した射影で別の低次元表現へ変換する | 代表的なデータから変換に使う軸を求める | 文書と質問に同じ変換を適用し、検索に必要な情報が残るか評価する |
| 直積量子化(PQ) | 部分ベクトルを代表値に対応する短いコードで表す | 代表値の集合であるコードブックを学習する | 代表値への置き換えで誤差が生じる。検索方式に合う設定が必要 |
MRLと通常の切り詰めは、利用時に行う「先頭の成分を残す」という操作だけを見ると似ています。違いは、その長さでも役に立つように元のモデルが学習されているかです。既存のベクトルに切り詰め処理を加えただけでは、MRLで学習した表現にはなりません。
PCAは、元の成分の組み合わせから新しい軸を作り、そこへデータを写す次元削減です。元のベクトルの先頭をそのまま使う方法ではありません。また、データのばらつきをよく残す軸が、検索で必要な意味の違いも必ず残すとは限らないため、変換後の検索結果を確かめます。
PQでは、ベクトルを複数の部分に分け、それぞれを近い代表値の番号などで表します。たとえば長い数値列をそのまま保存する代わりに、どの代表値を使うかという短い情報を保存します。MRLは使う成分数を減らし、PQは成分を表現する方法を変えるという違いです。短縮したベクトルをさらに量子化する構成も考えられますが、併用時は両方による品質変化を含めて評価します。
対応モデル・正規化・検索精度を確認する手順
導入時は、対応モデルであることを確かめ、全次元での検索結果を基準にして候補の次元数を比較します。次の順序で進めると、設定の不一致と短縮そのものの影響を分けて確認できます。
-
MRLへの対応と、推奨・評価済みの次元数を確認する。モデルの説明で、Matryoshka形式の利用を想定しているかを調べます。Sentence Transformersでは、モデルの設定や
encodeのtruncate_dimで次元数を指定できます。ただし、指定できること自体は、そのモデルの対応や品質を保証しません。出力の形状も確かめ、たとえば10件を256次元で処理したら、10行×256成分になっているかを確認します。 -
文書側と質問側の設定をそろえる。同じモデルと同じ次元数を使い、モデルが指定する前処理をそれぞれに適用します。質問用・文書用に別の指示文を求めるモデルでは、その区別も守ります。検索基盤の索引が1024次元で作られているなら、256次元への変更に合わせた索引が必要です。元の対応済みベクトルが残っていれば先頭部分を使える場合がありますが、モデル自体を変更する場合などは埋め込みの作り直しも検討します。
-
短縮後の正規化と、検索側の類似度の前提を確認する。正規化とは、ベクトルの方向を保ったまま長さを一定にそろえる処理です。全次元で長さを1にしてあっても、後ろの成分を捨てると通常は長さが変わります。正規化済みベクトルの内積をコサイン類似度として使う構成なら、短縮後にも長さをそろえる必要があります。一方、検索側でコサイン類似度を計算するなど、扱いは構成によって異なります。
normalize_embeddingsの既定値はFalseなので、自動的に正規化されると考えず、モデルと検索基盤の仕様に合わせて設定します。 -
全次元と複数の短い次元数を、同じ条件で評価する。実際に使われる質問と、その正解となる文書を用意します。文書集合、検索方式、返す件数などをそろえて、検索品質、保存容量、処理時間を比較します。短縮後の検索結果が全次元と似ているかだけでなく、利用者が必要とする文書を取得できているかで判断します。
検索品質の指標には、Recall@kやMRRがあります。Recall@kは、正解とした文書のうち上位k件に取得できた割合です。MRRは、最初の正解文書の順位の逆数を質問ごとに求め、その平均を取ります。必要な資料を広く拾いたい場合は再現率、最初の数件で答えにたどり着いてほしい場合は順位にも注目すると、指標と用途を結び付けやすくなります。
二段階検索では、最終結果だけでなく、最初の候補集合に正解が入る割合も調べます。候補件数を増やすと拾える文書が増える一方、後段の比較や読み出しも増えます。次元数と候補件数を一緒に調整し、容量と応答時間の両方が要件内に収まるかを確かめます。
資料にある「少ない次元で性能を維持した」という実験値は、特定のモデル・学習データ・評価課題での結果です。文章の類似度と正解スコアの相関を測った成績を、そのまま文書検索の正解率として読み替えることはできません。日本語の社内文書や専門領域など、利用条件が違えば影響も変わります。
判断の基準は、最も短いベクトルを作れるかではなく、必要な検索品質を満たしながら負担をどこまで減らせるかです。全次元での結果を起点に、品質の低下が許容範囲に収まり、容量や時間の改善が得られる次元数を選びます。
仕組みの出典はMRLの原論文です。学習と短縮の例はSentence Transformersの公式ガイド、設定項目は公式APIリファレンスに掲載されています。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |