
GRPOとは?複数の回答を比較してLLMを学習させる仕組み

AIの初心者
GRPOは、AIに何度も回答させて、一番よい答えを選ぶ仕組みですか?

AI専門家
複数の回答を比べる点は近いですが、目的はモデルの学習です。同じ質問への回答を採点し、点数が相対的に高い回答を出しやすくする方向にモデルを更新します。
AIの初心者
回答を比べれば、どれが正しいかも自動で分かるのでしょうか?
AI専門家
正しさを判断する採点基準は別に必要です。まず、何を点数にするのかと、その点数をどう学習に使うのかを分けて考えてみましょう。
GRPOとは。
GRPO(Group Relative Policy Optimization)は、同じ質問に対して生成した複数の回答の報酬をグループ内で比較し、その相対評価を使ってモデルの生成方策を改善する強化学習手法です。別の価値モデルを使わず、回答グループの報酬を学習の基準にする点が特徴です。
全体の流れは「一つの質問から複数回答を作る」「外部の基準で採点する」「グループ内で比較する」「モデルを更新する」の四つです。比較の対象と採点の役割が分かると、仕組みや使いどころを理解しやすくなります。

GRPOの定義とLLM学習での位置づけ
GRPOは、2024年のDeepSeekMath論文で導入された手法です。大規模言語モデル(LLM)の追加学習で、すでに回答を生成できるモデルの振る舞いを、報酬が高くなる方向へ調整するために使われます。大量の文章を読んで基礎を身につける事前学習に対し、ここでは生成した回答への評価が学習の手掛かりになります。
「方策」は、ある入力や書きかけの回答に対して、次の単語などをどの確率で出すかを決めるモデルの振る舞いです。方策の更新とは、モデルの重みを変えて、その生成確率を調整することを指します。一方、「報酬」は回答に与える点数であり、正解との一致やテスト結果など、用意した基準から決まります。
GRPOが担当するのは、採点結果を使った学習の進め方です。正解を見抜く能力が手法そのものに備わっているわけではありません。採点基準が誤っていれば、望ましくない回答を増やす方向に学習が進むこともあります。
利用時に複数の候補を作り、最もよい回答だけを表示する処理とも区別が必要です。候補を選ぶだけならモデルの重みは変わりません。GRPOでは比較結果を重みの更新に使い、以後の回答生成を改善することを目指します。学習で複数回答を使っていても、利用時に必ず同じ数の候補を作る必要があるわけではありません。
同じ質問への複数回答から方策を更新する仕組み
基本となる比較の単位は、一つの質問に対する回答グループです。難易度が違う別々の質問への回答を集めて、すべて同じ平均点と比較するわけではありません。原論文の回答単位の報酬を使う基本形は、次の手順で理解できます。
- 学習用の質問を用意し、更新前の方策から複数の回答を生成します。生成にばらつきを持たせることで、異なる解き方や答えが候補に含まれます。
- それぞれの回答を、ルールや報酬モデルで採点します。この時点で得られるのが、回答ごとの報酬です。
- 同じ質問の回答グループで報酬の平均と標準偏差を求め、各回答が平均よりどの程度よいかを計算します。
- その相対評価に基づいて、回答の生成確率を調整するようにモデルを更新します。
- 更新した方策から再び回答を生成し、採点と更新を繰り返します。
この相対評価を「アドバンテージ」と呼びます。基本の計算は、アドバンテージ=(回答の報酬−グループの平均報酬)÷グループの報酬の標準偏差です。平均を引くと基準より上か下かが分かり、標準偏差で割ると、その差をグループ内の点数のばらつきに応じた大きさへ調整できます。
アドバンテージが正なら、その回答を生成しやすくする方向、負なら生成しにくくする方向に学習します。ただし、点数をそのまま確率へ置き換えるわけではありません。回答を構成するトークンの生成確率などを使って更新量を計算するため、一回の更新で正解率が必ず上がるという意味でもありません。
急激な変化を抑える仕組みもあります。原論文では、更新前後の生成確率の比を使い、一定の範囲を超えた変化による学習上の利益を制限する「クリッピング」を取り入れています。また、参照方策からのずれを抑えるKL項も使います。更新前の方策は今回の変化を測る基準、参照方策は元の振る舞いから離れすぎないための基準で、役割が異なります。
生成を担うモデルと採点を担う仕組みを分けて捉えることが大切です。モデルは候補を出し、採点器が点数を与え、GRPOがその点数から更新の方向を決めます。

4つの回答で見る報酬の相対化
「3個入りの袋が4袋あると、全部で何個か」という問題に、モデルが4通りの回答を生成したとします。説明を簡単にするため、最終的な答えが12個なら1点、それ以外なら0点を与えます。文章の丁寧さや途中の説明は、この例の採点対象に含めません。
| 回答 | 最終的な答え | 報酬 | 平均との差 | 相対評価 |
|---|---|---|---|---|
| A | 7個 | 0 | −0.5 | −1 |
| B | 16個 | 0 | −0.5 | −1 |
| C | 12個 | 1 | +0.5 | +1 |
| D | 12個 | 1 | +0.5 | +1 |
報酬は0・0・1・1なので、平均は0.5です。説明用に4件全体の母標準偏差0.5を使うと、AとBは(0−0.5)÷0.5で−1、CとDは(1−0.5)÷0.5で+1になります。実装では標準偏差の推定方法や、ゼロ除算を避ける安定化処理によって値が変わる場合があります。
ここでの0点は採点器が与えた評価、−1は同じグループの中での相対評価です。二つは同じ数字ではありません。学習ではCとDの両方が正の信号を持つので、一人の勝者だけを残して他を捨てる仕組みでもありません。

全回答が1点、または全回答が0点なら、平均との差はすべてゼロです。この場合、グループ内の報酬差からは、どの回答を増やすべきかという信号が得られません。ただし、KL項など別の項による更新まで必ずゼロになるとは限りません。
また、部分点を使う課題では、不正解でも他の候補より点数が高ければ正の相対評価になることがあります。高い相対評価は「このグループの採点基準では有利」という意味であり、回答の正しさを保証しません。最終回答だけの採点では、途中の説明が正しいかどうかも別途確かめる必要があります。
PPO・DPOとの違い
三つの手法を比べるときは、「何を評価情報にするか」「価値モデルを使うか」「学習中に回答を生成するか」を見ると整理できます。以下は典型的なLLM向けの構成の比較であり、すべての派生手法に共通する仕様ではありません。
| 比較軸 | PPO | GRPO | 標準的なDPO |
|---|---|---|---|
| 主な評価情報 | 報酬と価値モデルの予測を使ったアドバンテージ | 同じ質問への回答グループ内で相対化した報酬 | 同じ入力に対する好ましい回答と好ましくない回答のペア |
| 価値モデル | 通常は使用する | 別の価値モデルを使わない | 使わない |
| 学習用の回答生成 | 学習中の方策から生成する | 同じ質問に複数回答を生成する | 保存済みの選好ペアを使って学習できる |
PPOでは通常、ある時点からどの程度の報酬が期待できるかを価値モデルで推定します。この予測を基準として、実際の結果がどのくらいよかったかを評価します。GRPOは代わりに回答グループの報酬を基準にするため、別の価値モデルを学習・保持する負担を省けます。
ここでいう価値モデルと報酬モデルは別物です。価値モデルは期待される報酬を予測し、報酬モデルは回答を採点します。GRPOでも報酬モデルを採点に使う構成はあります。また、価値モデルを省略できても、回答を生成する方策モデルが不要になるわけではなく、参照モデルの必要性も学習設定によって決まります。
DPOは、どちらの回答が好ましいかという選好ペアから直接学習します。標準的な構成では、保存済みのペアを使えるため、更新のたびに複数回答を生成・採点する工程は必須ではありません。これに対してGRPOは、学習中に生成した回答の数値報酬を使います。単なる順位だけでなく、点数差も相対評価に関係します。
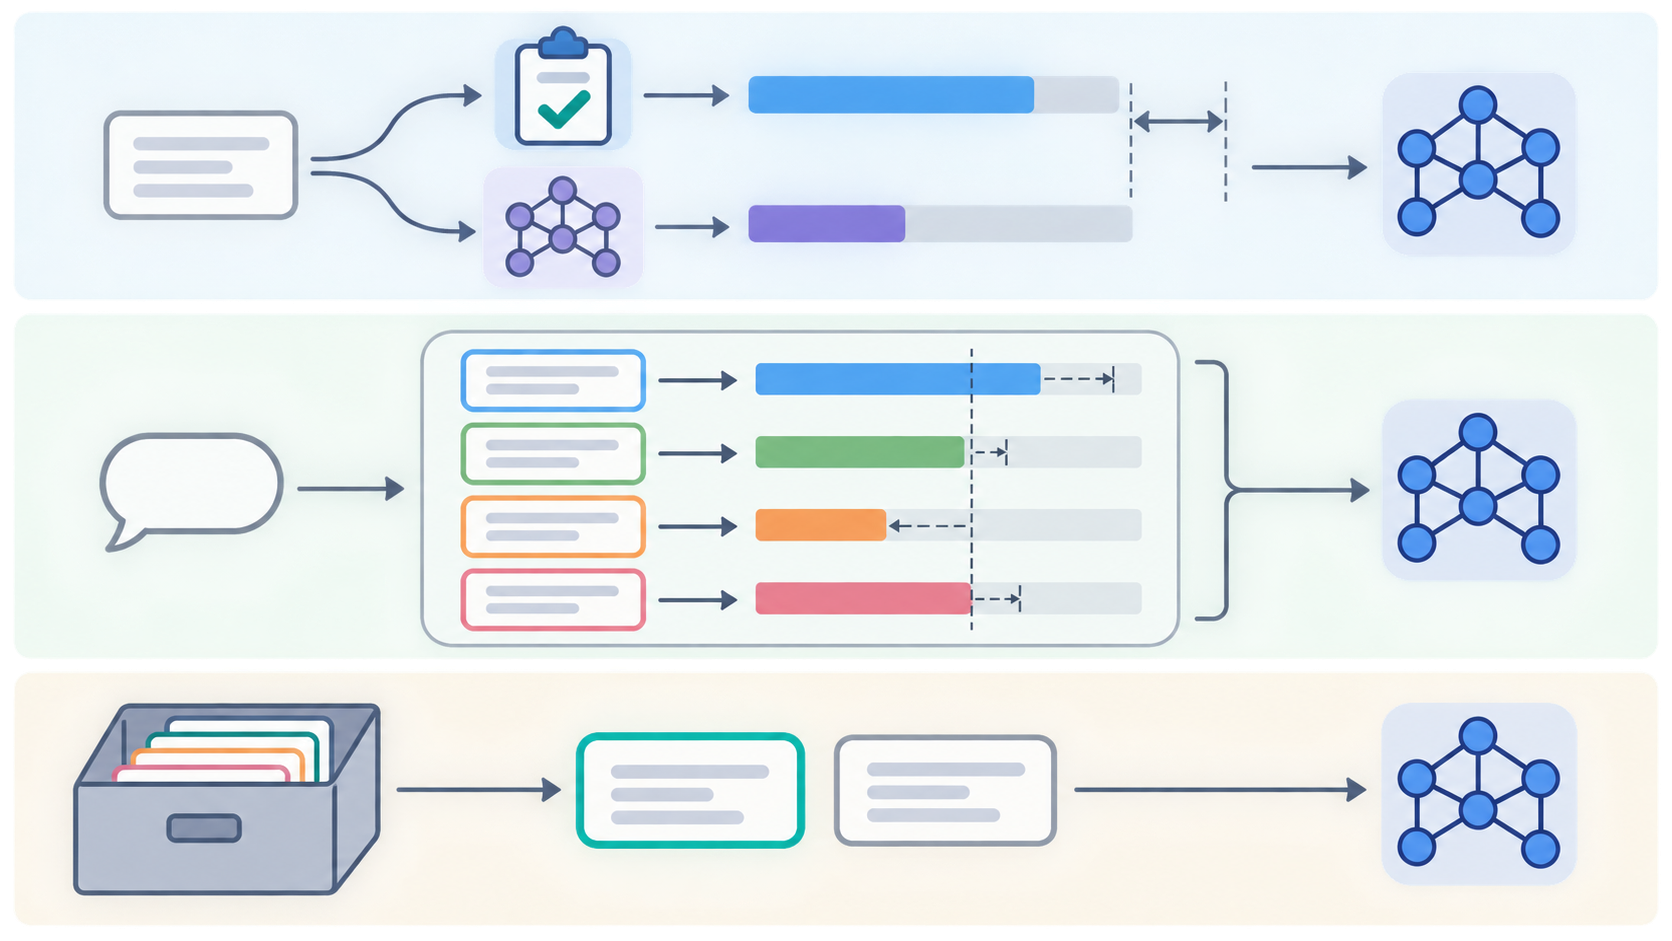
選好データが十分にあるならDPO、生成した回答を継続的に採点できるならGRPOを検討する、という見方ができます。ただし、どの手法が優れるかは、データ、採点の質、計算資源によって変わります。価値モデルの有無だけで品質や総費用の優劣は決まりません。
GRPOが向く課題と報酬の作り方
取り組みやすいのは、回答の良し悪しを一定の基準で確かめられる課題です。数学なら正解との一致、コード生成ならテストの通過数などを報酬にできます。同じ問題に対する複数の候補を採点できることが、回答グループを使った学習の土台になります。
ルール採点では、数値の一致判定やプログラムの実行結果などから点数を決めます。数学では「0.5」と「1/2」を同じ答えと認めるか、コードではどの入力をテストするかなど、採点条件を明確にします。判定しやすい課題でも、評価ルールの作り方次第で学習の目標は変わります。
出力形式への報酬を補助的に加える方法もあります。たとえば、必要な項目を含むJSONなら加点できます。ただし、形式が正しくても中身が誤っていれば、利用者の目的は達成できません。内容の正しさを評価する報酬と、形式を整える報酬は分けて設計し、どちらの点数が伸びているか確認します。
要約や自由記述のように正解が一つでない課題では、学習済みの報酬モデルで有用性や読みやすさを採点する方法があります。その場合は、採点器が長い文章や特定の言い回しを好むなどの偏りに注意が必要です。人の評価と照合し、同程度の回答を安定して採点できるかを先に確かめます。
導入には、目的に合った良質な問題、妥当性を検証できる報酬、複数回答を生成する計算予算が必要です。モデルがほぼ解けない問題ばかりでは候補が全滅し、簡単すぎる問題ばかりでは全正解になり、比較の手掛かりが減ります。推論能力の改善を目指す場合も、GRPOを採用するだけで効果が保証されるわけではありません。
報酬ハッキング・偏り・計算費用の注意点
最も注意したいのは、報酬の上昇と実際の品質向上がずれることです。採点の抜け道を利用して高得点を得る振る舞いを、報酬ハッキングと呼びます。これはモデルが意図を持って不正をするという意味ではなく、用意した点数を高める学習の結果、目的から外れた回答が増える問題です。
たとえば、所定の見出しがあるだけで加点すると、内容が薄くても形式を整える回答が有利になります。コードも、限られたテストだけを通る処理を覚えれば、想定外の入力では失敗するかもしれません。採点器に好まれる丁寧な文体で、根拠のない説明を長く書く回答が高く評価される場合もあります。
対策は、学習に使っていない問題や追加テストで性能を測り、人の確認も組み合わせることです。コードなら境界値や異常な入力を試し、数学なら答えだけでなく説明の妥当性も確認します。学習中の報酬とは別に、利用者が求める品質を測る評価を用意する必要があります。

回答の長さや報酬の正規化にも注意が必要です。長い回答をどのような重みで学習するかは損失の計算方法に左右されます。また、報酬の差を標準偏差で割る処理は、ばらつきに応じて信号の大きさを変えます。採点の小さな揺れまで相対化されることがあるため、正規化をすれば偏りがなくなるとはいえません。
全正解・全不正解のグループが多い場合は、平均報酬だけでなく、同点の割合も確認すると原因を探れます。問題の難易度、候補の多様性、採点の粗さのどこに問題があるかで、見直す対象は異なります。差を作ることだけを目的に、意味のない報酬を加えないことも大切です。
計算費用では、価値モデルを省いた分のメモリ節約と、複数回答を作る費用を分けて考えます。たとえば、32問に各8回答なら、32グループで合計256回答です。回答数を増やせば生成と採点の量が増え、長い回答では負担も大きくなります。候補を増やして有益な違いが得られるかを確かめ、回答数の増加が常に得になるとは考えないようにします。
原論文と実装を区別して読むポイント
手法の出発点を確認する資料は、DeepSeekMath論文のv3にあるSection 4.1です。本記事の数値例は、回答単位の報酬を使い、グループ平均との差を標準偏差で割る基本形を説明しています。この計算や学習設定が、GRPOと呼ばれるすべての実装・派生で同一とは限りません。
実装を読む際は、Hugging Face TRLのGRPOTrainer文書などで、使う版の設定を確認します。2026年10月4日を確認日とする制作資料では、TRLのmain版に、標準偏差によるスケーリングの無効化、バッチ単位のスケーリング、長さの正規化、損失形式、KL係数などの設定や派生があることが整理されています。
バッチ単位のスケーリングは、複数の質問を含む学習データのまとまりで報酬のばらつきを扱う設定です。基本形の「同じ質問の中で比較する」という説明と、更新に使う値をどの範囲で調整するかという設定は、分けて読む必要があります。KL項についても、原論文で使われていることだけを根拠に、利用する実装で必ず有効だとは判断できません。
再現や導入の際には、文書が更新されるmain版か固定された版かを確認し、ライブラリのバージョンとともに、報酬関数、質問ごとの回答数、報酬の正規化、損失形式、KLの設定を記録します。論文の式、文書に載る選択肢、自分の環境の既定値を同じものとして扱わないことが重要です。
GRPOを使う判断では、別の価値モデルを省ける点だけでなく、「回答を適切に採点できるか」「候補の間に学習に役立つ違いが出るか」「独立した評価でも改善が見えるか」を確かめます。回答グループ内の比較を学習に生かせる条件がそろっているかが、用途を見極める中心になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |