
ColBERTとは?トークンごとの対応で検索するLate Interactionの仕組み

AIの初心者
ベクトル検索は、文章を一つのベクトルにして似ているか調べる仕組みですよね。ColBERTは何が違うのですか?

AI専門家
ColBERTは文章全体を一つにまとめず、トークンごとのベクトルを残します。質問の各部分に対して、文書のどの部分がよく対応するかを調べる検索モデルです。
AIの初心者
細かく比べるほど、検索に時間がかかりそうです。たくさんの文書を探すときにも使えるのでしょうか?
AI専門家
文書のベクトルは先に計算しておけます。細かな照合を残しながら、検索時の処理を減らす設計なのです。ただし、保存量やベクトルを比較する負担は確認する必要があります。
ColBERTとは。
ColBERTは、質問と文書をそれぞれ文脈を反映したトークン埋め込みの集合に変換し、トークン間の類似度から関連度を求める検索モデルです。別々に符号化した後で照合する仕組みをLate Interactionと呼び、基本となるスコア計算にMaxSimを使います。文書を複数のベクトルで表すため、単一ベクトル検索とは照合の粒度が異なります。
検索方式を理解する鍵は、「文章をどの単位で表すか」と「質問と文書をいつ照合するか」です。まず表現の粒度を比べ、その後でMaxSimの計算例を見ると、ColBERTが何を得意とし、どこにコストをかけるのかが分かります。
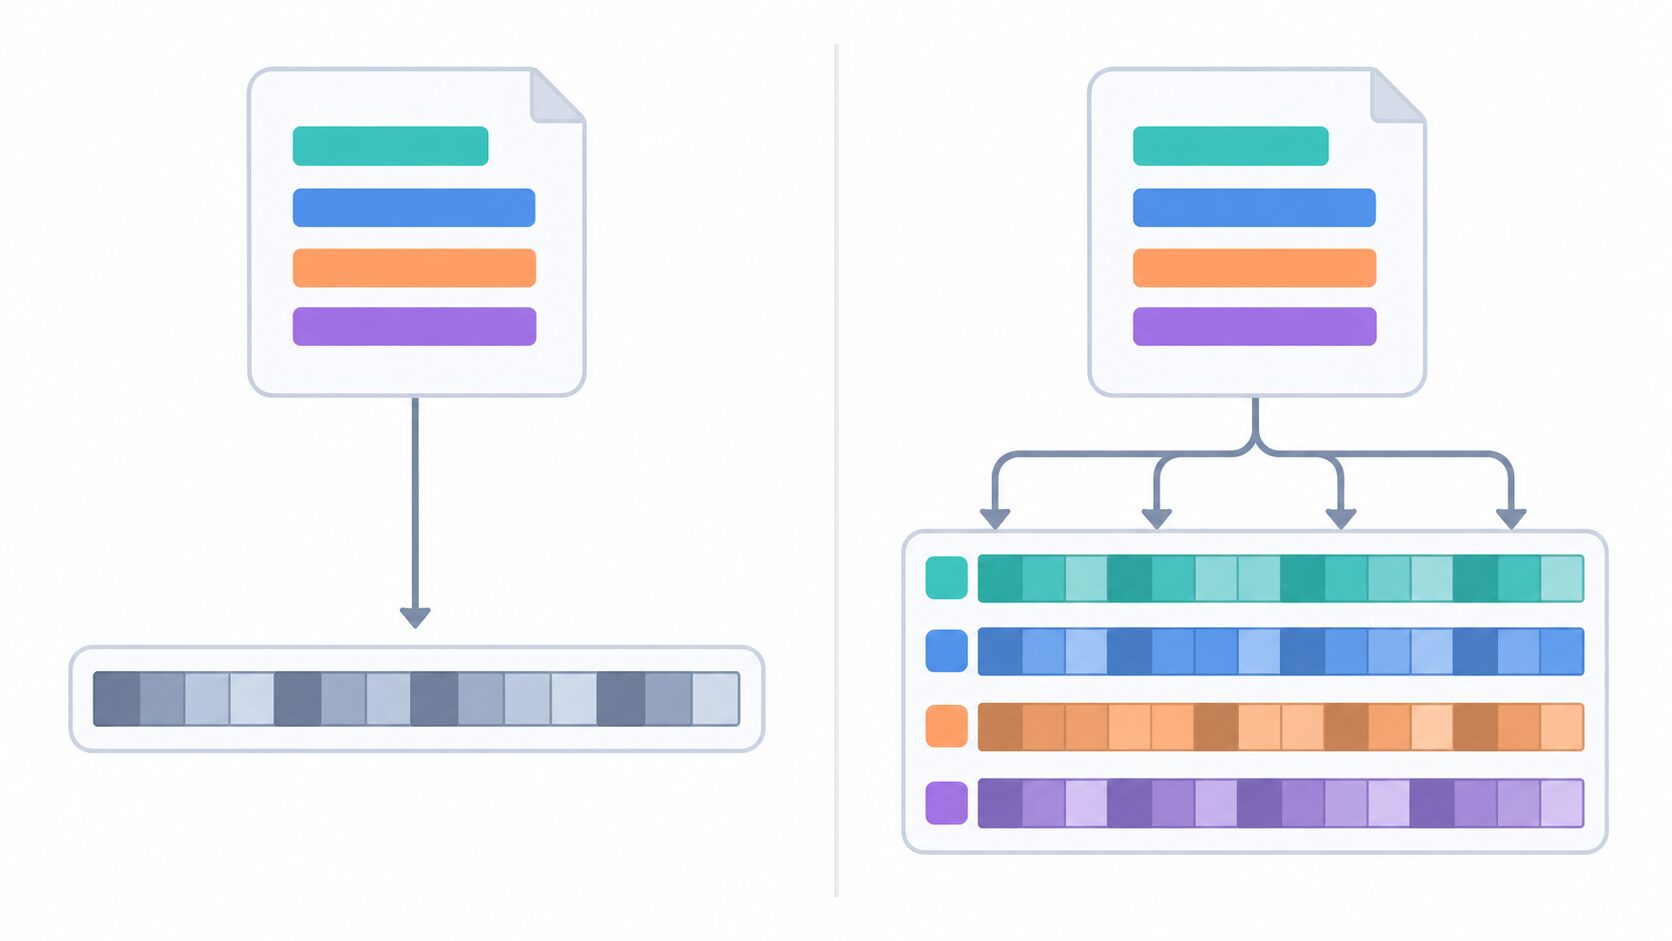
ColBERTが文書を複数のベクトルで表す理由
ColBERTは2020年に提案された検索モデルです。中心にある考え方は、文書の各部分に対応する表現を残し、質問の細かな手掛かりとの照合に使うことです。ベクトルは意味の特徴を数値の並びで表したもので、ColBERTでは一つの文書に対して複数のベクトルを持ちます。
典型的な単一ベクトル方式では、質問と文書をそれぞれ一つのベクトルに集約し、その二つを比較します。文書全体の特徴をコンパクトに扱え、検索しやすいのが利点です。一方、一つの表現へ圧縮する過程で、細かな条件の手掛かりが十分に残らない場合があります。単一ベクトルでは必ず条件を見落とすという意味ではなく、どの粒度の情報を比較に使えるかが違います。
例えば「軽いパソコン」を探す場面では、「軽い」という性質と「パソコン」という機器の種類の両方が手掛かりになります。「持ち運べる小型PC」の説明にはそれぞれに対応する表現がありそうです。ColBERTは、質問を構成する部分ごとに文書との対応を調べ、文書全体の関連度へまとめます。全体の話題が近いだけでなく、質問の各部分を支える記述を照合に使える設計です。
この「複数ベクトル」は、複数の文書をまとめることでも、複数のAIモデルを組み合わせることでもありません。一つの文章を、トークンごとのベクトルの列として表すという意味です。ただし、それぞれのベクトルは孤立した語の意味だけを持つわけではなく、周囲の文脈を反映しています。
Late Interactionは符号化した後に照合する
トークンとは、モデルが文章を処理するときの文字列の単位です。単語と一致する場合もありますが、一つの単語が複数のトークンに分かれる場合もあります。日本語を必ず単語単位で区切るわけでもありません。どのように分割するかは、モデルが使うTokenizerに左右されます。
ColBERTでは、質問と文書をそれぞれBERTで符号化し、トークンのベクトル列に変換します。符号化とは、文章をモデルで処理して数値表現を得ることです。このとき各トークンは同じ文章内の周囲の情報を取り込むため、単純に文字列の一致数を数える検索とは異なります。「軽い」が重量を指すのか負担を指すのかといった文脈も、表現を作る際の手掛かりになります。
処理は、文書を準備する段階と、質問を受け取る段階に分けられます。
- 検索対象の文書を符号化し、トークンごとのベクトルを索引に保存する。
- ユーザーの質問を受け取ったら、質問側のトークンベクトルを計算する。
- 質問側と文書側のベクトルを照合し、関連度に基づいて検索結果を並べる。

Lateは「質問と文書の照合を符号化後まで遅らせる」という処理順を指します。検索結果の表示が遅いという意味ではありません。質問の内部、文書の内部では文脈を反映させつつ、両者の間の相互照合は後段で行います。
文書側の表現が質問に依存しないため、新しい質問のたびに全対象文書をBERTへ通す必要がありません。ただし、検索時の仕事がなくなるわけではなく、質問の符号化、索引からの候補探索、必要なベクトル比較は残ります。事前計算で省ける処理と、質問ごとに必要な処理を分けて考えることが大切です。
MaxSimを小さな類似度表で理解する
MaxSimは、質問側の各トークンについて、文書側で最も似たトークンとの類似度を選び、それらを合計する計算です。質問をq、文書をdとすると、基本形は次のように表せます。
score(q,d) = Σ_i max_j sim(q_i,d_j)
q_iは質問のi番目、d_jは文書のj番目のトークンベクトルで、simは二つのベクトルの類似度です。maxは最大値を選ぶ操作、Σは選んだ値を足す操作を表します。数式では、文書側から最大値を取る操作を、質問側の各トークンに対して繰り返しています。
「軽い/パソコン」という質問と、「持ち運べる/小型/PC」という文書を考えましょう。次の表は質問側を行、文書側を列にした2行3列の類似度表です。語の区切りは説明用で、実際のTokenizerの出力ではありません。数値も仕組みを示す架空の値です。
| 質問側\文書側 | 持ち運べる | 小型 | PC |
|---|---|---|---|
| 軽い | 0.9 | 0.7 | 0.2 |
| パソコン | 0.1 | 0.3 | 0.8 |
まず「軽い」の行で最大の0.9を選びます。次に「パソコン」の行で最大の0.8を選びます。最後に二つを足すと、この例の関連度スコアは0.9+0.8=1.7です。質問側の各行から一つずつ値を取り出すのであり、表にある六つの数値すべてを足すのではありません。

また、これは質問と文書のトークンを一対一に割り当てる操作ではありません。別の質問トークンにとっても同じ文書トークンが最も似ていれば、その列を再び選べます。文書側のすべてのトークンを一回ずつ使う必要もありません。
1.7というスコアは「正解である確率」を表していません。同じ質問に対する候補文書の順位を決めるための値であり、合計する質問トークン数などの影響も受けます。さらに、個々の対応が強いことと、条件全体を満たすことは同じではありません。「軽くないパソコン」の否定や、仕様の条件関係を正しく評価できるかは、MaxSimの計算規則だけでは保証されません。
単一ベクトル方式・cross-encoderとの違い
三つの方式を比べるときは、表現の粒度に加え、質問と文書が相互作用する段階を見ると整理できます。ここでいう単一ベクトル方式は、質問と文書を別々に符号化する典型的なbi-encoderを指します。
| 比較軸 | 単一ベクトル方式 | ColBERT | cross-encoder |
|---|---|---|---|
| 表現の粒度 | 質問・文書ごとに一つのベクトル | 質問・文書のトークンごとに複数のベクトル | 質問と文書を組にして処理した表現 |
| 照合の段階 | 別々の符号化後に、集約した表現を比較 | 別々の符号化後に、トークン単位で比較 | 一緒に入力し、符号化の過程で相互作用を計算 |
| 文書の事前計算 | 検索用ベクトルを保存できる | トークンベクトルを保存できる | 通常、照合用の表現を文書単独では完成できない |
| 計算・保存負担 | 一文書当たりの保存・比較をコンパクトにしやすい | 複数ベクトルの保存と比較に負担が生じる | 候補ごとに質問との組をモデルで処理する負担がある |
| 主な利用位置 | 広い文書集合からの候補取得 | 直接検索、候補の再ランキング | 絞り込んだ候補の再ランキング |

bi-encoderという呼び方は、質問と文書を別々に符号化する構成に注目したものです。ColBERTもその構成を持つため、bi-encoderとColBERTは排他的な分類ではありません。「bi-encoderは必ず一つのベクトルしか使わない」と捉えるより、単一ベクトルか複数ベクトルかを併せて確認すると正確です。
cross-encoderでは、通常、質問と文書を一緒にモデルへ入力します。質問に応じて文書の読み取り方を変える細かな相互作用を計算できる一方、質問が変われば候補との組を改めて処理します。この性質から、先に集めた候補の関連度を詳しく評価する場面でよく使われます。
ColBERTの特徴は、文書の事前計算を可能にしながら、後段にトークン単位の照合を残す点です。ただし、「必ずcross-encoderより速い」「必ず単一ベクトル方式より高精度」とは言えません。モデル、索引、データ、候補数、実行機器によって結果は変わります。
直接検索と再ランキングでの使いどころ
ColBERTは、文書集合から候補を探す直接検索にも、取得済みの候補を並べ直す再ランキングにも使えます。同じスコア計算を使っていても、どこから文書を集めるかが異なります。
直接検索では、事前に作った索引から質問に関連する文書を探します。MaxSimの定義が全トークン間の類似度に基づいていても、大規模検索で全件を総当たりすることが必須というわけではありません。ベクトル類似度インデックスや、見込みの低い候補を計算対象から外す枝刈りなどを使い、探索する範囲を絞れます。
再ランキングでは、キーワードに基づくBM25や単一ベクトル検索が集めた候補に対し、ColBERTで関連度を計算して順位を更新します。この場合、最初の候補集合に入らなかった文書は、再ランキングでは取り戻せません。候補を増やすと必要な文書が入る可能性は高まりますが、後段の処理量も増えます。
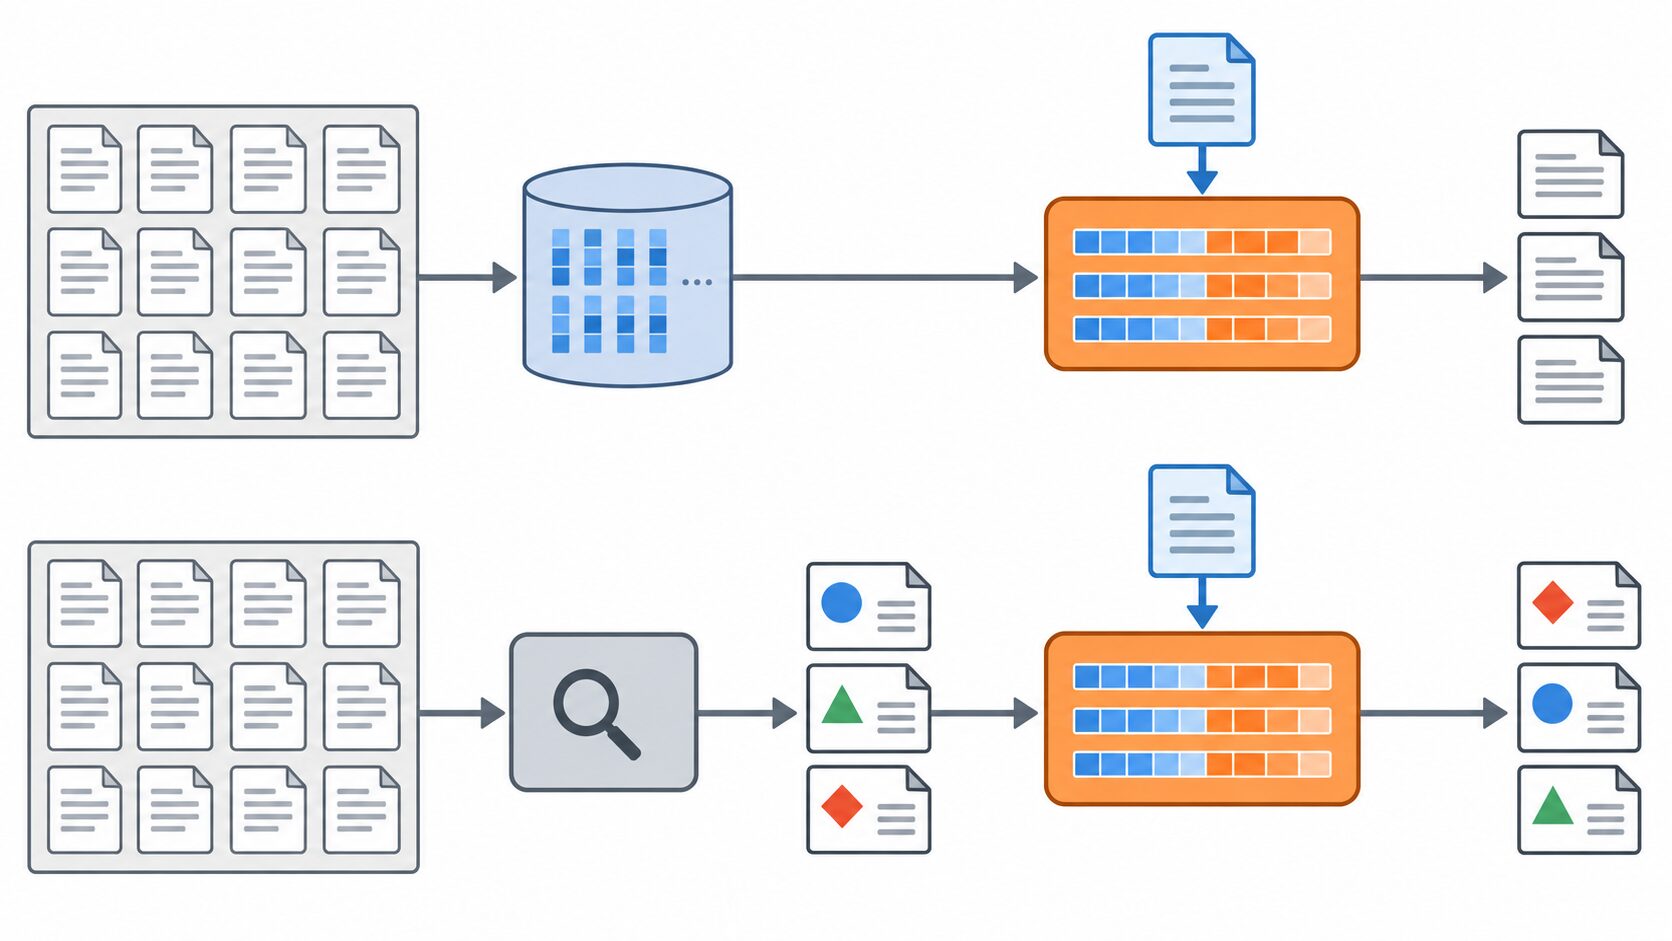
利用を検討しやすいのは、製品仕様や社内FAQなど、質問中の複数の手掛かりを文書と照合したい場面です。例えば「軽くてUSB-C充電に対応するパソコン」では、重量、充電方式、機器の種類が検索の手掛かりになります。ただし、数値の大小や必須条件を厳密に判定したい場合は、検索スコアだけに任せず、構造化された仕様の絞り込みなども組み合わせます。
RAGでは、回答の材料となる文書の取得や選別をColBERTが担当できます。ColBERT自体が回答文を生成するわけではありません。また、再ランキングは検索工程の役割の名前であり、ColBERTはその役割に使えるモデルの一方式です。
導入前に確認したい容量・評価・日本語対応
導入判断では、検索品質の改善が保存量と処理量の増加に見合うかを、自分たちの文書で確かめます。文書ごとの複数ベクトルを保持するため、索引容量には文書数だけでなく、文書長、保持するトークン数、ベクトルの次元、数値の保存形式が影響します。
長い文書をどう分割するかも重要です。短く分けると一つの検索単位で扱う情報は減りますが、条件の説明が別々の断片に分かれる場合があります。重なりを持たせて分割すれば、保存する情報が増えることもあります。文書を更新した際には、変更箇所に対応する埋め込みの再計算と索引の更新が必要になるため、更新頻度も運用コストに含めて考えます。
圧縮や索引設計、候補数の調整によって負担は変わります。保存容量だけでなく、検索中のメモリ使用量やベクトル転送の負担も確認しましょう。効率化の設定によっては、関連文書の取りこぼしや順位への影響も評価する必要があります。
評価には、実際に想定する質問と、その質問に答える文書の組を用意します。比較の観点は次の四つです。
- 取得率:答えを含む文書が、上位の候補にどの程度入っているか。
- 順位:より関連性の高い文書を上位に置けているか。
- 遅延:候補件数や同時利用数が増えたときも、応答時間が要件を満たすか。
- 資源:索引容量、必要メモリ、文書の追加・更新に必要な時間は許容範囲か。
日本語対応は、ColBERTという方式名だけでは判断できません。採用するチェックポイントの学習言語、Tokenizer、日本語検索での評価結果を個別に確認します。日本語を入力できることと、日本語文書を適切に順位付けできることは別です。専門用語、表記揺れ、略語などを含む実際の質問でも試す必要があります。
初代の原理と後続の実装も区別しましょう。元資料の確認時点では、公式リポジトリはColBERTv2やPLAIDを含みます。ColBERTv2による表現の圧縮やPLAIDによる検索の効率化など、後続の工夫を初代モデルの仕様と混同しないことが大切です。
原理は2020年のColBERT論文、実装は公式リポジトリで確認できます。論文のMS MARCOやTREC CARなどでの評価は、それぞれのデータセットと測定条件に基づく結果です。特定条件で得た精度や速度を、そのまま自社の検索の保証にはできません。
ColBERTを理解する出発点は、文章を複数ベクトルで保持し、別々に符号化した後でMaxSimによる照合を行うことです。この仕組みが必要な検索の手掛かりを残せるか、実際の品質と運用負担の両方から採用を判断します。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月4日 | 初回公開 |