
連続バッチ処理とは?LLMの複数リクエストを効率よくさばく仕組み

AIの初心者
同じAIに何人も質問すると、短い質問でも、ほかの人の長い回答が終わるまで待つのでしょうか?

AI専門家
待ち方はサーバーの仕組みによります。連続バッチ処理では、終わった要求を外して、待っている別の要求を途中から加えられます。
AIの初心者
それなら、利用者が増えても全員の回答が速くなるのですか?
AI専門家
空いた計算枠を活用できますが、計算能力やメモリには限りがあります。一人が感じる待ち時間と、全体で処理できる量を分けて見るのがポイントです。
連続バッチ処理とは。
連続バッチ処理(continuous batching)は、LLMの推論で、生成ステップごとに完了した要求を外し、新しい要求を加えて、処理する組を動的に組み直す方式です。回答の長さが異なる複数の要求を効率よく扱うための既存技術で、モデルを学習させる手法ではありません。長い回答が続いている間も、利用可能な計算量とメモリの範囲で次の要求を進められます。
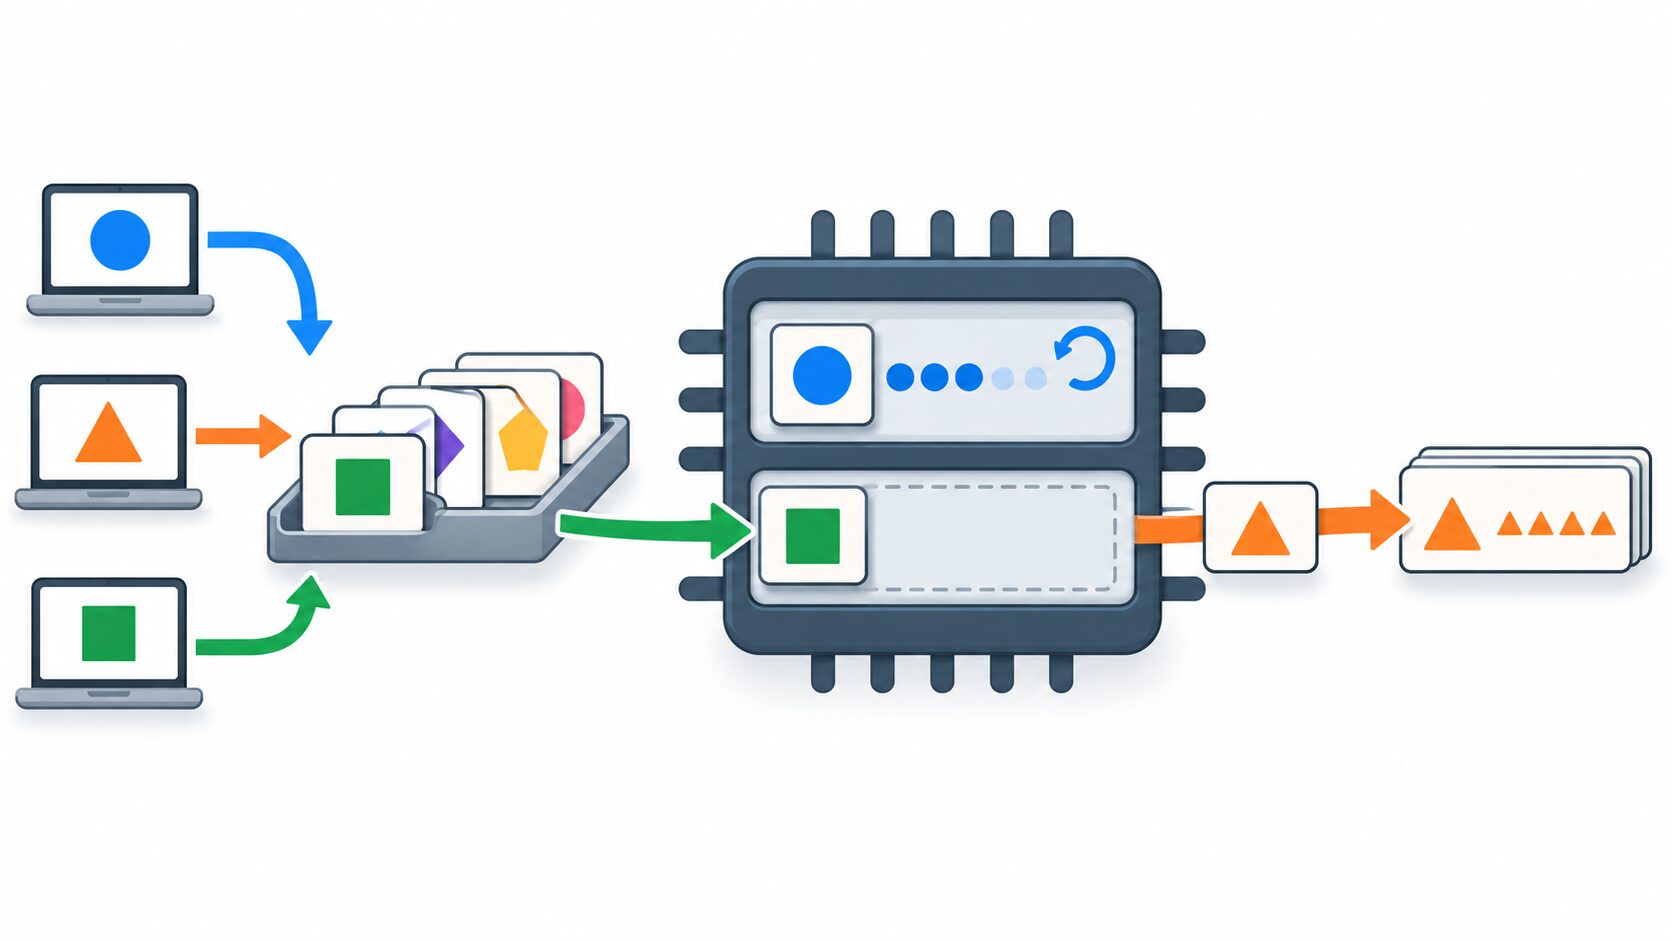
複数人から届いた質問は待機列に入り、処理対象に選ばれると回答生成が進みます。全体像をつかむには、「まとめて開始すること」よりも「完了に応じて参加する要求を入れ替えること」に注目してください。
固定バッチでは短い回答の後に空きが生まれる
バッチとは、複数の要求をひとまとめにして計算する単位です。GPUなどの計算装置で複数の要求を一緒に扱うと、一件ずつ処理する場合より計算資源を有効に使えることがあります。ただし、LLMの回答は要求によって長さが異なります。「はい」と答える質問と、長い説明文を書く依頼では、終了するタイミングがそろいません。
LLMは通常、トークンという単位で出力を順に生成します。トークンは単語の一部や記号などに相当し、日本語の一文字と必ず一致するわけではありません。生成ステップを繰り返して文章を延ばし、終了条件に達した要求から処理を終えます。
ここでいう固定バッチは、開始した後に要求の組を変えない方式です。二つの要求を一緒に始めて片方が先に終わっても、その場所へ別の要求を途中参加させられません。長い要求の処理が続く間、終了した要求の分を次の要求で埋められず、処理枠に空きが残ることが問題になります。入力長をそろえるためのパディングなどもありますが、ここで注目するのは生成中の入れ替えです。
ただし、「新しい要求が計算を始められないこと」と「終わった回答を利用者へ返せないこと」は別です。出力を逐次送るストリーミングや個別返却に対応していれば、短い回答を先に受け取れる場合があります。一括返却なら全件の完了を待ちます。固定バッチだから短い回答の表示まで必ず遅れる、と考えるのは正確ではありません。
生成ステップごとに完了要求を外し新規要求を加える
連続バッチ処理では、スケジューラーと呼ばれる仕組みが、各ステップで処理する要求やトークンを選びます。一度決めた組を最後まで固定せず、生成の区切りで状況を見直すため、まだ続く要求を残したまま、終了した要求を別の要求へ入れ替えられます。
- 現在の処理対象について、生成を進める。
- 終了した要求を外し、継続する要求の状態を保持する。
- 計算量とメモリの余裕を確認し、待機列から新しい要求を選ぶ。
- 継続する要求と追加した要求を含め、次のステップへ進む。
このように、入れ替えるのは処理に参加する要求であり、継続中の回答を最初から作り直すわけではありません。各要求の入力や生成済みの情報は分けて管理されます。同じバッチで計算することが、利用者同士の会話の文脈を混ぜることにはなりません。また、行っているのは学習済みモデルによる推論で、モデルの重みを更新する処理でもありません。
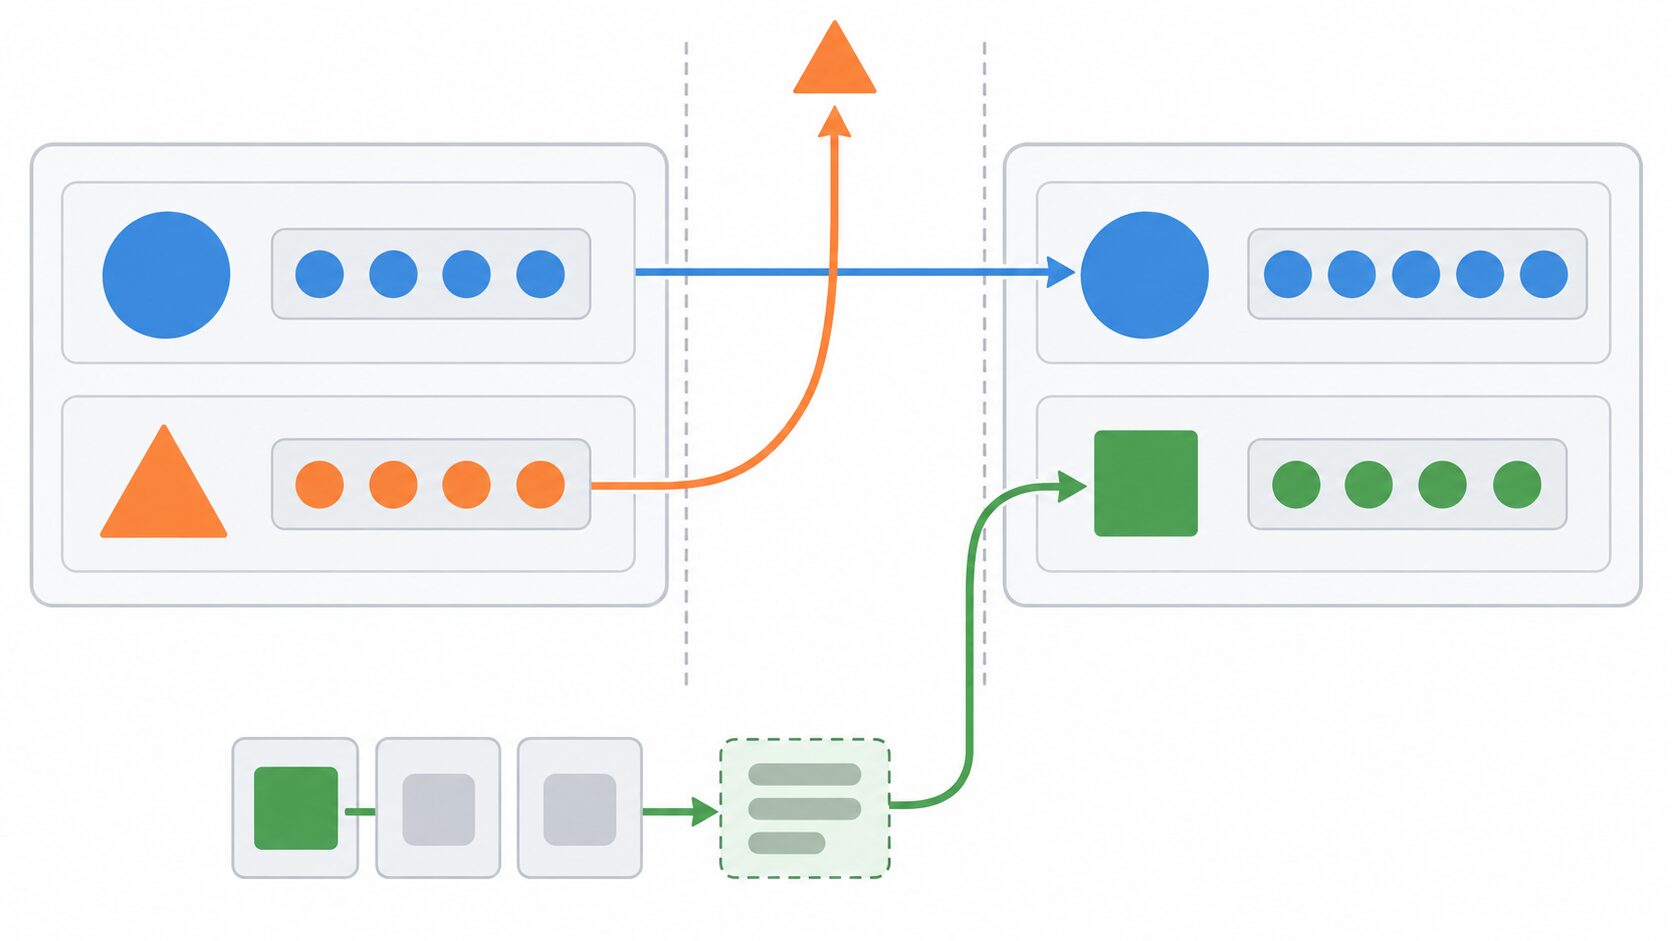
新しく参加する要求は、まず入力文を読み込むプリフィルが必要です。一方、処理中の要求は、出力を順に進めるデコードを続けます。この二つは必要な計算の性質や量が異なるため、単に要求の数だけを数えて追加できるとは限りません。どの程度の入力を一度に処理するか、既存の出力生成とどう配分するかは実装によります。
したがって、空きが生まれた瞬間に、待機中のすべての要求が実行されるわけではありません。入力が長い要求や、必要なメモリを確保できない要求は待つことがあります。目的は空き枠の活用であり、各要求の生成計算そのものを必ず短縮したり、同時実行数を無制限に増やしたりする仕組みではないのです。
3人の質問で見る固定バッチと連続バッチの違い
同時に二つの要求を処理できると仮定します。Aさんの回答には6ステップ、Bさんには2ステップ、Cさんには3ステップ必要です。最初にAさんとBさんを処理し、途中で届いたCさんの要求は、Bさんが終わる時点ですでに待機列にあるものとします。
固定バッチでは、2ステップ目でBさんが終わっても、3〜6ステップ目はAさんだけが残ります。CさんはAさんの終了後に始まり、7〜9ステップ目で処理されます。二つまで処理できる枠があっても、最初の組が終わるまで追加できないためです。
連続バッチ処理なら、Bさんが終わった後の3ステップ目からCさんを加えられます。Cさんは3・4・5ステップ目で処理されて終了し、Aさんは6ステップ目で終了します。Aさんの必要な生成回数は変わらず、Cさんが処理に参加する時点が早まります。
| 要求 | 必要な生成ステップ数 | 固定バッチの処理区間 | 連続バッチの処理区間 |
|---|---|---|---|
| Aさん | 6 | 1〜6ステップ目 | 1〜6ステップ目 |
| Bさん | 2 | 1〜2ステップ目 | 1〜2ステップ目 |
| Cさん | 3 | 7〜9ステップ目 | 3〜5ステップ目 |
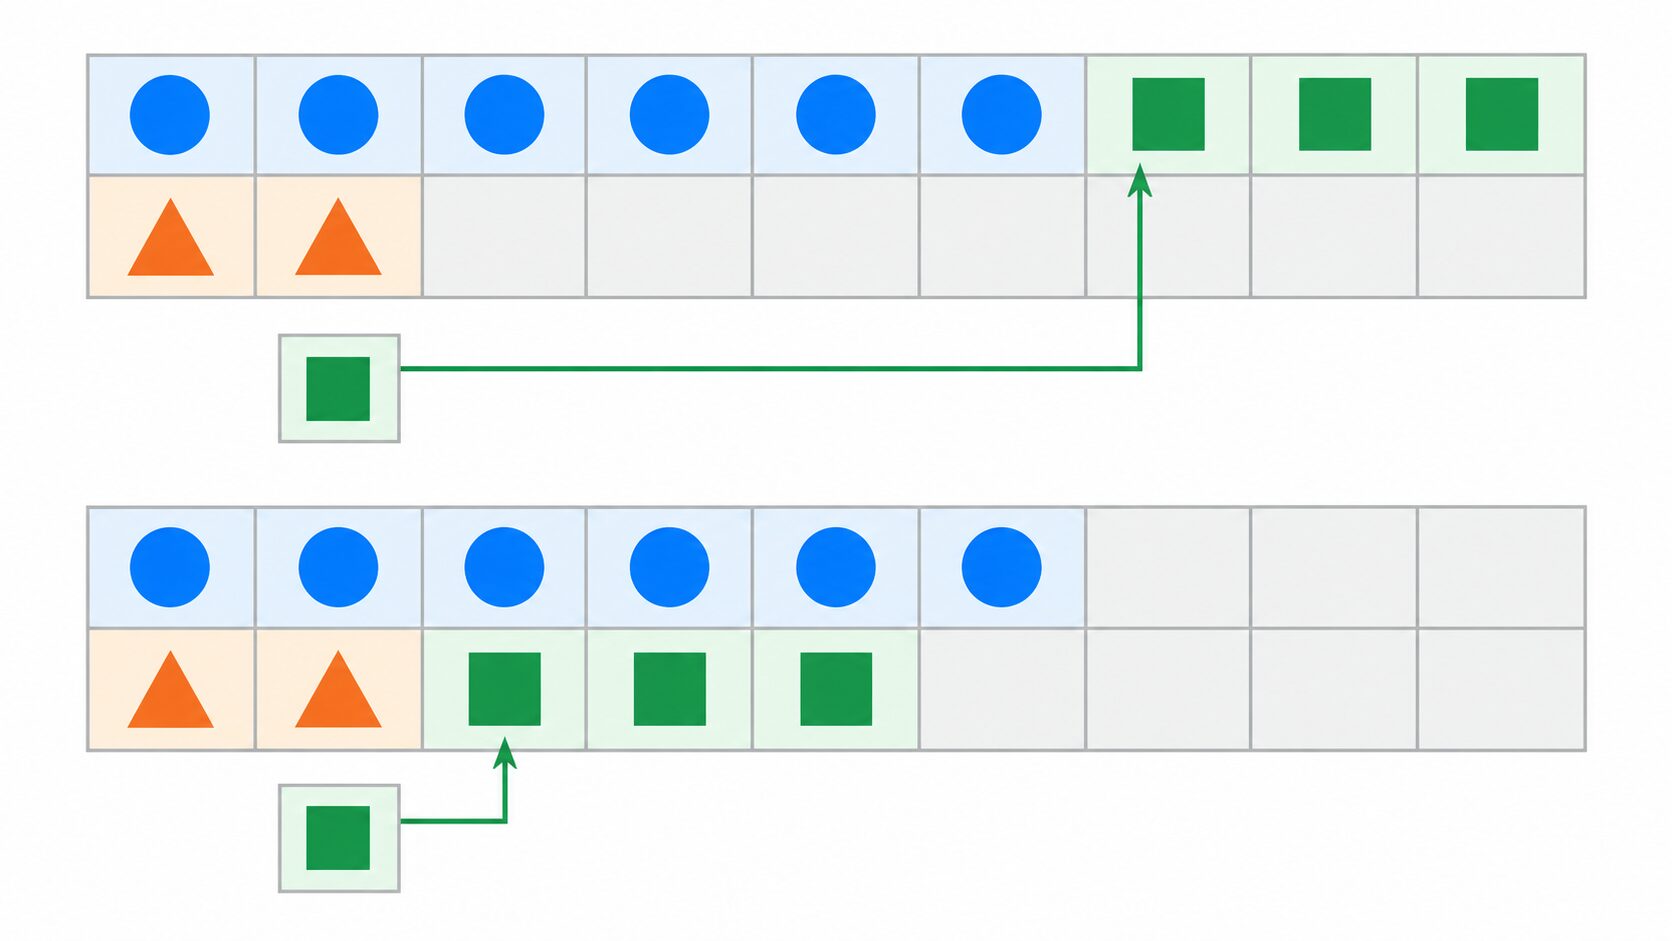
この例で見るべき点は、Bさんの終了で生まれた空きをCさんに使い、Cさんの待機を減らせることです。説明を簡単にするため、プリフィル、通信、ステップごとの計算時間の違いは省いています。実際には参加する要求が増えると一回の計算時間も変わり得るので、「9ステップが6ステップになったから実時間も同じ比率で短くなる」とは判断できません。
学習のミニバッチ・非同期処理・PagedAttentionとの違い
似た用語でも、何をまとめ、何を管理しているかは異なります。「バッチ」という言葉だけで同じ技術と考えず、対象と役割を分けると整理できます。
| 用語 | 対象 | 役割 | 連続バッチ処理との関係 |
|---|---|---|---|
| 連続バッチ処理 | 推論中の生成要求 | ステップごとに処理対象を入れ替える | 要求のスケジューリング方式 |
| 学習のミニバッチ | 複数の訓練例 | 勾配を計算し、モデルの重みを更新する | 推論ではなく学習の話 |
| 一般の非同期処理 | 完了を待つ必要がある作業 | ある作業の完了を待たずに別の作業を進める | 要求の入れ替えとは別の考え方 |
| PagedAttentionとKV管理 | 要求ごとのKVキャッシュ | メモリを割り当て、計算時に保持情報を参照する | 効率的な入れ替えを支える構成として併用される |
学習のミニバッチでは、複数の訓練例からモデルをどちらへ修正するかを表す勾配を求め、重みの更新につなげます。連続バッチ処理は、すでに学習したモデルで複数の回答を生成する際の運用技術です。学習時のバッチサイズを変える話とは、目的も処理の段階も異なります。
非同期処理も同義ではありません。たとえば、アプリがAIの返答を待つ間に画面操作を受け付けても、推論サーバー内で要求を入れ替えているとは限りません。Hugging Face Transformersの「Async batching」は、CPUによる次のバッチの準備と、GPUによる現在のバッチの計算を重ねる機能です。「準備と計算を重ねること」と「バッチの参加者を変えること」は別の軸にあります。
KVキャッシュは、過去のトークンに関する計算結果のうち、後続の生成で再利用する情報です。回答を継続するには、その要求の情報を保持して参照できる必要があります。PagedAttentionとKV管理は、こうした情報をブロック単位で扱う仕組みに関わります。
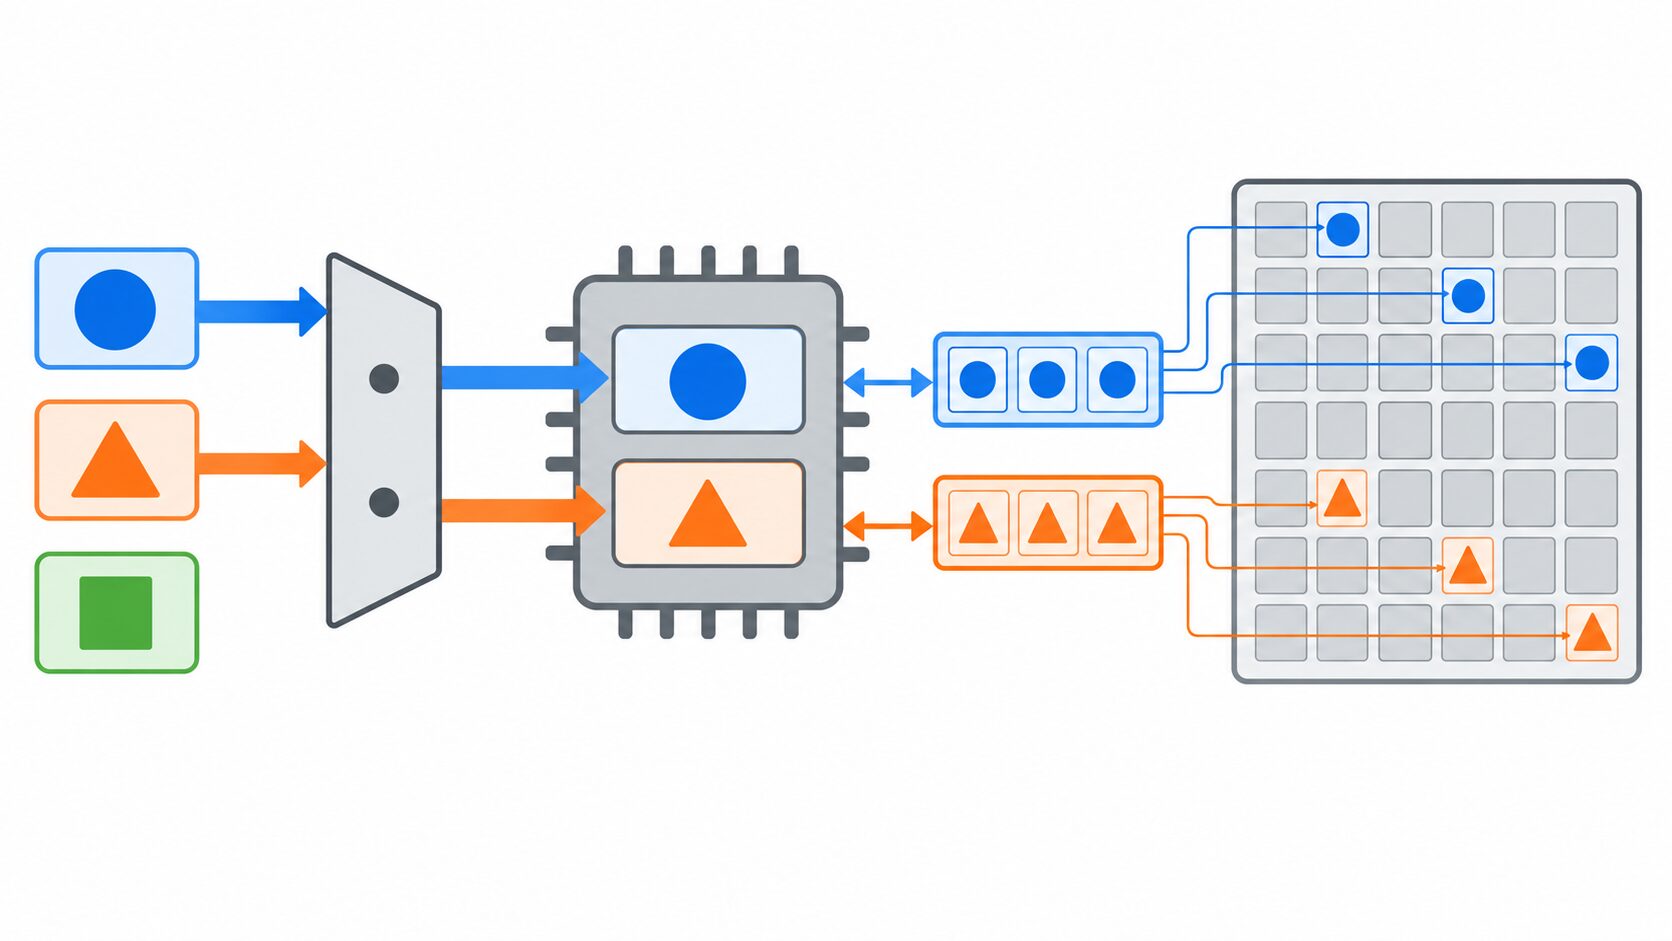
スケジューラーは「次に誰を処理するか」、KV管理は「継続に必要な情報をどこに保持して参照するか」を担います。両者は連携しますが、PagedAttentionという名称だけで要求の選び方まで説明できるわけではありません。また、プリフィルとデコードの分離は、入力を読む段階と出力する段階を別の計算資源などへ配置する設計です。生成中に要求を入れ替える方式とは区別して考えます。
応答の待ち時間と全体の処理量を分けて読む
性能を見るときは、一人の利用者が経験する時間と、サーバー全体が処理する量を分けて確認します。連続バッチ処理で多くの要求をさばけても、一人ひとりが待つ時間まで必ず短くなるとは限りません。
| 指標 | 何を測るか | 読み取れること |
|---|---|---|
| TTFT | 要求開始から最初のトークンまでの時間 | 回答が出始めるまでの待ち時間 |
| ITL | 出力されるトークン同士の時間間隔 | 回答が流れてくる滑らかさや途中の停滞 |
| TPOT | 要求ごとの平均トークン間隔 | 生成中の平均的な出力ペース |
| E2E | 要求開始から完了までの時間 | 回答全体がそろうまでの待ち時間 |
| スループット | 単位時間当たりの処理量 | サーバー全体のtoken/sやrequest/s |
対話用チャットなら、回答が出始めるまでのTTFTと、その後の出力間隔が体感に関わります。平均的な出力ペースが同じでも、途中で長く止まる回答は読みにくく感じられます。文書要約を大量に実行する用途では、一定時間に何件完了できるかや、全体の処理終了までの時間も重視するでしょう。
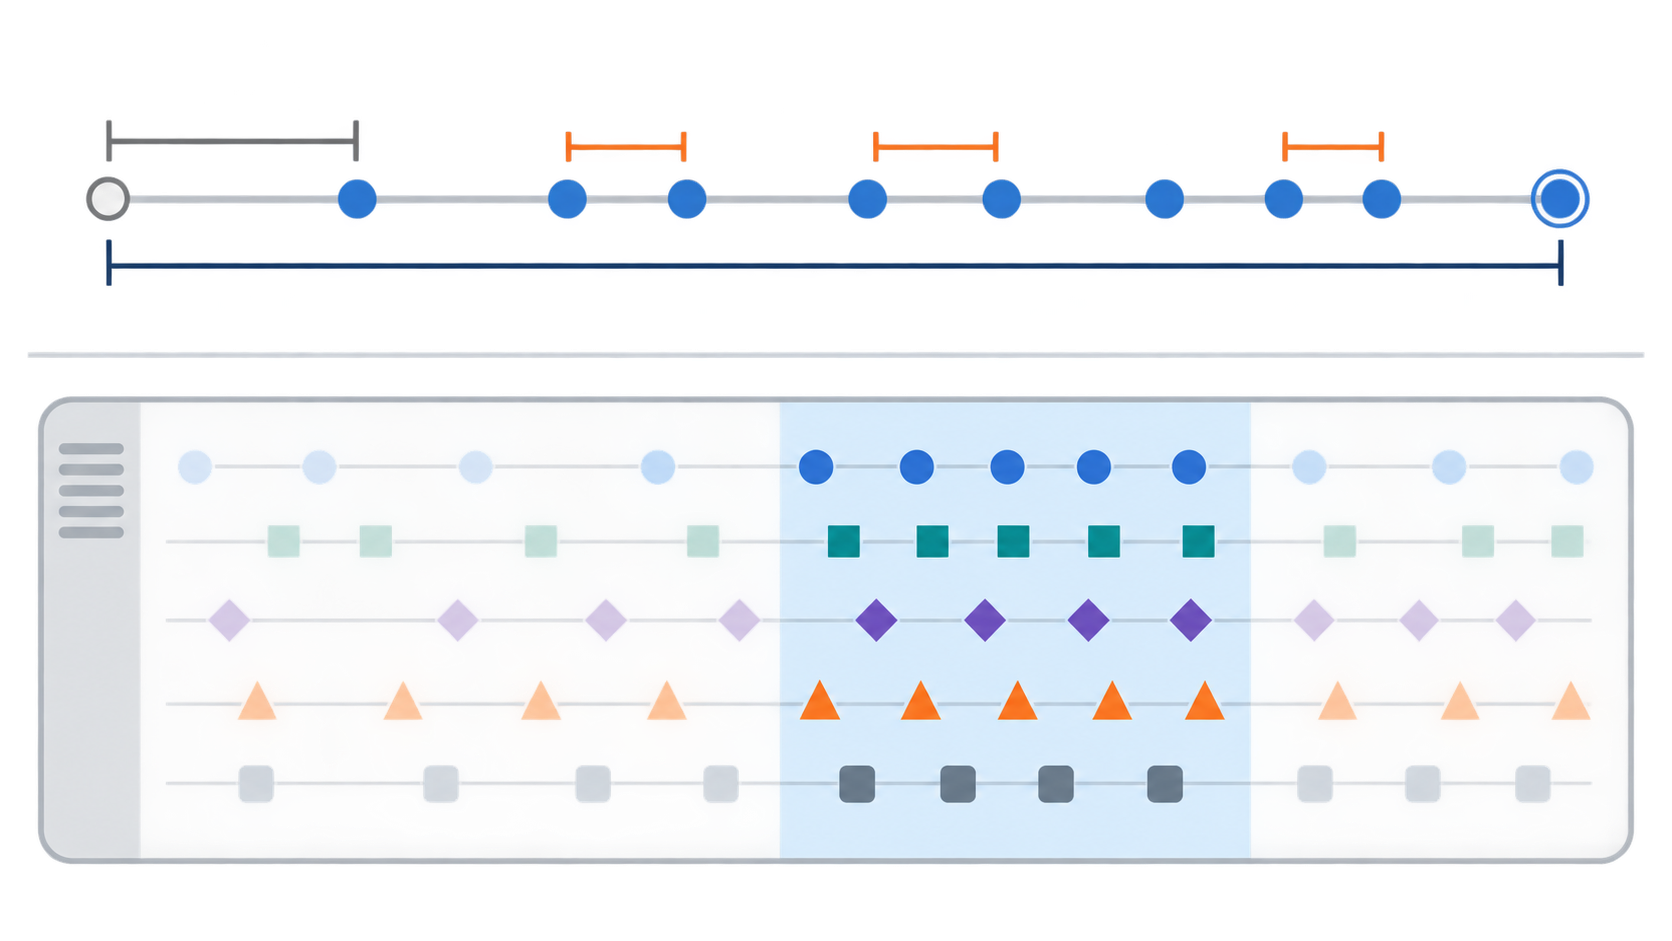
バッチを大きくして計算資源を活用すると、全体のスループットが上がる場合があります。一方、混雑や計算能力の飽和によって、一回の処理に時間がかかり、出力間隔が伸びることもあります。待機列が長くなれば、最初の出力を受け取るまでの時間も増えます。処理量の増加と応答の快適さは、別々に確かめる必要があります。
比較するときは、モデル、機器、入力長、出力長、要求の到着頻度、同時数をそろえます。短い回答が多い条件ではrequest/sが高くなりやすく、token/sも入力と出力のどちらを数えるかで意味が変わるため、測定条件の確認が欠かせません。
平均値だけでなく、遅い要求にも目を向けてください。たとえば、通常はすぐに返答できても、混雑したときの一部の要求だけ長く待つことがあります。実際の利用に近い質問の長さや到着の偏りを含めて見ると、処理量を増やした結果、どの利用者の待ち方が変わったかを判断しやすくなります。
同時利用で役立つ場面とメモリ不足時の限界
連続バッチ処理が役立ちやすいのは、共有チャット、社内問い合わせ窓口、ローカルLLMの複数人利用など、要求が重なり、回答長にもばらつきがある場面です。短い確認と長い文章生成が混在していても、終了した要求の分を待機中の要求に回せます。
反対に、一人が一件ずつ質問し、回答が終わってから次を送る使い方では、空きを埋める別の要求がほとんどありません。この場合に効果が限定的なのは、入れ替えの仕組みから考えられることです。一件の長文生成を速めたいのか、多人数から届く要求を効率よくさばきたいのかで、期待する効果を分けましょう。
大きな制約になるのがKVキャッシュの容量です。長い入力を読んだり、長い回答を生成したり、多くの要求を同時に保持したりすると、必要なメモリが増えます。計算する余地があっても、要求の状態を置くメモリがなければ、新しい要求は待機します。完了によってメモリが解放されるまで、追加できない場合があるのです。
運用では、同時処理数、入出力のトークン上限、待機列の長さを、TTFTや出力間隔と合わせて確認します。同時数だけを増やしても、メモリ不足や混雑が強まれば待ち時間の改善につながりません。たとえば長文を扱う利用者が増えたときは、短い質問だけで行った測定がそのまま当てはまるとは限りません。
要求の投入方法と結果の返却方法も確認が必要です。TransformersのContinuousBatchingManagerは要求の投入と結果取得を個別に扱えますが、generate_batch()はすべての要求が完了するまで待って結果を返します。内部で連続バッチ処理を使っていても、APIが一括返却なら、利用者は短い回答だけを先に受け取れません。対話画面で逐次表示したい場合は、ストリーミングまで含めた経路を見る必要があります。
この方式はvLLMなどで利用され、Apple Silicon上の同時サービングにも適用例があります。ただし、特定の機種、モデル、量子化、同時数で得られた測定値は、すべての環境での効果や、連続バッチ処理だけによる高速化を保証するものではありません。名称だけで性能を判断せず、自分の利用条件で「待機を減らせるか」「出力が途切れないか」「必要な処理量を満たすか」を確かめることが大切です。
仕組みと実装上の区別は、Hugging Face Transformersの連続バッチ処理ドキュメント、vLLMの推論システム解説、Apple Siliconでの同時サービング紹介に基づいています。資料の確認日は2026年10月3日です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月3日 | 初回公開 |