
マルチタスク学習とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「マルチタスク学習」って、AIにいくつもの仕事を一度に覚えさせることですか?どうやって学ぶんでしょうか?

AI専門家
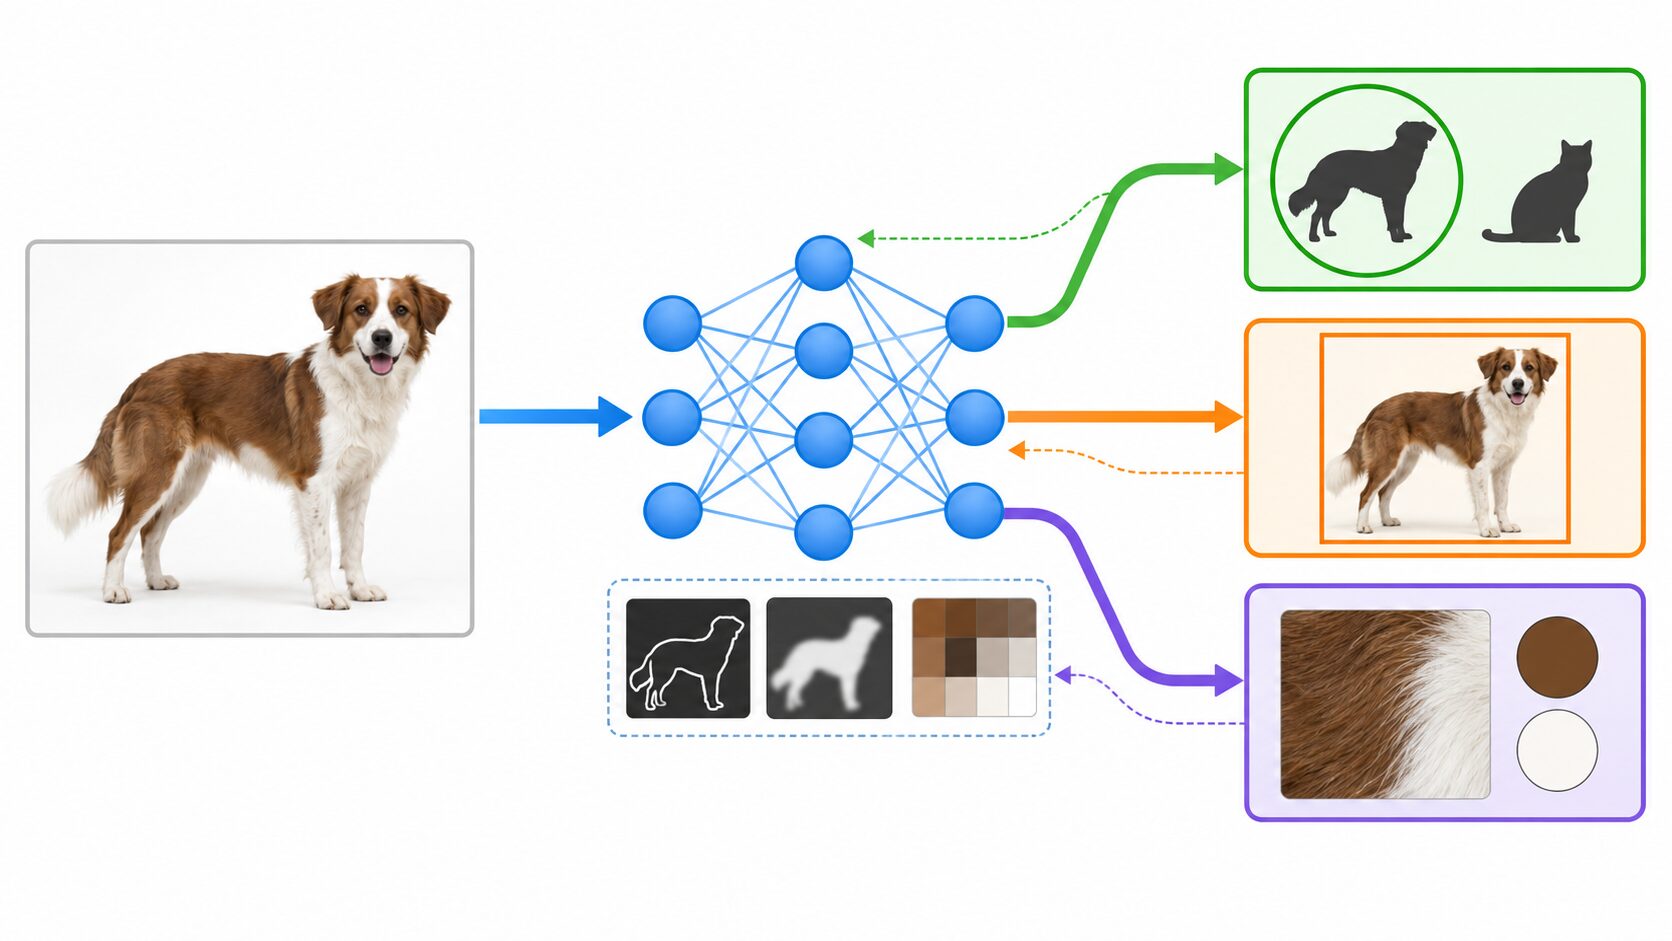
関連する複数の課題を、共通の手掛かりを使いながら一緒に学ぶ方法だよ。例えば写真から「犬が写っているか」を判断する課題と、「犬がどこにいるか」を見つける課題なら、輪郭や形の情報を共有できるんだ。
AIの初心者
共通の手掛かりを使うんですね。でも、一つの課題に集中して学んだ方が、得意になることもありませんか?
AI専門家
もちろんあるよ。複数の課題が互いに役立つ情報を与えれば精度の向上が期待できるけれど、学習を邪魔し合うこともある。何を一緒に学ばせるかを選び、一つずつ学ばせた場合と比べることが大切なんだ。
マルチタスク学習は、関連する複数の予測・判定の課題を、知識や特徴を共有しながら共同で学習する手法です。画像から物体の種類と位置を求めたり、文章の翻訳と要約を学んだりする場面が例になります。課題を組み合わせることで、限られたデータを有効に使い、未知のデータへの予測性能を高められる可能性があります。
ただし、課題の数を増やすだけで精度が上がるわけではありません。まずは犬の写真から種類・位置・毛色を学ぶ例を入り口に、特徴を共有する仕組み、ほかの学習方法との違い、効果を確かめるポイントを見ていきましょう。
マルチタスク学習とは
機械学習でいう「タスク」とは、モデルに解かせたい予測や判定の課題を指します。例えば「写真に写る動物が犬か猫かを判定する」「物体の位置を座標で答える」「文章を別の言語へ翻訳する」といったものです。入力に対して何を答えさせ、その答えをどう評価するかによって、課題の内容が決まります。
マルチタスク学習は、英語でMulti-Task Learningといい、MTLと略されます。複数の課題を個別に学ぶだけでなく、学習する特徴やモデルの一部を共有し、ある課題から得た情報をほかの課題にも役立てる点が特徴です。深層学習では、入力から手掛かりを取り出す部分を共通にし、その先で課題ごとの答えを出す構成が代表例です。
犬の写真を例にすると、次のような課題を考えられます。
- 種類の判定:写真に写っている動物が犬なのか、猫なのかを答える。
- 位置の特定:犬が写っている範囲を四角い枠などで示す。
- 大きさの推定:画像の中で犬が占める幅や高さを求める。
- 毛色の判定:犬の毛が茶色、白色などのどれに当たるかを答える。
種類や位置を判断する際には輪郭や体の形が、毛色を判断する際には犬の領域や色が手掛かりになります。必要な情報は完全には一致しませんが、共通して使える部分があれば、学習を助け合える可能性があります。なお、画像内の大きさは位置を示す枠から計算することもでき、必ず独立した課題にする必要はありません。写真から現実の体長を推定する場合は、距離や縮尺など別の情報も必要です。
複数の処理を同時に実行することと、複数の課題から共同で学ぶことは別です。犬を判定するモデルと毛色を判定するモデルを別々に学習し、同時に動かしても、それだけではマルチタスク学習とはいえません。学習の過程で知識や特徴を共有しているかがポイントです。
また、設計の目的は一つに限りません。種類判定と位置推定の両方を実用に使い、双方の性能を高める設計もあれば、種類判定を主目的として、学習を助けるためだけに位置推定を加える設計もあります。後者のような課題を補助タスクと呼びます。補助タスクの出力は、実際の利用時には使わない場合もあります。
共通の特徴を学ぶ仕組み
代表的なニューラルネットワークの構成では、入力から特徴を取り出す共有部分と、課題別に答えを出す出力部分を組み合わせます。画像なら、共有部分で輪郭、模様、形などの手掛かりを表現し、それを受け取った各出力部分が「犬である」「この範囲にいる」といった異なる答えを作ります。この課題別の出力部分は「ヘッド」と呼ばれることもあります。
学習では、予測と正解のずれを数値にした損失を使って、モデルの内部の数値であるパラメータを調整します。マルチタスク学習では複数の課題の損失を学習に反映させるため、共有部分が複数の観点から修正されます。入力、共有部分、課題別の出力、そして正解とのずれという流れで捉えると、知識を共有する場所が理解しやすくなります。
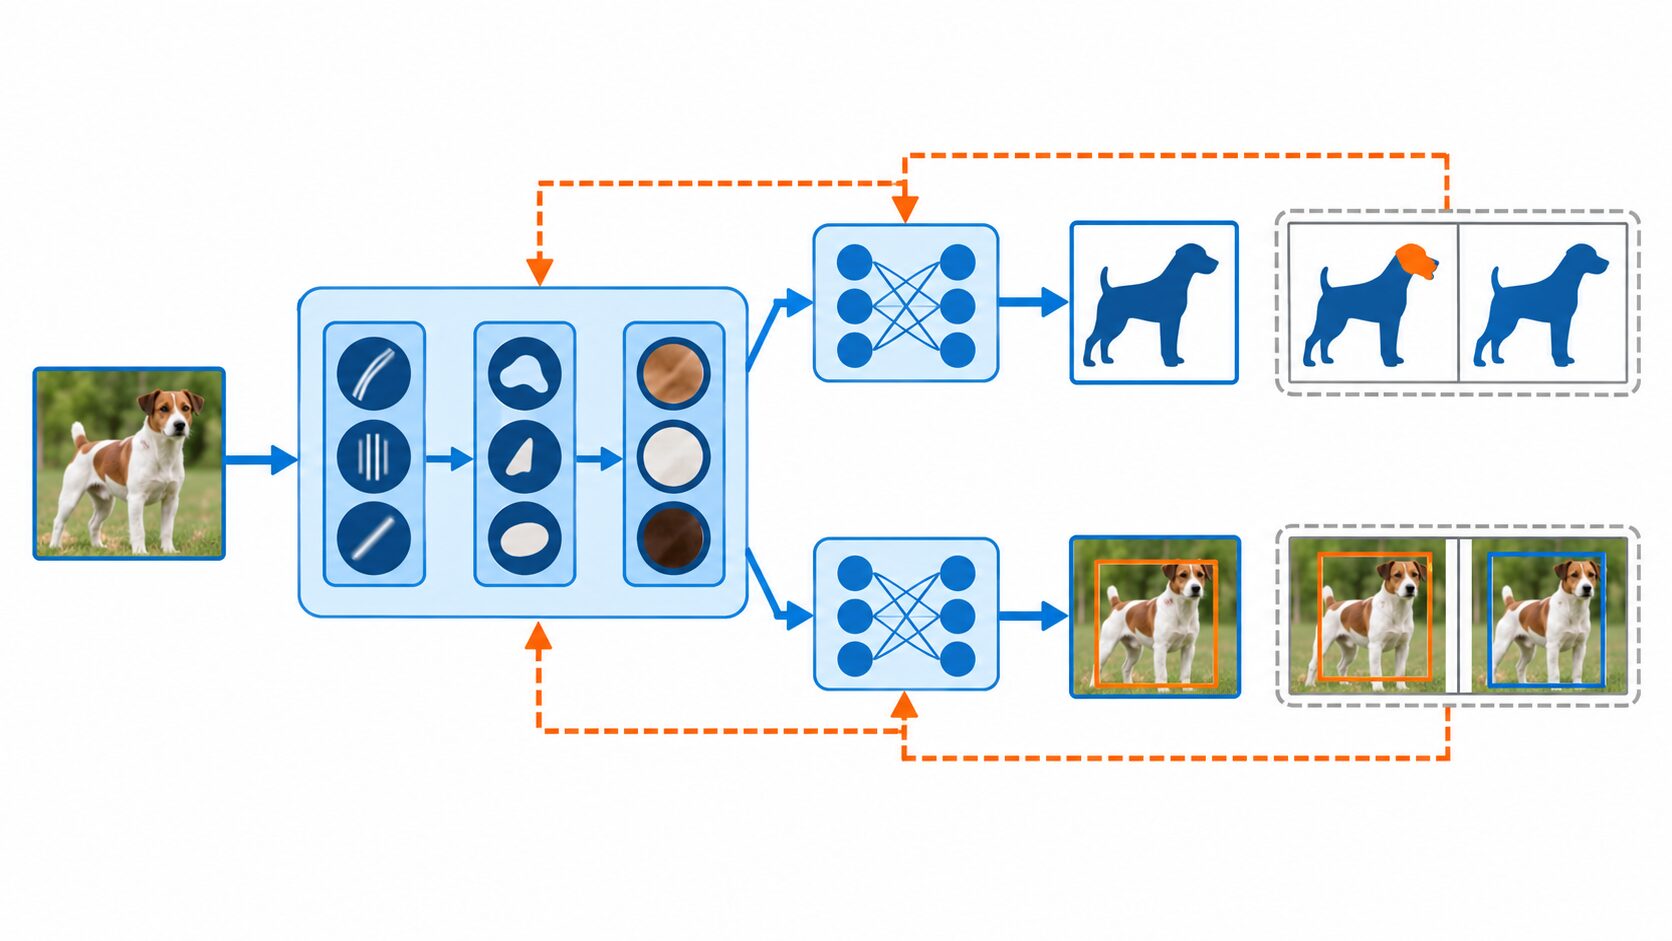
例えば犬の種類判定を間違えたときと、犬の位置を外したときでは、モデルに修正を促す情報が異なります。その両方を利用することで、共有部分は種類を見分けるだけでなく、対象がどこにあるかにも役立つ特徴を学ぶよう調整されます。ただし、二つの課題が求める修正の方向がいつも一致するとは限りません。
そのため、課題ごとの損失には重みを付けて、学習への影響を調整することがあります。種類判定の誤りと位置のずれは数値の尺度が異なるため、そのまま足すと片方の影響が大きくなる場合があるからです。重みは「どの課題を重視するか」に関わりますが、大きくすれば必ずその課題の性能が上がるわけではなく、検証が必要です。
特徴の共有方法にも、いくつかの考え方があります。
- ハード共有:複数の課題でモデルの一部のパラメータを直接共有します。共通の特徴抽出部分と課題別の出力部分を持つ構成が一例です。共有部分の更新が複数の課題に影響します。
- ソフト共有:課題ごとにモデルやパラメータを持ちつつ、対応するパラメータを近づける制約などによって、学ぶ内容を関連付けます。各課題に固有の部分を持たせながら知識を共有する考え方です。
すべての入力に、すべての課題の正解が付いていることは必須ではありません。種類の正解がある画像と位置の正解がある画像を交互に使い、同じ共有部分を更新する学習も可能です。この場合、正解がない課題の損失を計算から外すなどの設計が必要になります。未記入の正解を「犬がいない」とみなすような扱いは、誤った学習につながります。データごとの正解の有無や、課題間でのラベルの定義を管理することが大切です。
精度向上・過学習抑制が期待できる理由
マルチタスク学習に期待される効果の一つが、過学習の抑制です。過学習とは、訓練に使ったデータにはよく合う一方で、学習に使っていないデータでは性能が落ちる状態をいいます。正解に結び付く一般的な手掛かりだけでなく、訓練データに偶然含まれた偏りやノイズまで覚えてしまうことが原因になり得ます。
例えば、訓練用の犬の写真に芝生が多いと、犬の形よりも背景の緑色を頼りに判定するモデルになる可能性があります。ここに犬の位置を特定する課題を加えると、背景だけでなく犬の領域にも注目するよう学習を促せます。複数の課題に役立つ特徴を求めることが、特定のデータの癖への過度な適応を抑える方向に働くわけです。ただし、背景への依存が必ずなくなるわけではなく、データの偏り自体を見直すことも必要です。
こうした効果は、モデルが訓練データに合わせすぎることを抑える正則化の一種として捉えられます。ほかの課題にも使える特徴を学ぶという条件が加わることで、一つの課題の訓練データだけに都合のよい学び方をしにくくなるためです。
汎化性能とは、学習対象の課題について、まだ見ていないデータにも適切に予測できる力です。犬猫の分類なら、新しく撮影した犬や猫の写真でも分類できることが該当します。犬猫の分類を学んだモデルが、学習していない翻訳までできるようになるという意味ではありません。また、単一タスク学習でも、十分なデータや適切なモデル設計によって高い汎化性能を得られます。
もう一つの利点は、関連する課題の教師情報、つまり学習の手掛かりとなる正解データを活用できることです。主目的の正解データが少なくても、関連する課題に十分なデータがあれば、共有部分の学習を支えられる可能性があります。一つの課題からだけでは得にくい情報を別の課題が補い、特徴を学ぶ手掛かりが増える場合もあります。
例えば、犬猫の識別と年齢推定は、組み合わせを検討できる候補です。両方で顔や体の特徴を使える可能性がありますが、年齢に有効な手掛かりが種類の識別にも役立つかはデータ次第です。写真だけでは年齢を判断しにくい場合や、正解の年齢に誤差がある場合もあります。未知の犬種・猫種で必ず精度が上がるとはいえず、実際の評価によって確かめる必要があります。
マルチタスク学習は、情報の見落としやデータ不足を自動的に解消する仕組みではありません。複数の課題に共通する有用な手掛かりがあり、その手掛かりを学べるデータがそろっているときに、効果を期待しやすくなります。
単一タスク学習・転移学習との違い
マルチタスク学習を理解するには、何を学ぶかに加えて、知識をどう共有し、どのように学習を進めるかを比べると整理しやすくなります。単一タスク学習、マルチタスク学習、転移学習は、単純な性能の順位を表す言葉ではありません。
| 学習方法 | 対象となる課題 | 知識の共有・利用方法 | 学習の進め方 |
|---|---|---|---|
| 単一タスク学習 | 一つの予測・判定の課題 | 対象の課題に必要な特徴を学ぶ | その課題の損失を基にモデルを調整する |
| マルチタスク学習 | 関連する複数の課題 | 特徴やパラメータなどを共有する | 複数の課題から得られる情報を共同学習に反映する |
| 転移学習 | 別の課題やデータで得た知識を利用する対象の課題 | 学習済みモデルの特徴やパラメータなどを利用する | 事前学習の後、対象のデータで追加学習する方法が代表例 |
単一タスク学習は、対象の課題に集中でき、設計や評価が比較的単純です。十分な正解データがあり、組み合わせたい課題が見つからない場合には、有力な選択肢になります。ほかの課題との重みの調整も必要ないため、まず比較の基準として作るモデルにも適しています。
転移学習は、ある課題やデータで得た知識を、別の課題やデータに利用する考え方です。例えば、大量の一般画像で学んだモデルを使い、手元の商品画像の分類に合わせて追加学習する方法があります。代表的な流れでは、前の学習で得た知識を後の学習に引き継ぎます。一方、マルチタスク学習では、複数の課題が共同の学習過程に関わることが中心です。
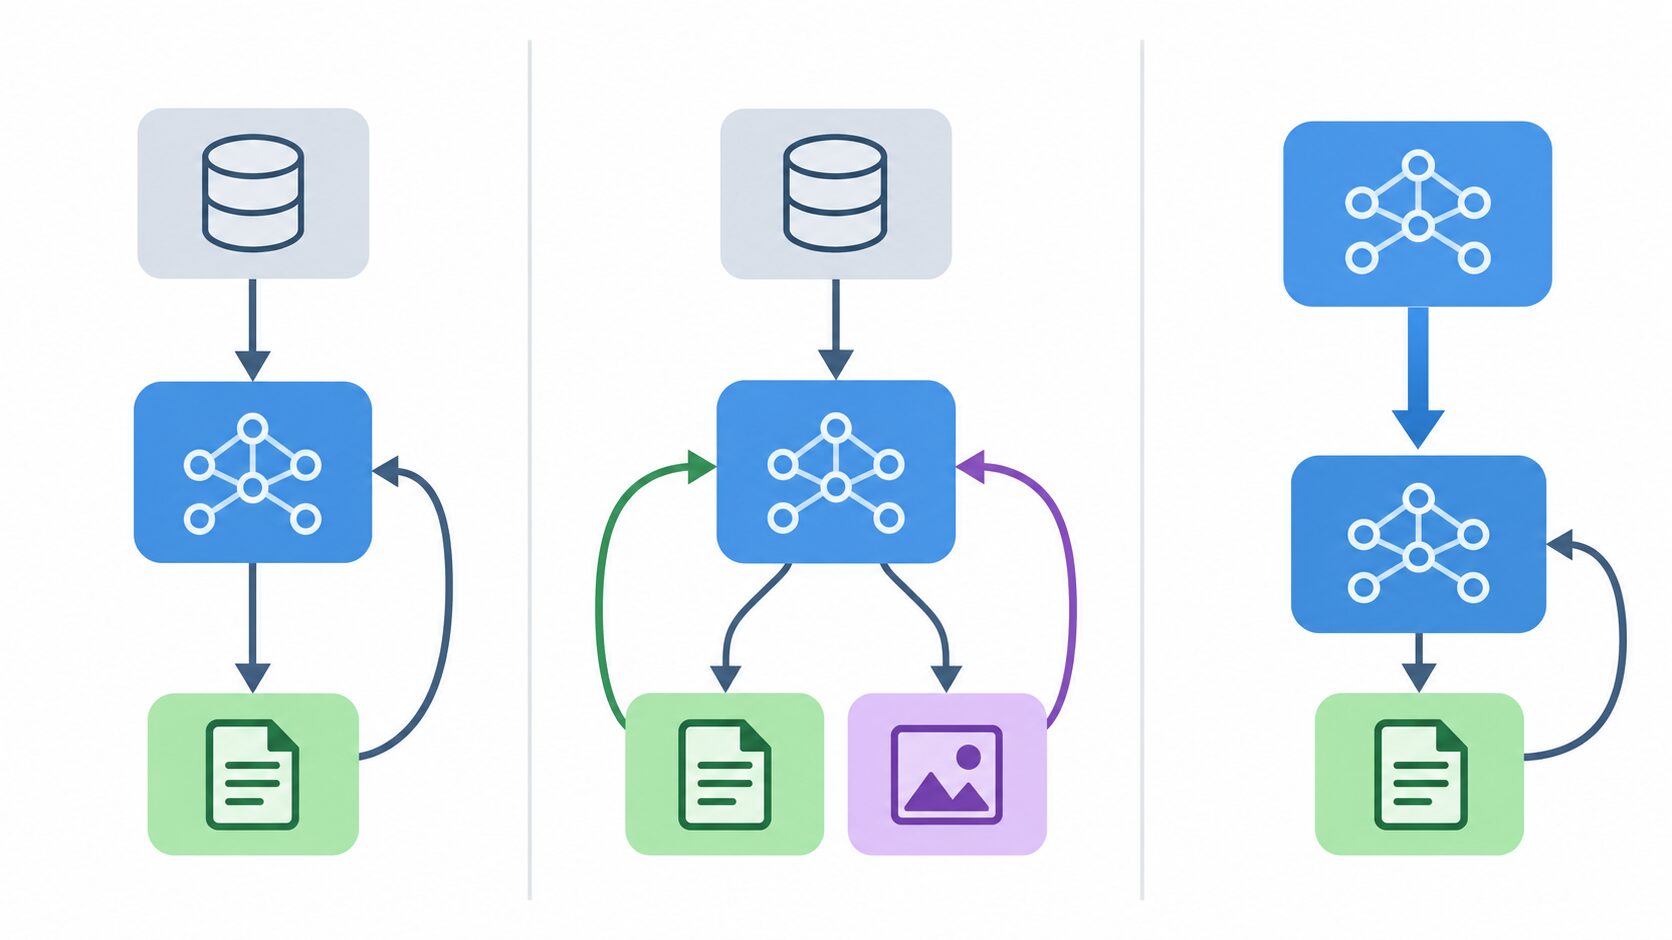
転移学習とマルチタスク学習は併用できます。例えば、事前学習済みの画像モデルを土台にし、車種の判定と損傷の判定を共同で学習させる方法です。この場合、学習済みの知識を利用する点が転移学習であり、複数の課題を一緒に学ぶ点がマルチタスク学習に当たります。
混同しやすい言葉にマルチラベル分類もあります。これは、一つの入力に複数のラベルを付ける問題設定です。例えば一枚の写真に犬と猫が写っていれば、「犬」と「猫」の両方を付けます。複数ラベルの有無をまとめて予測する一つの分類課題として扱えるため、出力が複数あるだけでマルチタスク学習とは限りません。マルチラベル分類は答えの付け方、マルチタスク学習は複数課題の学び方に関する概念です。
画像認識と自然言語処理での活用例
活用を考えるときは、「同じ入力だから一緒に学ばせる」と決める前に、各課題がどの手掛かりを必要とするかを確認します。画像認識なら輪郭や形、自然言語処理なら語句の意味や文中の関係など、共有できる情報を具体的に挙げることが出発点になります。
| 入力・場面 | 組み合わせる課題の例 | 共有が期待できる手掛かり |
|---|---|---|
| 動物や商品の画像 | 物体の種類判定と位置・画像内の大きさの推定 | 輪郭、形、対象の領域 |
| 車の画像 | 車種判定と損傷の有無の判定 | 車体の形、部品の配置、表面の状態 |
| 走行中の道路画像 | 物体検出と道路領域の識別 | 道路の構造、周囲の物体、境界の位置 |
| 文章 | 翻訳と要約 | 語句の意味、主語と述語の関係、出来事や重要な情報 |
画像認識では、種類判定と位置推定を一緒に学ぶことで、「何があるか」と「どこにあるか」に関わる特徴を共有できます。車種判定と損傷判定なら車体や部品の情報を使えますが、車種の違いには全体の形、損傷には局所的な傷が重要になるなど、必要な情報の細かさが異なる点にも注意が必要です。
物体の認識に、材質や用途の推定を組み合わせることも候補になります。例えば表面の模様が物体の種類と材質の両方に役立つ場面です。ただし、写真から見えない材質の性質や、利用状況によって変わる用途もあります。入力から推定できる範囲を定め、正解ラベルの基準をそろえる必要があります。
自動運転のような道路環境の理解では、歩行者や車を枠で捉える物体検出と、画像の各画素が道路に属するかを判定する領域分割を組み合わせる例が考えられます。ここでは答えの形式や評価方法が異なる課題を共同で学びます。歩行者と信号を検出するだけなら、どちらも同じ物体検出の中のカテゴリである場合があり、対象の種類が違うだけで別タスクになるとは限りません。
自然言語処理では、翻訳と要約の組み合わせが一例です。翻訳は原文の内容を別の言語で表す課題であり、要約は重要な内容を選んで短くまとめる課題です。出力の目的は異なりますが、どちらも「誰が、何を、いつ行うのか」といった文章の内容を捉える必要があります。
例えば「来週の火曜日に新しい図書館が開館し、初日は見学会が開かれます」という文を考えます。英訳の例は「A new library will open next Tuesday, with a tour on opening day.」、短い要約の例は「新図書館が来週火曜に開館」です。これは課題の違いを示す説明用の例で、同じ内容を別の言語へ伝える場合と、中心となる情報を取り出す場合で、求められる答えが変わります。
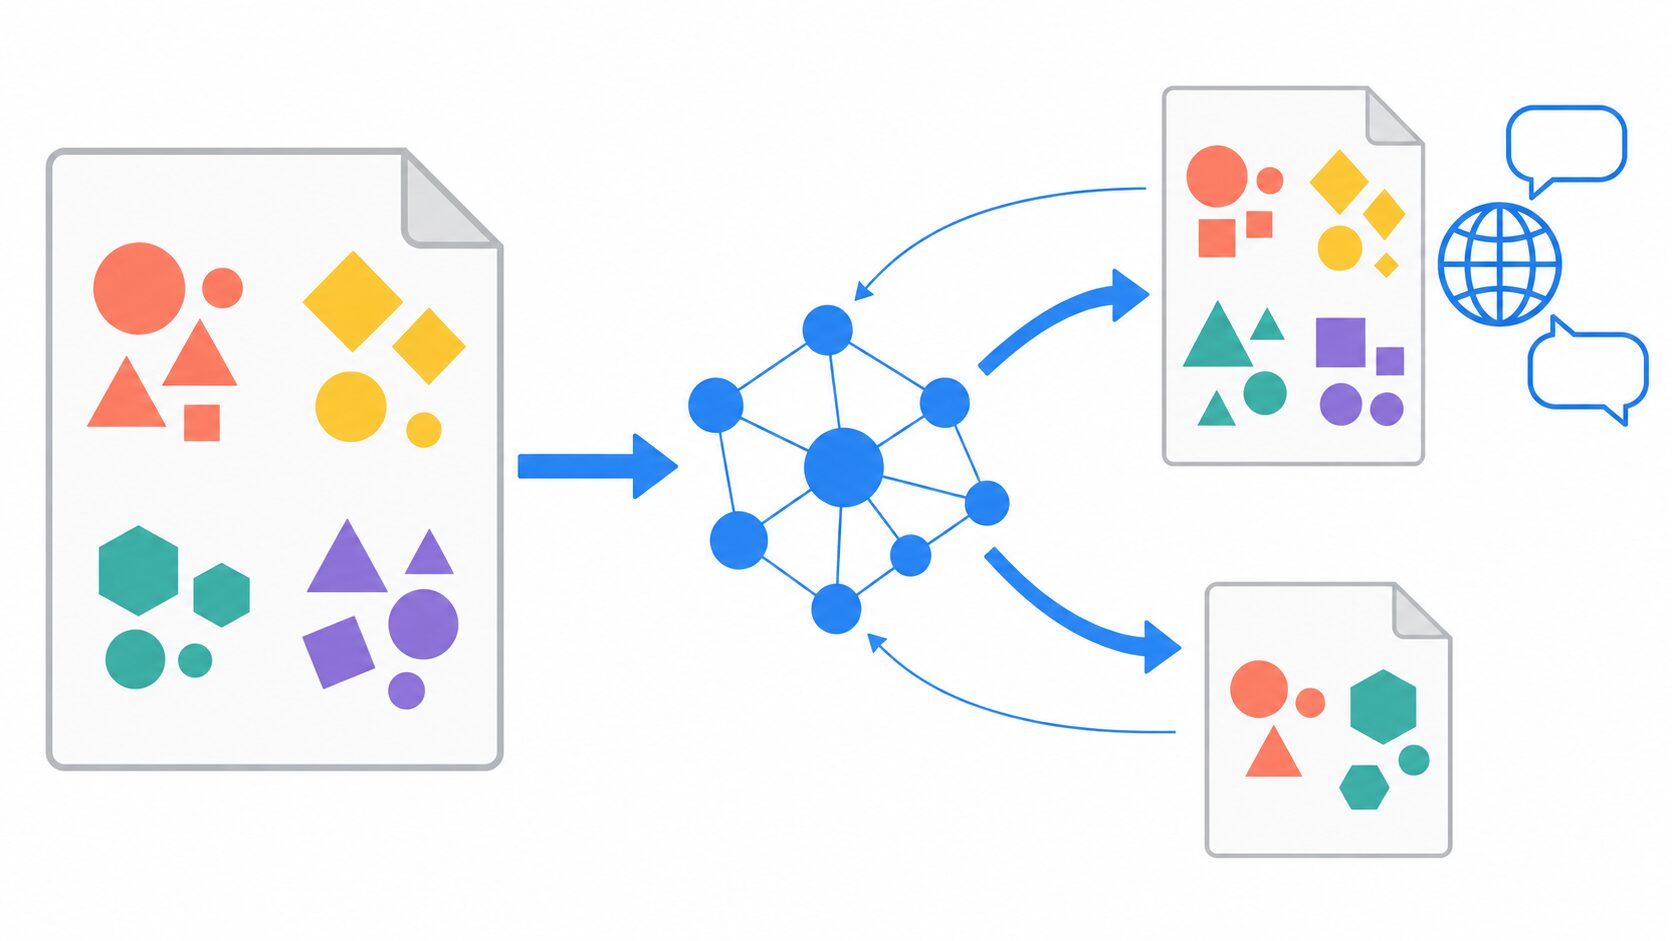
翻訳と要約で文章の内容を表す部分を共有すれば、それぞれの正解データを通じて、その表現を学ぶ手掛かりを増やせる可能性があります。ただし、翻訳だけを学ぶ場合でも文章の意味や構成は学習されます。要約を加えれば必ず意味の理解や翻訳精度が向上する、という関係ではありません。
いずれの例でも、共通の特徴があることと、各課題に適した教師データを用意できることが検討の土台です。利用したい出力を増やす利便性だけでなく、学習を共有することで実際にどの課題が助かるのかを見極めます。
負の転移を防ぐタスク選択と評価
マルチタスク学習では、課題同士が干渉し、単独で学習した場合より性能が悪くなることがあります。このように、共有した知識や学習の影響が不利益になる現象を負の転移と呼びます。まったく無関係な課題だけでなく、一見関連している課題の組み合わせでも起こり得ます。
例えば、車種の判定では小さな表面の変化に左右されない特徴が役立つ一方、損傷の判定ではその小さな変化を捉えることが重要になる場合があります。共有部分に両方の要求を強く押し込めると、一方に有利な調整がもう一方の手掛かりを弱める可能性があります。共有する範囲を減らす、課題別の部分を増やす、補助課題や損失の重みを見直すといった対応が候補です。
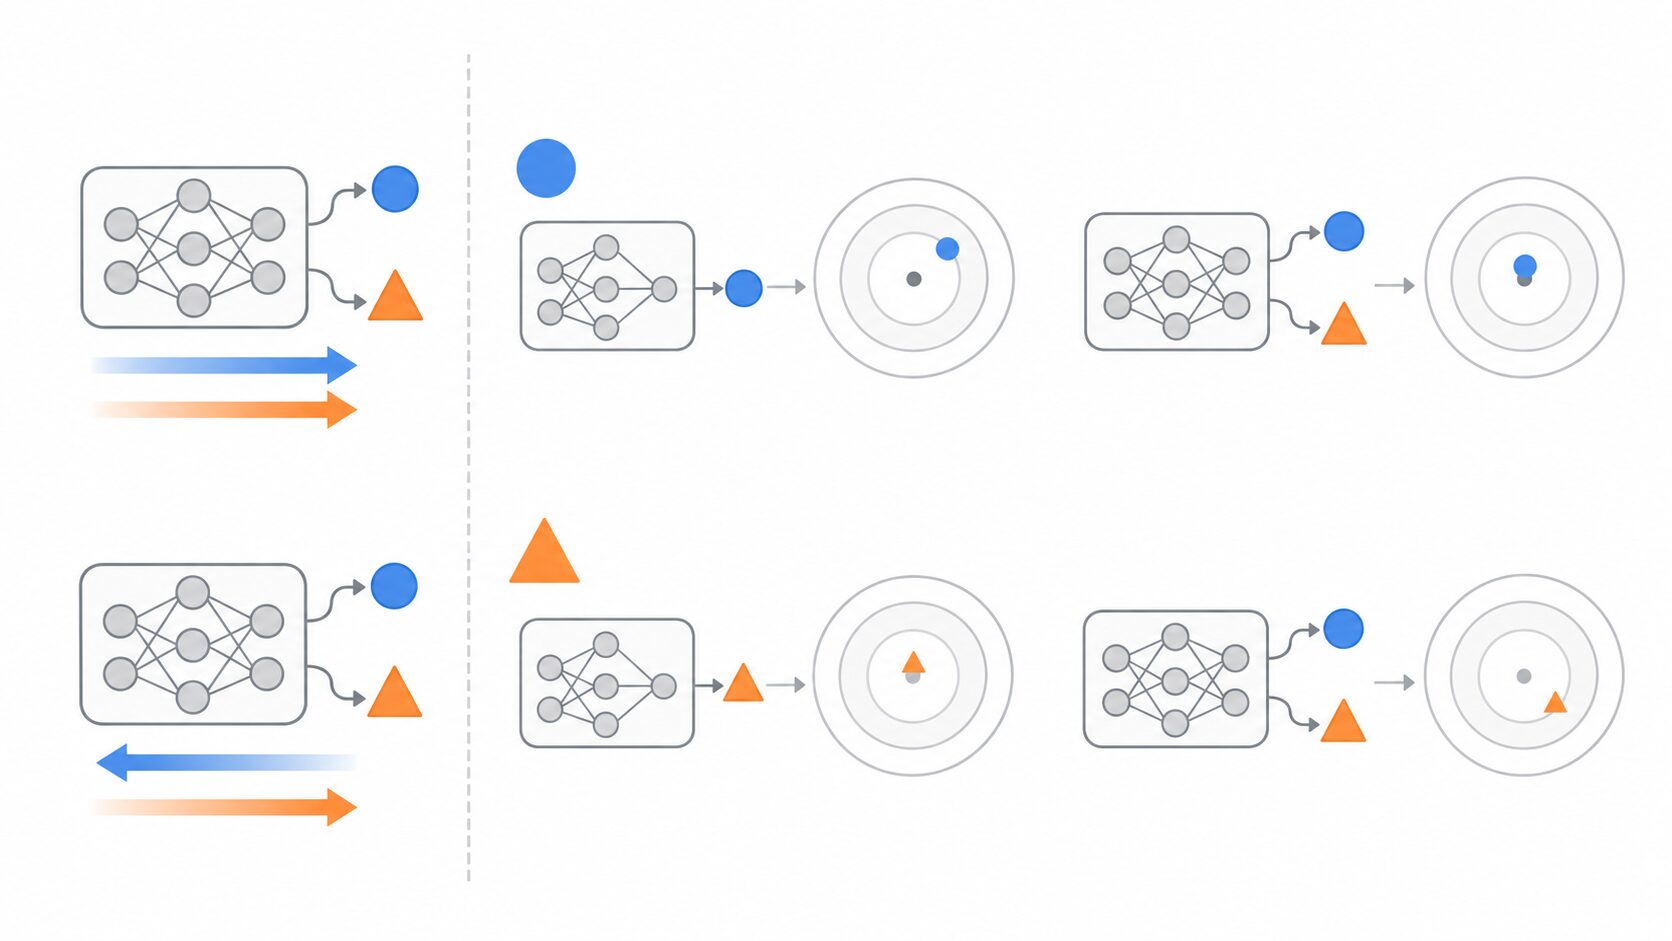
課題の関係だけでなく、データや学習のバランスも確認します。ある課題のデータだけが多ければ、その課題で共有部分を更新する回数が増える場合があります。また、正解ラベルの品質が低い補助課題は、主目的に誤った手掛かりを持ち込む可能性があります。データ量、データを選ぶ頻度、損失の数値の尺度、損失に付ける重みを分けて考えると、偏りの原因を探しやすくなります。
マルチタスク学習における人間の判断は、こうした設計上の選択に関わります。何を主目的とするか、どの課題を補助に使うか、どこまで共有するかは、利用目的や分野の知識に基づいて決めます。ただし、人が関連性を感じることは出発点にすぎず、有効かどうかは評価データで確かめる必要があります。
実務や学習で導入を検討するなら、次の順序で比較すると判断しやすくなります。
- 主目的と評価指標を決める。種類判定なら正解率やF1スコア、位置推定なら予測した範囲と正解の重なり具合など、課題に合った指標を選びます。複数の出力を利用するなら、それぞれに必要な性能を定めます。
- 単一タスクの基準モデルを用意する。主目的の課題を単独で学習し、比較の出発点にします。訓練・検証・テストの分け方をそろえ、モデルの規模や学習の計算量もできるだけ比較可能な条件にします。
- 関連性を説明できる課題を加える。共有できる手掛かりと、正解データの用意しやすさを確認します。最初は課題を絞ると、何が性能に影響したかを追いやすくなります。
- 課題別に改善と悪化を見る。平均的な成績だけで判断せず、主目的や各課題の指標を単独学習と比較します。損失の値が小さくなったことと、実用上の予測性能が改善したことも区別します。
- 補助課題を外した場合も比べる。複数の補助課題を使うなら、一つずつ外して効果を確かめます。性能への寄与と、ラベル作成・学習・調整の負担を合わせて採用を判断します。
評価用のデータを学習や調整に混ぜないことも大切です。同じ対象の似た画像が訓練側と評価側に分かれると、実際よりよく見える場合があります。検証用データで組み合わせや重みを調整し、最後は調整に使っていないテスト用データで確認します。差が小さい場合は、学習の偶然による変動でないかも検討します。
マルチタスク学習を採用する目安は、必要な課題の性能が保たれ、追加の負担に見合う利点が得られることです。共有部分によって処理をまとめられる場合でも、教師データの作成や課題間の調整には手間がかかります。主目的の性能が落ちる、補助課題の正解を十分に用意できない、改善が小さいといった場合は、単一タスク学習を続ける判断も妥当です。
マルチタスク学習の価値は、複数の課題から得た情報を、共通する特徴の学習に生かせる点にあります。課題の組み合わせを選び、未知のデータに対する性能を課題別に確かめることで、精度向上や過学習抑制という期待を、実際の効果として評価できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月4日 | 特徴共有の仕組みと転移学習との違いを補い、負の転移の評価手順を追記 |