
未学習とは?過学習との違い・原因・対策をわかりやすく解説

AIの初心者
「未学習」ってどういう意味ですか?過学習とは、どこが違うのでしょうか。

AI専門家
未学習は、モデルがデータの規則を十分に捉えられず、学習に使った問題もうまく解けない状態だよ。過学習は、学習に使った問題にはよく対応できても、新しい問題には弱い状態なんだ。
AIの初心者
それなら、データを増やしたり、学習する時間を長くしたりすれば、未学習は解消できますか?
AI専門家
それで改善する場合もあるけれど、原因によるんだ。モデルが単純すぎたり、予測に必要な情報が足りなかったりすると、時間やデータを増やすだけでは解決しない。学習の結果を比べて、どこに問題があるか確かめよう。
未学習(underfitting)とは、機械学習モデルがデータに含まれる重要な規則を十分に学べず、訓練データにも適切に当てはまっていない状態です。「学習不足」とも呼ばれます。学習を一度も行っていないという意味ではなく、学習を実行しても必要な予測性能が得られていない状態を指します。
精度が上がらないときは、まず学習に使ったデータと、それとは別に用意した検証データの両方で結果を確認します。この記事では、未学習と過学習の違い、四つの主な原因、学習曲線による見分け方、改善の進め方を順に説明します。
未学習とは:データの規則を十分に捉えられない状態
機械学習では、入力と正解の組み合わせなどから規則を学び、まだ見ていないデータの結果を予測します。学習に使うデータが「訓練データ」です。モデルは、重みや係数といった内部の値であるパラメータを調整し、予測と正解のずれを小さくしていきます。
ただし、どのモデルでもあらゆる関係を表せるわけではありません。曲がった関係を直線でしか表せないモデルに学ばせても、全体をうまく捉えることは難しくなります。また、適切なモデルを選んでいても、パラメータの調整が十分に進む前に学習を終えれば、予測は大きく外れたままです。こうした場合には、訓練データと検証データの両方で性能が低いという未学習の典型的な傾向が現れます。
例えば、犬と猫の画像を分類するモデルを考えましょう。耳の形や顔の輪郭など、判別に役立つ特徴をうまく利用できず、学習に使った画像でも誤判定が多いなら、未学習を疑う手がかりになります。新しい画像でも間違いが多ければ、入力の作り方やモデルの表現力、学習の進み具合を調べる必要があります。
一方、背景色だけを手がかりに分類していることは、それだけで未学習を意味しません。背景色が偏った訓練データでは高い成績を出し、背景の異なる画像で失敗するなら、見かけの手がかりへの依存やデータの偏りが問題になっている可能性があります。どんな特徴に頼っているかに加え、どのデータで失敗するかを確認することが大切です。
目指すのは、学習した画像をすべて覚えることではありません。未知のデータにも対応できる能力を「汎化性能」と呼びます。未学習の診断は、この汎化性能を高めるために、まず訓練データから必要な規則を学べているか確かめる作業です。
過学習との違いを訓練・検証誤差で比較
未学習と過学習を見分けるには、データの役割を分けます。訓練データはパラメータを学ぶために使い、検証データはモデルの種類や学習条件などの設定を評価するために使います。検証データの正解を学習に混ぜると、未知のデータに対応できているかを判断しにくくなります。
ここでは、予測と正解のずれを「誤差」と呼び、小さいほどよい指標として比較します。回帰で使う平均絶対誤差などがその例です。分類では誤分類率などを使えますが、どの指標でも訓練用と検証用で同じ計算方法を使うことが前提です。
| 状態 | 訓練誤差 | 検証誤差 | 読み取れること |
|---|---|---|---|
| 未学習 | 高い | 高い | 訓練データの規則を十分に捉えられていない可能性がある |
| 良好な適合 | 十分に低い | 十分に低い | 学習した規則が検証データにも役立っている |
| 過学習 | 低い | 訓練誤差より高く、性能が不十分 | 訓練データに合わせすぎて、未知のデータに対応しにくい |
この表は典型的な傾向です。「高い」「低い」を決める共通の数値基準はなく、課題の難しさや業務で必要な性能に照らして判断します。訓練誤差と検証誤差の差が小さくても、両方が高ければ良好なモデルとはいえません。反対に、少し差があるだけで過学習と断定することもできません。
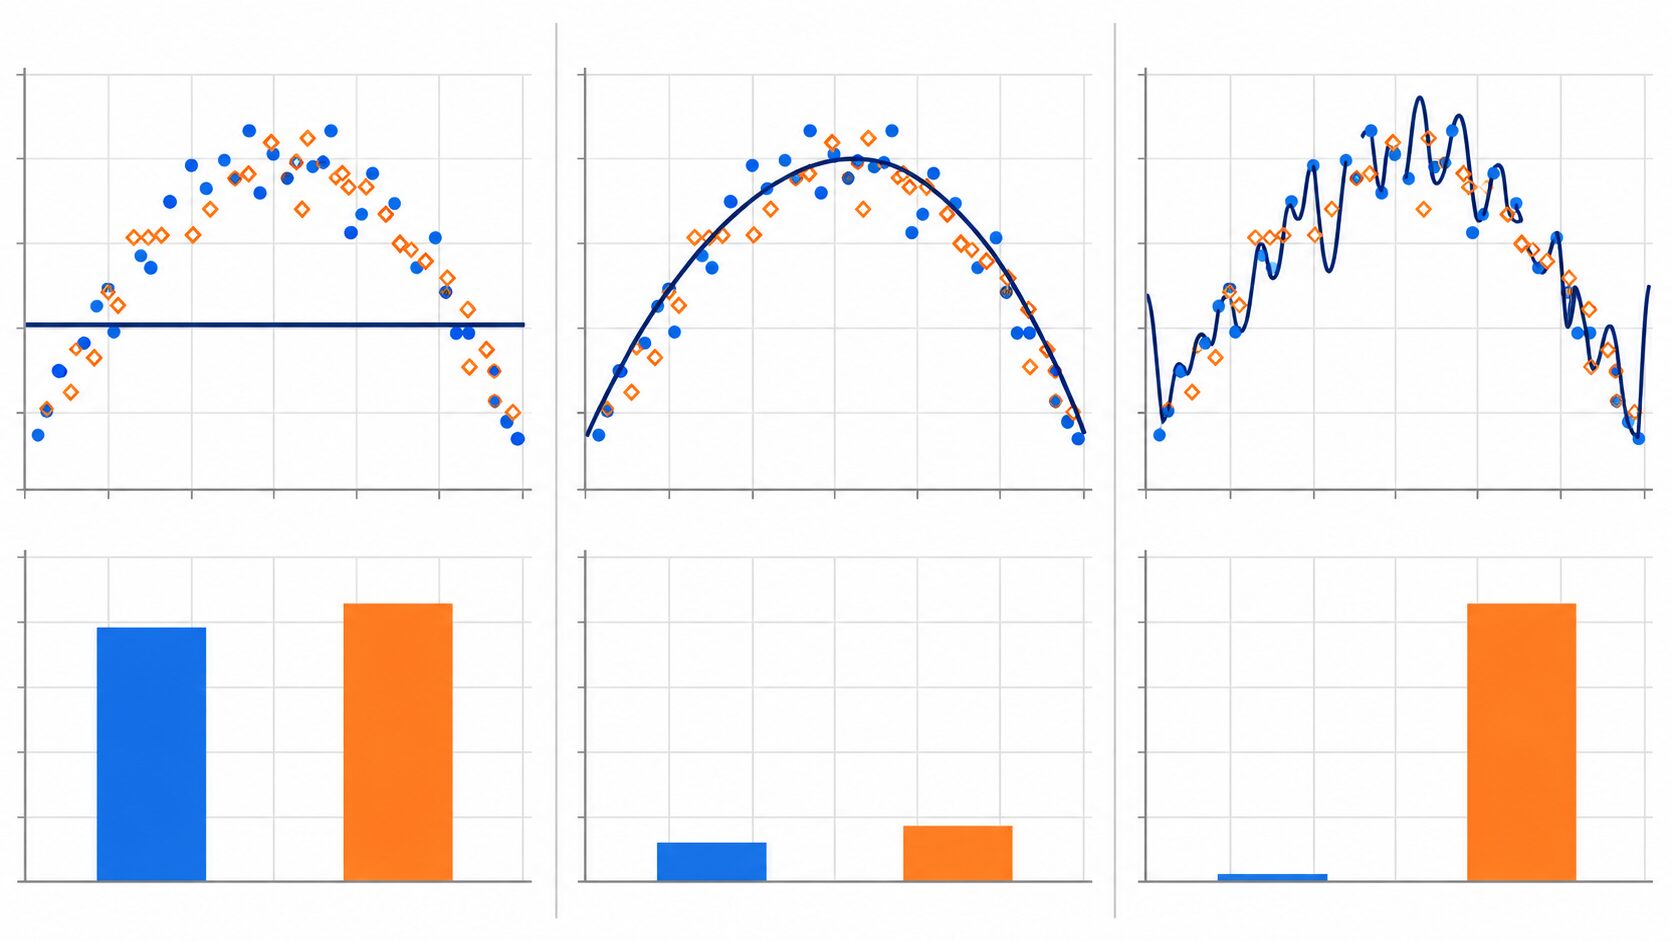
「練習問題の答えを丸暗記し、初めての問題では点数を取れない」というたとえは、過学習に対応します。未学習は、練習問題そのものも十分に解けない状態に近いと考えると、違いを捉えやすくなります。
過学習は、単純に学習時間が長いことや、データの量が多いことを意味しません。訓練データ固有の細かな揺らぎやノイズまで拾い、未知のデータでは役立たない規則に適合することが問題です。学習を長く続けた結果、過学習が進む場合はありますが、時間やデータ量だけで状態を判断しないようにしましょう。
未学習が起こる四つの原因
同じ「訓練誤差が高い」という結果でも、原因によって有効な対策は異なります。まずは、モデルが表せる関係、入力情報、学習の進め方、学習への制約という四つの観点に分けて確認します。
-
モデルの表現力が足りない
表現力とは、モデルがどれくらい多様な関係や複雑なパターンを表せるかという能力です。曲線的な関係に直線しか当てはめられないモデルや、細かな条件分岐が必要な課題に極端に浅い決定木を使うと、重要な規則を取り逃がすことがあります。
このような強い仮定による系統的な予測のずれは「バイアス」と呼ばれ、単純すぎるモデルによる未学習は高バイアスの典型例です。ここでいうバイアスは、社会的な偏見という意味ではありません。モデルの仮定とデータの性質が合っていないために生じる、予測の偏りを指します。
-
必要な特徴量が足りない
特徴量とは、予測の材料としてモデルへ渡す情報です。例えば住宅価格を床面積だけで予測すると、立地や築年数による価格差を説明しきれません。入力に必要な情報がなければ、モデルを大きくするだけでその不足を埋めることはできません。
元の項目がそろっていても、変化の割合や項目同士の組み合わせが重要な場合があります。使うモデルによっては、そうした関係を特徴量として明示すると学習しやすくなります。ただし、予測時点で入手できない情報を使ってはいけません。
-
パラメータの最適化が十分に進んでいない
反復しながらパラメータを更新する学習方法では、反復回数が少なすぎると、誤差を下げられる余地が残ったまま終了します。更新の一歩の大きさを決める「学習率」が小さすぎれば進み方が遅く、大きすぎれば誤差が振動したり増えたりすることがあります。
十分に学習が進んで落ち着くことを「収束」と呼びます。まだ収束していない状態と、十分に調整してもモデルの表現力が足りない状態は区別しましょう。前者では学習条件の変更が有効でも、後者では同じ学習を延長するだけでは限界があります。
-
正則化が強すぎる
正則化は、係数の大きさなどに制約をかけ、訓練データへの過剰な適合を抑える仕組みです。過学習対策として役立ちますが、強くかけすぎると、予測に必要な関係まで表しにくくなることがあります。
例えば係数を強く小さくする設定では、入力が変わっても予測値があまり変わらず、本来あるはずの変化を捉え損ねます。モデルの構造だけでなく、実際にどの程度の自由度で学習できる設定になっているかも確認が必要です。
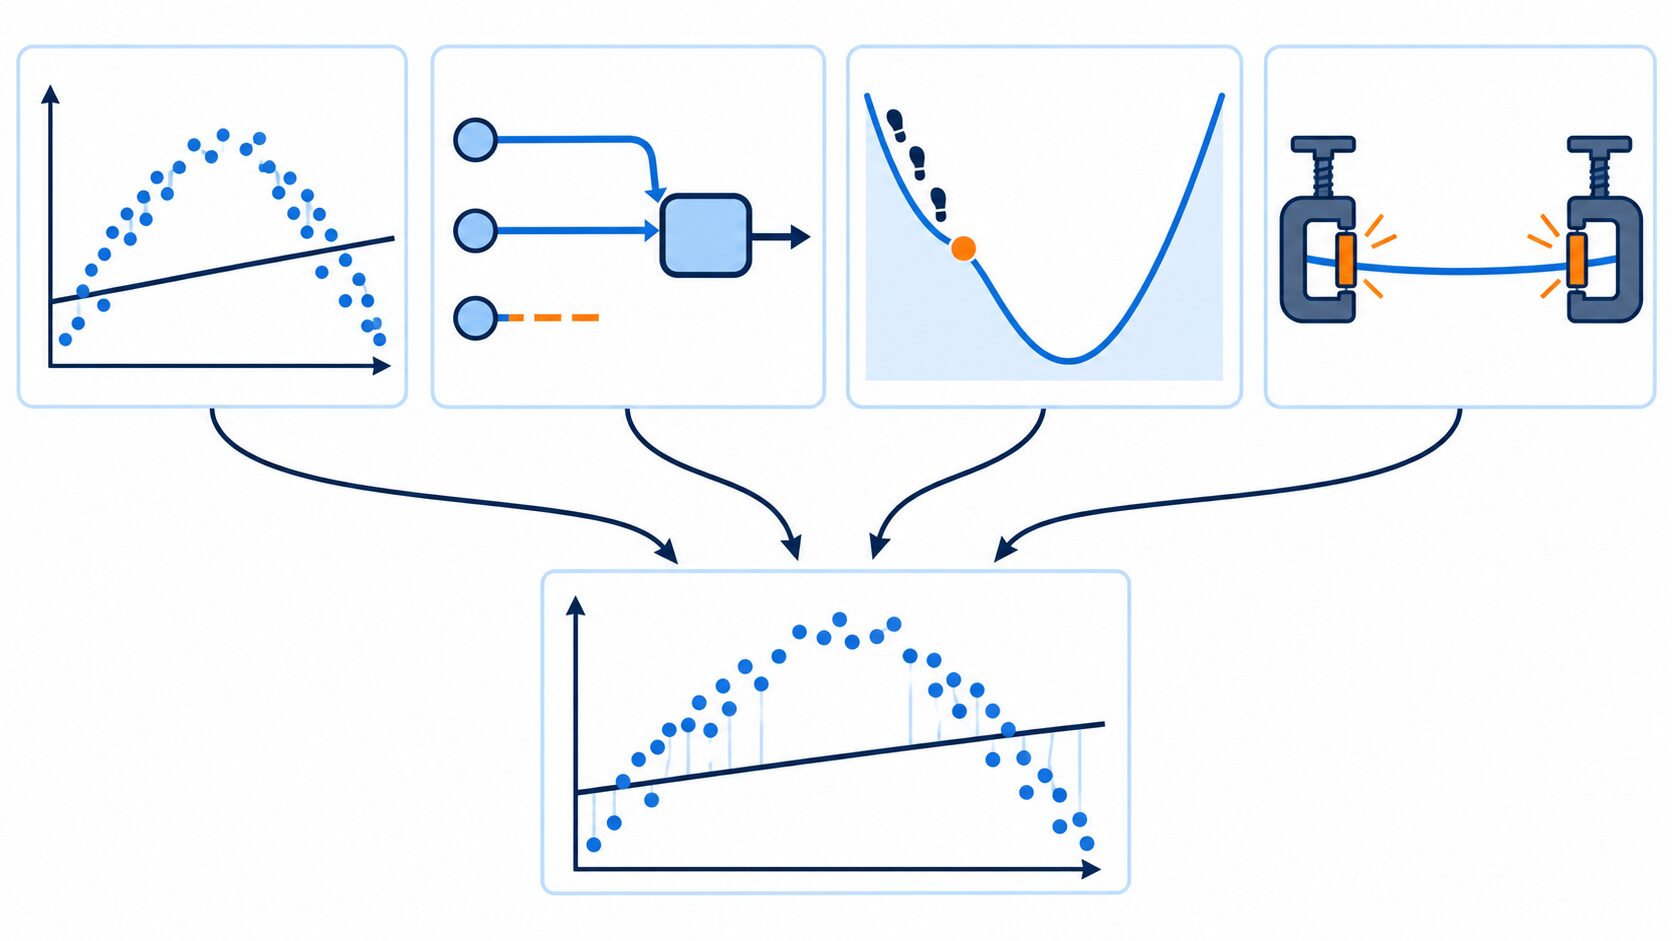
複雑なモデルは常に良いわけではありませんが、「複雑すぎるから未学習になる」と一律には説明できません。複雑なモデルでも最適化が進まなければ訓練誤差は高くなります。その場合は、モデルの大きさそのものより、学習が進まない理由を調べます。
学習曲線から未学習の兆候を見分ける
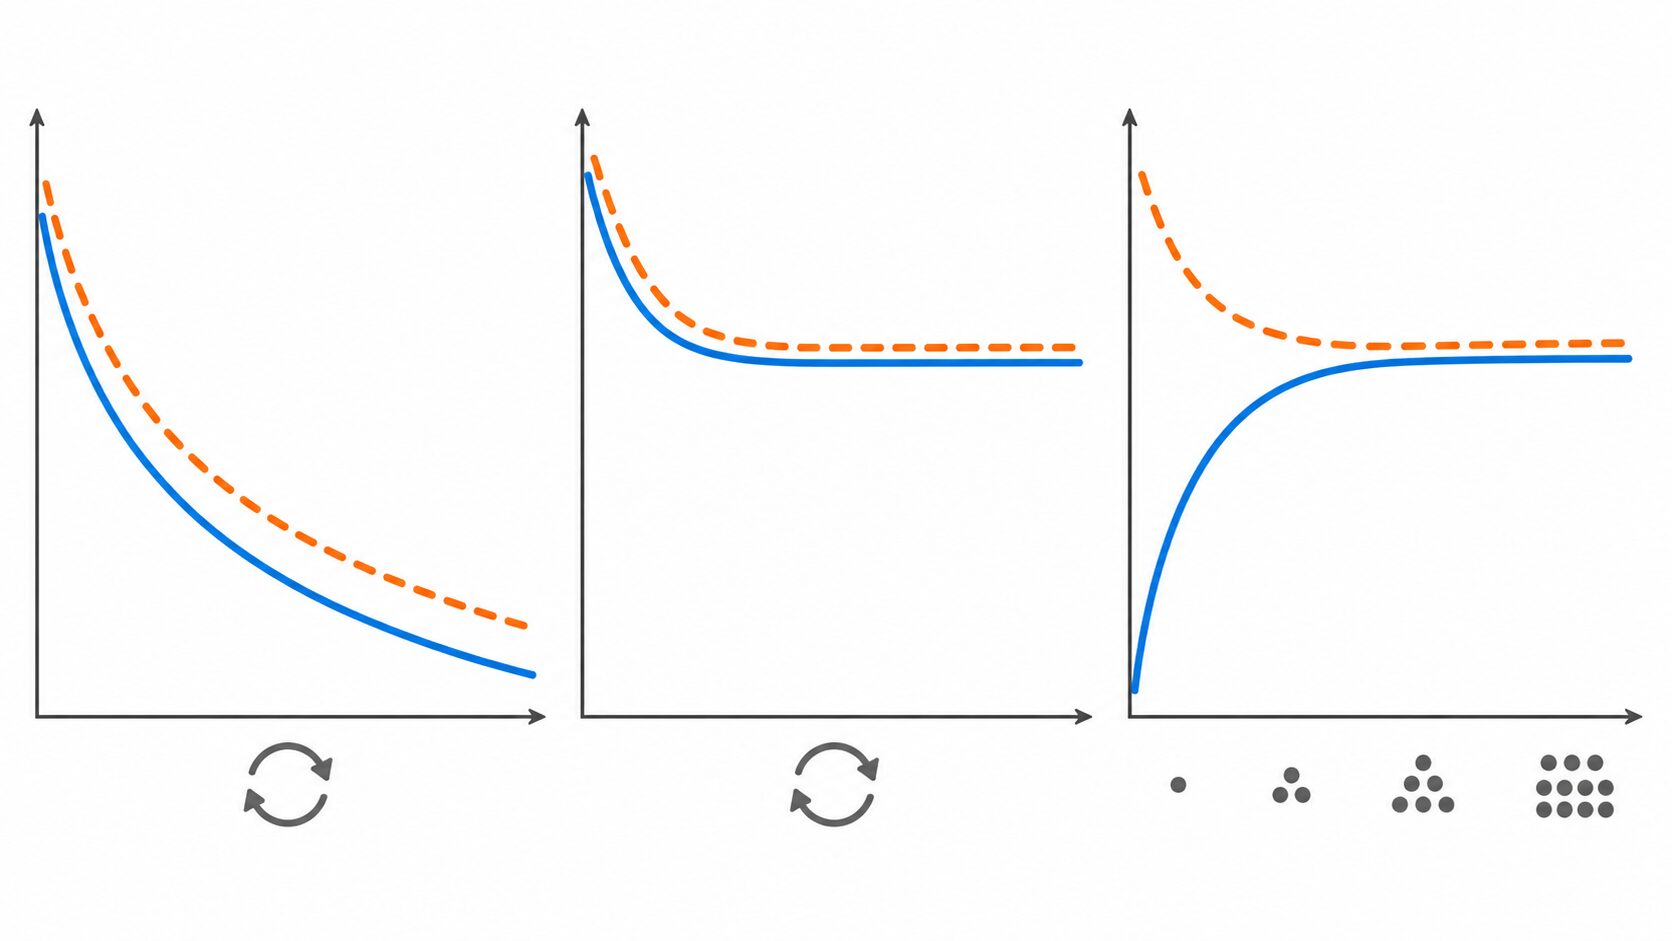
学習曲線は、学習条件の変化とモデルの性能の関係を表すグラフです。よく使うのは、横軸を「学習の反復回数」にしたものと、「訓練データ数」にしたものです。同じ呼び名でも示す内容が異なるため、まず横軸と縦軸を確認します。ここでも縦軸は、小さいほどよい誤差として説明します。
横軸が反復回数の場合は、同じ訓練データで学習を進めたときの変化を追います。訓練誤差と検証誤差がまだ下がっているなら、学習を続けることで改善する可能性があります。反対に、両方が高いままほとんど変化しなければ、表現力や特徴量、正則化の強さを点検します。学習率が適切でなく、最適化が停滞している可能性もあるため、曲線だけで原因を一つに絞らないことが大切です。
訓練誤差が下がり続ける一方で検証誤差が上がり始めた場合は、過学習を疑う手がかりになります。検証誤差の小さな上下には偶然の変動も含まれるため、一時点だけでなく全体の傾向を見ます。検証性能が改善しなくなったところで学習を止める「早期終了」も選択肢です。
横軸が訓練データ数の場合は、同じモデルと設定を用い、学習に使うデータの件数を変えて比べます。各条件で十分に学習させ、同じ検証データで評価すると、件数の影響を読み取りやすくなります。データを増やしても両方の誤差が高い水準で近づき、そのまま停滞するなら、高バイアスを疑います。学べる規則がモデルの表現範囲を超えている場合、同じ種類のデータを追加するだけでは大きな改善を期待できません。
ただし、性能が低いことだけで未学習と断定しないでください。予測に使える情報がもともと乏しい、正解ラベルに誤りが多い、観測値に大きなノイズがある、といった事情でも誤差は高くなります。訓練時と検証時で対象の地域や期間が大きく違えば、分布の違いが性能低下を招くこともあります。
比較の出発点になるのが「ベースライン」です。例えば回帰なら訓練データの目的変数の平均値を常に予測する方法、分類なら最も多いクラスを常に選ぶ方法が、単純な基準になります。二つのクラスの件数が大きく偏っている場合は、正解率が高くても少数のクラスをまったく見つけられないことがあります。見逃しが重要なら再現率も確認するなど、目的に合う指標で基準を上回れているかを見ましょう。
具体例で考える未学習への対策
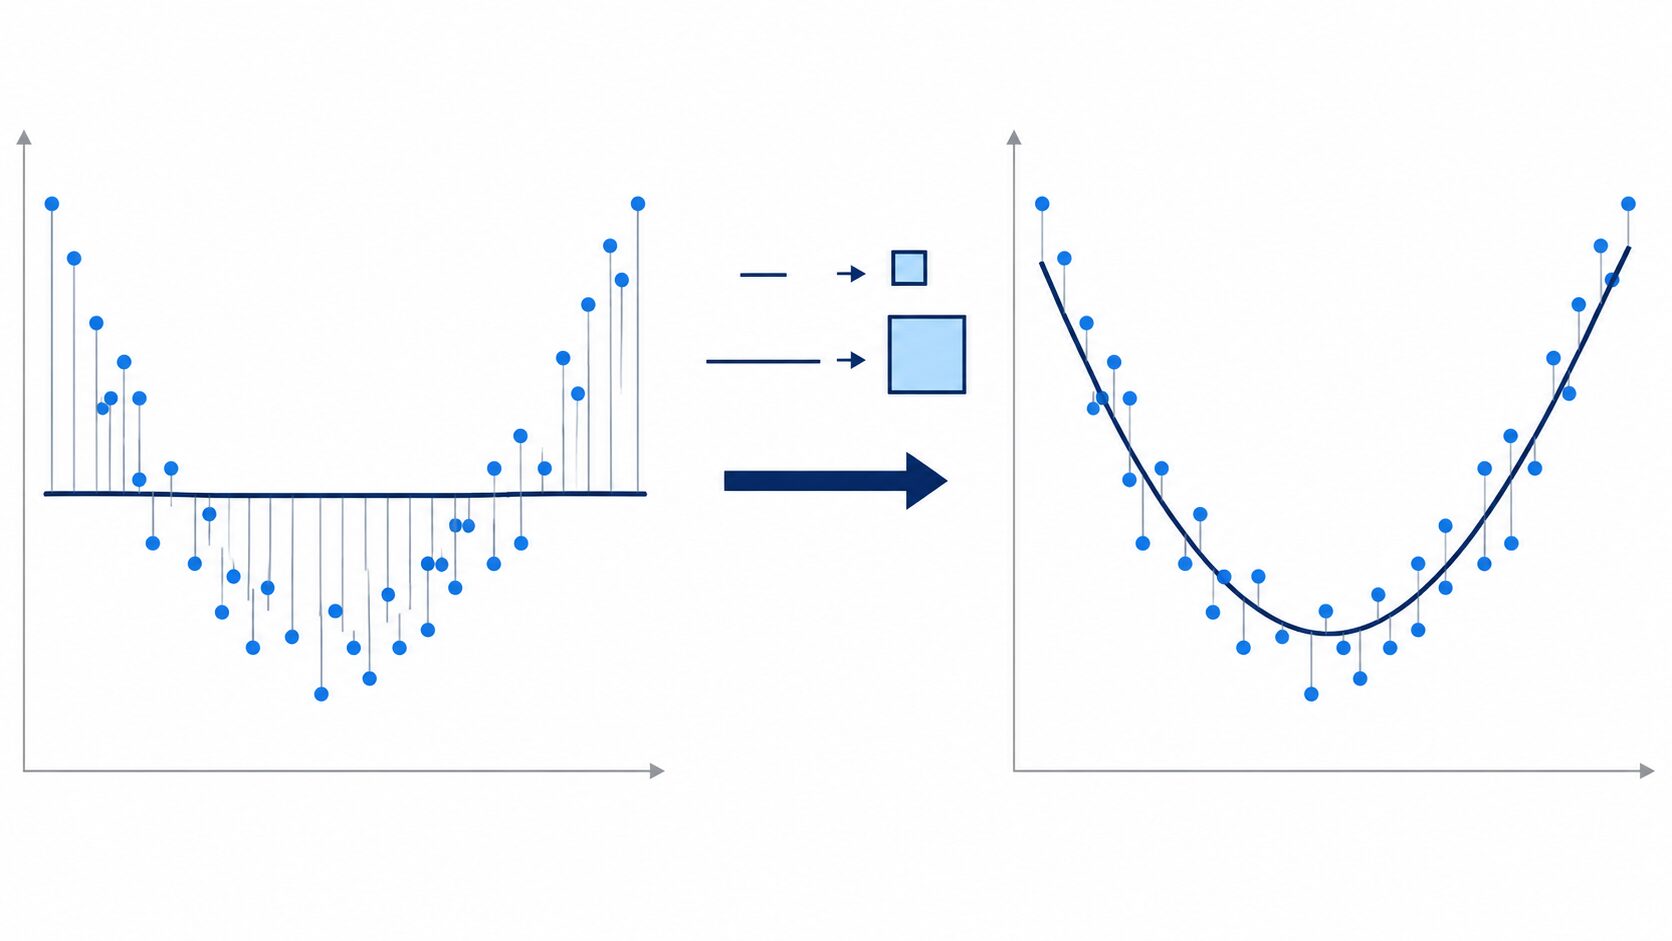
未学習への対策を、U字状に点が並ぶ架空のデータで考えます。入力が中央付近なら目的の値は小さく、中央から左右に離れるほど値が大きくなる関係を想定してください。ここで直線回帰を使うと、上向きか下向きの一本の直線、あるいはほぼ水平な直線で近似することになります。
この直線を十分に調整しても、左右の端で値が大きくなる形を同時には表せません。反復回数を増やしても直線が曲線に変わることはないため、学習時間の延長だけでは解決しない例です。
そこで、入力値を二乗した値を特徴量に追加すると、U字の形を表せるようになります。元の入力と二乗した入力の係数を学ぶことで、直線だけでは捉えられなかった関係を近似できます。特徴量の変換に加え、非線形な関係を扱える別のモデルを選ぶ方法もあります。これは仕組みを示す説明であり、特定の実験で得た精度や改善率を示すものではありません。
実際の課題では、次のように原因の仮説と変更する設定を対応させます。複数の原因が重なっている場合もありますが、一度に多くを変えるより、小さく変更して結果を比べたほうが次の判断に役立ちます。
| 疑う原因 | 試す対策 | 確認する点 |
|---|---|---|
| 表現力不足 | モデルを変更する、決定木を深くする、ニューラルネットワークの層数やユニット数を調整する | 訓練誤差だけでなく検証誤差も下がるか |
| 特徴量不足 | 必要な項目を追加する、二乗や比率、項目の組み合わせを作る | 追加情報が予測時にも使え、検証性能の改善に役立つか |
| 最適化不足 | 反復回数や学習率を調整する、入力の尺度をそろえる | 誤差が安定して減少し、十分に学習が進むか |
| 強すぎる正則化 | 正則化の強度を段階的に弱める | 検証性能が改善するか、過学習が進んでいないか |
入力の尺度をそろえる標準化などは、学習方法によって最適化を助けます。ただし、前処理の手順にも注意が必要です。平均やばらつきの計算、欠損値の補完値の決定などは訓練データで行い、その結果を検証データに適用します。データから学ぶ特徴量変換も同様です。検証データを含めて処理の設定を決めると、本来使えない情報が流れ込む「情報漏洩」が起こり、評価が実態より良く見えることがあります。
また、正則化を一律に外したり、精度が下がるという理由だけで扱いにくいデータを削除したりする方法は避けましょう。正則化には過学習を抑える役割があり、難しいデータも実際の利用場面を表している可能性があります。入力や正解の誤りを調べ、修正や除外に理由があるか確認してから対処します。
未学習を防ぐ評価と調整の進め方
未学習という考え方が役立つのは、モデル開発や精度改善で「次に何を変えるべきか」を判断するときです。最初から最適な設定を当てる必要はありません。評価の条件を整え、原因を確かめながら改善を積み重ねます。
- データと目的を把握する。何を予測し、どの程度の誤差まで許容できるかを決めます。件数、欠損、ラベルの品質、クラスの偏り、対象の期間や分布も確認します。
- 分割方法とベースラインを決める。訓練用・設定調整用の検証・最終評価用のテストに役割を分けます。同じ対象の重複が分割をまたがないようにするなど、実際の利用条件に合う分け方を選びます。
- 訓練誤差と検証誤差を比較する。両方が高いのか、訓練だけ良いのかを見ます。学習曲線や、特定の条件で間違いやすいかも調べ、原因の仮説を立てます。
- 仮説に対応する設定を変更する。モデル、特徴量、反復回数、学習率、正則化などを、原因を追える単位で調整します。分割と評価指標をそろえ、変更前後を比較します。
- 検証結果で設定を選び、最後にテストする。検証性能が目的に近づいたら設定を確定し、調整に使っていないテストデータで最終評価します。
一回の分割で差が小さい場合は、偶然に評価しやすいデータが選ばれた可能性もあります。データを複数の組に分け、訓練と検証の担当を入れ替えて評価する「交差検証」は、分割による結果のばらつきを確認する方法です。この場合も、前処理は各回の訓練部分だけで学習します。
分割はデータの性質に合わせます。例えば未来の売上を予測する時系列データでは、過去で学習し、後の期間で検証するなど、時間順を保った評価が基本になります。無作為に混ぜると、実際の予測時には利用できない未来の情報が評価に入り込むおそれがあります。
テストデータは、最後に未知のデータへの対応力を確認するためのものです。その結果を見ながら何度も設定を調整すると、テストデータも実質的に設定選びに使ったことになります。改善のための検証と、最終評価の役割を分けておきましょう。
データが少ないときに単純なモデルから始めるのは有用ですが、「少量データなら必ず単純なモデル」「データ不足なら必ず未学習」とは限りません。少ないデータへの過学習が問題になることもあります。目標は訓練誤差をゼロにすることではなく、目的に必要な検証性能と汎化性能を得ることです。誤差の現れ方から原因を絞り、必要な変更を選ぶことが、未学習への着実な対処につながります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年10月31日 | 過学習との混同を修正し、学習曲線の読み方と原因別の対策を追記 |