
隠れマルコフモデル(HMM)とは?音声認識の仕組みを初心者向けに解説

AIの初心者
「隠れマルコフモデル」は、何が隠れているモデルなのですか?

AI専門家
直接見えない状態です。音声認識なら、マイクで観測できる音の特徴から、その背後にある音素や音響状態の並びを確率的に推定します。
AIの初心者
聞こえた波形と、推定したい音の状態を分けて考えるのですね。どうやって候補を選ぶのでしょうか?
AI専門家
状態が次へ移る確率と、その状態から音声特徴が現れる確率を組み合わせ、入力全体に最も合う状態の並びを探します。
隠れマルコフモデルとは。
時系列データの背後にある、直接観測できない状態の移り変わりを確率で表すモデルです。音声認識では、波形から取り出した特徴を手掛かりに、発音された音の状態を推定するために使われてきました。
隠れマルコフモデル(Hidden Markov Model、HMM)は、音声認識を学ぶときに頻繁に登場する確率モデルです。名前は難しそうですが、考え方の中心は「見えるデータから、見えない状態の並びを推定する」ことにあります。
この記事では、マルコフモデルとの違い、HMMを構成する確率、音声から単語を選ぶ流れ、利点と限界を順に説明します。なお、HMMは長く音声認識の中心技術でしたが、現在の大規模な音声認識では深層学習によるend-to-end方式が主流です。歴史的な役割と現在の位置付けを分けて理解することが大切です。
隠れマルコフモデル(HMM)とは
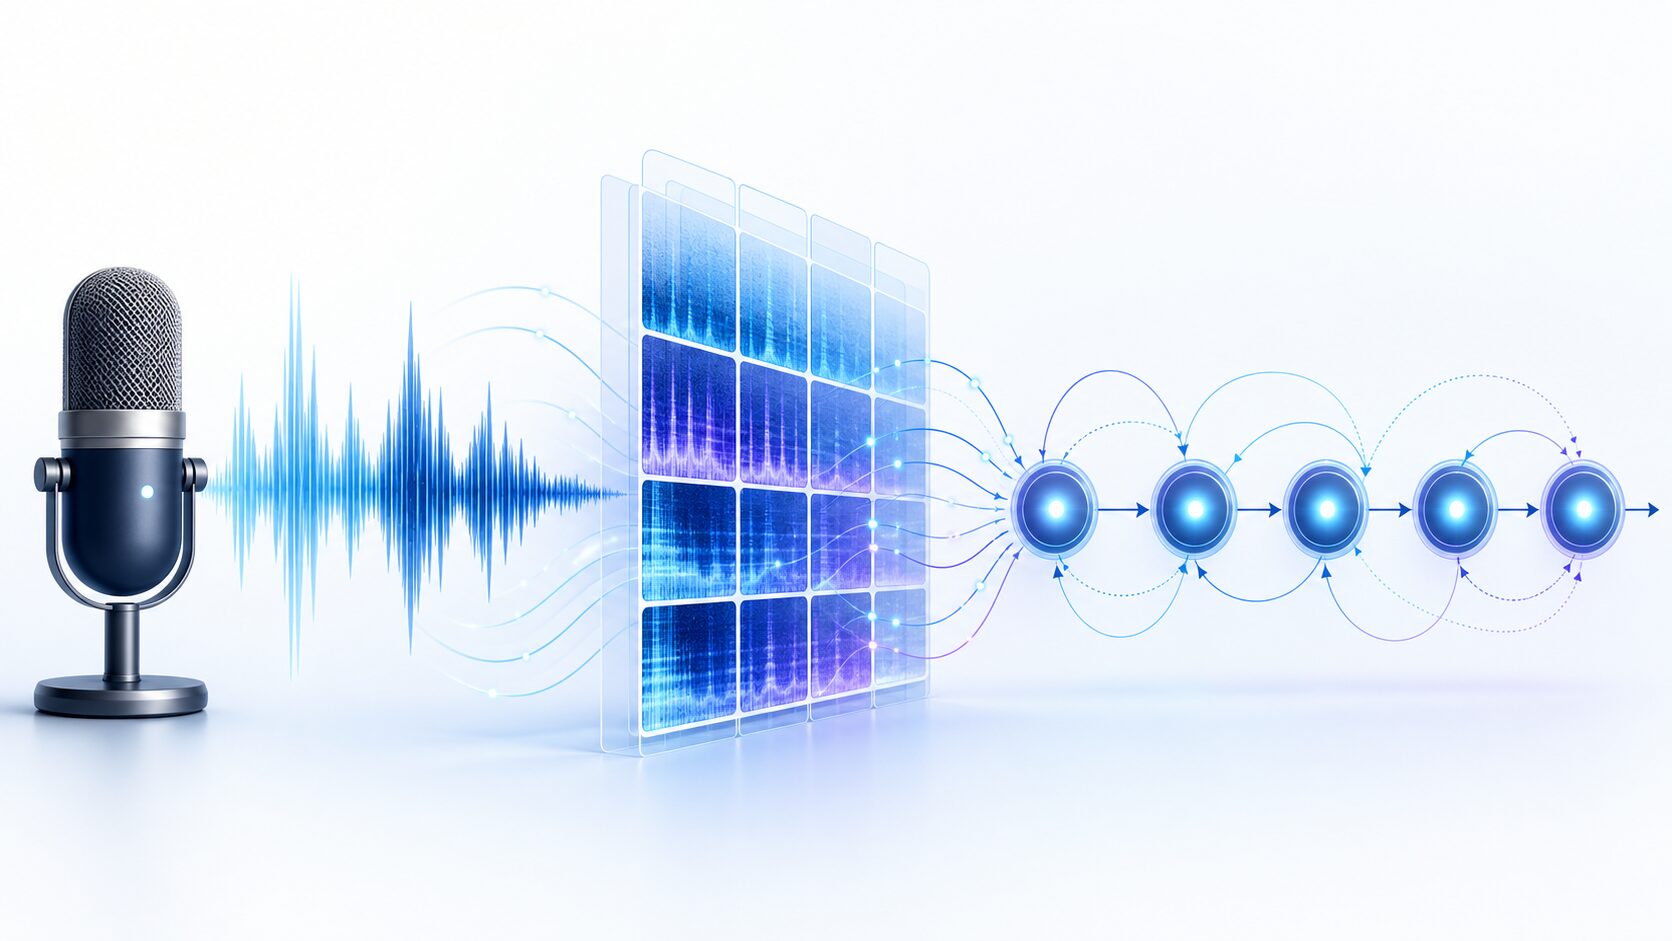
HMMは、時間とともに変わる隠れ状態と、そこから確率的に生じる観測データの関係を表します。音声認識で観測できるのは、マイクが捉えた波形そのもの、または波形から抽出した周波数成分などの音響特徴です。一方、モデルが推定したい音素や、その内部を細かく分けた音響状態は直接見えません。
たとえば「こんにちは」という発話は、話す速さ、声質、周囲の騒音によって毎回異なる波形になります。それでも、対応する音の状態は一定の順序で進みやすく、それぞれの状態から現れやすい音響特徴にも傾向があります。HMMはこの二つの傾向を確率として学び、入力に最もよく合う状態列を探します。
ここでいう「隠れ状態」は、話者の頭の中の意味や単語そのものに限りません。音声認識のHMMでは、一般に音素や音素を分割した音響状態など、設計者がモデル内に置いた状態を指します。この区別を押さえると、「何が隠れているのか」が明確になります。
マルコフモデルと隠れマルコフモデルの違い
マルコフモデルは、次の状態が現在の状態によって決まると考える確率モデルです。一次のマルコフ性は、状態を \(q_t\) とすると、次のように表せます。
\(P(q_t \mid q_{t-1}, q_{t-2}, \ldots)=P(q_t \mid q_{t-1})\)つまり、遠い過去をすべて参照せず、直前の状態に情報をまとめたと仮定します。これは現実の現象が本当に過去を忘れるという意味ではなく、計算可能なモデルにするための近似です。
通常のマルコフ連鎖では状態を直接観測できると考えます。天気を「晴れ・曇り・雨」と記録する例なら、今日の状態は見えています。HMMでは状態が見えず、各時点の観測値 \(o_t\) だけが得られます。見えない状態列と観測列を確率で結び、背後の状態を推定する点が違いです。
| 比較項目 | マルコフモデル | 隠れマルコフモデル |
|---|---|---|
| 状態 | 直接観測できる | 直接観測できない |
| 手掛かり | 状態の履歴 | 状態から生じた観測データ |
| 音声認識の例 | 音の状態が既知という設定 | 音響特徴から音の状態を推定 |
HMMを構成する3つの確率
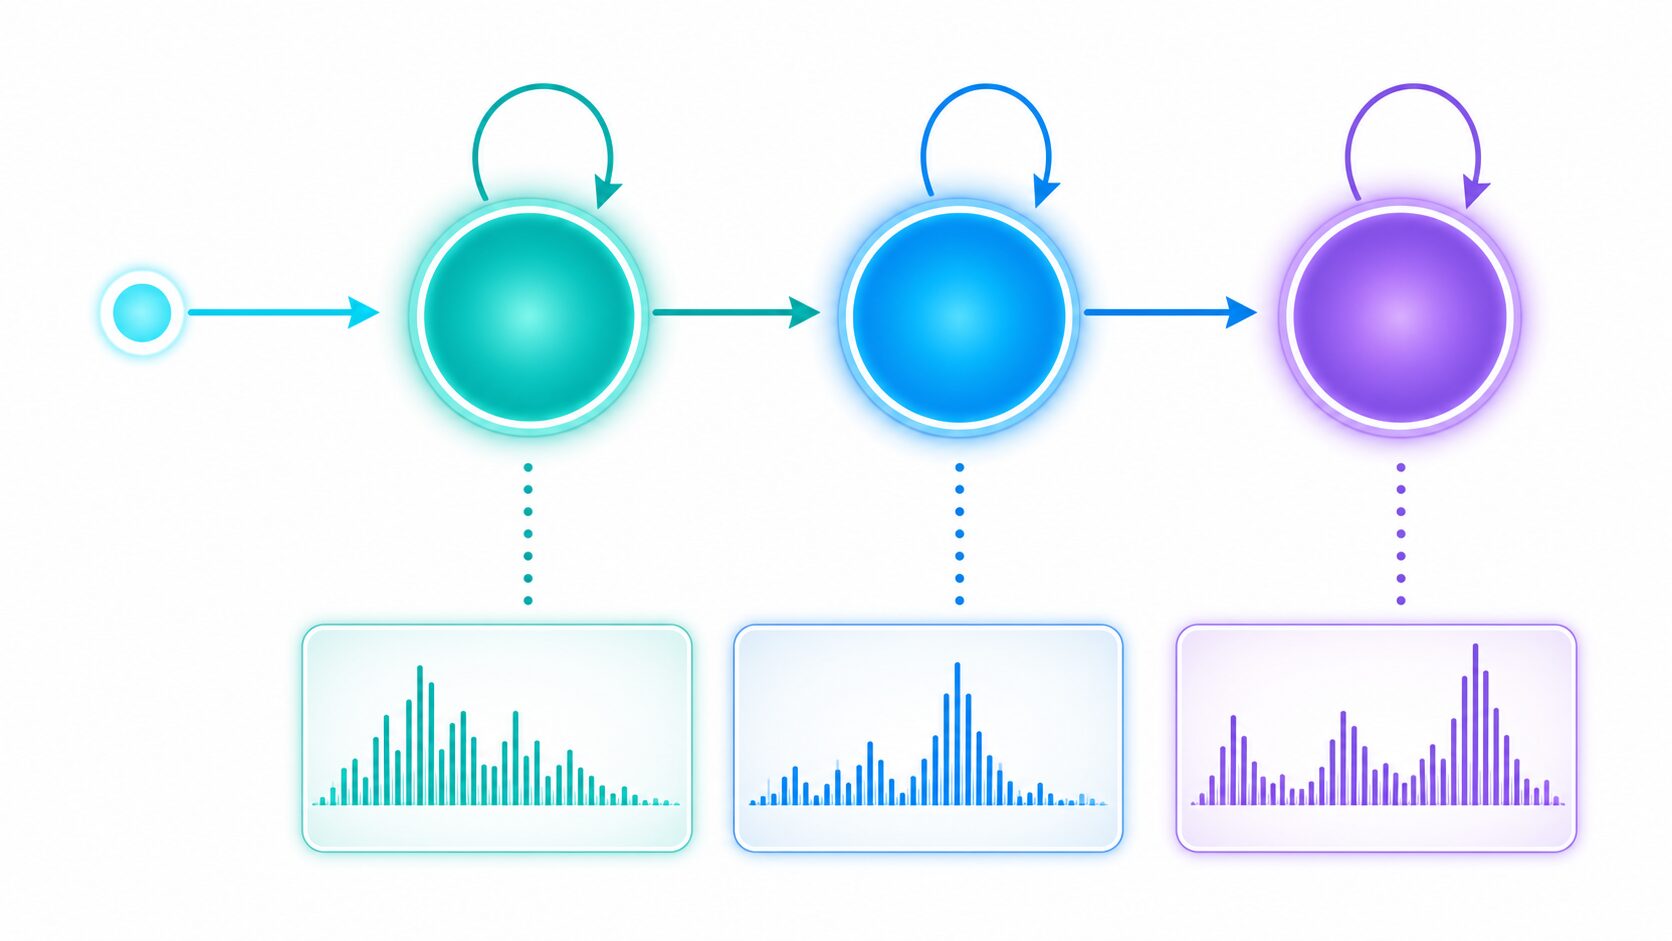
基本的なHMMは、次の3種類の確率で表せます。
- 初期確率:最初に各状態から始まる確率 \(\pi_i=P(q_1=i)\)
- 遷移確率:状態 \(i\) から状態 \(j\) へ移る確率 \(a_{ij}=P(q_t=j\mid q_{t-1}=i)\)
- 出力確率:状態 \(j\) から観測値 \(o_t\) が生じる確率 \(b_j(o_t)=P(o_t\mid q_t=j)\)
音声認識なら、遷移確率は音の状態がどの順番で続きやすいかを、出力確率は各状態でどのような音響特徴が現れやすいかを表します。連続値の音響特徴には、かつてガウス混合モデル(GMM)が広く使われ、後にはニューラルネットワークで状態の確率を推定するDNN-HMM方式も普及しました。
状態列 \(Q=(q_1,\ldots,q_T)\) と観測列 \(O=(o_1,\ldots,o_T)\) の組み合わせの尤もらしさを評価し、多数の候補から入力全体に合うものを選ぶのがHMMの基本です。
音声認識で言葉を推定する流れ
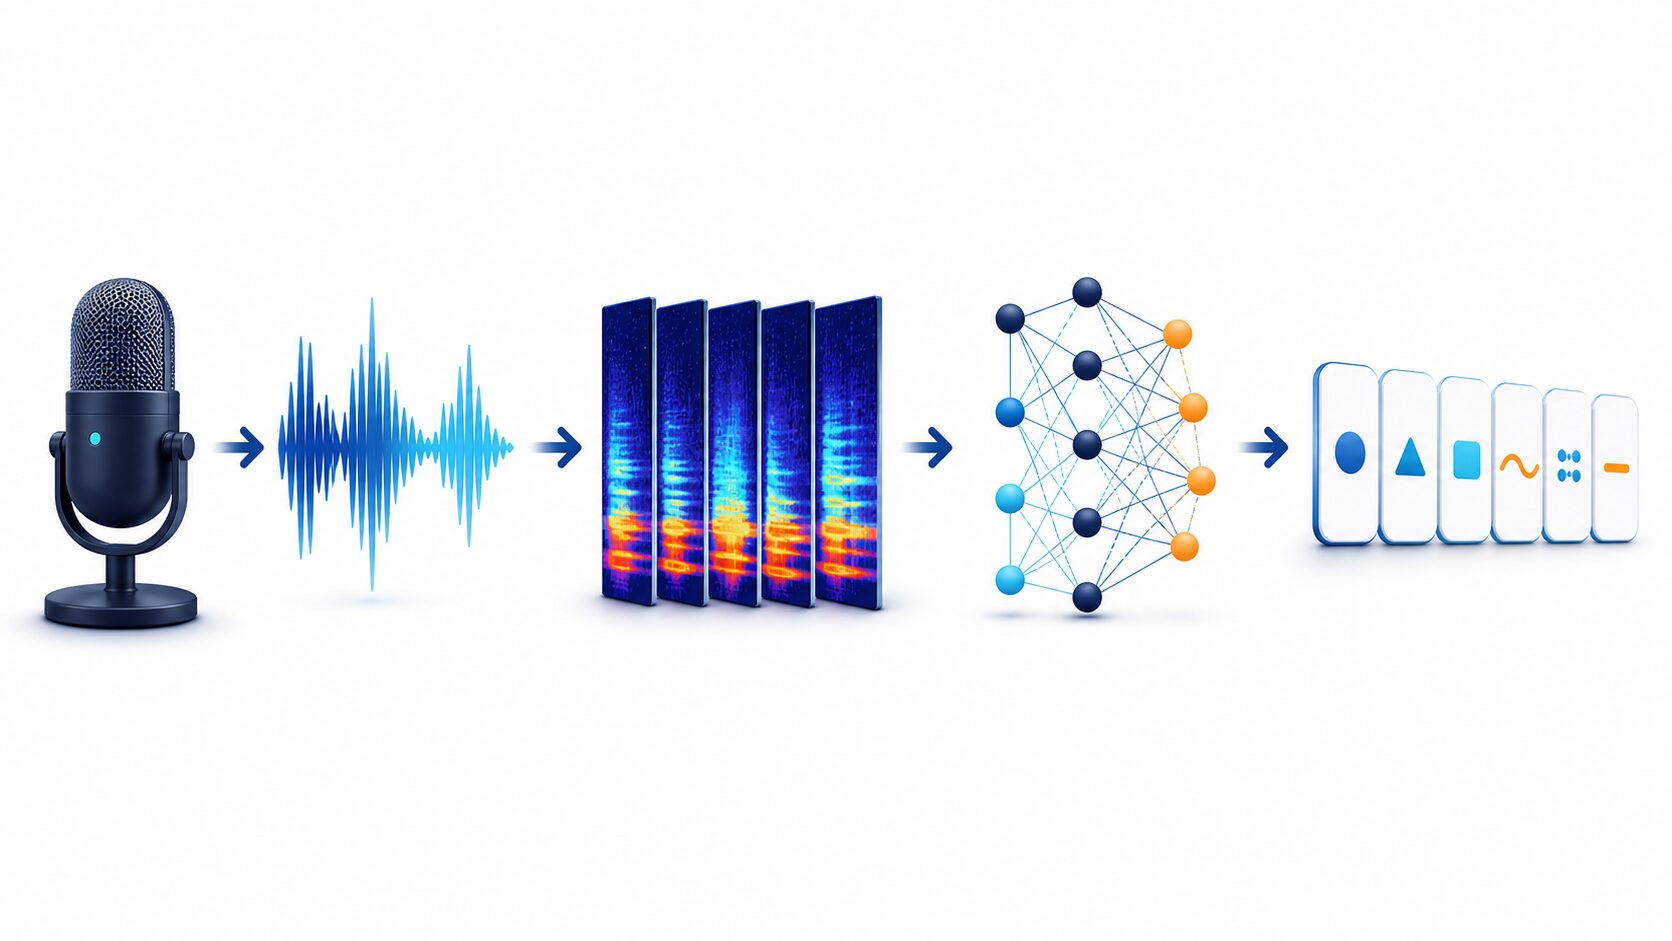
- 音声を短い区間に分ける:連続した波形を数十ミリ秒程度の短いフレームとして扱います。
- 音響特徴を抽出する:周波数分布などを要約し、MFCCなどの特徴量へ変換します。
- 音響的な尤もらしさを計算する:各フレームがどのHMM状態から出た可能性が高いかを評価します。
- 発音と単語の候補をつなぐ:発音辞書で音素列と単語を対応付け、言語モデルで自然な単語の並びを評価します。
- 最良の経路を選ぶ:ビタビアルゴリズムなどで、全体として確率が高い状態列・単語列を効率よく探索します。
HMMだけが波形をそのまま文章へ変えるわけではありません。実用的な従来型システムは、音響モデル・発音辞書・言語モデル・探索器を組み合わせます。「こんにちは」と「今日は」のように音が近い候補は、前後の単語や文としての自然さも利用して判別します。
また、HMMが雑音を直接「除去する」と考えるのは正確ではありません。雑音を含むデータで学習したり、前処理や頑健な特徴量を組み合わせたりすることで、ばらつきのある観測に対して候補の確率を比較します。
左から右型が音声に向く理由
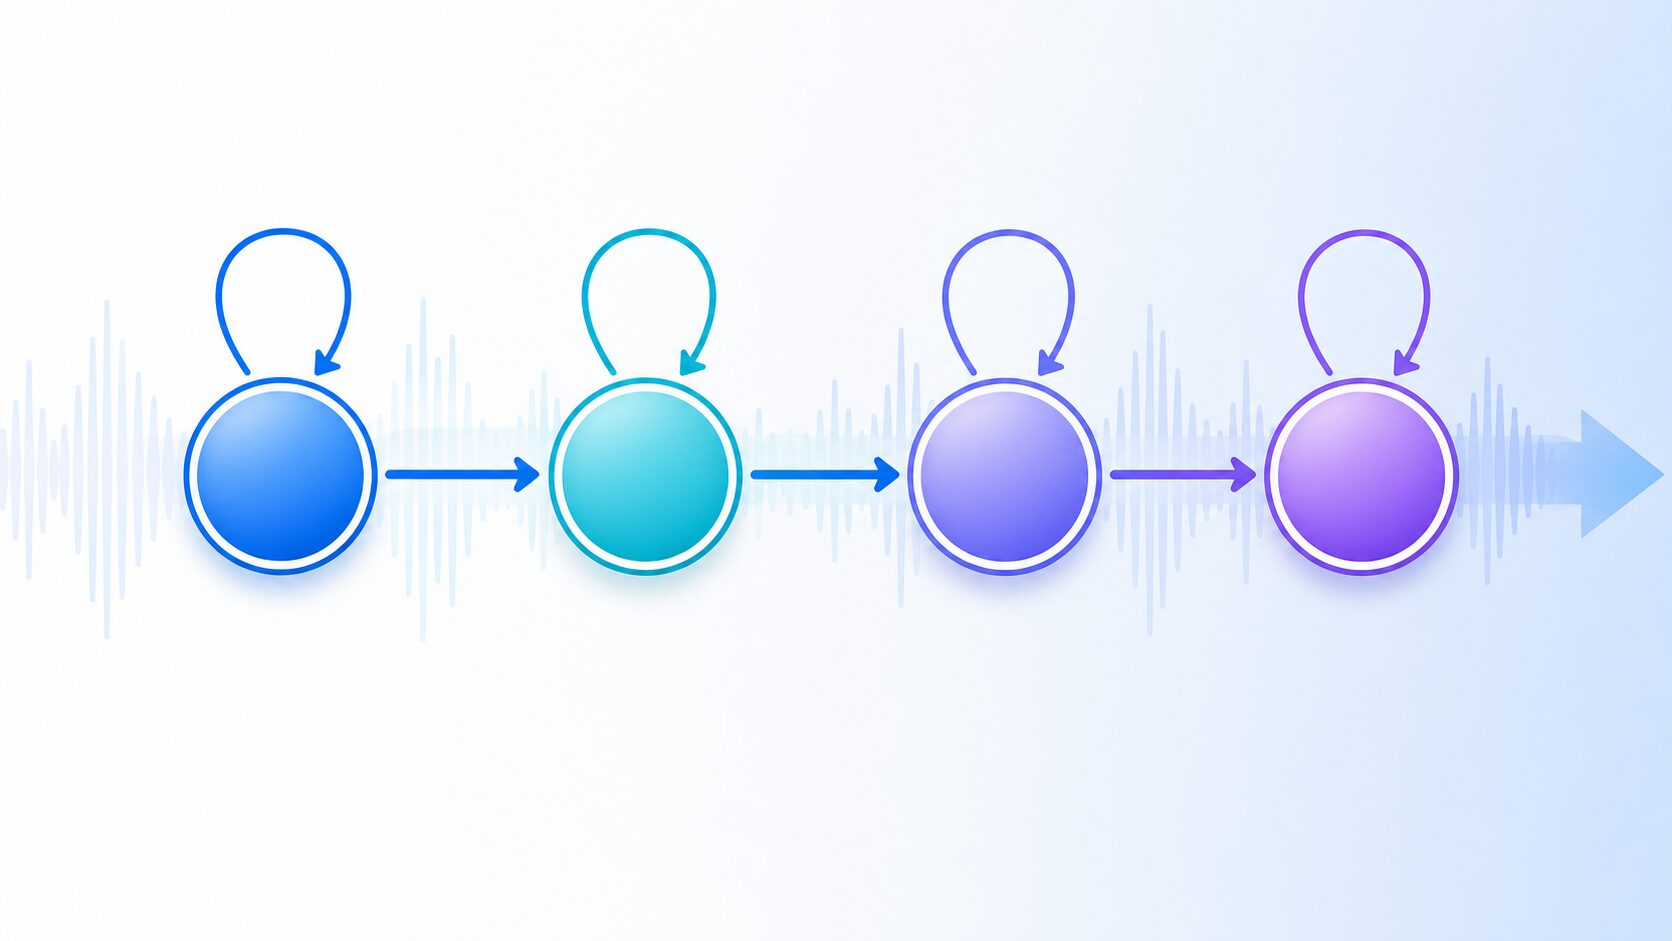
音声認識では、状態が前へ戻らず、同じ状態にとどまるか次の状態へ進む左から右型HMMがよく使われてきました。発音は時間の順に進むため、この構造が音の始まり・中間・終わりを表しやすいからです。
同じ状態への自己遷移を許すと、ある音を長く発音した場合はその状態に長くとどまり、短く発音した場合は早く次へ進めます。これにより、話す速度が違っても同じ発音として扱いやすくなります。
ただし、すべてのHMMが左から右型ではありません。用途によっては任意の状態間を行き来するエルゴード型も使われます。左から右型は、音声の時間方向という制約をモデルへ組み込んだ代表的な設計です。
音素単位で学習する利点
単語を丸ごと一つのモデルとして覚えると、語彙が増えるたびに多数のモデルが必要です。音素や音響状態を部品として学習すれば、それらを組み合わせて多くの単語を表現できます。積み木の共通部品を再利用するような考え方です。
実際には、同じ音素でも前後の音によって響きが変わります。そのため、前後の文脈を考慮したtriphoneなどの文脈依存音素が利用されます。似た状態の学習データを共有する仕組みも、限られたデータで安定した確率を得るために重要です。
なお、「音素を学習すれば未知語を自動的に認識できる」とは限りません。新しい単語の読みを発音辞書へ追加し、探索語彙や言語モデルでも扱えるようにする必要があります。音素単位のモデルは拡張を容易にしますが、システム全体の設定は別途必要です。
学習と推定で使われる代表的な手法
HMMには、目的の異なる代表的な計算方法があります。混同しやすいため、何を求める手法なのかで整理しましょう。
| 手法 | 主な目的 | 概要 |
|---|---|---|
| 前向きアルゴリズム | 観測列の確率を計算 | 時点ごとの候補をまとめながら全経路の確率を効率よく足し合わせる |
| Baum–Welch法 | パラメータを学習 | 前向き・後ろ向き計算を使うEMアルゴリズムの一種 |
| Viterbiアルゴリズム | 最尤状態列を推定 | 各時点で最良候補を記録し、最後に最も尤もらしい経路を復元する |
音声認識の「どの音の並びだったか」を求める場面ではViterbiが理解しやすい代表例です。一方、学習では正解ラベルの有無やシステム構成に応じて手順が変わります。HMMは、学習と推定を分けて考えると全体像をつかみやすくなります。
HMMの利点・限界と深層学習との違い
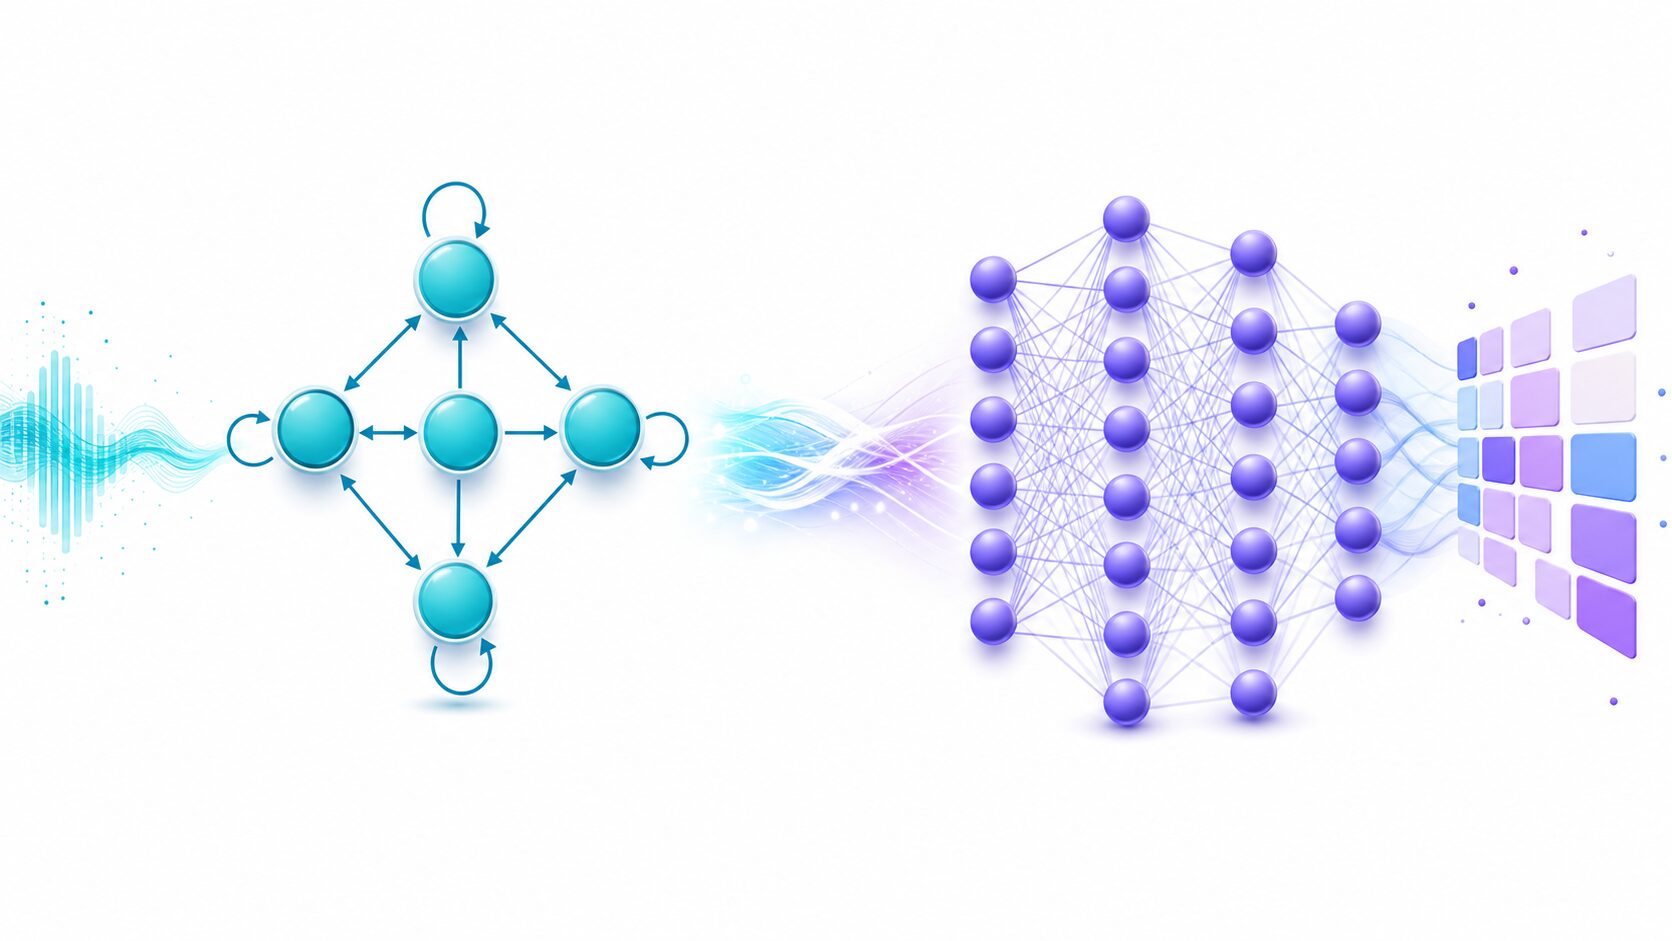
HMMの利点は、時間方向の構造と確率の役割が明確で、動的計画法により効率よく計算できることです。状態や遷移を設計できるため、現象についての知識を組み込みやすく、比較的小規模な問題でも扱いやすい場合があります。
一方、直前の状態だけを見るマルコフ性や、現在の状態が決まれば観測が他から独立になるという仮定は、複雑な音声を単純化しています。特徴量、発音辞書、状態設計など複数の部品を個別に整える必要もありました。
その後、出力確率の推定に深層ニューラルネットワークを使うDNN-HMMが高い性能を示しました。さらに現在は、CTC、RNN Transducer、attention系のencoder-decoderなど、音声特徴から文字・サブワード列までを一体で学ぶend-to-end方式が主流です。これらは長い文脈や複雑な音響パターンを学びやすい反面、多くのデータと計算資源を必要とし、判断過程を説明しにくい場合があります。
| 観点 | 従来型HMMシステム | end-to-end深層学習 |
|---|---|---|
| 構成 | 音響モデル・辞書・言語モデルなどを分割 | 入力から出力までを一体で最適化 |
| 時間表現 | 状態遷移を明示的に設計 | ニューラルネットワークが表現を学習 |
| 理解しやすさ | 確率と状態の役割を追いやすい | 内部表現の解釈が難しい場合がある |
| 現在の位置付け | 基礎学習、既存システム、条件の限られた用途 | 大規模な最新音声認識の中心 |
音声認識以外の活用例
HMMは、観測できる時系列の背後に状態がある問題へ応用できます。自然言語処理では単語列から品詞を推定する古典的手法、生物情報学ではDNAやタンパク質配列のパターン推定、設備監視ではセンサー値から正常・劣化・故障といった状態を推定する例があります。
天気や市場データにも適用はできますが、モデルの仮定が現象に合うかを確認しなければなりません。特に株価のように外部要因が多く構造が変化しやすい対象では、HMMを使うだけで高精度に予測できるわけではありません。状態の意味、データ量、評価方法を決めることが先です。
まとめ
隠れマルコフモデルは、観測列から直接見えない状態列を確率的に推定するモデルです。音声認識では、音響特徴が現れる確率と音の状態が移る確率を組み合わせ、最も尤もらしい発音や単語の並びを探索してきました。
観測・隠れ状態・遷移確率・出力確率の4語を結び付けることが、HMM理解の近道です。現在の大規模音声認識は深層学習中心ですが、時系列推定、確率モデル、Viterbi探索の基礎を学ぶうえでHMMは今も重要なモデルです。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年2月1日 | 初回公開 |
| 2026年7月25日 | 3つの確率と認識手順を補い、深層学習との役割の違いを追記 |