
Contextual Retrievalとは?文書の断片に文脈を補うRAG改善手法

AIの初心者
資料には売上の数字があるのに、AIに会社名と年度を指定して質問すると見つかりません。なぜですか?

AI専門家
検索用に資料を小さく分けた結果、数字のある断片から会社名や年度が離れてしまった可能性があります。
AIの初心者
その断片が何の資料のどの部分なのか、検索にも伝える必要があるのですね。
AI専門家
はい。元の資料から分かる文脈を短く補い、検索の手掛かりにするのがContextual Retrievalです。補足の正確さも大切になります。
Contextual Retrievalとは。
Contextual Retrievalは、文書を分割した各断片に、その文書内での位置づけを説明する短い文脈を付けて検索する手法です。2024年にAnthropicが公開しました。会社名、対象期間、章の主題など、分割によって失われやすい情報を補い、外部資料を検索して回答に使うRAGの検索精度改善を目指します。
ポイントは、検索する前に断片と元文書のつながりを明らかにしておくことです。まず文脈が失われる理由を確認し、処理の流れ、具体例、ほかの検索手法との違い、導入時の判断へ進みます。
Contextual Retrievalが補う「失われた文脈」
RAGでは、質問に関係する資料を探し、その内容を大規模言語モデル(LLM)へ渡して回答を作ります。長い文書を検索しやすい大きさに分けた単位が、チャンクです。必要な箇所だけを取り出せる一方、どこで分けるかによって文章の意味を支える情報が切り離されます。
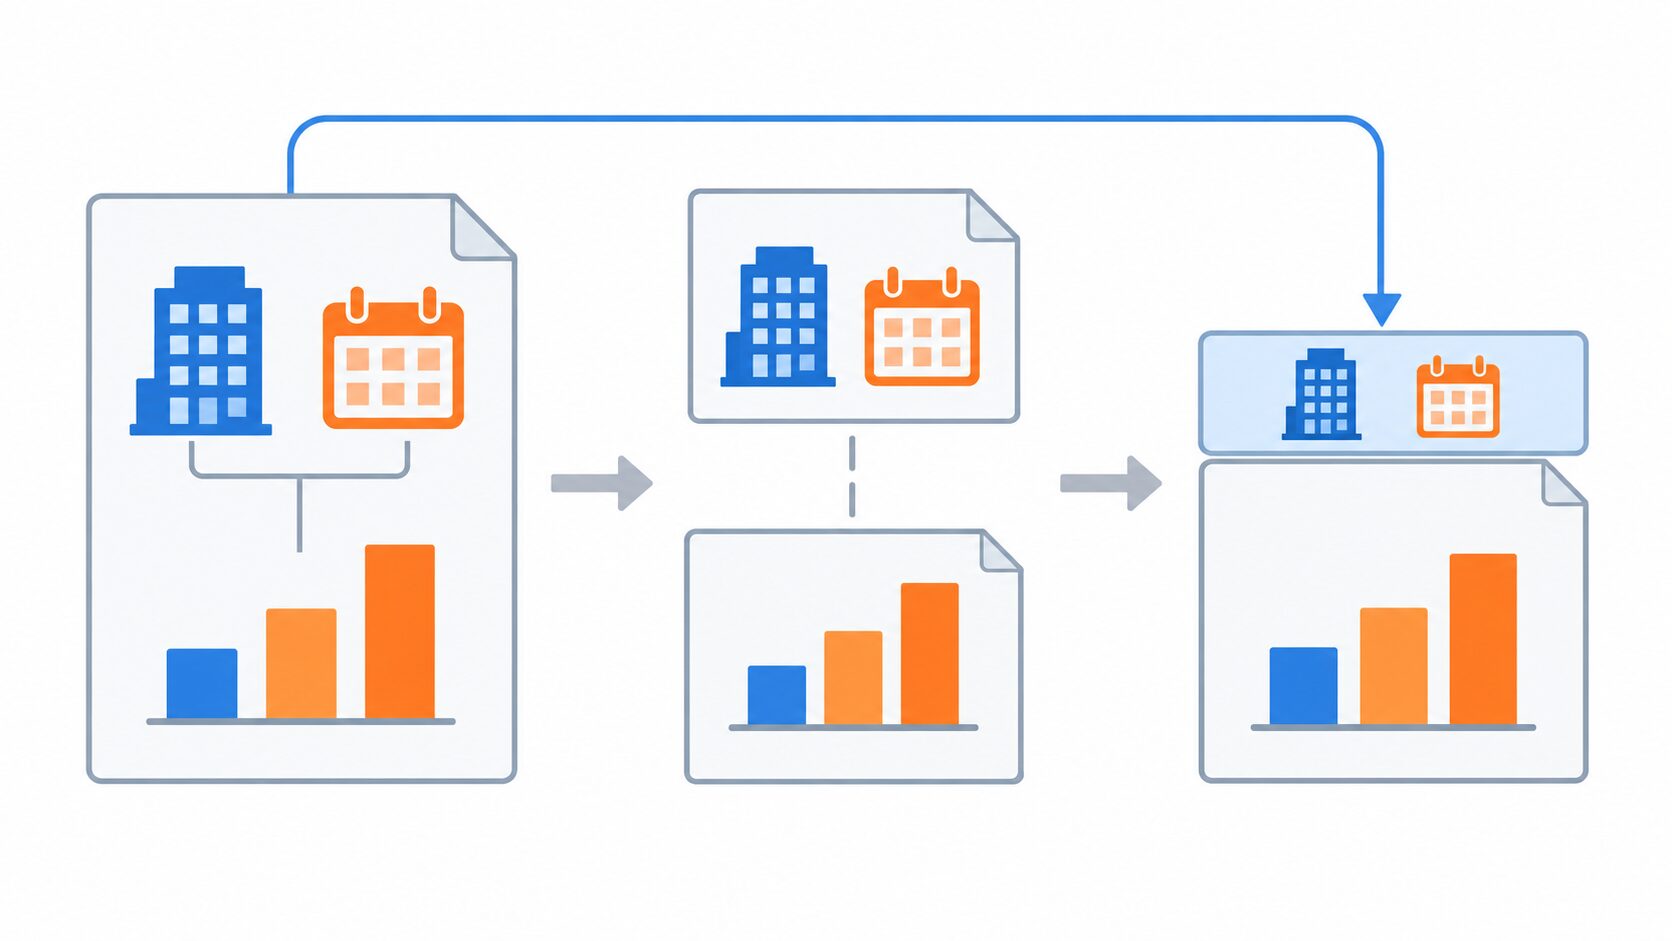
例えば、会社名が表紙に、年度が章の見出しに、売上の増減が本文に書かれている資料を考えましょう。本文だけを取り出すと「売上が増えた」という内容は残っても、どの会社のいつの話か分かりません。「当製品」「同期間」「この条件」といった表現も、前の説明から離れると指す対象が曖昧になります。
人が資料を順番に読むときは、表紙や見出しを覚えながら解釈できます。しかし、検索では各チャンクを独立した情報として扱うため、そのつながりが十分に使われない場合があります。質問に会社名や期間が含まれていても、対応するチャンクに手掛かりがなければ、別の資料に埋もれやすくなるのです。
この問題に対し、チャンクが何について述べているかを短い文で補います。原文に足りない事実を創作するのではなく、元文書にある文脈を検索単位へ持ち込むことが狙いです。回答の言い回しを調整する前に、根拠となる資料へたどり着きやすくします。
文脈を補って検索するまでの仕組み
処理は、資料を登録するときの事前準備と、利用者が質問するときの検索に分かれます。文脈を生成する作業は、原則として索引を作る段階で行います。質問のたびに全資料を読み直し、補足を作る仕組みではありません。
-
元文書をチャンクに分割します。あわせて文書名、版、ページや節、チャンクの識別子を管理し、後から出典へ戻れるようにします。
-
元文書全体と対象チャンクをLLMへ渡し、その箇所を理解するための短い説明を生成します。文書全体の要約ではなく、対象の会社、期間、製品、条件など、そのチャンクの位置づけを示す情報を選びます。
-
生成した補足を元チャンクの前に付け、検索用のテキストを作ります。原文を補足や要約に置き換えず、元の記述を残します。
-
補足付きのテキストから、ベクトル検索用と語句検索用の索引を作ります。索引とは、情報を効率よく探すために整えた検索用のデータです。
ベクトル検索では、文章を意味の特徴を表す数値の並びへ変換します。この変換を埋め込みと呼び、質問とチャンクの意味の近さを比べます。補足付きチャンクを埋め込みに使うのがContextual Embeddingsです。本文の「売上が増えた」という意味に加え、対象企業や期間も検索の手掛かりになります。
もう一方のBM25は、質問と文書に現れる語句、その出現頻度などから関連性を評価する方式です。補足を語句ベースの索引にも反映するのがContextual BM25です。補足に会社名や製品名が入れば、元のチャンクだけでは一致しなかった語句でも候補を探せます。
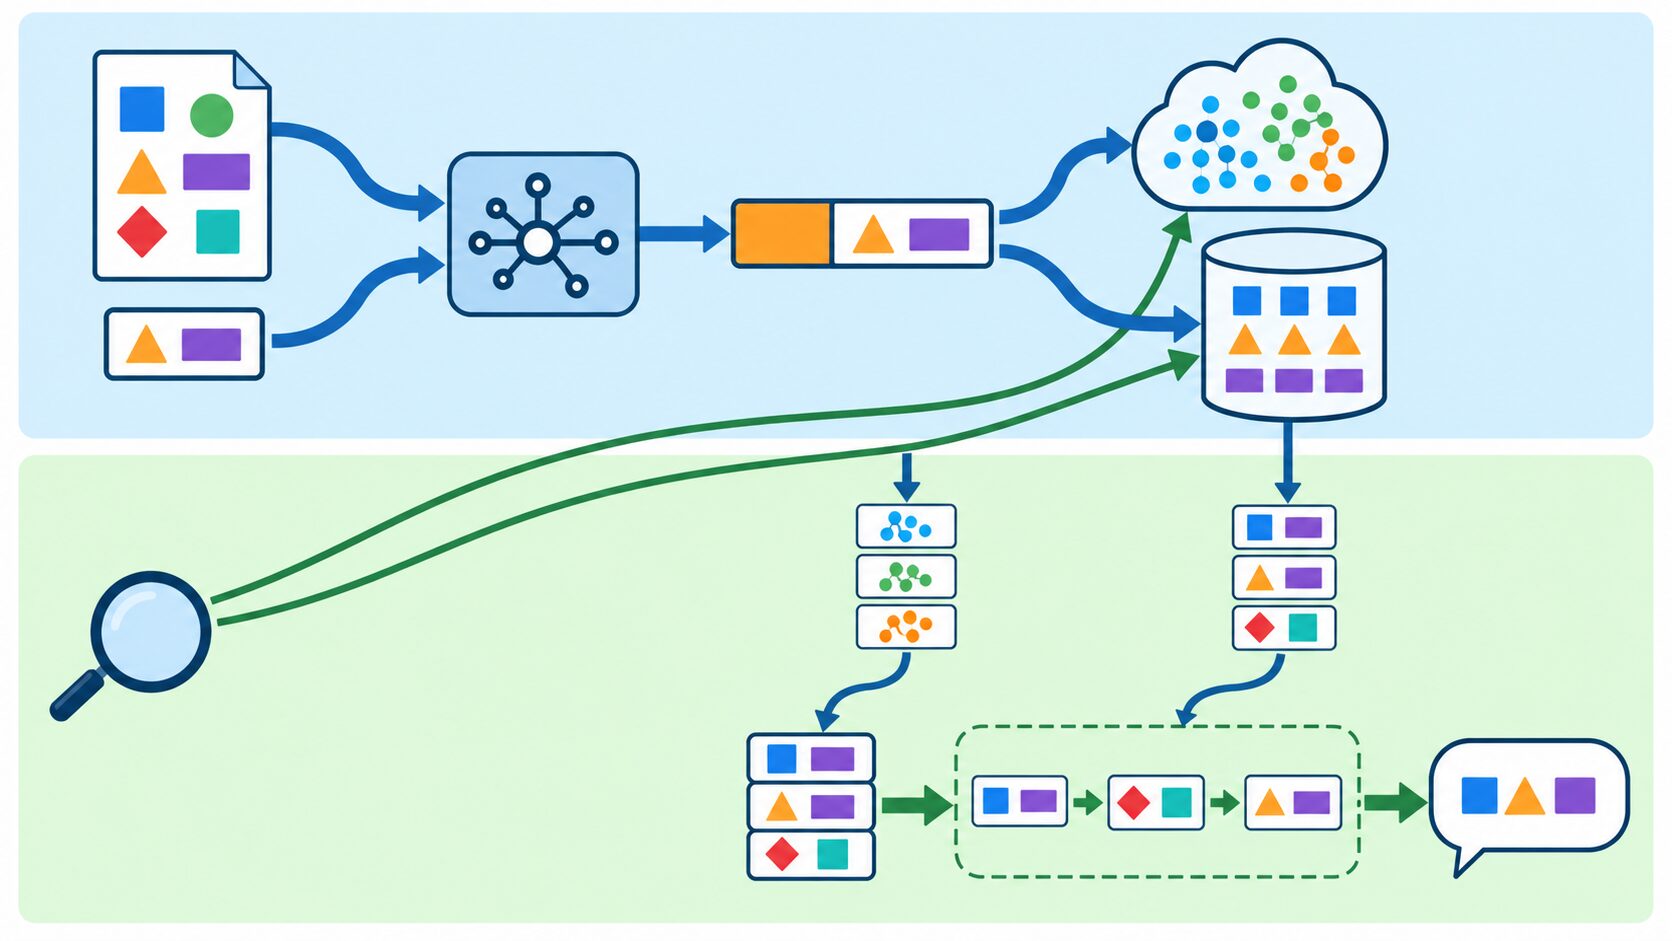
質問を受けたら、ベクトル検索とBM25で候補を取得し、重複を整理して統合します。必要に応じて候補の順序を再評価し、選ばれた資料を質問とともにLLMへ渡します。検索時に使う補足と原文を区別して保持しておくと、回答の根拠が実際の資料にあるか確認しやすくなります。
このように、事前の文脈生成と質問時の回答生成では目的が異なります。前者は資料を見つける準備、後者は見つけた資料に基づく説明です。補足には特定の質問への答えを作らせるのではなく、さまざまな質問でも役立つ文書内の位置づけを書かせます。
企業レポートで見る文脈補足の具体例
架空のA社が作成した「2024年度第2四半期レポート」を例にします。表紙と見出しから会社名と対象期間を確認でき、売上高を説明する本文に「売上高は前年同期比10%増加した」と記載されているとします。
| 状態 | 検索に使うテキスト |
|---|---|
| 補足前 | 売上高は前年同期比10%増加した。 |
| 補足後 | 【文脈】A社の2024年度第2四半期の売上高を説明する箇所。 【原文】売上高は前年同期比10%増加した。 |
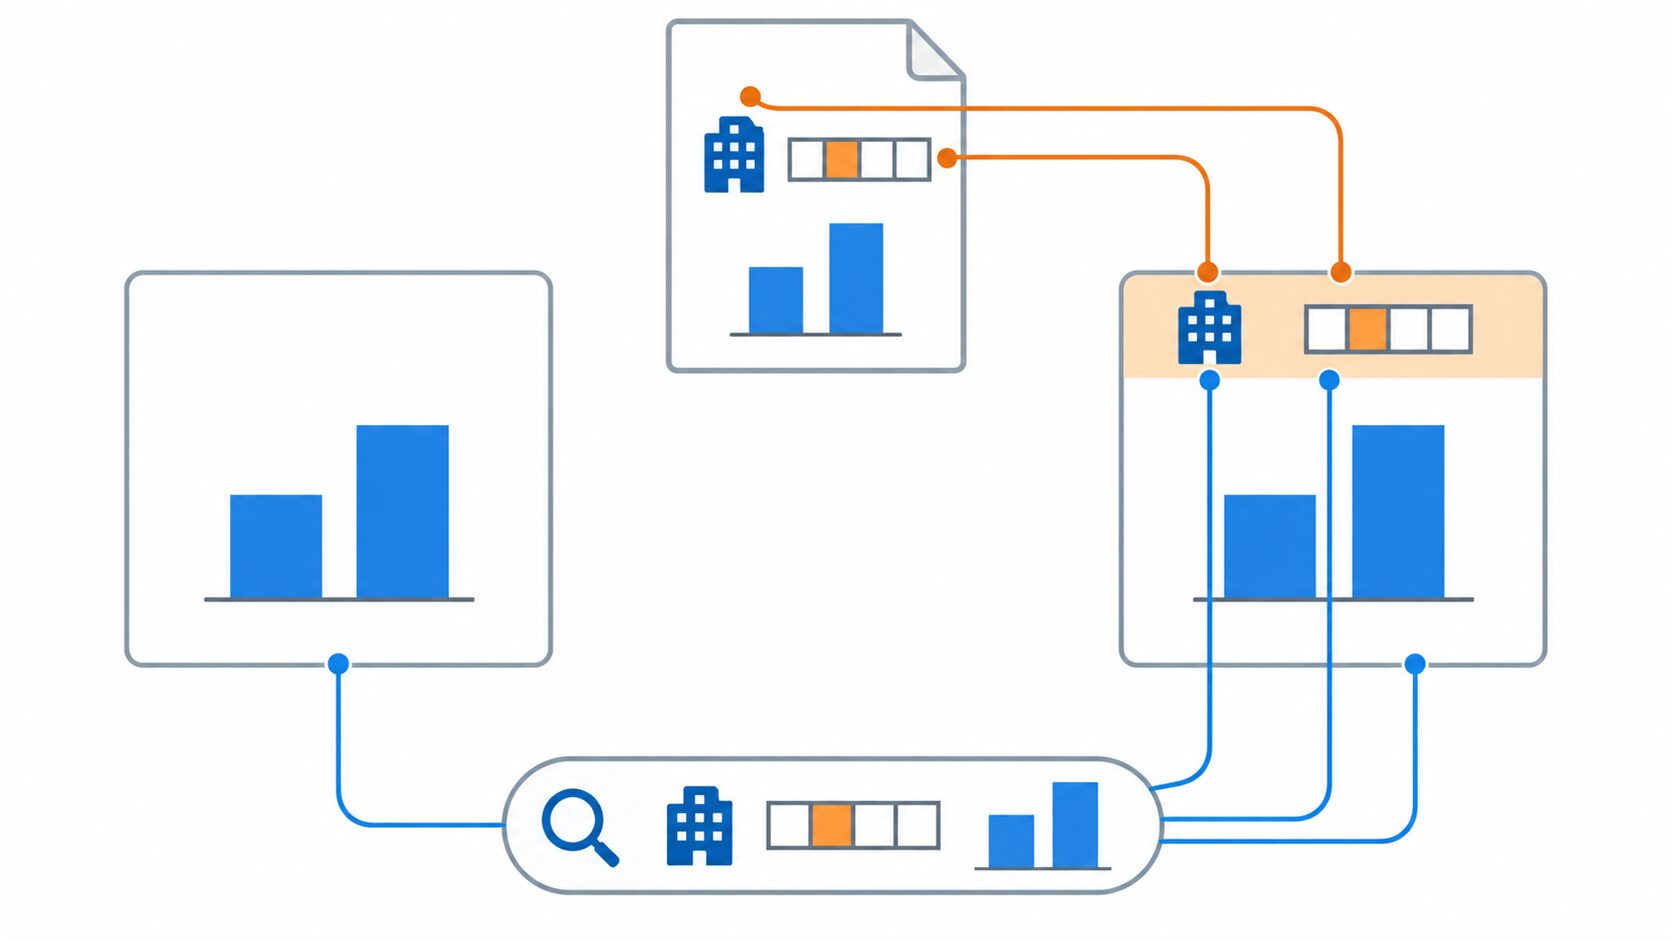
質問が「A社の2024年度第2四半期の売上動向は?」なら、補足前の文章には「A社」も「2024年度第2四半期」もありません。似た売上増加の文章が複数社のレポートにあれば、質問が求める一件を区別する手掛かりが不足します。
補足後は、会社名と期間が語句検索の対象に加わります。埋め込みにも、それらの情報を含めて文章を渡せます。同じ売上の記述でも、何についての記述かが明確になるため、質問との対応を取りやすくなるわけです。
ただし、補足に「新製品の好調が理由」と書けるのは、元文書でその理由を確認できる場合だけです。また、見出しが四半期単独を指すのか累計を指すのかも確認が必要です。自然な説明に見えても、期間や条件の取り違えがあれば別の意味になります。
この例は仕組みを示すもので、検索成功を保証するものではありません。ほかの候補の内容、チャンクの分け方、検索方式、取得件数によって順位は変わります。
ハイブリッド検索・RRF・リランキングとの違い
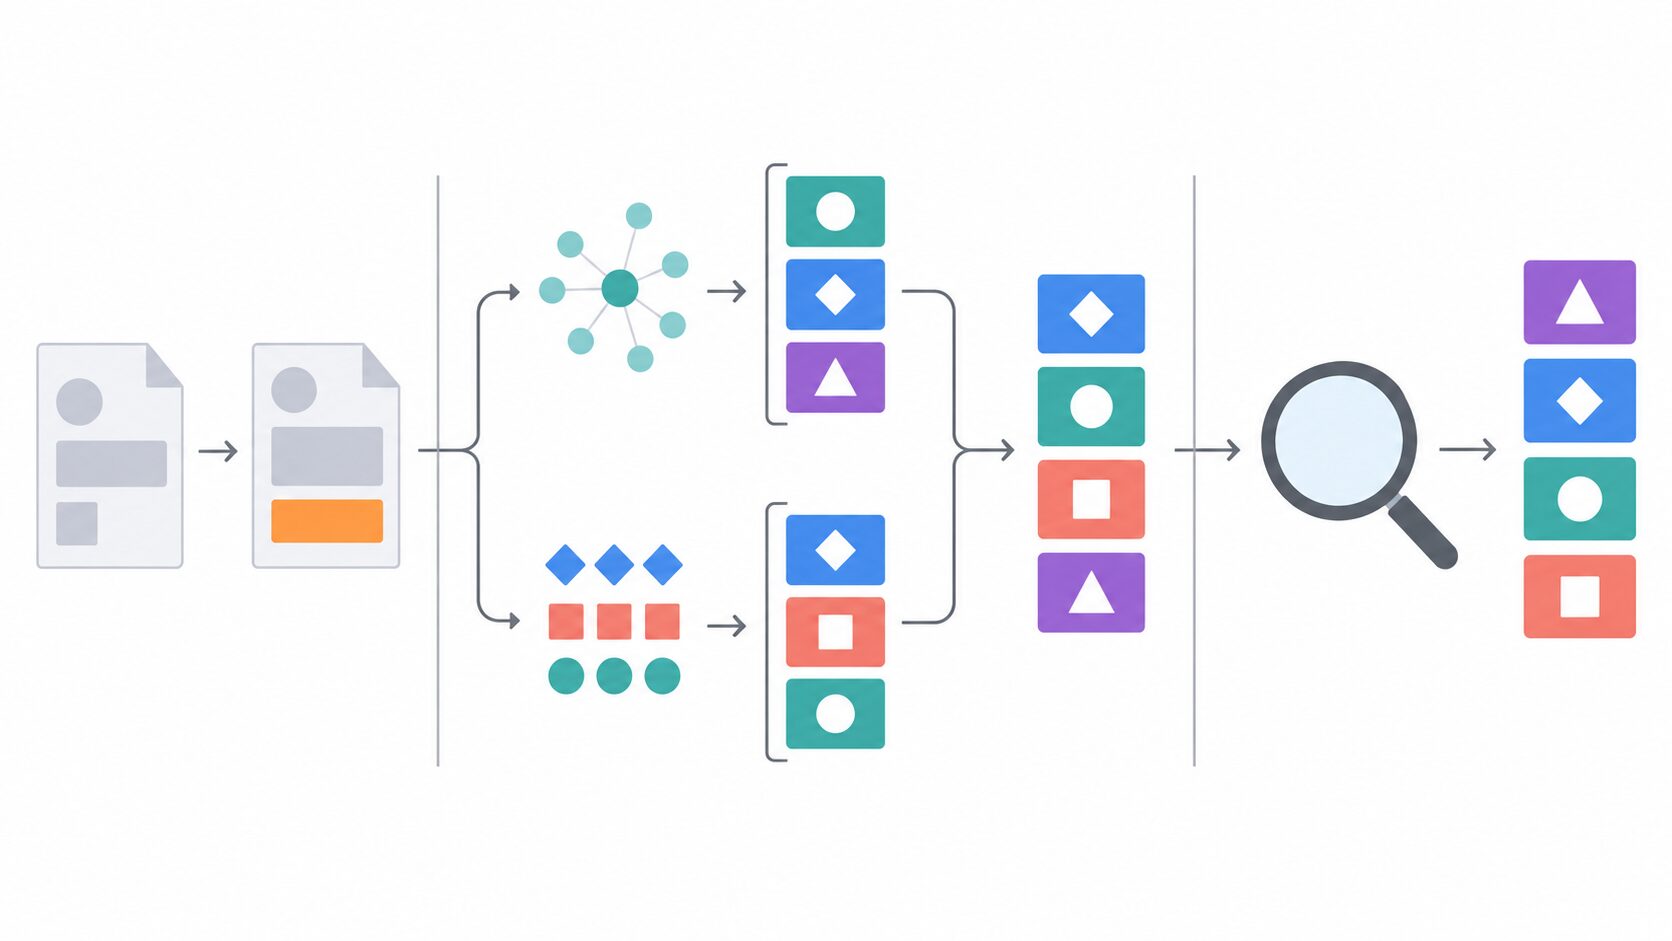
これらは一緒に使えますが、働く段階が異なります。文脈補足は検索対象の情報を整える処理であり、検索方式の組み合わせや取得後の並べ替えそのものではありません。
| 手法 | 処理対象 | 主な段階 | 役割 |
|---|---|---|---|
| 文脈補足 | 文書の各チャンク | 索引作成前 | 文書内の位置づけを説明し、検索の手掛かりを加える |
| ハイブリッド検索 | 質問と複数の索引 | 検索時 | 語句検索とベクトル検索などを併用して候補を集める |
| RRF | 複数の検索結果の順位 | 候補の統合時 | 各結果での順位を基に、候補全体の順序を決める |
| リランキング | 質問と取得済みの候補 | 候補取得後 | 関連性を再評価して順序を見直す |
ハイブリッド検索は、語句の一致と意味の近さなど、異なる探し方を組み合わせます。製品型番のように表記が重要な質問と、表現を言い換えた質問の両方に対応するために使われます。補足のないチャンクに対しても実施できます。
RRFはReciprocal Rank Fusionの略で、複数の検索結果を順位に基づいて統合する方法です。各方式で上位に出た候補へ点数を与えて足し合わせるため、性質の違う検索スコアをそのまま比較せずに済みます。ハイブリッド検索の統合部分に使えますが、チャンクへ会社名などを書き足す機能はありません。
リランキングは、取得した候補と質問を改めて比べて順位を付け直します。例えば、広めに集めた候補から回答に渡す少数を選ぶ場面で使います。候補に入っていない資料は通常のリランキングでは救えないため、まず必要なチャンクを候補へ入れる工夫にも意味があります。
文脈を保つ方法には、見出しや会社名などの固定メタデータを各チャンクへ付ける方法もあります。項目を確実に取得できる資料なら、LLMを使わず必要な情報を補える可能性があります。LLMによる補足の特徴は、対象箇所ごとに文書全体を踏まえた説明を作れる点です。
チャンクを大きくしたり、隣り合うチャンクで文章を重複させたりする方法も比較対象になります。周辺の説明を残しやすい一方、不要な話題まで含まれたり、同じ情報が候補に重なったりします。文脈がどこにあり、どの程度離れているかに応じて方法を選びます。
効果が期待できる文書と使いどころ
導入候補になるのは、断片だけでは主語や条件が分かりにくい文書です。複数社・複数期間の報告書をまとめて検索する場合、似た表現の文章を会社名や対象時期で区別する必要があります。文書全体には識別情報があるのに、検索する箇所へ届いていないなら、補足の価値を検討できます。
製品名や版番号が冒頭の見出しにしかないマニュアルも該当します。同じ操作名でも製品や版で手順が異なる場合、検索対象のチャンクにもその区別が必要です。社内規程では、前の章で示された対象者や適用条件を後の節が引き継いでいると、節の本文だけでは適用範囲を誤解しやすくなります。
一方、一つの質問と回答で意味が完結するFAQや、各項目に製品名・条件が明記された資料では、追加効果が小さいこともあります。見出しの付与、メタデータによる絞り込み、分割位置の調整だけで必要な検索品質を得られるなら、補足生成の費用との比較が必要です。
資料が少なく、質問のたびに全文をモデルへ渡せる規模なら、細かく検索する方式と全文を扱う方式を比較する選択肢もあります。全文を渡す場合にも入力の費用や処理時間、根拠を正しく読み取れるかを確認します。資料の量だけで方式を決めないことが大切です。
元資料に対象期間が書かれていない、表の見出しが読み取り時に落ちた、本文の数値が誤っているといった問題は、文脈補足だけでは解決しません。検索の不調が情報の欠落に由来するなら、資料の修正や取り込み処理の改善から着手します。
追加コストと誤補足をどう検証するか
導入判断では、検索品質と維持にかかる費用の両方を測ります。主な追加負担は、登録時にLLMへ文書とチャンクを渡して補足を生成する処理です。チャンク数が多いほど処理が増え、補足の分だけ検索用テキストも長くなります。語句索引などの容量や、埋め込みを作る際の入力費用にも影響します。
更新の扱いも見積もりに含めます。本文が変わっていなくても、文書の見出しや対象期間が変われば、その情報を使った補足が古くなる可能性があります。どの補足がどの版の原文から作られたかを記録し、影響する範囲を再生成・再索引します。更新頻度が高い資料では、初回登録だけでなく継続運用の負担が重要です。
これらは、質問ごとに発生する検索、リランキング、回答生成の費用や待ち時間とは分けて測ります。補足生成を事前に済ませても、回答へ渡すテキスト量や検索構成の変更によって、利用者が待つ時間が変わる可能性はあります。
品質面では、補足文を検索用に生成した情報として扱い、原文に照らして確認することが基本です。別会社の説明を混ぜる、前年度の実績を今年度の情報として書く、例外条件を落とすといった誤りは、誤ったチャンクを上位へ押し上げる原因になります。
代表的な文書からサンプルを選び、会社名、年度、製品の版、適用条件が元文書と一致するかレビューします。特に、複数企業の比較資料や、実績と予測が混在する資料を含めると、取り違えやすい箇所を確認できます。補足、原文、出典の位置、版を対応付け、誤りがあれば生成時の指示や分割方法へ戻って修正できるようにします。
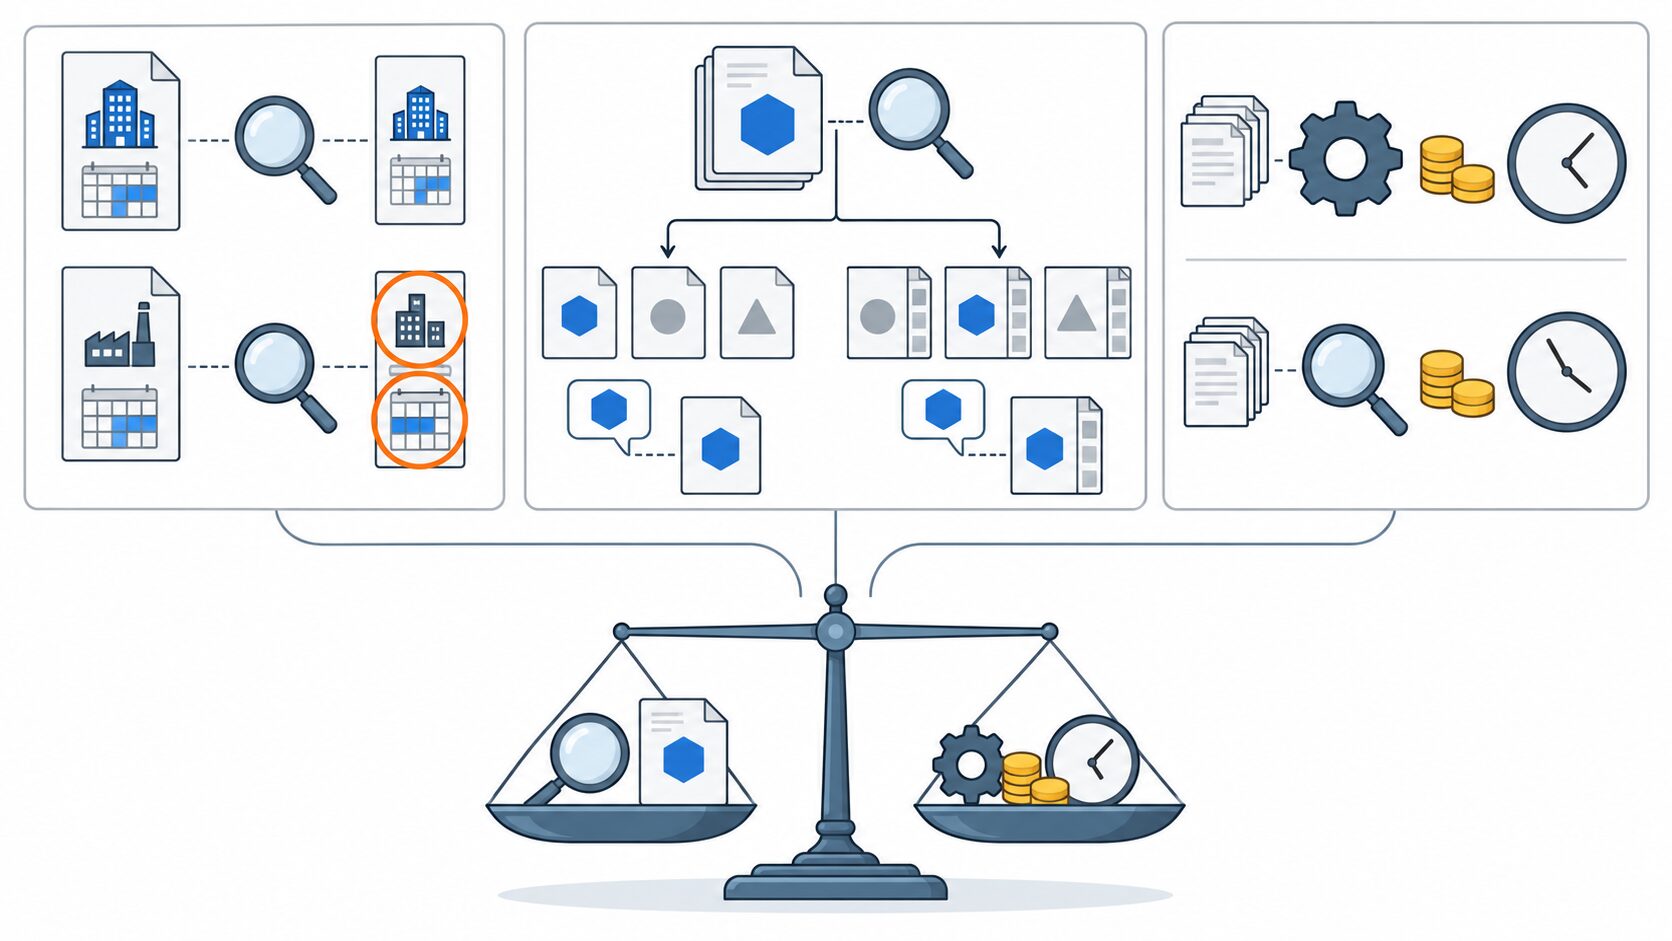
効果の比較には、実際の利用を想定した質問と、その回答の根拠になる資料を用意します。同じ文書、質問、チャンク分割、取得件数を使い、まず補足の有無だけを変えて評価します。指標は次のように分けると、改善した箇所を把握しやすくなります。
-
検索品質:根拠となる正解資料が上位k件に含まれる質問の割合を確認します。kは取得する候補数で、例えば上位10件を比較するなら両方式とも10件にそろえます。正解資料が複数ある場合は、必要な資料をどれだけ回収できたかも見ます。
-
回答品質:回答の主張が取得した原文に裏付けられているか、会社名や期間、条件が質問と一致するかを確認します。正解資料が見つかったことと、正しい回答が作れたことは分けて評価します。
-
運用負担:登録と更新にかかる時間・費用、索引の容量、質問から回答までの時間・費用を記録します。検索の改善幅が追加負担に見合うかを判断します。
次に語句検索の併用やリランキングを加え、それぞれの効果を分けて確かめます。一度にすべて変えると、どの処理が改善に寄与したか分かりません。結果を共有するときも、資料の種類、質問数、取得件数、検索構成を添えれば、別の環境へ適用できるか判断しやすくなります。
文脈補足で検索が改善しても、回答時の読み違いや根拠のない生成がなくなるわけではありません。自社の資料で文脈の欠落が起きているかを確かめ、小さな対象で原文照合と比較評価を行うことが、導入の出発点になります。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月3日 | 初回公開 |