
学習係数とは?意味・仕組み・活用例をわかりやすく解説

AIの初心者
「学習係数」は、大きすぎても小さすぎてもいけないと聞きました。何を調整しているのですか?

AI専門家
目的地へ向かう一歩の大きさを思い浮かべてみてください。学習係数は、モデルの数値を更新するときの歩幅を決めます。歩幅が大きすぎると目的地を通り越し、小さすぎるとなかなか近づけません。
AIの初心者
つまり、正解の値そのものではなく、そこへ近づくための更新幅を調整するんですね。
AI専門家
その通りです。学習曲線を確かめながら値を調整すると、学習を安定して進めやすくなります。更新の仕組みから、実際の試し方まで見ていきましょう。
学習係数は、機械学習のモデルが予測の誤差を小さくするために、内部のパラメータを一度にどれだけ動かすかを決める値です。「学習率」とも呼ばれます。学習の速さや安定性に関わりますが、値が大きいほど精度が高くなるわけではありません。
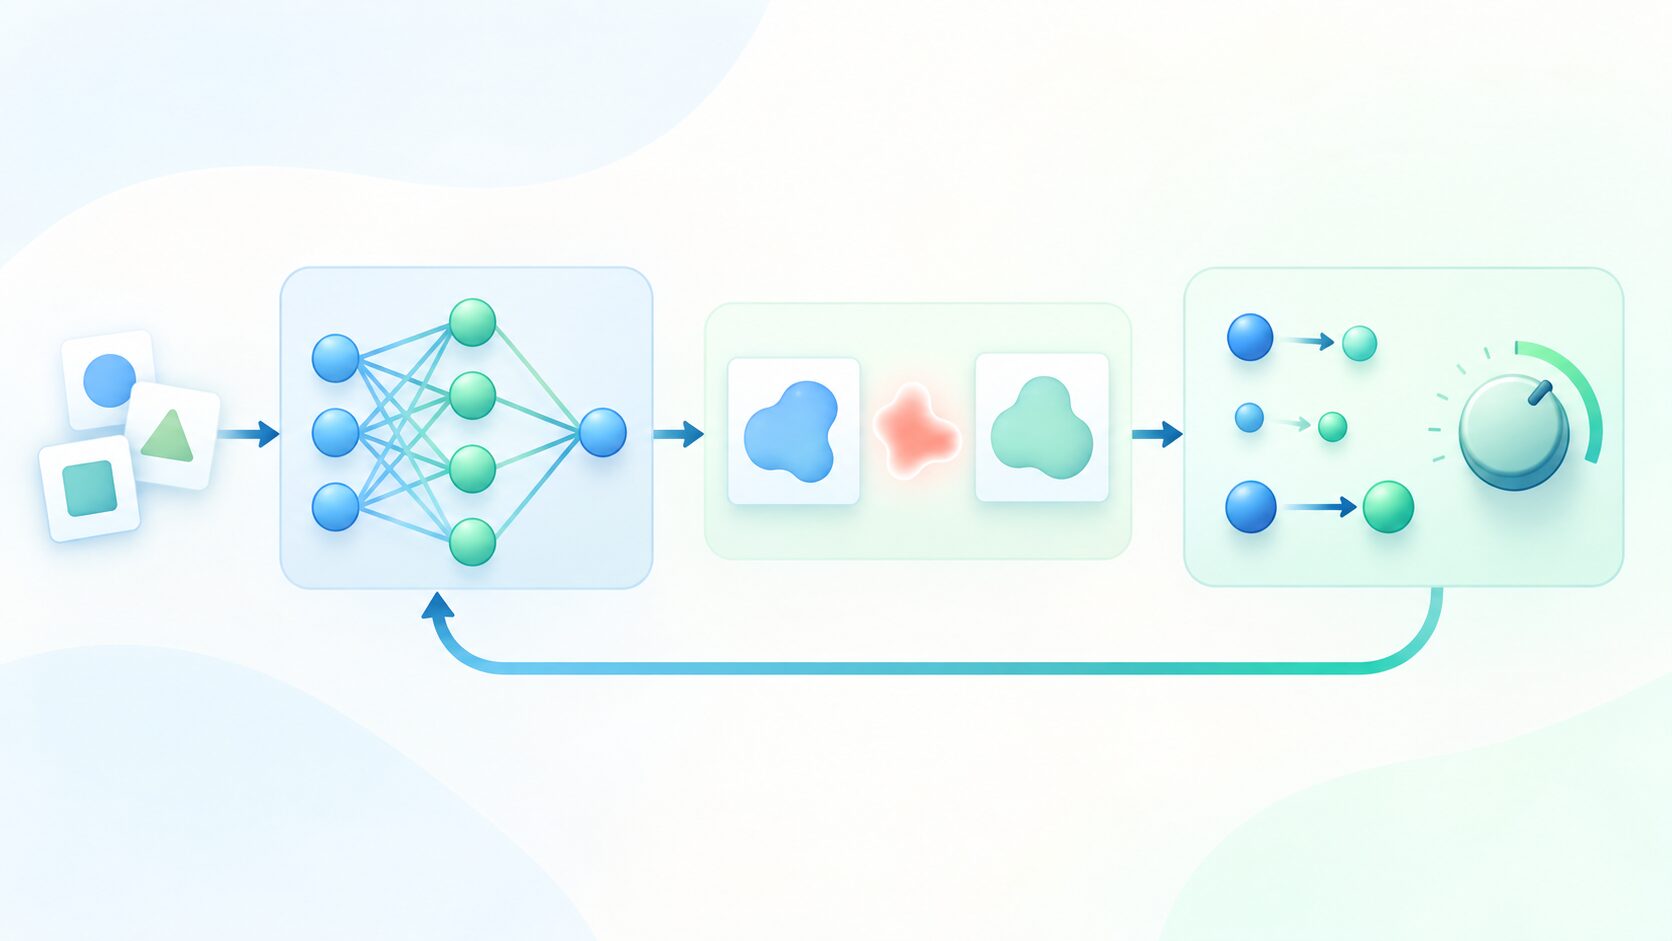
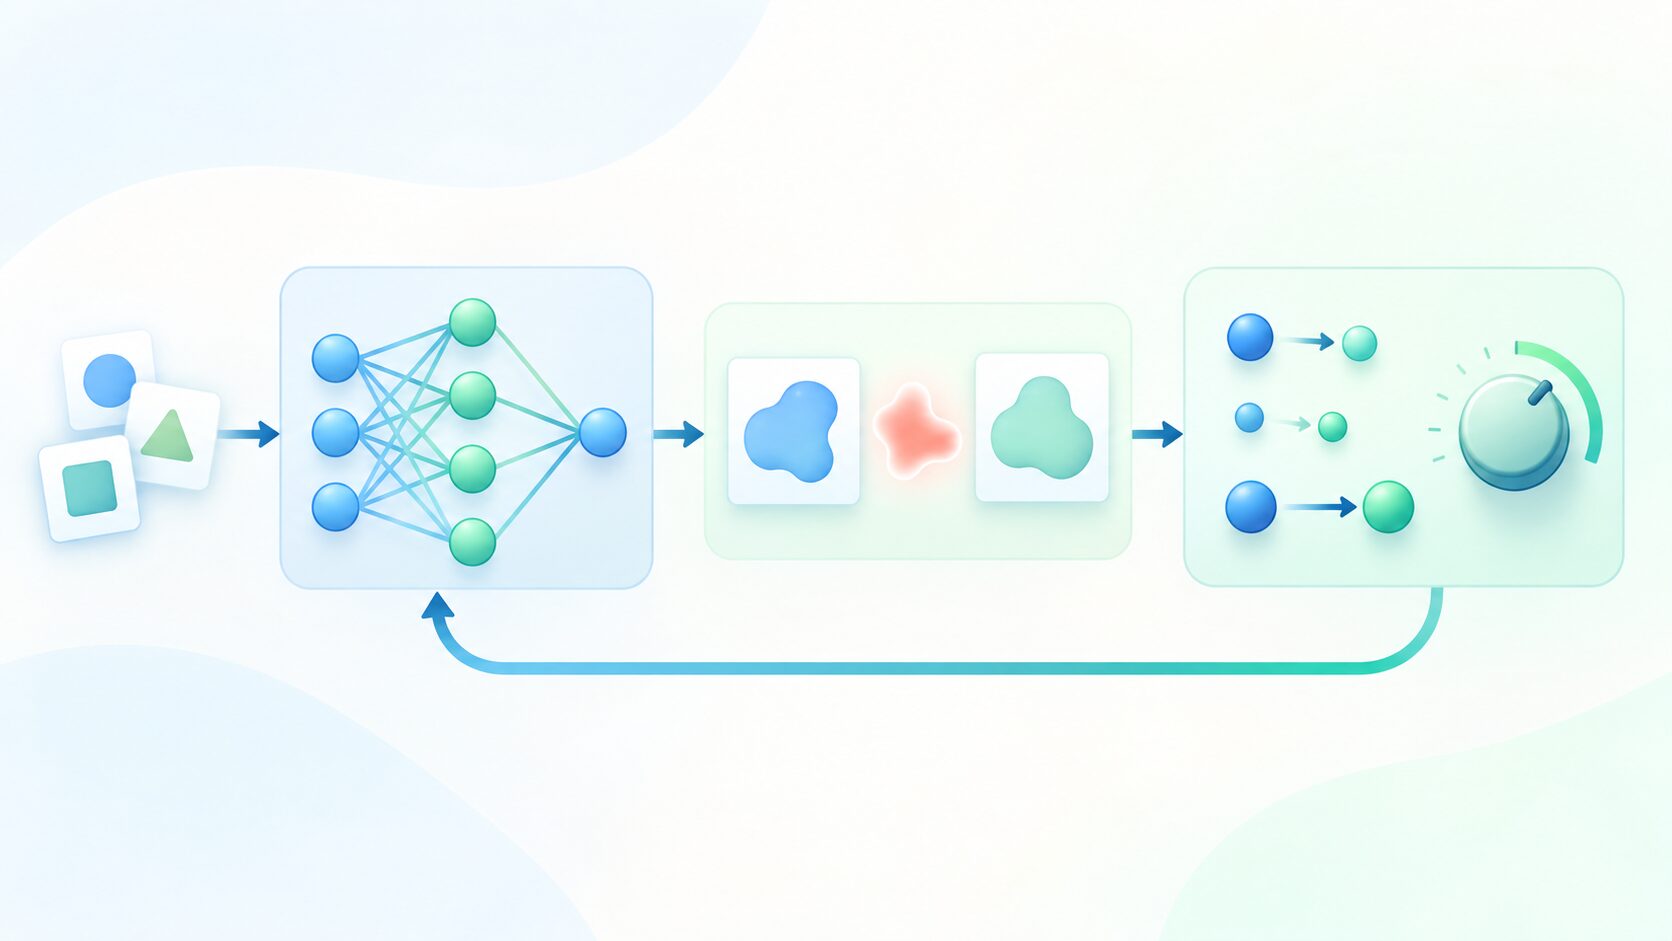
モデルは予測と正解のずれを計算し、そのずれを減らす方向へパラメータを更新します。学習係数はその更新幅を調節します。まずは、この処理の流れの中で学習係数が使われる位置を押さえておきましょう。
学習係数(学習率)とは
学習係数は、モデルの学習中にパラメータを更新する幅を決めるハイパーパラメータです。ハイパーパラメータとは、学習を始める前や学習中に人が設定する値のことです。学習係数は一般に正の値を使いますが、その数値自体がモデルの精度を表すわけではありません。
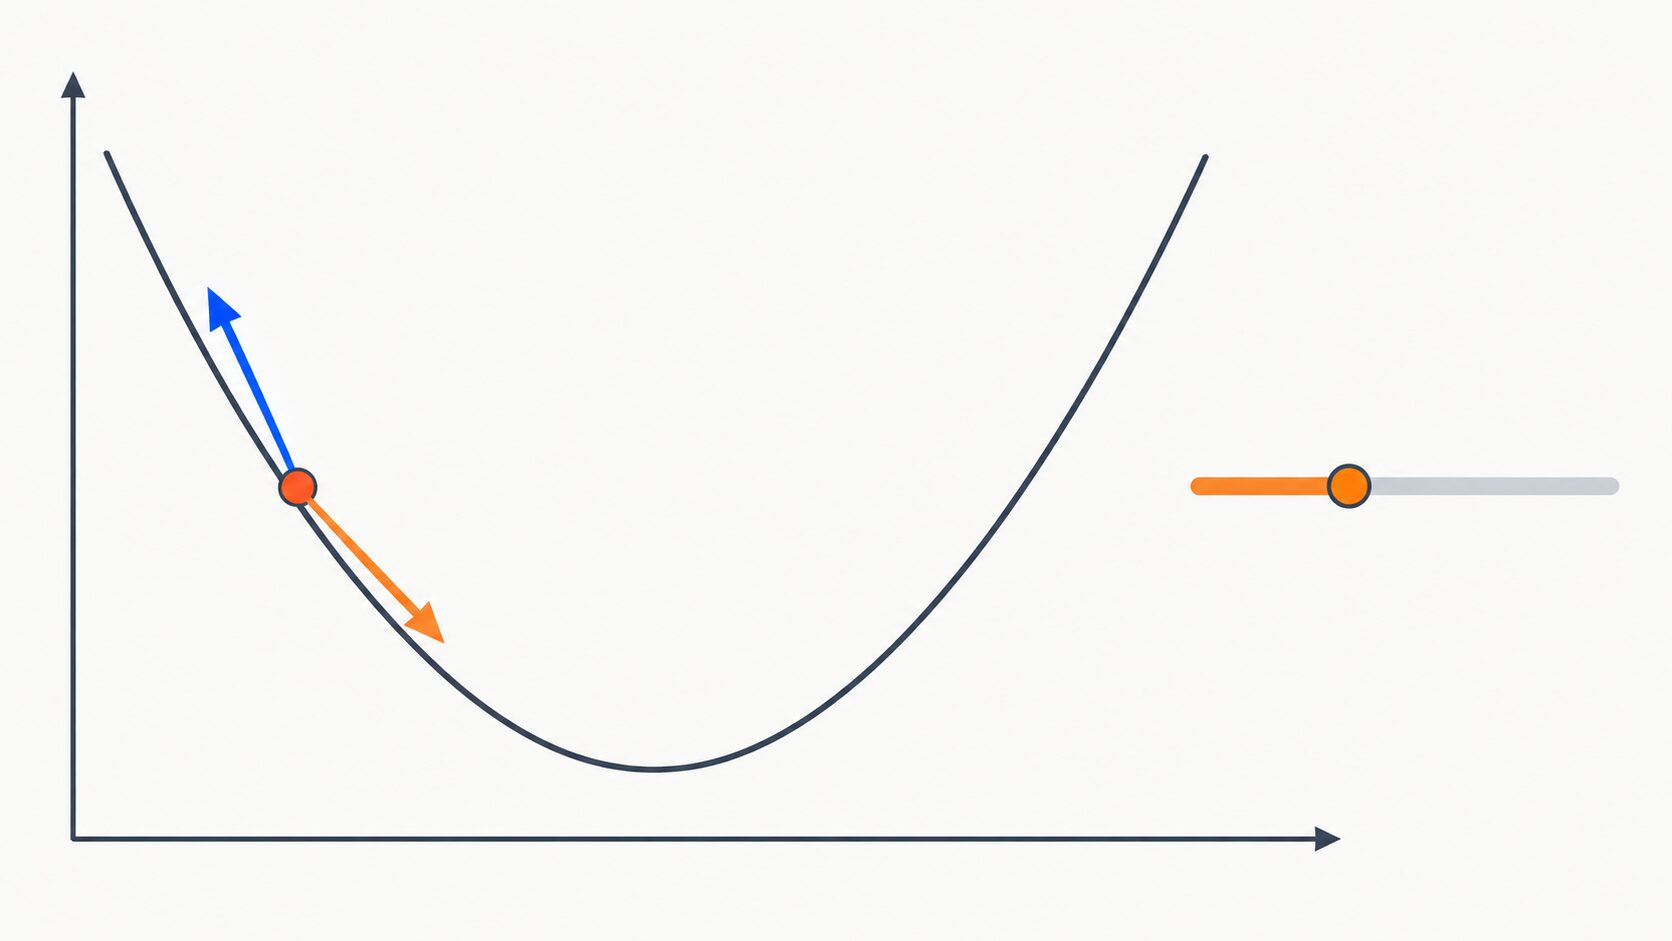
たとえば、坂道の低い場所を探しているとします。現在地から下り坂の方向へ進むとき、学習係数が大きければ一度に大きく進み、小さければ少しずつ進みます。学習では、この歩幅に当たる値がパラメータの更新量に反映されます。大きな歩幅なら短い時間で近づけることがありますが、最適な位置を通り過ぎる危険もあります。
適切な値は、データの特徴やモデル、タスク、使う最適化手法によって変わります。そのため、すべての機械学習に共通する固定の正解はありません。学習率の候補を試し、学習中の損失や検証データでの性能を見ながら調整します。
勾配降下法でパラメータが更新される仕組み
モデルの予測と正解のずれを数値で表したものを損失といい、損失を計算する関数を損失関数と呼びます。損失関数の勾配は、パラメータを少し動かしたときに損失がどちら向きに増えるかを示します。そこで勾配とは反対の方向へ進めば、損失を減らせる可能性があります。この考え方に基づいてパラメータを更新する方法が勾配降下法です。
基本的な更新式は次のとおりです。
\(\theta \leftarrow \theta – \eta \nabla L(\theta)\)- \(\theta\):モデルが学習するパラメータ
- \(\eta\):学習係数。更新の幅を調整する値
- \(\nabla L(\theta)\):パラメータに対する損失関数の勾配
式では、勾配に学習係数を掛け、その分だけパラメータを勾配と反対向きへ動かします。勾配が大きい場所でも、学習係数を小さくすれば更新幅を抑えられます。一方、学習係数を大きくすると一度の更新が大きくなります。
実際の深層学習では、データの一部を取り出したミニバッチから勾配を推定する方法がよく使われます。毎回異なるデータの組み合わせを使うため、勾配にはばらつきが含まれ、損失が毎回きれいに下がるとは限りません。学習係数は、このばらつきがある更新をどれくらいの幅で行うかにも関係します。
大きすぎる・小さすぎると何が起きるか
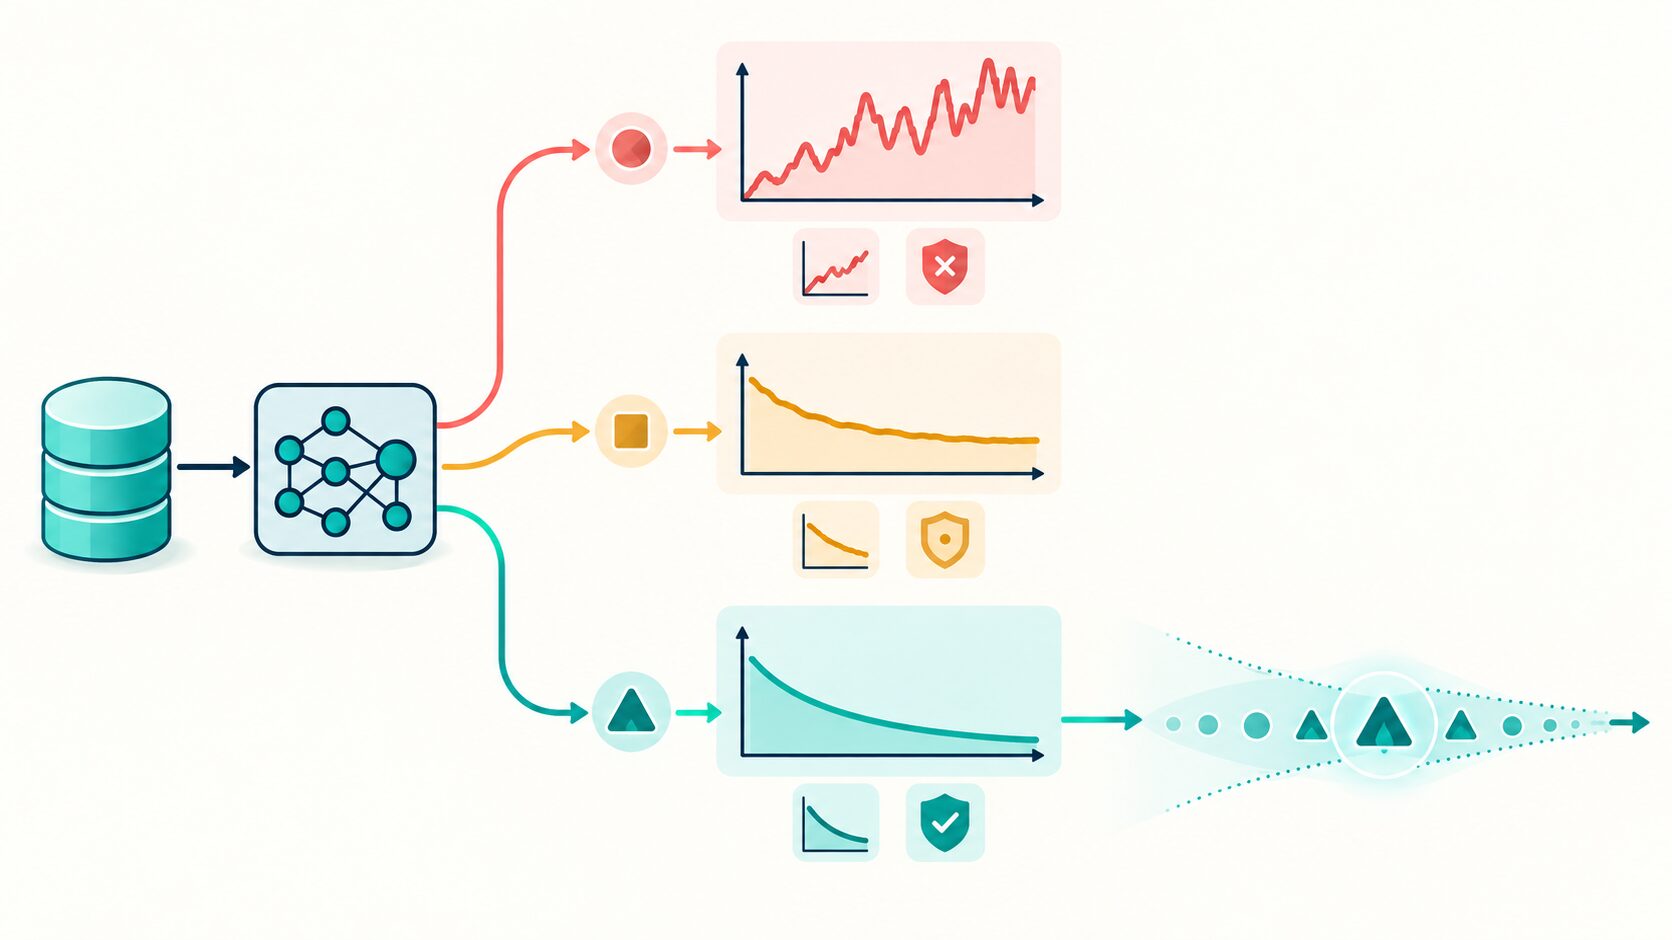
学習係数が大きすぎると、損失が小さくなる位置を一度に通り越し、更新のたびに反対側へ飛び越えることがあります。損失が上下に振動したり、値が増え続けて発散したりすると、学習が安定しません。反対に小さすぎると更新幅がわずかになり、損失がなかなか減らず、学習に時間がかかります。
更新幅の違いを、単純な一変数の例で見てみます。損失関数を\(L(w)=(w-3)^2\)、開始時の値を\(w=0\)とすると、勾配は\(\frac{dL}{dw}=2(w-3)=-6\)です。更新式は\(w_{\mathrm{new}}=w-\eta\frac{dL}{dw}\)なので、学習係数を\(\eta=0.1\)にすると次の値は\(w=0.6\)、\(\eta=0.5\)なら\(w=3\)になります。この例では\(w=3\)が損失の最小値です。
一方、\(\eta=1.1\)では一度の更新で\(w=6.6\)まで進み、最小値を越えます。この関数では次の更新で反対側へさらに大きく移動するため、更新を繰り返すと振動しながら損失が増えていきます。これは仕組みを示すための単純な例で、実際に適切な値はモデルやデータによって異なります。
損失曲線の振動や停滞は学習係数を見直す手掛かりですが、それだけで原因を断定はできません。データの前処理やモデルの設定なども学習の安定性に影響するため、他の条件も合わせて確認します。

学習係数を決める実践的な手順
初めてモデルを学習させるときは、候補を桁違いでいくつか試し、損失と検証性能を比べる方法が実践的です。たとえば\(10^{-1}\)、\(10^{-2}\)、\(10^{-3}\)のような値から短く試せます。これは探索を始めるための例であり、どのモデルにも当てはまる推奨値ではありません。
- データの分割、前処理、モデル、最適化手法などの条件をそろえます。
- 学習係数だけを変えて複数の候補を試し、学習損失と検証損失、必要に応じて検証指標を記録します。
- 損失が発散するほど大きな値や、短い試行でほとんど進まないほど小さな値を候補から外します。
- 有望な範囲をさらに細かく試し、検証データで安定して性能を出せる値を選びます。
学習データの損失が下がっていても、検証データでの損失や指標が悪化している場合は、学習データへの過適合など別の問題が起きている可能性があります。学習損失だけを見て値を決めず、未知のデータに対する性能も確認しましょう。短い試行は大きく外れた候補を見つけるのに役立ちますが、最終候補は十分な学習時間で比較します。
候補の範囲を見つけたら、その周辺の値を追加して比較します。学習の最初は大きな値から始め、必ず徐々に小さくするのが常に最善というわけではありません。学習曲線と検証結果に基づいて、必要な調整を選びます。
学習率スケジューラと最適化手法の違い
学習率スケジューラは、学習の進行に合わせて学習係数を変化させる仕組みです。たとえば段階的減衰では一定の学習回数ごとに値を下げ、指数関数的減衰や多項式減衰では決めた計算式に沿って少しずつ下げます。後半の更新幅を小さくすることで、最適な値の近くを細かく調整しやすくなります。
MomentumやAdamは、学習係数を変えるスケジューラとは役割が異なる最適化手法です。Momentumは過去の勾配を蓄積して更新に反映し、勾配の向きが続く方向へ進みやすくするとともに、更新の振動を抑えることを目指します。坂道を進む物体の勢いを利用するイメージです。
Adamは過去の勾配と勾配の二乗の移動平均を使い、パラメータごとに更新量を調整します。そのため、パラメータ間で勾配の大きさに差がある場合にも対応しやすい手法です。ただし、Adamも全体の更新幅を調整する基準の学習係数を必要とします。最適化手法を選べば学習係数の検討が不要になるわけではありません。
つまり、学習係数は更新幅の基準、スケジューラは学習の進行に応じた値の変更方法、MomentumやAdamは勾配を使ってパラメータを更新する方法です。それぞれの役割を分けて考え、組み合わせを検証データで比較すると、調整の見通しが立ちやすくなります。

学習曲線を見て調整するときの注意点
学習曲線を確認するときは、学習データの損失と検証データの損失を並べて見ます。両方の損失が下がっていれば学習が進んでいる可能性がありますが、学習損失だけ下がり、検証損失が上がる場合は、訓練データへの過適合が疑われます。学習係数を変えれば必ず解決するとは限らないため、データやモデルも含めて状況を調べます。
特徴量の尺度が大きく異なると、勾配の大きさに偏りが生じ、学習が進みにくくなることがあります。特徴量のスケーリング、初期値、モデル構造、バッチサイズも結果に影響するため、学習係数を比較するときは、変更する条件を一つずつにして結果を比べると原因を捉えやすくなります。
バッチサイズと学習係数も混同しやすい項目です。バッチサイズは一度の更新に使うデータ数を決め、学習係数はその更新でパラメータをどれだけ動かすかを決めます。どちらも学習の挙動に関わり、互いに影響することはありますが、役割は異なります。まずは更新式と学習曲線を手掛かりに、値を変えたときの影響を一つずつ確かめていきましょう。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年10月17日 | 更新式と数値例を加え、学習率・スケジューラ・最適化手法の違いを整理 |