アルゴリズム

記事数:(463)

アルゴリズム

画像認識の革新:SENetの仕組みと活用例

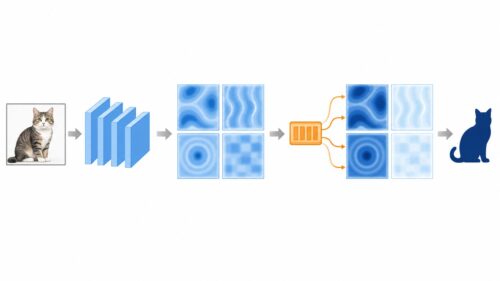
多くの写真から、写っているものが何かを当てる技術、つまり写真認識技術の進歩は目覚ましいものがあります。世界中から優れた技術を持つチームが集まり、その技術を競う大会が数多く開かれています。中でも、写真認識技術の分野で特に権威ある大会として知られるのが、イメージネット大規模視覚認識チャレンジ、略してアイエルエスブイアールシーです。この大会は、多種多様な写真の中から、何が写っているかを正確に認識する能力を競うもので、毎年世界中から精鋭チームが参加します。二〇一七年に行われたこの大会で、驚くべき成果を上げた技術があります。それが、エスイーネットという技術です。 エスイーネットは、他の技術と比べて非常に高い精度で写真の認識に成功しました。なんと、誤って認識してしまう割合、つまり誤答率はわずか二・二五パーセントという驚異的な数字を記録し、見事優勝の栄冠を手にしました。これは、アイエルエスブイアールシーのような高いレベルの大会では、まさに画期的な成果と言えるでしょう。百枚の写真があれば、そのうち九十七枚以上を正しく認識できるというのは、私たちの日常生活にも大きな影響を与える可能性を秘めています。例えば、自動運転の車に搭載されれば、周囲の状況をより正確に把握することができ、安全性の向上に繋がります。また、医療の分野では、エックス線写真やエムアールアイ画像から病気をより正確に診断するのに役立つ可能性もあります。 エスイーネットの革新的な構造と、それを開発したチームのたゆまぬ努力が、この輝かしい成果に繋がったと言えるでしょう。エスイーネットは、写真認識技術の分野に新たな可能性を切り開き、私たちの未来をより豊かで便利な方向へと導いてくれると期待されています。
アルゴリズム

SELUとは?自己正規化する活性化関数の仕組みと使い方

人間の頭脳の仕組みをまねた人工知能の技術、ニューラルネットワーク。これは、複雑な計算を繰り返し学習することで、まるで人間のように問題を解決できる画期的なものです。このネットワークの中には、「ニューロン」と呼ばれる小さな部品がたくさんつながっています。それぞれのニューロンは、受け取った情報を処理して、次のニューロンへと情報を送ります。この情報の流れを調整するのが「活性化関数」と呼ばれる重要な役割です。 活性化関数は、ニューロンの出力値を適切な範囲に調整する働きをします。もし活性化関数がなければ、ニューロンの出力は際限なく大きくなったり、小さくなったりしてしまい、学習がうまく進みません。活性化関数は、学習の効率を高め、ニューラルネットワークの性能を向上させるために必要不可欠な存在と言えるでしょう。 さまざまな種類の活性化関数が開発されていますが、その中でも注目されているのが「SELU(スケールドエクスポネンシャル線形ユニット)」です。「自己正規化」という特別な性質を持つこの活性化関数は、ニューラルネットワークの学習をより安定させ、効率的にする効果があります。これは、データの分布を自動的に調整する働きによるものです。SELUを用いることで、より精度の高い学習結果を得られることが期待できます。 活性化関数は、ニューラルネットワークの心臓部と言える重要な要素です。それぞれの活性化関数の特性を理解し、適切に選択することで、人工知能の可能性を最大限に引き出すことができます。
アルゴリズム

ResNet:層を深くする技術

残差ネットワーク(ResNet)は、画像認識などの深層学習の世界で大きな進歩をもたらした、画期的なネットワーク構造です。深層学習では、たくさんの層を重ねることで複雑な事柄を学習できますが、層を増やしすぎると、学習がうまくいかなくなり、精度が落ちるどころか、かえって悪くなってしまう問題がありました。これを勾配消失問題と言います。ResNetはこの問題を解決するために、特別な仕組みである残差ブロックを導入しました。 残差ブロックは、畳み込み層の出力を次の層に渡すだけでなく、元の入力をそのまま次の層に足し合わせるという構造です。これは、まるで近道を作るようなもので、入力された情報を変化させずに、次の層へ伝える経路を作ることになります。この一見簡単な工夫が、勾配消失問題の解決に大きく貢献し、とても深いネットワークの学習を可能にしました。層を深くすることで、ネットワークはより複雑な特徴を捉えられるようになり、画像認識などの精度が飛躍的に向上しました。 たとえば、画像に写っているのが猫なのか犬なのかを判断する場合、これまでのネットワークでは、全体の形や模様など、たくさんの特徴を順番に見ていく必要がありました。しかし、ResNetでは、残差ブロックによって、重要な特徴がより深い層まで、はっきりと伝わるようになります。つまり、猫特有の耳の形や、犬特有の鼻の形といった、見分けるために特に重要な特徴が、ネットワークの深い部分まで届くのです。その結果、ResNetは、画像に写っている動物が猫なのか犬なのかを、より正確に判断できるようになりました。このように、ResNetは深層学習の分野に大きな影響を与え、様々な応用で目覚ましい成果を上げています。
アルゴリズム

ランダムフォレスト入門

たくさんの木々が茂る森を思い浮かべてみてください。ランダムフォレストは、まさにその名の通り、決定木と呼ばれる予測モデルがたくさん集まった森のようなものです。個々の木は、データの特徴に基づいて判断を下します。そして、最終的な判断は、森全体の木々の意見をまとめることで決定されます。これが、ランダムフォレストの基本的な考え方です。 ランダムフォレストは、機械学習の中でもアンサンブル学習と呼ばれる手法の一種です。アンサンブル学習とは、複数のモデルを組み合わせて、全体的な性能を向上させることを目指す手法です。まるで、様々な専門家がそれぞれの知識を出し合って、より良い結論を導き出す会議のようなものです。ランダムフォレストでは、たくさんの決定木を並列に学習させ、それぞれの予測結果を集約することで、単体の決定木よりも高い精度と安定した予測を実現します。 ランダムフォレストの大きな特徴は、予測の際に使用するデータをランダムに選択することです。そして、それぞれの木を学習させる際にも、データの特徴をランダムに選びます。このようにランダム性を導入することで、個々の木に多様性を持たせ、森全体の予測能力を高めています。例えるなら、様々な分野の専門家を集めることで、より多角的な視点からの判断が可能になるようなものです。 ランダムフォレストは、物事をグループ分けする分類問題と、数値を予測する回帰問題の両方に適用できます。そのため、様々な分野で広く活用されています。例えば、病気の診断や顧客の行動予測、商品の需要予測など、データに基づいて判断や予測を行う必要がある場面で、ランダムフォレストは力を発揮します。ランダムフォレストは、複雑な計算を必要とせず、比較的簡単に利用できるという点も大きな利点です。
アルゴリズム

ResNet:画像認識の革新

絵や写真を見てそれが何かを当てる人工知能の分野では、近年目覚ましい発展が見られています。その進歩を支える技術の一つに、畳み込みニューラルネットワークと呼ばれるものがあります。これは、人間の脳の仕組みを真似た情報処理のしくみで、層と呼ばれる部分を何層も重ねることで、複雑な形や模様を捉えることができます。層を深くすればするほど、より細かい特徴を捉え、認識の正確さを高めることができると考えられてきました。しかし、ただ層を重ねるだけでは、学習がうまく進まないという問題がありました。深い層に情報が届くまでに、だんだん薄れて消えてしまう、まるで遠くの音が聞こえなくなるような現象が起きるためです。これを勾配消失問題と呼びます。 この問題を解決するために、二〇一五年にマイクロソフト研究所のカイミン・ヒー氏によって、残差接続と呼ばれる新しい方法が考案されました。これは、幾つかの層を飛び越えて、手前の層からの情報を直接奥の層に伝える経路を作るという画期的な仕組みです。奥の層へは、飛び越えてきた情報と、幾つかの層を通ってきた情報の両方が届きます。これにより、層を深くしても情報が薄れて消えてしまうことを防ぎ、学習をうまく進めることができます。残差接続を導入したニューラルネットワークは、残差ネットワークと呼ばれ、画像認識の分野に大きな革新をもたらしました。残差ネットワークは、層を深くしても学習が安定し、高い認識精度を達成できるため、現在では様々な画像認識の課題に応用されています。まさに、人工知能の分野における、重要な技術の一つと言えるでしょう。
アルゴリズム

回帰分析:未来予測の強力な手法

回帰分析とは、ある数値と別の数値の関係性を調べて、一方の数値からもう一方の数値を予測するための統計的な手法です。例えば、日々の気温とアイスクリームの売上の関係を考えると、気温が高いほどアイスクリームの売上も増える傾向があると予想されます。回帰分析を使うことで、この関係性を数値的に捉え、気温からアイスクリームの売上を予測することができるようになります。 回帰分析は、教師あり機械学習という分野でよく使われています。教師あり機械学習とは、過去のデータから規則性やパターンを学び、それを元に未知のデータについて予測を行う手法のことです。回帰分析では、過去のデータにおける数値の関係性を分析し、その関係性を表す数式(モデル)を作ります。この数式を用いることで、新たな数値が与えられた際に、対応する数値を予測することが可能になります。 回帰分析には様々な種類がありますが、最も基本的なものは線形回帰分析です。線形回帰分析は、二つの数値の関係性を直線で表そうとする手法です。気温とアイスクリームの売上の例で言えば、気温を横軸、売上を縦軸としたグラフ上に点をプロットし、それらの点に最もフィットする直線を求めます。この直線が、気温と売上の関係性を表すモデルとなります。 回帰分析は、様々な分野で広く活用されています。例えば、企業では将来の売上予測や需要予測、株価予測などに用いられています。また、医療分野では、患者の症状から病気の進行を予測したり、治療の効果を予測したりする際に利用されています。さらに、科学研究では、実験データの分析や現象の予測にも活用されています。このように、回帰分析はデータに基づいて未来を予測するための強力なツールであり、様々な分野で重要な役割を担っています。
アルゴリズム

バンディットアルゴリズムとは?探索と活用を初心者向けに解説

近頃では、誰もが手軽に情報を得たり、発信したりできるようになりました。その結果、様々な情報やデータが溢れかえっています。これらをうまく活用することで、私たちの暮らしは便利になり、より豊かなものへと変化しています。しかし、新しい商品やサービスを作ろうとするとき、必ずしも十分な情報やデータがあるとは限りません。むしろ、情報がほとんどない状態から開発を始めなければならないことも珍しくありません。 このような、情報が不足している状況で、どのようにすれば最適な方法を見つけられるのでしょうか。限られた情報から、試行錯誤を通じて最良の選択を探っていく方法の一つとして、「バンディットアルゴリズム」と呼ばれる手法が注目されています。バンディットアルゴリズムは、元々カジノにあるスロットマシン、通称「ワンハンド・バンディット」に由来します。複数のスロットマシンから、どのマシンで遊べば最も多くの報酬を得られるかを、限られた試行回数で見つけるという問題です。 この考え方を応用すれば、様々な場面で最適な選択を見つけるのに役立ちます。例えば、ウェブサイトに複数の広告を掲載する場合を考えてみましょう。どの広告が最も効果的かは、実際に表示してみなければわかりません。しかし、表示回数を無駄にすることなく、最もクリックされる可能性の高い広告を見つけたいところです。このような状況で、バンディットアルゴリズムは効果を発揮します。限られた表示回数の中で、様々な広告を試しながら、クリック率の高い広告に絞り込んでいくことで、全体的なクリック数を最大化することができるのです。 このように、バンディットアルゴリズムは、情報が不足している状況下でも、探索と活用のバランスを取りながら、最適な選択を見つけるための強力な道具となります。限られた情報から最良の結果を導き出すために、様々な分野で活用が期待されています。
アルゴリズム

再現率:機械学習の精度を測る

「再現率」とは、機械学習の出来栄えを測る物差しの一つで、見つけ出すべきものを見つける能力を表す数値です。たとえば、病気の人を診断する機械があるとします。実際に病気の人がいる中で、機械が正しく病気だと判断できた人の割合が再現率です。言い換えると、本当に病気の人を見落とさずに、どれだけ捉えられているかを示す大切な数値です。 この数値は、0から1までの間の値で表され、1に近いほど性能が良いとされます。理想的には1、つまり100%を目指しますが、現実的には他の要素との兼ね合いも考える必要があるため、必ずしも100%を目指すことが最良とは限りません。たとえば、病気ではない人を誤って病気と診断してしまう可能性も考慮に入れる必要があります。 再現率が高いほど、見落としは少なくなりますが、その分、本来は病気ではない人を病気と診断する可能性も高まることがあるのです。これは、魚を捕る網の目を大きくする様子に似ています。網の目を大きくすれば多くの魚を捕まえられますが、同時に小さな魚も逃してしまいます。逆に、網の目を小さくすれば小さな魚も捕まえられますが、大きな魚は網にかかりません。つまり、状況に応じて適切な網の目、つまり適切な再現率を設定する必要があるのです。 具体的な例として、迷惑メールの判別を考えてみましょう。再現率の高い判別機は、ほとんどの迷惑メールを正しく迷惑メールと判断できます。しかし、普通のメールを迷惑メールと誤って判断する可能性も高くなります。逆に、再現率の低い判別機は、普通のメールを誤って迷惑メールと判断する可能性は低くなりますが、多くの迷惑メールを見逃してしまう可能性があります。このように、再現率は、他の要素とのバランスを考えながら調整する必要がある大切な指標です。
アルゴリズム

ラッソ回帰:スパースなモデル推定

{ラッソ回帰とは、統計学や機械学習の分野で、予測のために使われる手法です。}たくさんのデータから、ある値を予測したい時に役立ちます。例えば、家の広さや築年数から家の価格を予測したり、気温や湿度からアイスクリームの売上を予測したりするといった具合です。 ラッソ回帰は、重回帰分析という手法とよく似ています。重回帰分析では、予測したい値に影響を与える要素(説明変数)それぞれに、どれくらい影響力があるかを示す重み付けを行います。しかし、説明変数が多すぎると、重回帰分析では複雑すぎる予測モデルを作ってしまい、学習データにはよく当てはまるのに、新しいデータにはうまく当てはまらないという問題が起こることがあります。これは、まるで試験勉強で過去問だけを完璧に覚えて、新しい問題に対応できないような状態です。このような現象を過学習といいます。 ラッソ回帰は、この過学習を防ぐための工夫がされています。具体的には、重み付けの値をなるべく小さくするように調整します。不要な説明変数の重み付けはゼロに近づき、本当に必要な説明変数だけが残るため、予測モデルをシンプルにすることができます。これは、試験勉強で重要なポイントだけを絞って学習するようなものです。 このように、ラッソ回帰は過学習を防ぎ、新しいデータにも対応できる、汎化性能の高い予測モデルを構築するのに役立ちます。そのため、様々な分野で活用されているのです。
アルゴリズム

マルコフ決定過程モデル:未来予測

人は昔から、この先何が起こるかを知りたいと願ってきました。空模様や景気の動向、病気の経過など、未来を予想することは、私たちの暮らしに欠かせません。そうした中で、これから起こる不確かな出来事を踏まえて、より良い判断をするための方法として、マルコフ決定過程モデルというものに注目が集まっています。 このモデルは、現在の状況を把握し、それに基づいて最も良い行動を選ぶことで、将来の望ましい状態へ導くための指針を示してくれます。天気予報を例に考えてみましょう。明日の天気が晴れか雨かによって、傘を持っていくかどうかを判断します。現在の状況(今日の天気や気圧配置など)から明日の天気を予測し、雨が降る確率が高いと判断した場合、傘を持っていくという行動を選びます。これがマルコフ決定過程モデルの基本的な考え方です。 このモデルは、様々な分野で応用されています。ロボットの制御では、周囲の環境を認識し、最適な動作を選択することで目的を達成するために利用されます。また、在庫管理では、将来の需要を予測し、最適な発注量を決定することで在庫切れや過剰在庫を防ぎます。さらに、医療分野では、患者の状態に基づいて最適な治療方針を決定する際にも役立ちます。 マルコフ決定過程モデルの重要な特徴は、過去の履歴を考慮しないという点です。つまり、現在の状態だけに着目し、過去の状態は意思決定に影響を与えません。これは、過去の情報が必ずしも将来の予測に役立つとは限らないという考え方に基づいています。例えば、今日が晴れでも、明日が必ず晴れとは限りません。過去の天気の情報よりも、現在の気象状況を把握する方が、明日の天気を正確に予測するために重要です。このように、マルコフ決定過程モデルは、限られた情報からでも最適な意思決定を行うことを可能にする強力なツールと言えるでしょう。
アルゴリズム

活性化関数ReLUとは?仕組み・利点・注意点を初心者向けに解説

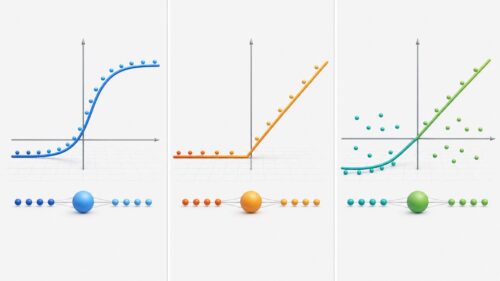
人間の脳の仕組みを模倣した人工知能技術であるニューラルネットワーク。その学習において中心的な役割を担うのが活性化関数です。 活性化関数は、ニューラルネットワークの各層に入力された信号を、ある関数に基づいて変換する働きを持ちます。この変換は、非線形変換と呼ばれるもので、これがニューラルネットワークの表現力を飛躍的に高める鍵となっています。 もし活性化関数が無く、線形変換のみが行われていたとしたらどうでしょうか。線形変換は、入力信号に比例した出力信号を生成する単純な変換です。これを幾重にも重ねたとしても、全体としては依然として線形変換にしかなりません。つまり、複雑なパターンを学習することができません。 一方、活性化関数を用いることで、ニューラルネットワークは非線形な関係性を表現できるようになります。例えば、ある活性化関数は、入力信号がある値を超えた場合にのみ大きな出力信号を生成し、それ以外の場合は小さな出力信号を生成する、といった挙動を示します。これは、生物の神経細胞が、ある一定以上の刺激を受けた場合にのみ信号を伝える仕組みに似ています。 このように、活性化関数は入力信号の強弱に応じて出力信号を調整することで、ニューラルネットワークに複雑な問題を解決する能力を与えているのです。活性化関数の種類は様々で、それぞれ異なる特徴を持っています。目的に合わせて適切な活性化関数を選ぶことで、ニューラルネットワークの性能を最大限に引き出すことができます。
アルゴリズム

A3C:並列学習で賢く強化

近頃、人のように考える機械を作る分野で、試行錯誤を通して学ぶ方法が注目されています。この方法は、様々な分野で成果を上げており、まさに時代の寵児と言えるでしょう。その中でも、A3Cと呼ばれる方法は、特に効率的に学ぶことができると評判です。この記事では、A3Cの仕組みや利点、そしてどのように使われているのかを詳しく説明します。人のように考える機械の世界を探求する上で、この記事が皆様の最初の道案内となれば幸いです。 試行錯誤を通して学ぶ方法は、まるで子供が遊びを通して成長していくように、機械も経験から学びます。具体的には、機械がある行動をとったとき、もしそれが良い結果に繋がれば褒め、悪い結果に繋がれば罰を与えます。これを繰り返すことで、機械はだんだんと良い行動をとるように学習していくのです。A3Cは、この学習過程をより早く、より賢く進めるための工夫が凝らされています。従来の方法では、一つの機械が学習した結果を次の学習に活かすという流れでしたが、A3Cでは、複数の機械が同時に学習し、それぞれの学習結果を共有することで、より効率的に学習を進めることができます。まるで、複数の生徒が互いに教え合い、共に成長していくようなイメージです。 このA3Cの利点は、学習速度の向上だけではありません。複数の機械が同時に様々な行動を試すため、より多様な可能性を探求することができ、結果として、従来の方法では思いつかないような独創的な行動を発見できる可能性も秘めています。まるで、多様な個性を持った人々が集まり、新しいアイデアを生み出す創造の場のようなものです。 そして、A3Cは既に様々な場面で使われ始めています。例えば、ゲームの攻略や、ロボットの制御、さらには資源の効率的な配分など、その応用範囲はますます広がっています。今後、A3Cがどのように進化し、私たちの生活をどのように変えていくのか、非常に楽しみです。
アルゴリズム

活性化関数ReLU:ニューラルネットワークの立役者

人間の脳は、膨大な数の神経細胞が複雑に繋がり、情報を処理しています。この神経細胞の仕組みをまねて作られたものが、人工知能で使われるニューラルネットワークです。このニューラルネットワークの中で、活性化関数は重要な役割を担っています。 活性化関数は、ニューロン(神経細胞)が受け取った情報に特定の計算を施し、次のニューロンへの出力に変換する働きをします。それぞれのニューロンは、前の層のニューロンからの出力を受け取り、それらを足し合わせた値を計算します。しかし、この値をそのまま次のニューロンに渡すだけでは、複雑な問題を解くことができません。そこで、活性化関数が登場します。活性化関数は、受け取った値を特定の関数に基づいて変換することで、ネットワーク全体の学習能力を高めるのです。 活性化関数がなければ、ニューラルネットワークは単純な直線的な関係しか表現できません。これは、複雑な曲線やパターンを学習するには不十分です。例えば、画像認識で猫と犬を見分ける場合、直線的な関係だけでは、両者の微妙な特徴を捉えることは難しいでしょう。活性化関数は、入力値と出力値の間に非線形性(直線的ではない関係)を導入することで、より複雑な表現を可能にします。これにより、ニューラルネットワークは、曲線や複雑なパターンを学習し、高度なタスクをこなせるようになります。 例えるなら、活性化関数は、料理で使う様々な調味料のようなものです。単純な材料だけでは、美味しい料理は作れません。様々な調味料を加えることで、味に深みと複雑さが生まれます。活性化関数も同様に、ニューラルネットワークに非線形性という「隠し味」を加えることで、より高度な学習を可能にしているのです。様々な種類の活性化関数があり、それぞれに特徴があります。目的に合わせて適切な活性化関数を選ぶことが、ニューラルネットワークの性能向上に繋がります。
アルゴリズム

方策勾配法とは?仕組み・価値関数との違い・活用例を解説

方策勾配法は、機械学習の一分野である強化学習で用いられる、優れた学習方法です。この方法は、ある状況下で主体となるものが、どのような行動をとるべきか、その指針となるものを直接的に学習します。この指針のことを「方策」と呼びます。 従来の強化学習の方法、例えばQ学習では、まずそれぞれの状況における行動の良し悪しを数値化したもの、すなわち価値を推定する関数を学習します。そして、その価値の良し悪しに基づいて、どの行動をとるべきかを決めていました。言ってみれば、それぞれの行動の価値を一つ一つ評価してから行動を選択していたわけです。 一方、方策勾配法は、この価値を評価する関数を用いません。方策そのものを数値で表し、その数値を調整することで、最適な方策を探索します。これは、目的地までの詳しい地図を見ながら、どの道を通れば良いか考えるのではなく、方位磁石だけを頼りに、目的地へと進んでいく様子に似ています。地図を見ずに進むため、一見すると非効率的に思えるかもしれません。しかし、複雑な状況や、様々な行動をとることができる場合、地図を作るよりも、方位磁石を頼りに進む方が、最終的に目的地に早くたどり着けることがあります。 このように、方策勾配法は、価値関数を学習する必要がないため、状況が複雑な場合や、行動の種類が多い場合に特に効果を発揮します。そのため、近年注目を集めている学習方法と言えるでしょう。
アルゴリズム

ランダムフォレストで予測精度向上

たくさんの木を組み合わせることで、より正確な予測を可能にする方法、それが「ランダムフォレスト」です。まるで森を作るように、多数の「決定木」と呼ばれる予測の仕方を用意し、それらを組み合わせて最終的な判断を下します。 一つ一つの決定木は、データの一部だけを見て学習します。まるで、全体像ではなく、断片的な情報から判断を下す専門家のようなものです。そして、それぞれの決定木が異なるデータを使って学習するため、それぞれ異なる視点、異なる判断基準を持つことになります。これは、様々な専門家の意見を聞くことと似ています。 ランダムフォレストの精度の高さは、この「多様性」から生まれます。個々の木は完璧ではありません。限られたデータで学習しているため、間違った判断をする可能性もあります。しかし、多数の木の意見を集約することで、これらの間違いを打ち消し合うことができます。多数決を取ることで、より信頼性の高い予測結果を得ることができるのです。 ランダムフォレストは、様々な場面で使われています。例えば、病気の診断や、商品の売れ行き予測、株価の変動予測など、複雑な問題を解決するために役立っています。多くの専門家の意見を総合することで、より正確な判断を下せるように、ランダムフォレストもまた、多数の決定木の知恵を集めることで、複雑な問題にも対応できる強力な予測方法となっています。まるで、森全体の知恵を活用するかのようです。 このように、ランダムフォレストは、複雑な問題を解くための強力な道具となります。多くの木を組み合わせ、それぞれの多様な視点を統合することで、単独の木では到達できない高い精度と信頼性を実現しています。
アルゴリズム

アムダールの法則とは?並列処理の限界と高速化率をわかりやすく解説

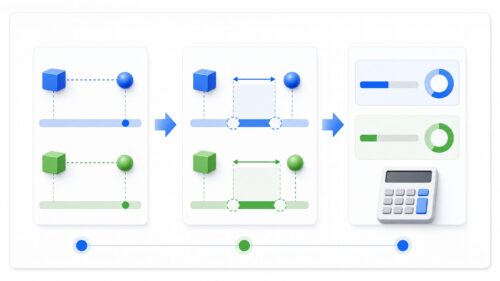
計算機の処理を速くするには、複数の処理装置を同時に使って仕事を分担させる方法があります。これを並列処理と言います。もし全ての処理を分担できたら、処理装置の数だけ処理速度も上がるはずです。しかし、実際にはプログラムの一部は分担できない場合があります。例えば、処理の最初と最後で必要な準備やまとめの作業などです。アムダールの法則は、このような並列処理による速度向上の限界を計算する方法です。この法則は、計算機の処理全体を分担できる部分と分担できない部分に分け、分担できる部分の割合と処理装置の数を使って、どれだけ処理速度が向上するかを計算します。 具体的には、全体の処理時間を1とした時、分担できる部分をP、分担できない部分を1-Pと表します。そして、N個の処理装置を使った場合の処理時間は、分担できない部分の処理時間1-Pと、分担できる部分の処理時間PをNで割ったものの和で表されます。つまり、1-P + P/N が並列処理後の処理時間です。元の処理時間は1なので、並列処理によって処理速度がどれだけ向上したかは、1をこの処理時間で割ることで計算できます。これがアムダールの法則です。 この法則を使うことで、処理装置の数を増やしても、分担できない部分のせいで速度向上には限界があることが分かります。例えば、プログラムの半分しか分担できない場合、処理装置をどれだけ増やしても、処理速度は2倍以上にはなりません。この法則は、1967年にジーン・アムダール氏によって提唱されました。当時から並列計算は行われていましたが、現代のように多くの処理装置を使った大規模な並列計算が当たり前になった現在においても、アムダールの法則は処理速度向上のための指針となる重要な法則です。プログラムを設計する際には、アムダールの法則を念頭に置いて、並列処理に適した構造にすることが重要です。そうすることで、処理装置の数を増やしたときに、より効果的に処理速度を向上させることができます。
アルゴリズム

Actor-Criticとは?強化学習の仕組みと使いどころをわかりやすく解説

「行動主体」と「評価主体」は、難しい問題を解くための協力する二人組のようなものです。これは、試行錯誤を通じて学習する「強化学習」という方法で使われています。この方法では、「行動主体」は現在の状況に応じてどのような行動をとるかを決定する役割を担います。例えば、迷路にいるロボットの場合、「行動主体」は、右に曲がるか、左に曲がるか、まっすぐ進むかなどを決めます。「評価主体」は、「行動主体」が選択した行動の良し悪しを評価する役割を担います。ロボットが右に曲がって袋小路に入ってしまった場合、「評価主体」は低い点数をつけます。反対に、ロボットが左に曲がって出口に近づいた場合、「評価主体」は高い点数をつけます。「行動主体」は、「評価主体」から受け取った点数に基づいて、自分の行動を改善していきます。最初はランダムに動くロボットも、「評価主体」からの点数が高い行動を繰り返すことで、徐々に正しい道を選べるようになります。 「評価主体」は、環境からの報酬を基に評価基準を洗練させていきます。例えば、ロボットが迷路の出口に到達すると、大きな報酬が与えられます。この報酬を基に、「評価主体」は出口に近い行動ほど高い点数をつけるように評価基準を調整します。このように、「行動主体」と「評価主体」は互いに影響を与えながら学習を進めます。「行動主体」は「評価主体」の評価を参考にしながら行動を改善し、「評価主体」は環境からの報酬を参考にしながら評価基準を洗練させます。この二人組が協力することで、迷路を解くような複雑な問題に対する最適な行動を見つけ出すことが可能になります。まるで、先生と生徒のように、互いに教え合い、学び合う関係と言えるでしょう。「評価主体」はまるで先生のように、「行動主体」である生徒に適切な助言を与え、生徒は先生の助言を参考にしながら、より良い行動を学習していくのです。
アルゴリズム

Rainbowとは?DQNを拡張した強化学習手法をわかりやすく解説

虹のように鮮やかな七色の技術を組み合わせた手法、それが2017年に発表された画期的な深層強化学習の手法、「レインボー」です。この手法は、まるで七色の光が混ざり合って美しい虹を作り出すように、七つの優れた要素技術を組み合わせることで、目覚ましい成果を生み出しています。その七つの要素技術とは、「ディーキューエヌ」と呼ばれる基本技術を土台として、「ダブルディーキューエヌ」「デュエリングネットワーク」「マルチステップラーニング」「ノイジーネットワーク」「カテゴリカルディーキューエヌ」、そして「優先度付き経験再生」です。これらの要素技術は、それぞれ単独でも高い性能を示しますが、「レインボー」はこれらを統合することで、個々の技術の力を最大限に引き出し、より高いレベルへと押し上げています。 「ディーキューエヌ」は、過去の経験から学習する強化学習の手法で、「レインボー」の基礎となっています。「ダブルディーキューエヌ」は、学習の安定性を高める工夫を加えた技術です。「デュエリングネットワーク」は、行動の価値と状態の価値を分けて学習することで、より効率的な学習を実現します。「マルチステップラーニング」は、将来の報酬を予測することで、より長期的な視点での学習を可能にします。「ノイジーネットワーク」は、学習過程にわざとノイズを加えることで、より頑健な学習を実現します。「カテゴリカルディーキューエヌ」は、報酬の分布を学習することで、より正確な予測を行います。そして「優先度付き経験再生」は、重要な経験を優先的に学習することで、学習効率を向上させます。 これらの七つの技術は、それぞれ異なる側面から深層強化学習の性能向上に貢献します。「レインボー」は、これらの技術を巧みに組み合わせることで、まるで七色の光が一つになって輝く虹のように、個々の技術の力を最大限に発揮させ、調和させています。その結果、「レインボー」は従来の手法を凌駕する性能を達成し、深層強化学習の新たな可能性を示しました。まさに、七色の技術が織りなす虹色の輝きが、深層強化学習の未来を明るく照らしていると言えるでしょう。
アルゴリズム

条件付き生成:狙ったデータを生成

条件付き生成とは、指定した条件を満たすようなデータを作り出す技術のことです。これは、まるで絵描きに「赤い夕焼けを描いてください」と注文するように、作り出す物に具体的な指示を与え、望み通りのものを手に入れるようなものです。これまでのデータ生成技術では、作り出されるものは偶然に左右されていましたが、条件付き生成では作り出されるものの特徴を細かく調整できます。 例えば、笑顔の顔画像だけを作りたい、あるいは悲しい顔画像だけを作りたいといった場合に、従来の技術ではたくさんの画像の中から目的のものを探し出す必要がありました。しかし、条件付き生成を用いれば、最初から笑顔の画像だけ、あるいは悲しい顔画像だけを作り出すことができるのです。これは特定の条件に合ったデータを集めるのが難しい場合に特に役立ちます。 この技術は、画像だけでなく、音楽や文章など様々なデータの作成にも利用できます。例えば、明るい雰囲気の音楽を作りたい、あるいは特定のテーマに関する文章を書いて欲しいといった場合にも、条件付き生成は力を発揮します。作りたいものに合わせて条件を指定することで、欲しいデータを効率よく作り出せるのです。 このように、条件付き生成は人工知能が私たちの意図をより深く理解し、それに応じた結果を返すことを可能にします。これは、人工知能がより人間に寄り添った存在となるために、極めて重要な技術と言えるでしょう。
アルゴリズム

REINFORCEとは?方策勾配法の仕組みをわかりやすく解説

機械学習の世界では、様々な方法で学習を行います。その中で、試行錯誤を通じて学習する手法を強化学習と言います。人間の子供がおもちゃで遊ぶうちに、どのようにすればうまく操作できるかを覚えていく過程に似ています。目的は、長い目で見て最も良い結果が得られる行動の仕方を見つけることです。 この行動の仕方を指針、つまり手順書のようにまとめて「方策」と呼びます。方策には、ある状況でどのような行動をとるべきかが記されています。例えば、迷路で行き止まりに突き当たったら、引き返すという指示が方策に含まれているかもしれません。強化学習では、この方策をより良いものへと改良していくことが重要です。 強化学習を実現するための手順は様々ありますが、その中でも「REINFORCE」は基本的な手法の一つです。REINFORCEは、方策勾配法という種類の学習方法に属します。方策勾配法の特徴は、行動の価値を評価するのではなく、方策そのものを直接的に調整していく点にあります。価値とは、ある行動をとった時にどのくらい良い結果が期待できるかを数値で表したものです。REINFORCEは、価値を介さずに、試行錯誤を通じて得られた結果をもとに、方策を少しずつ修正していくことで、最適な行動を見つけることを目指します。これは、まるで職人が経験を通して技術を磨いていくように、試行錯誤と改善を繰り返すことでより良い方策を学習していくのです。
アルゴリズム

拡散モデル:画像生成の新潮流

近ごろの科学技術の進歩は大変目覚ましく、中でも人のように考える機械による絵を描く技術の進歩には驚くばかりです。まるで写真のように現実そっくりな絵や、絵本に描かれるような想像上の絵まで、様々な種類の絵を描くことができるようになり、多くの人々が注目しています。この技術の中心となるのが「拡散模型」と呼ばれる方法です。この拡散模型は、どのようにして絵を描いているのでしょうか。これから、その仕組みや良い点、これからの可能性について、順番に説明していきます。 まず、拡散模型の絵を描く手順を見てみましょう。この方法は、霧が晴れていく様子を逆回しにしたような工程を経て絵を描きます。最初に、全体がぼんやりとした霧のような状態から始めます。この霧のような状態には、様々な絵を描くための情報が隠されています。そこから少しずつ霧を晴らしていくように、隠された情報を明らかにしていくことで、最終的に目指す絵が浮かび上がってくるのです。この霧を晴らす過程は、まるで彫刻家が石を削って作品を仕上げていくように、不要な情報を削り落としていく作業に似ています。 拡散模型を使うことの利点の一つは、様々な種類の色や形、模様などを組み合わせた、複雑な絵を描くことができる点です。例えば、実在する動物と空想上の生き物を組み合わせたり、現実には存在しない風景を作り出したりすることも可能です。また、写真のように精密な絵だけでなく、水彩画や油絵のような、様々な画風の絵を描くこともできます。このように、拡散模型は絵を描く人の創造性を大きく広げる力を持っています。 今後、この技術はさらに進歩し、私たちの生活をより豊かにしていくと考えられます。例えば、映画やゲームの制作現場では、よりリアルで迫力のある映像を作り出すために役立つでしょう。また、広告やデザインの分野でも、人々の目を引く斬新な作品を生み出すことができるでしょう。さらに、医療の分野では、体の内部の状態をより正確に把握するための画像診断技術の向上にも貢献することが期待されています。このように、拡散模型は様々な分野で活用され、私たちの未来を大きく変える可能性を秘めているのです。
アルゴリズム

行動価値関数で最適な行動を探る

行動価値関数は、強化学習においてとても大切な考え方です。強化学習とは、機械学習の一種であり、機械が周りの環境と触れ合いながら、試行錯誤を通して物事を覚えていく方法です。この学習する者を「エージェント」と呼びます。エージェントは、ある状況の中でどのような行動をすれば良いのかを学び、その行動の結果として得られる報酬を最大化しようとします。行動価値関数は「ある状況で、特定の行動をとった時に、将来にわたってどれだけの報酬をもらえるか」という期待値を表す関数です。つまり、ある状況と行動の組み合わせに対して、どれだけの価値があるのかを評価する指標となります。 たとえば、迷路の中でエージェントが右に進むか左に進むかを考えなければならないとします。右に行けばチーズにたどり着けるかもしれませんが、左に行けば猫に出会うかもしれません。この時、行動価値関数は、右に行く行動と左に行く行動にそれぞれどれだけの価値があるのかを数値で示します。チーズは大きな報酬に繋がり、猫は報酬を減らすので、右に行く行動の価値は高く、左に行く行動の価値は低くなります。 エージェントは、この行動価値関数を基に行動を選択します。もし関数が正確であれば、エージェントは常に最も価値の高い行動、つまり最大の報酬が期待できる行動を選びます。逆に、関数が不正確であれば、エージェントは間違った行動を選び、報酬を最大化できません。そのため、この関数を正しく見積もることが、エージェントが最適な行動を選ぶために非常に重要です。 行動価値関数の推定方法は様々で、それぞれの方法に利点と欠点があります。より良い推定方法の研究は、強化学習分野における重要な課題の一つです。
アルゴリズム

Q学習:試行錯誤で学ぶAI

機械に学習をさせる方法は、この情報化社会において様々な分野で研究開発が進められています。その学習方法の中でも、強化学習は特に注目を集めているものの一つです。強化学習とは、人間が様々な経験を通して学習していくように、機械も周りの状況と関わり合いながら、一番良い行動を学習していく方法です。 この強化学習の代表的な方法の一つに、今回ご紹介するQ学習があります。Q学習は、様々な分野で活用されており、その応用範囲は実に多様です。例えば、ゲームの攻略方法を学習させたり、機械仕掛けの人形を思い通りに動かす制御に使われたり、あるいは商品の広告をより効果的に配信するために活用されたりしています。 Q学習では、行動の価値を数値で表す「Q値」というものを用います。機械は、様々な行動を試してみて、その結果得られる報酬と、その行動を取った後の状態でのQ値を元に、現在の状態でのQ値を更新していきます。この更新を繰り返すことで、機械はどの行動が最も高い報酬に繋がるかを学習し、最適な行動を選択できるようになるのです。 Q学習は、試行錯誤を通して学習を進めるため、事前に正解を用意する必要がありません。そのため、複雑な状況や未知の環境に対しても、柔軟に適応することができます。また、比較的単純な仕組みで実装できるため、様々な分野への応用が容易である点も大きな特徴です。 このように、Q学習は、機械学習の中でも特に注目される技術であり、今後の発展が期待される分野です。人間のように学習する機械の実現に向けて、Q学習は重要な役割を担っていると言えるでしょう。
アルゴリズム

RSEとは?予測精度を割合で見る指標の計算式と使い方

「相対絶対誤差」は、統計学や機械学習の世界で、予測モデルの良し悪しを測る物差しの一つです。この物差しは、「RSE」と呼ばれています。RSEとは、予測した値と実際の値のズレを、実際の値と比べた割合で表すものです。 例えば、千円の品物を九百円と予測した場合と、百円の品物を九十円と予測した場合を考えてみましょう。どちらも百円の外れですが、RSEを使うと、どちらの場合も誤差の割合は同じ、つまり十分の一だということが分かります。これは、予測するものの値段が高くても安くても、同じようにモデルの正確さを比べることができるということを意味します。 従来の測り方では、扱う数字が大きい場合、誤差も大きく見えてしまい、逆に扱う数字が小さい場合、誤差も小さく見えてしまうため、異なる規模のデータを見比べるのが難しいという問題がありました。RSEを使うことで、この問題を解決し、規模が違っても、モデルの正確さをきちんと比べることができるようになります。 さらに、RSEは百分率で表すことが簡単です。例えば、十分の一は十パーセントと表せます。このように、RSEは分かりやすく、直感的に理解しやすい指標として、モデルの評価に役立ちます。百円のものを九十円と予測すれば誤差は十パーセント、千円のものを九百円と予測しても誤差は十パーセントと、同じように評価できるのです。このように、RSEは、予測するものの規模に左右されずに、モデルの性能を測るための、便利で分かりやすい指標と言えるでしょう。