アルゴリズム
白色化とは?標準化との違いとデータ前処理での使い方
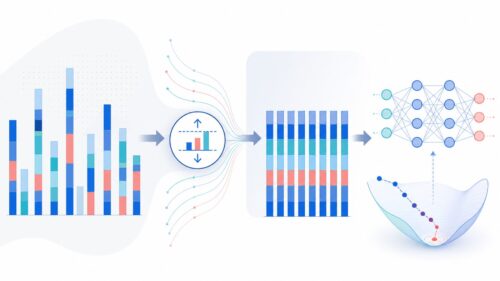
白色化とは、データの前処理における重要な手法で、データの性質を調整し、分析や機械学習をより効果的に行うためのものです。具体的には、複数の数値データ群を扱う際、それぞれの数値データが互いに影響し合わないようにし、さらに個々の数値データのばらつき具合を揃えることで、データ本来の持つ特徴を捉えやすくします。白色化は主に二つの段階に分かれています。
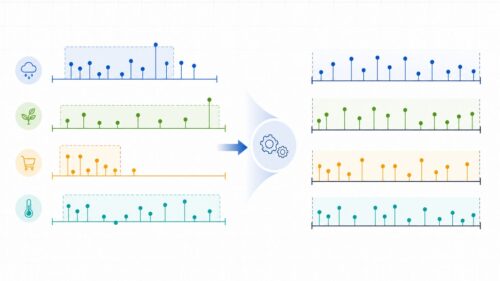
まず、データの無相関化です。データの各要素が互いに関連性を持っている場合、その関連性が分析や学習の妨げになることがあります。例えば、気温とアイスクリームの売上高は正の相関を持つと考えられますが、この相関関係は、気温以外の要因、例えば広告効果などを見えにくくしてしまう可能性があります。無相関化は、このような要素間の関係性をなくし、それぞれの要素が独立した情報を持つように変換する処理です。
次に、標準化(正規化)を行います。無相関化されたデータの平均値をゼロ、ばらつきの度合いを示す分散を1に揃えます。これは、異なる種類のデータを比較しやすくするために重要です。例えば、あるデータの範囲が0から100で、別のデータの範囲が-1から1の場合、単純に比較することは難しいです。標準化によって、異なるデータのスケールを統一し、比較や分析を容易にします。
画像認識の例を挙げると、隣り合う画素は色の値が似通っていることが多く、強い相関があります。この相関をそのままにしておくと、機械学習モデルは画素間の関係性に引っ張られ、本来捉えるべき画像の特徴を見失う可能性があります。白色化によって画素間の相関をなくし、個々の画素の色の値を標準化することで、モデルは画像の重要な特徴をより正確に学習できます。このように、白色化は、画像認識だけでなく、金融データ分析など、様々な分野でデータの質を高めるために利用されており、データ分析や機械学習において重要な役割を担っています。