AIサービス

音声で顧客の心を知る技術

近ごろの技術の進歩には目を見張るものがあり、中でも人工知能という分野は私たちの暮らしに大きな変化を与えています。特に、人の言葉を理解する技術は大きく進み、まるで人と話しているかのような自然なやり取りができるようになってきています。この技術の中心となるのが「意図理解」です。意図理解とは、人が話す言葉の表面的な意味だけでなく、その奥にある真意や目的を読み解く力のことを指します。 例えば、お店のお客様が商品について尋ねている時、「使い方がよくわからない」という言葉を発したとします。この時、お客様はただ単に使い方の説明を求めているだけではないかもしれません。もしかしたら、商品に対して不安を感じていたり、不満を抱えていたりする可能性も考えられます。意図理解とは、このような隠れた気持ちや求めていることを汲み取り、より適切な対応をすることを可能にするのです。 例えば、AIを搭載した案内係のロボットが駅に設置されたとしましょう。ロボットに「ここから近いトイレはどこですか?」と尋ねたとします。するとロボットは単に最寄りのトイレの場所を教えるだけでなく、「お客様はお急ぎでしょうか?」と尋ね返したり、トイレの混雑状況を伝えたり、多機能トイレの有無を知らせたりするかもしれません。これは、利用者が「トイレに行きたい」という表面的な欲求だけでなく、「早くトイレに行きたい」「空いているトイレに行きたい」「車椅子で入れるトイレを探している」といった、言葉の裏に隠された真の目的を理解しているからです。 このように、意図理解は私たちの暮らしをより便利で快適なものにするために欠かせない技術と言えるでしょう。今後、この技術がさらに発展していくことで、人と機械とのコミュニケーションはより円滑になり、さまざまな場面で私たちの生活を支えてくれると期待されます。
AIサービス

CanvaのAI音楽生成サービスSoundrawとは?使い方・著作権・活用例を解説

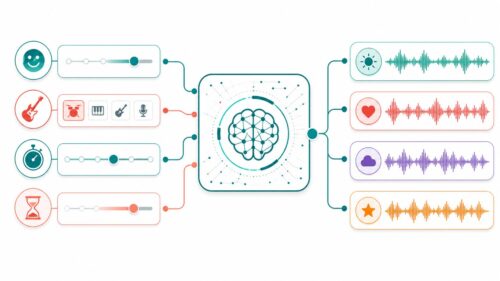
近年の技術の進歩は目覚ましく、様々な分野に大きな影響を与えています。中でも、人工知能の進歩は目覚ましく、音楽を作る分野にも大きな変化をもたらしています。これまで、作曲や演奏をするには専門的な知識や技術が必要で、高度な機材も必要でした。そのため、音楽を作る楽しみは一部の人に限られていました。しかし、人工知能を使った新しいサービスが登場したことで、誰でも手軽に音楽を作ることができるようになりました。 Canvaが提供するSoundrawは、そのような革新的なサービスの一つです。Soundrawは人工知能を使って音楽を作るサービスで、誰でも手軽に自分の音楽を作ることができます。使い方はとても簡単で、まず作りたい音楽の種類を選びます。例えば、楽しい雰囲気の曲や落ち着いた雰囲気の曲など、様々な種類から選ぶことができます。次に、曲の長さやテンポなどを決めます。さらに、楽器の種類や曲調なども細かく設定することができます。 これらの設定が終わると、Soundrawの人工知能が自動的に音楽を作り出します。まるで魔法のようです。しかも、出来上がった音楽は著作権フリーなので、自由に使うことができます。動画の背景音楽にしたり、お店のBGMにしたり、様々な場面で活用することができます。従来の方法で音楽を作ろうとすると、作曲家や演奏家に依頼したり、自分で楽器を演奏したりする必要がありました。時間も費用もかかりますし、技術的な知識も必要でした。しかし、Soundrawを使えば、誰でも簡単に、しかも低価格で高品質な音楽を作ることができます。 Soundrawは、音楽を作る喜びを多くの人に広げる画期的なサービスと言えるでしょう。人工知能の技術は日々進歩しており、今後さらに高度な音楽制作が可能になるでしょう。音楽の世界はますます広がり、誰でも自分の創造性を自由に表現できる時代が到来しています。
アルゴリズム

ROC曲線とAUCとは?意味・仕組み・活用例をわかりやすく解説

「受信者動作特性曲線」を縮めて「ROC曲線」と呼びます。これは、二つの選択肢から一つを選ぶ問題で、作った予測の仕組みの良し悪しを確かめるために使われる図です。この図は、縦軸と横軸にそれぞれ特別な割合を示すことで描かれます。縦軸は「真陽性率」と呼ばれ、実際に正解が「陽性」であるものの中で、正しく「陽性」と予測できたものの割合を示します。例えば、病気の人を診断する際に、実際に病気の人の中で、正しく病気だと診断できた人の割合です。横軸は「偽陽性率」で、実際は正解が「陰性」であるものの中で、間違えて「陽性」と予測してしまったものの割合を指します。病気でない人を診断する際に、健康な人の中で、誤って病気だと診断してしまった人の割合です。 ROC曲線は、これらの割合を使うことで、予測の仕組みがどれくらい正確に「陽性」と「陰性」を区別できるかを目に見える形で示してくれます。この曲線は、様々な判定の基準での予測の仕組みの働きを一度にまとめて見せてくれます。判定の基準とは、例えば、ある検査値を境に病気か健康かを判断する場合の、その境目の値のことです。ROC曲線は、この境目の値を変えたとき、予測の仕組みの働きがどう変わるかを曲線で表しています。ROC曲線を見ることで、特定の境目の値に左右されずに、予測の仕組み全体の良し悪しを理解できるのです。つまり、様々な状況に対応できる予測の仕組みかどうかを判断するのに役立ちます。これは、様々な状況で使える、より信頼性の高い予測の仕組みを作るために非常に重要な情報となります。
LLM

AIのハルシネーションとは?原因・具体例・対策をわかりやすく解説

近ごろ、人工頭脳の著しい進歩に伴い、様々な場所で活用が進んでいます。ものの、人工頭脳はなんでもできるわけではなく、時として人が驚くような間違いを起こすことがあります。特に注目されているのが「幻覚」と呼ばれる現象です。まるで幻覚を見ているかのように、人工頭脳が事実に基づかない情報を作り出してしまうこの現象は、人工頭脳開発における大きな課題となっています。人工頭脳が社会に深く入り込んでいく中で、幻覚の理解はますます大切になっています。 この幻覚は、人工頭脳が学習したデータに偏りがあったり、学習データが不足していたりする場合に発生しやすくなります。例えば、特定の人物や物事に関する情報ばかりを学習した場合、それ以外の情報について問われると、学習データに基づかない不正確な情報を生成してしまう可能性があります。また、大量のデータを学習したとしても、そのデータの中に誤った情報が含まれていた場合、人工頭脳はそれを正しい情報として認識し、幻覚を引き起こす原因となることがあります。 この幻覚は、様々な問題を引き起こす可能性があります。例えば、ニュース記事を生成する人工頭脳が幻覚を起こした場合、事実に基づかない誤った情報が拡散される危険性があります。また、医療診断を支援する人工頭脳が幻覚を起こした場合、誤診につながり、患者の健康を脅かす可能性も考えられます。このように、人工頭脳の幻覚は、社会に大きな影響を与える可能性があるため、早急な対策が必要です。 幻覚への対策としては、学習データの質と量を向上させることが重要です。偏りのない、多様なデータを用いて人工頭脳を学習させることで、幻覚の発生率を抑制することができます。また、人工頭脳が生成した情報が正しいかどうかを検証する仕組みを導入することも有効です。人が生成された情報をチェックしたり、他の情報源と照らし合わせたりすることで、幻覚による誤りを防ぐことができます。人工頭脳が社会にとってより良いものとなるよう、幻覚への理解を深め、対策を進めていく必要があります。
その他

系統図法とは?目的と手段を整理する作り方・具体例を解説

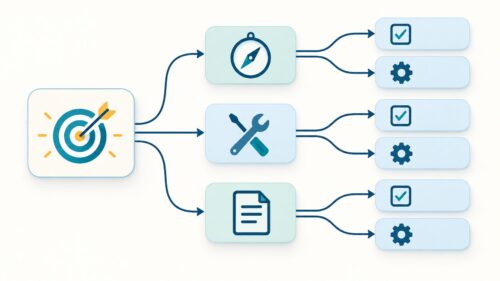
系統図法とは、込み入った事柄を整理して、分かりやすく示す方法の一つです。ちょうど、木の幹から枝や葉が広がるように、大きな目的から細かい行動へと段階的に分けていくことで、全体像を掴みやすくします。上位の目的を達成するためには、どのような手段が必要なのかを階層構造で示すことで、それぞれの繋がりを明らかにすることができます。 例えば、会社の新しい事業計画を立てるときに、系統図法を使うと、最終目標を達成するために必要な個々の業務や手順を明確に示すことができます。まず、事業計画全体の目標を一番上に置き、その目標を達成するために必要な大きな項目をいくつか下に書き出します。さらに、それぞれの項目を達成するためにはどのような具体的な行動が必要なのかを、さらに下に書き加えていきます。このように、大きな目標から小さな行動へと段階的に展開していくことで、計画全体を分かりやすく示し、関係者全員が同じ認識を持つことができます。 また、系統図法は、問題解決にも役立ちます。例えば、製品の不良率が高いという問題が発生したとします。この問題の原因を探るために、系統図法を用いて、考えられる原因を階層構造で書き出していきます。まず、不良率が高いという問題を一番上に置き、その下に考えられる大きな原因をいくつか書き出します。そして、それぞれの原因をさらに細かく分けて、具体的な要因を特定していきます。このように、問題の原因を階層構造で分解していくことで、根本原因を特定しやすくなり、効果的な対策を立てることができます。系統図法は、図解としてだけではなく、考えを整理し、新しい考えを生み出すための大切な道具と言えるでしょう。
LLM

位置エンコーディングとは?Transformerに順序を教える仕組みを解説

近ごろ、言葉を扱うコンピューター技術が大きく進歩し、まるで人間のように文章を理解したり、文章を作ったりする人工知能が現実のものになりつつあります。この進歩を支えている技術の一つに、「変形する器」という意味を持つ「トランスフォーマー」と呼ばれる仕組みがあります。このトランスフォーマーは、文章の中の単語同士の関係性を理解するのが得意で、外国語を私たちの言葉に翻訳したり、新しい文章を作ったりといった作業で高い能力を発揮します。 トランスフォーマーが文章を理解する上で重要な役割を果たしているのが、「位置の情報」です。人間であれば、「太郎が花子にプレゼントを渡した」と「花子が太郎にプレゼントを渡した」のように、単語の順番が変われば意味も変わることがすぐに分かります。しかし、コンピューターにとっては、単語の順番を理解するのは簡単ではありません。そこで、単語の位置情報をコンピューターに教えるために、「位置符号化」と呼ばれる技術が使われます。この位置符号化を理解することは、トランスフォーマーの仕組みを理解する上で欠かせません。 では、位置符号化とは一体どのようなものでしょうか?簡単に言うと、位置符号化とは、各単語が文章のどの位置にあるのかを数値で表したものです。例えば、「今日、私は学校へ行く」という文章があるとします。「今日」は一番最初の単語なので「1」、「私」は二番目の単語なので「2」、というように、それぞれの単語に番号を振っていきます。そして、この番号を基に、三角関数などを用いて特別な計算を行い、各単語に位置を表す固有の数値を割り当てます。 このようにして作られた位置情報は、トランスフォーマーが文章の意味を理解するために重要な役割を果たします。位置情報がないと、トランスフォーマーは単語の順番を無視してしまい、文章の意味を正しく理解することができません。この記事では、位置符号化とは何か、なぜ必要なのか、そしてどのように計算されるのかについて詳しく説明しました。これらを理解することで、トランスフォーマーの仕組みをより深く理解できるようになるでしょう。
学習

層を飛び越す技術:スキップコネクション

人工知能の分野でよく耳にする、層を飛び越える接続、いわゆるスキップコネクションについて詳しく説明します。 人工知能の中核を担うニューラルネットワークは、人間の脳の神経回路を模倣した構造を持ち、多くの層が積み重なって構成されています。通常、データは入力層から出力層へと、各層を順々に通過しながら処理されます。これは、まるでバケツリレーのように、情報を一つずつ次の層へと受け渡していくイメージです。しかし、層が深くなるにつれて、情報が薄まってしまうという問題が生じることがあります。これを勾配消失問題といいます。 この問題を解決するために考案されたのが、スキップコネクションです。スキップコネクションは、ある層の出力を、後方の層に直接伝える経路を作る技術です。例えば、3番目の層の出力を5番目の層に直接加えるといった具合です。これにより、深い層の情報が浅い層にも届きやすくなります。 スキップコネクションには、幾つかの利点があります。まず、勾配消失問題の軽減です。深い層の情報が浅い層に直接伝わることで、情報の劣化を防ぎ、学習をスムーズに進めることができます。次に、学習の効率化です。スキップコネクションによって、ネットワークは複数の経路で情報を伝達できるようになり、より効率的に学習を進めることができます。さらに、スキップコネクションは、過学習を防ぐ効果も期待できます。過学習とは、学習データに過度に適応しすぎて、未知のデータに対して精度が低くなってしまう現象です。スキップコネクションは、ネットワークの構造を複雑にしすぎず、過学習のリスクを軽減するのに役立ちます。 スキップコネクションは、高速道路のジャンクションのような役割を果たします。ジャンクションによって、目的地までスムーズかつ効率的に移動できるように、スキップコネクションはニューラルネットワークにおける情報の伝達を最適化するのです。これにより、人工知能はより高度なタスクをこなせるようになります。
アルゴリズム

シャープレイ値:予測への影響

機械学習の模型は、今の時代、様々な場所で役立っています。例えば、お店のおすすめ商品表示や、病院での病気の診断、怪しい行動を見つけることなど、色々な場面で使われています。しかし、これらの模型がどのように考えて答えを出しているのか、その中身は複雑で分かりにくいことがよくあります。模型がなぜそのような結果を出したのかを理解することは、模型の正しさを確かめ、より良くしていく上でとても大切です。そこで役に立つのが「シャープレイ値」です。シャープレイ値は、複数人で遊ぶゲームの理論を応用した方法で、それぞれの要素が結果にどれだけ影響を与えているかを数字で表すことができます。つまり、模型の中身を分かりやすく説明し、なぜその答えになったのかという理由を明らかにする道具と言えるでしょう。 具体的に説明すると、シャープレイ値は、ある要素があった場合と無かった場合の結果の違いを比較することで計算されます。例えば、商品の購入予測模型で、年齢、性別、過去の購入履歴といった要素を考えるとします。シャープレイ値を計算することで、「この人は30代男性で、過去に似た商品を買っているから、この商品を買う可能性が高い」といった予測の理由を説明できます。それぞれの要素の影響度合いが数字で分かるため、どの要素が最も重要なのかが一目で分かります。もし、過去の購入履歴が最も重要な要素だと分かれば、より詳細な購入履歴データを集めることで、予測の精度をさらに向上させることができるかもしれません。また、年齢や性別の影響が小さいと分かれば、これらの要素を除外することで、模型をよりシンプルにすることも可能です。このように、シャープレイ値は模型の改善点を明らかにするためにも役立ちます。さらに、シャープレイ値を使うことで、模型の予測結果に対する説明責任を果たすことにも繋がります。なぜこの結果になったのかを明確に示すことで、利用者からの信頼を得やすくなります。これは、特に医療診断や金融取引など、重要な意思決定を支援する際に重要です。
セキュリティ

見えない脅威:クリプトジャッキング

「見えない採掘」と呼ばれるものについて、詳しく説明します。これは、知らないうちにあなたのコンピュータを仮想通貨の採掘に不正利用する行為で、まるでコンピュータの中にこっそりと入り込んだ鉱夫が、あなたの知らないうちに黙々と作業しているようなものです。この不正行為は「クリプトジャッキング」と呼ばれ、まるで忍び寄る影のように、気づかないうちに進行していくため、非常に危険です。 あなたのコンピュータが、本来の持ち主であるあなたではなく、他人の利益のために使われていると想像してみてください。貴重な計算資源を搾取され、本来のパフォーマンスを発揮できなくなってしまうのです。もし、心当たりがないのにパソコンの処理速度が遅くなったり、冷却ファンが急に激しく回り始めたりしたら、それはクリプトジャッキングの警告かもしれません。まるでコンピュータが過労で苦しんでいるかのように、発熱や動作の異常が見られることもあります。 この見えない脅威は、個人だけでなく企業にとっても大きな損失につながる可能性があります。知らないうちに資源を盗まれ、電気代を負担させられるだけでなく、業務効率の低下やシステムの不安定化といった深刻な問題を引き起こすこともあります。企業全体のネットワークがクリプトジャッキングの被害に遭えば、甚大な損害が発生することは想像に難くありません。 まるで静かに忍び寄る泥棒のように、クリプトジャッキングは私たちのデジタル生活を脅かしています。パソコンのセキュリティ対策を強化し、怪しいウェブサイトへのアクセスを避けるなど、一人ひとりが意識を高め、この見えない脅威から身を守る必要があります。まるで家の鍵をかけるように、コンピュータにも適切な対策を施すことが大切です。
学習

鞍点とは?機械学習で学習が停滞する理由と対策

馬の鞍のような形を想像してみてください。馬の背中に沿って前後に見ると、鞍の中央は最も低い位置になっています。しかし、馬の胴体に対して垂直に、左右を見ると、鞍の中央部分は盛り上がっています。まさに、ある方向から見ると谷底、別の方向から見ると山頂のように見える、これが鞍点です。 数学的に表現すると、鞍点は多次元の空間で定義された関数の特別な点です。この点の周辺のごく狭い範囲に着目すると、ある方向に進むと関数の値が増加し、別の方向に進むと減少します。二次元の平面上では、ちょうど馬の鞍のような形になります。ある方向に沿って切ると下に凸のカーブ、別の方向に沿って切ると上に凸のカーブを描きます。 この鞍点という概念は、様々な分野で登場しますが、特に機械学習の分野では重要な意味を持ちます。機械学習では、学習の目標は、ある関数の値を最小にする、あるいは最大にする最適な点を見つけることです。しかし、学習過程で鞍点に捕まってしまうと、そこが真の最適解ではないにもかかわらず、抜け出せなくなる可能性があります。なぜなら、鞍点の周辺では、どの方向に少し進んでも関数の値が良くなったり悪くなったりを繰り返すだけで、全体としては改善しないからです。まるで、山登りで頂上を目指しているのに、鞍部に留まってしまい、真の頂上に到達できないような状態です。そのため、機械学習のアルゴリズム開発では、この鞍点の問題をいかに回避するかが大きな課題となっています。
AI活用

生成AIの正確性とは?評価方法・高め方・注意点を初心者向けに解説

人工知能が作り出す情報や結果が、実際に合致した正しいものであるかどうかの程度を示すのが、正確性と呼ばれる考え方です。この正確性の度合いは、人工知能が扱う情報の種類によって大きく変わってきます。 例えば、天気予報を作り出す人工知能の場合を考えてみましょう。明日の天気が晴れと予報したのに、実際には曇りだったとしても、それほど大きな問題にはなりません。多少のずれは、許容範囲内と言えるでしょう。 しかし、医療診断や車の自動運転のように、人の命に関わる人工知能の場合はどうでしょうか。ここで結果がずれてしまうと、重大な事故につながる可能性があります。そのため、医療診断や自動運転を担う人工知能には、非常に高い正確性が求められます。少しのずれも許されない場面もあるのです。 人工知能が作り出した情報が、現実の世界とどれだけ合致しているか。これは、人工知能の正確性を測る上で、非常に重要な点です。正確性の高い人工知能を開発するためには、現実世界を正しく反映した、大量の情報を学習させる必要があります。学習データの質が、人工知能の正確性に直結すると言えるでしょう。 さらに、人工知能がどのように情報を処理し、結果を導き出すのか、その仕組みを理解することも重要です。人工知能の思考過程を透明化することで、どこで間違いが発生しやすいかを把握し、改善につなげることができます。また、利用者は人工知能の判断根拠を知ることで、その結果をより適切に利用できるようになります。 人工知能技術の進歩に伴い、様々な分野で人工知能が活用されるようになってきました。それぞれの分野で求められる正確性の水準を理解し、適切な開発と運用を行うことが、人工知能の信頼性を高め、社会への貢献へと繋がるのです。
クラウドサービス

グリッドコンピューティングとは?分散処理の仕組みと活用例をわかりやすく解説

多くの計算機を網のように繋ぎ、まるで一つの巨大な計算機であるかのように扱う技術、それが格子状計算です。これは、小さな力を持つ人々が集まり、大きな建物を建てるのに似ています。一つ一つの計算機はそれほど高性能ではないかもしれませんが、網目状の通信経路を通じて互いに連携することで、全体として強力な計算能力を持つシステムとなります。 例えば、天気予報を考えてみましょう。正確な天気予報を出すには、膨大な量の気象データを集め、複雑な計算を行う必要があります。一昔前であれば、このような計算にはスーパー計算機と呼ばれる高性能な計算機が必要でした。しかし、格子状計算を用いれば、普通の計算機を複数繋げるだけで、スーパー計算機に匹敵する計算能力を得ることができます。 また、新薬の開発にも格子状計算が役立っています。新薬の候補となる物質を探すには、膨大な数の分子構造をシミュレーションする必要があります。これは、大変な時間と計算資源を必要とする作業です。格子状計算を使えば、複数の計算機でシミュレーションを分担して行うことができるため、開発期間を大幅に短縮できます。 近年、写真や動画、文章といった電子的な情報は爆発的に増えています。従来のように、一台の計算機ですべての情報を処理するのは限界に達しつつあります。格子状計算は、こうした膨大な情報を効率よく処理するための、今後ますます重要となる技術と言えるでしょう。まるで無数の小さな歯車が噛み合って大きな力を生み出すように、格子状計算は、様々な分野で私たちの生活を支えています。
セキュリティ

データ保護の重要性:安全なAI活用

近頃、人工知能(AI)は様々な場所で大きく進歩し、私たちの暮らしを大きく変えています。家事の手伝いから会社の仕事、そして医療の現場まで、AIは幅広く使われています。このAIの中心となるのは、たくさんの情報です。そして、これらの情報の中には、個人の名前や住所、時には健康状態といった、とても大切な情報が含まれていることがよくあります。これらの情報は、もし誰かに勝手に使われたり、盗まれたりすると、大きな問題につながる可能性があります。例えば、個人の情報が勝手に使われれば、その人の生活に大きな影響が出ることがありますし、会社の機密情報が漏洩すれば、会社の信用を失墜させ、大きな損失を招く可能性があります。 AIを安全に使うためには、情報保護の大切さを理解し、しっかりとした対策を立てることが必要不可欠です。これは、AIを作る会社だけでなく、AIを使う人々にとっても同じです。AIを作る会社は、集めた情報をしっかりと守り、誰にも勝手にアクセスできないようにする必要があります。また、AIを使う人々は、どのような情報がAIに使われているのか、そしてその情報がどのように守られているのかを理解する必要があります。 具体的には、AIシステムに強力な守りを築き、外部からの不正アクセスを防ぐことが重要です。また、情報を暗号化して、たとえ情報が盗まれても、内容がわからないようにすることも重要です。さらに、誰がいつ、どの情報にアクセスしたかを記録することで、何か問題が起きたときに、すぐに原因を特定できるようにする必要もあります。 この文章では、AIを使う上で情報保護がどれほど大切かを説明し、安全性を高めるための具体的な方法について考えます。AIは私たちの生活を豊かにする力を持っていますが、その力を正しく安全に使うためには、情報保護への意識を高め、適切な対策を講じることが重要です。そうすることで、私たちはAIの恩恵を安心して享受できるようになります。
学習

情報量規準とは?AIC・BICの違いとモデル選択の考え方を解説

機械学習を行う上で、どのモデルを選ぶかは大変重要です。数多くのモデルから最適なものを選ぶ作業は、まるで迷路を進むように複雑で、容易ではありません。 モデルの良し悪しを判断する時、多くの人は正答率に注目します。正答率が高いほど良いモデルだと考えがちですが、正答率だけで判断するのは危険です。学習に使ったデータに過剰に適合したモデルは、見かけ上は高い正答率を示すことがあります。しかし、新しいデータに直面すると、その性能は著しく低下する可能性があります。これは、まるで暗記に得意な生徒が、試験問題の形式が変わると全く解けなくなるようなものです。この現象は過学習と呼ばれ、モデルが学習データの細かな特徴やノイズまでも記憶してしまうことが原因です。 本当に良いモデルとは、未知のデータに対しても安定して高い性能を発揮するモデルです。そのため、モデルを選ぶ際には、正答率だけでなく、モデルの複雑さも考慮する必要があります。複雑すぎるモデルは過学習を起こしやすく、単純すぎるモデルはデータの特徴を捉えきれません。ちょうど良い複雑さのモデルを見つけることが重要です。これは、料理で適切な量の調味料を加えるのと同じように、バランスが大切です。 最適なモデルを選ぶためには、様々な指標を組み合わせて評価し、検証用データを用いて性能を確かめる必要があります。また、交差検証などの手法を用いることで、より信頼性の高い評価を行うことができます。モデル選択は試行錯誤の繰り返しですが、適切な手順を踏むことで、データに最適なモデルを見つけることができます。
AI活用

専門特化型生成AI:ドメイン固有とは

近頃、文章や画像、音楽などを作り出す人工知能が大きな進歩を見せており、様々な場面で使われています。こういった人工知能は広く一般的な知識を学習していますが、特定の分野における専門的な知識や言い回し、文脈の理解が十分でない場合があります。特定の分野に特化した人工知能は、この点を克服するために注目を集めています。 特定の分野に特化した人工知能とは、ある特定の領域や分野に絞って学習させた人工知能のことです。医療、法律、金融など、様々な分野を専門とする人工知能が開発されています。これらの特化型人工知能は、専門分野における知識や用語、独特の言い回しを理解し、その知識に基づいて文章や応答を作り出します。 例えば、医療分野に特化した人工知能を考えてみましょう。この人工知能は、医学用語や病気に関する知識を豊富に持っています。患者の症状を説明する文章を入力すると、その症状から考えられる病気を推測したり、適切な検査方法を提案したりすることができます。これは医師の診断を補助するツールとして役立ちます。 また、法律分野に特化した人工知能もあります。法律用語や過去の判例に関する知識を大量に学習しており、法的紛争が生じた際に過去の判例を参考にしながら、どのような法的措置を取るのが適切かをアドバイスすることができます。 このように、特定の分野に特化した人工知能は、その分野に特化することで、より正確で専門性の高い結果を生み出すことができます。これは、人工知能が様々な専門分野で活躍するための重要な一歩と言えるでしょう。
セキュリティ

クリックジャッキングの脅威

画面に見えるものだけが真実とは限りません。インターネットの世界には、「クリックジャッキング」と呼ばれる、巧妙な罠が仕掛けられていることがあります。まるで忍者が巧みに仕掛けた罠のように、気づかぬうちに危険な目に遭う可能性があるのです。 クリックジャッキングは、ユーザーの意図しない操作をさせるための悪意ある手法です。例えば、信頼できるホームページ上に表示されたボタンやリンクをクリックしたとします。一見、普段通りの操作に思えますが、実は背後に透明な悪意のあるホームページが重ねて表示されているかもしれません。ユーザーは気づかぬまま、その透明なホームページ上でクリック操作を行い、意図しないまま不正な操作を実行させられてしまうのです。まるで澄んだ水面下に隠された鋭い岩のように、クリックジャッキングは見えない危険を潜ませています。 具体的には、動画の再生ボタンや「いいね」ボタンなど、よく利用されるボタンが狙われます。悪意あるホームページは、これらのボタンと全く同じ形をした透明なボタンを、ユーザーがクリックするであろう位置に重ねて配置します。ユーザーが安心してボタンをクリックすると、実際には背後に隠された悪意のあるホームページのボタンをクリックしたことになり、知らないうちに個人情報を盗まれたり、望まない商品を購入させられたりする可能性があります。 この罠を見破るのは非常に困難です。なぜなら、悪意のあるホームページは透明で見えないように設計されているからです。そのため、ユーザーは自分が騙されていることに気づきにくく、被害に遭ってしまうのです。まるで熟練の忍者が気配を消して罠を仕掛けるように、クリックジャッキングは静かに、しかし確実にユーザーを狙っています。 このような危険から身を守るためには、信頼できるホームページのみを利用すること、不審なリンクはクリックしないこと、そしてセキュリティソフトを導入することが重要です。インターネットの世界は便利である一方、見えない危険も潜んでいます。日頃から警戒心を持ち、安全にインターネットを利用するように心がけましょう。
AIサービス

感情分析:AIによる心の読み解

人の心を機械で理解する、まるで夢のような技術、それが人工知能による感情分析です。近年、人工知能は様々な分野でめざましい発展を遂げており、その中でも感情分析は特に注目を集めています。感情分析とは、文章に込められた喜び、悲しみ、怒り、驚きなど、複雑な人間の感情を人工知能が読み解く技術のことです。 かつては、感情を理解することは人間だけが持つ特別な能力だと考えられていました。しかし、人工知能技術の進歩により、機械にも人の気持ちが少しずつ分かるようになってきました。人工知能は、大量の文章データを学習することで、特定の言葉や表現がどのような感情と結びついているのかを把握します。例えば、「嬉しい」や「楽しい」といった言葉は喜びの感情を表し、「悲しい」や「つらい」といった言葉は悲しみの感情を表すといった具合です。 人工知能はまだ完璧に感情を理解できるわけではありません。現状では、人間が書いた文章を参考にしながら、感情を識別し、分類をおこなっています。そのため、人間のサポートは依然として重要です。しかし、人工知能が人の感情をある程度理解できるようになったことは、大きな進歩と言えるでしょう。 この技術は、様々な場面で役立ちます。例えば、お客様対応では、お客様の感情を素早く読み取ることで、より適切な対応をすることが可能になります。また、市場調査では、商品やサービスに対する消費者の反応を分析することで、より効果的な販売戦略を立てることができます。このように、人工知能による感情分析は、私たちの生活をより豊かに、そして便利にする可能性を秘めた、革新的な技術と言えるでしょう。
AI活用

二値分類の評価指標:正解率、適合率、再現率、F値

{機械学習の世界では、物事を二つに分ける方法は、様々な場面で使われています。例えば、迷惑メールかどうかを判断したり、病気かどうかを診断したりする際に、この二つのグループに分ける方法が役立っています。この方法を二値分類と言います。そして、この二値分類の良し悪しを測るためには、いくつかの指標が必要です。この指標を使うことで、どのくらい正確に二つのグループに分けられているかを調べることができます。本稿では、二値分類の指標の中でも特に重要な四つの指標について説明します。 まず、全体の中でどのくらい正しく分類できたかを表す指標が正解率です。これは、全体のデータの中で正しく分類できたデータの割合を示しています。しかし、正解率だけでは、分類の正確さを完全には把握できません。例えば、珍しい病気の診断の場合、ほとんどの人が病気ではないため、単純に全員を「病気ではない」と診断しても高い正解率が出てしまいます。しかし、これは実際には正しい診断とは言えません。 そこで、「病気である」と診断した人の中で、実際に病気だった人の割合を表す指標が適合率です。これは、診断の確実性を示す指標と言えます。一方で、実際に病気の人の中で、どのくらいの人を「病気である」と正しく診断できたかを表す指標が再現率です。これは、見落としがないかをチェックするための指標です。 適合率と再現率は、どちらか一方を高くしようとすると、もう一方が低くなる傾向があります。例えば、なるべく見落としを減らそうとして、多くの人を「病気である」と診断すると、再現率は上がりますが、誤診も増えるため適合率は下がります。逆に、確実な診断だけをしようとすると、適合率は上がりますが、診断数が少なくなり再現率は下がります。そこで、適合率と再現率のバランスを考えた指標がF値です。F値は、適合率と再現率の調和平均で計算され、両方の指標をバランス良く評価することができます。 これらの四つの指標、正解率、適合率、再現率、F値を理解することで、二値分類モデルの性能をより深く理解し、適切なモデルを選ぶことができます。それぞれの指標の特徴を踏まえ、状況に応じて適切な指標を用いることが重要です。
AI活用

AIによる広告革命:創造性と効率性の融合

近頃、人工頭脳の技術が急速に発展し、広告作りを大きく変えています。特に、絵や文章などを作り出す人工頭脳は、広告の見た目や印象を刷新しています。以前は、質の高い絵や動画を作るには、多額の費用と熟練した専門家が必要でした。しかし、人工頭脳のおかげで、手軽に安く作れるようになりました。 この技術の進歩は、広告作り全体を効率化し、新しい表現方法を生み出しています。以前は時間と費用がかかっていた作業が自動化され、作る人はより独創的な仕事に集中できるようになりました。たとえば、キャッチコピーを考えたり、広告全体の構成を練ったりすることに時間を割けるようになったのです。その結果、広告の質が上がり、制作期間も短くなりました。 人工頭脳は、広告で使う言葉を選ぶのにも役立ちます。例えば、ある商品を宣伝する場合、その商品の特性を的確に捉え、消費者の心に響く言葉を選び出すことができます。また、膨大な量の情報を分析し、どの言葉が最も効果的かを判断することも可能です。さらに、人工頭脳は、様々な広告の効果を予測することもできます。これにより、広告主は費用対効果の高い広告展開を行うことができるようになります。 人工頭脳は、広告作りの新しい時代を切り開く力となっています。今後も、人工頭脳の技術はますます進歩していくでしょう。そして、広告作りはさらに進化し、私たちの生活をより豊かにしていくことでしょう。
その他

環境に優しい買い物のすすめ:グリーン購入のススメ

環境を大切にする買い物のことを「緑の買い物」と言います。これは、私たちの普段の生活で、どんな商品やサービスを選ぶかという、とても身近な行動に深く関わっています。地球の温度が上がったり、資源がなくなったりといった、環境の大きな問題が深刻になっている今、一人ひとりの買い物が環境に大きな影響を与えることは間違いありません。商品が作られてから捨てられるまでの全ての段階で、環境への負担が少ない商品を選ぶことが「緑の買い物」の大切な考え方です。 例えば、電気をあまり使わない家電製品を選ぶと、使う時の電気代が安くなるだけでなく、地球全体のエネルギー消費量を減らし、温暖化防止にも繋がります。また、再生紙で作られたノートやボールペンを選ぶことは、資源の無駄遣いを減らすだけでなく、森林伐採による環境破壊を防ぐことにも繋がります。遠くから運ばれてくる物ではなく、地元で作られた野菜や果物を選ぶことも「緑の買い物」の一つです。地元の物を買うことで、輸送にかかるエネルギーを減らし、二酸化炭素の排出量を減らすことに貢献できます。 「緑の買い物」は、単にお金を節約することとは違います。将来の地球を守るために、私たち一人ひとりが責任を持って行うべき大切な行動です。普段の買い物で少し意識を変えるだけで、地球環境に良い影響を与えることができます。毎日の生活の中で、環境に優しい商品を選んでいきましょう。小さな行動の積み重ねが、大きな変化を生み出します。
アルゴリズム

感度とは?意味・計算方法・特異度との違いをわかりやすく解説

「感度」とは、機械学習の分野で、分類モデルの性能を評価する大切な指標のひとつです。 特に、二つの選択肢から結果を予測する分類問題でよく使われます。病気の有無を判断する診断や、不正利用を見つける不正検知のように、見落としが許されない状況で特に重要な役割を担います。 感度は、実際に陽性であるもの全体を分母とし、その中で正しく陽性と予測できた割合を表します。つまり、本当に陽性であるものを見つける能力を測る指標と言えるでしょう。例として、ある病気の検査キットを考えてみましょう。実際にその病気に罹っている人々の中で、検査キットによって陽性と正しく判定された人の割合が感度です。 この数値は0から1までの範囲で表現され、1に近づくほど性能が高いことを示します。もし感度が1に近い値であれば、本当に陽性であるものを見逃す可能性が低いことを意味します。 反対に、感度が低いと、本当は陽性なのに陰性と判定されてしまう可能性が高くなります。これは、病気の診断であれば、治療が必要な患者を見逃してしまうことに繋がりかねません。不正検知であれば、不正を見逃し、大きな損害に繋がる可能性も出てきます。 感度は、他の指標と組み合わせて使われることが多く、単独でモデルの良し悪しを判断する材料としては不十分な場合もあります。例えば、「特異度」と呼ばれる指標は、実際に陰性であるもの全体の中で、正しく陰性と予測できた割合を表します。感度と特異度は、モデルの性能を様々な角度から評価するために、共に用いられることが一般的です。 感度を正しく理解することは、機械学習モデルの性能を適切に評価し、それぞれの目的に最適なモデルを選ぶ上で欠かせません。目的に応じて、感度と他の指標をバランス良く考慮することで、より効果的なモデルの選択と活用に繋がります。
アルゴリズム

ε-greedy方策とは?探索と活用の仕組み・利点・注意点をわかりやすく解説

機械学習の中でも、試行錯誤を通して学習する手法を強化学習と言います。この学習方法は、まるで人間が新しい技術を習得する過程に似ています。最初はうまくいかないことばかりでも、何度も挑戦し、成功と失敗を繰り返すことで徐々に上達していく、そのような学習方法です。近年、この強化学習は様々な分野で注目を集めています。例えば、囲碁や将棋などのゲームで人間を凌駕する強さを誇るプログラムや、ロボットの複雑な動きを制御する技術、さらには限られた資源を効率的に配分するシステムなど、幅広い分野で応用が期待されています。 強化学習では、学習を行う主体であるエージェントがどのように行動を選択するかが学習効率を大きく左右します。常に現状で最良と思われる行動だけを選択していては、より良い行動を見つける機会を逃してしまう可能性があります。これは、登山で目の前の小さな丘に登頂しただけで満足し、その先にさらに高い山があることに気づかないようなものです。一方で、やみくもにランダムな行動ばかり選択していては、目標に近づくための効果的な行動を学習することが難しく、いつまでたっても上達しません。これは、地図を持たずにでたらめに歩き回るようなもので、目的地にたどり着くのは困難です。 そこで、探索と活用のバランスが重要になります。探索とは、未知の行動を試すことで、より良い行動を見つける可能性を広げることです。活用とは、これまでの経験から最良と思われる行動を選択し、確実に成果を得ることです。この二つのバランスをうまくとることで、効率的な学習が可能になります。ε-greedy方策は、この探索と活用のバランスを簡単かつ効果的に実現する手法の一つです。この手法では、一定の確率(ε)でランダムな行動を選択することで探索を行い、残りの確率(1-ε)で現状で最良と思われる行動を選択することで活用を行います。このεの値を調整することで、探索と活用のバランスを制御することができ、様々な状況に合わせた学習を実現することができます。
LLM

外部ツールで進化するLLMとは?RAG・Function Calling・エージェントを解説

近ごろの技術の進歩によって、巨大な言葉の模型、いわゆる大規模言語模型が急速に発展しています。これらの模型は、膨大な量の文章を学習することで、人間のように自然な文章を作ったり、質問に答えたりすることができます。まるで、知識の宝庫を持っているかのように、様々な話題について話したり、文章を書いたりすることができるのです。しかし、この知識の宝庫にも限界があります。大規模言語模型が学習した情報は、学習時点までのものです。そのため、常に最新の出来事や特定の分野の専門的な知識を提供することは難しいのです。 そこで注目されているのが、外部の道具を使って大規模言語模型の能力を拡張する技術、「拡張言語模型」です。これは、大規模言語模型が単独で答えを出すのではなく、外部の道具を使って必要な情報を集め、より正確で豊富な内容を伝えることを可能にします。例えるなら、専門家が調べ物をするときのようにです。専門家は、文献や情報データベースから必要な情報を集め、それを基に答えをまとめます。同じように、拡張言語模型も外部の道具を使うことで、まるで専門家のように振る舞い、その能力を格段に向上させることができるのです。 具体的には、計算機や情報検索システム、翻訳システムなど、様々な道具を連携させることができます。例えば、最新のニュースについて質問された場合、拡張言語模型はニュースサイトから最新の情報を取り出して答えを生成します。また、特定の分野の専門知識が必要な場合は、専門のデータベースにアクセスして情報を取得し、より専門的で正確な回答を提供することができます。このように、拡張言語模型は、大規模言語模型単体では不可能だった、常に最新で正確な情報を提供することを可能にし、私たちの生活をより豊かにする可能性を秘めていると言えるでしょう。
その他

つながりを捉えるグラフ指向DB

近ごろ、情報の量が爆発的に増えるのに伴い、データ同士の繋がりをうまく扱う方法が必要とされています。従来広く使われてきた関係データベースは、データを一覧表のような形で整理するため、複雑に絡み合ったデータの関係を表すのには不向きでした。そこで現れたのが、グラフ指向データベースと呼ばれる新しい種類のデータベースです。これは、データとデータの繋がりを線で結んだ図のように表現し、必要な情報を素早く探し出せるようにすることで、様々な新しい活用方法を生み出しています。 従来の関係データベースでは、複数の表を組み合わせることでデータの関係性をたどる必要がありました。例えば、顧客情報と購入履歴を別々の表で管理している場合、特定の顧客の購入履歴を調べるには、二つの表を繋げて検索する必要がありました。しかし、グラフ指向データベースでは、「節」と「枝」を使ってデータの関係性を直接的に表現できます。顧客を「節」、購入を「枝」として表現することで、顧客と購入履歴の繋がりを直接たどることが可能になります。これにより、処理速度が格段に速くなります。 また、データの構造が複雑になってくると、関係データベースでは検索の命令が複雑になりがちでした。例えば、友達の友達の友達を検索する場合、何度も表を繋げる必要があり、命令文も長くなってしまいます。しかし、グラフ指向データベースでは、簡単な命令で複雑な関係性をたどることができます。友達関係を「枝」で表現すれば、何回友達関係をたどるかは、枝をたどる回数で簡単に指定できます。これは、システムを作る人の作業効率向上にも繋がります。 このように、グラフ指向データベースは、複雑なデータの関係性を分かりやすく表現し、素早く検索できるという点で、従来の関係データベースよりも優れた点が多く、今後のデータ活用の重要な技術となるでしょう。