AI活用

データ中心人工知能:その本質と重要性

近頃話題になっているデータ中心人工知能とは、人工知能を作る際に、中心となる考え方をデータの質や管理に置く新しい方法です。これまでの人工知能開発では、人工知能の仕組みや計算方法といった、いわば頭脳の部分を改良することに多くの時間と労力が使われてきました。しかし、データ中心人工知能は、頭脳の部分が完璧でなくても、質の高い、きちんと整理されたデータがあれば、人工知能は良い成果を出せると考えます。 近年の技術革新により、膨大な量のデータが集められるようになりました。この状況を受けて、データ中心人工知能は、人工知能の出来不出来を左右するのはデータの質であるという考え方に基づいています。つまり、正確なデータを集め、整理し、人工知能に学習させることで、より役に立つ人工知能を作ることができるという考え方です。 具体的には、データの正確さだけでなく、データの種類や量、そしてデータ同士の関連性なども重要になります。例えば、猫を認識する人工知能を作る場合、様々な種類の猫の画像データを集めるだけでなく、猫ではない他の動物の画像データも必要になります。また、それぞれの画像データに、「猫」「犬」「鳥」といった正確なラベルを付けることも重要です。さらに、データに偏りがないように、様々な角度から撮影された画像や、様々な環境で撮影された画像をバランスよく集める必要もあります。 このように、データ中心人工知能では、データの質を高めるための様々な工夫が凝らされます。そして、高品質なデータを用いることで、従来の方法よりも効率的に、高性能な人工知能を開発することが可能になります。データ中心人工知能は、今後の人工知能開発において、中心的な役割を果たしていくことが期待されています。
AI活用

新規参入の壁:コールドスタート問題

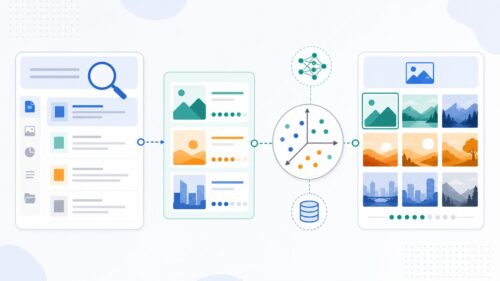
多くの人の好みを集めて、似たような好みを持つ人を仲間にすることで、一人ひとりに合ったおすすめ情報を知らせる技術のことを、協調ろ過と言います。これは、インターネットで買い物をしたり、動画を見たりする時など、様々な場面で使われています。 例えば、ある人が特定の歌をよく聞いているとします。この時、この人と似た音楽の好みを持つ他の人が聞いている別の歌を、おすすめすることができます。このように、協調ろ過は、過去の行動や評価の記録をもとに、その人にとって最適な情報を提供することを目指しています。 近年の情報化社会では、たくさんの情報の中から自分に本当に必要な情報を見つけるのは大変です。新聞や雑誌、テレビ、インターネットなど、あらゆる所から情報が溢れ出てきて、どれを選べば良いのか迷ってしまうことも多いでしょう。協調ろ過は、このような情報過多の時代において、一人ひとりの選択を助ける重要な技術です。たくさんの情報の中から、本当に欲しいもの、必要なものを見つけやすくしてくれます。 協調ろ過は、インターネット上の買い物サイトで商品をおすすめしたり、動画配信サービスでコンテンツをおすすめしたりするなど、様々な分野で活用されています。例えば、よく本を買う人がいれば、その人が過去に買った本と似た種類の本をおすすめすることができます。また、ある映画をよく見る人がいれば、その人が好きそうな他の映画をおすすめすることもできます。 このように、過去の行動や評価の記録を分析することで、その人が潜在的に求めているものを捉え、より個人に合わせたサービスを提供することが可能になります。これにより、利用者はより快適にサービスを利用できるようになり、満足度も向上します。インターネットがますます普及していく中で、協調ろ過は、より良い情報社会を実現するための重要な技術と言えるでしょう。
その他

投資効果を測るROI:その本質と活用法

利益をどれだけ得られたかを知ることは、投資をする上でとても大切なことです。そのために役立つのが「投資利益率」、つまり「アールオーアイ(ROI)」です。これは、投資した金額に対してどれだけの利益が得られたかを割合で表すものです。ROIを使うことで、投資の効果を簡単に数字で比較検討することができるのです。 例えば、新しい機械を導入するために100万円を投資したとします。そして、その機械のおかげで120万円の売り上げが得られたとしましょう。この場合、投資によって得られた利益は120万円から投資額の100万円を引いた20万円です。ROIは、この利益を投資額で割り、100を掛けて百分率で表します。つまり、(20万円 ÷ 100万円)× 100 = 20%となります。この20%という数字が、今回の投資におけるROIです。ROIが高いほど、投資の効果が大きいと言えるでしょう。 ROIは、過去の投資を評価するだけでなく、これから行う投資の計画を立てる際にも役立ちます。複数の投資案がある場合、それぞれのROIを計算して比較することで、どの投資案が最も効果的かを判断することができます。限られた資金や時間を有効に使うためには、ROIに基づいた慎重な検討が必要です。 ただし、ROIだけで投資の全てを判断できるわけではありません。ROIはあくまでも投資の収益性を測る一つの指標です。投資には、金銭的な利益以外にも、会社の評判向上や従業員の技術向上など、数値化しにくい効果も存在します。また、ROIの計算には将来の予測が含まれるため、必ずしも正確な値になるととは限りません。これらの点も踏まえ、ROIを他の情報と合わせて総合的に判断することが、投資を成功させるための鍵となります。
IoT

実現性の検証:IoTシステム構築の鍵

実現性の検証とは、考え出したことや計画の段階にある物事が実際に形にできるかどうかをしっかりと確かめる作業のことです。机の上で練り上げた計画が完璧に思えても、現実の世界では様々なことが起こり、思うように進まないことがあります。 例えば、工場の温度を常に見ている仕組みを新しく作ろうとした場合を考えてみましょう。温度を測る機械をどこに置くか、集めた温度の情報をどのように送るか、仕組みを動かすためのお金はどれくらいかかるかなど、考えなければならないことはたくさんあります。これらのことが、実際に工場でうまくいくかどうかを確かめるのが実現性の検証です。 この検証を怠ると、仕組みを作った後に思わぬ問題が起こり、たくさんの時間とお金を無駄にしてしまうかもしれません。例えば、温度を測る機械を設置する場所を検証せずに設置してしまうと、配線が難しくなったり、温度が正確に測れなかったりする可能性があります。また、データの送信方法を検証せずに決めてしまうと、通信が不安定で必要な情報がリアルタイムに届かない可能性もあります。 さらに、運用コストの見積もりが甘いと、システムを維持していくためのお金が足りなくなって運用を停止せざるを得ない状況に陥るかもしれません。このような事態を避けるためにも、事前にしっかりと検証を行う必要があります。 実現性の検証では、計画を実行するために必要な資源(人、物、金、情報、時間など)が十分に確保できるかどうかも重要なポイントです。資源が不足している場合は、計画を見直したり、追加の資源を確保するための対策を立てる必要があります。 このように、実現性の検証は、物事を成功させるために欠かせない大切な手順と言えるでしょう。
音声生成

フォルマント周波数とは?声の音色を決める共鳴の仕組み

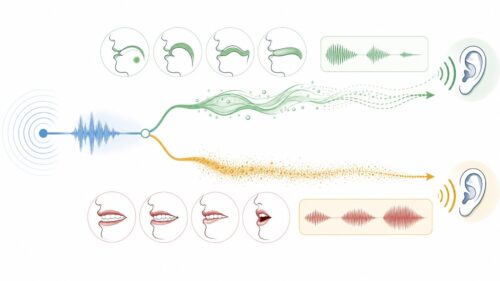
私たちが日々耳にする音、例えば人の声や楽器の音などは、様々な高さの音が組み合わさってできています。様々な高さの成分の中でも、フォルマント周波数と呼ばれるものは、音の持ち味を決める上で特に大切な役割を担っています。 フォルマント周波数は、いわば音の通り道の共鳴によって生まれるものです。人の声で言えば、のどや口の中などの形が、音の通り道を作ります。楽器で言えば、管楽器の管の中や弦楽器の胴体などが音の通り道となります。これらの音の通り道は、特定の高さの成分を強く響かせます。これがフォルマント周波数です。 フォルマント周波数は、音の指紋のようなものです。例えば、「あ」という母音と「い」という母音は、同じ高さで発声しても、音の通り道の形が違います。そのため、響き方が異なり、異なるフォルマント周波数が生まれます。この違いが、「あ」と「い」の音色の違いを生み出しているのです。 楽器の音色も、フォルマント周波数によって大きく変わります。同じ高さの音をバイオリンとフルートで演奏したとき、全く異なる音に聞こえるのは、それぞれの楽器が持つ音の通り道の形が違うからです。バイオリンの弦の振動や胴体の響き、フルートの管の中の空気の振動は、それぞれ特有のフォルマント周波数を生み出し、楽器ごとの独特の音色を決定づけます。 このように、フォルマント周波数を理解することは、音の特徴や音色の違いを深く理解する上で非常に大切です。音の指紋を読み解くことで、私たちが普段何気なく聞いている音の世界を、より豊かに感じることができるようになるでしょう。
AI活用

データサイエンス:データの宝を掘り起こす

データサイエンスとは、様々な情報を集めたものから、役に立つ知恵や知識を引き出すための学問です。近ごろは、あらゆる場所で情報が集められており、企業の活動から科学の研究、社会問題の解決まで、様々な場面で重要な役割を果たしています。データサイエンスは、統計学や数学、計算機科学といった様々な分野の知識を組み合わせることで、情報の山から価値あるものを探し出すことができます。 データサイエンスは大きく分けて三つの段階から成り立っています。まず最初の段階は、集めた情報の整理です。集められたままの情報は雑多でそのままでは使い物になりません。目的や分析手法に合わせて情報を整理し、分析できる状態にする必要があります。次に、整理された情報から法則や関係性を見つけ出す段階です。統計学や機械学習といった手法を用いて、隠れたパターンや関係性を見つけ出し、未来を予測するための数式を作ったりします。そして最後の段階は、得られた結果を分かりやすく説明し、実際に活用する段階です。グラフや表を用いて結果を可視化し、その結果が何を意味するのかを専門知識を用いて解釈します。 データサイエンスで扱う情報は多種多様です。例えば、商品を購入した人の情報や、ウェブサイトの閲覧履歴、天気の情報、センサーから得られる数値など、様々な種類の情報を扱うことができます。これらの情報を分析することで、消費者の好みを把握して新しい商品を開発したり、病気の発生を予測して予防策を考えたり、機械の故障を予知して事故を防いだりすることができます。このように、データサイエンスは社会の様々な場面で活用されており、私たちの生活をより豊かにするための重要な役割を担っています。
学習

AI学習の宝庫:コーパスとは?

言葉のデータベース、いわゆるコーパスは、膨大な量の文章を整理して蓄積したものです。例えるなら、巨大な図書館のようなもので、様々なジャンルの文章が体系的に分類され、保管されています。小説や新聞の記事、個人が綴るブログ、日々更新されるソーシャルメディアへの投稿など、実に多様な情報源から集められた文章が、このデータベースには含まれています。まるで知識の宝庫のように、様々な言葉や表現が集積されているのです。 この言葉の図書館とも呼べるコーパスは、人工知能の学習にとって欠かせない資源となっています。人工知能は、この膨大なデータを使って、人間が言葉をどのように使い、どのように理解しているのかを学びます。いわば、人工知能にとっての教科書と言えるでしょう。コーパスに蓄積された文章を分析することで、言葉の意味や使われ方、文の構造などを理解し、人間のように言葉を操るための知識を習得していくのです。 人工知能が人間のように自然な言葉で会話したり、文章を書いたりするためには、言葉に関する膨大な知識が必要です。例えば、「嬉しい」という言葉一つとっても、どのような状況で使われるのか、どのような言葉と組み合わされるのか、といった情報を理解する必要があります。コーパスは、このような言葉の知識を学ぶための貴重な教材を提供し、人工知能が人間のように言葉を理解し、扱うための基礎を築く役割を担っているのです。そして、コーパスの質と量は、人工知能の性能に直接影響を与えます。より多くの種類の文章、より質の高い文章が集積されたコーパスを利用することで、人工知能はより高度な言語能力を獲得することが可能になります。つまり、コーパスは人工知能の発展を支える重要な基盤と言えるでしょう。
その他

RoHS指令:有害物質から環境を守る

有害物質の使用制限の略称である「特定有害物質の使用制限指令」は、ヨーロッパ連合が定めた環境保護のための大切な法律です。この法律は、電気製品や電子機器に使われる特定の有害物質の使用を制限することで、環境や人の健康を守ることを目的としています。私たちの身近にある携帯電話やパソコン、テレビ、冷蔵庫など、様々な家電製品がこの指令の対象となっています。 この指令は、有害物質が環境へ及ぼす影響を抑えるために作られました。例えば、これらの有害物質が土壌や水に混ざると、農作物や生き物に悪影響を及ぼし、最終的には私たちの食卓にも危険が及ぶ可能性があります。また、これらの物質は大気中に放出されると、呼吸器系の病気を引き起こす可能性も懸念されています。 この指令で制限されている物質には、鉛、水銀、カドミウム、六価クロム、ポリ臭化ビフェニル、ポリ臭化ジフェニルエーテルの6種類があります。これらの物質は、かつて電子機器の製造に広く使われていましたが、環境や人体への有害性が明らかになったため、使用が制限されることになりました。 製造業者には、製品に使われている部品や材料をしっかりと管理し、環境に配慮した製品作りを進めることが求められています。具体的には、製品に含まれる有害物質の量を基準値以下にすること、代替物質を使用すること、製造工程を改善することなどが求められています。 現代社会では、電気製品や電子機器はなくてはならないものですが、一方で、廃棄物による環境汚染も深刻な問題です。この指令は、この問題に取り組むための重要な一歩であり、製造業者だけでなく、消費者も環境問題への意識を高め、製品を選ぶ際に環境への影響を考えることが大切です。
AI活用

実世界で学ぶAI:オフライン強化学習

人工知能、とりわけ強化学習は、試行錯誤を通して学習するという特徴があります。ちょうど、子供が何度も転びながら歩くことを覚えるように、人工知能も様々な行動を試してみて、その結果から成功や失敗を学び、より良い行動を選択できるようになっていきます。しかし、この学習方法には大きな課題があります。それは、現実世界での試行錯誤が難しいということです。 例えば、自動運転技術を考えてみましょう。安全な自動運転を実現するためには、人工知能は様々な道路状況や天候の中で適切な運転操作を学習しなければなりません。しかし、もし学習中に人工知能が誤った判断をして事故を起こしてしまったらどうでしょうか。人の命に関わる重大な事故につながる可能性があります。現実の道路で、そのような危険を冒しながら試行錯誤を繰り返すことはできません。 医療の分野でも同様の問題があります。例えば、新薬の開発や治療方法の確立には、様々な投薬量や治療手順を試す必要があります。しかし、患者の体を使って試行錯誤することは倫理的に許されません。薬の副作用や治療の失敗によって、患者の健康状態が悪化してしまうかもしれません。人の命を預かる医療現場では、絶対に失敗が許されないため、現実世界での直接的な学習は非常に困難です。 また、試行錯誤には膨大な時間と費用がかかるという問題もあります。自動運転の例で言えば、様々な道路状況や天候を再現するためには、莫大な数のテスト走行が必要になります。医療の分野でも、新薬開発には長期間の臨床試験が必要で、莫大な費用がかかります。 このように、現実世界での試行錯誤による学習には、安全面、倫理面、そして費用面で大きな課題があります。そのため、現実世界で試行錯誤を繰り返すことなく、安全かつ効率的に学習を進めるための新しい方法が求められています。人工知能の更なる発展のためには、これらの課題を解決するための技術革新が不可欠です。
LLM

音素とは?音の最小単位の意味と日本語・英語の違いをわかりやすく解説

私たちが日々何気なく口にしている言葉は、実は様々な音の粒の組み合わせによって成り立っています。そして、その音の粒を細かく砕いていった一番小さな単位こそが「音素」と呼ばれるものです。音素とは、言葉を区別するために必要となる、最小の音の単位のことを指します。 例えば、「かき」と「さき」を考えてみましょう。この二つの言葉は、最初の音だけが異なっていますが、その違いだけで意味は全く別のものになってしまいます。このように、言葉の意味を区別する上で重要な役割を果たしているのが、まさに音素なのです。 五十音図を思い浮かべてみてください。日本語学習では、まずこの五十音を学びます。しかし、五十音の一つ一つが音素と完全に一致するわけではありません。実際には、日本語の音素は五十音よりももっと数多く存在します。例えば、「ぱぴぷぺぽ」の音は、五十音には含まれていませんが、これらも日本語の音素として扱われます。さらに、「き」と「ち」のように、発音の際に息を強く出すかどうかといった違いも、音素を区別する要素となります。このように、音素は発音の微妙な違いをも捉えるのです。 また、音素の種類や数は言語によって様々です。ある言語では区別される音が、別の言語では区別されない、ということがよくあります。例えば、日本語には「ら」と「la」を区別する音素はありませんが、英語にはあります。逆に、日本語には「つ」と「tsu」を区別する音素がありますが、英語にはありません。このような音素の違いが、外国語の聞き取りや発音を難しくする大きな要因の一つとなっているのです。私たちが母語を自然に習得できるのは、幼い頃から母語の音素に耳を慣れ親しんでいるからと言えるでしょう。
AI活用

データ品質でAIをパワーアップ

皆様、本日は「はじめに」と題しまして、人の知恵を模倣した機械、いわゆる人工知能についてお話させていただきます。人工知能は、今や私たちの暮らしの様々なところに浸透し、日々の生活を大きく変えつつあります。自動車の自動運転、病気の診断、お店のお客様対応など、様々な分野で革新的な変化をもたらしています。 人工知能の働きは、それを支える情報の質に大きく左右されます。情報の質が低いと、人工知能は期待通りの成果を上げることができず、間違った判断や予測をしてしまう可能性があります。例えば、自動運転の車が、不正確な道路情報に基づいて走行した場合、事故につながる危険性も考えられます。また、医療診断において、質の低いデータで学習した人工知能が誤診をしてしまうと、患者の健康に深刻な影響を与える可能性があります。お客様対応でも、不適切な情報に基づいて応答すると、お客様の満足度を低下させるばかりか、会社の評判を落とすことにもなりかねません。 このように、人工知能を活用する際には、情報の質を確保することが非常に重要です。情報の質を高めるためには、情報の正確性、網羅性、最新性を確認する必要があります。情報の正確性とは、情報に誤りがないことを指します。網羅性とは、必要な情報が全て揃っていることを指します。最新性とは、情報が最新の状況を反映していることを指します。これらの要素を満たすことで、人工知能の性能を最大限に引き出し、より良い成果を期待することができます。 人工知能は、まさに現代社会の進歩を象徴する技術の一つです。しかし、その力を最大限に発揮するためには、質の高い情報を提供することが不可欠です。今後、人工知能がさらに発展していく中で、情報の質の重要性はますます高まっていくでしょう。私たち一人ひとりが情報の質について意識し、より良い情報を提供していくことで、人工知能の未来はより明るいものになるでしょう。
AIサービス

コード生成AIで変わる未来

「コード生成AI」とは、人間の言葉を理解し、コンピュータプログラムを自動で作成してくれる人工知能です。まるで魔法の呪文のように、言葉で表現した機能を、実際に動くプログラムのコードへと変換してくれます。これまで、プログラムを作るには専門的な知識と技術が必要でしたが、この革新的な技術によって、誰もが手軽にプログラムを作れるようになる可能性を秘めています。 例えば、「赤い押しボタンを押すとメッセージが出るプログラムを作って」と指示するだけで、コード生成AIは、その通りの機能を持ったプログラムのコードを自動的に生成してくれます。これまで時間をかけて書いていたコードを、AIが瞬時に作ってくれるため、開発にかかる時間を大幅に短縮できます。また、プログラミングの経験がない人でも、自分のアイデアを形にすることが可能になります。 この技術は、様々な場面での活用が期待されています。例えば、新しい商品の試作品を作る際、簡単な指示を出すだけで、試作品に必要なプログラムをすぐに作ることができます。また、普段使っている業務システムに新しい機能を追加したい場合でも、専門の技術者に頼むことなく、自分で必要な機能を言葉で指示して、プログラムを生成することができます。 しかし、現状では、コード生成AIが生成するコードは、完璧ではありません。まだ複雑なプログラムを作ることは難しく、生成されたコードを人間が修正する必要がある場合もあります。また、AIが生成したコードに欠陥があった場合、その責任の所在が曖昧になる可能性も懸念されています。今後、技術の進歩と共に、これらの課題が解決されていくことが期待されます。それでも、コード生成AIは、これからのプログラム開発を大きく変える可能性を秘めた、画期的な技術と言えるでしょう。
アルゴリズム

ROC曲線でわかる分類モデルの性能

機械学習における分類モデルの良し悪しを判断する際に、ROC曲線と呼ばれるグラフが用いられます。これは、データを二つの種類に分類する問題、例えば、迷惑メールかどうかを判別する、病気か健康かを判断するといった場合に特に役立ちます。 分類モデルは、あるデータがどちらの種類に属するかを、閾値と呼ばれる基準値を使って決めます。この閾値は、モデルがデータを陽性と判断する境界線のようなものです。例えば、迷惑メールフィルターで、あるメールが迷惑メールである確率が閾値を超えた場合、そのメールは迷惑メールと判定されます。 ROC曲線は、この閾値を様々に変化させた時に、モデルの性能がどう変わるかを視覚的に示したものです。具体的には、「偽陽性率」と「真陽性率」という二つの指標をグラフ上に描き出します。偽陽性率とは、実際には陰性であるデータを誤って陽性と判断してしまう割合のことです。例えば、健康な人を誤って病気と診断してしまう割合に当たります。一方、真陽性率とは、実際に陽性であるデータを正しく陽性と判断できる割合のことです。例えば、実際に病気の人を正しく病気と診断できる割合です。 ROC曲線は、様々な閾値に対して計算された偽陽性率と真陽性率の組み合わせをプロットすることで描かれます。理想的なモデルは、真陽性率は高く、偽陽性率は低い状態です。つまり、真に陽性であるデータを正しく陽性と判定し、陰性であるデータを誤って陽性と判定することが少ない状態です。ROC曲線を見ることで、閾値をどのように設定すれば、偽陽性と真陽性のバランスを最適化できるかを判断することができます。また、異なるモデルのROC曲線を比較することで、どのモデルがより優れた性能を持っているかを評価することも可能です。つまり、ROC曲線は、分類モデルの性能を多角的に評価するための強力な道具と言えるでしょう。
AI活用

自動運転で変わる未来の車

自動運転とは、人がハンドルやアクセル、ブレーキといった操作に一切関わることなく、車が自らの力で目的地まで安全に走行する技術のことです。まるで映画や物語の世界のようですが、近年、電子技術や人工知能の目覚ましい進歩によって、現実のものへと変わりつつあります。 現在、自動運転はいくつかの段階に分けて考えられています。完全な自動運転はまだ実現していませんが、特定の条件下でシステムが運転操作を行う「限定的な自動運転」は既に実用化されています。例えば、高速道路で一定の速度を維持したり、車線の中央を走行したりする機能は多くの車に搭載されています。また、駐車を支援するシステムも普及しており、車庫入れや縦列駐車の際に、ハンドル操作やブレーキ操作を自動で行ってくれます。これらの技術は、ドライバーの負担を軽くするだけでなく、事故を減らすことにも役立っています。居眠り運転や脇見運転による事故を防いだり、危険を察知して自動的にブレーキをかけたりする機能も開発されています。 完全な自動運転が実現すれば、私たちの生活は大きく変わると期待されています。高齢者や体が不自由な人も自由に移動できるようになり、交通事故の減少も見込まれます。また、渋滞の緩和や環境負荷の軽減といった効果も期待されています。 しかし、自動運転には課題も多く残されています。複雑な交通状況や悪天候への対応、事故発生時の責任の所在など、解決すべき問題が山積しています。法整備や社会的な受容も必要です。技術開発だけでなく、様々な角度からの検討が必要不可欠です。今後の技術革新と社会の取り組みにより、安全で快適な自動運転社会の実現が期待されています。
その他

音韻:音の認識を探る

ことばを話すとき、私たちは様々な音を使い分けています。例えば、「か」と「が」、「さ」と「た」など、これらの音の違いによって、ことばの意味は大きく変わってきます。これらのことばの音の最小単位を、音素といいます。音素は、空気が声帯や舌、唇などの動きによって変化し、耳に届く空気の振動として生まれる物理的な現象です。しかし、音韻論が扱うのは、この物理的な音そのものではありません。音韻論は、それぞれの言語において、これらの音がどのように意味の違いを生み出すのか、どのような規則性を持っているのかを研究する学問分野です。 例えば、「かき」と「がき」では、「か」と「が」の音の違いだけで意味が全く変わってきます。このとき、「か」と「が」は、日本語において意味を区別する働きを持つ、異なる音韻であると言えます。同じように、「さ」と「た」も、日本語では異なる音韻です。このように、ある言語において、ことばの意味の違いを生み出す音声上の最小単位を、音韻と呼びます。音韻は、その言語を話す人々の頭の中に存在する、いわば音の認識の枠組みのようなものです。 音韻は、言語によって異なります。例えば、日本語では「ら」と「la」を聞き分けられますが、英語では同じ音に聞こえます。これは、日本語では「ら」と「la」が異なる音韻として認識されているのに対し、英語では同じ音韻として認識されているからです。また、同じ音であっても、周囲の音によって発音が変化することがあります。例えば、「おにぎり」の「に」は、実際には「ん」に近い音で発音されることがあります。しかし、私たちはそれを「に」の音韻として認識します。このように、音韻論は、物理的な音と、私たちが頭の中で認識する音との関係を探求する、奥深い学問分野と言えるでしょう。
学習

データラベリングとは何か?

近頃よく耳にする人工知能、略してAIは目覚ましい発展を遂げており、私たちの暮らしの様々な場面で役立てられるようになってきました。AI技術の中でも、機械学習は特に注目を集めており、様々な分野で応用されています。この機械学習をより賢く、より正確にするためには、大量の情報をAIに学ばせる必要があります。それはまるで、私たち人間が多くの経験を積むことで賢くなっていくのと似ています。このAIの学習において、データラベリングは大変重要な役割を担っています。 データラベリングとは、写真や音声、文章といった様々な情報に、まるで名前を付けるように印(ラベル)を付ける作業のことです。例えば、猫が写っている写真に「猫」というラベルを付けます。こうすることで、AIは写真に写っているものが猫だと理解できるようになります。また、音声データであれば、「人の声」「車の音」「鳥の鳴き声」といったラベルを付けます。文章データであれば、「楽しい」「悲しい」「怒っている」といった感情を表すラベルを付けることもあります。このように、データにラベルを付けることで、AIは情報の内容を理解しやすくなり、より正確な判断ができるようになります。 一見すると単純な作業に思えるかもしれませんが、このデータラベリングはAIの性能向上に大きく貢献しています。AIがより正確に情報を理解し、適切な判断を下せるようにするためには、質の高いデータラベリングが不可欠です。大量のデータを正確にラベル付けすることで、AIはより賢く、私たちの生活をより豊かにしてくれる存在へと成長していくのです。まるで先生のように、AIに正しい知識を教え込む大切な作業と言えるでしょう。
IoT

RFタグとは?仕組み・種類・活用例を初心者向けに解説

無線で情報のやり取りができる小さな電子部品である無線タグは、まるで持ち物に付ける名札のようです。これを物に貼り付けたり、埋め込んだりすることで、その物が何であるかを見分けたり、物の情報を記録したりすることができるのです。無線タグは様々な大きさがあり、財布や鍵に付けるキーホルダーのような形のものから、米粒ほどのとても小さなものまであります。大きさだけでなく、材料も紙、プラスチック、金属など様々で、使う場面に合わせて選ぶことができます。 無線タグは、高周波という電波を使って情報をやり取りします。読み取り機と呼ばれる機械から電波を送ると、タグに内蔵された小さな回路に電気が流れます。その電気を使って、タグに書き込まれた情報を読み取ったり、新しい情報を書き込んだりできるのです。電池を必要としない受動型と、電池を内蔵した能動型があり、能動型はより遠くまで電波を送ることができます。 この小さな無線タグは、私たちの生活を大きく変える力を持っています。例えば、お店の商品管理に利用すれば、在庫の確認作業を簡単に行うことができます。また、図書館の本に付ければ、貸し出しや返却の手続きをスムーズに行うことができます。さらに、動物の個体識別や、工場の部品管理など、様々な分野で活用が期待されています。まるで魔法の札のように、私たちの生活をより便利で豊かにしてくれる、そんな可能性を秘めた技術なのです。
アルゴリズム

グローバルアベレージプーリングとは?CNNで平均を取る仕組みとメリット

画像を認識する時によく使われる技術に、全体平均値を計算する方法があります。これは、畳み込みニューラルネットワークという仕組みの中で、最後の層あたりで使われます。この方法は、画像の特徴を表すたくさんの小さな区画(これを特徴マップと言います)それぞれについて、全体の平均値を計算するものです。 特徴マップは、縦と横の小さな点(ピクセル)の集まりでできています。例えば、縦が7ピクセル、横が7ピクセルの特徴マップを考えてみましょう。この中には、明るさや色の濃淡など、様々な特徴が入り混じっています。全体平均値を求めるには、この49個のピクセルの値を全て合計し、49で割ります。これで、この特徴マップ全体の平均値が計算できます。 特徴マップは複数枚あり、それぞれ異なる特徴を表しています。例えば、一枚目が輪郭の特徴を、二枚目が色の特徴を表しているといった具合です。これらの全ての特徴マップに対して同じ計算を繰り返すことで、それぞれの代表値を得ることができます。 従来の方法では、全結合層というものが使われていました。これは、全ての特徴マップの全てのピクセルを、次の層の全ての点に繋げるという複雑な方法です。そのため、調整すべき値(パラメータ)の数が膨大になってしまい、計算に時間がかかっていました。全体平均値を使う方法では、特徴マップ一枚につき一つの代表値しか使わないので、パラメータの数を大幅に減らすことができます。これにより、計算の負担を軽くし、処理速度を向上させることができるのです。また、不要な細かい情報に惑わされにくくなり、画像認識の精度を向上させる効果も期待できます。
AI活用

自動運転の未来:AI技術による進化

自動運転とは、人が運転席に座って操作しなくても、車が自分で目的地まで走る技術のことです。人の手を借りずに、機械が状況を判断して安全に走行する点が、これまでの自動運転技術とは大きく異なるところです。近年、様々な分野で活用されている人工知能技術の急速な進歩がこの自動運転技術の発展を大きく後押ししています。 以前の自動運転技術では、あらかじめ決められた経路を走るだけでした。しかし、現在の技術では、周りの状況を認識し、状況に応じて適切な判断をしながら走行することが可能です。例えば、前方に歩行者が飛び出してきた場合には、自動でブレーキをかけたり、隣の車線を走る車を認識して車線変更をしたり、といった高度な運転操作を実現しています。 こうした高度な判断は、人工知能技術による画像認識や物体検出、そして最適な経路を計画する技術などによって実現されています。カメラやセンサーで周囲の状況を捉え、人工知能が瞬時に分析することで、人間のように状況を判断し、安全な運転を可能にしているのです。 自動運転技術は、交通事故を減らし、渋滞を緩和し、移動をより効率的にするなど、私たちの生活に多くの利点をもたらすと期待されています。高齢者や障害を持つ人など、運転が難しい人にとっても、移動の自由を広げる大きな可能性を秘めています。また、長距離トラックの運転など、過酷な労働環境の改善にも役立つと考えられています。今後、更なる技術開発によって、自動運転は私たちの社会を大きく変える可能性を秘めていると言えるでしょう。
アルゴリズム

MFCCとは?メル周波数ケプストラム係数の意味・仕組み・音声認識での使い方

私たちが音を聞き分けられるのは、音の高さ、大きさ、そして音色の三つの要素のおかげです。音の高低は、音の振動の速さ、つまり周波数によって決まります。高い音は速く振動し、低い音はゆっくり振動しています。音の大小は、音の波の大きさ、つまり振幅によって決まります。大きな音は波が大きく、小さな音は波が小さいです。そして音色は、音の波形の違いによって生み出されます。同じ高さ、同じ大きさの音でも、楽器によって異なる音に聞こえるのは、この音色の違いがあるからです。 この音色を捉える有力な方法の一つに、メル周波数ケプストラム係数(略してエムエフシーシー)と呼ばれるものがあります。これは、人間の耳の仕組みを模倣した計算方法で、音の特徴を数値化することができます。人間の耳は、高い音よりも低い音に対して敏感に反応するようにできています。エムエフシーシーは、この人間の耳の特性を考慮に入れて、音の周波数成分を分析します。 具体的には、まず音声を短い時間ごとに区切り、それぞれの区間で周波数分析を行います。そして、人間の耳の感度に合わせた特別な尺度を使って、周波数ごとのエネルギーの分布を計算します。最後に、この分布をさらに変換して、音色を表す特徴的な数値を抽出します。これがエムエフシーシーです。 エムエフシーシーは、まるで音の指紋のようなものです。同じ音であれば、エムエフシーシーも同じような値になります。逆に、異なる音であれば、エムエフシーシーも異なる値になります。この性質を利用することで、音声認識や音声検索、音声合成など、様々な音声処理技術で音声を識別することができます。例えば、音声認識では、入力された音声のエムエフシーシーを計算し、あらかじめ登録されている音声のエムエフシーシーと比較することで、どの音声に一番近いかを判断し、認識を行います。
セキュリティ

データ統治:信頼できるデータ活用

データ統治とは、組織内でデータがどのように扱われるかを定める包括的な規範と基準の枠組みです。データは現代の事業活動において大変貴重な財産となっています。その真価を最大限に発揮するには、データの質、正しさ、一貫性、そして安全性を確かなものにすることが欠かせません。データ統治は、まさにこれらの要素を確立し、維持するための土台となります。 具体的には、データ統治は、データの収集方法、保管場所、処理手順、そして最終的な廃棄方法まで、データのライフサイクル全体を網羅します。誰がどのようなデータにアクセスできるのか、どのように利用できるのかといった権限も明確に定義されます。これにより、不用意なデータの漏洩や不正利用を防ぎ、安全性を確保することができます。また、データの定義や用語を統一することで、組織全体でデータの意味を共有し、誤解や混乱を防ぐことができます。 データ統治は単なるデータ管理とは一線を画します。データ管理はデータの日常的な運用や保守に焦点を当てるのに対し、データ統治は組織全体のデータ活用を最適化するための戦略的な視点を含みます。組織全体のデータの整合性と信頼性を確かなものにすることで、データに基づいた意思決定の質を高め、事業の成功へと繋げます。 例えば、ある販売会社を考えてみましょう。データ統治が適切に機能していれば、顧客情報、売上データ、商品情報などが正確かつ一貫性を持って管理されます。これにより、顧客の購買動向を的確に分析し、効果的な販売戦略を立案することができます。また、データの品質が保証されているため、経営層は安心してデータに基づいた意思決定を行うことができます。このように、データ統治は事業活動のあらゆる側面を支え、競争優位性を築く上で重要な役割を担っています。データ統治は、組織の成長と発展に不可欠な要素と言えるでしょう。
IoT

RFID:見えない力、未来を拓く

無線で情報をやり取りする技術は、私たちの身の回りに急速に広まり、生活を大きく変えています。この技術の中心となるのが、無線自動識別と呼ばれるものです。これは、電波を使って情報をやり取りする仕組みで、小さな札に情報を書き込み、読み取り装置をかざすだけで、札に記録された情報を読み取ることができます。まるで魔法のように、触れずに情報を読み取れるため、様々な場所で活用されています。 例えば、お店のレジで商品を会計する際に、商品一つ一つに貼られた小さな札の情報を読み取ることで、あっという間に会計を済ませることができます。また、図書館で本を借りる際にも、この技術が使われています。本に貼られた札を読み取ることで、どの本を誰が借りたのかを簡単に管理することができます。さらに、工場では、製品にこの札を取り付けることで、製品がどこで作られ、どのような工程を経てきたのかを追跡することができます。このように、様々な分野で、私たちの生活を便利で効率的にしています。 従来の縞模様の印を使った情報読み取り方式と比べて、この無線による方法は多くの利点を持っています。従来の方式では、読み取り装置を印に正確に向ける必要がありましたが、無線方式では札に直接読み取り装置を向ける必要がありません。そのため、作業の効率が大幅に向上します。また、複数の札の情報を同時に読み取ることができるため、大量の商品管理も容易になります。さらに、札に情報を書き込むこともできるため、商品の状態や、いつどこでどのように扱われたかといった履歴を記録し、より高度な管理を実現することができます。これにより、商品の品質管理や在庫管理をより正確に行うことができ、私たちの生活をより豊かに、そして安全なものにしてくれます。
学習

最適な設定を見つける!グリッドサーチとは?意味・仕組み・活用例をわかりやすく解説

機械学習の世界では、目的のデータに合わせて様々な設定を行う必要があります。この設定は、料理のレシピを作る作業によく似ています。美味しい料理を作るには、材料の種類や分量、火加減、調理時間などを適切に調整する必要があるように、機械学習でも様々な項目を設定することで、予測精度を向上させることができます。 例えば、ある料理のレシピを考える際に、砂糖の量を少しずつ変えて、一番美味しい分量を探すとします。砂糖を大さじ1杯入れた場合、2杯入れた場合、3杯入れた場合と、それぞれ試してみて味を比較することで、最適な砂糖の量を見つけることができます。機械学習もこれと同じように、設定項目の値を少しずつ変えながら、一番性能の良い組み合わせを探すという作業を行います。 しかし、機械学習の設定項目は砂糖の量のように単純なものではありません。たくさんの設定項目があり、それぞれが複雑に影響し合っているため、最適な組み合わせを見つけるのは至難の業です。そこで、効率的に最適な設定を見つけるための手法が開発されてきました。その代表的な手法の一つが「グリッドサーチ」です。 グリッドサーチは、設定項目の値を網羅的に変化させて、一つずつ試していく方法です。先ほどの料理の例で言えば、砂糖だけでなく、塩、醤油、味噌など、様々な調味料の量を様々に変え、すべての組み合わせを試して一番美味しい配合を見つけるようなものです。グリッドサーチは単純な方法ですが、確実に最適な設定を見つけることができるため、機械学習の現場で広く利用されています。多くの設定の組み合わせを試すため、計算に時間がかかることもありますが、コンピュータの性能向上により、以前と比べて手軽に利用できるようになっています。
AIサービス

言葉を理解するコンピュータ:自然言語処理の世界

人と機械の間には、深い溝があります。それは言葉の溝です。私たち人間は、様々な言い回しや複雑な文の組み立て、そして言葉に込められた unspoken な意味合いを読み取りながら、互いに意思疎通を図っています。しかし、機械は0と1のデジタル信号しか理解できません。まるで違う世界の言葉のようです。 この言葉の溝を埋めるために、「自然言語処理」という技術が開発されました。自然言語処理とは、私たちが普段使っている言葉を、機械が理解できる形に変換する技術です。まるで通訳のような役割を果たします。この技術によって、機械は人間の言葉の意味や、その言葉が使われた時の状況、前後関係などを分析できるようになります。 例えば、ある人が「今日は暑い」と言ったとします。人間であれば、この言葉から、相手が暑さを感じていること、もしかしたら冷たい飲み物を欲しがっていることなどを推測できます。自然言語処理も同様に、この言葉から話し手の気持ちを汲み取ろうとします。もちろん、機械はまだ人間のように完璧に言葉を理解できるわけではありません。しかし、自然言語処理の技術は日々進歩しており、機械は少しずつ人間の言葉に近づいてきています。 この技術が発展すれば、機械と人間はよりスムーズに会話できるようになります。まるで人と人が話すように、機械と自然な言葉でやり取りできる未来が、すぐそこまで来ているのかもしれません。機械が私たちの言葉を理解し、私たちも機械の言葉、つまりデータや情報を理解することで、全く新しいコミュニケーションの形が生まれる可能性を秘めているのです。まるで言葉の橋が架かるように、人と機械が繋がる未来を想像してみてください。