
MFCCとは?メル周波数ケプストラム係数の意味・仕組み・音声認識での使い方

AIの初心者
メル周波数ケプストラム係数って、音声認識でよく出てきますが、何を表す数値なんですか?

AI専門家
簡単に言うと、人の耳の聞こえ方に近づけて、音声の特徴を短い数値列にまとめたものだよ。特に音色の違いを機械が扱いやすい形にするために使われるんだ。
AIの初心者
どうして普通の周波数分析だけではなく、わざわざMFCCに変換するんですか?
AI専門家
人間は低い音の違いには敏感だけれど、高い音の細かな違いには比較的鈍感だからだよ。その性質を反映すると、「あ」と「い」のような音色の差を音声認識モデルが捉えやすくなるんだ。
MFCC(メル周波数ケプストラム係数)は、音声を機械学習や音声認識で扱いやすい特徴量へ変換する代表的な方法です。正式には「Mel-Frequency Cepstral Coefficients」と呼ばれ、日本語ではメル周波数ケプストラム係数と訳されます。
音声データは、そのままでは時間ごとの波の集まりです。コンピューターに「どの音らしいか」「どの単語らしいか」を判断させるには、音の高さ、強さ、音色の違いを比較しやすい数値へ整理する必要があります。MFCCはこのために、周波数分析、人間の聴覚に近いメル尺度、メルフィルタバンク、離散コサイン変換(DCT)を組み合わせます。
メル周波数ケプストラム係数(MFCC)とは
メル周波数ケプストラム係数とは、音声のスペクトルの形を、人間の耳の聞こえ方に合わせて要約した特徴量です。音そのものを保存する形式ではなく、音声認識や話者認識などのモデルに渡すための「音の特徴を表す数値列」と考えると分かりやすいでしょう。
人の耳は、すべての周波数を同じ細かさで聞き分けているわけではありません。低い周波数帯では差を細かく感じ取り、高い周波数帯では差を大まかに感じます。MFCCはこの性質を利用し、周波数成分をメル尺度上でまとめてから、音色の大まかな形を少数の係数で表します。
たとえば同じ高さ、同じ大きさで「あ」と「い」を発音しても、聞こえ方は違います。この違いは、音の中に含まれる周波数成分の分布、つまりスペクトル包絡の違いとして現れます。MFCCはそのスペクトル包絡をコンパクトに表すため、音声認識で母音や音素の違いを見分ける助けになります。
音声を特徴量にする前に知っておきたい音の三要素
MFCCを理解するには、まず音の基本要素を押さえておくと見通しがよくなります。音は大きく、高さ、大きさ、音色という三つの観点で説明できます。
| 要素 | 関係する性質 | 例 |
|---|---|---|
| 音の高さ | 周波数 | 高い声、低い声 |
| 音の大きさ | 振幅やエネルギー | 大きな声、小さな声 |
| 音色 | 波形や周波数成分の分布 | 同じ音程でも声や楽器が違って聞こえる |
MFCCが特に注目するのは音色です。音色は、周波数成分がどのように混ざっているかによって変わります。音声認識では、単に音が高いか低いかだけではなく、発音された音が「あ」なのか「い」なのか、誰の声に近いのか、といった違いを扱う必要があります。そのため、音色を数値化する特徴量が重要になります。
MFCCの基本的な計算手順
MFCCは一つの処理だけで得られる値ではなく、いくつかの変換を順番に行って求めます。細部の実装はライブラリや設定によって異なりますが、基本の流れは次の通りです。
| 手順 | 内容 | 目的 |
|---|---|---|
| 短時間分割 | 音声を数十ミリ秒程度の短い区間に分ける | 時間とともに変わる音を局所的に分析する |
| 周波数分析 | 各区間を周波数成分に変換する | どの周波数帯にエネルギーがあるかを見る |
| メルフィルタバンク | メル尺度に基づく複数のフィルタを通す | 人間の聞こえ方に近い帯域ごとの強さを得る |
| 対数化 | エネルギー値の対数を取る | 人間の音量感覚に近づけ、値の幅を扱いやすくする |
| DCT | 離散コサイン変換で係数にまとめる | スペクトル包絡を少数の特徴量に圧縮する |
この一連の処理によって、長い音声波形はフレームごとのMFCCベクトルになります。音声認識モデルは、これらの特徴量の時間変化を見ながら、音素、単語、文章を推定します。
周波数を人間の聞こえ方に近づけるメル尺度
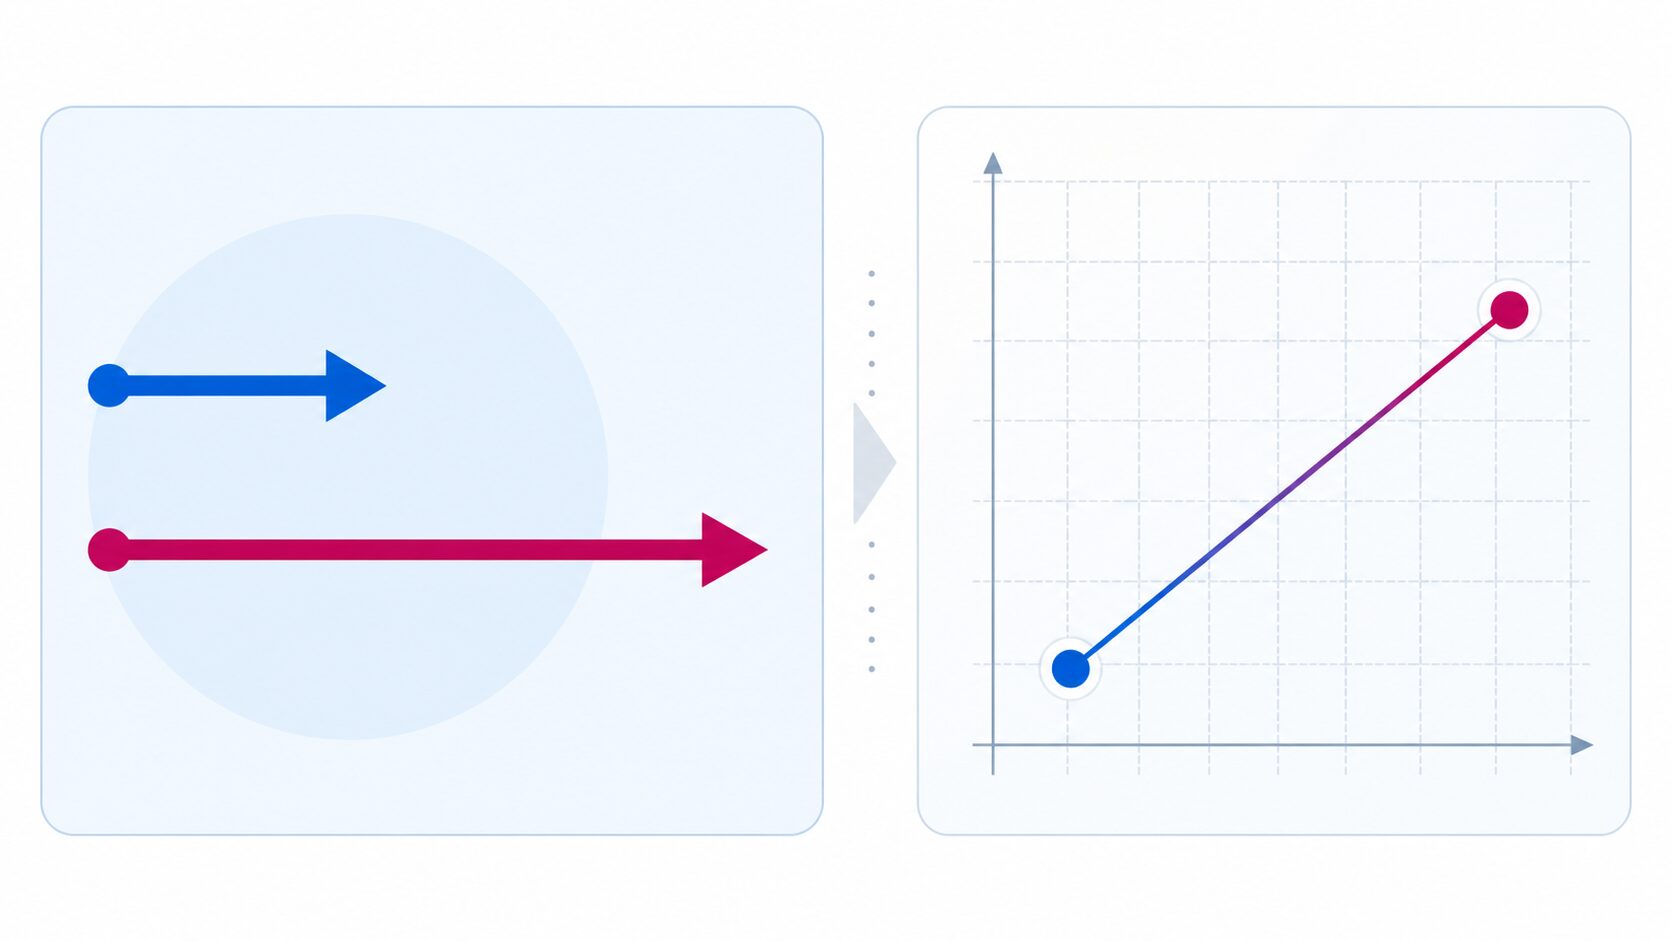
音声をコンピューターで分析するとき、最初はヘルツ(Hz)で表される通常の周波数を扱います。しかし、人間の聞こえ方はHzの目盛りと同じではありません。低い周波数の差は細かく聞き分けやすい一方、高い周波数では同じ差でも違いを感じにくくなります。
この聴覚特性を反映する尺度がメル尺度です。メル尺度では、低周波数帯を比較的細かく、高周波数帯を圧縮して扱います。つまり、機械が周波数を分析するときの見方を、人間の耳が重要だと感じやすい領域に寄せる役割を持ちます。
音声認識では、人間が聞き分けやすい差を特徴量にも反映した方が、発音の違いや音色の違いを捉えやすくなります。そのため、MFCCでは通常の周波数軸をそのまま使うのではなく、メル尺度に基づいたフィルタでエネルギーを集計します。
メルフィルタバンクでスペクトル包絡を取り出す
メルフィルタバンクは、メル尺度上に並べた複数の帯域通過フィルタです。各フィルタは担当する周波数帯のエネルギーを取り出し、音声がどの周波数帯にどれくらい強い成分を持っているかを表します。
ここで得られる帯域ごとのエネルギー分布は、音のスペクトル包絡を大まかに表します。スペクトル包絡は、音色を決める重要な情報です。同じ人が同じ高さで発声しても、「あ」と「い」では強く現れる周波数帯が異なります。この違いを捉えるために、メルフィルタバンクが使われます。
メルフィルタバンクは、細かすぎる周波数成分をそのまま扱うのではなく、人間の聞こえ方に近い帯域単位で情報をまとめます。これにより、必要な特徴を残しながらデータ量を抑えられ、学習や推論の処理も扱いやすくなります。
DCTでケプストラム係数へ変換する
メルフィルタバンクで得た対数エネルギーは、そのままでも音声の特徴を表します。ただし、隣り合うフィルタの値は似た傾向を持つことが多く、冗長な情報も含まれます。そこで、離散コサイン変換(DCT)を使って、情報をより少数の係数へまとめます。
DCTによって得られる値がケプストラム係数です。低次の係数は、声が太い、細い、明るい、暗いといった音色の大まかな特徴を表しやすく、高次の係数は細かな変化や揺れを含みやすくなります。音声認識では、すべての係数を使うのではなく、低次から一定数だけを使うことが一般的です。
元記事では変換方法を離散フーリエ変換として説明していましたが、一般的なMFCCの計算では離散コサイン変換(DCT)を使います。ここを混同すると、MFCCの計算手順を学ぶときに理解がずれやすいため注意が必要です。
音声認識でMFCCが使われる理由
音声認識では、入力された音声を特徴量に変換し、学習済みモデルがその特徴量のパターンを見て音素や単語を推定します。MFCCは、音声の重要な特徴を比較的少ない数値で表せるため、長く使われてきました。
特に、音声の音色に関係するスペクトル包絡を扱いやすく表現できる点が強みです。たとえば「あ」と「い」のような母音の違い、話者ごとの声質、電話越しの音声などは、周波数成分の分布に違いが現れます。MFCCはその違いを特徴量として取り出し、認識モデルが比較できる形にします。
また、MFCCは計算量が比較的軽く、リアルタイム処理にも向いています。そのため、音声入力、音声検索、自動音声応答、話者認識、感情認識、音声合成の前処理など、さまざまな音声処理で利用されてきました。
MFCCを学ぶときの注意点
MFCCは便利な特徴量ですが、音声の意味や文脈をそれだけで理解するわけではありません。MFCCが表すのは主に音響的な特徴であり、「何を話しているか」を判断するには、音響モデルや言語モデルなど、後段の仕組みが必要になります。
また、MFCCは雑音や録音条件の影響を完全に消せるわけではありません。騒音、マイクの品質、部屋の反響、話す速さなどによって特徴量は変わります。実務では、ノイズ除去、音量正規化、データ拡張、モデル側の工夫などと組み合わせて精度を高めます。
近年の深層学習では、生波形、スペクトログラム、メルスペクトログラムを直接入力する手法も広く使われています。それでもMFCCは、音声特徴量の基礎を理解しやすく、軽量で扱いやすい特徴量として今も重要です。音声認識の入門では、MFCCを学ぶことで「音声を機械が読める特徴に変換する」という考え方をつかみやすくなります。
まとめ
MFCC(メル周波数ケプストラム係数)は、人間の耳の聞こえ方を反映しながら、音声の音色に関係する特徴を数値化する方法です。音声を短い区間に分け、周波数分析、メルフィルタバンク、対数化、DCTを通して、認識モデルが扱いやすい特徴量へ変換します。
音声認識で重要なのは、音声波形そのものをそのまま比べることではなく、発音や音色の違いが現れる特徴を取り出すことです。MFCCはこの目的に合った代表的な特徴量であり、音声認識、話者認識、感情認識、音声検索などの基礎として理解しておきたい概念です。
更新履歴
| 日付 | 内容 |
|---|---|
| 2025年1月31日 | 初回公開 |
| 2026年7月5日 | 計算手順とDCTの位置づけを補い、音声認識での使い方を追記 |