AI活用

データサイエンティストの仕事とは?

情報を集め分析する専門家であるデータサイエンティストは、企業にとって宝ともいえる多くの情報の中から、真に価値のあるものを探し出し、会社の進むべき道を決める際に役立てます。まるで鉱山から宝石を掘り出す熟練の職人のように、データの海から価値ある情報を抽出するのです。 彼らは、数字を扱う学問や、機械に学習させる技術を用いて情報を分析し、一見すると分からない隠れた規則性や関係性を見つけ出します。例えば、顧客の購買情報から、どのような商品が一緒に買われやすいか、といった関係性を発見し、販売戦略に役立てます。また、天気や気温と商品の売れ行きの関係性を分析し、最適な在庫管理を行うことにも役立ちます。 未来を予測するのも、データサイエンティストの重要な役割です。過去の情報や現在の状況を基に、これからの世の中の動きや顧客の行動を予測する数式を作ります。これは、天気予報士が過去の気象データや現在の気圧配置から未来の天気を予測するのと似ています。未来の売上や顧客の動向を予測することで、企業は先を見据えた的確な準備を行い、成長へと繋げることができるのです。 近頃では、確かな情報に基づいた経営判断の大切さが増しており、データサイエンティストは会社にとってなくてはならない存在となっています。データサイエンティストは、まるで会社の羅針盤のように、情報に基づいた的確な方向へと会社を導き、成功へと導く重要な役割を担っているのです。
アルゴリズム

深さ優先探索で迷路を解くとは?意味・仕組み・活用例をわかりやすく解説

コンピュータに迷路を解かせる場面を想像してみてください。複雑に曲がりくねった通路を進むとき、どのように出口を探し出すのが良い方法でしょうか?このような問題を解くために、深さ優先探索と呼ばれる手法が役立ちます。この手法は、まるで糸を手繰り寄せるように、可能な限り深く迷路の奥へと進んでいく方法です。 具体的には、まず出発点からスタートし、行き止まりにぶつかるまで、ひたすら一つの道を進みます。行き止まりに到達したら、一つ前の分岐点まで戻り、まだ進んでいない別の道を選びます。そして、再び行き止まりにぶつかるまで進み、これを繰り返します。まるで冒険家が未知の洞窟を探検するように、あらゆる道をくまなく探索していくイメージです。 この探索方法の利点は、比較的単純な手順で実装できることです。複雑な計算や高度な判断は必要なく、ひたすら「前に進む」「行き止まりなら戻る」「別の道を選ぶ」という動作を繰り返すだけで、最終的には迷路の出口にたどり着くことができます。ただし、非常に深く入り組んだ迷路の場合、探索に時間がかかる可能性があります。また、最短経路で見つからない場合もあります。 この記事では、深さ優先探索の基本的な考え方と、それを迷路解決にどのように応用するかを具体例を交えて解説します。迷路を二次元配列として表現し、各地点を「通路」「壁」「現在地」「通過済み」といった状態に分け、プログラムでどのように処理していくかを順を追って説明します。深さ優先探索の仕組みを理解することで、複雑な問題解決へのアプローチ方法を学ぶことができます。ぜひ最後までお読みください。
LLM

文章生成の革新:GPT

近ごろの科学技術の進歩はめざましく、中でも人の知能を模倣した技術の分野は驚くほどの発展を見せています。特に、文章を自動で作る技術は多くの関心を集めており、様々な分野で活用され始めています。この技術の中でも、GPTは特に注目すべき技術と言えるでしょう。GPTは、人間が書いた膨大な量の文章を読み込み、そこから言葉の使い方や文章の構成などを学びます。そして、まるで人間が書いたかのような自然で分かりやすい文章を作り出すことができます。 GPTが持つこの高度な文章生成能力は、私たちの生活や仕事のやり方を大きく変える可能性を秘めています。例えば、これまで多くの時間と労力をかけていた文章作成作業を自動化することで、私たちの負担を大幅に減らすことができます。また、GPTを活用することで、より質の高い文章を作成することも可能になるでしょう。 この技術は、様々な場面で活用されることが期待されています。例えば、ニュース記事や小説、詩などの創作活動、顧客対応の自動化、多言語翻訳、情報要約など、その応用範囲は非常に広いです。もちろん、GPTのような高度な文章生成技術には、倫理的な問題や社会への影響など、解決すべき課題も存在します。しかし、この技術が持つ可能性は計り知れず、私たちの未来をより豊かで便利なものにしてくれると期待されています。 本稿では、このGPTの仕組みや特徴、そして社会に与える影響について、より深く掘り下げて解説していきます。GPTがどのように文章を生成するのか、その仕組みを分かりやすく説明し、他の文章生成技術との違いやGPTならではのメリット・デメリットについても詳しく解説します。さらに、GPTの活用事例や今後の発展性、そして社会にもたらす影響についても考察していきます。これらを理解することで、GPTの持つ可能性と課題を正しく認識し、より効果的に活用していくことができるでしょう。
学習

残差強化学習とは?意味・仕組み・活用例をわかりやすく解説

近年、機械学習という分野の中で、強化学習というものが注目を集めています。 強化学習とは、機械がまるで人間のように、様々な試行錯誤を繰り返しながら、周りの環境から学習していく方法のことです。しかし、複雑で難しい課題に直面すると、学習に時間がかかってしまうという問題がありました。 そこで、より速く効率的に学習を進める方法として、残差強化学習という新しい手法が登場しました。これは、従来の強化学習に改良を加えたもので、複雑な課題にも対応できる、より高度な学習方法です。 残差強化学習は、まず全体の目標を小さな目標に分割します。そして、それぞれの小さな目標を達成するための学習を行います。大きな目標を一気に行うのではなく、小さな目標を一つずつクリアしていくことで、学習の効率を高めることができるのです。 小さな目標を達成するごとに、機械は「報酬」を受け取ります。この報酬は、機械にとってのモチベーションとなり、次の目標達成へと駆り立てます。そして、全ての小さな目標を達成することで、最終的に全体の目標を達成できるようになるのです。 残差強化学習は、ロボット制御やゲームプレイなど、様々な分野で応用されています。例えば、ロボットに複雑な動作を教えたい場合、残差強化学習を用いることで、よりスムーズで効率的な学習が可能になります。また、ゲームのキャラクターをより賢く動かすためにも、この技術は役立ちます。 従来の強化学習では難しかった複雑な課題も、残差強化学習を用いることで解決できる可能性が広がっています。今後の発展に、ますます期待が高まっています。
学習

説明変数とは何か?

物事の結果に影響を与えると思われる様々な要素を、説明変数と呼びます。別の言い方をすれば、ある事柄を説明したり、将来を予測するために役立つ数値や情報のことです。 例えば、庭に植えたひまわりの成長について考えてみましょう。ひまわりの成長に影響を与える要素として、日当たりの良い時間や、水やりの回数、土の種類などが考えられます。これらの要素こそが説明変数です。日当たりが良ければ良く育つでしょうし、水やりが少なすぎれば枯れてしまうかもしれません。土に栄養がなければ、あまり大きく成長しないかもしれません。このように、これらの要素が変化すると、ひまわりの成長にも変化が現れると予想されます。 統計や機械学習といった分野では、説明変数を用いて、目的とする事柄(目的変数)を予測するための計算式(モデル)を作ります。この計算式を作る際、説明変数は計算式の入力となり、目的変数(ひまわりの成長具合など)は計算式の出力となります。ひまわりの例で言えば、日当たり時間、水やり回数、土の種類といった説明変数を入力することで、ひまわりがどれくらい成長するかを予測する計算式を作るわけです。 より正確な予測をするためには、適切な説明変数を選ぶことがとても大切です。例えば、ひまわりの成長を予測するために、近所の猫の鳴き声を加えても、あまり意味がありません。適切な説明変数を選ぶことで、より精度の高い予測モデルを構築し、ひまわりの成長をより正確に予測することが可能になります。
学習

データの網羅性とは?AI学習の鍵

機械学習は人工知能の中でも特に注目を集める技術であり、その発展は学習データに大きく依存しています。まるで生命の源である血液のように、データは機械学習モデルの成長を支える重要な役割を担っています。高精度なモデルを作るためには、質の高いデータはもちろん、十分な量のデータが必要です。さらに、データの網羅性も重要な要素となります。 データの網羅性とは、現実世界で起こりうる様々な事象や状況を、データがどれだけ漏れなく表現できているかを表すものです。例えば、猫を認識するモデルを開発する場合、様々な種類の猫の画像データが必要です。毛の色が異なる猫、様々なポーズをとる猫、子猫や老猫など、多様な猫の画像を網羅的に学習させることで、より精度の高い認識モデルを作ることが可能になります。もし特定の種類の猫の画像データばかりで学習した場合、そのモデルは他の種類の猫を認識できない可能性が高くなります。 これは猫の認識に限った話ではありません。自動運転技術を開発する場合、晴天時だけでなく、雨天時や雪道など、様々な気象条件下の道路状況を網羅したデータが必要です。また、歩行者や自転車、他の車両など、様々な状況を想定したデータも必要です。このように、現実世界を反映した多様で偏りのないデータセットを構築することは、様々な状況に対応できる、より信頼性の高い人工知能モデルの開発に不可欠です。データの網羅性を確保することで、人工知能は現実世界の問題をより効果的に解決できるようになり、私たちの生活をより豊かにしてくれる可能性を秘めています。
アルゴリズム

行動計画とSTRIPSとは?意味・仕組み・活用例をわかりやすく解説

行動計画とは、始めの状態から目標の状態にたどり着くまでの一連の手順を定める方法です。毎日の暮らしの中でも、朝起きてから会社に着くまでにすることを考えるのは、行動計画のひとつと言えるでしょう。 たとえば、会社に行くという目標を達成するためには、家を出る、電車に乗る、会社に着く、といった行動が必要です。これらの行動は順番通りに行わなければなりません。家を出る前に電車に乗ることはできませんし、電車に乗る前に会社に着くこともできません。このように、行動には順序があり、その順序を正しく組み立てることが行動計画の重要な点です。 また、それぞれの行動には、実行するための条件があります。たとえば、家を出るためには、鍵を持っている必要があります。電車に乗るためには、切符を買っている必要があります。これらの条件が満たされていない場合、行動を実行することはできません。行動計画では、これらの条件を考慮に入れて、実行可能な計画を作成する必要があります。 さらに、それぞれの行動には、結果が伴います。たとえば、家を出るという行動の結果、家の外に出ます。電車に乗るという行動の結果、会社に近づきます。これらの結果を予測することで、目標への到達を確実にすることができます。会社に行くという目標を達成するためには、家を出るという行動によって家の外に出る結果を得て、電車に乗るという行動によって会社に近づく結果を得る必要があります。 人工知能の分野では、機械に行動計画を立てさせる研究が盛んに行われています。たとえば、ロボットに特定の作業をさせる場合、どのような手順で作業を進めればよいかをロボット自身に考えさせることができます。また、ゲームのキャラクターに複雑な行動をさせる場合にも、行動計画の技術が役立ちます。 複雑な状況の中で、最も効率の良い手順を見つけ出すためには、高度な計算技術が必要です。そのため、より効率的な方法の開発が重要な課題となっています。
AIサービス

生成AI:創造性を革新する人工知能

近頃、機械の知能、いわゆる人工知能(AI)は目覚ましい進歩を遂げ、暮らしの様々な場面で活躍しています。例えば、自動で車を動かす技術や、病気の診断を助ける技術、お金の取引を自動で行う技術など、AIは社会を便利で豊かなものにする大きな役割を担っています。これまで、AIは主に情報を読み解いたり、論理的に考える作業に優れていましたが、新しいものを作り出すといった創造的な活動は、人間の特別な能力だと考えられてきました。しかし、ここに来て「生成AI」と呼ばれる新しい技術が登場し、AIが創造性の分野にも進出を始めています。この生成AIは、まるで人間が想像力を働かせるように、文章や音声、絵や動画、音楽など、様々な新しい情報を作ることができるのです。 この画期的な技術は、芸術や娯楽、教育や研究など、様々な分野で活用が期待されています。例えば、芸術の分野では、画家や音楽家が新しい作品を生み出す際の助けとなるでしょう。また、娯楽の分野では、今までにないゲームや映画の制作に役立つと期待されています。教育の分野では、生徒一人ひとりに合わせた教材作りや、学習内容の説明に役立ち、研究の分野では、新しい薬や材料の開発に貢献する可能性を秘めています。 生成AIによって作り出されるものは、単なる情報の組み合わせではありません。AIは大量の情報を学び、その中にあるパターンやルールを見つけ出し、それらを元に全く新しいものを作り出すことができます。これは、まさに人間の創造性に匹敵する能力と言えるでしょう。今後、生成AIは様々な分野で活用され、私たちの創造活動を大きく変えていくと予想されます。まるで無限の可能性を秘めたこの技術は、私たちの未来をより豊かで創造的なものにしてくれるでしょう。
学習

ドメインランダマイゼーションでリアリティギャップを克服

近頃、人工知能の技術は、驚くほどの速さで進歩し、様々な分野で活用されるようになってきました。特に、機械の制御や車の自動運転といった分野では、模擬実験の環境で学習させた技術を現実世界で使うことが期待されています。模擬実験は、まるで現実世界のような環境を作り出して行う実験のことです。 しかし、模擬実験はあくまでも現実世界を近づけたものに過ぎません。現実世界そのものではありません。そのため、どうしても現実世界との間に違いが生じてしまいます。この違いは、まるで本物そっくりの映画のセットと、実際の街並みとの違いのようなものです。セットは一見すると本物のように見えますが、細かい部分を見ていくと、現実とは異なる点がたくさんあります。 人工知能の世界でも、同じようなことが起こります。模擬実験の環境では非常に高い性能を示す技術が、現実世界ではうまくいかないという問題が発生するのです。これは、模擬実験で作られた仮想世界と現実世界との間に、まるで深い溝があるように、違いが存在するためです。この違いのことを「現実との差」と呼び、人工知能を実際に使えるようにするための大きな課題となっています。 例えば、自動運転の技術を開発する場合、模擬実験では、様々な道路状況や天候を再現して、車を安全に走らせるための学習を行います。しかし、現実の道路には、模擬実験では再現できないような、予期せぬ出来事が起こることがあります。例えば、急に子供が飛び出してきたり、道路に障害物が落ちていたりするなどです。このような状況に、模擬実験だけで学習した人工知能は、うまく対応できない可能性があります。 この「現実との差」を埋めるためには、様々な工夫が必要です。例えば、より現実世界に近い精巧な模擬実験環境を作る、現実世界で得られたデータを使って人工知能の学習を補完する、人工知能が現実世界でうまく動作しなかった場合の原因を分析し、改善策を模擬実験に反映させる、といった方法が考えられます。これらの方法を組み合わせることで、人工知能を現実世界でより効果的に活用できるようになると期待されています。
AI活用

説明可能なAI:信頼の構築

近頃、人工知能(AI)は私たちの暮らしの中に急速に広まり、様々な場面で役立てられています。買い物をする時の商品のおすすめや、病院での診察、車の自動運転など、AIはすでに私たちの生活に欠かせないものとなっています。しかし、AIがどのように考えて結論を出しているのかが分かりにくいという問題も抱えています。まるで魔法の箱のように、入力すると結果が出てくるだけで、その過程が見えないため「ブラックボックス」と呼ばれています。このようなAIの仕組みが分からない状態では、たとえ正しい結果が出たとしても、本当に信頼していいのか不安に感じてしまいます。 そこで注目されているのが、説明可能なAI、つまり「説明できるAI」です。これは英語でExplainable AIと言い、XAIと略されることもあります。XAIは、AIがどのように考えて答えを出したのかを、人間にも理解できる言葉で説明してくれる技術です。まるで算数の問題で、答えだけでなく計算の過程も示してくれる先生のように、XAIはAIの思考プロセスを分かりやすく示してくれます。例えば、AIが特定の商品をおすすめしてきた場合、XAIは「この商品はあなたの過去の購入履歴や年齢、最近の流行などを考慮して選びました」といった具体的な理由を提示します。 XAIによってAIの思考過程が明らかになることで、私たちはAIの判断をより深く理解し、信頼性を高めることができます。もしAIが間違った判断をした場合でも、その原因を特定しやすく、改善につなげることができます。さらに、AIが差別的な判断をしていないか、倫理的な問題がないかを確認することも可能になります。XAIは、AIをより安全に、そしてより効果的に活用するための重要な鍵となるでしょう。今後、様々な分野でXAIの活用が期待されており、私たちの生活をより豊かにしてくれると信じています。
学習

データ正規化と重みの初期化

情報をうまく扱う機械を作るには、準備段階がとても大切です。その中でも、情報の整え方の一つである「正規化」は重要な役割を担います。正規化とは、様々な範囲に散らばっている情報を、決められた範囲、例えば0から1の間に収めるように変える作業のことです。では、なぜこのような作業が必要なのでしょうか。 たとえば、賃貸物件の値段を予想する機械を想像してみてください。この機械には、物件の広さ(平方メートル)と築年数(年)の情報を与えるとします。広さと築年数は、単位も範囲も全く違います。もし、そのまま機械に情報を与えると、広さの情報ばかりが重視され、築年数の情報が軽視される可能性があります。つまり、機械が正しく学習できないのです。 正規化を行うことで、これらの情報の範囲を同じように揃え、機械がすべての情報を受け入れやすくします。これは、すべての情報を同じように大切にするということです。そうすることで、機械の学習速度と正確さが向上します。 また、正規化は情報の偏りをなくす効果もあります。例えば、ある情報が極端に大きな値を持つ場合、その情報が機械の学習に過剰な影響を与えてしまうことがあります。正規化によって値の範囲を調整することで、このような偏りを防ぎ、より安定した結果を得ることができます。 さらに、正規化は異なる種類の情報を比較しやすくするという利点もあります。例えば、身長と体重のように単位も範囲も異なる情報を比較する場合、正規化によって両者を同じ尺度に変換することで、より意味のある比較が可能になります。このように、正規化は機械学習において、データの前処理として非常に重要な役割を果たしているのです。
学習

Garbage In, Garbage Outとは?機械学習でデータ品質が重要な理由

機械学習とは、人間のように学習し推論する能力をコンピュータに持たせる技術です。膨大な量の情報をコンピュータに与えることで、コンピュータ自身がそこから規則性やパターンを見つけ出すことを可能にします。まるで職人が長年の経験から勘を磨くように、コンピュータもデータから学習し、未来の予測や状況判断を行うことができるようになります。 近年、この機械学習は様々な分野で活用され、私たちの生活にも大きな変化をもたらしています。例えば、自動車の自動運転技術では、周囲の状況を認識し、適切な運転操作を行うために機械学習が用いられています。また、医療の現場では、画像診断や病気の早期発見に役立てられています。さらに、インターネット通販では、個々の利用者の好みに合わせた商品推薦にも利用されており、私たちの購買行動にも影響を与えています。このように、機械学習の応用範囲はますます広がり、私たちの社会に欠かせない技術になりつつあります。 しかし、機械学習の成果は、学習に用いるデータの質に大きく左右されます。質の高いデータを入力すれば、精度の高い予測や判断が期待できますが、逆に質の低いデータを入力すると、誤った結果を導き出す可能性が高まります。これは、「質の低い入力は質の低い結果を生む」という、「ごみを入れたらごみが出てくる」という格言にも例えられます。つまり、機械学習を効果的に活用するためには、質の高いデータを集め、適切に処理することが非常に重要なのです。データの前処理、例えば不要なデータの除去やデータの形式の統一などは、機械学習の精度向上に欠かせない作業と言えるでしょう。適切なデータがあってこそ、機械学習は真価を発揮し、私たちの生活をより豊かにしてくれるのです。
アルゴリズム

赤池情報量基準:モデル選択の指標

統計解析を行う上で、数ある統計モデルの中から最適なものを選ぶことは肝要です。適切なモデル選びは、データに潜む真の構造を明らかにする鍵となります。そこで登場するのが、赤池情報量基準(AIC)です。AICは、モデルの良さだけでなく、複雑さも加味して評価することで、データへの過剰な適合を防ぎ、より良いモデル選びを助けてくれます。 統計モデルとは、データの生成過程を数式で表現したものです。例えば、ある商品の売上高を予測したい場合、売上高に影響を与えるであろう広告費や気温などの変数を用いてモデルを構築します。しかし、変数を多くすればするほどモデルは複雑になり、手元のデータにぴったりと合うようになります。一見すると良いモデルのように思えますが、これは過学習と呼ばれる状態で、新しいデータに対しては予測精度が下がってしまう可能性があります。AICは、このような過学習を防ぐために、モデルの複雑さを罰則として加えることで、真の構造を捉えることに重点を置いたモデル選びを実現します。 AICは、-2 × (最大対数尤度) + 2 × (モデルのパラメータ数)で計算されます。最大対数尤度は、モデルが観測データにどれだけ適合しているかを示す指標で、値が大きいほど適合度が高いことを意味します。パラメータ数は、モデルの複雑さを表す指標で、値が大きいほどモデルは複雑になります。AICはこれらのバランスを取りながら、最適なモデル選びを支援します。AICが小さいほど良いモデルとされ、複数のモデルを比較する際は、AICが最も小さいモデルが最良のモデルとして選択されます。 AICは様々な分野で活用されています。例えば、経済学では、経済指標の予測モデルの選択に、医学では、病気の診断モデルの選択に、そして工学では、システム制御モデルの選択に用いられています。AICは、データに基づいて客観的にモデルを選択できる強力なツールであり、その活用は研究の信頼性を高める上で非常に重要です。
IoT

データ取得:信頼性と効率性を両立

近頃は、技術の進歩によって、とてもたくさんの情報が集まるようになりました。これらの情報は、企業がどのような活動をするか決めたり、新しい商品を作ったり、社会の問題を解決したりなど、色々な場面で使われています。しかし、集めた情報が本当に役に立つためには、確かな情報であることがとても大切です。そのため、情報を集める方法や仕組みを作る際には、綿密な計画と確認作業が必要不可欠です。 まず、情報の集め方をしっかり考えないと、間違った情報や偏った情報が集まってしまうことがあります。例えば、ある商品の評判を知りたいとき、特定の場所や特定の人たちからだけ意見を聞くと、本当の評判とは違う結果になってしまうかもしれません。ですから、色々な立場の人から、色々な方法で情報を集めることが重要です。アンケート調査、インタビュー、実験、観察など、色々な方法を組み合わせて、多角的に情報を集めることで、より正確な全体像を把握することができます。 次に、集めた情報の正しさを確かめる作業も欠かせません。集めたばかりの情報には、間違いや不足が含まれている可能性があります。そのため、情報を整理し、内容を確認し、必要に応じて修正や追加を行う必要があります。また、情報の出典や収集方法が明確になっているかどうかも重要な確認事項です。出典が不明瞭な情報や、偏った方法で集められた情報は、信頼性が低いため、重要な判断材料として使うことは避けるべきです。 最後に、情報を効率よく集める仕組みを作ることも大切です。一度に大量の情報を集める必要がある場合、手作業では時間と手間がかかりすぎてしまいます。そこで、コンピューターを使ったシステムを構築することで、自動的に情報を集め、整理することができます。このようなシステムを導入することで、時間と労力を節約できるだけでなく、より多くの情報を迅速に集めることが可能になります。 このように、信頼できる情報を集めるためには、計画から検証、そしてシステム構築まで、それぞれの段階で丁寧な作業が必要です。適切な方法で集められた情報は、様々な分野で大きな価値を生み出し、社会の発展に貢献することができます。
アルゴリズム

ロボットの行動計画:プランニングとは

機械などが目的を達成するためには、どのように動くか、どう作業するかをあらかじめ決めておく必要があります。この動きの設計図を作る技術のことを、計画作成と言います。計画作成は、機械を自分で動かす技術の中でも特に大切な基本技術で、機械が自分の力で動くための土台となります。たとえば、部屋の中を動く機械を思い浮かべてください。ものをよけながら目的地に着くためには、正しい道筋を選ぶ必要があります。この道筋を選ぶことが、まさに計画作成の役割です。計画作成は単に道筋を決めるだけでなく、様々な仕事をこなすための一連の動きを作る技術を指します。 計画作成が必要となる場面はたくさんあります。工場の組み立てラインで部品を組み立てる機械の腕、倉庫の中で荷物を運ぶ機械、そして宇宙を調査する機械など、様々な機械が計画作成技術を使っています。機械が複雑な環境の中で自分の力で動くためには、高度な計画作成技術が欠かせません。また、計画作成は機械の分野だけでなく、自動で動く車や空飛ぶ機械などにも使われています。これらの機械では、周りの様子を認識し、安全で効率の良い道筋を作るために計画作成技術が使われています。計画作成技術の進歩は、自分で動く機械の更なる発展に大きく貢献していくでしょう。そのため、計画作成技術は機械の分野で重要な研究テーマとなっています。より高度な計画作成技術を作ることが、未来の機械が活躍する場を広げる鍵となるでしょう。
アルゴリズム

GRUとは?LSTMとの違いとゲート構造を初心者向けに解説

人間が何かを学ぶとき、過去の経験や知識を思い出して活かします。同じように、コンピュータにも過去の情報を覚えて活用する仕組みが必要です。文章や音声のように、時間とともに変化するデータを扱う場合、過去の情報が現在の状態に影響を与えるため、そのつながりを考慮しなければなりません。そこで登場するのが、リカレントニューラルネットワーク(回帰型神経回路網)と呼ばれる技術です。これは、過去の情報をループ状に保持し、現在の情報処理に役立てる仕組みです。 しかし、初期のリカレントニューラルネットワークには、遠い過去の情報を覚えておくのが苦手という弱点がありました。例えるなら、長い文章を読んでいるうちに、最初の頃の内容を忘れてしまうようなものです。この問題を解決するために、長期・短期記憶(LSTM)と呼ばれる技術が開発されました。LSTMは、情報を記憶しておくための特別な仕組みを備えており、より長い期間の情報を覚えることができます。まるで、重要な箇所に線を引いたり、メモを取ったりしながら読書をするように、必要な情報をしっかりと記憶しておくのです。 LSTMは画期的な技術でしたが、複雑な構造であるがゆえに、計算に時間がかかり多くの資源が必要という問題がありました。そこで、LSTMの機能は維持しつつ、より効率的に計算できるように改良されたのが、ゲート付き回帰型ユニット(GRU)です。GRUはLSTMに比べて構造を簡素化することで、計算の負担を軽減することに成功しました。これは、持ち物を整理して、必要なものだけをコンパクトな鞄に詰め替えるようなものです。必要な情報はきちんと保持しながら、処理の速度と効率を向上させたGRUは、様々な分野で活用される、重要な技術となっています。
学習

オフライン強化学習:データ駆動型学習の革新

近ごろの科学技術の進歩によって、人工知能の研究はめざましい発展を遂げてきました。中でも、機械学習の一種である強化学習は様々な分野で注目を集めています。ロボットの動きの制御やゲームにおける戦略の決定など、複雑な課題を解決する大きな可能性を秘めているからです。 従来の強化学習では、実際に試したり、失敗したりすることを繰り返しながら学習を進める必要がありました。まるで人間が新しい技術を習得する過程とよく似ています。自転車の乗り方を覚える時、何度も転びながら練習するように、強化学習も試行錯誤を通じて学習を進めます。しかし、現実世界の問題を扱う場合、この試行錯誤による学習は危険を伴う場合や多大な費用がかかる場合があり、常に現実的であるとは限りません。例えば、自動運転技術の開発において、試行錯誤による学習は事故の危険性があるため、現実世界での実施は困難です。また、工場の生産ラインの最適化においても、試行錯誤による学習は生産効率の低下につながる可能性があり、多大な損失をもたらす可能性があります。 そこで、近年注目されているのがオフライン強化学習という手法です。オフライン強化学習は、過去に集められたデータを使って学習を行うため、実際に現実世界の環境で試したり、失敗したりする必要がありません。これは、既に取得済みの運転データを使って自動運転技術を向上させる、あるいは過去の生産データを使って工場の生産ラインを最適化することに似ています。オフライン強化学習を用いることで、現実世界の環境で試行錯誤を行うことなく、安全かつ効率的に学習を進めることが可能になります。 この革新的な手法は、自動運転、ロボット制御、医療診断、創薬など、様々な分野での応用が期待されており、今後の発展に大きな注目が集まっています。オフライン強化学習の発展によって、人工知能はより現実世界の問題解決に貢献し、私たちの生活をより豊かにする可能性を秘めています。
AIサービス

テンプレート機能でAI-OCRをもっと使いやすく

初めて画像から文字を読み取る技術に触れる時、多くの人がどこから始めたら良いのか分からず、途方に暮れる思いをすることでしょう。特に、色々な書式や様式の書類を読み込みたい場合、それぞれの書類に合わせて設定を変えるのは、骨の折れる作業です。例えば、請求書を読み取る場合、日付、金額、会社名など、抽出したい情報がそれぞれ異なる場所に記載されているため、設定を細かく調整する必要があります。また、商品の説明書を読み取る場合、文字の大きさやフォントが異なる場合があり、その都度設定を変更しなければ正確に読み取ることができません。しかし、使いやすい雛形を用意する機能があれば、このような初期設定の手間を大幅に減らすことができます。あらかじめ用意された雛形には、請求書、領収書、説明書など、一般的な書類の種類ごとに最適な設定が保存されています。利用者は、読み込みたい書類の種類に合った雛形を選ぶだけで、基本的な設定が完了します。そのため、初めてこの技術を使う人でも、スムーズに作業を始められます。 例えば、初めて請求書を読み取る場合でも、「請求書」の雛形を選ぶだけで、日付や金額といった重要な情報が自動的に抽出されるようになります。手作業で設定を行う必要がないため、時間と労力を大幅に節約できます。また、読み取りの精度も向上するため、入力ミスや転記ミスを減らすことができます。複雑な設定に頭を悩ませる必要がなく、すぐにでも画像から文字を読み取る技術の恩恵を受けることができるのです。さらに、一度設定した雛形は保存しておけるため、次回から同じ種類の書類を読み取る際に、再度設定を行う必要はありません。このように、雛形機能は、初めて画像から文字を読み取る技術を使う人にとって、非常に便利な機能と言えるでしょう。作業効率を大幅に向上させ、誰でも簡単に利用できる環境を提供してくれます。
GPU

画像処理の要、GPU

画像処理装置は、電子計算機の中で絵を描くことに特化した部品です。写真や動画、遊戯の画面など、私たちが目にする画像を作り出す役割を担っています。「絵を描く処理装置」というのが正式名称で、その名の通り、画像処理に特化した処理装置です。 電子計算機の中でも、画面表示をする機器には必ずと言っていいほど搭載されています。例えば、持ち運びのできる計算機や電話機、遊戯機など、画面を持つあらゆる電子機器の中で活躍しています。画像処理装置があるおかげで、私たちは鮮明で滑らかな映像を楽しむことができるのです。 近年では、画像処理以外にも活躍の場を広げています。人工知能の学習や科学技術の計算など、様々な分野で活用されるようになってきており、なくてはならない存在になりつつあります。これは、画像処理装置が並列処理に優れているという特徴があるためです。たくさんの計算を同時に行うことができるので、複雑な計算も速く行うことができます。 電子計算機全体の司令塔を中央処理装置と呼ぶとすると、画像処理装置は画像処理における司令塔と言えるでしょう。中央処理装置が全体の処理を管理しているのに対し、画像処理装置は画像処理に特化した命令を処理します。両者はそれぞれ得意な処理が異なるため、役割分担をすることで電子計算機の処理能力を最大限に引き出すことができるのです。 このように、画像処理装置は現代の電子機器に欠かせない重要な部品となっています。今後ますます技術が進歩していくことで、私たちの生活はさらに便利で豊かなものになっていくでしょう。そして、その進化を支える重要な役割を、画像処理装置は担っていくと考えられます。
学習

状態表現学習:強化学習を加速する

近年、人工知能技術の進歩は目覚ましく、様々な分野で応用が広がっています。中でも、強化学習は特に注目を集める学習方法の一つです。強化学習とは、まるで人間が学習するかのごとく、試行錯誤を繰り返しながら、周囲の環境との関わり合いを通じて学習を進める方法です。例えば、ロボットの動きの制御や、ゲームの遊び方を学ぶといった場面で使われています。 しかし、強化学習は複雑な環境ではなかなか学習が進まず、うまくいかないという課題も抱えています。複雑な状況に対応するためには、より効率的な学習方法を見つける必要があります。そこで、強化学習を助ける重要な技術として、「状態表現学習」が登場しました。 状態表現学習とは、周囲の環境の状態を適切に表すことを目指す技術です。例えば、ロボットが周囲の状況をどのように認識し、理解するかが重要になります。ロボットにとっての「状態」とは、周囲にある物体の位置や形、色、そして自身の腕や脚の位置や角度など、様々な情報を含んでいます。これらの情報を適切に捉え、表現することで、ロボットはより効率的に学習を進めることができます。 状態表現学習は、強化学習の効率を上げるための鍵となる技術です。適切な状態表現を獲得することで、複雑な環境でもスムーズに学習を進めることができ、ロボット制御やゲームプレイといった様々な分野での応用が期待されます。今後、状態表現学習の発展は、人工知能技術の発展をさらに加速させると考えられます。
アルゴリズム

テンプレートマッチで画像を探す

私たちの身の回りでは、写真や絵の中から特定のものを見つける技術が、様々なところで役立っています。例えば、工場で製品の不完全な部分を見つける検査や、病院で病気を見つけるための画像診断、そして自動車が自分で走るための自動運転技術など、多くの分野で使われています。 このような技術の中でも、「テンプレートマッチング」と呼ばれる方法は、その分かりやすさと、色々な場面で使えるという特徴から、広く使われている画像の中のものを探し出す方法の一つです。 テンプレートマッチングは、例えるなら、絵探しパズルのようなものです。探したい絵の一部(テンプレート)をあらかじめ用意しておき、大きな絵の中から、そのテンプレートと全く同じ形や模様の部分を探し出すのです。この方法は、プログラムで実現するのが比較的簡単なので、多くの場面で使われています。 テンプレートマッチングの利点は、計算が単純で、処理速度が速いことです。また、特別な装置や複雑な設定が必要ないため、導入しやすいというメリットもあります。 しかし、テンプレートマッチングには課題もあります。例えば、探したいものが少し傾いていたり、大きさが違っていたりすると、見つけることが難しくなります。また、光の影響で色が変わっていたり、背景に紛れていたりする場合も、うまくいかないことがあります。 このように、テンプレートマッチングは手軽で便利な技術ですが、万能ではありません。状況によっては、他の高度な技術と組み合わせるなど、工夫が必要となる場合もあります。この技術の仕組みや利点、課題点を理解することで、より効果的に活用することが可能になります。
AI活用

製品の外観検査:品質保証の第一歩

外観検査とは、製品の最終チェックであり、人間の目で製品の仕上がり具合を確かめる作業のことです。工場で作られた製品が、設計図通りに作られているか、傷や汚れ、変色がないか、部品が正しく組み合わされているかなどを細かく調べます。これは、製品の品質を保つために欠かせない工程です。不良品が市場に出回るのを防ぎ、顧客の満足度を保つためには、外観検査の正確さを高めることがとても大切です。 検査する項目は製品の種類によって様々ですが、基本的には大きさ、形、色、表面の状態などを確認します。製品の寸法が設計通りか、形が歪んでいないか、色は均一で変色がないか、表面に傷や汚れ、凹凸がないかなどを、五感を駆使して注意深く観察します。場合によっては、専用の検査機器を使って、肉眼では見えない微細な傷や欠陥を見つけ出すこともあります。顕微鏡や拡大鏡を用いて表面の微細な傷や異物を見つけたり、特殊な光を当てて表面の凹凸や欠陥を検出したりするなど、高度な技術が用いられることもあります。 特に、熟練した検査員は長年培ってきた経験と知識を活かして、ごくわずかな異常も見逃しません。彼らは、まるで職人のように、鋭い目で製品の一つ一つを丁寧に検査し、不良品を排除します。製品の品質を守る最後の砦として、彼らの役割は非常に重要です。近年では、自動化技術の発展に伴い、カメラやセンサーを用いた自動外観検査システムも導入されていますが、最終的には人間の目による確認が不可欠な場合が多く、人の目による外観検査は今でも重要な役割を担っています。高い精度と信頼性を保つためには、検査員の育成や教育も重要であり、技術の伝承も重要な課題となっています。
LLM

文章生成AIとは?GPTの仕組みと使い方を初心者向けに解説

近頃、技術の進歩には目を見張るものがあります。中でも、文章を自動で作る人工知能の進化は目覚しく、まさに驚異的と言えるでしょう。この技術の中心となっているのが、「生成済み事前学習済み変換器」の略称である「言語モデル」です。この言語モデルは、膨大な量の文章データから学習することで、まるで人間が書いたかのような自然な文章を作り出すことができます。 具体的には、人に代わって電子郵便を書いたり、新聞の記事や物語などを創作したりすることが可能です。そのため、様々な分野での活用が期待されています。例えば、顧客からの問い合わせに自動で返答するシステムや、ニュース記事を自動生成するシステムなどが考えられます。また、小説や脚本の執筆支援ツールとしても活用できるでしょう。 この言語モデルの最大の特徴は、その高い柔軟性にあります。与えられたキーワードやテーマに基づいて、多様な文章表現を生成することが可能です。例えば、「春」というキーワードを与えると、春の美しい情景を描写した文章や、春の訪れを喜ぶ心情を表した文章など、様々な文章が生成されます。また、文体や口調も自由に調整できるため、フォーマルな文章からカジュアルな文章まで、様々な場面に対応できます。 この技術の進歩は、私たちのコミュニケーションや情報伝達の方法を大きく変える可能性を秘めています。従来は人間が行っていた文章作成作業を人工知能が担うことで、作業効率の向上やコスト削減が期待できます。また、より多くの人が質の高い情報を手軽に入手できるようになるでしょう。今後、この技術がどのように発展し、私たちの生活にどのような影響を与えるのか、注目が集まっています。
アルゴリズム

探索木とは?迷路で学ぶ仕組みと幅優先・深さ優先探索

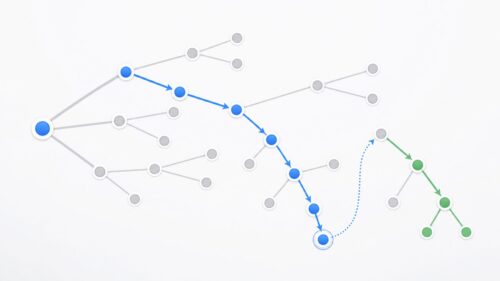
道が入り組んだ迷路を解く手順を、どのように機械に教えたらよいのでしょうか?人は、行き止まりにぶつかるまで進んだり、分かれ道でどちらの道を行くかいろいろ試しながら、ゴールを目指します。機械にも同じような考え方をさせる方法の一つに、探索木という仕組みを使うやり方があります。探索木とは、迷路の分かれ道や行き止まりを、木の枝のように表したものです。 木の根っこの部分から出発し、道が分かれるごとに新しい道を選び、それぞれの選択を木の枝として記録していきます。このようにして、迷路全体を木構造として捉えることで、機械はどの道がゴールに繋がっているかを能率的に探すことができるようになります。迷路の分かれ道に差し掛かると、機械はそこで可能な選択肢を木の枝として展開します。それぞれの枝は、その時点で選択可能な道を表しています。そして、選んだ道を進んで行き止まりに達した場合、その枝はそこで終わります。つまり、行き止まりは木の葉に相当します。もし、分かれ道に到達した場合には、さらにそこから枝分かれを繰り返します。 この探索木は、機械が迷路を探索する過程の記録であり、同時にこれから探索すべき経路の候補を示す地図でもあります。木を辿ることで、機械はこれまでどの道を通り、どこで行き止まりにぶつかったかを把握できます。また、まだ進んでいない枝があれば、そこにはまだ探索していない道が存在することを意味します。まるで木の枝を一本ずつ丁寧にたどっていくように、機械は探索木を使って迷路の出口を探し出します。このように、人間が迷路を解く時の試行錯誤を、探索木という構造によって機械にも再現させることができるのです。そして、この方法を用いることで、機械は複雑な迷路でも効率的に解くことができるようになります。