学習

深層学習における二重降下現象の謎

近年の技術革新はめざましく、様々な分野で目覚ましい成果を上げています。特に、人間の脳の仕組みを模倣した学習方法は、画像認識や自然言語処理といった分野で目覚ましい成果を上げてきました。しかし、この画期的な学習方法は複雑な仕組みを持ち、その奥底には未だ多くの謎が潜んでいます。 その謎の一つが「二重降下現象」と呼ばれるものです。この現象は、学習の進み具合を示す指標と、学習に使うデータの量や学習を行う仕組みの複雑さとの関係が、私たちの直感とは異なる変化を見せることを指します。一般的には、学習に使うデータを増やす、あるいは学習を行う仕組みを複雑にすることで、学習の進み具合を示す指標は向上すると考えられます。しかし、「二重降下現象」では、指標が一度向上した後、下降し、その後再び向上する、という不思議な変化が見られるのです。 まるで山を登り、一度谷に下り、再び山を登るような、この不思議な現象は、一体なぜ起こるのでしょうか。この現象は、学習に使うデータが少ない場合や、学習を行う仕組みが非常に複雑な場合に特に顕著に現れることが知られています。具体的には、学習の初期段階では指標が向上しますが、データの不足や仕組みの複雑さから、学習がうまく進まなくなり、指標が下降します。しかし、学習がさらに進むと、仕組みがデータの特徴をより深く捉えることができるようになり、再び指標が向上し始めるのです。 一見すると不可解なこの現象ですが、学習方法の仕組みをより深く理解する上で重要な手がかりを与えてくれます。「二重降下現象」を解明することで、より効率的な学習方法の開発や、より高性能な仕組みの構築につながると期待されています。この現象は、私たちがまだ学習方法の真の姿を完全には理解できていないことを示す、重要なサインと言えるでしょう。
AIサービス

説明可能なAIとその重要性

人間が理解できる人工知能、それが説明可能な人工知能(説明可能エーアイ)です。この技術は、人工知能がどのように考え、判断したのかを私たちに示してくれます。これまでの、特に深層学習を基盤とした人工知能は、複雑な計算過程がまるで中身の見えない箱のようでした。入力された情報から結果が出るまでの仕組みが分かりにくく、たとえ正しい答えを出しても、なぜそうなのか理由が分からなかったのです。これをブラックボックス問題と呼びます。例えば、病気の診断支援をする人工知能が、ある病気を診断したとします。しかし、どのような情報に基づいてその診断に至ったのかが分からなければ、医師は安心してその診断結果を治療に役立てることはできません。説明可能な人工知能は、この問題を解決するために開発されました。人工知能の思考過程を明らかにして、なぜその判断に至ったのかを説明できるようにすることで、私たち人間は人工知能の判断を信頼し、安心して様々な場面で活用できるようになります。例えば、医療の現場では、人工知能が示す診断の根拠を医師が理解することで、より的確な治療方針を立てることができるようになります。また、金融の分野では、融資の判断がどのように行われたかを説明することで、公平性を担保することができます。このように、説明可能な人工知能は、人工知能の信頼性を高め、社会における活用範囲を大きく広げる可能性を秘めているのです。
学習

機械学習のパラメータ調整とは?手法と注意点を初心者向けに解説

機械学習の模型を作る際には、その能力を最大限に発揮させるために、細かい設定を調整することが欠かせません。この設定値は、模型の動き方を決める指示のようなもので、適切な値を選ぶことで、模型の正確さや、様々な状況に対応できる能力を高めることができます。 この設定の調整作業は、まるで職人が道具を丁寧に調整するように、模型を最適な状態に仕上げるための重要な工程です。しかし、設定値の数は模型の種類や複雑さによって大きく変わり、数十から数百、時には数千にも及ぶことがあります。そのため、最適な設定値の組み合わせを見つける作業は非常に複雑で、多くの時間と労力を必要とします。 闇雲に設定値を調整するだけでは最適な結果を得ることは難しく、体系的な方法が必要です。例えば、特定の設定値を少しずつ変えながら、模型の性能がどのように変化するかを調べる方法があります。また、複数の有望な設定値の組み合わせを試し、最も良い結果を出す組み合わせを探す方法もあります。さらに、近年では、自動的に最適な設定値を見つけるための様々な技術も開発されています。これらの技術は、膨大な数の設定値の組み合わせの中から、効率的に最適な値を見つけ出すことを可能にします。 適切な設定値を見つけることは、機械学習の模型を実際に役立つものにするために不可欠です。時間をかけて丁寧に調整を行うことで、模型の性能を最大限に引き出し、様々な課題解決に役立てることができるようになります。
その他

中国語の部屋とは?AIは本当に理解しているのかをわかりやすく解説

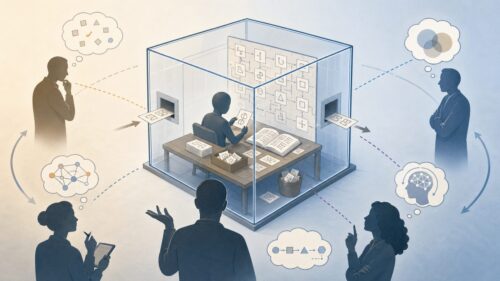
「中国語の部屋」という思考実験は、アメリカの哲学者、ジョン・サールによって考え出されたものです。この実験は、機械がどれだけ複雑な処理をこなせるようになっても、本当にものを考えていると言えるのかどうかという問題を私たちに問いかけます。 想像してみてください。ある部屋の中に、中国語が全くわからない人がいます。この人は、中国語で書かれた質問が書かれた紙切れを受け取ります。部屋の中には、分厚い説明書が置いてあります。この説明書には、中国語の文字をどのように組み合わせればよいかが、事細かに書かれています。まるで料理のレシピのように、どの文字にどの文字を組み合わせれば、どのような答えが作れるのかが、全て指示されているのです。 部屋の中にいる人は、中国語の意味は全くわかりません。ただ、説明書に書かれた通りに文字を組み合わせ、紙に書き写すだけです。そして、書き写した紙を部屋の外に出します。部屋の外には、中国語を理解できる人が待っています。この人から見ると、部屋の中から出てきた答えは、まるで中国語を理解している人が書いたかのように自然で正しいものです。まるで部屋の中にいる人が中国語を理解しているかのように見えます。 しかし、本当に部屋の中にいる人は中国語を理解していると言えるでしょうか? この人は、ただ説明書に従って文字を操作しただけで、中国語の意味は全く理解していません。料理のレシピ通りに料理を作れるからといって、料理人が食材や栄養について理解しているとは限らないのと同じです。この思考実験は、たとえ機械が人間のように振る舞えたとしても、それは単なる記号の操作に過ぎず、真の理解や知性とは異なるのではないかということを示唆しています。つまり、表面的に知的に見える行動と、本当の理解の間には大きな隔たりがあるということを、この「中国語の部屋」は私たちに教えてくれるのです。
学習

機械学習における内挿:未知への挑戦

既知の値を基に、未知の値を推測する手法を、内挿と言います。例えば、毎日決まった時刻に気温を測り、その記録があるとします。ある日の記録を取り忘れてしまった場合、前後の日の気温から、その日の気温を推測することができます。これが内挿です。言わば、点と点の間を滑らかに繋ぐ作業と言えるでしょう。 内挿は、限られた情報から全体像を掴むための便利な道具です。例えば、山の等高線を思い浮かべてみてください。等高線は、山のいくつかの地点の標高を示した線です。しかし、等高線の間の標高は直接測っていません。内挿を使って、既知の標高から等高線の間の標高を推測し、山の全体像を把握しているのです。 内挿は、様々な分野で役立っています。天気予報では、観測所の気温データから、観測所のない場所の気温を内挿によって推測し、気温分布図を作成しています。また、医療現場では、断層撮影などの画像データから、臓器の形状をより詳細に再現するために内挿が用いられています。 しかし、内挿はあくまで推測であることを忘れてはいけません。真の値とは異なる可能性があることを常に意識する必要があります。特に、データの値が大きく変動する場合は、内挿の精度は低くなります。例えば、株価の動きを内挿で予測するのは難しいでしょう。また、既知のデータの範囲外を推測する外挿は、内挿よりもさらに不確実性が高くなります。 内挿を効果的に活用するためには、データの特徴を良く理解し、適切な手法を選ぶことが重要です。そして、内挿の結果はあくまで推測値であることを踏まえ、慎重に判断する必要があります。
画像生成

画像生成AI「Midjourney」の魅力とは?使い方・仕組み・活用例をわかりやすく解説

言葉で表現したイメージを現実のものとする、まるで魔法のような技術、それが革新的な画像生成です。この技術を牽引する「Midjourney」は、言葉を入力するだけで、それに対応した画像を作り出すことができます。まるで魔法の呪文を唱えるように、頭に描いた情景を言葉に変換し入力するだけで、その通りの画像が目の前に現れます。 Midjourneyが生み出す画像は、単なる写真のような写実的な表現だけでなく、絵画のような芸術的な表現も可能です。油絵のようなタッチや水彩画のような風合い、鉛筆画のような繊細な線画など、様々な表現方法で画像を生成することができます。そのため、まるでプロの画家が描いたような、芸術性の高い作品を作り出すことも可能です。また、写真のように現実世界をそのまま切り取ったような画像も生成できます。風景写真、人物写真、物撮り写真など、あらゆるジャンルの写真表現に対応可能です。 従来、画像を制作するには専門的な知識や高度な技術が必要とされていました。絵を描くためにはデッサン力や色彩感覚、構図力などを習得する必要がありましたし、写真を撮影するにはカメラの操作方法や現像技術を学ぶ必要がありました。しかし、Midjourneyはこれらの専門知識や技術を必要としません。誰でも簡単に、思い通りの画像を作り出すことができます。使い方はとても簡単で、テキストボックスに言葉を入力するだけです。そのため、絵を描くのが苦手な人や、写真の撮影に慣れていない人でも、美しい画像を簡単に生成することができます。 これはまさに、画像生成における革命と言えるでしょう。誰もが自由に画像を作り、共有し、楽しむことができる新しい時代が到来しました。Midjourneyは、私たちの創造性を無限に広げ、表現の可能性を大きく変える力を持っています。この革新的な技術は、今後ますます発展し、私たちの生活に大きな影響を与えていくことでしょう。
開発環境

人工知能開発の立役者、Python

「パイソン」とは、様々な用途に使える便利な道具のような、広く使われているプログラムを作る言葉のことです。人間が使う言葉のように分かりやすく、書きやすいのが特徴で、プログラム作りを始めたばかりの人から、熟練した人まで、幅広い人に使われています。 パイソンは、まるで万能ナイフのように、色々なことができます。特に最近注目されている「人工知能」の開発には、パイソンが欠かせない存在となっています。人工知能は、まるで人間のように考えたり、判断したりするコンピュータを作る技術のことですが、パイソンを使うことで、複雑な計算や処理を分かりやすく書くことができます。 パイソンが人工知能開発で選ばれる理由の一つに、豊富な「道具」の存在があります。人工知能を作るには、様々な計算方法や手順が必要ですが、パイソンには、これらの「道具」があらかじめたくさん用意されています。そのため、開発者は、複雑な処理を一から作る必要がなく、用意されている「道具」を組み合わせることで、効率的に人工知能を作ることができます。これは、まるで、料理人が色々な調理器具を使って美味しい料理を作るのと同じです。 また、パイソンの分かりやすさも、人気の理由の一つです。プログラムを作る言葉の中には、複雑で分かりにくいものもありますが、パイソンは、人間が使う言葉に近い形で書くことができるため、読みやすく、理解しやすいという特徴があります。そのため、プログラムの修正や改良もしやすく、共同で開発を進める場合にも便利です。 パイソンは、人工知能開発以外にも、様々な分野で活躍しています。例えば、インターネット上で動く仕組みを作ったり、大量の情報を整理したり、分析したりするのにも使われています。このように、パイソンは、その使いやすさと汎用性の高さから、世界中で多くの人に利用され、今後も様々な分野で活躍していくことが期待されています。
その他

パラメータを理解する

仕組みを動かすための数値や文字列といった値のことを、言い換えるならば「変数」と呼びます。 機械や計算機を思い通りに操るには、この変数を調整することが重要です。例えば、温度調節器で室温を設定する際、設定温度が変数となります。この値を変えることで、温風や冷風の強さが変わり、結果として室温が変わります。 ウェブサイトで調べ物をする際にも、検索窓に入力する言葉が変数です。この言葉に基づいて表示される情報が変わります。また、写真加工のアプリで、明るさやコントラストを調整する際も、それぞれの設定値が変数となります。これらの値を変えることで、写真の雰囲気がガラリと変わります。 計算や統計の世界では、変数は「変わりうる数」という意味で使われます。例えば、商品の値段と売れた個数の関係を調べる際に、値段を変数として、売れた個数を分析します。一方、情報処理の世界では、変数はプログラムの動作や結果に影響を与える値を指します。 これらの値は、プログラムの一部として固定されているのではなく、外部から与えることができます。これにより、プログラムの動作を変えることなく、様々な状況に対応できます。例えば、人工知能の学習において、学習の速さや正確さを調整する値も変数として扱われます。 変数は、様々な種類があります。数値、文字列、日付など、様々な形式のデータを変数として扱うことができます。プログラムによって、どのような形式のデータを変数として扱えるかが決まります。変数を適切に設定することで、プログラムを思い通りに動かし、様々な結果を得ることができます。つまり、変数はプログラムを制御するための重要な要素と言えるでしょう。
学習

人工知能の鍵、特徴量設計とは?

計算機に学習させるための準備として、元の情報を計算機が理解できる数値へと変換する手順を特徴量設計と言います。これは、まるで人間が食事をする前に食べ物をよく噛み砕くように、計算機がデータをうまく処理できるようにするための大切な作業です。 例えば、コンビニの売上を予測する場面を考えてみましょう。売上高は、気温や曜日、近隣に住む人の数など、様々な要因に影響を受けます。これらの要因を数値化したものが特徴量です。 気温が高い日は冷たい飲み物がよく売れ、寒い日は温かい食べ物が売れると予想できます。これは、気温という特徴量が売上に影響を与えることを示しています。また、平日は近隣の会社員が多く利用し、週末は近隣住民の利用が多いといったように、曜日も売上を左右する重要な要素です。さらに、周辺の人口が多ければ多いほど、潜在的な顧客が増えるため、売上にも影響を与えると考えられます。これらの要因を数値化することで、計算機は売上とこれらの要素との関係性を学習し、将来の売上を予測することが可能になります。 特徴量設計の良し悪しは、学習結果の精度を大きく左右します。適切な特徴量を選択し、それを適切な数値表現に変換することで、計算機はデータに潜む規則性や関連性をより深く理解し、精度の高い予測や分類を行うことができます。逆に、重要な特徴量が見落とされていたり、適切な数値表現が用いられていなかったりすると、計算機はデータの本質を捉えることができず、学習の成果は期待できません。 特徴量設計は、データの性質や目的とするタスクに応じて、様々な工夫が凝らされます。例えば、複数の特徴量を組み合わせたり、既存の特徴量を加工して新しい特徴量を作成するなど、データ分析の専門家の知識と経験が活かされる重要な工程です。
AIサービス

マイクロソフトと人工知能

マイクロソフト社は、世界的に有名な巨大なソフトウェア会社です。パソコンの基本となるソフトウェアであるウィンドウズや、事務作業に欠かせないワード、エクセルといったオフィスソフトで広く知られています。近年、マイクロソフト社は、インターネットを通して様々なサービスを提供する、いわゆるクラウドコンピューティングと呼ばれる分野に力を入れています。中でも、人工知能技術を活用したサービス群である「アジュール・エーアイ」は、特に注目に値します。 この「アジュール・エーアイ」は、写真や絵の内容を理解する画像認識、人の声を文字に変換する音声認識、人間が使う言葉を理解し処理する自然言語処理など、多様な人工知能技術を、誰もが使いやすい形で提供しています。これまで人工知能技術を使うには、専門的な知識や高度な技術が必要で、限られた人にしか扱うことができませんでした。しかし、「アジュール・エーアイ」では、専門家ではない一般の人でも、高度な人工知能技術を簡単に利用できるようになっています。 例えば、プログラミングの知識がなくても、あらかじめ用意された機能を組み合わせるだけで、画像認識機能を使ったアプリを作ることができます。また、音声認識機能を使って、会議の内容を自動的に文字起こしすることも可能です。さらに、自然言語処理機能を活用すれば、大量の文章データから重要な情報を抽出したり、顧客からの問い合わせに自動で応答するシステムを構築したりすることもできます。 このように、マイクロソフト社のような巨大企業が、クラウドを通して手軽に利用できる人工知能サービスを提供することで、人工知能は特別なものではなく、より身近なものになりつつあります。この技術の進歩は、私たちの日常生活や仕事のやり方を大きく変え、より便利で効率的なものにしていくでしょう。まさに、技術の進歩が社会全体を変革していく時代と言えるでしょう。
開発環境

Docker入門:アプリ実行環境の革新

船で荷物を運ぶための入れ物と同じように、必要なもの全てを詰め込んでアプリを動かすための技術、それがDockerです。正式にはDocker Engineと呼ばれ、無料で使えるオープンソースの仕組みです。 Dockerのすごいところは、アプリと、アプリが動くために必要な周辺の道具一式をまとめて、コンテナと呼ばれる小さな入れ物に閉じ込めてしまうところです。この入れ物を別のコンピュータに持っていけば、まるで魔法のように同じようにアプリが動きます。 従来の仮想化技術では、アプリを動かすための土台として仮想マシンと呼ばれる、まるごと別のコンピュータをソフトウェアで作り出して使っていました。仮想マシンは、まるで本物のコンピュータのように、独自のOSや周辺機器を全て持っているため、サイズが大きくて動きも遅くなりがちでした。 Dockerは、コンテナ仮想化技術という新しい方法を使っています。コンテナは、ホストコンピュータのOSの中核部分(カーネル)を共有して動くため、仮想マシンに比べてはるかに小さく、起動も速く、資源の消費も抑えられます。まるでアパートのように、建物全体(OSのカーネル)は共有しながら、各部屋(コンテナ)で独立して生活できるイメージです。 Dockerを使えば、開発したアプリが、開発者のコンピュータでは動くのに、テスト担当のコンピュータでは動かない、といった環境の違いによる問題を解消できます。開発、テスト、本番環境など、どのコンピュータでも同じようにアプリが動くため、開発者はアプリを作る作業そのものに集中できます。また、コンテナは非常に軽いので、必要な時に必要なだけすぐに立ち上げたり、停止したりできます。これにより、開発のスピードアップや、コンピュータ資源の効率的な利用につながります。 まるで荷物を運ぶコンテナ船のように、アプリをコンテナに詰め込んで自由に移動させ、必要な場所で必要な時にアプリを動かす。これがDockerの目指す世界です。
WEBサービス

情報発信者:パブリッシャーの役割

発信者とは、広く情報を伝える個人や組織のことです。様々な方法で情報を作り、それを世の中に送り出しています。発信という言葉が示す通り、自らが何かを生み出し、それを受け手に届ける役割を担っています。 発信者は、様々な形で情報を伝えます。文字はもちろん、写真や絵、声や動画など、表現方法は多岐に渡ります。ホームページや日記帳のような場所に書き込んだり、仲間同士で繋がる場所で共有したり、あるいは本や雑誌といった印刷物を使ったりもします。 発信者が扱う内容も様々です。例えば、新聞社やテレビ局は、出来事を分かりやすく伝えたり、背景にある事情を説明したりします。娯楽会社は、人々を楽しませる歌や物語、映像などを届けます。個人が趣味について語るのも発信の一つです。 情報技術の進歩によって、誰でも簡単に情報を発信できるようになりました。誰もが発信者になれる時代だからこそ、質の高い情報の重要性が増しています。正しい知識や心を豊かにする内容を、適切な方法で届けることが大切です。 信頼できる情報を発信し続けることは、社会にとって非常に重要です。人々の知識や考え方を広げ、世の中の動きに影響を与え、文化を育み、次の世代に伝えていく役割を担っているからです。発信者の活動は、社会の健全な発展に欠かせないものと言えるでしょう。
AI活用

特徴量ドリフトとは?予測モデルの精度劣化を検知・対策する方法

学習する機械の仕組みは、過去の情報をもとに、これからのことを予想するものです。まるで、過去の天気図から明日の天気を予想するようなものです。しかし、学習に使った過去の情報と、今の実際の状況が大きく違ってしまうと、予想が外れてしまうことがあります。たとえば、過去の天気図がずっと晴れ続きだったのに、今は急に大雨が降り始めたら、晴れを予想していた天気予報は役に立ちません。 機械学習の世界では、この過去の情報と今の状況のずれを「特徴量ドリフト」と呼びます。このずれが起きると、どんなに優秀な予想の仕組みでも、だんだん役に立たなくなってしまいます。一度は素晴らしい成績を上げていた予想モデルが、時間の流れとともに力を失ってしまうのです。これは、まるで弓の名人が、的との距離が変わってしまったのに同じ力で弓を引いて、的を外してしまうようなものです。 この特徴量ドリフトには、いくつかの種類があります。たとえば、今まで重要だった情報が重要でなくなったり、今までなかった新しい情報が急に大切になったりする場合があります。また、情報の値そのものが少しずつ変化していくこともあります。これらの変化を見逃すと、予想の精度はどんどん落ちていきます。 この問題を解決するためには、いくつかの方法があります。まず、常に新しい情報を加えて学習し続けることが大切です。過去の情報だけでなく、今の情報を常に取り入れることで、予想の仕組みを最新の状態に保つことができます。また、ずれが生じていないか常に監視することも重要です。もしずれを見つけたら、予想の仕組みを調整したり、新しい仕組みを作り直したりする必要があります。 本稿では、この特徴量ドリフトについて、その種類や対策方法を具体例を交えながら詳しく説明していきます。これらを理解することで、より長く、より正確な予想を行うことができるようになります。
アルゴリズム

距離学習:データの識別を容易にする手法

距離学習とは、ものごとの間にある隔たり、すなわち距離をコンピュータに学ばせる手法です。ものごとの間柄を理解しやすくするために、似たもの同士は近くに、似ていないもの同士は遠くに配置するよう、コンピュータに距離の測り方を覚えさせます。 たとえば、果物を分類する場合を考えてみましょう。りんご、みかん、バナナの絵をコンピュータに見せるとします。このとき、甘さ、酸味、色といったそれぞれの果物の特徴を数値で表します。これらの数値を特徴量と呼びます。距離学習では、りんご同士は近くに、りんごとは異なるバナナは遠くに配置されるように、甘さ、酸味、色といった特徴量の組み合わせ方をコンピュータが自動的に調整します。この調整によって、果物の種類をより正確に見分けられるようになります。 従来の方法では、人間がそれぞれの果物の特徴量の組み合わせ方を手作業で調整する必要がありました。たとえば、りんごを分類する場合、「赤色であること」を重視し、「甘さ」を軽視するといった具合です。しかし、この作業は大変な手間がかかり、人間の経験や勘に頼るため、必ずしも最良の結果が得られるとは限りませんでした。 一方、距離学習では、大量の果物のデータから、コンピュータが自動的に最適な特徴量の組み合わせ方を学習します。これにより、人間の手間を省くだけでなく、人間の勘に頼るよりも精度の高い分類が可能になります。また、果物だけでなく、様々な種類のデータに適用できるため、応用範囲の広い手法と言えるでしょう。たとえば、顔写真の分類、音声の認識、文字の識別などにも利用できます。距離学習は、今後ますます発展が期待される技術の一つです。
アルゴリズム

ニューラルネットワーク入門

人間の脳は、驚くほど複雑な情報処理を可能にする器官です。思考や学習、記憶といった高度な機能は、無数の神経細胞が複雑に絡み合い、電気信号をやり取りすることで実現されています。この脳の仕組みを理解し、その働きを模倣することで、人工知能の研究は大きく進展してきました。その中心にあるのが、脳の神経細胞のネットワークを数式で表現した「脳の仕組みを模倣した数理モデル」です。 この数理モデルは、一般的に「ニューラルネットワーク」と呼ばれています。ニューラルネットワークは、人間の脳の神経細胞を模した「ノード」(ニューロン)と、それらを繋ぐ「接続」で構成されています。それぞれのノードは、他のノードから信号を受け取り、それを処理して、さらに別のノードへと信号を送ります。この信号の伝わり方や処理の仕方を調整することで、様々な種類の情報を処理することが可能になります。 人間の脳では、神経細胞間の接続の強さが学習によって変化し、記憶や思考に影響を与えます。ニューラルネットワークも同様に、ノード間の接続の強さを調整することで学習を行います。大量のデータを使って学習させることで、画像認識や音声認識、自然言語処理など、様々なタスクをこなせるようになります。これは、複雑な思考プロセスを、単純な要素の組み合わせで表現するという画期的な試みです。脳の働きを完全に再現するにはまだ道のりは遠いですが、ニューラルネットワークは、人工知能の実現に向けた重要な一歩と言えるでしょう。
開発環境

ライブラリ活用術:開発効率アップの秘訣

プログラムを作る際、よく使う機能をまとめて、部品のように使えるようにしたものが、ライブラリと呼ばれるものです。例えるなら、大工さんが使う道具箱のようなものだと考えてみてください。道具箱には、のこぎり、金槌、ドライバーなど、様々な道具が整理されて入っていますよね。何かを作る時、例えば椅子を作りたい時、一からノコギリや金槌を作る人はいません。道具箱から必要な道具を取り出して使います。ライブラリもこれと同じで、既に誰かが作ってくれた便利な道具たちなのです。 ライブラリを使う一番の利点は、作業効率が大幅に上がることです。椅子を作るのに、ノコギリから作っていたら何日もかかってしまいますが、既にある道具を使えば、ずっと早く作ることができますよね。プログラム開発でも同じで、例えば、画面に文字を表示する機能や、計算をする機能など、基本的な処理はライブラリとして既に用意されています。開発者はそれらを組み合わせることで、簡単に目的のプログラムを作ることができます。一から全ての機能を作る必要がないので、開発にかかる時間と労力を大幅に削減できるのです。 ライブラリには、様々な種類があります。写真や絵を扱うための画像処理、たくさんの情報を分析するためのデータ分析、難しい計算を行うための数値計算など、色々な分野に特化したライブラリが用意されています。開発者は、作りたいものに合わせて、適切なライブラリを選ぶことができます。まるで、色々な種類の道具箱を使い分けるように、それぞれのライブラリは特定の作業に特化しているので、より効率的に開発を進めることができるのです。 このように、ライブラリを使うことで、開発者は既に作られた機能を再利用できます。これは、車輪を再び発明するような無駄な作業を避けることに役立ちます。また、ライブラリは多くの開発者によって使われ、改良が重ねられているため、品質も高く、安心して使うことができます。先人たちの知恵と技術の結晶を活用することで、より高品質なシステム開発が可能になるのです。これは、巨人の肩の上に立つようなものと言えるでしょう。
AIサービス

メタ社の動向:Llama2とCodeLlama

米国西部、カリフォルニア州に拠点を置く巨大企業、メタ社は、近年、人工知能の分野で目覚ましい動きを見せています。誰もが知る交流サイト「フェイスブック」や写真共有の「インスタグラム」などを運営するこの企業は、2023年7月、大規模言語モデル「Llama2」を公開し、世間を驚かせました。続いて8月には、プログラムのひな形を自動で作る人工知能「CodeLlama」を発表。矢継ぎ早の発表は、人工知能分野における彼らの本気度を示すものと言えるでしょう。 「Llama2」は、人間のように自然な言葉を作り出すことができる大規模言語モデルです。膨大な量の文章データを学習することで、まるで人間が書いたかのような文章を作成したり、質問に答えたりすることが可能です。この技術は、様々な場面での活用が期待されています。例えば、顧客からの問い合わせに自動で対応するシステムや、大量の文書を要約するツールなど、私たちの生活や仕事に大きな変化をもたらす可能性を秘めています。 一方、「CodeLlama」は、プログラムのひな形を自動で生成する人工知能です。プログラマーが書くプログラムの骨組みを自動的に作ってくれるため、開発にかかる時間や手間を大幅に削減できると期待されています。また、プログラミングの知識が少ない人でも、簡単にプログラムを作ることができるようになるかもしれません。このように、人工知能技術は、私たちの仕事のやり方そのものを変えてしまう可能性を秘めているのです。 メタ社によるこれらの発表は、人工知能技術がより身近なものになりつつあることを示しています。今後、これらの技術がどのように発展し、私たちの生活や仕事にどのような影響を与えていくのか、巨大企業の挑戦から目が離せません。
アルゴリズム

全てを見通す分割:パノプティックセグメンテーション

一枚の絵全体を細かく分けて、何が写っているかを理解する技術があります。これを「全てを見渡す絵の分割」と言います。この技術は、写真のそれぞれの小さな点一つ一つに、それが何なのか名前を付けます。例えば、街の写真なら、建物、道路、車、人など、全部の名前を付けます。しかも、同じ種類の物も見分けます。例えば、たくさんの車が写っていても、それぞれの車を別々に認識します。 この技術は、二つの技術の良いところを取り入れています。一つは「意味で分ける絵の分割」です。これは、写真のそれぞれの点に、それが建物なのか道路なのかといった意味の名前を付けます。しかし、この方法では、同じ種類の物を区別できません。例えば、一台一台の車を区別することはできません。もう一つは「実体で分ける絵の分割」です。これは、写真の中のそれぞれの物を区別できます。例えば、一台一台の車を別々に認識できます。しかし、この方法では、写真の全ての点に名前を付けるわけではありません。例えば、空や道路には名前を付けないこともあります。 「全てを見渡す絵の分割」は、この二つの技術を組み合わせることで、写真のそれぞれの点に意味の名前を付け、さらに、同じ種類の物も区別できるようにします。これにより、写真に何が写っているかをより深く理解することができます。例えば、自動運転では、周りの状況をより正確に把握するためにこの技術が使われます。また、医療画像診断では、臓器や腫瘍をより正確に特定するために役立ちます。このように、「全てを見渡す絵の分割」は、様々な分野で応用が期待される重要な技術です。
学習

機械学習とデータ量の増加

近頃よく耳にする「機械学習」は、コンピュータがまるで人間のように学習し、賢くなっていく技術のことです。この技術は、近年目覚ましい発展を遂げており、私たちの生活にも様々な影響を与え始めています。 この技術の進歩は、データ量の増大と密接に関係しています。人間と同じように、コンピュータも多くのデータに触れることで学習し、より正確な判断ができるようになります。インターネットの普及や、様々な機器に取り付けられた測定器の進化により、これまで考えられなかったような膨大な量のデータが集められるようになりました。この莫大なデータこそが、機械学習の進化を加速させている大きな要因なのです。 機械学習は、まるで人間の脳のように、多くの経験を積むことで成長します。例えば、たくさんの画像データを読み込むことで、コンピュータは猫や犬を識別できるようになります。また、過去の気象データを学習することで、未来の天気を予測することも可能になります。このように、機械学習は様々な分野で応用され、私たちの生活をより便利で豊かにする可能性を秘めているのです。 機械学習は、医療、金融、製造業など、様々な分野で既に活用されています。医療分野では、画像診断の補助や新薬の開発に役立てられています。金融分野では、不正取引の検知や投資判断の支援に活用されています。製造業では、製品の品質管理や生産工程の最適化に役立てられています。 今後、機械学習はますます進化し、私たちの生活はさらに大きく変わっていくでしょう。例えば、自動運転技術の発展により、交通事故の減少や移動時間の短縮が期待されます。また、パーソナルアシスタントの進化により、より快適で効率的な生活が実現するでしょう。機械学習は、未来社会を形作る重要な技術の一つであり、その進歩に今後も注目していく必要があります。
AI活用

カメラ画像、どう使う?安心のための活用ガイド

近年、撮影技術の向上に伴い、街中やお店など、様々な場所に設置されたカメラから得られる画像が、私たちの暮らしをより便利で安全なものにするために活用されるようになってきました。この手引きは「カメラ画像活用の手引き」と題し、事業者と生活者の双方にとって有益なカメラ画像の活用方法を探り、お互いの理解を深めるための資料として作成されました。 カメラで撮影された画像は、防犯対策として犯罪の抑止や証拠の確保に役立つだけでなく、商業施設では顧客の動きの分析による販売戦略の改善、交通管理の効率化、災害時の状況把握など、幅広い分野で活用されています。例えば、商業施設では、カメラ画像を分析することで、どの商品棚に人が多く集まっているか、顧客の年齢層や性別などを把握することができます。これらの情報は、商品の配置や品揃えの改善、効果的な広告展開などに役立ちます。また、交通量の多い交差点にカメラを設置することで、交通の流れをリアルタイムで監視し、信号の切り替えを最適化することで渋滞の緩和に繋げることができます。さらに、災害発生時には、被災地の状況を迅速に把握し、救助活動に役立てることも可能です。 しかし、カメラ画像の活用には、プライバシーや個人情報の保護といった課題も存在します。撮影された画像が誰のものか分からなくなることや、個人の行動が監視されているという不安感を抱く人もいるでしょう。そのため、カメラ画像を適切に管理し、個人のプライバシーを侵害しないよう配慮することが重要です。この手引きでは、カメラ画像の活用における課題やリスクについても詳しく解説し、適切な活用方法、個人情報の保護のための対策、関係法令の遵守など、事業者と生活者が共に安心してカメラ画像の恩恵を受けられるための指針を示します。この手引きを通して、カメラ画像の利活用に関する正しい知識を身につけ、より良い社会の実現に貢献できることを願っています。
学習

メタ学習:学習を学ぶAI

学び方を学ぶとは、どういうことでしょうか。私たち人間は、自転車に乗る練習をするとき、以前スケートボードを練習した経験を活かしてバランスの取り方を早く習得できることがあります。このように、過去の経験を活かして新しいことを学ぶ能力をメタ学習といいます。 機械学習の世界でも、このメタ学習の考え方が取り入れられています。従来の機械学習では、大量のデータを使って特定の課題を解くように訓練していました。例えば、大量の猫の画像を見せることで、猫を認識するように学習させるのです。しかし、新しい課題、例えば犬の認識をさせたい場合は、また一から大量の犬の画像を使って学習させなければなりませんでした。 メタ学習は、この問題を解決するために、学習の仕方自体を学習します。様々な課題を経験することで、新しい課題に直面した時に、どのように学習すれば良いかを学ぶのです。 過去の課題で得た知識や経験を活かして、少ないデータで新しい課題を効率的に学習できるようになります。自転車の練習で培ったバランス感覚が、スケートボードの練習に役立つように、過去の学習経験を新しい学習に活かすのです。 メタ学習は、少量のデータで新しい課題を学習できるため、データ収集が困難な分野や、変化の激しい環境への適応に役立ちます。例えば、医療診断のようにデータが少ない場合でも、過去の症例データから学習した経験を活かして、新しい病気の診断精度を向上させることが期待できます。また、自動運転技術のように、常に状況が変化する環境でも、過去の運転データから学習した経験を活かして、安全な運転を継続することが可能になります。このように、メタ学習は、人工知能がより賢く、より柔軟に学習するための重要な技術として注目を集めています。
学習

機械学習による特徴発見:表現学習

機械学習の世界では、データの中に隠された重要な特徴を見つけることが極めて大切です。これまで、この特徴を見つける作業は、人が行っていました。例えば、猫の画像を見分けるためには、耳の形やヒゲ、目の形など、猫の特徴を人が機械に教えていました。しかし、扱うデータが膨大になり、複雑になるにつれて、人が一つ一つ特徴を教えるやり方は難しくなってきました。 そこで生まれたのが、表現学習と呼ばれる考え方です。表現学習では、機械が自分でデータの中から重要な特徴を見つけ出します。これは、人が特徴をいちいち教える必要がないため、大量のデータや複雑なデータにも対応できるという利点があります。まるで、子供がたくさんの猫の画像を見て、自然と猫の特徴を覚えるようなものです。 例えば、画像認識の分野を考えてみましょう。従来の方法では、人は機械に「物の輪郭や色の違いが重要だ」と教えていました。しかし、表現学習では、機械が自ら画像データから輪郭や色の違いなど、重要な特徴を学習します。そして、学習した特徴を使って、様々な種類の猫を正確に見分けられるようになります。 さらに、表現学習は、画像認識だけでなく、自然言語処理や音声認識など、様々な分野で応用されています。例えば、文章の意味を理解するために、単語同士の関係性や文章の構造といった特徴を機械が自ら学習します。このように、表現学習は、機械学習の進歩に大きく貢献しており、今後ますます重要な技術となるでしょう。
その他

神経回路:脳の神秘に迫る

人間の脳は、無数の神経細胞で構成されています。この神経細胞は「ニューロン」と呼ばれ、まるで夜空に輝く星のように、脳の中に散りばめられています。一つのニューロンは、細胞体と呼ばれる中心部分と、そこから伸びる樹状突起、そして軸索という細長い突起から成り立っています。樹状突起は他のニューロンからの信号を受け取るアンテナのような役割を果たし、軸索は他のニューロンに信号を送る役割を担っています。 これらのニューロンは、単独で存在しているわけではありません。一つ一つのニューロンは、他の無数のニューロンと複雑につながり合い、巨大なネットワークを形成しています。このネットワークこそが、神経回路と呼ばれるものです。神経回路は、まるで道路網のように、情報を脳全体に伝達するための経路となっています。私たちが何かを考えたり、感じたり、行動したりするとき、この神経回路を通じて情報がやり取りされています。 神経細胞同士の接続部分は、「シナプス」と呼ばれています。シナプスは、ニューロンとニューロンの間にあるわずかな隙間ですが、情報伝達において重要な役割を果たしています。軸索の先端から放出された神経伝達物質は、シナプス間隙を通過し、次のニューロンの樹状突起にある受容体に結合することで、信号が伝達されます。この精巧な仕組みによって、脳は複雑な情報処理を瞬時に行うことができるのです。小さな神経細胞が集まり、互いに連携することで、思考、感情、記憶、運動など、人間のあらゆる精神活動を支えているのです。まるで精巧な機械のように、一つ一つの部品が正確に役割を果たすことで、全体として調和のとれた働きを生み出し、驚くべき能力を発揮していると言えるでしょう。
AIサービス

パッケージデザインAI:革新的な商品開発

株式会社プルガイと東京大学山崎研究室が共同で作り上げた、図案の良し悪しを評価する人工知能は、商品の開発手法に大きな変化をもたらしています。この人工知能は、デザイン評価に特化した画期的な技術と言えるでしょう。膨大な量の図案データを読み込み、学習することで、人の感覚に訴える図案の良さを数値として表すことを可能にしました。これにより、これまで掴みづらかった消費者の好みを的確に捉えることができます。 従来、図案の評価は、経験豊富な担当者やデザイナーの主観的な意見に頼る部分が大きく、客観的な評価をするための基準を設けることが難しいという課題がありました。評価する人によって意見が異なってしまうため、本当に消費者に受け入れられる図案なのか、判断が難しかったのです。しかし、人工知能を用いることで、蓄積されたデータに基づいた客観的な評価が可能となりました。これまで勘や経験に頼っていた部分が、数値化されることで、商品開発の作業は効率化され、成功する可能性も高まると期待されています。 さらに、この人工知能は、消費者の感性に響く図案を新たに作り出すこともできます。これまでデザイナーが多くの時間を費やしていた図案作成も、人工知能が支援することで、作業時間を大幅に短縮できます。そして、人工知能が提案する、消費者の心に響く図案を採用することで、市場での競争力を高められると考えられています。人の感性と人工知能の技術を組み合わせることで、商品開発は新たな時代へと進みつつあります。