セキュリティ

生成AI利用における自主対策の重要性

近頃、ものすごい速さで進化している人工知能は、私たちの暮らしや働き方に大きな変化をもたらしています。文章を書いたり、絵を描いたり、音楽を作ったりと、様々な分野で役に立ち、今までにない発想や高い効率性を実現できる可能性を秘めています。 例えば、文章作成支援の人工知能を使うと、これまで時間をかけていた記事の作成や報告書の作成が短時間で済むようになります。また、画像生成人工知能は、新しい広告のデザインや商品のイメージ画像を簡単に作ることができます。音楽制作の分野でも、人工知能を使って新しいメロディーやリズムを生み出すことが可能になっています。このように、人工知能は私たちの創造性を大きく広げ、生産性を飛躍的に向上させる力を持っています。 しかし、便利な反面、情報が漏れてしまったり、間違った情報が広まってしまったりといった危険性も抱えています。作ったものの中に、うっかり大切な個人情報や会社の機密情報が入ってしまうかもしれません。また、人工知能が作った間違った情報が、インターネットを通してあっという間に広がり、人々に大きな影響を与える可能性もあります。このような危険性を防ぐためには、早急な対策が必要です。 人工知能を安全に、そしてきちんと役立てるためには、使う人と作る人の両方が、自分たちで気を付けて使うことが何よりも大切です。使う人は、入力する情報に注意したり、出てきた結果が正しいかを確認したりする必要があります。作る人は、作った人工知能が安全に使えるように、しっかりと設計する必要があります。 この文章では、人工知能を使う上での自主的な対策の大切さについて説明し、具体的な対策方法についても紹介します。人工知能を正しく理解し、責任を持って使うことで、より良い未来を築くことができると信じています。
アルゴリズム

ReLU関数とは?意味・仕組み・活用例をわかりやすく解説

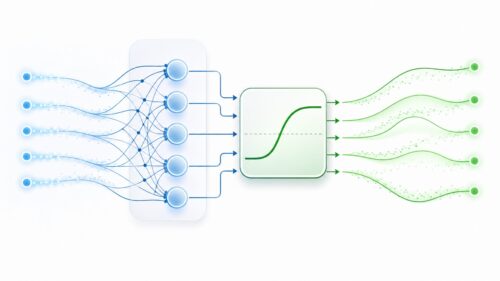
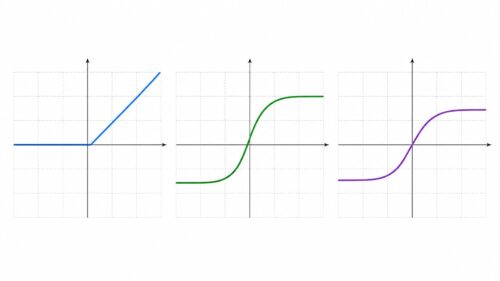
人の脳を模倣した仕組みである人工知能は、無数の繋がりを持つ人工神経細胞のネットワークによって情報を処理します。この人工神経細胞の出力部分を活性化関数と呼びます。活性化関数は、人工神経細胞の出力を調整し、ネットワーク全体の学習能力を高める重要な役割を担っています。 もし活性化関数がなければ、人工神経細胞は単純な入力の合計を出力するだけになってしまいます。これは、幾重にも神経細胞が重なった複雑なネットワークを作っても、結局は単純な計算をしているのと同じです。例えるなら、どんな複雑な計算式を作っても、足し算と掛け算だけで表現できてしまうようなものです。これでは複雑な問題を解くことはできません。 活性化関数は、この単純な計算に非線形性、つまり曲線的な変化を加えます。これにより、ネットワークは複雑なパターンを学習し、より高度な問題を解決できるようになります。ちょうど、単純な直線だけでなく、曲線や折れ線を使うことで、より複雑な図形を描けるようになるのと同じです。活性化関数の種類も様々で、それぞれ異なる特徴を持っています。よく使われるものとして、出力値を0から1の間に収めるもの、負の値を0に変換するもの、滑らかな曲線を描くものなどがあります。 どの活性化関数を選ぶかは、扱う問題の種類やネットワークの構造によって大きく影響します。例えば、画像認識では、特定の特徴を強調する活性化関数がよく用いられます。また、自然言語処理では、言葉の意味関係を捉えるのに適した活性化関数が使われます。適切な活性化関数を選ぶことで、学習の速度を上げたり、予測の精度を向上させることができます。活性化関数は、人工知能の性能を左右する重要な要素と言えるでしょう。
アルゴリズム

U-Netとは?画像セグメンテーションの仕組みと活用例をわかりやすく解説

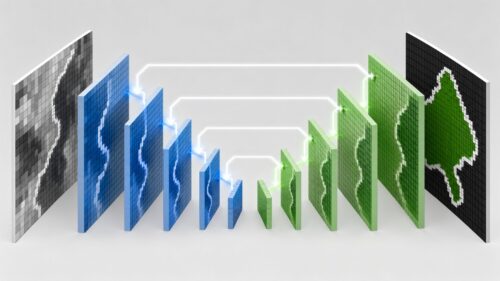
Uネットは、その名前の通り、アルファベットの「U」のような形をした画像の領域分割に特化した神経回路網です。この独特の形が、この回路網の大きな特徴であり、高精度な分割を実現する鍵となっています。回路網は大きく二つの部分に分けることができます。左半分は「符号化器」と呼ばれ、右半分は「復号化器」と呼ばれます。 符号化器の役割は、入力された画像から重要な特徴を抽出することです。これは、幾重にも重ねられた「畳み込み層」と「縮小層」によって行われます。畳み込み層は、小さなフィルターを画像全体に滑らせながら、画像の模様や輪郭などの特徴を捉えます。縮小層は、画像の大きさを段階的に小さくすることで、より広い範囲の情報から抽象的な特徴を抽出します。この一連の処理により、入力画像は徐々に小さくなりながらも、重要な情報はしっかりと保持されます。 一方、復号化器は、符号化器で抽出された特徴を元に、元の画像と同じ大きさの分割結果を生成します。復号化器では、「拡大層」と畳み込み層が用いられます。拡大層は、符号化器で縮小された画像を元の大きさに戻す役割を果たします。この際に、符号化器で得られた特徴の情報が活用され、より精細な分割結果が得られます。また、復号化器の各段階では、符号化器の対応する層からの情報が「飛び越し結合」によって直接入力されます。これにより、画像全体の大きな特徴と、細かい部分の特徴の両方を組み合わせることができ、より正確な分割が可能になります。 Uネットのこの「U」字型の構造と飛び越し結合こそが、この回路網の優れた性能の源です。全体像と細部の情報を組み合わせることで、特に医療画像や衛星画像など、高い精度が求められる画像分割の分野で、目覚ましい成果を上げています。たとえば、医療画像では臓器や腫瘍などの領域を正確に特定するために、衛星画像では道路や建物などの物体を識別するために利用されています。このように、Uネットは様々な分野で活用され、画像解析技術の発展に大きく貢献しています。
開発環境

スタック領域とは?メモリの仕組みとヒープ領域との違いを解説

計算機で手順を動かすには、情報の置き場所が必要です。この置き場所を記憶域と呼びます。記憶域には様々な管理方法がありますが、中でも基本的なものが積み重ね方式の領域です。この積み重ね方式の領域は、情報を一時的に置いておく場所で、その仕組みを知ることは手順作りでとても大切です。積み重ね方式の領域は、ちょうど食器を重ねていくように、上から順番に情報を置いていきます。一番上に置かれたものが一番最初に使われ、次に上から二番目、というように、上から順番に取り出されます。このような仕組みを「後入れ先出し」と言います。 例として、手順の中で計算を行う場面を考えてみましょう。まず、計算に必要な数字を積み重ね方式の領域に置いていきます。そして、計算を行う際に、必要な数字を上から順番に取り出して計算を行います。計算が終わったら、その結果は再び積み重ね方式の領域の上に置かれます。このように、積み重ね方式の領域は一時的な情報の保管場所として使われます。関数を呼び出す際にも、この積み重ね方式の領域が利用されます。関数を呼び出すと、その関数で使う情報が積み重ね方式の領域に保存されます。そして、関数が処理を終えると、その情報は積み重ね方式の領域から取り除かれます。 積み重ね方式の領域には、使用する記憶域の大きさが最初に決まっているという特徴があります。そのため、積み重ね方式の領域よりも多くの情報を保存しようとすると、領域が足りなくなり、「積み重ね崩れ」と呼ばれる問題が発生します。これは、領域の外に情報を書き込んでしまうことで、他の情報が壊れてしまう危険な状態です。積み重ね崩れを防ぐためには、積み重ね方式の領域に置く情報の大きさを適切に管理する必要があります。積み重ね方式の領域は、情報の出し入れが速いという利点があります。これは、情報の置き場所が常に決まっているため、探し出す手間がかからないからです。この記事を通して、積み重ね方式の領域の仕組みと特徴、そして使い方を理解し、より良い手順作りに役立ててください。
学習

情報収集とは?AI学習に必要な理由とリスクを初心者向けに解説

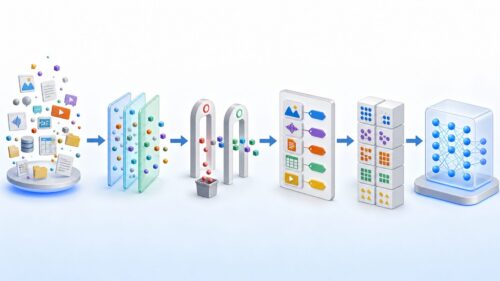
近ごろ、人工知能、とりわけ文章や画像などを作り出す人工知能の進歩には目を見張るものがあります。この驚くべき発展は、莫大な量の情報の学習による成果と言えるでしょう。高性能な人工知能を作るには、大規模な情報の集まりが欠かせません。人の脳が多くの経験から学ぶのと同様に、人工知能もたくさんの情報から規則性やパターンを学び、高度な推論や新しいものを生み出す力を得ます。 例えば、私たちが日々使うインターネット検索や翻訳の機能、文章を作る人工知能などは、膨大な文字情報や音声情報によって学習されています。これらの情報は、人工知能が私たちの質問に的確に答えたり、自然で滑らかな翻訳をしたりすることを可能にしています。また、医療の診断を助ける人工知能の場合、過去の医療画像や診断情報が学習情報として使われ、病気の早期発見や正確な診断に役立てられています。 人工知能は、集めた情報をどのように処理するかという点も重要です。ただ情報を集めるだけでなく、その情報を整理し、分析し、人工知能が理解できる形に変換する必要があります。この過程を事前学習と呼びますが、この事前学習の質が人工知能の性能を大きく左右します。質の高い事前学習を行うためには、情報の正確さや最新の情報であるかどうかも重要な要素となります。このように情報の収集は人工知能の成長に欠かせないものであり、より高度な人工知能を実現するために、これからも重要な役割を担うと考えられます。人工知能が社会の様々な場面で活躍するためには、質の高い情報を適切に集め、処理する技術の向上が不可欠です。
アルゴリズム

Transformerとは?仕組み・注意機構・活用例を初心者向けに解説

近頃、言葉を扱うコンピュータ技術が急速に発展し、様々な新しい仕組みが生まれています。特に、二〇一七年に発表された「変形器」という仕組みは、これまでの限界を大きく超え、言葉の処理方法に革命を起こしました。 以前は、「繰り返し型神経網」や「畳み込み型神経網」といった仕組みが主流でした。しかし、これらの仕組みでは、長い文章を扱う際に膨大な計算が必要となり、複数の処理を同時に行うのが難しいという問題がありました。「変形器」は、この問題を解決するために、全く新しい設計思想を採用しました。それが、「注意機構」と呼ばれる仕組みです。 「注意機構」とは、文章中の各単語が、他のどの単語と関連が深いかを自動的に判断する仕組みです。例えば、「私は猫が好きです」という文章では、「好き」という単語は「猫」と強く関連し、「私」とはやや関連が薄いと判断されます。従来の仕組みでは、文章を前から順番に処理していくため、離れた単語の関係を捉えるのが苦手でした。一方、「注意機構」は、文章全体を一度に見渡すことができるため、離れた単語の関係も正確に捉えることができます。 この「注意機構」の導入により、「変形器」は、長い文章の処理を効率的に行うことができるようになりました。また、複数の処理を同時に行うことも可能になったため、学習速度も大幅に向上しました。これらの利点から、「変形器」は、機械翻訳、文章要約、質問応答など、様々な自然言語処理のタスクで高い性能を発揮し、今日の言葉処理技術の基盤となっています。まさに、言葉の処理技術における転換点と言えるでしょう。
アルゴリズム

Leaky ReLU関数とは?意味・仕組み・ReLUとの違いをわかりやすく解説

人間の脳の神経細胞は、他の細胞から信号を受け取ると、一定のしきい値を超えた場合にのみ発火し、次の細胞に信号を伝えます。人工知能の中核を担う神経回路網も、この仕組みを模倣しています。神経回路網を構成する人工神経細胞は、入力された信号に重みを掛け、その合計値を計算します。しかし、この合計値をそのまま出力するだけでは、層を重ねた神経回路網はただの一次関数になってしまいます。そこで、活性化関数が重要な役割を果たします。 活性化関数は、入力された値を特定の計算式に基づいて変換し、出力する関数です。これは、神経細胞の発火の仕組みを模倣したもので、神経回路網に非線形性を与えます。非線形性とは、入力と出力の関係が単純な直線では表せない性質を指します。もし活性化関数がなければ、神経回路網は何層重ねても単一の一次関数と同じ働きしかできません。つまり、複雑な事象を学習することが不可能になります。活性化関数を導入することで、神経回路網は複雑なパターンを学習し、より高度な問題を解決できるようになります。 活性化関数には様々な種類があり、それぞれ異なる特徴を持っています。よく使われるものとしては、入力値を0から1の間に変換するシグモイド関数や、負の値を0に変換し、正の値はそのまま出力する正規化線形関数などがあります。これらの関数は、問題の種類やデータの特性に合わせて適切に選択する必要があります。例えば、画像認識では、正規化線形関数がよく用いられます。これは、画像データによく現れるスパース性(多くの値が0である性質)を効果的に処理できるためです。このように、活性化関数は神経回路網の性能を左右する重要な要素であり、様々な分野で活用されています。例えば、音声認識や自動翻訳、株価予測など、人工知能が活躍する多くの場面で、活性化関数が重要な役割を担っています。
クラウドサービス

手軽に拡張!スケールアウトで性能向上

処理の滞りを解消し、より多くの仕事をこなせるようにするために、情報処理の仕組みを強化する方法の一つに「規模拡張」というものがあります。これは、複数の計算機を新たに投入して、全体の処理能力を底上げする方法です。 計算機の数を増やすことで、全体的な処理能力が向上し、これまで以上に多くの要求や情報を処理できるようになります。 たとえば、お店がとても混雑している状況を考えてみましょう。お客さんが長蛇の列を作り、レジ係はてんてこ舞いです。このような時に、レジの台数を増やすとどうなるでしょうか。レジが増えれば、より多くのお客さんを、より速く会計処理できるようになります。規模拡張もこれと同じで、計算機を増やすことで、処理の速度と量を向上させることができるのです。 また、近年需要が高まっている背景には、柔軟な対応力が挙げられます。急に仕事量が増えても、計算機を追加することでスムーズに対応できます。さらに、全体の処理を複数の計算機に分散させることで、一部の計算機に障害が発生した場合でも、他の計算機が処理を引き継ぐため、全体が停止してしまう事態を防ぐことができます。これは、お店でいうと、一つのレジが故障しても他のレジで会計を続けられるようなものです。 このように、規模拡張は、処理能力の向上と柔軟な対応力という二つの利点を持つ、現代の情報処理システムにおいて重要な手法と言えるでしょう。
AI活用

AI規制とは?必要性・課題・生成AIへの対応を初心者向けに解説

近頃、人工知能は驚くほどの進歩を遂げ、私たちの暮らしの様々な場面で見かけるようになりました。例えば、車を自動で走らせる技術や、病気の診断を助ける技術、お客さまへのサービスなど、様々な分野で使われており、社会を大きく変える力を持っています。 しかし、人工知能の進化は良いことばかりではありません。いくつかの問題も出てきています。例えば、人工知能がどのように判断しているのかが分かりにくいことや、その判断が本当に公平なのかどうか、個人の情報をきちんと守れるのか、そして誰かが悪いことに使ったり、間違った使い方をしたりする危険性など、解決しなければならない課題がたくさんあります。 だからこそ、人工知能が正しく発展し、安全に社会で使われるように、適切なルール作りが必要なのです。人工知能の良い点を最大限に活かし、危険な点を最小限に抑えるためには、技術の進歩に合わせて、柔軟で効果的なルールが必要です。 人工知能の開発者、利用者、そして社会全体で、この重要な課題について理解を深め、共に考えていく必要があります。例えば、どのような情報を人工知能に学習させるのか、どのようにその判断過程を分かりやすく説明するのか、そしてもしも問題が起きた場合、誰が責任を取るのかなど、様々な点を議論し、ルール作りに反映させることが大切です。また、技術は常に進化しているので、ルールもそれに合わせて変えていく必要があります。 人工知能は、私たちの未来をより良くする大きな可能性を秘めています。しかし、その力を正しく使い、安全を確保するためには、継続的な議論と適切なルール作りが欠かせません。私たちは皆で協力し、人工知能と共存できる社会を築いていく必要があるのです。
学習

学習用データとは?AIの成長を支えるTraining Dataの基本

人工知能は、自ら学び、考えを巡らせ、答えを導き出すことができる計算機処理方法です。まるで人が学ぶように、人工知能も学ぶ必要があります。その学習には欠かせないものがあります。それが「学習用資料」です。 学習用資料とは、人工知能に知識を教え込むための情報の集まりです。例えるなら、人が学ぶための教科書や練習問題集のようなものです。人工知能はこの資料を読み解き、そこに潜む法則や繋がりを見つけ出すことで、決められた作業をこなせるようになります。 たとえば、絵の内容を理解する人工知能を考えてみましょう。この人工知能には、たくさんの絵と、それぞれの絵に何が描かれているかを示す説明書きが必要です。これらが学習用資料となります。人工知能はこれらの資料から、例えば、とがった耳やひげがある絵には「ねこ」という説明書きがされていることを学びます。たくさんの絵と説明書きを学ぶことで、人工知能は初めて見る絵でも、それが何の絵なのかを判断できるようになるのです。 また、文章を書く人工知能の場合には、様々な文章を学習用資料として用います。人工知能はこれらの文章を読み込み、言葉の繋がり方や文の構成などを学びます。そして、新しい文章を作る際に、学習した知識を活かして、自然で意味の通る文章を作り出すことができるようになります。 このように、学習用資料は人工知能が様々な作業をこなせるようになるための土台となる重要なものです。学習用資料の質や量は、人工知能の性能に大きな影響を与えます。より質の高い、より多くの学習用資料を用いることで、人工知能はより賢く、より正確に作業をこなせるようになります。
その他

スーパスカラで処理速度向上

スーパスカラとは、計算機の処理速度を飛躍的に高める技術です。これまでの計算機は、命令を一つずつ順番にこなしていく方式が主流でした。料理に例えると、一つの料理を完成させてから、次の料理に取り掛かるようなものです。しかし、スーパスカラでは、複数の命令を同時に処理できます。これは、複数の料理を同時進行で作るようなものです。 この並列処理を可能にするのが、複数の演算器です。演算器とは、計算を行うための部品です。料理で例えるなら、フライパンや鍋のようなものです。スーパスカラでは、これらの演算器を複数備え、それぞれに異なる命令を割り当てて同時に実行します。複数のフライパンや鍋を同時に使って、様々な料理を同時に作るイメージです。 もちろん、全ての命令を同時に処理できるわけではありません。例えば、ある命令の結果が次の命令で必要になる場合は、前の命令が完了するまで次の命令は実行できません。料理で言えば、前の料理で作ったソースを次の料理で使う場合、ソースが完成するまで次の料理には取り掛かれません。スーパスカラは、このような依存関係を解析し、実行可能な命令を効率的に演算器に割り当てて並列処理を実現します。 この技術によって、計算機の処理能力は大幅に向上しました。まるで、多くの料理人が同時に働く大きな台所のように、多くの命令を同時に処理することで、計算速度を格段に速くすることが可能になったのです。現代の高速な計算機には、このスーパスカラ技術が欠かせない要素となっています。まるで、現代のレストランの厨房には、複数の調理器具が不可欠であるように、現代の計算機にはスーパスカラがなくてはならない存在と言えるでしょう。
学習

深層学習とデータ量の関係とは?必要なデータ量と質を初心者向けに解説

近年の技術革新において、深く学ぶ技術は目覚ましい成果を上げています。これは、人間のように自ら学び、考え、判断を下せる人工知能の一種です。この技術は、膨大な量の資料から、まるで宝探しのように規則性や特徴を見つけ出し、記憶していくことで、様々な仕事をこなせるようになります。 この深く学ぶ技術の巧拙を決める大きな要素の一つに、学習に使う資料の量があります。資料が多ければ多いほど、この技術はより複雑で微妙な規則性を見抜き、より正確な予測を立てることができるようになります。例えば、植物を判別する技術を開発する場合を考えてみましょう。もし、限られた種類の植物しか学習していない場合、その技術は初めて見る植物を正しく判別できないかもしれません。しかし、様々な環境で育った、多種多様な植物の資料を大量に学習させれば、見たことのない植物でも高い精度で判別できるようになるでしょう。 逆に、十分な量の資料がないと、学習に使った資料の特徴だけを過度に記憶してしまうという問題が発生します。これは、まるで試験のために過去問だけを丸暗記し、全く新しい問題が出されると途方に暮れてしまう学生のようです。この状態は「過学習」と呼ばれ、深く学ぶ技術の精度を大きく下げてしまいます。 したがって、深く学ぶ技術を正しく育て、その潜在能力を最大限に引き出すためには、適切な量の資料を用意することが不可欠です。適切な量の資料は、この技術が様々な状況に対応できる応用力を身につけ、未知の資料に対しても正確な予測を立てるための土台となります。大量の良質な資料こそが、深く学ぶ技術の真価を発揮するための鍵と言えるでしょう。
セキュリティ

生成系AIが生む新たなリスクと課題

近頃、機械が作った絵や動画の技術が驚くほど進歩しています。まるで写真や実際に撮影した動画のように、本物と見分けがつかないほど精巧な偽物の画像や動画が簡単に作れるようになりました。この技術の進歩は、私たちに様々な恩恵をもたらす可能性を秘めている一方で、大きな危険もはらんでいます。 精巧に作られた偽物の情報があふれることで、私たちは真実を見抜くことがますます難しくなっています。これまで、情報の真偽を判断するには、情報源の信頼性や内容の一貫性などを注意深く確認すれば十分でした。しかし、最新技術で作られた偽物の画像や動画は、本物とほとんど区別がつかないため、従来の方法では真偽を見分けるのが非常に困難になっています。 このような状況において、私たちに必要なのは、新しい情報の見分け方です。単に情報の出所や内容をチェックするだけでなく、画像や動画がどのように作られたのか、その制作過程にも目を向ける必要があります。例えば、動画の中に不自然な動きや編集の痕跡がないか、画像の細部に違和感がないかなどを注意深く観察することで、偽物を見抜く手がかりを見つけられるかもしれません。また、信頼できる情報源から発信された情報かどうかを確認することも重要です。公式な報道機関や専門家の見解などを参考にすることで、偽情報に惑わされるリスクを減らすことができます。 さらに、情報に対する私たちの姿勢も変えていく必要があります。全ての情報を鵜呑みにするのではなく、常に批判的な目で情報を読み解き、複数の情報源を比較検討することで、真実に近づく努力が大切です。情報技術が進化するにつれて、偽情報も巧妙化していくでしょう。だからこそ、私たちは情報との向き合い方を改めて考え、真偽を見抜く力を養い続ける必要があるのです。
アルゴリズム

時系列分析とは?意味・仕組み・活用例をわかりやすく解説

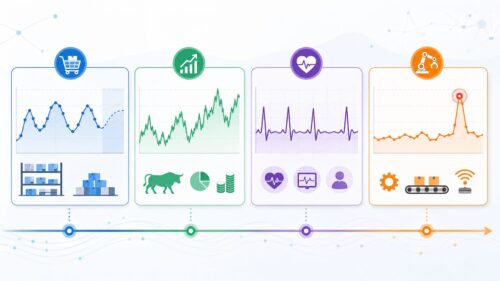
時系列分析とは、時間とともに変化するデータ、すなわち時間の経過とともに順序立てて記録されたデータの並びを詳しく調べる方法です。このデータの並びのことを時系列データと呼びます。たとえば、毎日の気温の変化や毎月の商品の売り上げ金額、毎年の会社の株価、一日の間に変わる心臓の鼓動の数など、様々なものが時系列データとして扱われます。時系列データの特徴は、データが時間の流れに沿って並んでおり、この順番が分析を行う上で非常に重要だということです。普通のデータ分析のように、順番を入れ替えて計算してしまうと、正しい結果が得られません。 時系列分析を行う主な目的は、データの中に隠れている規則性や全体的な流れ、そして繰り返す動きを見つけることです。そして、これらの情報をもとに、将来の値がどのようになるか予測したり、普段とは違う値を見つけて問題を早期に発見したりします。 この分析方法は、様々な分野で役に立ちます。例えば、会社の経営判断に必要な情報を得るために使われます。将来の商品の売れ行きを予測することで、適切な量の在庫を確保し、無駄を減らすことができます。また、株価の上がり下がりを予測することで、より効果的な投資計画を立てることができます。 医療の分野でも、この分析方法は活用されています。たとえば、入院している人の体温や血圧など、刻々と変化する体の状態を示すデータから、病気が悪化する兆候を早期に見つけることができます。 環境問題についても、時系列分析は役立ちます。大気汚染の程度を示すデータの変化を分析することで、汚染の原因を探ったり、効果的な対策を考えたりすることができます。このように、時系列分析は、時間とともに変化する様々な現象を理解し、未来を予測するための強力な道具なのです。
その他

スイッチングハブ:賢いネットワークの立役者

情報のやり取りをスムーズにする装置、それが交換機です。家庭や職場にある情報網の中で、情報の交通整理を行う、まさに信号機のような働きをしています。 複数の計算機や印刷機などが情報網につながっている場面を想像してみてください。それぞれの機械が送る情報は、まるでたくさんの車が行き交う道路のようです。この情報の行き先を間違えずに、きちんと届けるのが交換機の仕事です。それぞれの機械が持つ固有の番号を基に、情報が正しい相手に届くように制御します。 例えば、AさんがBさんに情報を送りたい場合、交換機はBさんの番号を確認し、Aさんから受け取った情報をBさんのみに送ります。CさんやDさんには届きません。これにより、不要な情報の拡散を防ぎ、情報網全体の混雑を避けることができます。 また、交換機は、情報網への入り口となる装置と各機械との間を取り持ちます。情報網への入り口となる装置は、異なる情報網同士をつなぐ役割を果たしています。交換機はこの装置と各機械の間で情報の受け渡しを仲介することで、情報網全体の効率的な運用を支えています。 このように、交換機は情報の送受信を滞りなく行うことで、快適な情報網環境を実現するために無くてはならない存在と言えるでしょう。まるで縁の下の力持ちのように、私たちの暮らしや仕事を支えているのです。
GPU

GPGPU:画像処理を超えたGPUの力

絵を描く、動画を滑らかに動かすといった役割を担う部品である画像処理装置、略して画像処理器。この画像処理器は、元々はパソコンで画像を扱うためだけに作られました。しかし、この画像処理器はたくさんの計算を同時に行うことができるという優れた力を持っています。この力に目をつけた技術者たちは、画像処理以外の計算にもこの力を使えないかと考えました。これがまさに、画像処理器を用いた汎用計算、略して汎用画像処理計算の始まりです。 汎用画像処理計算とは、画像処理器が持つ同時計算処理能力を、本来の画像処理以外の様々な計算作業に活用する技術のことです。例えば、複雑な科学技術計算や大量の情報の分析など、従来は中央処理装置、略して演算処理器が担っていた計算処理の一部を画像処理器に肩代わりさせることで、処理速度を飛躍的に向上させることができます。 演算処理器は、複雑な計算を一つずつ順番に処理していくのに対し、画像処理器は簡単な計算を大量に同時に行うという特徴があります。例えるなら、演算処理器は熟練の職人が一つずつ丁寧に作品を作り上げるのに対し、画像処理器はたくさんの作業員が流れ作業で同じ製品を大量に生産するようなものです。大量の同じ作業を同時に行う必要がある場合には、画像処理器の方が圧倒的に速く処理を終えることができます。 このように、汎用画像処理計算は、画像処理器の並列処理能力を活用することで、様々な分野の計算処理を高速化できる革新的な技術です。近年では、人工知能の学習や仮想通貨の計算、医療分野での画像診断など、様々な分野で活用されており、今後も更なる発展が期待されています。
その他

音韻とは?具体例・簡単な説明・活用例をわかりやすく解説

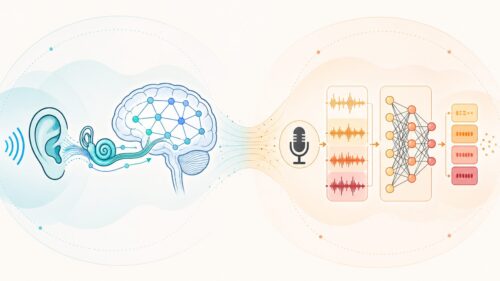
ことばを話すとき、私たちは様々な音を使い分けています。これらの音は、意味の違いを生み出す最小の単位に分解することができます。これを音素といいます。例えば、「かき」と「たけ」を考えてみましょう。これらのことばは、「か」と「た」、「き」と「け」というそれぞれ異なる音素によって区別されています。音素一つが変わるだけで、ことばの意味が全く変わってしまうのです。 しかし、音素は常に一定の音として発音されるわけではありません。例えば、「たち」の「た」と「たい」の「た」は、実際の音としては少し違います。「たち」の「た」は息を強く出しませんが、「たい」の「た」は息を強く出します。このように、同じ音素であっても、周囲の音やアクセント、話し手の癖などによって、具体的な発音は微妙に変化します。 音韻とは、このような音素の様々なバリエーションを含んだ、より抽象的な概念です。具体的にどのような音で発音されたとしても、話し手たちが同じ音として認識するのであれば、それらは同じ音韻に属します。つまり、「たち」の「た」と「たい」の「た」は、物理的な音としては異なる場合がありますが、どちらも「た」という音韻として認識されるのです。 このように、音韻は、音素の物理的な違いを超えた、言語における音の体系を表しています。同じ言語を話す人々は、無意識のうちにこの音韻体系を共有しており、だからこそ多少の発音の違いがあっても、互いに理解し合うことができるのです。音韻の理解は、ことばをどのように聞き分け、どのように理解しているのか、その仕組みを解き明かす重要な鍵となります。
AIサービス

生成AI利用規約:理解と同意の重要性

利用規約とは、あるサービスを使う人々とそのサービスを提供する側との間で交わされる、いわば約束事です。これは文書にまとめられており、サービスを使う上での様々なルールや注意事項が書かれています。最近よく耳にする「生成人工知能」という新しい技術が登場したことで、この利用規約は、これまで以上に大切になってきました。 生成人工知能は、とても多くの情報から学習し、様々なものを作り出すことができます。そのため、従来のサービスには無かった、複雑な問題が出てきています。例えば、誰かの作ったものに対する権利(著作権)や、個人の情報の扱い方、倫理的な問題などです。生成人工知能を使う上で、これらの問題を避けて通ることはできません。 利用規約には、こうした問題に対して、サービスを提供する側がどのような考えを持っているのか、利用者に対してどのような責任を負うのか、そして利用者がどのようなルールを守らなければならないのかが、はっきりと書かれています。例えば、生成人工知能を使って作ったものの権利は誰にあるのか、作ったものをどのように使っていいのか、使ってはいけないのか、といったことです。これらのルールを守ることで、私たちは安心してサービスを使うことができますし、他の人にも迷惑をかけることなく、正しく技術を活用していくことができるのです。 生成人工知能のサービスを安全に、そして適切に使うためには、利用規約をよく読んで内容を理解し、同意することが欠かせません。これは、ただの手続きではありません。責任ある利用者として、自覚を持つための最初のステップなのです。利用規約をよく理解し、それに従ってサービスを使うことで、私たちは新しい技術の恩恵を安全に受けることができるようになります。
画像生成

文章から画像生成:新たな創造性を

「言葉が絵に変わる技術」という表現は、まさに言い得て妙です。まるで魔法のようなこの技術は、「文章から画像を生成する技術」と呼ばれ、近年急速に発展を遂げています。具体的には、私たちが普段使っている言葉で情景や物体を説明するだけで、人工知能がその意味を理解し、それに基づいて画像を作り出すことができます。例えば、「夕焼けに浮かぶ赤い帆船」と入力すると、燃えるような夕焼け空を背景に、鮮やかな赤い帆を張った船が静かに海に浮かぶ絵が、まるで魔法のように画面に現れます。今まで絵を描くことは、特別な才能や技術、そして長年の訓練が必要な、一部の人のみが可能な表現方法でした。しかし、この技術の登場によって、絵を描くための技術や知識を持たない人でも、頭に思い描いたイメージを簡単に形にすることが可能になりました。これは、まさに「表現の手段を誰もが手にできるようになった」という、大きな変化と言えるでしょう。まるで想像力を形にする装置を手に入れたかのように、誰もが自由に自分の世界観を表現し、共有できるようになりました。この技術は単に絵を描く道具という枠を超え、言葉と絵画の境界線を曖昧にすることで、私たちの創造性を大きく広げる可能性を秘めています。例えば、商業デザインの分野では、言葉でイメージを伝えれば、人工知能が即座にデザイン案を作成してくれるため、デザイン制作の効率化に繋がります。また、教育の分野では、子供たちが想像力を働かせて言葉で表現したものを、すぐに絵として見ることができるため、より豊かな表現力や創造性を育むための効果的なツールとなるでしょう。今後、この技術がどのように進化し、私たちの生活にどのような影響を与えていくのか、期待が高まります。
GPU

CPUとGPUの違いとは?AI学習でGPUが使われる理由をわかりやすく解説

電子計算機の心臓部とも呼ばれる中央処理装置、すなわちCPUは、人間の脳のように様々な指示を受け取り、それを処理する役割を担っています。あらゆる計算処理はこのCPUで行われており、例えば画面に文字を表示したり、絵を描いたり、音を鳴らしたり、といった動作も、全てCPUからの指示によって実現されています。また、インターネットを閲覧したり、文章を作成したり、様々な道具を動かすのも、CPUが中心となって制御しています。 CPUは、複雑な計算や論理的な判断を、高速で正確に行うことが得意です。料理に例えると、たくさんの手順が書かれた複雑なレシピを、一つずつ丁寧に手順を追って調理していくようなものです。CPUは、与えられた命令を順番に、一つずつ確実に処理していくため、様々な種類の作業に柔軟に対応できます。例えば、文章を書きながら音楽を聴き、同時にインターネットで情報を検索するといった複数の作業も、CPUがそれぞれを順番に処理することで実現できるのです。 しかし、CPUには不得意な処理もあります。それは、同じ種類の計算を大量に同時に行う処理です。例えば、大量の写真の色味を同時に調整するといった作業は、CPUにとっては少々荷が重い処理です。このような処理は、CPUとは異なる仕組みを持つ部品、例えば画像処理装置など、同時に多数の計算を処理することに特化した部品に任せた方が効率的です。CPUは、様々な作業を柔軟にこなせる反面、同時処理に関しては限界があることを理解しておくことが大切です。
AI活用

生成AIの商用利用とは?意味・活用例・注意点を初心者向けに解説

生成人工知能(生成AI)とは、自ら新しい情報や表現を生み出す能力を持つ人工知能のことです。従来の人工知能は、人間が与えた情報から規則性を見つけ、分類や予測を行うことを得意としていました。例えば、大量の画像データから猫を識別する、過去の売上データから将来の売上を予測するといったことです。しかし、生成AIは、学習した情報に基づいて、文章、画像、音声、プログラムのコードなど、様々な種類の新しい情報を作り出すことができます。 文章生成AIは、キーワードやテーマを与えると、それに沿った文章を自動的に作成します。例えば、小説や記事の執筆、翻訳、文章の要約などを人間の手を借りずに実行できます。また、画像生成AIは、言葉で説明を入力するだけで、写真のようなリアルな画像やイラスト、デザインなどを生成することができます。これにより、絵を描く技術を持たない人でも、簡単に画像を制作することが可能になります。さらに、音声生成AIは、まるで人間が話しているかのような自然な音声や、音楽、効果音などを作り出すことができます。これは、映画やゲームの音声制作、バーチャルアシスタントの音声などに活用できます。 このように、生成AIは様々な分野で応用が期待されています。創造的な作業を支援・自動化することで、私たちの仕事効率を大幅に向上させるだけでなく、新しい表現の可能性を広げることにも繋がります。今後、生成AIは社会の様々な場面で活用され、私たちの生活を大きく変えていくと予想されます。
セキュリティ

シングルサインオンで快適ログイン

今では、誰もが暮らしの中で様々な場所でインターネットを使うようになりました。買い物や友達とのやり取り、調べ物など、インターネットを通してできることは実に様々です。そして、こうしたインターネット上のサービスを使うためには、ほとんどの場合、利用者登録をして自分のアカウントを作る必要があります。それぞれのサービスごとにアカウントを作り、バラバラのパスワードを設定して管理するのは、なかなか面倒なものです。パスワードを忘れてログインできない、なんていう経験をした人も多いのではないでしょうか。 そこで登場したのが、一度の認証手続きで複数のサービスにログインできる仕組み、シングルサインオンです。シングルサインオンを使えば、いくつものサービスを利用する際にも、たった一度のログインで済むようになります。まるで鍵のかかった複数の部屋に、一つの鍵で入れるようなイメージです。この仕組みのおかげで、たくさんのパスワードを覚えておく必要がなくなり、パスワード管理の手間が大幅に軽減されます。また、複雑で推測されにくいパスワードを設定することが容易になり、セキュリティの向上にも繋がります。 シングルサインオンは、私たちのインターネット生活をより便利で安全なものにしてくれる、大変便利な仕組みです。この仕組みがどのように実現されているのか、導入することでどのような利点や欠点があるのか、実際にどのようなサービスで活用されているのか、といった点について、これから詳しく見ていきましょう。シングルサインオンを理解することで、インターネットをより快適に、そして安全に利用できるようになるでしょう。
セキュリティ

営業秘密:守るべき企業の宝

会社にとって宝物のような情報、それが営業秘密です。会社の強みを生み出し、他社に差をつけるために欠かせない、大切な情報のことです。この営業秘密は、不正競争をなくすための法律によって守られています。この法律では、営業秘密を「役に立つ」「秘密にされている」「みんなが知らない」という三つの特徴を持つ情報としています。 まず、「役に立つ」とは、その情報を使うことで会社の利益につながったり、仕事がうまく進んだりすることを意味します。例えば、特別な商品の作り方や、お客さんに関する特別な情報などが考えられます。次に、「秘密にされている」とは、その情報が限られた人だけが知っている状態で、きちんと管理されていることを意味します。情報を扱う人だけにアクセスを制限したり、書類に鍵をかけて保管したりといった対策が必要です。最後に「みんなが知らない」とは、その情報が、同じ仕事をしている人たちの間では知られていない、特別な情報であることを意味します。 この三つの特徴をすべて満たす情報だけが、法律で営業秘密として認められ、守られます。もし、これらの条件を満たしていない場合、他社が同じ情報を使っても、法律で罰せられることはありません。ですから、自社の情報を営業秘密として守るためには、まず自社にある大切な情報を洗い出し、この三つの条件を満たすようにきちんと管理することが重要です。具体的には、秘密の情報にアクセスできる人を制限したり、情報を保管する場所をきちんと管理したりするなど、秘密を守るための対策をしっかりと行う必要があります。そうすることで、他社に真似されることなく、安心して事業を進めることができます。営業秘密を守ることは、会社の将来を守ることにつながるのです。
開発環境

TensorFlowとは?仕組み・できること・学習方法を初心者向けに解説

「テンソル・フロー」とは、機械学習を扱うための便利な道具集のようなもので、誰でも無料で使うことができます。これは、まるでたくさんの部品が入った箱のようなもので、開発者は自分のプログラムにこれらの部品を組み込むことで、難しい機械学習の機能を簡単に実現できます。この道具集は、人間の脳の神経回路の仕組みを真似た「ニューラルネットワーク」を作るのが得意です。 テンソル・フローは、特に画像を認識したり、人間の言葉を理解したりする技術で広く使われています。例えば、写真に写っているのが犬なのか猫なのかを判断したり、文章を翻訳したり、文章の内容を要約したりといった作業が可能です。また、医療の分野では、レントゲン写真から病気を診断するのを助けたり、創薬の研究にも役立っています。 テンソル・フローは、まるで学習の達人のように、膨大な量のデータを読み解き、複雑な規則性を学ぶことができます。この能力のおかげで、機械は大量のデータから隠れたパターンを見つけ出すことができます。例えば、過去の気象データから未来の天気を予測したり、顧客の購買履歴からおすすめの商品を提案したりすることが可能になります。 テンソル・フローは、私たちが普段使っている様々な技術をより賢く、便利にしてくれる、縁の下の力持ちのような存在です。例えば、スマートフォンの音声認識や検索エンジンの予測変換、自動運転技術など、様々な場面で活躍しています。今後もテンソル・フローの進化によって、さらに生活が豊かになり、新しい技術が生まれてくることが期待されます。