 学習
オフライン強化学習:過去のデータ活用の力
人工知能の研究分野で近年、大きな注目を集めている技術の一つに強化学習があります。強化学習とは、まるで人間が学習するように、試行錯誤を繰り返しながら最適な行動を学ぶ方法です。囲碁や将棋といったゲームの分野では、すでに人間を超える強さを示しており、様々な分野への応用が期待されています。
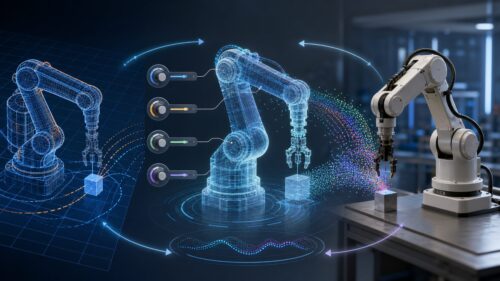
従来の強化学習では、実際にシステムを動かしながら、うまくいったかどうかを評価し、次の行動を決定するという過程を繰り返す必要がありました。例えば、ロボットに新しい動作を学習させる場合、ロボットを実際に何度も動かし、成功と失敗を繰り返しながら学習を進めます。自動運転技術の開発であれば、実車を用いた走行実験を繰り返すことになります。
しかし、このような学習方法は現実世界のシステムへの適用において、いくつかの課題を抱えています。一つは安全性の問題です。自動運転の例では、学習中に誤った行動を取ると事故につながる可能性があり、実環境での学習は危険を伴います。また、膨大な費用と時間がかかることも課題です。ロボットの動作学習では、ロボットが壊れる可能性があり、修理費用がかかります。自動運転の学習では、実験車両の維持や実験場所の確保に多額の費用が必要となります。さらに、試行錯誤を繰り返すため、学習に時間がかかることも問題です。
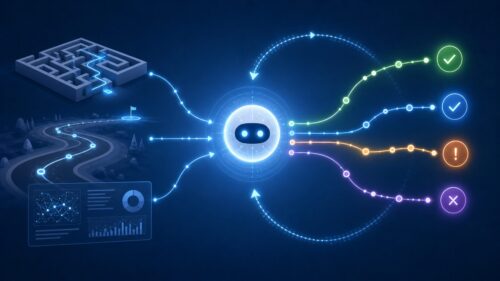
これらの課題を解決する手段として、近年注目されているのがオフライン強化学習です。オフライン強化学習は、過去に収集したデータのみを用いて学習を行うため、実環境での試行錯誤を必要としません。つまり、既に記録されているデータを使って、あたかも実際にシステムを動かしているかのように学習を進めることができます。この学習方法は、安全性と効率性を大幅に向上させる可能性を秘めています。過去のデータを用いるため、実環境での危険な試行錯誤を避けられるだけでなく、実験にかかる費用や時間も大幅に削減できます。これにより、これまで現実世界への適用が難しかった分野でも、強化学習を活用できるようになると期待されています。