AI活用

アルファスター:ゲームAIの進化

囲碁や将棋の世界で人工知能が人間を超える実力を示したことは記憶に新しいですが、複雑な操作と戦略が求められるコンピューターゲームの世界でも人工知能の躍進は目覚ましいものがあります。その代表例として、ディープマインド社が開発した「アルファスター」という人工知能をご紹介しましょう。アルファスターは、人気のあるリアルタイム戦略ゲーム「スタークラフト2」をプレイするために作られました。 このゲームは、資源を集め、建物を建て、軍隊を編成し、敵と戦うという複雑な要素が絡み合っており、人間でも熟練するには大変な努力が必要です。これまでのコンピューターゲーム用の人工知能は、あらかじめ決められたルールやパターンに従って動くものが主流でした。しかし、アルファスターは違います。アルファスターは人間と同じように、ゲーム画面を見て状況を判断し、適切な行動を選択できるのです。まるで人間のプレイヤーが操作しているかのような、高度なゲームプレイを実現しています。 アルファスターの学習方法は「強化学習」と呼ばれており、これは試行錯誤を通じて学習していく方法です。アルファスターは自分自身と対戦を繰り返し、その中で勝利につながる行動や戦略を学び、徐々にその能力を高めていきました。驚くべきことに、この自己学習によってアルファスターはプロゲーマーに匹敵する、場合によっては凌駕するほどの高いレベルに到達したのです。 アルファスターの革新的な点は、画面情報を入力として受け取り、人間と同じようにゲームを理解するという点にあります。これは、従来の人工知能とは一線を画すアプローチです。アルファスターの成功は、人工知能が複雑な課題を解決する能力を秘めていることを示しており、今後のゲーム開発だけでなく、様々な分野への応用が期待されています。
セキュリティ

声紋認証とは?声で本人確認する仕組み・利点・注意点をわかりやすく解説

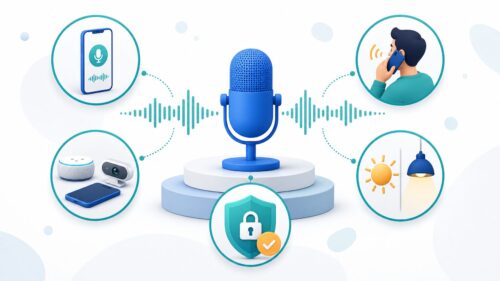
声紋認証とは、人の声の特徴を捉え、それを基に個人を識別する技術のことです。私たちは毎日、色々な人の声を聞き分けていますが、声紋認証もこれと似た仕組みを持っています。ただし、人の耳で聞き分けるよりもはるかに精密な分析を行い、声に含まれる様々な個人特有の特徴を捉えます。 人の声には、実に多くの要素が含まれています。例えば、声帯の形状や大きさは人それぞれ異なり、これが声の基本的な高さや音質を決定づけます。また、声道や鼻腔、口腔といった空間の形状も声に影響を与え、共鳴によって独特の音色を作り出します。さらに、話し方や発音の癖、話す速さ、声の大きさなど、無意識のうちに身につく発声の習慣も、個人を識別する重要な手がかりとなります。声紋認証では、これらの様々な要素を音声データから抽出、数値化し、固有のパターンとして記録します。 この記録されたパターンは、言わば声の指紋のようなもので、「声紋」と呼ばれます。声紋認証は、この声紋を照合することで本人確認を行います。認証時には、利用者の声を取り込み、同様に声の特徴を数値化し、登録されている声紋データと比較します。両者が一致すれば本人と認証され、アクセスが許可される仕組みです。 声紋認証は、高い精度で本人確認を行えるため、近年、様々な分野で活用が進んでいます。例えば、電話による本人確認や、建物の入退室管理、スマートフォンやパソコンのロック解除など、セキュリティ対策として導入されています。また、ハンズフリー操作を可能にするなど、利便性の向上にも役立っています。今後、ますます私たちの生活の中で身近な存在になっていくと期待されています。
AI活用

テキストマイニングで情報の宝探し

今や誰もが使うようになったインターネット。そこには、ブログの記事や会員制交流サイトへの書き込み、お店への質問のメールなど、毎日膨大な量の文章が生まれています。これらの文章の中には、私たちの暮らしや仕事に役立つ大切な情報が隠されているのです。まるで、広大な海に沈んだ宝物を探すようなものです。その宝探しの役に立つのが、文章の中から価値ある情報を見つけ出す技術、「文章掘り出し」です。 文章掘出しを使うと、大量の文章を分析し、隠れた流行やお客さんの望み、市場の動きなどを掴むことができます。例えば、会員制交流サイトで人気の話題や、お客さんからよく寄せられる質問を分析することで、商品開発や販売戦略に役立てることができるでしょう。また、膨大な数の新聞記事や研究論文を分析することで、最新の技術動向や社会問題の現状を把握することも可能です。 文章掘り出しは、まるで砂浜から金塊を見つけ出すような作業と言えるでしょう。一見するとただの砂の塊にしか見えませんが、よく見てみると、その中には貴重な金塊が隠されていることがあります。同じように、膨大な文章データも、一見するとただの文字の羅列にしか見えませんが、文章掘り出しを使うことで、そこに隠された価値ある情報を見つけ出すことができるのです。 この技術は、様々な分野で活用されています。例えば、企業は顧客の声を分析して商品開発に役立てたり、研究者は論文を分析して新しい発見につなげたり、行政機関は世論を分析して政策に反映させたりしています。文章掘出しは、情報化社会においてますます重要な技術となり、私たちの暮らしや社会をより豊かにしてくれる可能性を秘めていると言えるでしょう。
LLM

進化したAI、GPT-4の可能性

人間の言葉を理解し、まるで人間が書いたかのような文章を生み出す技術は、近年目覚ましい発展を遂げています。その進歩を牽引する技術の一つが、最新の言語モデルです。この革新的な言語モデルは、膨大な量の文章データを読み込んで学習することで、言葉の繋がりや意味、文脈などを理解し、自然で人間らしい文章を生成することを可能にしています。 この度、人工知能開発の最前線にいる研究機関が、これまでの言語モデルを大きく上回る性能を持つ、全く新しい言語モデルを開発しました。この革新的な言語モデルは、以前のモデルと比べて、より自然で滑らかな文章を生成できるだけでなく、複雑で難しい指示にも正確に対応できるという点で、大きな進化を遂げています。 以前のモデルでは、指示が複雑になると、意図しない文章が生成されたり、指示の内容を正しく理解できなかったりするといった課題がありました。しかし、この新しい言語モデルは、高度な計算方法と洗練された仕組みによって、これらの課題を克服しています。膨大な量のデータで学習することで、言葉の奥深くに隠された意味や文脈を理解する能力が格段に向上し、複雑な指示内容を正確に捉え、適切な文章を生成できるようになりました。 この新しい言語モデルの登場は、人工知能が人間の言葉を理解し、扱う技術において、新たな段階へと進んだことを示しています。この技術は、文章の自動生成だけでなく、様々な分野での応用が期待されています。例えば、文章の要約、翻訳、質疑応答システム、文章の校正、更には小説や脚本の執筆支援など、私たちの生活の様々な場面で革新をもたらす可能性を秘めているのです。今後、更なる研究開発によって、この革新的な技術がどのように進化し、私たちの社会に貢献していくのか、期待が高まります。
学習

報酬成形とは?意味・仕組み・活用例をわかりやすく解説

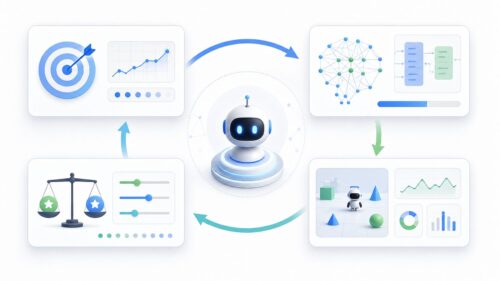
試行錯誤を通して学習する機械学習の手法の一つである強化学習では、まるで動物の調教のように、望ましい行動には褒美を与え、望ましくない行動には罰を与えることで、学習を行う主体であるエージェントに最適な行動を覚えさせていきます。この学習の過程で、褒美を与える基準となるのが報酬関数です。報酬関数は、エージェントの行動に対する褒美の与え方を定めた規則であり、強化学習の肝となる重要な要素です。報酬成形とは、この報酬関数を適切に作り上げる工程のことを指します。 適切な報酬関数を作り上げることで、エージェントは効率的に学習を進め、目標とする行動を習得できます。例えば、迷路を解く課題を学習させる場合、ゴールに到達した時に大きな褒美を与え、壁にぶつかった時には罰を与えることで、エージェントは迷路を解くための適切な経路を見つけることができます。また、ゴールまでの距離に応じて段階的に褒美を与えることで、より早くゴールに到達するようにエージェントを導くことも可能です。 逆に、報酬関数の設計が不適切だと、エージェントは望ましくない行動を学習してしまったり、学習が全く進まなかったりする可能性があります。例えば、迷路の途中で特定の場所に留まることで小さな褒美が得られるように設定してしまうと、エージェントはその場所に留まり続け、ゴールを目指さなくなってしまうかもしれません。また、褒美と罰のバランスも重要です。罰が大きすぎると、エージェントは行動を起こすことを恐れ、学習が進まなくなる可能性があります。 このように、報酬関数の設計は強化学習の成否を大きく左右します。そのため、報酬成形は強化学習において非常に重要な役割を担っていると言えるでしょう。試行錯誤を通して最適な報酬関数を見つけることが、強化学習を成功させる鍵となります。
AIサービス

声で感情を読み解くAI

近年、人工知能の技術は目覚ましい発展を遂げ、さまざまな分野で活用されています。特に、音声から感情を読み取る人工知能は、人と人とのやり取りをより深く理解する上で、画期的な技術として注目を集めています。これまでの音声認識技術は、話されている言葉の内容を理解することに重点が置かれていました。しかし、この声の感情認識人工知能は、言葉の意味ではなく、声そのものの特徴から感情を捉えます。 これにより、異なる言葉を話す人同士でも、感情のやり取りを理解することができるようになります。例えば、日本語を話す人と英語を話す人が会話をしている時、言葉は通じなくても、声の調子や上がり下がりから互いの気持ちを察することができる場合があります。声の感情認識人工知能は、まさにこのような人の能力を機械で再現しようとする取り組みです。言葉の壁を越え、声を通してより円滑な意思疎通を実現する可能性を秘めています。 具体的には、声の高さ、速さ、強さ、そして声の震え方などを分析することで、喜び、悲しみ、怒り、驚きといった様々な感情を識別します。この技術は、顧客対応の向上にも役立ちます。例えば、電話対応の際に顧客の声から不満や怒りを検知し、適切な対応を取ることで、顧客満足度を高めることができます。また、教育分野でも活用が期待されています。学習者の声から集中度や理解度を把握し、学習内容や指導方法を最適化することで、より効果的な学習を支援することができます。 さらに、エンターテイメント分野への応用も期待されています。ゲームや映画などのコンテンツに声の感情認識人工知能を組み込むことで、登場人物の感情をよりリアルに表現したり、利用者の感情に合わせた演出を行うことが可能になります。このように、声の感情認識人工知能は、様々な分野で私たちの生活を豊かにする可能性を秘めているのです。
アルゴリズム

チューリングマシンとは何か?初心者向けにわかりやすい解説と仕組みを整理

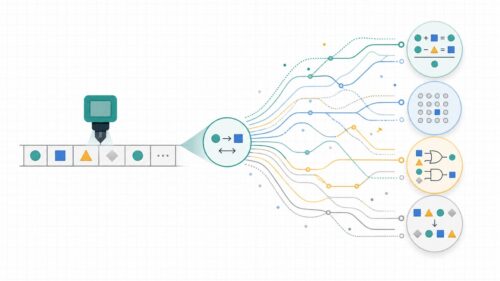
今の計算機、つまりコンピュータがどのように動くのかを知るには、チューリング機械という考え方を避けて通ることはできません。このチューリング機械は、イギリスの数学者、アラン・チューリングが1936年に考えた計算の仕組みを表す画期的な模型です。計算とは何かという根本的な部分をうまく捉えています。チューリング機械は、単純な作りに見えますが、どんな計算でもこなせる力を持っているところが驚くべき点です。それは、無限に続くテープと、そのテープに書き込んだり読み込んだりする装置、そして現在の状態と読み込んだ記号に応じて次の動作を決める規則表という、たった3つの要素からできています。テープには記号が書かれており、装置はその記号を一つずつ読み込みます。そして、規則表に従って記号を書き換えたり、テープの位置をずらしたり、機械の状態を変えたりします。この単純な動作の繰り返しによって、どんな複雑な計算でも実現できるのです。今のコンピュータも、基本的にはこのチューリング機械と同じように動いていると言えるでしょう。例えば、コンピュータの記憶装置はチューリング機械のテープ、中央処理装置は読み書き装置と規則表に相当します。プログラムは規則表に書かれた指示のようなもので、コンピュータはこの指示に従って計算を進めていきます。ですから、チューリング機械を学ぶということは、計算機の根本的な仕組みを学ぶことに繋がると言えるのです。計算機の歴史を振り返ると、様々な計算装置が開発されてきましたが、チューリング機械はそれらと一線を画しています。それは、具体的な機械の構造ではなく、計算の本質を抽象的なモデルとして捉えているからです。このおかげで、計算とは何かを深く理解する手がかりとなり、現代のコンピュータ科学の基礎を築く上で重要な役割を果たしました。チューリング機械は単なる理論的な模型にとどまらず、今日の情報化社会を支える計算機技術の根底にある重要な概念なのです。
AI活用

人工知能の幕開け:ダートマス会議

一九五六年、夏の暑さが街を包む頃、アメリカ北東部のニューハンプシャー州ハノーバーにあるダートマス大学で、のちに世界を変える画期的な会議が幕を開けました。緑豊かなキャンパスに集まったのは、ジョン・マッカーシーを筆頭とする、若くして才能あふれる研究者たちでした。マッカーシーは当時ダートマス大学に所属する数学者で、人間の知的な働きを機械で再現するという、当時としては途方もない構想を抱いていました。この会議はのちに「ダートマス会議」と呼ばれ、人工知能という概念が公式に提唱された歴史的な場となりました。 会議の開催にあたり、マッカーシーは世界中からこの分野の有望な研究者たちに声をかけました。会議の提案書には、マービン・ミンスキー、クロード・シャノン、ナサニエル・ロチェスターといった、のちに人工知能研究の土台を築くことになる、そうそうたる顔ぶれが名を連ねていました。ミンスキーは、人間の学習能力を機械で実現しようと研究に情熱を注ぐ研究者でした。シャノンは、情報の伝達を数学的に体系化した情報理論の大家として知られていました。ロチェスターは、コンピューターの設計に携わり、その発展に大きく貢献した人物でした。 彼らは、人間の思考の仕組みを解き明かし、それを機械で模倣するという、当時としては非常に斬新な目標を掲げ、熱のこもった議論を交わしました。会議では、人間の言葉を理解する機械翻訳や、自ら学習する機械学習、複雑な問題を解決する推論など、様々なテーマが話し合われました。ダートマス会議は、人工知能という新しい学問分野の出発点となり、その後の技術革新の大きな流れを生み出すきっかけとなりました。会議の参加者たちは、人工知能の実現に向けて、互いに協力し、切磋琢磨しながら研究を進めていくことを誓い合ったのでした。
学習

連続値制御:AIによる滑らかな動きの学習

機械学習、とりわけ深層強化学習という分野では、学習をする主体であるエージェントというものが周りの状況と関わり合いながら、最も良い行動を学びます。この学習の中で、エージェントが行う行動は大きく二つに分けることができます。一つ目は「離散値制御」と呼ばれるものです。これは、例えばゲームの登場人物が「上」「下」「左」「右」に動く、もしくは「攻撃」「防御」のような選択肢から一つを選ぶように、飛び飛びの値で行動を決めるものです。たとえば、じゃんけんのように「グー」「チョキ」「パー」から選ぶのも離散値制御にあたります。選択肢が限られているため、エージェントは比較的簡単に最適な行動を見つけ出すことができます。一方、二つ目は「連続値制御」です。こちらは滑らかに変化する値で行動を決めるものです。例えば、ロボットアームの角度を細かく調整したり、車のアクセルを踏む強さを微妙に変えたりする場面では、行動は連続的な値で表されます。他にも、工場の機械の温度設定や、薬品を混ぜる際の分量調整なども連続値制御の例です。離散値制御とは異なり、連続値制御では無数の選択肢の中から最適な値を見つけなければなりません。これは複雑な問題であり、高度な学習アルゴリズムが求められます。連続値制御は、ロボットの制御や自動運転といった分野で重要な役割を担っており、より精密で柔軟な制御を実現するために欠かせない技術となっています。近年では、深層強化学習の発展に伴い、連続値制御の性能も向上しており、様々な分野への応用が期待されています。
GPU

GPGPUとは?その仕組みと利点

図形を描く処理に特化した電子部品である画像処理装置(GPU)は、近年、その用途を大きく広げています。元々は画面に映し出される映像や画像の処理を高速に行うために設計されたものですが、画像処理以外の様々な計算にも利用できることが分かり、汎用的な計算処理にGPUを使う技術、それが「GPGPU」です。 GPUは、単純な計算を同時に行うことを得意とする小さな処理装置を多数搭載しています。この多数の処理装置が同時並行で働くことで、膨大な計算を素早くこなすことができます。一方、パソコンの頭脳である中央処理装置(CPU)は、複雑な計算を高速処理することに優れていますが、同時に行える作業の数はGPUに及びません。例えるなら、CPUは少数精鋭の熟練職人、GPUは多数の一般作業員といったところでしょうか。複雑な家具作りは熟練職人のCPUが得意ですが、単純作業の繰り返しであるレンガ積みは、多数の作業員で同時並行作業を行うGPUの方が効率的です。 GPGPUは、このGPUの並列処理能力を活かすことで、従来CPUで行っていた計算を高速化します。膨大な量の情報の分析や、未来予測のための模擬実験など、並列処理に適した作業において、GPGPUはCPUよりも高い性能を発揮します。最近では、人工知能の学習や、大量の情報の分析といった分野で注目を集めています。人工知能は大量の情報を学習することで賢くなりますが、この学習過程は並列処理に適しており、GPUの得意分野なのです。そして情報の量は日々増加しており、その処理能力の需要はますます高まっています。GPGPUは、従来の計算機の限界を突破する可能性を秘めた技術であり、膨大な量の情報の処理が求められる現代社会において、今後ますます重要な役割を担っていくと考えられます。
学習

精度検証データ:モデルチューニングの鍵

機械学習の模型を作る際、その模型がどれほど正確に予想できるかを見極めることはとても大切です。この見極めを行う際に用いる情報のひとつが、精度検証情報です。精度検証情報は、学習情報とは別に用意され、模型の学習中にその性能を測るために使われます。 模型を作るための学習情報は、いわば教科書のようなものです。学習情報を使って模型を訓練することで、模型は教科書の内容を学び、問題を解けるようになります。しかし、教科書に載っていない問題が出題されたとき、その模型がどれくらい正しく答えられるかは分かりません。これが、未知の情報に対する予想能力です。 そこで、精度検証情報を使います。精度検証情報は、本番の試験のようなものです。学習情報で訓練された模型に、精度検証情報を与えてみて、どれくらい正しく答えられるかを確認します。この結果から、模型が未知の情報にどれほど対応できるか、つまり模型の汎化性能を評価します。 例えば、ある模型が学習情報では90%の正答率だったとします。しかし、精度検証情報では60%しか正答できなかった場合、この模型は学習情報に過剰適合している可能性があります。これは、教科書の例題は完璧に解けるけれど、応用問題は解けない生徒のような状態です。 精度検証情報での評価結果をもとに、模型の調整を行います。例えば、模型の細かい設定を調整したり、学習方法を変えたりすることで、模型の精度を高めることができます。これは、生徒の弱点に合わせて勉強方法を改善するようなものです。このように、精度検証情報は、模型の性能を向上させるための特別な情報と言えるでしょう。
学習

複数エージェントの協調と競争:強化学習の新展開

機械学習の中でも、試行錯誤を通して学習する手法を強化学習と言います。従来の強化学習では、学習する主体であるエージェントは一つだけでした。この単一エージェントは、周囲の状況である環境と関わり合いながら、最適な行動を学び取っていきます。しかし、現実世界では、複数の主体が同時に活動し、互いに影響を及ぼし合う場面が多く見られます。 そこで、複数のエージェントが同時に学習する、複数エージェントによる強化学習が登場しました。これは、複数のエージェントが同じ環境の中で同時に活動し、互いの行動が環境に影響を与え、その結果がそれぞれのエージェントの学習に反映されるという仕組みです。単一のエージェントが学習するよりも、現実世界の複雑な状況をより良く表現できます。 複数エージェントによる強化学習は、様々な分野への応用が期待されています。例えば、工場などで複数のロボットを協調させて作業させる群制御の分野では、それぞれのロボットが他のロボットの動きを予測しながら、全体として効率的な作業手順を学習することができます。また、自動運転技術においては、複数の自動運転車が互いの位置や速度情報を共有しながら、安全かつスムーズな走行を実現するために活用できます。さらに、複数の人間が対戦するゲームにおいても、各プレイヤーの戦略を学習し、より高度な人工知能プレイヤーを開発するのに役立ちます。このように、複数エージェントによる強化学習は、複雑な状況下での最適な行動戦略を学習するための強力な手法として、今後の発展が期待されています。
AI活用

推論・探索:人工知能の黎明期

「人工知能」という言葉から、皆さんは何を思い浮かべるでしょうか?人間のように考え、行動する機械、もしかしたら映画や小説で描かれるような未来の世界を想像するかもしれません。しかし、人工知能の始まりは、もっと地道なものでした。 人工知能の初期の研究は、「推論」と「探索」という二つの能力に焦点を当てていました。人間の知能を機械で再現するという大きな目標に向けて、研究者たちはまず、コンピュータに特定の問題を解かせることから始めました。 「推論」とは、限られた情報から論理的に結論を導き出す能力のことです。例えば、ある病気の症状と患者の状態から、病気を特定するといった作業がこれにあたります。初期の人工知能研究では、このような推論の過程をコンピュータで再現しようと、様々な試みが行われました。明確なルールに基づいて結論を導き出すプログラムが開発され、その成果は後に専門家の知識を模倣した「エキスパートシステム」へと繋がっていきます。 一方、「探索」とは、膨大な選択肢の中から最適な解を見つけ出す能力のことです。例えば、迷路の最短経路を見つける、チェスや将棋で最も有利な手を選ぶといった作業が「探索」にあたります。コンピュータは、あらかじめ決められた手順に従って、可能な選択肢を一つずつ調べていくことで、最適な解を探し出します。この「探索」の技術は、後にゲームや経路探索といった分野で大きな成果を上げることになります。 このように、初期の人工知能研究は、「推論」と「探索」という二つの能力をコンピュータで実現することに力を注いでいました。これらの研究は、後の機械学習や深層学習といった技術の土台となり、今日の人工知能の発展に大きく貢献しているのです。
AI活用

知能を測る試金石:チューリングテスト

人間と同じように考える機械、そんな夢の実現に近づくために、どのように機械の知性を測るべきか、様々な方法が考えられています。その中で、アラン・チューリングという人が考えた「チューリングテスト」は、今でも重要なものとして知られています。このテストは、まるでゲームのような方法で機械の知性を試します。まず、人間が機械と別の人間と、文字だけで会話を行います。この時、人間はどちらが機械でどちらが人間かを知りません。もし、機械が上手に会話を続け、人間が機械と人間を見分けられなかった場合、その機械は人間と同じくらいの知性を持っていると判断されます。 チューリングテストの大切な点は、ただ計算が速いだけではなく、言葉の意味を理解し、会話の流れに合った返答ができるかを試すところです。例えば、「今日の天気は?」と聞かれたら、「晴れです」とだけ答えるだけでなく、「今日は晴れて気持ちが良いですね。ピクニックに最適です」のように、状況を理解した返答ができるかどうかが重要になります。これは、機械が人間のように考える力を測る上で、画期的な考え方でした。 チューリングテストは、人工知能の研究にとって、目指すべき目標を示す羅針盤のような役割を果たしました。また、このテストは、「知性とは何か」「人間らしさとは何か」といった、深い問いを私たちに投げかけています。機械が人間のように考える日が来るのか、それはまだ分かりません。しかし、チューリングテストのような様々な方法で機械の知性を測ることで、私たちは人間と機械の未来について、より深く考えることができるようになるでしょう。
AI活用

生成AI研究チーム「プロティノス」始動

私たちのものづくり会社、ジーエムテックは、常に新しい技術を取り入れ、お客様に最高のサービスをお届けすることを目指しています。近年、目覚ましい発展を見せている生成人工知能技術は、様々な分野で大きな変化を起こすと期待されています。この技術の秘めた力に注目し、自社製品の改良や新しいサービス開発に役立てるため、2023年3月、社内に専門チーム「プロティノス」を立ち上げました。 生成人工知能は、文章、絵、音声、プログラムなど、様々なものを作り出すことができる技術であり、私たちの事業に画期的な変化をもたらす可能性を秘めています。例えば、文章作成支援によって、より質の高い書類を効率的に作成したり、画像生成によって、今までにない斬新なデザインを生み出すことができます。また、音声合成技術を活用した自然な音声案内システムや、プログラム自動生成による開発期間の短縮なども期待されます。 プロティノスは、生成人工知能技術の中でも特に、文章生成、画像生成、音声合成、プログラム自動生成の4つの分野に重点的に取り組みます。それぞれの分野で専門知識を持つ社員を集め、技術の研究開発を進めていきます。 プロティノスは、この革新的な技術を徹底的に研究し、その可能性を最大限に引き出すことで、社会に貢献することを目指します。具体的には、生成人工知能技術を活用した新しい製品やサービスの開発、業務効率化による生産性向上、顧客満足度の向上を目指します。また、研究成果を積極的に公開し、業界全体の発展にも貢献していきます。 私たちは、プロティノスが社内外に大きな刺激を与え、会社全体の成長を加速させるものと確信しています。そして、プロティノスを通じて、社会全体の進歩に貢献していく所存です。
学習

精度の意味と重要性

人の暮らしに知恵を吹き込む技術、人工知能。この技術を語る上で、よく耳にする言葉の一つに「精度」があります。まるで職人の技を測るように、人工知能の良し悪しを測る物差し、それが「精度」です。この精度は、人工知能がどれくらい正確に仕事をこなせるかを示す大切な指標です。日常会話でも「精度の高い仕事」といえば、間違いなく、質の高い仕事を想像するでしょう。人工知能の世界でも、同じように考えられます。 人工知能の分野では、この「精度」は「適合率」という統計学や機械学習で使われる考え方と深く関わっています。適合率とは、人工知能が「正しい」と判断したものの中で、実際にどれだけが本当に正しかったのかを示す割合です。例えば、たくさんの写真の中から猫の写真を選ぶ人工知能があるとします。この人工知能が10枚の写真を猫と判断し、そのうち8枚が実際に猫の写真だった場合、この人工知能の精度は80%となります。 なぜ精度はそれほど重要なのでしょうか?それは、人工知能が社会の様々な場面で使われるようになってきているからです。病気の診断や車の自動運転など、人の命に関わるような場面でも人工知能が活躍しています。もし、これらの場面で使われる人工知能の精度が低ければ、重大な事故につながる可能性もあります。だからこそ、人工知能の精度を理解し、正しく評価することは、安全で信頼できる人工知能を作る上で欠かせないのです。 この文章では、人工知能における精度の意味、その重要性、そしてどのように解釈すればいいのかを、具体例を交えながら分かりやすく説明していきます。精度の基本を理解することで、人工知能についての理解をより深め、この技術の未来を考える一助となることを願っています。
AI活用

OpenAI Five:電脳が挑む複雑な戦い

近頃、電脳、つまり人工知能(じんこうちのう)の進歩は目覚しく、様々な分野で目を見張る成果を上げています。特に、複雑な戦略が必要となるゲームの世界において、その進歩は目覚ましいものがあります。古くからある将棋や囲碁といったゲームから、コンピューターゲームまで、人工知能は人間に並ぶ、あるいは人間を超える能力を見せ始めています。その代表例として挙げられるのが、オープンエーアイファイブです。これは、オープンエーアイによって作られた、複雑な対戦型オンラインゲームである「ドータツー」をプレイするための電脳システムです。「ドータツー」は、刻一刻と変化する戦況、多くの登場人物、そして数え切れないほどの技や道具の組み合わせといった要素が複雑に絡み合い、非常に高度な戦略が求められます。オープンエーアイファイブは、この複雑なゲームに挑戦し、驚くべき成果を上げています。 オープンエーアイファイブの強みは、膨大な量の対戦データを学習することで、人間のプレイヤーでは思いつかないような戦略を編み出すことができる点にあります。具体的には、自己対戦を通じて、様々な戦況における最適な行動を学習し、その知識を元に、対戦相手の一歩先を行く行動を取ることができます。また、人間のプレイヤーのように感情に左右されることなく、常に冷静に状況を判断できる点も、オープンエーアイファイブの強みと言えるでしょう。 オープンエーアイファイブの登場は、人工知能が複雑な戦略ゲームにおいても人間に匹敵する、あるいは凌駕する能力を持つことを示す、重要な出来事でした。これは、ゲームの世界だけにとどまらず、様々な分野への応用が期待されています。例えば、経済予測や金融取引、交通管制といった複雑なシステムの最適化など、人工知能の活躍の場は今後ますます広がっていくと考えられます。人工知能の発展は、私たちの社会に大きな変化をもたらす可能性を秘めており、今後の動向に注目が集まります。
学習

人工知能の調整:性能向上への道

近頃、人工知能という言葉をよく耳にするようになりました。まるで魔法のような技術だと感じている方もいるかもしれません。身近なものでは、言葉を話す機械や絵を描く機械、自動で運転する車など、様々なところで人工知能が活躍しています。 人工知能は、人間と同じように学ぶことができるという特徴を持っています。しかし、人間の子供と同じように、教え方や学ぶ内容によって、その成長は大きく変わってきます。人工知能も、学習に使う情報や様々な設定によって、その能力が大きく左右されるのです。 例えば、犬と猫を見分ける人工知能を作るとしましょう。たくさんの犬と猫の写真を見せることで、人工知能は徐々に両者の違いを学んでいきます。しかし、もし見せる写真が犬ばかりだったらどうでしょうか。猫の特徴を十分に学ぶことができず、猫を見分けることが難しくなるでしょう。また、学習の進め方や、見分けるためのポイントをどのように設定するかによっても、人工知能の精度は大きく変わってきます。 そこで重要になってくるのが「調整」です。これは、人工知能の学習方法や設定を細かく調整することで、その性能を最大限に引き出す作業のことを指します。 この調整は、いわば料理でいう味付けのようなものです。同じ材料を使っても、味付けによって料理の味が大きく変わるように、人工知能も調整によってその性能が大きく向上します。どのような情報をどのように学習させるか、どのような基準で物事を判断させるかなど、様々な要素を調整することで、人工知能はより賢く、より正確に動作するようになります。 この文章では、人工知能における調整の大切さについて説明しました。これからの時代、人工知能はますます私たちの生活に深く関わってくるでしょう。人工知能をより良く活用するためにも、調整の重要性を理解しておくことは大切です。
AI活用

ディープブルーとは?IBMのチェスAIがカスパロフに勝った仕組みと歴史

知的な遊びである将棋に似た、西洋の盤上遊戯であるチェスは、その奥深い複雑さから、長い間、人工知能の研究にとって格好の題材であり続けました。人間の知的な力を示す象徴とも言えるこのゲームにおいて、計算機が人間に打ち勝つことは、人工知能研究における大きな目標の一つでした。 初期の頃のチェスを遊ぶための計算機仕掛けは、熟練した人間のプレイヤーには全く及ばないものでした。しかし、計算機の性能が向上し、より良い手順を組み立てるための工夫が進むにつれて、徐々にその実力を高めていきました。チェスという限られた盤と規則の中で、数え切れないほどの可能性を探り、最も良い手を見つけるという作業は、計算機の計算能力を最大限に引き出すまたとない機会となりました。 チェスという舞台で、知性を持つ機械を作るという挑戦において、重要な役割を担ったのが「深い青」と呼ばれる高性能の計算機でした。この「深い青」は、膨大な数の可能な手を分析し、対戦相手の手を予測することで、チェスの名人に匹敵するほどの強さを身につけていきました。そしてついに、1997年、当時の世界チャンピオンであるガルリ・カスパロフ氏との対戦で歴史的な勝利を収めました。この出来事は、人工知能研究における大きな前進であり、計算機が複雑な思考を必要とする分野においても人間を超える可能性を示した象徴的な出来事となりました。 この勝利は、人工知能がチェスという特定の領域で人間を超えたことを示すだけでなく、機械学習や探索アルゴリズムといった技術の進歩を促す大きな原動力となりました。そして、その後の様々な分野における人工知能の発展へと繋がる重要な一歩となったのです。
LLM

言語理解のベンチマーク:GLUE

近年、人工知能、とりわけ言葉を扱う技術は、驚くほどの進歩を見せています。新しい方法が次々と生み出され、その精度は日に日に向上しています。しかし、新しい方法の良し悪しを判断する共通の基準がないと、それぞれの性能を比べることは容易ではありません。例えるなら、様々な教科の試験結果を総合的に見て、生徒全体の学力を判断するのと同じです。特定の教科だけが得意でも、他の教科が苦手であれば、真の学力が高いとは言えないでしょう。人工知能の分野でも同様に、特定の仕事だけができても、他の仕事ができないと、真の理解力が高いとは言えません。 そこで、言葉の理解力を測る共通の試験として、「GLUE」が登場しました。これは、「General Language Understanding Evaluation」の略で、様々な種類の課題をまとめて評価することで、人工知能の総合的な理解力を測ることを目的としています。まるで運動会のように、様々な競技を用意し、総合得点で順位を決めるようなものです。走るのが得意な人工知能もいれば、計算が得意な人工知能もいるでしょう。GLUEは、そのような様々な能力をまとめて評価することで、より実用的な人工知能の開発を促進することを目指しています。具体的には、質問に答える、文章の続きを考える、文章の感情を読み取る、など、様々な種類の課題が出題されます。これらの課題を総合的に評価することで、特定の課題に特化した人工知能ではなく、様々な状況に対応できる、より柔軟で汎用的な人工知能の開発を後押ししています。
AIサービス

生成器:新たな創造力を支援する技術

近ごろの技術の進歩は目覚ましいものがあり、中でも人工知能(略称人工頭脳)の進歩は、私たちの暮らしや仕事に大きな変化をもたらしています。特に、様々な人工頭脳技術の中でも、「生成器」と呼ばれるものが、大きな注目を集めています。生成器とは、与えられた情報や指示をもとに、文章、絵、音声、計算機の指示書など、様々な形の新しい内容を生み出す人工頭脳の道具です。これまで人間が行ってきた創作活動を、人工頭脳が手伝ったり、あるいは代わりに行う可能性を秘めており、様々な分野での活用が期待されています。 この生成器は、基本的に大量のデータから学習を行うことで、新しい内容を生み出すことができます。例えば、文章生成器であれば、膨大な量の文章データを読み込むことで、言葉の使い方や文章の構成などを学びます。そして、新しい文章を作成する際には、学習した内容に基づいて、自然で意味の通る文章を作り上げます。同様に、絵を描く生成器であれば、大量の絵のデータから画風や構図などを学び、新しい絵を作り出すことができます。音声や計算機の指示書についても、同様の仕組みで生成されます。 こうした生成器は、既に様々な分野で活用され始めています。例えば、文章生成器は、ニュース記事の作成や小説の執筆、広告の文章作成などに利用されています。絵を描く生成器は、イラストの作成やデザイン、芸術作品の作成などに利用されています。また、音声生成器は、音声案内や吹き替え、音楽制作などに利用されています。計算機の指示書を生成する人工頭脳は、ソフトウェア開発の効率化に大きく貢献しています。 今後、生成器はますます進化し、より高度な内容を生み出すことができるようになると期待されています。また、活用の場もさらに広がり、私たちの暮らしや仕事にさらに大きな影響を与えることになるでしょう。本稿では、生成器の仕組みや種類、活用事例、そして今後の展望について、より詳しく説明していきます。
AI活用

アルファ碁ゼロ:自己学習で最強へ

囲碁とは、黒白の碁石を盤上に交互に置いて陣地を取り合う、古くから伝わる盤上遊戯です。その盤面は縦横19本の線で構成されており、考えられる打ち手の数は莫大で、宇宙にある原子よりも多いと言われています。そのため、囲碁は長い間、計算機にとっては攻略が難しい遊戯だと考えられてきました。しかし、近年の計算機技術、特に人工知能技術の進歩は目覚しく、ついに囲碁の世界でも計算機が人間を上回る日がやってきました。 その象徴的な出来事として、人工知能「アルファ碁」が世界トップクラスの棋士に勝利したことが挙げられます。アルファ碁は、膨大な量の棋譜データを学習することで強さを身につけました。いわば、過去の棋士たちの知恵を吸収することで、高いレベルの打ち手を可能にしたのです。しかし、今回ご紹介するのは、そのアルファ碁の後継機にあたる「アルファ碁ゼロ」です。アルファ碁ゼロは、過去の棋譜データを一切使わず、いわば白紙の状態から学習を始めました。まるで生まれたばかりの子供が、何も知らない状態から囲碁を学ぶかのようです。具体的には、「強化学習」と呼ばれる手法を用いて、自分自身と対局を繰り返すことで、徐々に強くなっていきました。 驚くべきことに、アルファ碁ゼロは、過去の棋譜データに頼らず、独学で囲碁を学ぶことで、アルファ碁をはるかに超える強さを獲得しました。これは、人工知能の学習方法における大きな革新であり、様々な分野への応用が期待されています。アルファ碁ゼロの登場は、人工知能が新たな段階へと進化したことを示す、画期的な出来事と言えるでしょう。今後、人工知能は、囲碁だけでなく、様々な分野で人間を支援する、強力な道具となることが期待されています。人工知能がどのように発展していくのか、これからも注目していく必要があるでしょう。
アルゴリズム

ダブルDQNで強化学習を強化

機械学習の中でも、強化学習は特に注目を集める学習方法の一つです。人間が教えなくても、機械が自ら試行錯誤を繰り返すことで、最適な行動を学ぶことができるという画期的な手法です。まるで赤ん坊が周りの世界と触れ合いながら、何が良くて何が悪いのかを学んでいくように、機械もまた、与えられた環境の中で、様々な行動を試しながら学習していきます。この学習の主人公となるのが「エージェント」と呼ばれるプログラムです。エージェントは、環境の中で行動を起こし、その結果として報酬を受け取ります。そして、より多くの報酬を得られる行動を学習し、その行動をとる確率を高めていきます。目標は、最終的に得られる報酬の合計値を最大にすることです。 この強化学習の分野において、近年大きな成果をあげた手法の一つに、「深い行動価値関数ネットワーク」、略して「深層価値関数ネットワーク」という手法があります。この手法は、人間の脳の神経回路網を模倣した「深層学習」と呼ばれる技術を使って、複雑な環境における学習を可能にしました。簡単に言うと、膨大な数の行動とその結果得られる報酬の関係性を、深層学習によって近似的に表現することで、エージェントは最適な行動を効率よく学習できるようになります。しかし、この画期的な手法にも弱点がありました。それは、行動の価値を本来よりも高く見積もってしまう傾向があることです。例えるなら、宝くじの当選確率を実際よりも高く見積もってしまうようなものです。この過大評価は、学習の効率を低下させる要因となります。 そこで、この過大評価問題を解決するために考案されたのが、「二重深層価値関数ネットワーク」です。この手法では、二つの深層価値関数ネットワークを用いることで、価値の推定精度を向上させ、より安定した学習を実現しています。まるで二人の専門家が別々に評価を行い、その結果を比較することで、より正確な価値を見極めるようなものです。
学習

機械学習時代の到来

近ごろの技術革新で、おびただしい量の資料が集まるようになりました。例えるなら、広大な図書館に書物が山積みになっている様子を想像してみてください。この莫大な資料の山は、まるで知恵の宝庫であり、人工知能の成長を大きく促す力となっています。人工知能は、この山のような資料を読み解き、そこに隠された知識や規則を見つけ出すことを学びます。まるで名探偵のように、複雑に絡み合った糸を一つ一つ解きほぐし、事件の真相に迫っていくのです。この学ぶ行為こそが、機械学習と呼ばれる技術の核心であり、人工知能を賢くする秘訣なのです。 以前の人工知能は、人間が作った規則に従って動いていました。これは、まるで設計図通りに動く機械のようなものでした。しかし、機械学習では、資料から規則を自ら作り出すことができます。まるで職人が、木材から美しい家具を創造するように、人工知能は資料から新たな知恵を生み出すのです。これにより、人間が細かく指示を出さなくても、人工知能は自ら考え、行動できるようになりました。複雑な問題や大量の資料を扱う場合でも、人間よりも効率的に、そして効果的な解決策を見つけ出せるようになったのです。 この莫大な資料と機械学習の組み合わせは、様々な分野で革新的な変化を起こしています。例えば、医療の分野では、病気の早期発見や新薬の開発に役立っています。また、製造業では、不良品の発生を抑えたり、生産効率を高めたりするために活用されています。さらに、私たちの日常生活においても、より便利なサービスや商品が生まれるきっかけとなっています。まるで魔法の杖のように、私たちの生活をより豊かに、そして便利に変えていく力を持っているのです。