学習

ノイズで広がる探索:ノイジーネットワーク

近年、様々な分野で技術革新が目覚ましいものとなっています。特に、機械学習という分野は目覚ましい発展を遂げており、その中でも強化学習は特に注目を集めています。強化学習とは、機械がまるで人間のように、試行錯誤を繰り返しながら学習していく仕組みのことです。例えば、ゲームで遊ぶことや、ロボットの動きを制御することなど、様々な場面でこの技術は活用されています。 この強化学習を行う上で、適切な行動を探索するということは非常に重要です。過去の経験から、一番良いと思われる行動を選ぶだけでなく、時には今まで試したことのない行動を試してみることで、もっと良い方法が見つかる可能性が高まります。しかし、既に知っている良い行動を選ぶことと、新しい行動を試すことのバランスをうまくとるのは、簡単なことではありません。 これまで使われてきた方法の一つに、イプシロン-グリーディー法というものがあります。この方法は、ある一定の確率でランダムに行動を選択することで、新しい行動を探索する機会を設けています。しかし、この方法では探索できる範囲が狭く、十分な探索ができないという問題点がありました。 そこで、より効果的に探索を行う方法として、ノイジーネットワークという新しい手法が登場しました。この手法は、行動を決めるネットワークにノイズと呼ばれる微小な変化を加えることで、より幅広い行動を探索することを可能にします。これにより、従来の方法では見つけることができなかった、より良い行動を見つけ出す可能性が高まります。つまり、ノイジーネットワークは、探索と活用のバランスをより効果的に調整し、強化学習の性能を向上させるための重要な技術と言えるでしょう。
アルゴリズム

Leaky ReLUとは?ReLUとの違いと利点を初心者向けに解説

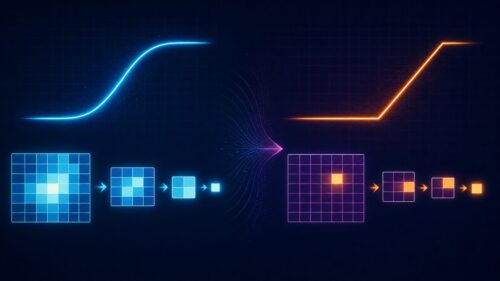
人間の脳を模倣した仕組みである人工知能技術の中でも、特に注目されているのがニューラルネットワークです。このニューラルネットワークは、人間の脳神経細胞の繋がりを数式で表現したもので、様々な情報を学習し、処理することができます。このニューラルネットワークの学習において、活性化関数は極めて重要な役割を担っています。 活性化関数は、入力された信号を加工して出力する役割を担います。具体的には、ニューラルネットワークの各層に入力された情報に、特定の計算を適用し、次の層へ出力する際に、信号の強さを調整します。もし活性化関数が存在しないと、入力信号は単純な足し算と掛け算だけで処理されることになります。これは、直線で表される計算と同じであり、表現力に限界が生じます。 例えば、曲線で描かれるような複雑な情報を学習しようとしても、直線で近似することしかできません。この制約は、ニューラルネットワークの性能を大幅に低下させてしまいます。そこで登場するのが活性化関数です。活性化関数は、入力信号を非線形に変換することで、ニューラルネットワークに複雑な表現力を与えます。 活性化関数の種類も様々です。代表的なものとしては、滑らかな曲線を描くシグモイド関数、階段状に変化するステップ関数、近年注目を集めているReLU関数などがあります。それぞれの活性化関数は異なる特性を持っており、扱うデータや目的に応じて使い分ける必要があります。適切な活性化関数を選択することで、ニューラルネットワークの学習効率を上げ、より高精度な予測を可能にします。このように活性化関数は、ニューラルネットワークが複雑な情報を学習するために必要不可欠な要素と言えるでしょう。
アルゴリズム

しのぎを削るAI:敵対的生成ネットワーク

二つの頭脳がしのぎを削る、敵対的生成ネットワーク、通称「ガン」は、深層学習という学びの型の中でも、ひときわ目を引く仕組みです。まるで二人の職人が、互いに技を競い合うように、二つの神経回路の網が切磋琢磨することで、驚くべき成果を生み出します。この仕組みの主役となるのは「生成器」と「識別器」です。 生成器は、絵描きや作曲家のように、新たな作品を生み出す創造者です。与えられた手本をもとに、絵や音声、文章など、様々な種類の創作物を作り出します。例えば、たくさんの猫の絵を見せることで、猫の特徴を学び、全く新しい猫の絵を描くことができるようになります。もちろん、最初は未熟な作品しか作れませんが、訓練を重ねることで、次第に本物と見紛うばかりの精巧な作品を生み出せるようになります。 一方、識別器は、鑑定士のように、作品の真贋を見極める役割を担います。生成器が作り出した作品を、本物と偽物に分類します。偽物と判断した場合は、その理由を生成器に伝えます。生成器は、識別器の指摘を元に、自分の作品をより本物らしく改良していきます。このように、識別器は、生成器の先生役として、生成器の成長を促す重要な役割を果たします。 この生成器と識別器のせめぎ合いこそが、「ガン」の肝です。生成器は、識別器を欺こうと、より精巧な偽物を作ることに励み、識別器は、生成器の巧妙な偽物を見破ろうと、鑑定眼を磨きます。この終わりのない競争によって、両者は互いに能力を高め合い、最終的には、人間が作ったものと区別がつかないほどの、高度な作品を生み出すことができるようになります。まるで二人の職人が、競い合うことで、互いの技を磨き上げるように、「ガン」は、二つの頭脳のせめぎ合いによって、驚くべき力を発揮するのです。
アルゴリズム

自己符号化器:データ圧縮と復元の仕組み

自己符号化器とは、機械学習の手法の一つで、入力された情報をそのまま出力するように学習させる仕組みです。まるで鏡のように、受け取った情報をそのまま映し出すように動作します。しかし、ただ情報を複製するだけでなく、その過程で情報の重要な特徴を捉え、情報を圧縮し、そして再び元の形に戻すことを行います。この圧縮と復元の過程を通して、情報の隠れた構造を学習していきます。 例として、手書きの数字の画像を考えてみましょう。この画像を自己符号化器に入力すると、同じ数字の画像が出力されるように学習させます。学習の初期段階では、出力される画像はぼやけていたり、元の数字とは少し異なるかもしれません。しかし、学習が進むにつれて、出力される画像は元の画像に近づいていきます。これは、自己符号化器が数字の重要な特徴、例えば線の太さや曲がり具合、数字全体の形状などを学習しているためです。 自己符号化器の内部には、「符号化器」と「復号化器」と呼ばれる二つの部分が存在します。符号化器は入力された情報をより少ない情報量で表現するように圧縮し、復号化器はその圧縮された情報から元の情報を復元します。この圧縮された情報のことを「潜在変数」と呼びます。潜在変数は、入力情報の重要な特徴を抽出したものと言えます。 一見単純な仕組みに見えますが、自己符号化器は様々な応用が可能です。例えば、画像のノイズ除去では、ノイズの多い画像を入力として、ノイズのない綺麗な画像を出力するように学習させることで、ノイズ除去を実現できます。また、異常検知では、正常なデータのみで自己符号化器を学習させます。学習後、異常なデータを入力すると、自己符号化器はうまく復元できず、出力と入力の差が大きくなります。この差を利用することで、異常なデータを見つけることができます。さらに、次元削減にも利用できます。高次元のデータの潜在変数を抽出することで、データの次元を削減し、データ分析を容易にすることができます。このように、自己符号化器は様々な分野で活用されている、大変有用な技術です。
アルゴリズム

ノーフリーランチ定理:万能解法は存在しない

「労せずして成果は得られない」、これは「無料の昼食なんてない」という意味の「ノーフリーランチ定理」が示す教訓です。この定理は、最適化問題、例えば、最も良い答えを見つけ出す問題において、どんな方法も万能ではないということを主張します。あらゆる問題に常に一番良い結果を出す魔法のような方法は存在しない、というわけです。 具体的に説明すると、色々な方法を試した時の平均的な成果を考えると、どの方法も同じになります。ある方法が特定の問題で良い成果を出したとしても、それは他の問題でも良い成果を出すことを保証しません。むしろ、ある特定の問題に特化して調整された方法は、他の問題ではうまくいかないことが多いのです。例えば、りんごの皮むきに特化した道具は、みかんの皮むきには向かないのと似ています。 この定理は、機械学習の分野で特に重要です。機械学習とは、コンピュータに大量のデータを与えて、そこから規則性やパターンを学習させ、将来の予測や判断に役立てる技術のことです。ノーフリーランチ定理は、どんなデータにも常に一番良い結果を出す単一の機械学習の型はないということを意味します。ある型が特定のデータで素晴らしい成果をあげたとしても、それは他のデータでも同じように素晴らしい成果をあげられるとは限りません。あるデータに特化して学習させた型は、他のデータではうまくいかない可能性が高いのです。これは、型が特定のデータの特徴に過剰に適応してしまうためと考えられます。 そのため、あらゆる問題に使える万能の型を作るのではなく、個々の問題に特化した型を作ることが重要になります。問題に合わせて適切な型を選び、調整することで、より良い結果を得ることができるのです。これはまるで、料理によって包丁を使い分けるように、データに合わせて適切な道具を選ぶ必要があるということです。
アルゴリズム

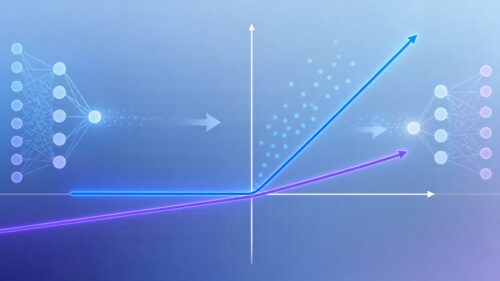
活性化関数:Leaky ReLU

人間の頭脳の働きを真似た仕組みである人工知能の神経網は、神経細胞に似たたくさんの小さな部品(節点)が層状に繋がってできています。それぞれの節点は、入力された信号を受け取って、それを別の形に変換して出力します。この変換作業を担うのが活性化関数です。活性化関数の役割は、神経網に複雑な模様を学習する能力を与えることです。 もし活性化関数がなければ、神経網は入力された信号を単純な計算で変換するだけで、複雑な模様を学習することはできません。例えば、簡単な足し算や引き算のような計算だけでは、写真に写っているのが猫か犬かを判断することは難しいでしょう。活性化関数は、この単純な計算に「ひと工夫」を加えることで、神経網が複雑な問題を解けるようにするのです。この「ひと工夫」とは、非線形と呼ばれる性質のことです。 非線形とは、入力の変化量と出力の変化量が比例しないことを意味します。例えば、単純な計算では、入力が2倍になれば出力も2倍になります。しかし、活性化関数を用いると、入力が2倍になっても出力は2倍になるとは限りません。この性質のおかげで、神経網は曲線や複雑な形を表現できるようになり、写真の中の猫や犬を見分けるような複雑な課題にも対応できるようになります。 例えるなら、活性化関数は、画家に様々な色を与えて、より複雑で豊かな絵を描けるようにするパレットのようなものです。もし画家が黒と白の2色しか使えなければ、表現できる絵には限界があります。しかし、赤や青、黄色など様々な色を使うことで、より鮮やかで複雑な絵を描くことができます。活性化関数も同様に、神経網に非線形性という「色」を与えることで、複雑な問題を解く能力を与えているのです。活性化関数なしでは、神経網は本来の力を発揮できません。
セキュリティ

人工知能への敵対的攻撃

近頃、様々な場所で人工知能という言葉を見聞きするようになりました。自動で車を走らせる技術や、病気を診断する技術、人の顔を識別する技術など、私たちの暮らしにも深く入り込みつつあります。こうした技術は、膨大な量の情報を元に学習し、様々な規則性を見つけることで、物事を判断したり予測したりしています。大変便利な反面、安全面で不安な点も潜んでいます。人工知能を狙った攻撃もその一つです。 この攻撃は、人工知能の弱点を探し出し、間違った動きや判断をさせるというものです。人工知能は、学んだ情報から規則性を見つけて判断しますが、この学習の過程や判断の過程を巧みに操ることで、人工知能の能力を低下させたり、本来とは異なる動作をさせたりすることが可能です。例えば、自動運転の車に搭載された人工知能が、道路標識を誤って認識し事故につながることも考えられます。また、人の顔を識別するシステムが悪意ある人物のアクセスを許可してしまう可能性も懸念されています。 この攻撃への対策はいくつか考えられます。一つは、人工知能の学習データに、攻撃を想定した様々な変化を加えておくことです。これにより、予期せぬ事態にも対応できる、より頑丈な人工知能を作ることができます。また、人工知能が出した判断結果を、別の方法で確認する仕組みも有効です。複数の方法で確認することで、誤りの発生を防ぐことができます。人工知能は私たちの社会を大きく変える力を持っています。その恩恵を安全に受けるためには、こうした攻撃に対する備えをしっかりと行うことが重要です。今後ますます発展していく人工知能と共に、安全対策の技術も進化していく必要があるでしょう。
AIサービス

誰でも手軽に使えるAI:ノーコード

近年、人工知能という技術は素晴らしい進歩を遂げてきました。しかし、これまでその技術を使うには、特別な知識や複雑な手順が必要でした。そのため、人工知能の恩恵を受けられるのは、限られた技術者や大きな会社だけだったのです。まるで高い山の頂上にある果実のように、誰もが簡単に手に取れるものではありませんでした。 ところが最近、「文字を使わない」という意味を持つ革新的な技術が現れ、状況は大きく変わり始めました。この技術は、組み立ておもちゃのように、特別な知識がなくても誰でも簡単に道具や仕組みを作れるようにしてくれます。まるで魔法の杖のように、複雑な手順を踏まずに、誰もが人工知能の力を使えるようになったのです。 この技術のおかげで、人工知能は専門家だけのものから、より多くの人々が利用できるものへと変わりました。例えば、これまで難しかったデータ分析や予測も、簡単にできるようになりました。お店の店主が商品の売れ行きを予測したり、農家の人が収穫量を予想したり、様々な場面で役立てることができるのです。人工知能は、まるで身近な道具のように、私たちの生活を支える存在になりつつあるのです。 さらに、この技術によって、新しい発想や工夫が生まれる可能性も広がっています。これまで人工知能に触れる機会がなかった人々が、気軽に試行錯誤できるようになったことで、今まで想像もできなかったような使い方や新しい発見が生まれるかもしれません。まるで誰も知らない宝物を探すように、様々な分野で人工知能を活用した新しい挑戦が始まっているのです。人工知能は、私たちの未来をより豊かで便利なものにしてくれる、大きな可能性を秘めていると言えるでしょう。
学習

網羅されたデータの重要性

人工知能の学習には、網羅的な情報を持つことが極めて大切です。では、網羅的な情報とはどのようなものでしょうか。それは、ある事柄全体をくまなく捉え、あらゆる側面を表現できる情報のことです。 例えば、色々な種類の犬を見分ける人工知能を作るとします。このとき、ただ犬の絵を集めるだけでは十分ではありません。色々な種類の犬を、色々な角度から捉えた情報が必要です。例えば、犬の種類はもちろん、年齢、毛の色、体の向き、周りの景色など、できる限り多くの種類の絵を集めることで、人工知能はより正確に犬の種類を見分けられるようになります。 もし、特定の種類の犬の絵だけで学習させた場合、その犬は見分けられても、他の種類の犬は見分けられない可能性が高くなります。これは、服の見分け方を知らない人に、赤い服だけを見せて「これは服です」と教えているようなものです。この人は、青い服や緑の服を見せられても、それが服だと分からないかもしれません。 このように、人工知能の精度は、学習に使う情報の網羅性に大きく左右されます。偏った情報で学習させた人工知能は、現実世界の問題を解決するには力不足で、思わぬ間違いを起こす心配もあります。家の鍵を色々な種類の鍵で試して開ける練習をした人と、家の鍵だけで練習した人では、初めて見る鍵を開ける能力に差が出るのと同じです。 ですから、人工知能に学習させる情報の収集段階から、網羅性を意識し、多様性のある情報を集めることが欠かせません。色々な経験を積んだ人のほうが、新しい問題にうまく対応できるのと同じように、人工知能も多様な情報を学習することで、より賢く、より役に立つものになるのです。
アルゴリズム

LeNetとは?CNNの仕組み・構造・現代モデルとの違いを解説

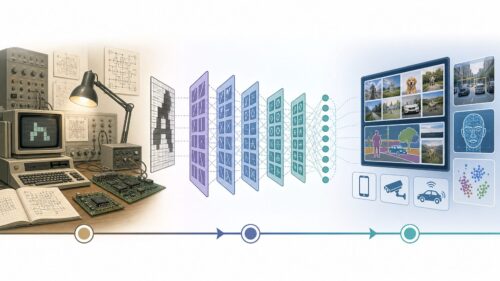
1990年代、機械による画像の認識はまだ始まったばかりの頃でした。例えば、手書きの文字を認識させるだけでも、とても複雑な計算のやり方と、たくさんの計算をするための機械の力が必要でした。そのような時代に、1998年、エー・ティー・アンド・ティー研究所の研究者であるヤン・ルカン氏を中心とした研究の集まりが、それまでのやり方とは全く異なる、新しい画期的な方法を考え出しました。それが、畳み込みニューラルネットワーク(略してシーエヌエヌ)という技術を使った「ルネット」というものです。ルネットは、それまでの方法よりもはるかに高い精度で手書き文字を認識することができ、画像認識の世界に大きな変化をもたらしました。これは、その後の深層学習という技術が大きく発展する土台となる、とても重要な出来事でした。ルネットが登場する前は、画像を小さな点の集まりとして扱うのではなく、形や模様などの特徴を取り出して認識する方法が主流でした。しかし、この方法では、特徴を見つけるための設計に専門的な知識が必要で、色々な画像に使える汎用性がないという問題がありました。ルネットは、畳み込み層という仕組みを使うことで、画像から自動的に特徴を学ぶことができるので、従来の方法よりも高い精度と、色々な画像に使える汎用性を実現しました。さらに、ルネットは計算量も少なく、当時の計算機でも比較的簡単に動かすことができました。これは、ルネットを実際に使えるものにする上で、重要な点でした。
アルゴリズム

調和平均とは?意味・仕組み・活用例をわかりやすく解説

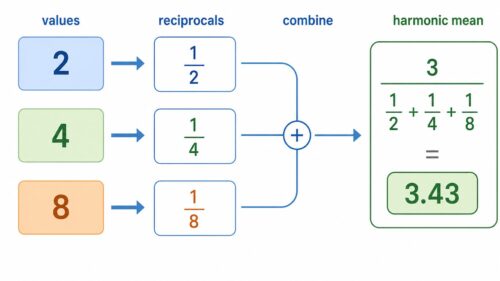
調和平均とは、数値群の逆数の算術平均の逆数で表される平均値のことです。 よく知られている算術平均とは異なり、数値の逆数に注目することで、数値のばらつき具合を別の角度から捉えることができます。 具体的に言うと、小さい数値の影響がより強く反映されるため、一部の極端に小さい数値が平均値全体を大きく引き下げることを防ぐことができます。 これは、例えば速度や割合といった値を扱う際に特に役立ちます。これらの値は、分母が小さくなると全体の値が大きくなる性質を持つため、算術平均では適切な平均値を得られないことがあります。調和平均を用いることで、このような状況でもより適切な平均値を計算することができます。 具体例として、異なる速度で往復した場合の平均速度を計算してみましょう。行きと帰りの距離が同じであれば、単純に二つの速度を足して2で割る算術平均では正しい平均速度は得られません。 例えば、片道10キロの道のりを、行きは時速20キロ、帰りは時速10キロで移動した場合を考えます。行きにかかる時間は0.5時間、帰りにかかる時間は1時間です。合計20キロの道のりを1.5時間で移動したので、平均速度は時速13.33キロになります。しかし、算術平均で計算すると、(20+10)÷2=15となり、時速15キロという誤った答えが導き出されます。 調和平均を用いると、2÷(1/20+1/10)=13.33となり、正しい平均速度を計算することができます。 このように、調和平均は特定の状況下で非常に役立つのです。
学習

人工知能と知識の宝庫:コーパス

「言葉の集まり」であるコーパスとは、膨大な量の文章データを集めて、整理して保管したものです。まるで巨大な図書館のように、様々な種類の文章が体系的に整理され、いつでも利用できるように準備されています。この言葉の図書館は、人工知能にとって、人間が使う言葉を学ぶための重要な教材となります。 人工知能は、このコーパスを利用することで、人間の言葉遣いの特徴やパターンを学習します。例えば、「こんにちは」や「こんばんは」といった挨拶の言葉から、複雑な言い回しや表現方法まで、あらゆる言葉をコーパスから学び取ります。コーパスに含まれる文章の種類が多いほど、人工知能はより多様な表現を学ぶことができ、より自然で人間らしい言葉遣いを習得できます。 コーパスには、新聞の記事や小説、ブログの記事、会員制交流サイトへの投稿など、様々な種類の文章が含まれています。これらの文章は、私たちの日常生活で使われる言葉から、専門的な分野で使われる言葉まで、多岐に渡ります。コーパスに含まれるデータが多ければ多いほど、人工知能はより多くの言葉を学習し、より高度な言語処理能力を身につけることができます。 コーパスのサイズは、人工知能の学習効果に大きな影響を与えます。コーパスが大きければ大きいほど、人工知能はより多くの知識を吸収し、より複雑な言語現象を理解できるようになります。まるで人間の脳のように、多くの情報に触れることで、より賢く成長していくのです。人工知能にとって、コーパスはまさに知識の宝庫であり、人間の言葉を理解するための重要な鍵と言えるでしょう。
学習

サンプリングバイアスとは?意味・原因・対策を初心者向けに解説

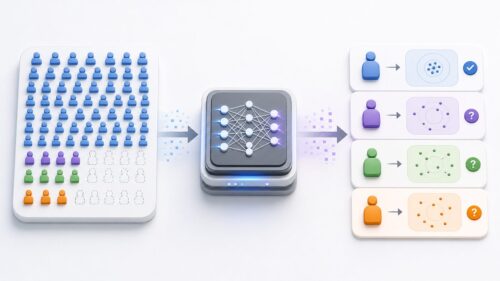
調査や研究を行う際、限られた時間や費用の中で対象全体を調べることは難しいものです。そのため、対象全体(母集団)の中から一部(標本)を選び出して調べ、その結果から母集団全体の性質を推測することがよく行われます。しかし、この標本の選び方に偏りがあると、母集団の真の姿を正しく捉えることができず、誤った結論に至ってしまうことがあります。これをサンプリングバイアスといいます。 例えば、ある街の住民全体の意見を聞きたいとします。もし、昼間の街頭インタビューで意見を集めた場合、主に日中に街にいる人々の意見しか集まりません。主婦や学生、高齢者など、日中に外出する機会が少ない人たちの意見は反映されにくくなってしまいます。このように、特定の属性の人々が標本に過剰に含まれたり、逆に過少に含まれたりする状態がサンプリングバイアスです。 サンプリングバイアスが生じる原因は様々です。前述の例のように、調査を行う時間や場所によって特定の層が標本に偏る便宜的サンプリングは、よくある原因の一つです。また、インターネット調査では、インターネットを利用できない人や利用する機会が少ない人は標本から除外されてしまうため、自己選択バイアスと呼ばれるバイアスが生じます。さらに、調査協力への同意を得やすい人に偏った回答が集まりやすい非回答バイアスも、結果を歪める要因となります。 サンプリングバイアスを避けるためには、母集団を代表するような標本を抽出する必要があります。例えば、無作為抽出法を用いることで、母集団のどの成員も等しい確率で標本に選ばれるように工夫することができます。また、様々な属性の人をバランスよく含むように標本を設計する層化抽出法なども有効な手法です。これらの手法を用いることで、より正確なデータに基づいた分析を行い、信頼性の高い結論を導き出すことが可能となります。
アルゴリズム

ネオコグニトロンとは?画像認識とCNNの原点をわかりやすく解説

近年、人工知能技術の進歩は目覚ましく、特に画像を認識する技術は目を見張るものがあります。これまで、機械に人間と同じように画像を見せ、内容を理解させることは長年の夢でした。そして、この夢の実現に大きく貢献したのが、日本の福島邦彦博士が考え出したネオコグニトロンです。 1980年に発表されたネオコグニトロンは、人間の脳の視覚をつかさどる部分の仕組みを真似て作られました。この仕組みにより、文字や図形など、様々な種類の画像を認識できるようになりました。これは、現在の画像認識技術の土台と言えるでしょう。当時の計算機の性能は限られていましたが、福島博士の画期的な考えは、その後の人工知能研究に大きな影響を与えました。 具体的には、ネオコグニトロンは、階層構造を持つ神経回路網を採用しています。これは、単純な特徴から複雑な特徴へと段階的に情報を処理する仕組みです。例えば、画像に「丸」や「線」といった単純な形が含まれていると、ネオコグニトロンはまずこれらの特徴を捉えます。そして、これらの特徴を組み合わせることで、「円」や「三角形」といったより複雑な形を認識し、最終的には「顔」や「車」といった高度な概念を理解します。 現在の画像認識技術の中心となっている畳み込みニューラルネットワーク(CNN)は、このネオコグニトロンの考え方を基に発展したものです。つまり、ネオコグニトロンはCNNの起源とも言える重要な存在なのです。福島博士の先見の明は、現代の人工知能技術の発展に欠かせないものだったと言えるでしょう。
AI活用

ランサーズ、生成AI専門チーム始動!

2023年7月、仕事や作業を仲介する会社であるランサーズは、「ランサーズ大規模言語模型研究室」という専門の部署を新しく立ち上げました。この研究室は、最近急速に発展し、多くの人々の注目を集めている、文章や画像などを作り出す人工知能と、それを支える大規模言語模型の研究開発に集中して取り組む組織です。 文章や画像、音声、そして計算機の指示書など、様々なものを作り出すことができる人工知能技術は、私たちの社会を大きく変える可能性を秘めています。ランサーズ大規模言語模型研究室は、この革新的な技術を最大限に活用することで、社会にとって新しい価値を生み出すことを目標としています。人工知能の研究開発は、これからの技術革新を引っ張っていく重要な役割を担っており、ランサーズ大規模言語模型研究室は、その最前線に立って、困難な課題にも挑戦し続けます。 この研究室の構成員は、ランサーズ社内外の、人工知能の専門家で構成されており、最先端の知識と技術を駆使して研究開発に励んでいます。今後、人工知能技術を活用した新しい仕事や作業の仲介方法、そして様々な課題を解決するための手段を提供することで、社会の発展に貢献していく予定です。 この研究室設立の背景には、人工知能技術の急速な進歩と、その技術を実際に社会で役立てたいという要望の高まりがあります。ランサーズは、この流れをいち早く感じ取り、専門の部署を立ち上げることで、人工知能技術の研究開発を速め、社会への貢献を目指します。人工知能技術が持つ大きな可能性を信じ、誰もがその恩恵を受けられる未来の実現に向けて、ランサーズ大規模言語模型研究室は、たゆまぬ努力を続けていきます。
その他

著作物とは?定義と注意点

著作物とは、人の考えや気持ちを独創的に表したもののことです。小説や詩、音楽、絵画、彫刻、写真、映画、電算機向け手順書など、様々な形で表されます。大切なのは、ただの思いつきや事実ではなく、それらを表す具体的な形が著作物として守られるということです。 例えば、物語のあらすじだけでは著作物ではありません。それを文章にした小説は著作物になります。商品の働きや性能の説明だけでは著作物ではありませんが、説明書きや商品案内に独創的な表現があれば、著作物と認められることがあります。料理のレシピを例に挙げると、材料や手順を箇条書きにしただけでは著作物ではありません。しかし、調理方法やコツ、料理にまつわるエピソードなどを織り交ぜて文章にすれば、創作性が認められて著作物と判断される可能性が高まります。 このように、著作物かどうかは表現の独自性に重きを置いて判断されます。同じ題材を扱っていても、作者によって表現方法が異なれば、それぞれが別の著作物として認められます。例えば、桜を題材にした歌でも、歌詞やメロディーが違えば、それぞれが独立した著作物です。 また、著作物には作者の権利(著作権)が認められます。著作権は、作者だけが持つ特別な権利で、他の人が勝手に自分の作品を複製したり、改変したり、公表したりすることを防ぐことができます。この権利は、作者の創作活動を保護し、文化の発展を促すために重要な役割を果たしています。そのため、他人の著作物を利用する場合は、著作権法に則って適切な手続きを行う必要があります。例えば、許可を得ずに他人の著作物を複製することは著作権侵害にあたります。 著作物とそうでないものの境界線は、常に明確とは限りません。新しい技術や表現方法が登場するたびに、著作物の定義も見直されることがあります。しかし、基本となるのは、人の考えや気持ちを形にしたものであり、それがどれほど独創的であるかという点です。この点を理解することで、著作物に対する理解を深めることができます。
AI活用

ビッグデータ:可能性と課題

近頃よく耳にする「膨大な情報の宝庫」とは、一体どのようなものなのでしょうか。それは、従来の情報の管理方法では扱うのが難しいほど巨大なデータの集まりのことを指します。そして、この膨大なデータこそが、現代社会における「宝の山」と表現される所以なのです。 インターネットの普及や、携帯電話、そして様々なものを計測する技術の発達に伴い、実に多くの情報が数字の姿に変換され、記録されるようになりました。例えば、人と人が繋がる場所への書き込みや、インターネット上で商品を購入した履歴、どこにいたかを示す位置情報、天気に関する数値など、実に様々な種類のデータが毎日大量に作られています。これこそが「膨大な情報の宝庫」の正体であり、適切な方法で分析すれば、社会の様々な場所で革新的な変化を起こす可能性を秘めているのです。 例えば、商業の世界では、顧客がどのような商品を買うのかを予測したり、新しい商品の開発に役立てたり、提供するサービスの質を向上させたりすることが可能になります。医療の分野では、病気を早期に発見したり、治療方法の開発に役立てたりすることができます。さらに、道路の混雑を緩和したり、災害に備える対策を考えたりと、社会全体の仕組みを良くすることにも役立つと期待されています。 この膨大なデータは、単なる数字の羅列ではなく、社会の様々な問題を解決するための鍵となる可能性を秘めているのです。どのように活用するかが、今後の社会を大きく左右すると言えるでしょう。宝の山から真の宝を掘り出すためには、データ分析の技術を高め、その価値を最大限に引き出す工夫が欠かせません。そして、個人情報の保護など、適切な利用についても真剣に考える必要があるでしょう。
AI活用

他企業との連携で成功するAIビジネス

近頃、人工知能(じんこうちのう)技術は目覚ましい発展を遂げ、様々な産業分野で革新的な変化を起こしています。ものづくり、医療、金融、小売など、あらゆる分野で人工知能の活用が進み、私たちの生活にも大きな影響を与えています。しかし、人工知能技術を事業で役立てるには、高い専門知識と多額の開発費用、そして幅広い事業展開のための多くの資源が必要となります。 一企業だけでこれらの全てをまかなうことは大変難しく、他企業や他業種との連携が重要な作戦となります。連携には、大きく分けて三つの目的があります。第一に、高品質な人工知能サービスや商品の開発です。各企業が持つ技術や知識、経験、販売網などを共有することで、より良い人工知能サービスや商品を効率的に開発することができます。第二に、市場投入までの時間短縮です。連携により、開発期間を短縮し、いち早く市場に商品を投入することが可能になります。これは、競争の激しい現代社会において非常に重要な要素です。第三に、リスク分散です。人工知能技術の開発には、技術的な課題や市場の不確実性など、様々なリスクが伴います。連携することで、これらのリスクを分散し、事業の安定性を高めることができます。 例えば、ある企業が優れた人工知能技術を持っているものの、販売網が限られているとします。この企業が、広い販売網を持つ別の企業と連携することで、より多くの人に商品を届けることができるようになります。また、人工知能技術の開発に多額の費用がかかる場合、複数の企業で費用を分担することで、それぞれの企業の負担を軽減することができます。このように、連携は、各企業の強みを活かし、弱みを補完することで、より大きな成果を生み出すことができます。人工知能技術の発展と普及のためには、企業間の連携がますます重要になっていくでしょう。
アルゴリズム

ニューラルネットワーク:人工知能の基盤

人間の頭脳は、膨大な数の神経細胞が複雑に繋がり、電気信号のやり取りによって情報を処理しています。この驚くべき仕組みを計算機上で再現しようと生まれたのが、神経回路網を模した計算モデルです。これは、人工的に作った神経細胞を繋げて網の目のような構造を作り、情報を処理させる仕組みです。 この人工の神経細胞は、本物の神経細胞のように、入力された信号を受け取り、処理をして出力します。それぞれの繋がりに「重さ」が割り当てられており、入力信号はこの重みを掛けられて重要度が調整されます。重みを掛けられた信号は全て足し合わされ、さらに活性化関数という特別な処理によって最終的な出力信号が作られます。この一連の処理は、まるで人間の神経細胞が電気信号を受け取り、処理し、次の神経細胞に伝える過程を模倣しているかのようです。 この人工神経細胞を複数繋げることで、より複雑な情報処理が可能になります。これは、人間の脳が多くの神経細胞の繋がりによって高度な思考を実現しているのと同じです。層状に神経細胞を配置し、前の層の出力が次の層の入力となるように繋げることで、多層構造ができます。まるで建物の階層のように、各層で異なる処理を行い、最終的に目的とする結果を得ることができます。 この神経回路網モデルの重要な点は、学習能力を持っていることです。学習とは、入力データと正解データから、適切な重みを自動的に調整する過程です。大量のデータを使って学習させることで、まるで人間の脳が経験を通して学習するように、計算機も精度を高めていくことができます。つまり、このモデルは、人間の脳の学習メカニズムを模倣することで、計算機に学習能力を与えていると言えるでしょう。
その他

中国語の部屋:知能とは何か?

「中国語の部屋」と呼ばれる思考の試みは、アメリカの思想家ジョン・サールが考え出したものです。この試みは、機械がどのように言葉を扱うかを深く考えるために行われました。 想像してみてください。ある部屋の中に、中国語が全く分からない人がいます。この人には、中国語で書かれた質問が紙で渡されます。部屋の中には、分厚い手引書があります。この手引書には、中国語の質問に対して、適切な答えを返すための、とても細かい手順が書かれています。この人は、手引書に書かれた通りに記号を並べ替え、中国語の答えを作り出します。 部屋の外には、中国語の分かる人がいます。この人から見ると、部屋の中の人は中国語を理解しているように見えます。まるで、中国語で書かれた質問を読んで、中国語で答えを書いているように見えるのです。しかし、実際には、部屋の中の人は中国語を全く理解していません。ただ、手引書に書かれた手順に従って、記号を並べ替えているだけです。 この思考の試みは、計算機がまるで人間のように言葉を理解しているように見えても、本当は記号を処理しているだけで、真の理解や意識を持っていないかもしれないということを示しています。計算機は、大量の情報を処理し、複雑な計算を行うことができます。しかし、それはあくまでも手順に従って記号を操作しているだけで、言葉の意味を理解しているわけではありません。 例えば、翻訳の機械を考えてみましょう。翻訳の機械は、膨大な量の文章データを使って学習し、異なる言葉の間の関係を把握します。そして、ある言葉を入力すると、別の言葉で出力します。これは、まるで言葉を理解しているかのように見えます。しかし、実際には、翻訳の機械は言葉の意味を理解しているのではなく、言葉の使われ方のパターンを学習しているだけです。つまり、「中国語の部屋」の例のように、記号を操作しているに過ぎないのです。 この思考の試みは、人工知能の研究において、非常に重要な示唆を与えています。人工知能が真に言葉を理解するためには、記号の操作だけでなく、言葉の意味や背景にある文化、文脈などを理解する必要があると言えるでしょう。
その他

不正競争防止法:公正な競争を守る盾

不正競争防止法は、健全な市場を維持し、事業者同士が正しく競争できるようにするために作られた大切な法律です。この法律は、他社の努力で作り上げた営業上の価値を不当に奪ったり、消費者を騙したりする行為を規制することで、公正な競争ができる環境を守ることを目的としています。 不正競争行為は、市場の秩序を乱し、新しい商品やサービスの開発を邪魔するだけでなく、最終的には消費者の利益を損なうことになります。例えば、他社が長年かけて開発した技術を盗用して、類似品を安く販売すれば、開発した会社は損失を被り、新しい技術の開発意欲を失ってしまうかもしれません。また、消費者は偽物をつかまされたり、品質の悪い商品を買わされたりする可能性があります。そのため、この法律は、事業者だけでなく、消費者にとっても重要な役割を担っています。 不正競争防止法には、様々な種類の不正競争行為が定められています。例えば、営業秘密の不正取得や使用、著名な商品の模倣、虚偽の表示による顧客の誘引、他社の信用を落とす行為などが挙げられます。これらの行為は、いずれも公正な競争を阻害し、市場の秩序を乱すものです。 時代とともに、経済の状況や技術は変化していきます。そのため、不正競争防止法も、それらの変化に対応するために何度も改正されてきました。近年では、インターネットの普及に伴い、ネット上での誹謗中傷や偽サイトによる詐欺など、新たな不正競争行為が増えています。不正競争防止法は、このような新しいタイプの不正競争行為にも対応できるように改正され、インターネット上での公正な競争の確保にも力を注いでいます。不正競争防止法を理解することは、健全な市場経済を支え、消費者を守る上で、大変重要なことと言えるでしょう。
AI活用

ことばを科学する:統計的自然言語処理の世界

私たちは日々、言葉を使って考えを伝え、情報を受け取っています。この言葉を、機械である計算機にも理解させ、扱えるようにしようとする試みが自然言語処理です。そして、統計的な手法を使って言葉を扱うのが統計的自然言語処理です。 人間が言葉を扱うときには、無意識のうちに多くのことを考えています。例えば、「読書」という言葉を見れば、私たちはすぐに「本を読むこと」だと理解できます。これは、私たちがこれまでの人生で「読書」という言葉とその意味、使われ方を何度も経験してきたからです。統計的自然言語処理では、この経験を大量の文章データで再現します。たくさんの文章データを集め、そこに「読書」という言葉が何回出てきているか、どんな言葉と一緒に使われているかを調べます。例えば、「読書が好き」「読書の時間」「読書感想文」といった言葉の組み合わせがよく出てくるとします。すると、計算機は「読書」という言葉が「本を読む」ことに関係する言葉だと理解し始めます。 このように、言葉の出現回数や一緒に使われる言葉の関係性といった情報を統計的に解析することで、計算機に言葉の意味や文脈を理解させるのです。どの言葉が次に出てきやすいかを統計的に調べることで、まるで人間が話しているかのような自然な文章を計算機が作れるようになることもあります。また、ある単語が、肯定的な言葉と一緒に使われることが多いのか、否定的な言葉と一緒に使われることが多いのかを分析することで、その単語が持つ感情的な意味合いを読み取ることもできます。 これは、大量のデータから隠れた法則性を見つける統計学と、人間の意思疎通の土台となる言語学とが組み合わさった学問分野と言えます。この研究が進めば、計算機がまるで人間のように言葉を読み書きし、私たちと自然に会話する日が来るかもしれません。
アルゴリズム

LSTM:長期記憶を掴むニューラルネットワーク

人間の脳は、必要な情報を長期に渡って記憶することができます。この複雑な仕組みを模倣するように開発されたのが、長・短期記憶(エル・エス・ティー・エム)と呼ばれる技術です。これは、時間の流れに沿ったデータの処理を得意とする、人工知能における学習方法の一つです。 従来の技術では、過去の情報を扱う際に、時間が経つにつれて情報が薄れていくという問題がありました。例えるなら、遠くの出来事をぼんやりとしか思い出せないようなものです。この問題を「勾配消失問題」と呼びます。エル・エス・ティー・エムはこの問題を解決するために、特別な記憶の仕組みを備えています。 この記憶の仕組みは、大きく分けて三つの部分から成り立っています。一つ目は情報を蓄える「セル」です。これは、まるで情報を書き留めておくノートのような役割を果たします。二つ目は情報の入り口を管理する「入力ゲート」です。これは、どの情報をセルに書き込むべきかを判断します。三つ目は情報の出口を管理する「出力ゲート」です。これは、どの情報をセルから読み出すべきかを判断します。さらに、セルに記憶された情報を消去する役割を持つ「忘却ゲート」も存在します。 これらの三つのゲートが連携することで、必要な情報を適切なタイミングで覚えたり、忘れさせたりすることが可能になります。まるで人間の脳のように、重要な情報を長く記憶しておき、不要な情報は忘れてしまうことができるのです。この仕組みのおかげで、エル・エス・ティー・エムは、従来の技術よりも長い期間にわたる情報の繋がりを学習することができます。例えば、文章の全体的な意味を理解したり、過去の出来事の影響を考慮した予測を行ったりすることが可能になります。
AI活用

知識経営とは?ナレッジマネジメントの意味・活用例・AIとの関係を解説

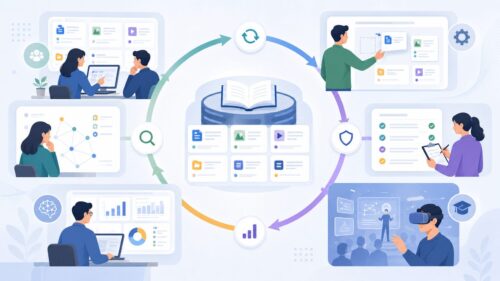
知識経営とは、会社の中にある様々な知識をうまく活用して、会社をより良くしていくための方法です。社員一人ひとりが持っている経験や知識、会社全体で集めたデータや情報などを、整理して集め、誰でも使えるようにすることで、会社全体の力を高めることを目指します。 例えば、ある社員が長年の経験から得た仕事のやり方やコツを、他の社員も使えるようにすることで、仕事の効率が上がり、質も向上します。また、会社全体で顧客情報や市場動向などの情報を共有することで、新しい商品やサービスを生み出すきっかけにもなります。 知識経営で大切なのは、個人の頭の中にある知識を、誰にでもわかる形にすることです。ベテラン社員だけが知っているやり方では、その人がいなくなると仕事が進まなくなってしまいます。そのため、経験に基づいたノウハウを文書化したり、マニュアルを作成したりすることで、誰でも同じように仕事ができるようにする必要があります。このように、個人の知識を会社の共有財産にすることで、特定の担当者に仕事が集中することを防ぎ、スムーズな引継ぎや人材育成にも繋がります。 また、集めた知識を整理してデータベース化し、必要な時に誰でも簡単にアクセスできるようにすることも重要です。情報が散らばっていると、必要な情報を探すのに時間がかかり、業務の効率が落ちてしまいます。 現代のように変化の激しい時代では、新しい情報や技術を常に取り入れ、学び続けることが企業の成長には欠かせません。知識経営は、会社の貴重な財産である知識を最大限に活用し、変化に柔軟に対応していくための、重要な取り組みと言えるでしょう。