
HyDEとは?仮想文書を手掛かりにRAGの検索を改善する仕組み

AIの初心者
社内の資料に答えがあるはずなのに、短い質問だとうまく検索できません。質問を詳しく書くしかないのでしょうか?

AI専門家
AIに仮の説明文を作らせ、その文章を手掛かりに探す方法があります。HyDE、正式にはHypothetical Document Embeddingsという手法です。
AIの初心者
資料を読む前に作った説明なら、内容が間違っていることもありますよね。そのまま回答にしてよいのですか?
AI専門家
仮の説明は検索専用の手掛かりです。回答は、そこから見つけた実際の資料を確かめて作ります。この役割の違いが理解のポイントです。
HyDEとは。
HyDE(Hypothetical Document Embeddings)は、質問に答えそうな仮想文書を大規模言語モデル(LLM)で生成し、その埋め込みを使って実在する関連文書を検索する手法です。質問と文書の表現の隔たりを補うことを狙います。生成した仮想文書は事実を保証する資料ではなく、検索のために使います。
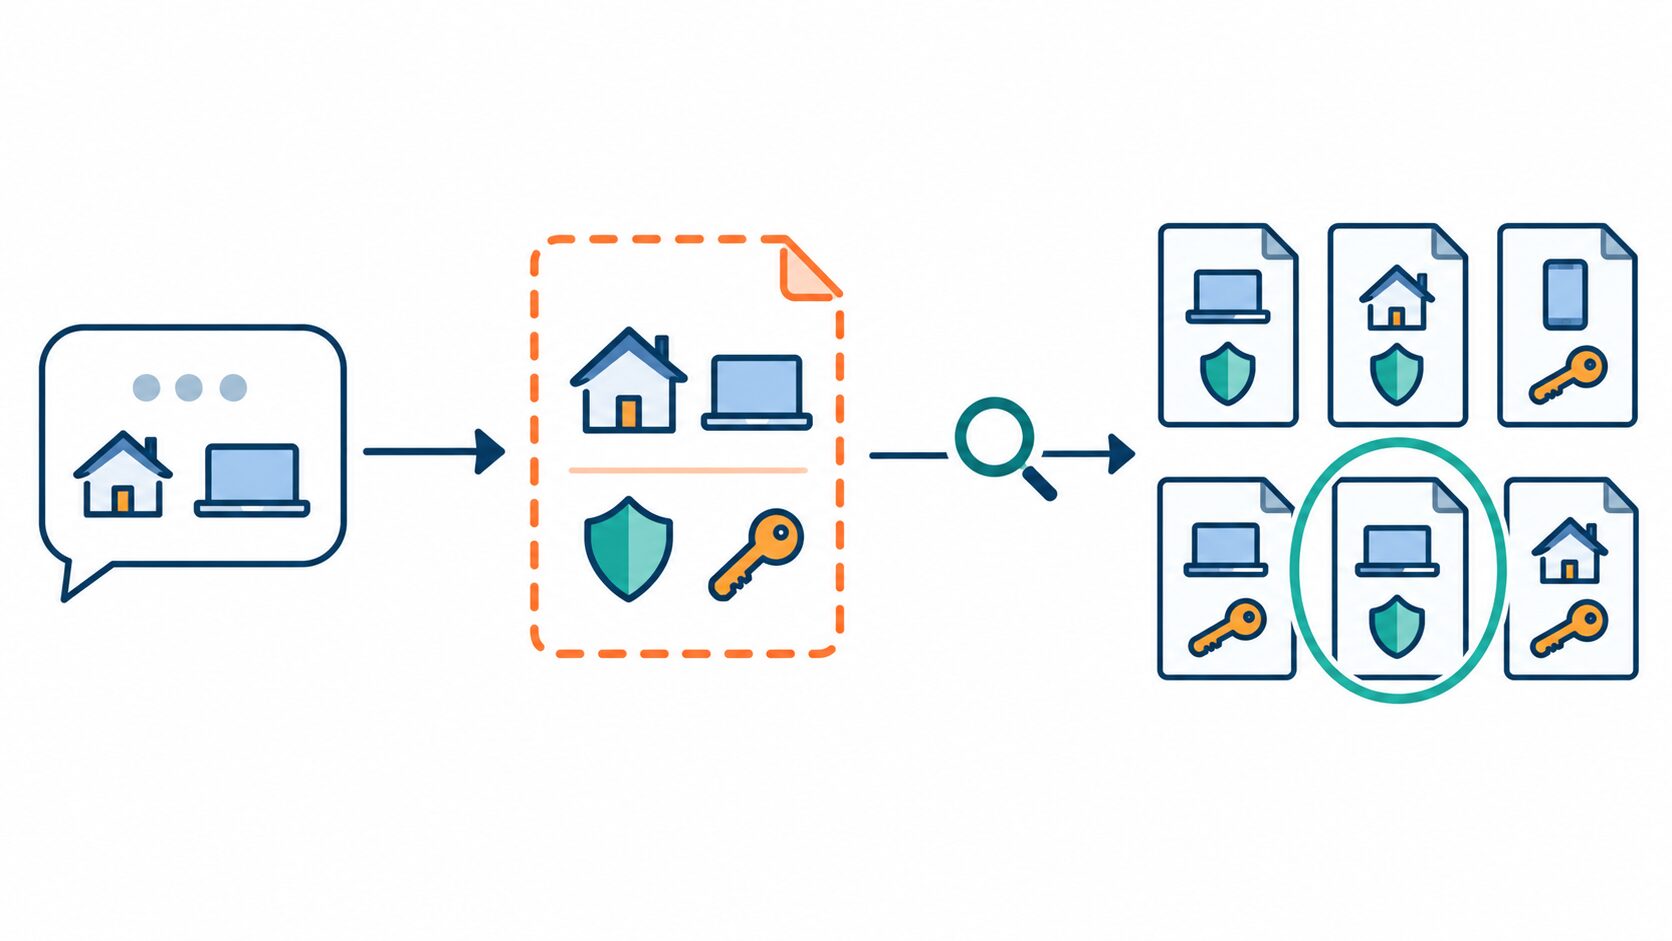
利用者が資料の専門用語を知らなくても、回答らしい文章を経由することで、目的の資料に近づける可能性があります。まずは検索で何を変えるのかを押さえ、実例と採用時の判断方法を見ていきましょう。
HyDEが補う質問と文書の表現の隔たり
HyDEが役立つ可能性があるのは、質問の言い方と、答えが書かれた文書の言い方が離れている場面です。利用者は困り事を日常語で尋ねますが、社内規程や技術資料は正式名称や分類名で書かれていることがあります。
たとえば「在宅勤務で会社のパソコンをなくしたら?」という質問に対し、資料の見出しは「貸与端末紛失時のインシデント報告手順」かもしれません。意味で探すベクトル検索は、単語が完全に一致しなくても関連する文章を見つけられます。ただし、質問が短く状況が十分に示されていなければ、在宅勤務制度や端末貸与の案内が上位に来る場合もあります。
そこで、質問から「端末の紛失を報告し、不正利用を防ぐための対応を依頼する」といった仮の文書を生成します。質問だけでは明示されていなかった関連語や説明の文脈を補い、探したい資料に近い表現で検索するのが狙いです。単に文章を長くするのではなく、関連文書にありそうな内容を表現させます。
HyDEは2022年に提案された検索手法です。RAGは外部資料を検索し、その内容を参照して回答を生成する仕組みですが、HyDEはその検索段階に組み込める選択肢に当たります。HyDE自体が、資料に基づく最終回答までを必ず行うわけではありません。
また、検索対象に目的の情報があることが前提です。未登録の規程や存在しない仕様を、仮想文書によって正式な情報として追加することはできません。資料が不足している問題と、ある資料を見つけられない問題を分けて考える必要があります。
仮想文書から実在する文書を検索する仕組み
処理の中心は、質問を直接検索用の数値へ変える代わりに、一度生成した文章を数値へ変えることです。ここでいう埋め込みとは、文章の意味的な特徴を数値の並びで表す処理を指します。その数値同士の近さを使って、関連する文書を探します。
- 質問を受け取る:利用者が知りたいことを入力します。固有名詞や状況など、質問に含まれる情報が生成の出発点になります。
- 仮想文書を生成する:LLMに、質問への回答が書かれていそうな文章を作らせます。この時点では検索対象の資料で内容を確認していません。
- 仮想文書を埋め込む:埋め込み用モデルで文章をベクトルに変換し、検索に使う表現を作ります。
- 実在する文書を検索する:事前に用意した文書索引から、仮想文書のベクトルに近い資料や文章の断片を取得します。
- 取得文書に基づいて回答する:RAGに組み込む場合は、元の質問と取得した資料を使い、利用者向けの回答を生成します。
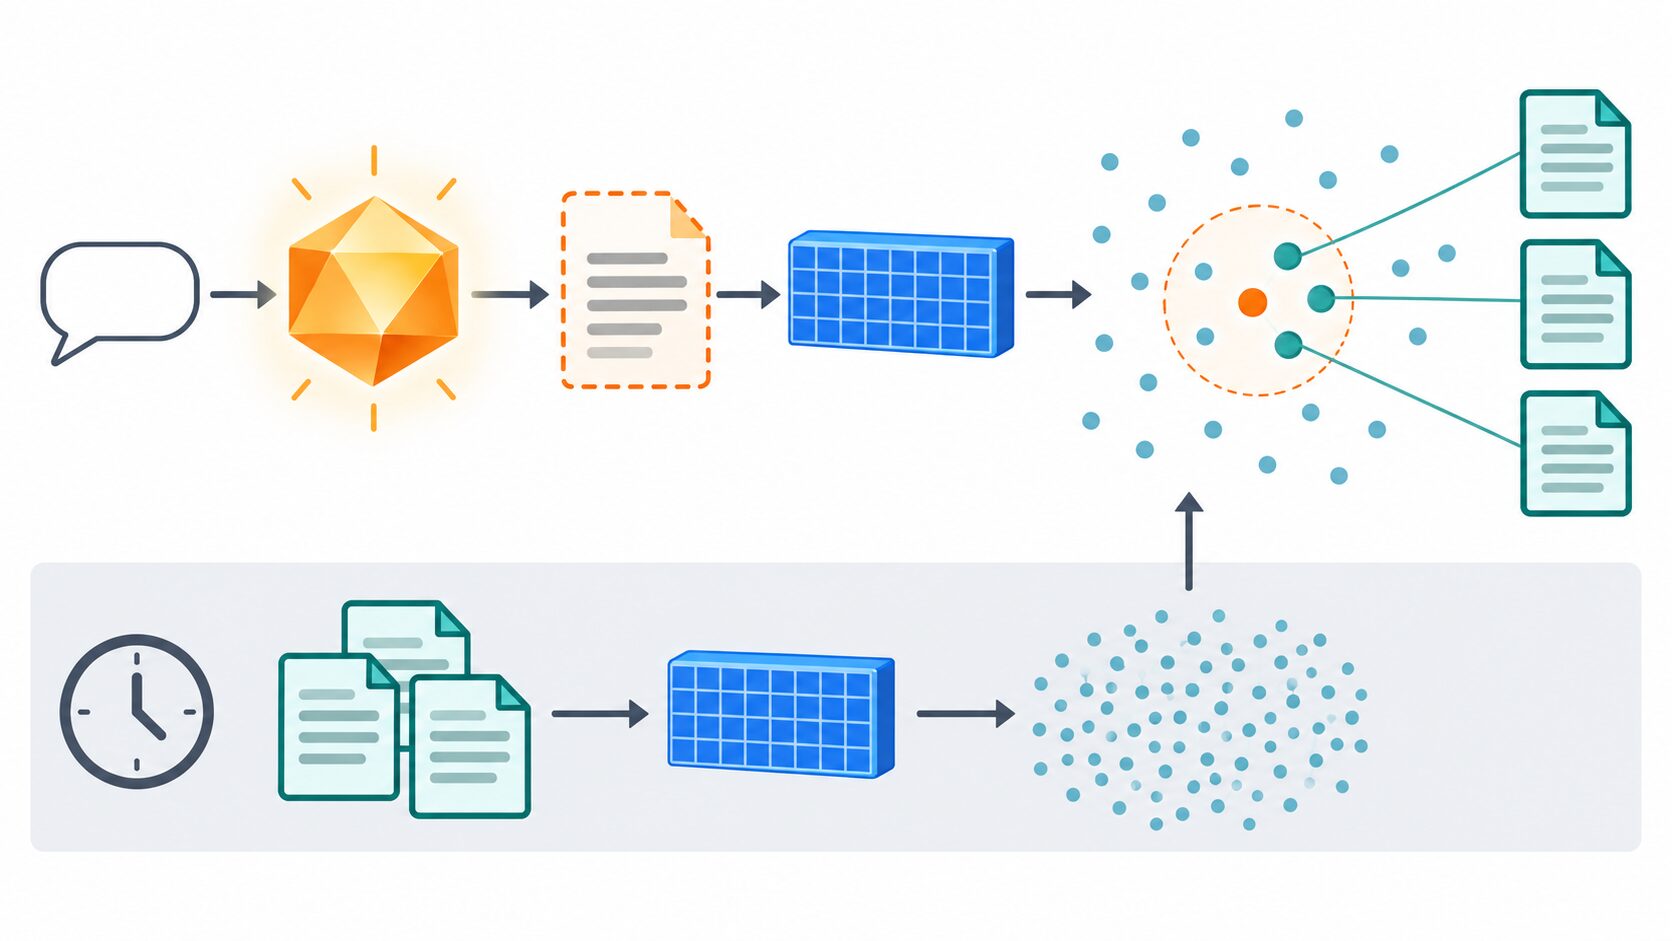
質問を受けてから行う処理とは別に、検索対象の文書を登録する準備が必要です。長い資料はチャンクと呼ぶ適度な長さの断片に分け、それぞれを埋め込んで索引に保存します。仮想文書と登録文書は、同じ埋め込みモデルなどを用い、数値の近さを比較できる同じ空間へ変換する必要があります。
文章を作るLLMと、文章を数値へ変える埋め込み用モデルは役割が異なります。原著では教師なしで学習されたエンコーダを使い、質問と関連文書の組に人が付けた関連度ラベルによる追加学習を必要としない検索を目指しています。モデルがまったく学習されていない、という意味ではありません。
埋め込みによって文章全体の意味を捉えれば、生成文の細部が違っていても関連資料に届く可能性があります。ただし、埋め込みは事実の真偽を判定する処理ではありません。誤った前提が強く表れた仮想文書なら、別の内容の資料へ検索を誘導するおそれもあります。
社内FAQの例で見る仮想文書と回答の根拠
同じ質問を使って、検索の手掛かりと回答の根拠を区別してみましょう。以下は仕組みを説明するための架空の社内規程の例です。部署名、対応内容、時間の指定は、実際の組織の規程を示すものではありません。
| 段階 | 文章の例 | 役割 |
|---|---|---|
| 元の質問 | 在宅勤務で会社のパソコンをなくしたら? | 利用者の知りたいことを示す。 |
| 仮想文書 | 会社の端末を紛失した場合、24時間以内に情報セキュリティ窓口へ連絡し、遠隔ロックを依頼する。 | 端末紛失、報告先、遠隔ロックなどの検索の手掛かりを補う。記載内容は未確認。 |
| 取得した規程 | 紛失に気づいたら速やかに情報システム部へ報告する。端末の遠隔操作は担当者が可否を判断する。 | 登録済みの「貸与端末紛失時対応マニュアル」に書かれた根拠。 |
| 最終回答 | マニュアルでは、気づいたら速やかに情報システム部へ報告するとされています。遠隔操作の可否は担当者が判断します。 | 取得した規程で裏付けられる内容を伝える。 |
この仮想文書には、検索には役立ちそうな語彙がある一方、取得した規程にない「24時間以内」という期限や、異なる窓口名が混ざっています。遠隔ロックを必ず実施できるとも確認できません。最終回答へそれらを引き継ぐと、資料を検索したにもかかわらず誤案内になってしまいます。
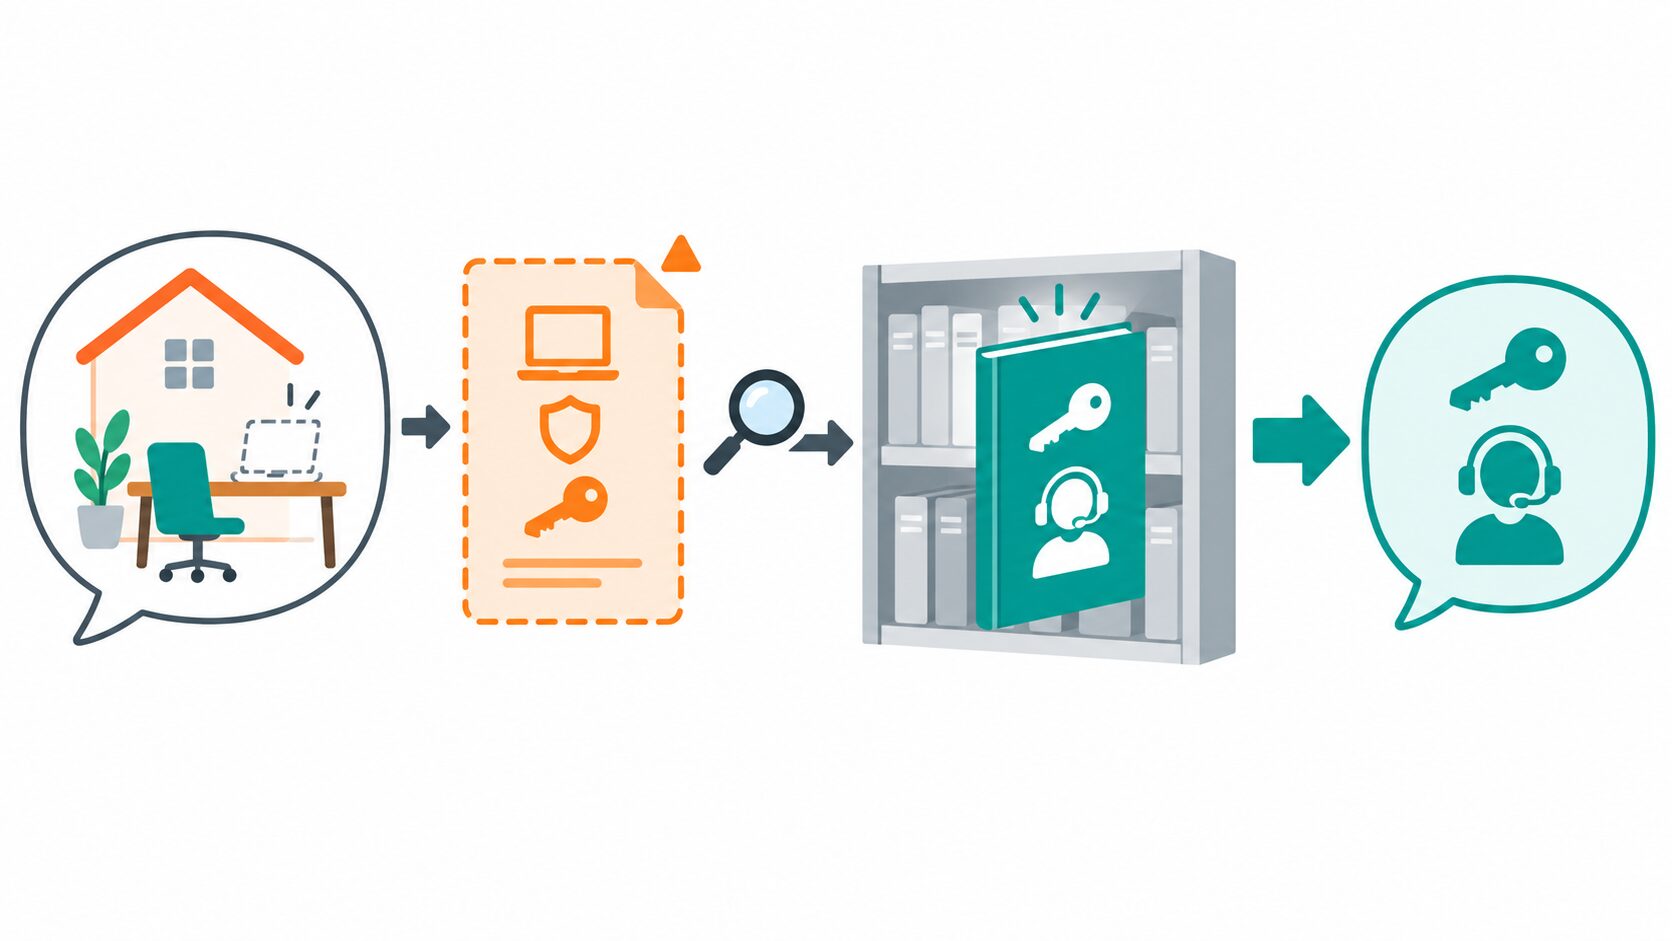
検索に使う文章と、回答の証拠として使う文章を分けることが重要です。構成を単純にするなら、回答生成には元の質問と取得した規程を渡し、仮想文書を根拠資料へ含めない設計が考えられます。回答に資料名や該当箇所も添えれば、利用者は内容を確かめやすくなります。
また、取得できたのが在宅勤務の一般案内だけなら、紛失時の期限や連絡先は分かりません。その場合は「取得できた資料では確認できません」と不足を示します。何かの文書が検索されたことと、質問に答える根拠が得られたことは別です。
クエリ書き換えやContextual Retrievalとの違い
検索改善の手法を比べるときは、処理する時点、入力、生成物、その用途を見ると整理できます。クエリは検索に渡す質問や検索語のことです。HyDEも広い意味ではクエリを変換する方法ですが、回答らしい文書を作って埋め込む点に特徴があります。
| 手法 | 処理時点 | 入力 | 生成物 | 主な用途 |
|---|---|---|---|---|
| 通常のクエリ書き換え | 質問時 | 質問。必要に応じて会話履歴も使う。 | 検索しやすく言い換えた質問や検索語。 | 曖昧な指示語の解消や表現の整理。 |
| HyDE | 質問時 | 質問。 | 質問に答えそうな仮想文書。 | 生成文の埋め込みで関連する実在文書を探す。 |
| Contextual Retrieval | 文書登録時 | 元文書全体と、その中のチャンク。 | チャンクの位置づけを説明する文脈情報。 | 文脈を付けたチャンクを索引化し、断片だけでは失われる意味を補う。 |
| ハイブリッド検索 | 検索時。各検索方式の索引は事前に準備。 | 質問や検索語。 | 複数方式の検索結果を統合した候補。 | キーワード検索とベクトル検索などの長所を組み合わせる。 |
先ほどの例で通常のクエリ書き換えをするなら、「在宅勤務中の貸与端末の紛失時対応」のように質問を整理します。HyDEでは、対応内容が書かれた説明文の形まで展開します。両者の境界を単なる文字数で決めるのではなく、何を生成し、どのように検索へ使うかで捉えましょう。
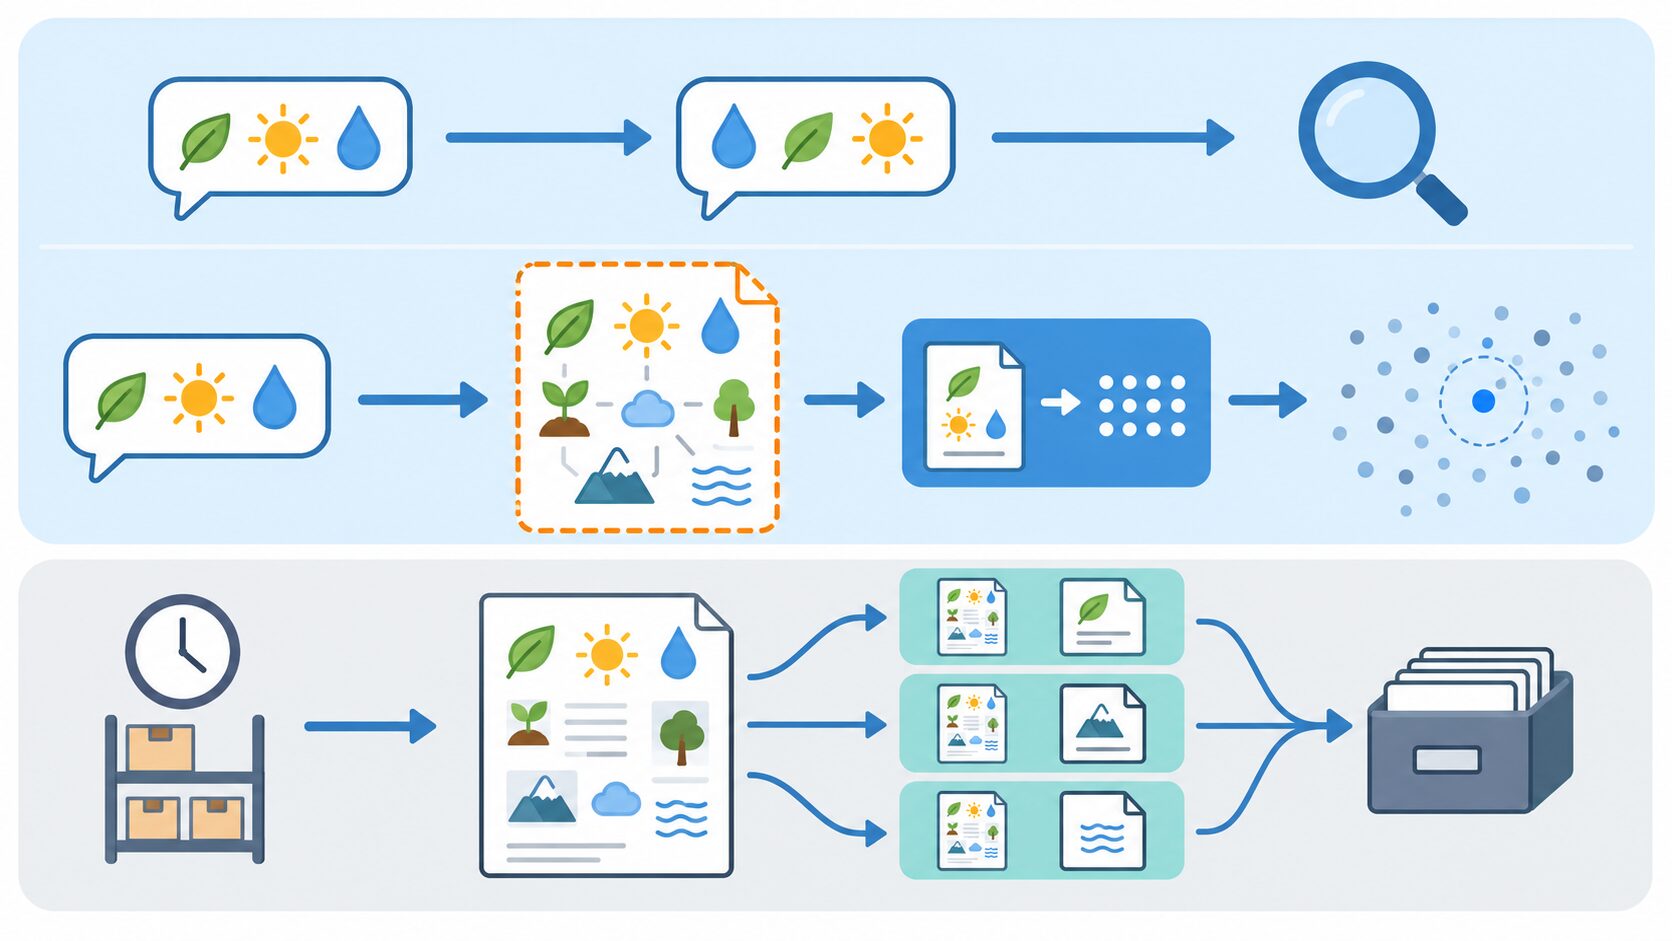
Contextual Retrievalが解決しようとするのは、たとえば規程の一部にある「担当部署へ報告」という断片だけでは、何の手続きか分からない問題です。元文書を参照して「貸与端末の紛失時対応に関する説明」といった文脈を補います。HyDEは質問側、Contextual Retrievalは登録文書側の表現を整えるという違いがあり、処理時点も異なります。
ハイブリッド検索は、回答らしい文章を作ることを必須としません。文字列の一致と意味の近さなど、異なる検索の結果を組み合わせる方法です。HyDEによるベクトル検索と、元の質問を使うキーワード検索を併用する構成も考えられます。
HyDEが向く場面と導入時の注意点
試す価値があるのは、資料はそろっているものの、利用者の質問が短い、あるいは利用者が専門用語を知らないために検索が外れる場面です。社内FAQや専門資料の検索で、質問と正解文書を見比べ、表現の隔たりが失敗の原因になっているか確認するとよいでしょう。
一方、「パソコンが使えない」のような質問からは、故障、ログイン失敗、紛失など複数の意図が考えられます。仮想文書が勝手に故障と決めつけると、もっともらしい修理の説明が検索を別方向へ導きます。意図を絞れない場合は、利用者への確認や、元の質問による検索結果も使う方法が適しています。
型番、製品名、エラーコードのように正確な文字列が重要な質問にも注意が必要です。生成の過程で似た名前へ置き換わると、内容が近くても別製品の資料を拾いかねません。生成時に文字列を保持するよう指示しつつ、元の質問を残したキーワード検索などで補う選択肢があります。指示だけで保持が保証されるわけではありません。
検索前にLLMの生成処理が増えるため、通常の検索と比べて待ち時間や利用料金が増えます。使うモデル、生成する長さ、質問数によって負担は変わります。常に有効にする前に、検索改善の幅が追加費用や応答の遅れに見合うかを確認しましょう。
運用面では、社名や顧客情報を含む質問をどの生成サービスへ送るのか、入力や生成結果をどこに記録するのかも、組織の取り扱い方針に照らして決めます。これは最終回答だけでなく、検索用に作る仮想文書にも関わります。
判断の基準は仮想文書の読みやすさではありません。滑らかな文章でも、取得資料と食い違うことがあります。良い仮想文書とは、実際の正解文書を探す助けになる文章です。検索対象に答えがない質問では、流暢な生成文ができても回答の裏付けにはなりません。
正解文書と回答品質で導入効果を確かめる
導入効果は、代表的な質問と、その質問に答えられる正解文書を用意して比較します。通常のベクトル検索を基準にし、HyDEを使ったときに必要な資料がより見つかるかを調べます。文書集合、チャンクの分け方、埋め込みモデル、取得件数をそろえると、質問側の処理を変えた効果を見やすくなります。
検索の指標の一つがRecall@kです。これは、正解文書のうち、検索結果の上位k件で取得できた割合を表します。ある質問の正解文書が4件あり、上位5件にそのうち3件が入れば、Recall@5は3÷4で75%です。上位5件の何割が正解か、という計算とは異なります。
正解が文書単位なのかチャンク単位なのかも、評価前に決めます。同じ規程の断片を複数取得しただけで、多くの正解を見つけたと数えないためです。実際のシステムが回答生成へ渡せる件数に合わせてkを固定し、複数の質問で比較しましょう。

検索の改善と、回答の品質は別々に評価します。正解文書を取得できても、回答生成が別の資料を優先したり、記載のない期限を付け加えたりすれば目的を達成できません。回答が質問に答えているか、取得資料と整合しているか、根拠のない情報を追加していないかを確認します。
評価用の質問には、専門用語を含まない質問、製品名や型番を含む質問、資料に答えがない質問を入れます。答えがない場合は正解文書がないため、通常のRecallの計算と分け、根拠不足を適切に示せたかを評価します。一部の得意な質問だけで判断すると、運用後の失敗を見落とします。
検索結果と回答品質に加えて、一問当たりの待ち時間や費用も記録します。全体の平均だけでなく、日常語の質問では改善し、型番を含む質問では悪化するなどの傾向を見ると、使いどころを判断できます。効果が確かめられた質問群に絞って導入する方法もあります。
HyDEの要点は、仮の回答で答えを確定することではなく、回答に必要な資料へ近づくために仮想文書を使うことです。この役割を守り、正解文書の取得と根拠に沿った回答の両方を確かめることで、自分たちのRAGに採用する価値があるか判断できます。
更新履歴
| 日付 | 内容 |
|---|---|
| 2026年10月7日 | 初回公開 |